


Zusammenfassung
In diesem Tutorial werden Sie durch das Bereitstellen und Ausführen von Llama 3.1- und Llama 3.2-Modellen mit vLLM in der Gemini Enterprise Agent Platform geführt. Es ist für die Verwendung mit zwei separaten Notebooks vorgesehen: Llama 3.1 mit vLLM zum Bereitstellen von Llama 3.1-Nur-Text-Modellen ausführen und Multimodales Llama 3.2 mit vLLM zum Bereitstellen von multimodalen Llama 3.2-Modellen ausführen, die sowohl Text- als auch Bildeingaben verarbeiten. Die auf dieser Seite beschriebenen Schritte zeigen Ihnen, wie Sie die Modellinferenz auf GPUs effizient handhaben und Modelle für verschiedene Anwendungen anpassen. Sie erhalten die Tools, mit denen Sie erweiterte Language Models in Ihre Projekte einbinden können.
Am Ende dieses Leitfadens werden Sie Folgendes wissen:
- Vordefinierte Llama-Modelle von Hugging Face mit vLLM-Container herunterladen.
- Diese Modelle auf GPU-Instanzen in Google Cloud Gemini Enterprise Agent Platform Model Garden mit vLLM bereitstellen.
- Modelle effizient bereitstellen, um eine große Anzahl von Inferenzanfragen zu verarbeiten.
- Inferenz für Nur-Text-Anfragen sowie Text- und Bildanfragen ausführen.
- Sie setzen alles wieder zurück.
- Bereitstellung debuggen.
Wichtige vLLM-Funktionen
| Feature | Beschreibung |
|---|---|
| PagedAttention | Ein optimierter Aufmerksamkeitsmechanismus, der den Arbeitsspeicher während der Inferenz effizient verwaltet. Unterstützt die Textgenerierung mit hohem Durchsatz durch dynamische Zuweisung von Speicherressourcen und ermöglicht so die Skalierbarkeit für mehrere gleichzeitige Anfragen. |
| Kontinuierliches Batching | Fasst mehrere Eingabeanfragen in einem einzigen Batch für die parallele Verarbeitung zusammen, um die GPU-Auslastung und den Durchsatz zu maximieren. |
| Token streaming | Ermöglicht die Ausgabe von Token für Token in Echtzeit während der Textgenerierung. Ideal für Anwendungen, die eine niedrige Latenz erfordern, z. B. Chatbots oder interaktive KI-Systeme. |
| Modellkompatibilität | Unterstützt eine Vielzahl vortrainierter Modelle in gängigen Frameworks wie Hugging Face Transformers. Erleichtert die Integration und das Experimentieren mit verschiedenen LLMs. |
| Multi-GPU und Multi-Host | Ermöglicht eine effiziente Modellbereitstellung, indem die Arbeitslast auf mehrere GPUs innerhalb einer einzelnen Maschine und auf mehrere Maschinen in einem Cluster verteilt wird. Dadurch werden Durchsatz und Skalierbarkeit erheblich erhöht. |
| Effiziente Bereitstellung | Bietet eine nahtlose Integration in APIs wie OpenAI Chat Completions, was die Bereitstellung für Produktionsanwendungsfälle vereinfacht. |
| Nahtlose Integration von Hugging Face-Modellen | vLLM ist mit dem Hugging Face-Modellartefaktformat kompatibel und unterstützt das Laden von HF. Dadurch können Llama-Modelle zusammen mit anderen gängigen Modellen wie Gemma, Phi und Qwen in einer optimierten Umgebung bereitgestellt werden. |
| Community-gesteuertes Open-Source-Projekt | vLLM ist Open Source und fördert Community-Beiträge, was zu einer kontinuierlichen Verbesserung der Effizienz der LLM-Bereitstellung beiträgt. |
vLLM-Anpassungen für die Google Gemini Enterprise Agent Platform: Leistung und Integration verbessern
Die vLLM-Implementierung in Google Gemini Enterprise Agent Platform Model Garden ist keine direkte Integration der Open-Source-Bibliothek. Die Gemini Enterprise Agent Platform bietet eine angepasste und optimierte Version von vLLM, die speziell auf die Verbesserung der Leistung, Zuverlässigkeit und nahtlosen Integration in Google Cloudzugeschnitten ist.
- Leistungsoptimierungen:
- Paralleles Herunterladen aus Cloud Storage: Beschleunigt das Laden und Bereitstellen von Modellen erheblich, da Daten parallel aus Cloud Storage abgerufen werden können. Dadurch wird die Latenz reduziert und die Startgeschwindigkeit verbessert.
- Funktionsverbesserungen:
- Dynamisches LoRA mit erweitertem Caching und Cloud Storage-Unterstützung: Erweitert die dynamischen LoRA-Funktionen um Datenträger-Caching-Mechanismen und robuste Fehlerbehandlung sowie Unterstützung für das Laden von LoRA-Gewichtungen direkt aus Cloud Storage-Pfaden und signierten URLs. Dies vereinfacht die Verwaltung und Bereitstellung benutzerdefinierter Modelle.
- Parsen von Funktionsaufrufen für Llama 3.1/3.2: Implementiert ein spezielles Parsen für Funktionsaufrufe von Llama 3.1/3.2, um die Robustheit des Parsens zu verbessern.
- Hostspeicher-Präfix-Caching: Das externe vLLM unterstützt nur GPU-Speicher-Präfix-Caching.
- Spekulatives Decodieren: Dies ist ein vorhandenes vLLM-Feature. Auf der Gemini Enterprise Agent Platform wurden jedoch Experimente durchgeführt, um leistungsstarke Modellkonfigurationen zu finden.
Diese Gemini Enterprise Agent Platform-spezifischen Anpassungen sind für den Endnutzer oft nicht sichtbar, ermöglichen es Ihnen aber, die Leistung und Effizienz Ihrer Llama 3.1-Bereitstellungen im Gemini Enterprise Agent Platform Model Garden zu maximieren.
- Integration in das Gemini Enterprise Agent Platform-Ökosystem:
- Unterstützung von Eingabe-/Ausgabeformaten für Vorhersagen der Gemini Enterprise Agent Platform: Sorgt für nahtlose Kompatibilität mit Eingabe- und Ausgabeformaten für Vorhersagen der Gemini Enterprise Agent Platform und vereinfacht so die Datenverarbeitung und die Integration in andere Gemini Enterprise Agent Platform-Dienste.
- Berücksichtigung von Vertex-Umgebungsvariablen: Berücksichtigt und nutzt Umgebungsvariablen der Gemini Enterprise Agent Platform (
AIP_*) für die Konfiguration und Ressourcenverwaltung, um die Bereitstellung zu optimieren und ein konsistentes Verhalten innerhalb der Gemini Enterprise Agent Platform-Umgebung zu gewährleisten. - Verbesserte Fehlerbehandlung und Robustheit: Implementiert umfassende Fehlerbehandlung, Eingabe-/Ausgabevalidierung und Mechanismen zur Serverbeendigung, um Stabilität, Zuverlässigkeit und nahtlosen Betrieb in der verwalteten Gemini Enterprise Agent Platform-Umgebung zu gewährleisten.
- Nginx-Server für die Funktion: Integriert einen Nginx-Server zusätzlich zum vLLM-Server, um die Bereitstellung mehrerer Replikate zu erleichtern und die Skalierbarkeit und Hochverfügbarkeit der Bereitstellungsinfrastruktur zu verbessern.
Weitere Vorteile von vLLM
- Benchmark-Leistung: vLLM bietet im Vergleich zu anderen Bereitstellungssystemen wie Hugging Face text-generation-inference und FasterTransformer von NVIDIA eine wettbewerbsfähige Leistung in Bezug auf Durchsatz und Latenz.
- Nutzerfreundlichkeit: Die Bibliothek bietet eine unkomplizierte API für die Einbindung in bestehende Workflows, sodass Sie sowohl Llama 3.1- als auch Llama 3.2-Modelle mit minimalem Aufwand bereitstellen können.
- Erweiterte Funktionen: vLLM unterstützt Streaming-Ausgaben (Generierung von Antworten Token für Token) und verarbeitet Prompts mit variabler Länge effizient, was die Interaktivität und Reaktionsfähigkeit in Anwendungen verbessert.
Eine Übersicht über das vLLM-System finden Sie in der Veröffentlichung.
Unterstützte Modelle
vLLM unterstützt eine große Auswahl an hochmodernen Modellen, sodass Sie das Modell auswählen können, das Ihren Anforderungen am besten entspricht. Die folgende Tabelle enthält eine Auswahl dieser Modelle. Eine vollständige Liste der unterstützten Modelle, einschließlich der Modelle für Nur-Text- und multimodale Inferenz, finden Sie auf der offiziellen vLLM-Website.
| Kategorie | Modelle |
|---|---|
| Meta AI | Llama 3.3, Llama 3.2, Llama 3.1, Llama 3, Llama 2, Code Llama |
| Mistral AI | Mistral 7B, Mixtral 8x7B, Mixtral 8x22B und ihre Varianten (Instruct, Chat), Mistral-tiny, Mistral-small, Mistral-medium |
| DeepSeek AI | DeepSeek-V3, DeepSeek-R1, DeepSeek-R1-Distill-Qwen-1.5B, DeepSeek-R1-Distill-Qwen-7B, DeepSeek-R1-Distill-Llama-8B, DeepSeek-R1-Distill-Qwen-14B, DeepSeek-R1-Distill-Qwen-32B, DeepSeek-R1-Distill-Llama-70B, Deepseek-vl2-tiny, Deepseek-vl2-small, Deepseek-vl2 |
| MosaicML | MPT (7B, 30B) und Varianten (Instruct, Chat), MPT-7B-StoryWriter-65k |
| OpenAI | GPT-2, GPT-3, GPT-4, GPT-NeoX |
| Together AI | RedPajama, Pythia |
| Stability AI | StableLM (3B, 7B), StableLM-Alpha-3B, StableLM-Base-Alpha-7B, StableLM-Instruct-Alpha-7B |
| TII (Technology Innovation Institute) | Falcon 7B, Falcon 40B und Varianten (Instruct, Chat), Falcon-RW-1B, Falcon-RW-7B |
| BigScience | BLOOM, BLOOMZ |
| FLAN-T5, UL2, Gemma (2B, 7B), PaLM 2, | |
| Salesforce | CodeT5, CodeT5+ |
| LightOn | Persimmon-8B-base, Persimmon-8B-chat |
| EleutherAI | GPT-Neo, Pythia |
| AI21 Labs | Jamba |
| Cerebras | Cerebras-GPT |
| Intel | Intel-NeuralChat-7B |
| Andere bekannte Modelle | StarCoder, OPT, Baichuan, Aquila, Qwen, InternLM, XGen, OpenLLaMA, Phi-2, Yi, OpenCodeInterpreter, Nous-Hermes, Gemma-it, Mistral-Instruct-v0.2-7B-Zeus, |
Erste Schritte mit Model Garden
Der vLLM-Cloud-GPUs-Bereitstellungscontainer ist in Model Garden, den Playground, die Ein-Klick-Bereitstellung und die Colab Enterprise-Notebook-Beispiele eingebunden. In dieser Anleitung wird die Llama-Modellfamilie von Meta AI als Beispiel verwendet.
Colab Enterprise-Notebook verwenden
Playground- und Ein-Klick-Bereitstellungen sind ebenfalls verfügbar, werden in dieser Anleitung jedoch nicht beschrieben.
- Rufen Sie die Seite „Modellkarte“ auf und klicken Sie auf Notebook öffnen.
- Wählen Sie das Vertex Serving-Notebook aus. Das Notebook wird in Colab Enterprise geladen.
- Gehen Sie das Notebook durch, um ein Modell mit vLLM bereitzustellen und Vorhersageanfragen an den Endpunkt zu senden.
Einrichtung und Anforderungen
In diesem Abschnitt werden die erforderlichen Schritte zum Einrichten Ihres Google Cloud-Projekts beschrieben. Außerdem wird erläutert, wie Sie die erforderlichen Ressourcen für die Bereitstellung und Bereitstellung von vLLM-Modellen erhalten.
1. Abrechnung
- Abrechnung aktivieren: Die Abrechnung für Ihr Projekt muss aktiviert sein. Weitere Informationen finden Sie unter Abrechnung für ein Projekt aktivieren, deaktivieren oder ändern.
2. GPU-Verfügbarkeit und -Kontingente
- Wenn Sie Vorhersagen mit Hochleistungs-GPUs (NVIDIA A100 80 GB oder H100 80 GB) ausführen möchten, prüfen Sie Ihre Kontingente für diese GPUs in der ausgewählten Region:
| Maschinentyp | Beschleunigertyp | Empfohlene Regionen |
|---|---|---|
| a2-ultragpu-1g | 1 NVIDIA_A100_80GB | us-central1, us-east4, europe-west4, asia-southeast1 |
| a3-highgpu-8g | 8 NVIDIA_H100_80GB | us-central1, us-west1, europe-west4, asia-southeast1 |
3. Google Cloud -Projekt einrichten
Führen Sie das folgende Codebeispiel aus, um zu prüfen, ob Ihre Google Cloud Umgebung korrekt eingerichtet ist. In diesem Schritt werden die erforderlichen Python-Bibliotheken installiert und der Zugriff auf Google Cloud -Ressourcen eingerichtet. Zu den Aktionen gehören:
- Installation: Aktualisieren Sie die
google-cloud-aiplatform-Bibliothek und klonen Sie das Repository mit den Dienstfunktionen. - Umgebungseinrichtung: Variablen für die Projekt-ID von Google Cloud , die Region und einen eindeutigen Cloud Storage-Bucket zum Speichern von Modellartefakten definieren.
- API-Aktivierung: Aktivieren Sie die Gemini Enterprise Agent Platform- und Compute Engine-APIs, die für die Bereitstellung und Verwaltung von KI-Modellen erforderlich sind.
- Bucket-Konfiguration: Erstellen Sie einen neuen Cloud Storage-Bucket oder prüfen Sie, ob sich ein vorhandener Bucket in der richtigen Region befindet.
- Gemini Enterprise Agent Platform initialisieren: Initialisieren Sie die Gemini Enterprise Agent Platform-Clientbibliothek mit den Einstellungen für Projekt, Standort und Staging-Bucket.
- Dienstkonto einrichten: Identifizieren Sie das Standarddienstkonto zum Ausführen von Gemini Enterprise Agent Platform-Jobs und weisen Sie ihm die erforderlichen Berechtigungen zu.
BUCKET_URI = "gs://"

REGION = ""

! pip3 install --upgrade --quiet 'google-cloud-aiplatform>=1.64.0'
! git clone https://github.com/GoogleCloudPlatform/vertex-ai-samples.git

import datetime
import importlib
import os
import uuid
from typing import Tuple

import requests
from google.cloud import aiplatform

common_util = importlib.import_module(
    "vertex-ai-samples.community-content.vertex_model_garden.model_oss.notebook_util.common_util"
)

models, endpoints = {}, {}

PROJECT_ID = os.environ["GOOGLE_CLOUD_PROJECT"]

if not REGION:
    REGION = os.environ["GOOGLE_CLOUD_REGION"]

print("Enabling Agent Platform API and Compute Engine API.")
! gcloud services enable aiplatform.googleapis.com compute.googleapis.com

now = datetime.datetime.now().strftime("%Y%m%d%H%M%S")
BUCKET_NAME = "/".join(BUCKET_URI.split("/")[:3])

if BUCKET_URI is None or BUCKET_URI.strip() == "" or BUCKET_URI == "gs://":
    BUCKET_URI = f"gs://{PROJECT_ID}-tmp-{now}-{str(uuid.uuid4())[:4]}"
    BUCKET_NAME = "/".join(BUCKET_URI.split("/")[:3])
    ! gsutil mb -l {REGION} {BUCKET_URI}
else:
    assert BUCKET_URI.startswith("gs://"), "BUCKET_URI must start with `gs://`."
    shell_output = ! gsutil ls -Lb {BUCKET_NAME} | grep "Location constraint:" | sed "s/Location constraint://"
    bucket_region = shell_output[0].strip().lower()
    if bucket_region != REGION:
        raise ValueError(
            "Bucket region %s is different from notebook region %s"
            % (bucket_region, REGION)
        )
print(f"Using this Bucket: {BUCKET_URI}")

STAGING_BUCKET = os.path.join(BUCKET_URI, "temporal")
MODEL_BUCKET = os.path.join(BUCKET_URI, "llama3_1")

print("Initializing Agent Platform API.")
aiplatform.init(project=PROJECT_ID, location=REGION, staging_bucket=STAGING_BUCKET)

shell_output = ! gcloud projects describe $PROJECT_ID
project_number = shell_output[-1].split(":")[1].strip().replace("'", "")
SERVICE_ACCOUNT = "your service account email"
print("Using this default Service Account:", SERVICE_ACCOUNT)

! gsutil iam ch serviceAccount:{SERVICE_ACCOUNT}:roles/storage.admin $BUCKET_NAME

! gcloud config set project $PROJECT_ID
! gcloud projects add-iam-policy-binding --no-user-output-enabled {PROJECT_ID} --member=serviceAccount:{SERVICE_ACCOUNT} --role="roles/storage.admin"
! gcloud projects add-iam-policy-binding --no-user-output-enabled {PROJECT_ID} --member=serviceAccount:{SERVICE_ACCOUNT} --role="roles/aiplatform.user"
Hugging Face mit Meta Llama 3.1, 3.2 und vLLM verwenden
Die Llama 3.1- und 3.2-Sammlungen von Meta bieten eine Reihe mehrsprachiger Large Language Models (LLMs), die für die hochwertige Textgenerierung in verschiedenen Anwendungsfällen entwickelt wurden. Diese Modelle sind vortrainiert und anhand von Anleitungen abgestimmt. Sie eignen sich hervorragend für Aufgaben wie mehrsprachige Dialoge, Zusammenfassungen und agentischen Datenabruf. Bevor Sie Llama 3.1- und 3.2-Modelle verwenden können, müssen Sie den Nutzungsbedingungen zustimmen, wie im Screenshot gezeigt. Die vLLM-Bibliothek bietet eine optimierte Open-Source-Bereitstellungsumgebung mit Optimierungen für Latenz, Speichereffizienz und Skalierbarkeit.
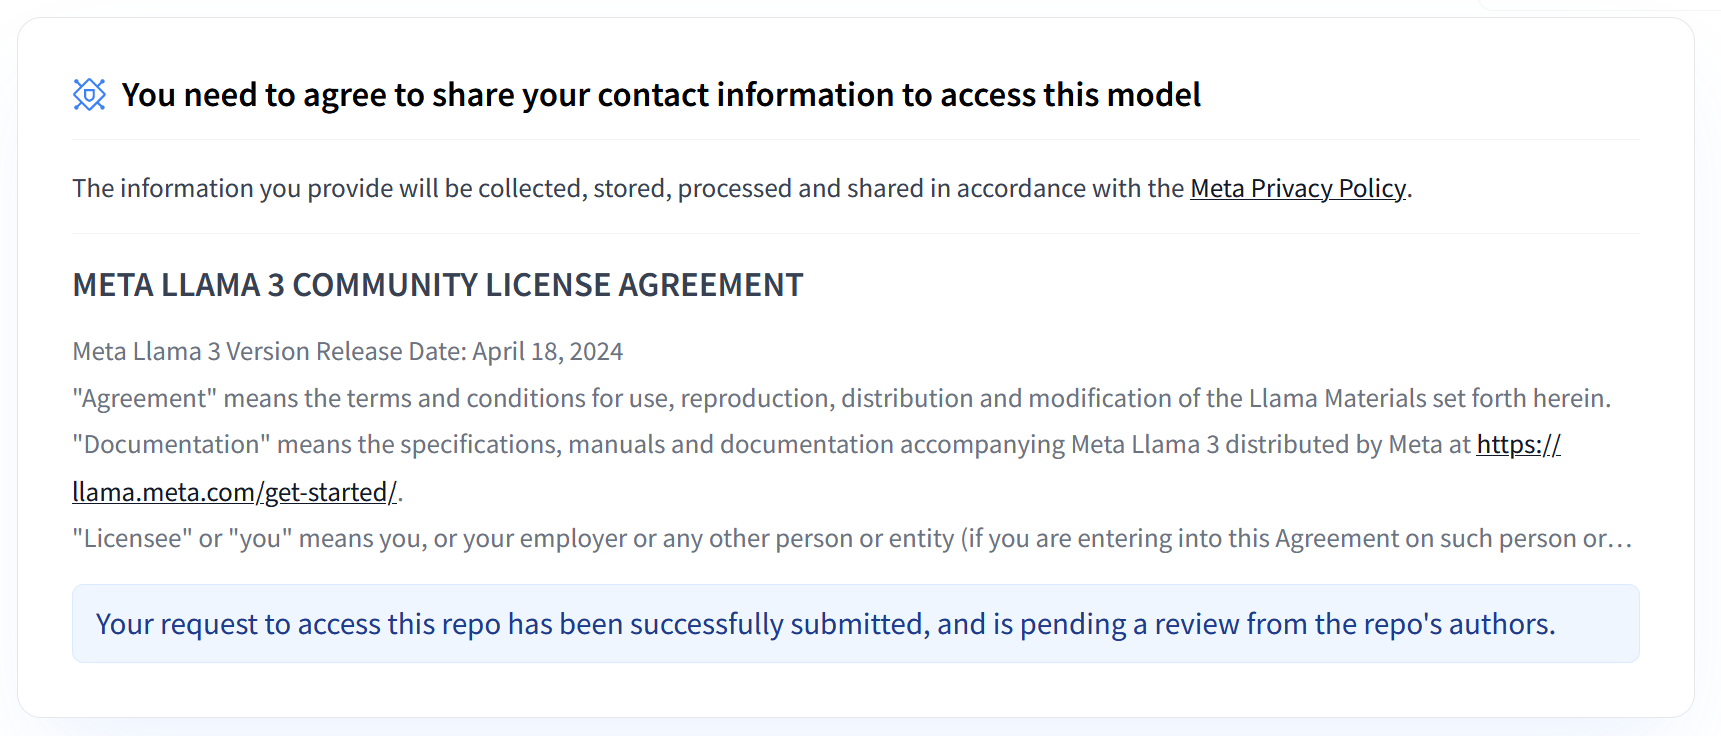 Abbildung 1: Meta LLama 3 Community-Lizenzvereinbarung
Übersicht über die Meta Llama 3.1- und 3.2-Sammlungen
Die Llama 3.1- und 3.2-Sammlungen sind jeweils für unterschiedliche Bereitstellungsskalen und Modellgrößen geeignet und bieten Ihnen flexible Optionen für mehrsprachige Dialogaufgaben und mehr. Weitere Informationen finden Sie auf der Übersichtsseite zu Llama.
- Nur Text: Die Llama 3.2-Sammlung mehrsprachiger Large Language Models (LLMs) ist eine Sammlung vortrainierter und anweisungsorientierter generativer Modelle in den Größen 1B und 3B (Text-in/Text-Ausgang).
- Vision und Vision Instruct: Die Llama 3.2-Vision-Sammlung multimodaler Large Language Models (LLMs) ist eine Sammlung vortrainierter und anweisungsorientierter generativer Modelle für die Bildanalyse in den Größen 11B und 90B (Text + Bilder als Eingabe, Text als Ausgabe). Optimierung: Wie Llama 3.1 sind die 3.2-Modelle auf mehrsprachige Dialoge zugeschnitten und erzielen gute Ergebnisse bei Abruf- und Zusammenfassungsaufgaben. Sie erreichen Spitzenwerte bei Standard-Benchmarks.
- Modellarchitektur: Llama 3.2 bietet ebenfalls ein autoregressives Transformer-Framework, bei dem SFT und RLHF angewendet werden, um die Modelle auf Nützlichkeit und Sicherheit auszurichten.
Hugging Face-Nutzerzugriffstokens
Für diese Anleitung ist ein Zugriffstoken mit Leseberechtigungen vom Hugging Face Hub erforderlich, um auf die erforderlichen Ressourcen zuzugreifen. So richten Sie die Authentifizierung ein:
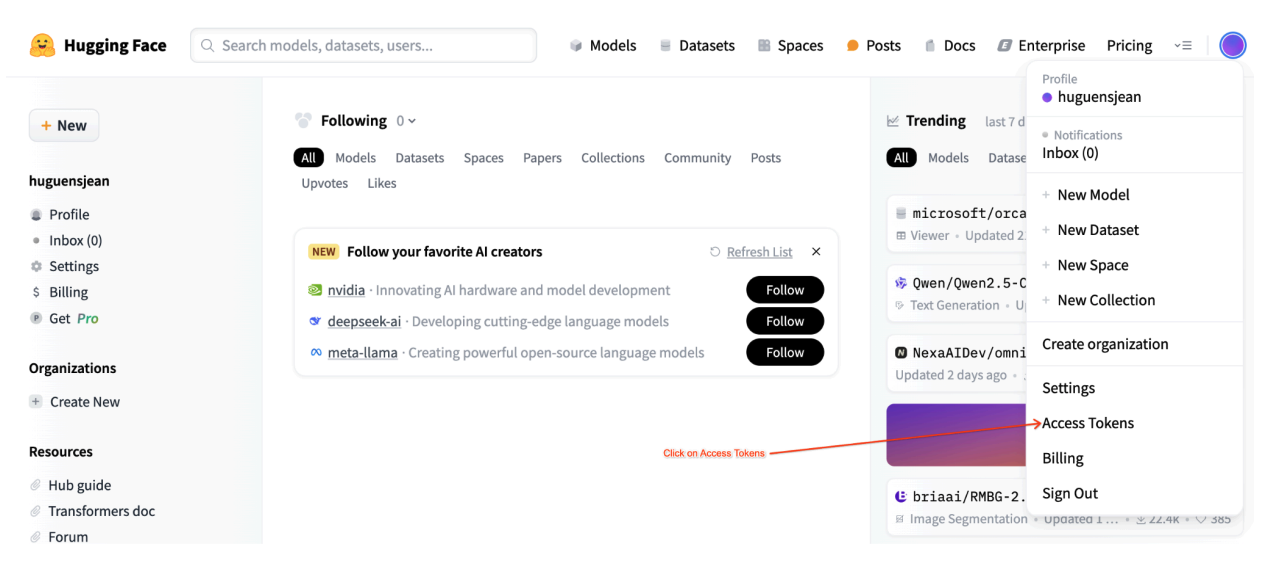 Abbildung 2: Hugging Face-Zugriffstoken-Einstellungen
Generieren Sie ein Token mit Lesezugriff:
- Rufen Sie die Hugging Face-Kontoeinstellungen auf.
- Erstellen Sie ein neues Token, weisen Sie ihm die Rolle „Lesen“ zu und speichern Sie das Token sicher.
Verwenden Sie das Token:
- Verwenden Sie das generierte Token, um sich zu authentifizieren und auf öffentliche oder private Repositories zuzugreifen, wie es für die Anleitung erforderlich ist.
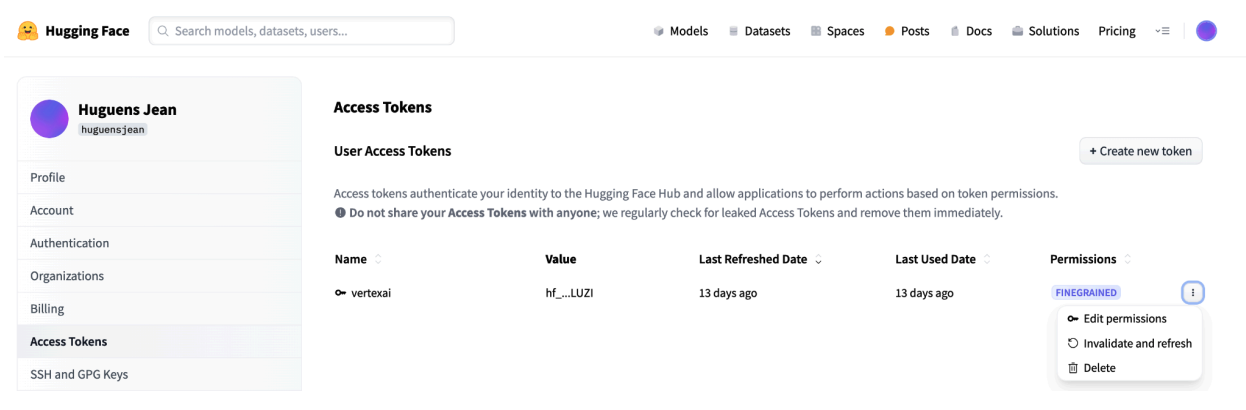 Abbildung 3: Hugging Face-Zugriffstoken verwalten
So haben Sie die erforderliche Zugriffsebene, ohne unnötige Berechtigungen zu erhalten. Diese Praktiken erhöhen die Sicherheit und verhindern, dass Tokens versehentlich offengelegt werden. Weitere Informationen zum Einrichten von Zugriffstokens finden Sie auf der Seite zu Hugging Face-Zugriffstokens.
Geben Sie Ihr Token nicht öffentlich oder online weiter. Wenn Sie Ihr Token während der Bereitstellung als Umgebungsvariable festlegen, bleibt es für Ihr Projekt privat. Die Gemini Enterprise Agent Platform sorgt für Sicherheit, indem sie verhindert, dass andere Nutzer auf Ihre Modelle und Endpunkte zugreifen.
Weitere Informationen zum Schutz Ihres Zugriffstokens finden Sie in den Best Practices für Hugging Face-Zugriffstokens.
Llama 3.1-Nur-Text-Modelle mit vLLM bereitstellen
Für die produktionsreife Bereitstellung von Large Language Models bietet vLLM eine effiziente Bereitstellungslösung, die die Speichernutzung optimiert, die Latenz verringert und den Durchsatz erhöht. Dadurch eignet es sich besonders gut für die Verarbeitung der größeren Llama 3.1-Modelle sowie der multimodalen Llama 3.2-Modelle.
Schritt 1: Modell für die Bereitstellung auswählen
Wählen Sie die Llama 3.1-Modellvariante aus, die Sie bereitstellen möchten. Zu den verfügbaren Optionen gehören verschiedene Größen und auf Anweisungen abgestimmte Versionen:
base_model_name = "Meta-Llama-3.1-8B"  # @param ["Meta-Llama-3.1-8B", "Meta-Llama-3.1-8B-Instruct", "Meta-Llama-3.1-70B", "Meta-Llama-3.1-70B-Instruct", "Meta-Llama-3.1-405B-FP8", "Meta-Llama-3.1-405B-Instruct-FP8"]
hf_model_id = "meta-Llama/" + base_model_name
Schritt 2: Bereitstellungshardware und Kontingent prüfen
Die Bereitstellungsfunktion legt die entsprechende GPU und den Maschinentyp basierend auf der Modellgröße fest und prüft das Kontingent in dieser Region für ein bestimmtes Projekt:
if "8b" in base_model_name.lower():
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-12"
    accelerator_count = 1
elif "70b" in base_model_name.lower():
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-96"
    accelerator_count = 8
elif "405b" in base_model_name.lower():
    accelerator_type = "NVIDIA_H100_80GB"
    machine_type = "a3-highgpu-8g"
    accelerator_count = 8
else:
    raise ValueError(f"Recommended GPU setting not found for: {accelerator_type} and {base_model_name}.")
Prüfen Sie die Verfügbarkeit des GPU-Kontingents in der angegebenen Region:
common_util.check_quota(
    project_id=PROJECT_ID,
    region=REGION,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    is_for_training=False,
)
Schritt 3: Modell mit vLLM prüfen
Mit der folgenden Funktion wird das Modell in die Gemini Enterprise Agent Platform hochgeladen, die Bereitstellungseinstellungen werden konfiguriert und das Modell wird mit vLLM auf einem Endpunkt bereitgestellt.
- Docker-Image: Für die Bereitstellung wird ein vordefiniertes vLLM-Docker-Image verwendet, um eine effiziente Bereitstellung zu ermöglichen.
- Konfiguration: Konfigurieren Sie die Arbeitsspeicherauslastung, die Modelllänge und andere vLLM-Einstellungen. Weitere Informationen zu den vom Server unterstützten Argumenten finden Sie auf der offiziellen vLLM-Dokumentationsseite.
- Umgebungsvariablen: Legen Sie Umgebungsvariablen für die Authentifizierung und die Bereitstellungsquelle fest.
def deploy_model_vllm(
    model_name: str,
    model_id: str,
    service_account: str,
    base_model_id: str = None,
    machine_type: str = "g2-standard-8",
    accelerator_type: str = "NVIDIA_L4",
    accelerator_count: int = 1,
    gpu_memory_utilization: float = 0.9,
    max_model_len: int = 4096,
    dtype: str = "auto",
    enable_trust_remote_code: bool = False,
    enforce_eager: bool = False,
    enable_lora: bool = False,
    max_loras: int = 1,
    max_cpu_loras: int = 8,
    use_dedicated_endpoint: bool = False,
    max_num_seqs: int = 256,
) -> Tuple[aiplatform.Model, aiplatform.Endpoint]:
    """Deploys trained models with vLLM into Agent Platform."""
    endpoint = aiplatform.Endpoint.create(
        display_name=f"{model_name}-endpoint",
        dedicated_endpoint_enabled=use_dedicated_endpoint,
    )

    if "8b" in base_model_name.lower():
        accelerator_type = "NVIDIA_L4"
        machine_type = "g2-standard-12"
        accelerator_count = 1
    elif "70b" in base_model_name.lower():
        accelerator_type = "NVIDIA_L4"
        machine_type = "g2-standard-96"
        accelerator_count = 8
    elif "405b" in base_model_name.lower():
        accelerator_type = "NVIDIA_H100_80GB"
        machine_type = "a3-highgpu-8g"
        accelerator_count = 8
    else:
        raise ValueError(f"Recommended GPU setting not found for: {accelerator_type} and {base_model_name}.")

    common_util.check_quota(
        project_id=PROJECT_ID,
        region=REGION,
        accelerator_type=accelerator_type,
        accelerator_count=accelerator_count,
        is_for_training=False,
    )

    vllm_args = [
        "python", "-m", "vllm.entrypoints.api_server",
        "--host=0.0.0.0",
        "--port=8080",
        f"--model={model_id}",
        f"--tensor-parallel-size={accelerator_count}",
        "--swap-space=16",
        f"--gpu-memory-utilization={gpu_memory_utilization}",
        f"--max-model-len={max_model_len}", f"--dtype={dtype}",
        f"--max-loras={max_loras}", f"--max-cpu-loras={max_cpu_loras}",
        f"--max-num-seqs={max_num_seqs}", "--disable-log-stats"
    ]

    if enable_trust_remote_code:
        vllm_args.append("--trust-remote-code")
    if enforce_eager:
        vllm_args.append("--enforce-eager")
    if enable_lora:
        vllm_args.append("--enable-lora")
    if model_type:
        vllm_args.append(f"--model-type={model_type}")

    env_vars = {
        "MODEL_ID": model_id,
        "DEPLOY_SOURCE": "notebook",
        "HF_TOKEN": HF_TOKEN
    }

    model = aiplatform.Model.upload(
        display_name=model_name,
        serving_container_image_uri=VLLM_DOCKER_URI,
        serving_container_args=vllm_args,
        serving_container_ports=[8080],
        serving_container_predict_route="/generate",
        serving_container_health_route="/ping",
        serving_container_environment_variables=env_vars,
        serving_container_shared_memory_size_mb=(16 * 1024),
        serving_container_deployment_timeout=7200,
    )
    print(f"Deploying {model_name} on {machine_type} with {accelerator_count} {accelerator_type} GPU(s).")

    model.deploy(
        endpoint=endpoint,
        machine_type=machine_type,
        accelerator_type=accelerator_type,
        accelerator_count=accelerator_count,
        deploy_request_timeout=1800,
        service_account=service_account,
    )
    print("endpoint_name:", endpoint.name)

    return model, endpoint
Schritt 4: Bereitstellung ausführen
Führen Sie die Bereitstellungsfunktion mit dem ausgewählten Modell und der ausgewählten Konfiguration aus. In diesem Schritt wird das Modell bereitgestellt und die Modell- und Endpunktinstanzen werden zurückgegeben:
HF_TOKEN = ""

VLLM_DOCKER_URI = "us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241001_0916_RC00"

model_name = common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve-vllm")
gpu_memory_utilization = 0.9
max_model_len = 4096
max_loras = 1

models["vllm_gpu"], endpoints["vllm_gpu"] = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve"),
    model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=machine_type,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    gpu_memory_utilization=gpu_memory_utilization,
    max_model_len=max_model_len,
    max_loras=max_loras,
    enforce_eager=True,
    enable_lora=True,
    use_dedicated_endpoint=use_dedicated_endpoint,
)
Nachdem Sie dieses Codebeispiel ausgeführt haben, wird Ihr Llama 3.1-Modell auf der Gemini Enterprise Agent Platform bereitgestellt und ist über den angegebenen Endpunkt zugänglich. Sie können damit für Inferenzaufgaben wie Textgenerierung, Zusammenfassung und Dialog interagieren. Je nach Modellgröße kann die Bereitstellung eines neuen Modells bis zu einer Stunde dauern. Sie können den Fortschritt bei der Onlinevorhersage prüfen.
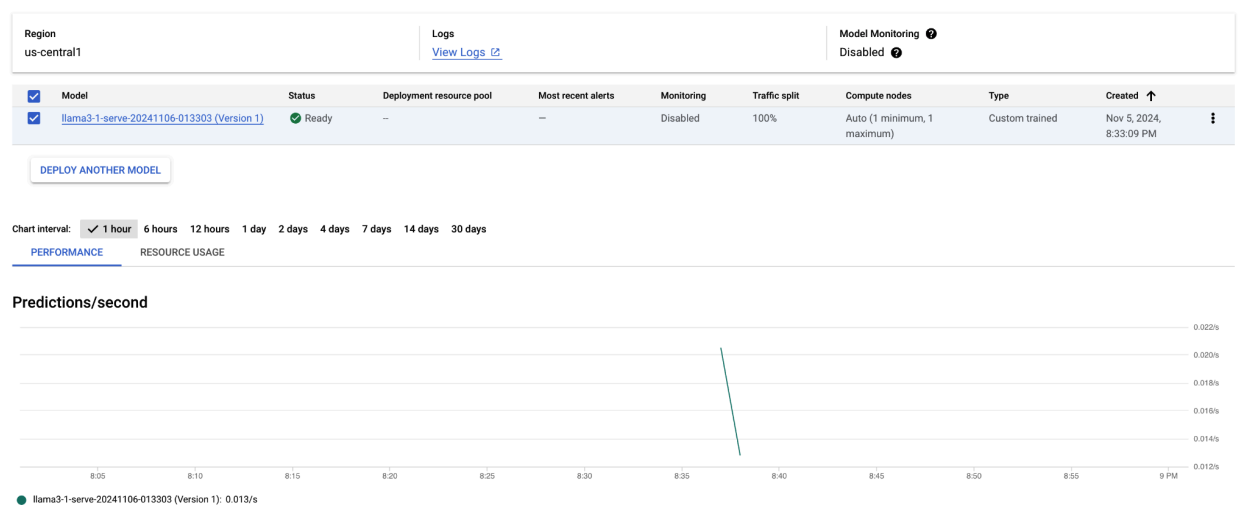 Abbildung 4: Llama 3.1-Bereitstellungsendpunkt im Vertex-Dashboard
Vorhersagen mit Llama 3.1 auf der Gemini Enterprise Agent Platform treffen
Nachdem Sie das Llama 3.1-Modell erfolgreich auf der Gemini Enterprise Agent Platform bereitgestellt haben, können Sie Vorhersagen abrufen, indem Sie Text-Prompts an den Endpunkt senden. In diesem Abschnitt finden Sie ein Beispiel für das Generieren von Antworten mit verschiedenen anpassbaren Parametern zur Steuerung der Ausgabe.
Schritt 1: Prompt und Parameter definieren
Richten Sie zuerst Ihren Text-Prompt und die Stichprobenparameter ein, um die Antwort des Modells zu steuern. Hier sind die wichtigsten Parameter:
prompt: Der Eingabetext, für den das Modell eine Antwort generieren soll. Beispiel: prompt = „Was ist ein Auto?“.max_tokens: Die maximale Anzahl von Tokens in der generierten Ausgabe. Wenn Sie diesen Wert verringern, können Sie Zeitüberschreitungsprobleme vermeiden.temperature: Steuert die Zufälligkeit von Vorhersagen. Höhere Werte (z. B. 1, 0) erhöhen die Vielfalt, während niedrigere Werte (z. B. 0, 5) die Ausgabe fokussierter machen.top_p: Begrenzt den Stichprobenpool auf die höchste kumulative Wahrscheinlichkeit. Wenn Sie beispielsweise top_p = 0,9 festlegen, werden nur Tokens innerhalb der obersten 90 % der Wahrscheinlichkeitsmasse berücksichtigt.top_k: Beschränkt die Stichprobenerhebung auf die k wahrscheinlichsten Tokens. Wenn Sie beispielsweise top_k = 50 festlegen, werden nur die 50 besten Tokens berücksichtigt.raw_response: Wenn „True“, wird die Rohausgabe des Modells zurückgegeben. Wenn „False“, wird eine zusätzliche Formatierung mit der Struktur „Prompt:\n{prompt}\nOutput:\n{output}“ angewendet.lora_id(optional): Pfad zu LoRA-Gewichtungsdateien, um LoRA-Gewichtungen (Low-Rank Adaptation) anzuwenden. Dies kann ein Cloud Storage-Bucket oder eine Hugging Face-Repository-URL sein. Dies funktioniert nur, wenn--enable-lorain den Bereitstellungsargumenten festgelegt ist. Dynamisches LoRA wird für multimodale Modelle nicht unterstützt.
prompt = "What is a car?"
max_tokens = 50
temperature = 1.0
top_p = 1.0
top_k = 1
raw_response = False
lora_id = ""
Schritt 2: Vorhersageanfrage senden
Nachdem die Instanz konfiguriert ist, können Sie die Vorhersageanfrage an den bereitgestellten Gemini Enterprise Agent Platform-Endpunkt senden. In diesem Beispiel wird gezeigt, wie Sie eine Vorhersage treffen und das Ergebnis ausgeben:
response = endpoints["vllm_gpu"].predict(
    instances=instances, use_dedicated_endpoint=use_dedicated_endpoint
)

for prediction in response.predictions:
    print(prediction)
Beispielausgabe
Hier ein Beispiel dafür, wie das Modell auf den Prompt „Was ist ein Auto?“ antworten könnte:
Human: What is a car?
Assistant: A car, or a motor car, is a road-connected human-transportation system
used to move people or goods from one place to another.
Zusätzliche Hinweise
- Moderation: Mit den Funktionen zur Textmoderation der Agent Platform können Sie den generierten Text moderieren, um sichere Inhalte zu gewährleisten.
- Umgang mit Zeitüberschreitungen: Wenn Probleme wie
ServiceUnavailable:
503
auftreten, versuchen Sie, den Parametermax_tokenszu reduzieren.
Dieser Ansatz bietet eine flexible Möglichkeit, mit dem Llama 3.1-Modell über verschiedene Sampling-Techniken und LoRA-Adapter zu interagieren. Er eignet sich für eine Vielzahl von Anwendungsfällen, von der Textgenerierung für allgemeine Zwecke bis hin zu aufgabenspezifischen Antworten.
Multimodale Llama 3.2-Modelle mit vLLM bereitstellen
In diesem Abschnitt wird beschrieben, wie Sie vordefinierte Llama 3.2-Modelle in die Model Registry hochladen und auf einem Gemini Enterprise Agent Platform-Endpunkt bereitstellen. Die Bereitstellung kann je nach Größe des Modells bis zu einer Stunde dauern. Llama 3.2-Modelle sind in multimodalen Versionen verfügbar, die sowohl Text- als auch Bildeingaben unterstützen. vLLM unterstützt:
- Nur-Text-Format
- Format mit einem Bild und Text
Diese Formate machen Llama 3.2 für Anwendungen geeignet, die sowohl visuelle als auch Textverarbeitung erfordern.
Schritt 1: Modell für die Bereitstellung auswählen
Geben Sie die Llama 3.2-Modellvariante an, die Sie bereitstellen möchten. Im folgenden Beispiel wird Llama-3.2-11B-Vision als ausgewähltes Modell verwendet. Sie können aber je nach Ihren Anforderungen aus anderen verfügbaren Optionen auswählen.
base_model_name = "Llama-3.2-11B-Vision"  # @param ["Llama-3.2-1B", "Llama-3.2-1B-Instruct", "Llama-3.2-3B", "Llama-3.2-3B-Instruct", "Llama-3.2-11B-Vision", "Llama-3.2-11B-Vision-Instruct", "Llama-3.2-90B-Vision", "Llama-3.2-90B-Vision-Instruct"]
hf_model_id = "meta-Llama/" + base_model_name
Schritt 2: Hardware und Ressourcen konfigurieren
Wählen Sie die geeignete Hardware für die Modellgröße aus. vLLM kann je nach Rechenanforderungen des Modells verschiedene GPUs verwenden:
- 1B- und 3B-Modelle: Verwenden Sie NVIDIA L4-GPUs.
- 11B-Modelle: Verwenden Sie NVIDIA A100-GPUs.
- 90B-Modelle: Verwenden Sie NVIDIA H100-GPUs.
In diesem Beispiel wird die Bereitstellung basierend auf der Modellauswahl konfiguriert:
if "3.2-1B" in base_model_name or "3.2-3B" in base_model_name:
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-8"
    accelerator_count = 1
elif "3.2-11B" in base_model_name:
    accelerator_type = "NVIDIA_TESLA_A100"
    machine_type = "a2-highgpu-1g"
    accelerator_count = 1
elif "3.2-90B" in base_model_name:
    accelerator_type = "NVIDIA_H100_80GB"
    machine_type = "a3-highgpu-8g"
    accelerator_count = 8
else:
    raise ValueError(f"Recommended GPU setting not found for: {base_model_name}.")
Prüfen Sie, ob Sie das erforderliche GPU-Kontingent haben:
common_util.check_quota(
    project_id=PROJECT_ID,
    region=REGION,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    is_for_training=False,
)
Schritt 3: Modell mit vLLM bereitstellen
Die folgende Funktion übernimmt die Bereitstellung des Llama 3.2-Modells auf der Gemini Enterprise Agent Platform. Sie konfiguriert die Umgebung, die Arbeitsspeicherauslastung und die vLLM-Einstellungen des Modells für eine effiziente Bereitstellung.
def deploy_model_vllm(
    model_name: str,
    model_id: str,
    service_account: str,
    base_model_id: str = None,
    machine_type: str = "g2-standard-8",
    accelerator_type: str = "NVIDIA_L4",
    accelerator_count: int = 1,
    gpu_memory_utilization: float = 0.9,
    max_model_len: int = 4096,
    dtype: str = "auto",
    enable_trust_remote_code: bool = False,
    enforce_eager: bool = False,
    enable_lora: bool = False,
    max_loras: int = 1,
    max_cpu_loras: int = 8,
    use_dedicated_endpoint: bool = False,
    max_num_seqs: int = 12,
    model_type: str = None,
) -> Tuple[aiplatform.Model, aiplatform.Endpoint]:
    """Deploys trained models with vLLM into Agent Platform."""
    endpoint = aiplatform.Endpoint.create(
        display_name=f"{model_name}-endpoint",
        dedicated_endpoint_enabled=use_dedicated_endpoint,
    )

    if not base_model_id:
        base_model_id = model_id

    vllm_args = [
        "python",
        "-m",
        "vllm.entrypoints.api_server",
        "--host=0.0.0.0",
        "--port=8080",
        f"--model={model_id}",
        f"--tensor-parallel-size={accelerator_count}",
        "--swap-space=16",
        f"--gpu-memory-utilization={gpu_memory_utilization}",
        f"--max-model-len={max_model_len}",
        f"--dtype={dtype}",
        f"--max-loras={max_loras}",
        f"--max-cpu-loras={max_cpu_loras}",
        f"--max-num-seqs={max_num_seqs}",
        "--disable-log-stats",
    ]

    if enable_trust_remote_code:
        vllm_args.append("--trust-remote-code")
    if enforce_eager:
        vllm_args.append("--enforce-eager")
    if enable_lora:
        vllm_args.append("--enable-lora")
    if model_type:
        vllm_args.append(f"--model-type={model_type}")

    env_vars = {
        "MODEL_ID": base_model_id,
        "DEPLOY_SOURCE": "notebook",
    }

    # HF_TOKEN is not a compulsory field and may not be defined.
    try:
        if HF_TOKEN:
            env_vars["HF_TOKEN"] = HF_TOKEN
    except NameError:
        pass

    model = aiplatform.Model.upload(
        display_name=model_name,
        serving_container_image_uri=VLLM_DOCKER_URI,
        serving_container_args=vllm_args,
        serving_container_ports=[8080],
        serving_container_predict_route="/generate",
        serving_container_health_route="/ping",
        serving_container_environment_variables=env_vars,
        serving_container_shared_memory_size_mb=(16 * 1024),
        serving_container_deployment_timeout=7200,
    )
    print(f"Deploying {model_name} on {machine_type} with {accelerator_count} {accelerator_type} GPU(s).")

    model.deploy(
        endpoint=endpoint,
        machine_type=machine_type,
        accelerator_type=accelerator_type,
        accelerator_count=accelerator_count,
        deploy_request_timeout=1800,
        service_account=service_account,
    )
    print("endpoint_name:", endpoint.name)

    return model, endpoint
Schritt 4: Bereitstellung ausführen
Führen Sie die Bereitstellungsfunktion mit dem konfigurierten Modell und den konfigurierten Einstellungen aus. Die Funktion gibt sowohl die Modell- als auch die Endpunktinstanz zurück, die Sie für die Inferenz verwenden können.
model_name = common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve-vllm")
models["vllm_gpu"], endpoints["vllm_gpu"] = deploy_model_vllm(
    model_name=model_name
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=machine_type,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    gpu_memory_utilization=gpu_memory_utilization,
    max_model_len=max_model_len,
    enforce_eager=True,
    use_dedicated_endpoint=use_dedicated_endpoint,
    max_num_seqs=max_num_seqs,
)
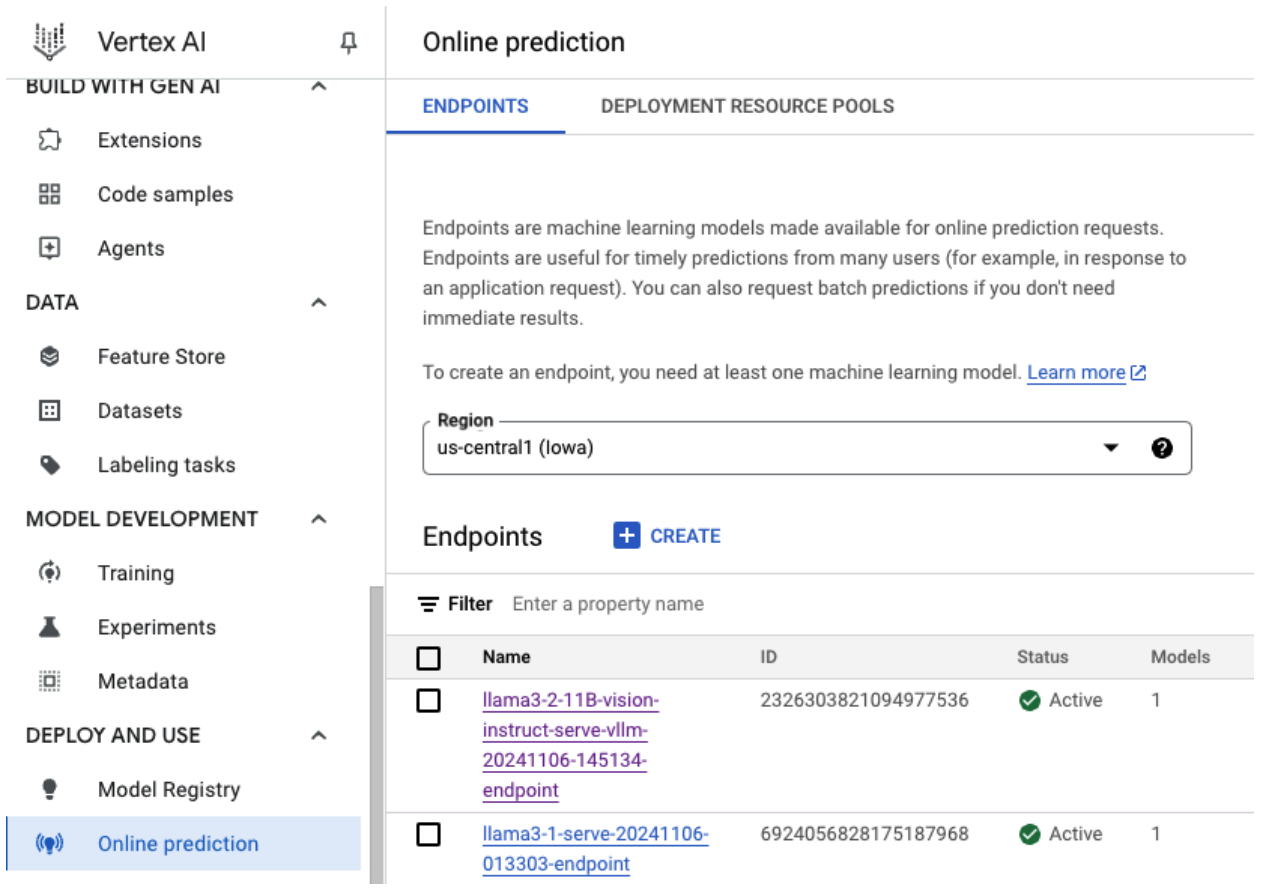 Abbildung 5: Llama 3.2-Bereitstellungsendpunkt im Vertex-Dashboard
Je nach Modellgröße kann die Bereitstellung eines neuen Modells bis zu einer Stunde dauern. Sie können den Fortschritt bei der Onlinevorhersage prüfen.
Inferenz mit vLLM auf der Gemini Enterprise Agent Platform über die Standardvorhersageroute
In diesem Abschnitt wird beschrieben, wie Sie die Inferenz für das Llama 3.2 Vision-Modell auf der Gemini Enterprise Agent Platform mit der Standardvorhersageroute einrichten. Sie verwenden die vLLM-Bibliothek für eine effiziente Bereitstellung und interagieren mit dem Modell, indem Sie einen visuellen Prompt in Kombination mit Text senden.
Stellen Sie zuerst sicher, dass Ihr Modellendpunkt bereitgestellt und für Vorhersagen bereit ist.
Schritt 1: Prompt und Parameter definieren
In diesem Beispiel werden eine Bild-URL und ein Text-Prompt bereitgestellt, die das Modell verarbeitet, um eine Antwort zu generieren.
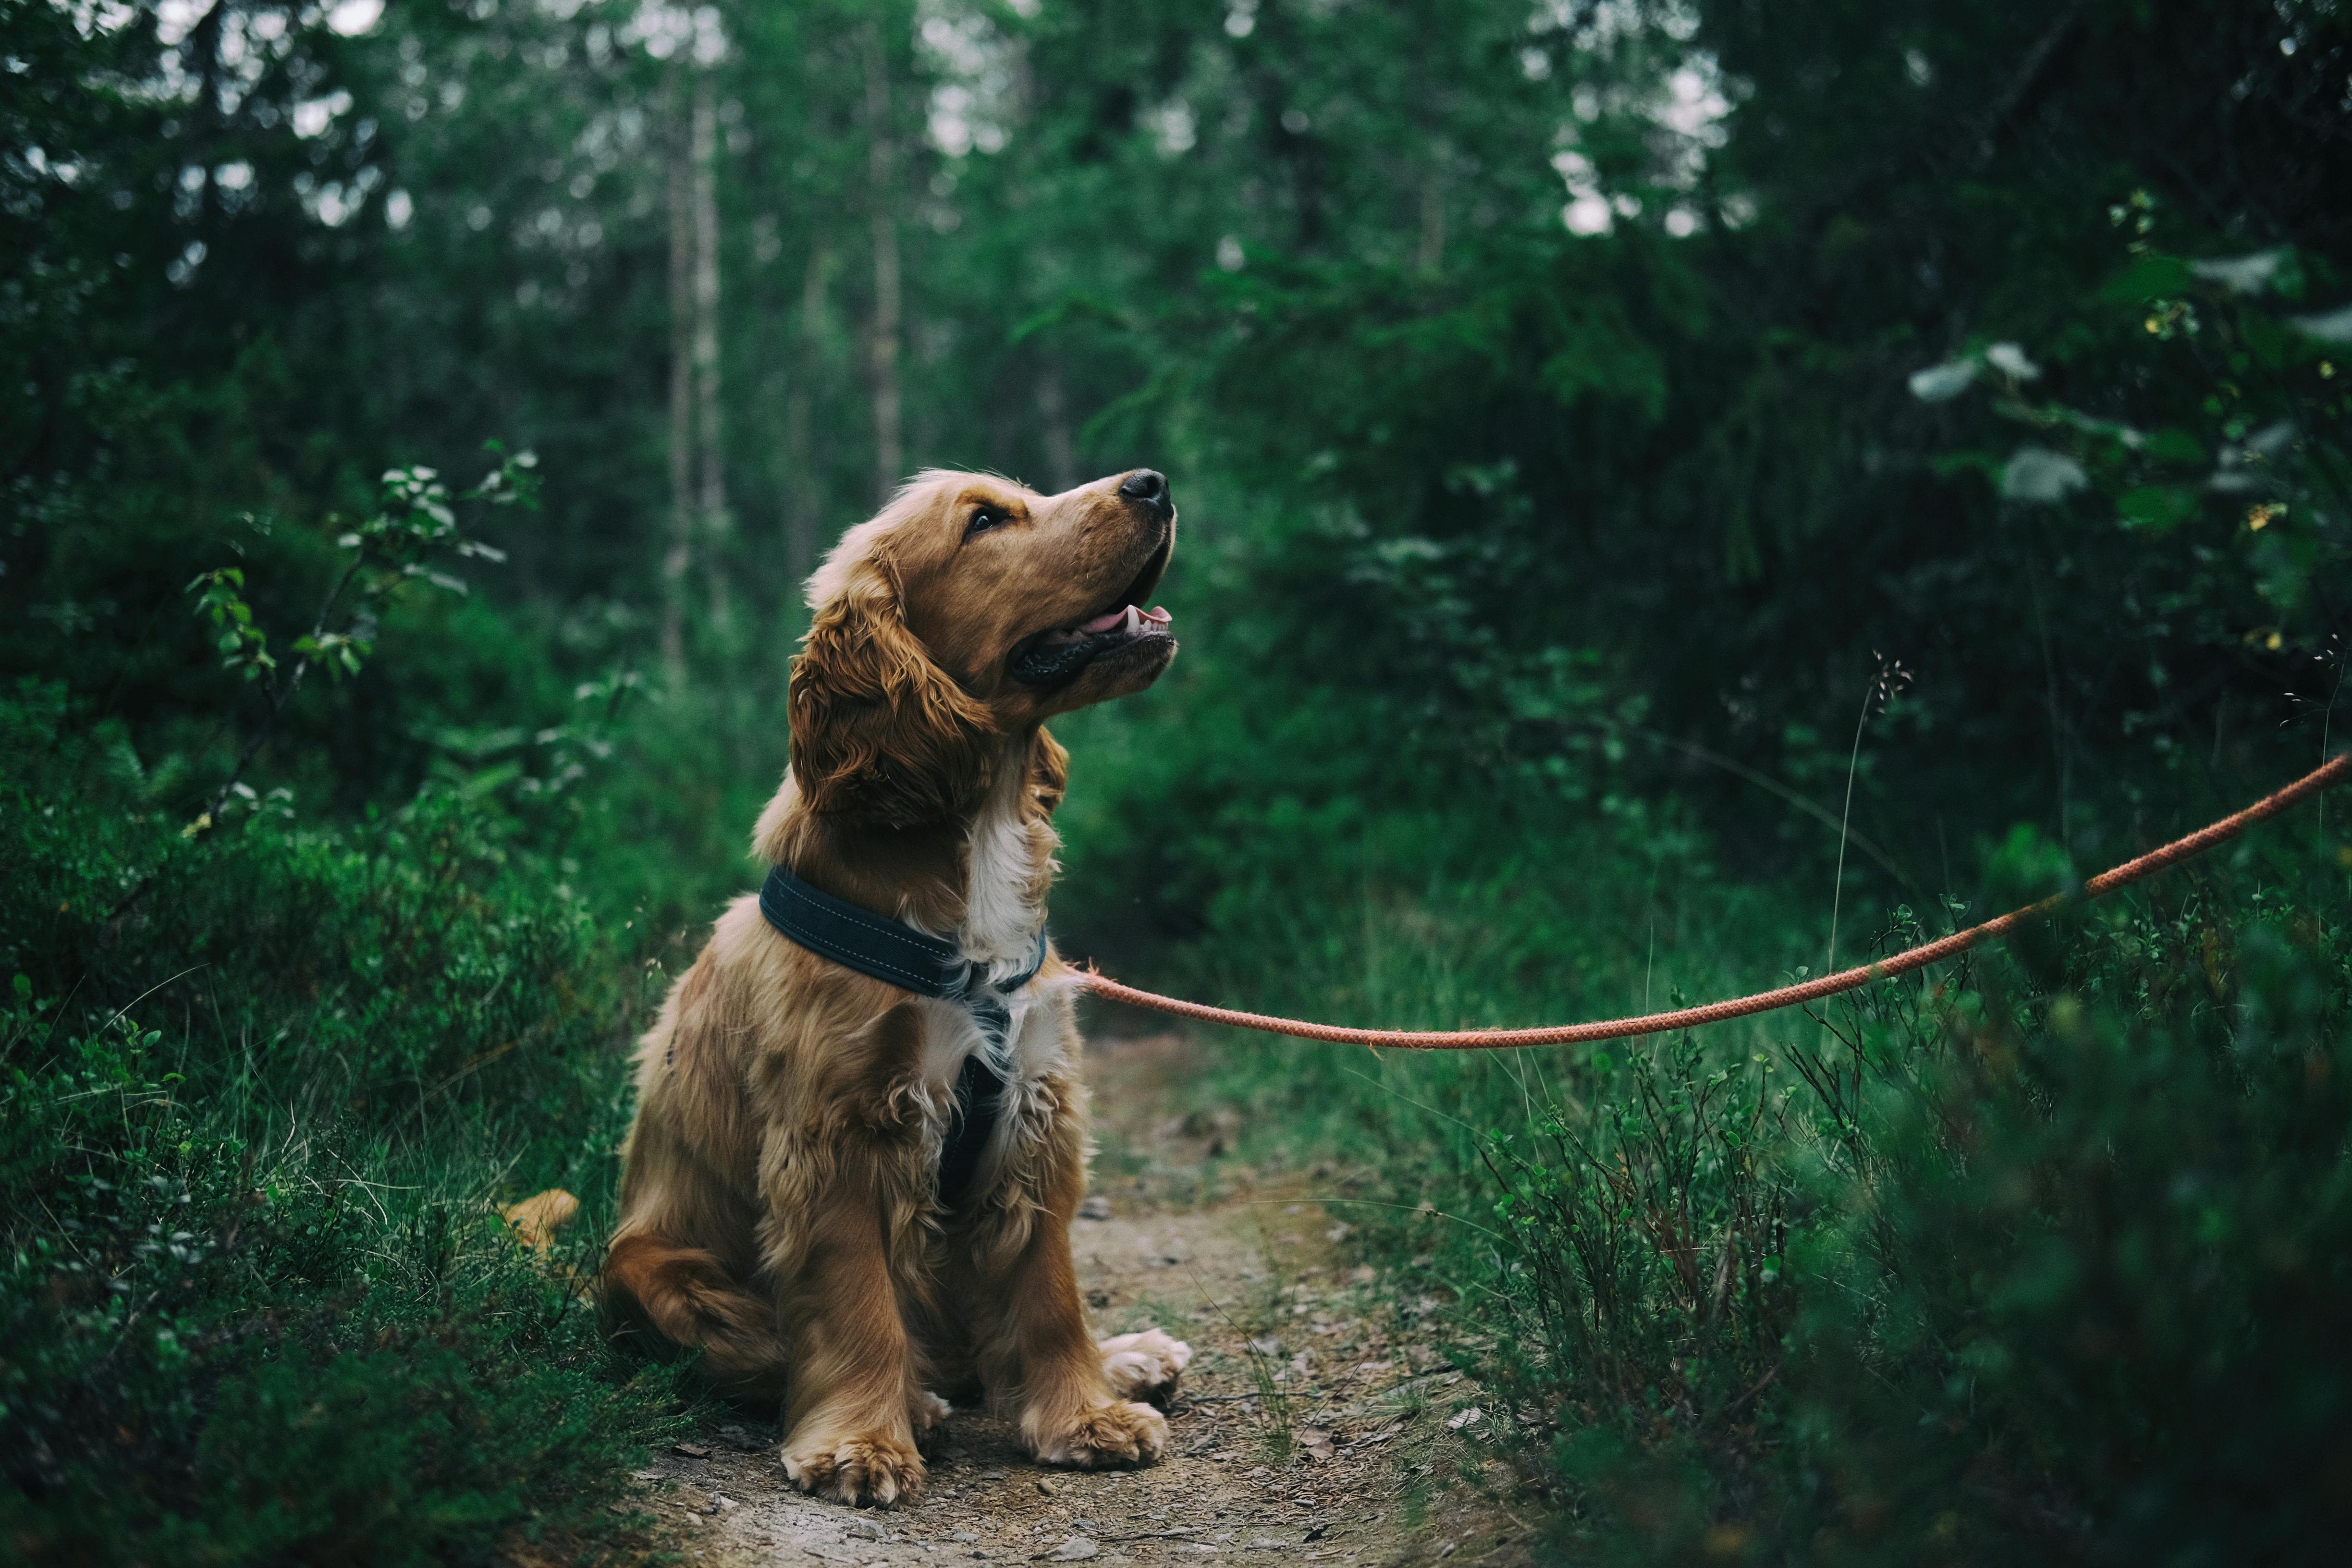 Abbildung 6: Beispielbild für die Eingabe in Llama 3.2
image_url = "https://images.pexels.com/photos/1254140/pexels-photo-1254140.jpeg"

raw_prompt = "This is a picture of"

# Reference prompt formatting guidelines here: https://www.Llama.com/docs/model-cards-and-prompt-formats/Llama3_2/#-base-model-prompt
prompt = f"<|begin_of_text|><|image|>{raw_prompt}"
Schritt 2: Vorhersageparameter konfigurieren
Passen Sie die folgenden Parameter an, um die Antwort des Modells zu steuern:
max_tokens = 64

temperature = 0.5

top_p = 0.95
Schritt 3: Vorhersageanfrage vorbereiten
Richten Sie die Vorhersageanfrage mit der Bild-URL, dem Prompt und anderen Parametern ein.
instances = [
    {
        "prompt": prompt,
        "multi_modal_data": {"image": image_url},
        "max_tokens": max_tokens,
        "temperature": temperature,
        "top_p": top_p,
    },
]
Schritt 4: Vorhersage treffen
Senden Sie die Anfrage an den Endpunkt Ihrer Gemini Enterprise Agent Platform und verarbeiten Sie die Antwort:
response = endpoints["vllm_gpu"].predict(instances=instances)

for raw_prediction in response.predictions:
    prediction = raw_prediction.split("Output:")
    print(prediction[1])
Wenn ein Zeitüberschreitungsproblem auftritt (z. B. ServiceUnavailable: 503 Took too
long to respond when processing), versuchen Sie, den Wert max_tokens auf eine niedrigere Zahl wie 20 zu reduzieren, um die Antwortzeit zu verkürzen.
Inferenz mit vLLM auf der Gemini Enterprise Agent Platform mithilfe von OpenAI Chat Completion
In diesem Abschnitt wird beschrieben, wie Sie mit der OpenAI Chat Completions API auf der Gemini Enterprise Agent Platform Inferenzen für Llama 3.2 Vision-Modelle ausführen. Mit diesem Ansatz können Sie multimodale Funktionen nutzen, indem Sie sowohl Bilder als auch Text-Prompts an das Modell senden, um interaktivere Antworten zu erhalten.
Schritt 1: Bereitstellung des Llama 3.2 Vision Instruct-Modells ausführen
Führen Sie die Bereitstellungsfunktion mit dem konfigurierten Modell und den konfigurierten Einstellungen aus. Die Funktion gibt sowohl die Modell- als auch die Endpunktinstanz zurück, die Sie für die Inferenz verwenden können.
base_model_name = "Llama-3.2-11B-Vision-Instruct"
hf_model_id = f"meta-llama/{base_model_name}"
model_name = common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve-vllm")
model, endpoint = deploy_model_vllm(
    model_name=model_name
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type="a2-highgpu-1g",
    accelerator_type="NVIDIA_TESLA_A100",
    accelerator_count=1,
    gpu_memory_utilization=0.9,
    max_model_len=4096,
    enforce_eager=True,
    max_num_seqs=12,
)
Schritt 2: Endpunktressource konfigurieren
Richten Sie zuerst den Ressourcennamen des Endpunkts für Ihre Gemini Enterprise Agent Platform-Bereitstellung ein.
ENDPOINT_RESOURCE_NAME = "projects/{}/locations/{}/endpoints/{}".format(
    PROJECT_ID, REGION, endpoint.name
)
Schritt 3: OpenAI SDK und Authentifizierungsbibliotheken installieren
Wenn Sie Anfragen mit dem OpenAI SDK senden möchten, müssen die erforderlichen Bibliotheken installiert sein:
!pip install -qU openai google-auth requests
Schritt 4: Eingabeparameter für die Chatvervollständigung definieren
Richten Sie die Bild-URL und den Text-Prompt ein, die an das Modell gesendet werden sollen. Passen Sie max_tokens und temperature an, um die Länge und Zufälligkeit der Antwort zu steuern.
user_image = "https://images.freeimages.com/images/large-previews/ab3/puppy-2-1404644.jpg"
user_message = "Describe this image?"
max_tokens = 50
temperature = 1.0
Schritt 5: Authentifizierung und Basis-URL einrichten
Rufen Sie Ihre Anmeldedaten ab und legen Sie die Basis-URL für API-Anfragen fest.
import google.auth
import openai

creds, project = google.auth.default()
auth_req = google.auth.transport.requests.Request()
creds.refresh(auth_req)

BASE_URL = (
    f"https://{REGION}-aiplatform.googleapis.com/v1beta1/{ENDPOINT_RESOURCE_NAME}"
)
try:
    if use_dedicated_endpoint:
        BASE_URL = f"https://{DEDICATED_ENDPOINT_DNS}/v1beta1/{ENDPOINT_RESOURCE_NAME}"
except NameError:
    pass
Schritt 6: Chat-Vervollständigungsanfrage senden
Senden Sie das Bild und den Text-Prompt mit der Chat Completions API von OpenAI an Ihren Gemini Enterprise Agent Platform-Endpunkt:
client = openai.OpenAI(base_url=BASE_URL, api_key=creds.token)

model_response = client.chat.completions.create(
    model="",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "image_url", "image_url": {"url": user_image}},
                {"type": "text", "text": user_message},
            ],
        }
    ],
    temperature=temperature,
    max_tokens=max_tokens,
)

print(model_response)
Schritt 7 (optional): Verbindung zu einem vorhandenen Endpunkt wiederherstellen
Verwenden Sie die Endpunkt-ID, um die Verbindung zu einem zuvor erstellten Endpunkt wiederherzustellen. Dieser Schritt ist nützlich, wenn Sie einen Endpunkt wiederverwenden möchten, anstatt einen neuen zu erstellen.
endpoint_name = ""
aip_endpoint_name = (
     f"projects/{PROJECT_ID}/locations/{REGION}/endpoints/{endpoint_name}"
)
endpoint = aiplatform.Endpoint(aip_endpoint_name)
Diese Einrichtung bietet die Flexibilität, nach Bedarf zwischen neu erstellten und vorhandenen Endpunkten zu wechseln, was optimierte Tests und Bereitstellungen ermöglicht.
Bereinigen
Um laufende Kosten zu vermeiden und Ressourcen freizugeben, sollten Sie die bereitgestellten Modelle, Endpunkte und optional den für diesen Test verwendeten Storage-Bucket löschen.
Schritt 1: Endpunkte und Modelle löschen
Mit dem folgenden Code wird die Bereitstellung der einzelnen Modelle aufgehoben und die zugehörigen Endpunkte werden gelöscht:
# Undeploy model and delete endpoint
for endpoint in endpoints.values():
    endpoint.delete(force=True)

# Delete models
for model in models.values():
    model.delete()
Schritt 2: Cloud Storage-Bucket löschen (optional)
Wenn Sie einen Cloud Storage-Bucket speziell für dieses Experiment erstellt haben, können Sie ihn löschen, indem Sie „delete_bucket“ auf „True“ setzen. Dieser Schritt ist optional, wird aber empfohlen, wenn der Bucket nicht mehr benötigt wird.
delete_bucket = False
if delete_bucket:
    ! gsutil -m rm -r $BUCKET_NAME
Wenn Sie diese Schritte ausführen, werden alle in dieser Anleitung verwendeten Ressourcen bereinigt und unnötige Kosten im Zusammenhang mit dem Experiment vermieden.
Häufige Probleme beheben
In diesem Abschnitt finden Sie Informationen zum Identifizieren und Beheben häufiger Probleme, die bei der Bereitstellung und Inferenz von vLLM-Modellen auf der Gemini Enterprise Agent Platform auftreten können.
Log prüfen
Prüfen Sie die Logs, um die Ursache von Bereitstellungsfehlern oder unerwartetem Verhalten zu ermitteln:
- Zur Gemini Enterprise Agent Platform Prediction Console wechseln: Rufen Sie in der Google Cloud Console die Gemini Enterprise Agent Platform Prediction Console auf.
- Endpunkt auswählen: Klicken Sie auf den Endpunkt, bei dem Probleme auftreten. Der Status sollte angeben, ob die Bereitstellung fehlgeschlagen ist.
- Logs ansehen: Klicken Sie auf den Endpunkt und rufen Sie dann den Tab Logs auf oder klicken Sie auf Logs ansehen. Sie werden zu Cloud Logging weitergeleitet. Dort werden die Logs für diesen Endpunkt und diese Modellbereitstellung angezeigt. Sie können auch direkt über den Cloud Logging-Dienst auf Logs zugreifen.
- Logs analysieren: Prüfen Sie die Logeinträge auf Fehlermeldungen, Warnungen und andere relevante Informationen. Zeitstempel ansehen, um Logeinträge mit bestimmten Aktionen zu korrelieren. Suchen Sie nach Problemen im Zusammenhang mit Ressourcenbeschränkungen (Arbeitsspeicher und CPU), Authentifizierungsproblemen oder Konfigurationsfehlern.
Häufiges Problem 1: CUDA-Fehler „Out of Memory“ (OOM) während der Bereitstellung
CUDA-Fehler aufgrund fehlenden Speichers (OOM) treten auf, wenn die Speichernutzung des Modells die verfügbare GPU-Kapazität überschreitet.
Für das reine Textmodell haben wir die folgenden Engine-Argumente verwendet:
base_model_name = "Meta-Llama-3.1-8B"
hf_model_id = f"meta-llama/{base_model_name}"
accelerator_type = "NVIDIA_L4"
accelerator_count = 1
machine_type = "g2-standard-12"
accelerator_count: int = 1
gpu_memory_utilization = 0.9
max_model_len = 4096
dtype = "auto"
max_num_seqs = 256
Für das multimodale Modell haben wir die folgenden Engine-Argumente verwendet:
base_model_name = "Llama-3.2-11B-Vision-Instruct"
hf_model_id = f"meta-llama/{base_model_name}"
accelerator_type = "NVIDIA_L4"
accelerator_count = 1
machine_type = "g2-standard-12"
accelerator_count: int = 1
gpu_memory_utilization = 0.9
max_model_len = 4096
dtype = "auto"
max_num_seqs = 12
Wenn Sie das multimodale Modell mit max_num_seqs = 256 bereitstellen, wie wir es beim reinen Textmodell getan haben, kann der folgende Fehler auftreten:
[rank0]: torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 3.91 GiB. GPU 0 has a total capacity of 39.38 GiB of which 3.76 GiB is free. Including non-PyTorch memory, this process has 0 bytes memory in use. Of the allocated memory 34.94 GiB is allocated by PyTorch, and 175.15 MiB is reserved by PyTorch but unallocated. If reserved but unallocated memory is large try setting PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True to avoid fragmentation. See documentation for Memory Management (https://pytorch.org/docs/stable/notes/cuda.html#environment-variables)
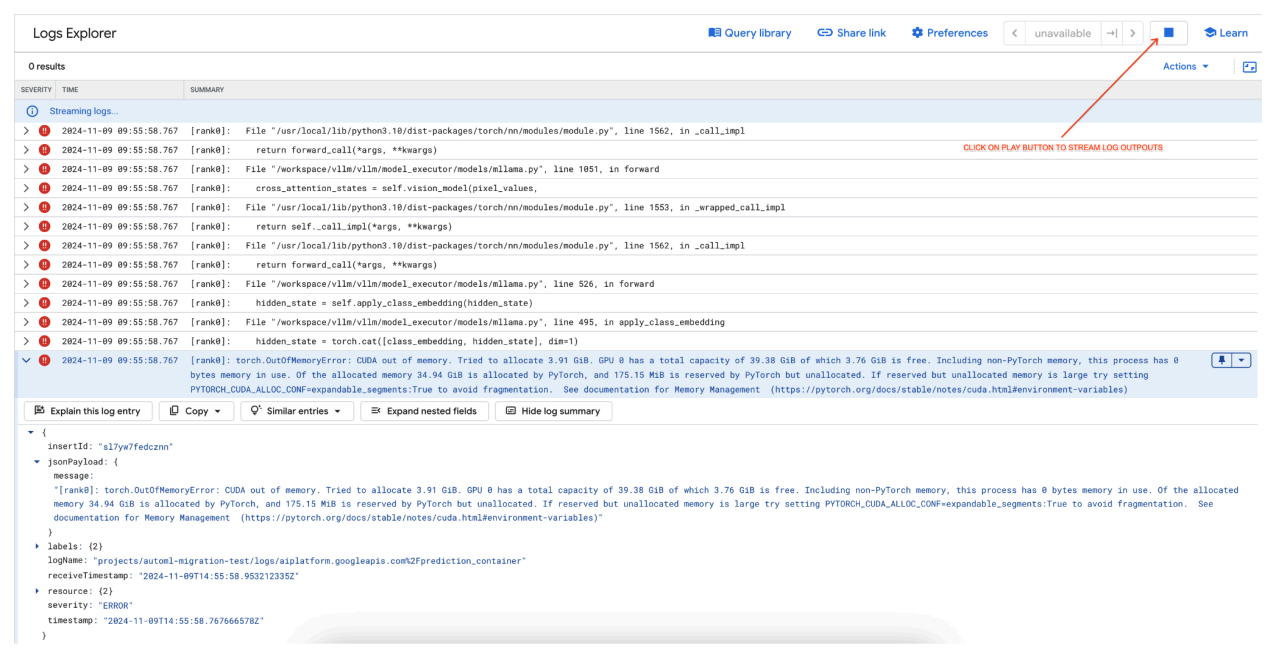 Abbildung 7: GPU-Fehlerprotokoll für Out of Memory (OOM)
max_num_seqs und GPU-Arbeitsspeicher:
- Der Parameter
max_num_seqsdefiniert die maximale Anzahl gleichzeitiger Anfragen, die das Modell verarbeiten kann. - Jede vom Modell verarbeitete Sequenz belegt GPU-Arbeitsspeicher. Die Gesamtarbeitsspeichernutzung ist proportional zu
max_num_seqsmal dem Arbeitsspeicher pro Sequenz. - Nur-Text-Modelle (wie Meta-Llama-3.1-8B) verbrauchen in der Regel weniger Arbeitsspeicher pro Sequenz als multimodale Modelle (wie Llama-3.2-11B-Vision-Instruct), die sowohl Text als auch Bilder verarbeiten.
Prüfen Sie das Fehlerprotokoll (Abbildung 8):
- Im Protokoll wird ein
torch.OutOfMemoryErrorangezeigt, wenn versucht wird, Arbeitsspeicher auf der GPU zuzuweisen. - Der Fehler tritt auf, weil die Speichernutzung des Modells die verfügbare GPU-Kapazität überschreitet. Die NVIDIA L4-GPU hat 24 GB. Wenn der Parameter
max_num_seqsfür das multimodale Modell zu hoch eingestellt ist, kommt es zu einem Überlauf. - Im Log wird vorgeschlagen,
PYTORCH_CUDA_ALLOC_CONF=expandable_segments:Truefestzulegen, um die Speicherverwaltung zu verbessern. Das Hauptproblem ist hier jedoch die hohe Speichernutzung.
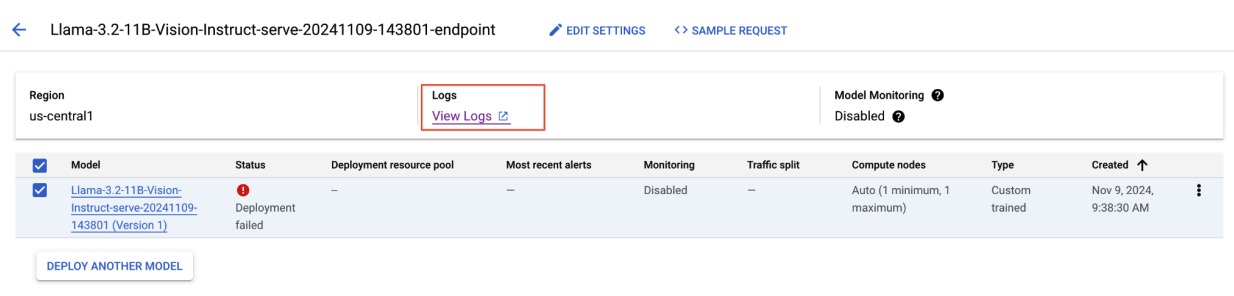 Abbildung 8: Fehlgeschlagene Llama 3.2-Bereitstellung
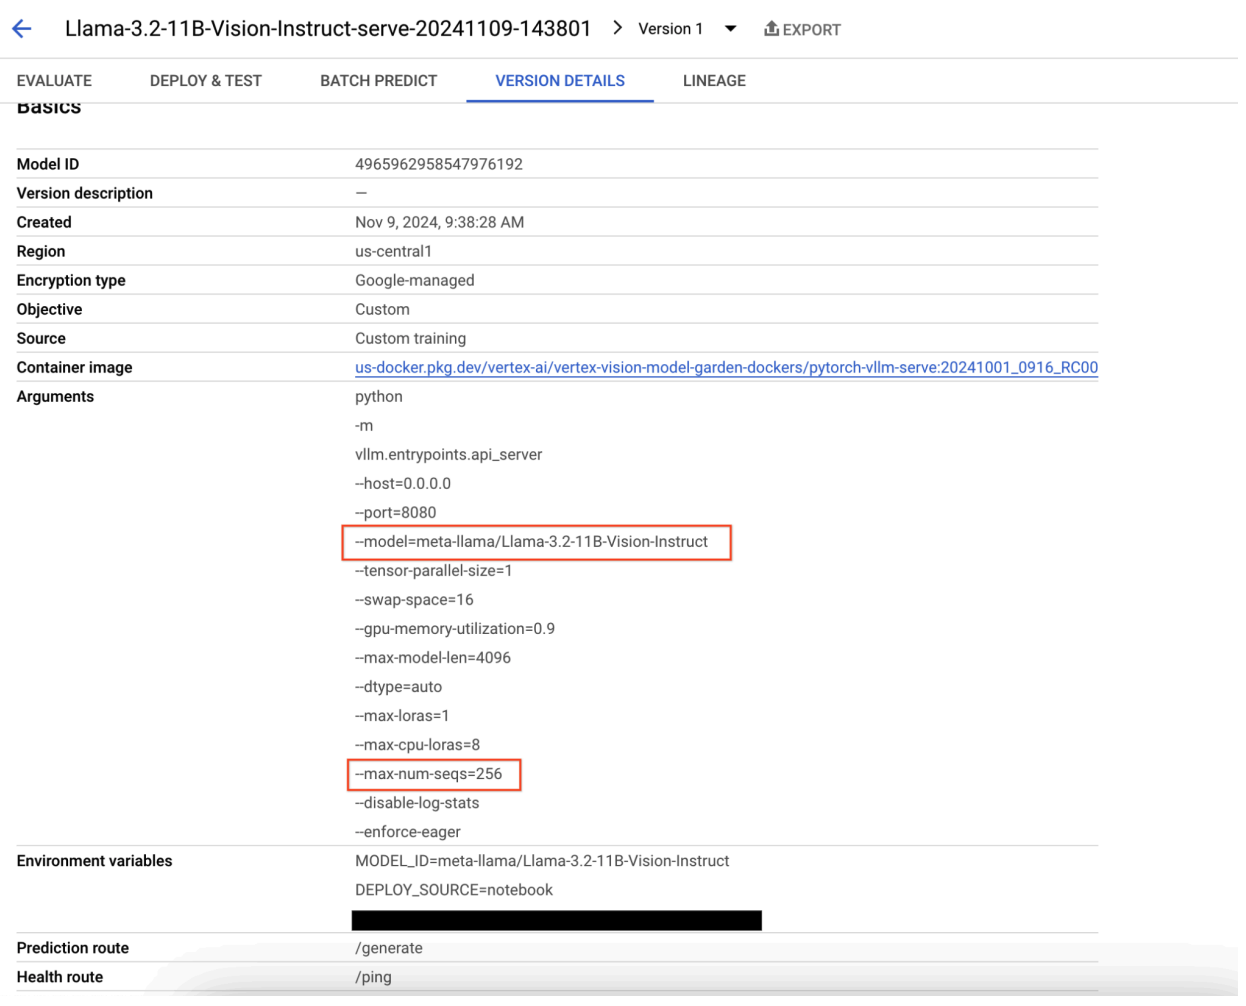 Abbildung 9: Bereich „Model Version Details“
Rufen Sie die Gemini Enterprise Agent Platform Prediction Console auf und klicken Sie auf den Endpunkt, um dieses Problem zu beheben. Der Status sollte anzeigen, dass die Bereitstellung fehlgeschlagen ist. Klicken Sie, um die Logs aufzurufen. Prüfen Sie, ob max-num-seqs = 256 ist. Dieser Wert ist für Llama-3.2-11B-Vision-Instruct zu hoch. Ein angemessenerer Wert wäre 12.
Häufiges Problem 2: Hugging Face-Token erforderlich
Hugging Face-Tokenfehler treten auf, wenn das Modell eingeschränkt ist und für den Zugriff die richtigen Authentifizierungsdaten erforderlich sind.
Der folgende Screenshot zeigt einen Logeintrag im Log-Explorer von Google Cloudmit einer Fehlermeldung im Zusammenhang mit dem Zugriff auf das auf Hugging Face gehostete Meta LLaMA-3.2-11B-Vision-Modell. Der Fehler weist darauf hin, dass der Zugriff auf das Modell eingeschränkt ist und eine Authentifizierung erforderlich ist, um fortzufahren. In der Nachricht heißt es ausdrücklich: „Cannot access gated repository for URL“ (Auf das Gated Repository für die URL kann nicht zugegriffen werden). Das bedeutet, dass das Modell gated ist und für den Zugriff die richtigen Authentifizierungsdaten erforderlich sind. Dieser Logeintrag kann bei der Behebung von Authentifizierungsproblemen helfen, wenn Sie mit eingeschränkten Ressourcen in externen Repositories arbeiten.
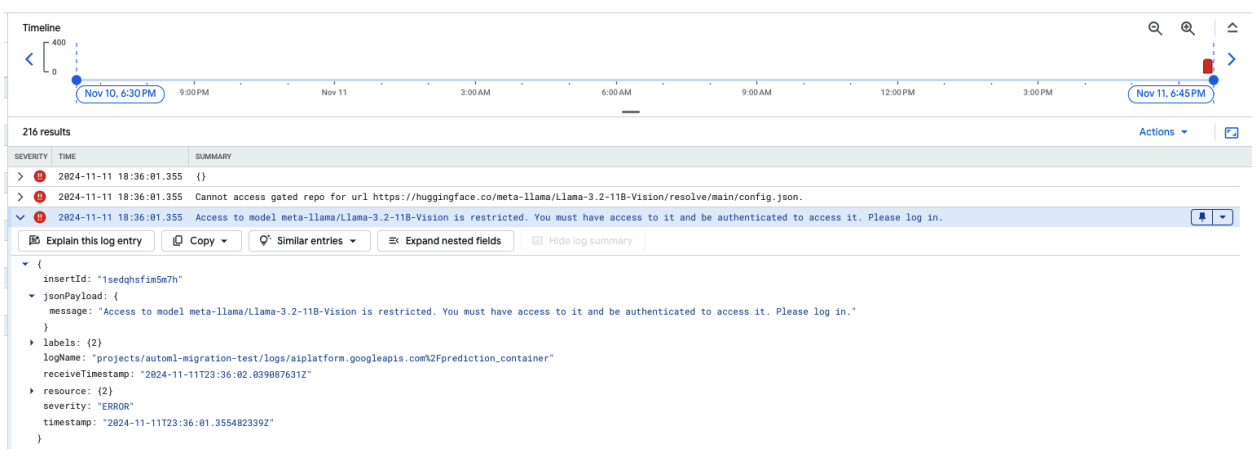 Abbildung 10: Hugging Face-Tokenfehler
Prüfen Sie zur Behebung dieses Problems die Berechtigungen Ihres Hugging Face-Zugriffstokens. Kopieren Sie das neueste Token und stellen Sie einen neuen Endpunkt bereit.
Häufiges Problem 3: Chatvorlage erforderlich
Chatvorlagenfehler treten auf, wenn die Standard-Chatvorlage nicht mehr zulässig ist. Wenn der Tokenizer keine benutzerdefinierte Chatvorlage definiert, muss eine angegeben werden.
Dieser Screenshot zeigt einen Logeintrag im Log-Explorer von Google Cloud, in dem ein ValueError aufgrund einer fehlenden Chatvorlage in der Transformers-Bibliothek, Version 4.44, auftritt. Die Fehlermeldung weist darauf hin, dass die Standard-Chatvorlage nicht mehr zulässig ist und eine benutzerdefinierte Chatvorlage bereitgestellt werden muss, wenn der Tokenizer keine definiert. Dieser Fehler weist auf eine kürzlich vorgenommene Änderung in der Bibliothek hin, die eine explizite Definition einer Chatvorlage erfordert. Dies ist nützlich, um Probleme beim Bereitstellen von chatbasierten Anwendungen zu beheben.
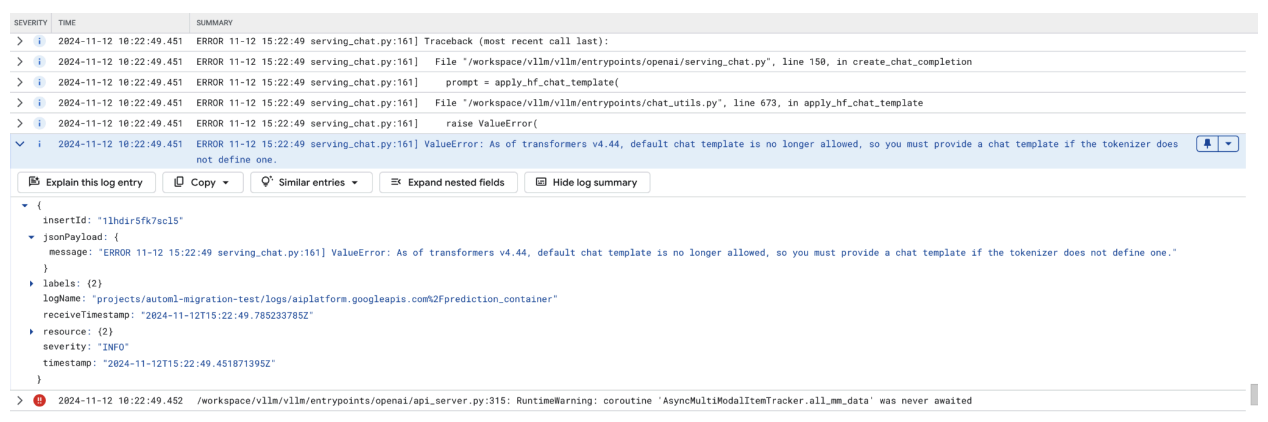 Abbildung 11: Chatvorlage erforderlich
Um dies zu umgehen, müssen Sie bei der Bereitstellung eine Chatvorlage mit dem Eingabeargument --chat-template angeben. Beispielvorlagen finden Sie im vLLM-Beispiel-Repository.
Häufiges Problem 4: Maximale Sequenzlänge des Modells
Fehler bei der maximalen Sequenzlänge des Modells treten auf, wenn die maximale Sequenzlänge des Modells (4096) größer ist als die maximale Anzahl von Tokens, die im KV-Cache gespeichert werden können (2256).
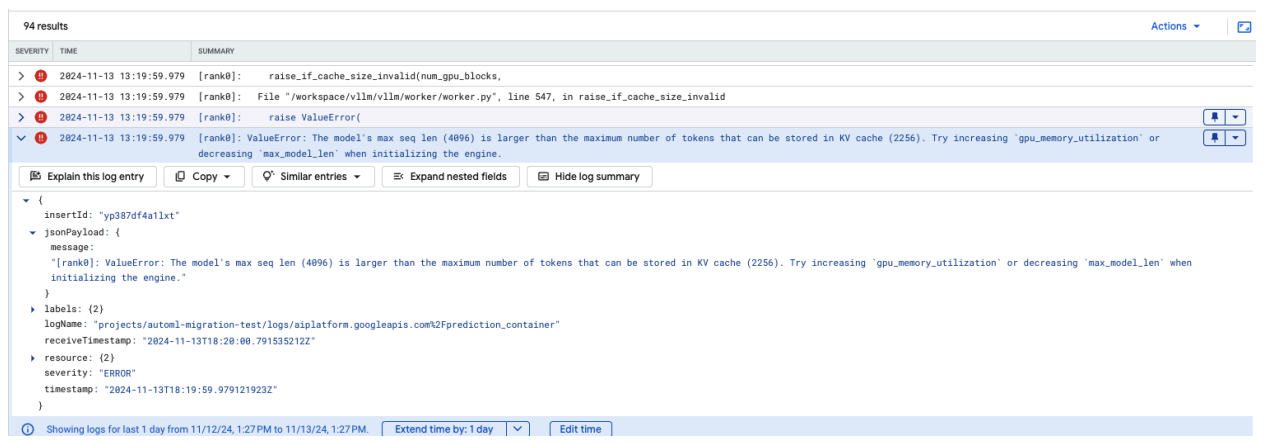 Abbildung 12: Max Seq Length zu groß
ValueError: Die maximale Sequenzlänge des Modells (4096) ist größer als die maximale Anzahl von Tokens, die im KV-Cache gespeichert werden können (2256). Versuchen Sie, beim Initialisieren der Engine gpu_memory_utilization zu erhöhen oder max_model_len zu verringern.
Legen Sie „max_model_len“ auf 2048 fest, was kleiner als 2256 ist, um dieses Problem zu beheben. Eine weitere Lösung für dieses Problem ist die Verwendung von mehr oder größeren GPUs. Wenn Sie mehr GPUs verwenden möchten, muss „tensor-parallel-size“ entsprechend festgelegt werden.
Versionshinweise zu Model Garden-vLLM-Containern
Hauptveröffentlichungen
Standard-vLLM
Veröffentlichungsdatum |
Architektur |
vLLM-Version |
Container-URI |
|---|---|---|---|
| 17. Juli 2025 | ARM |
v0.9.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250717_0916_arm_RC01 |
| 10. Juli 2025 | x86 |
v0.9.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250710_0916_RC01 |
| 20. Juni 2025 | x86 |
Nach v0.9.1, Commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250620_0916_RC01 |
| 11. Juni 2025 | x86 |
v0.9.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250611_0916_RC01 |
| 2. Juni 2025 | x86 |
v0.9.0 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250601_0916_RC01 |
| 6. Mai 2025 | x86 |
v0.8.5.post1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250506_0916_RC01 |
| 29. April 2025 | x86 |
v0.8.4 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250429_0916_RC01, 20250430_0916_RC00_maas |
| 17. April 2025 | x86 |
v0.8.4 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250417_0916_RC01 |
| 10. April 2025 | x86 |
Nach v0.8.3, Commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250410_0917_RC01 |
| 7. April 2025 | x86 |
v0.8.3 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250407_0917_RC01, 20250407_0917_RC0120250429_0916_RC00_maas |
| 7. April 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250404_0916_RC01 |
| 5. April 2025 | x86 |
Nach v0.8.2, Commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250405_1205_RC01 |
| 31. März 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250401_0916_RC01 |
| 26. März 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250327_0916_RC01 |
| 23. März 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250324_0916_RC01 |
| 21. März 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250321_0916_RC01 |
| 11. März 2025 | x86 |
Nach v0.7.3, Commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250312_0916_RC01 |
| 3. März 2025 | x86 |
v0.7.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250304_0916_RC01 |
| 14. Januar 2025 | x86 |
v0.6.4.post1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250114_0916_RC00_maas |
| 2. Dezember 2024 | x86 |
v0.6.4.post1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241202_0916_RC00_maas |
| 12. November 2024 | x86 |
v0.6.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241112_0916_RC00_maas |
| 16. Oktober 2024 | x86 |
v0.6.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241016_0916_RC00_maas |
Optimiertes vLLM
Veröffentlichungsdatum |
Architektur |
Container-URI |
|---|---|---|
| 21. Januar 2025 | x86 |
us-docker.pkg.dev/vertex-ai-restricted/vertex-vision-model-garden-dockers/pytorch-vllm-optimized-serve:20250121_0835_RC00 |
| 29. Okt. 2024 | x86 |
us-docker.pkg.dev/vertex-ai-restricted/vertex-vision-model-garden-dockers/pytorch-vllm-optimized-serve:20241029_0835_RC00 |
Weitere Veröffentlichungen
Die vollständige Liste der VMG-Standard-vLLM-Container-Releases finden Sie auf der Artifact Registry-Seite.
Releases für vLLM-TPU im experimentellen Status sind mit <yyyymmdd_hhmm_tpu_experimental_RC00> gekennzeichnet.