


In diesem Dokument wird beschrieben, wie Sie einen freigegebenen Kubernetes-Cluster in einer GDC-Zone (Google Distributed Cloud) mit Air Gap erstellen. Ein freigegebener Cluster erstreckt sich über mehrere Projekte und umfasst umfassende von GDC verwaltete Dienste, die eine stark vordefinierte Kubernetes-Clusterkonfiguration bieten, die weniger konfigurierbar ist als der Standardcluster. Weitere Informationen zu Standardclustern finden Sie unter Kubernetes-Clusterkonfigurationen.
Freigegebene Cluster sind eine zonale Ressource und können nicht mehrere Zonen umfassen. Wenn Sie Cluster in einem Multi-Zonen-Universum betreiben möchten, müssen Sie Cluster in jeder Zone manuell erstellen.
Dieses Dokument richtet sich an Zielgruppen wie Anwendungsentwickler in der Gruppe der Anwendungsoperatoren, die für die Verwaltung von Containerarbeitslasten in ihrer Organisation verantwortlich sind. Weitere Informationen finden Sie unter Dokumentation zu Zielgruppen für GDC mit Air Gap.
Hinweis
Bitten Sie den IAM-Administrator Ihrer Organisation, Ihnen die Rolle „User Cluster Admin“ (
user-cluster-admin) zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Erstellen eines freigegebenen Clusters benötigen. Diese Rolle ist nicht an einen Namespace gebunden.Wenn Sie die API oder Terraform zum Erstellen eines freigegebenen Clusters verwenden möchten, generieren Sie die kubeconfig-Datei des zonalen API-Servers, um Ihren Cluster zu hosten. Legen Sie die Umgebungsvariable
MANAGEMENT_API_SERVERauf den kubeconfig-Pfad fest. Weitere Informationen finden Sie unter Zonale API-Serverressourcen für die Verwaltung.Prüfen Sie die Clusterlimits auf Ressourcenaspekte.
Pod-CIDR-Block planen
Wenn Sie den Pod-CIDR-Block in der richtigen Größe für Ihre Arbeitslasten zuweisen möchten, müssen Sie die Anzahl der IP-Adressen berechnen, die für Ihren Kubernetes-Cluster erforderlich sind, bevor Sie ihn erstellen. Die meisten Netzwerkparameter können nach dem Erstellen des Clusters nicht mehr geändert werden.
Ein Kubernetes-Cluster folgt bei der Zuweisung von IP-Adressen der folgenden Logik:
- Kubernetes weist jedem Knoten einen
/24-CIDR-Block mit 256 Adressen zu. Diese Anzahl entspricht dem standardmäßigen Maximum von 110 Pods pro Knoten für Kubernetes-Cluster. - Die Größe des CIDR-Blocks, der einem Knoten zugewiesen wird, hängt von der maximalen Anzahl von Pods pro Knoten ab.
- Der Block enthält immer mindestens doppelt so viele Adressen wie die maximale Anzahl von Pods pro Knoten.
Im folgenden Beispiel wird gezeigt, wie der Standardwert von Maskengröße pro Knoten= /24 berechnet wurde, um 110 Pods aufzunehmen:
Maximum pods per node = 110
Total number of IP addresses required = 2 * 110 = 220

Per node mask size = /24
Number of IP addresses in a /24 = 2(32 - 24) = 256
Bestimmen Sie die erforderliche Pod-CIDR-Maske, die für den Kubernetes-Cluster konfiguriert werden soll, basierend auf der erforderlichen Anzahl von Knoten. Planen Sie beim Konfigurieren des CIDR-Bereichs zukünftige Knotenergänzungen für den Cluster ein:
Total number of nodes supported = 2(Per node mask size - pod CIDR mask)
Da die Standard-Maskengröße pro Knoten= /24 ist , finden Sie in der folgenden Tabelle die Zuordnung der Pod-CIDR-Maske zur Anzahl der unterstützten Knoten.
| Pod-CIDR-Maske | Berechnung: 2(Maskengröße pro Knoten – CIDR-Maske) | Maximale Anzahl unterstützter Knoten, einschließlich Knoten der Steuerungsebene |
|---|---|---|
| /21 | 2(24 - 21) | 8 |
| /20 | 2(24-20) | 16 |
| /19 | 2(24 - 19) | 32 |
| /18 | 2(24 - 18) | 64 |
Nachdem Sie den Pod-CIDR-Block für Ihren Kubernetes-Cluster berechnet haben, konfigurieren Sie ihn im nächsten Abschnitt im Rahmen des Workflows zur Clustererstellung.
Freigegebenen Cluster erstellen
Führen Sie die folgenden Schritte aus, um einen freigegebenen Kubernetes-Cluster zu erstellen:
Console
Wählen Sie in der Projektauswahl Ihre Organisation aus.
Freigegebene Cluster sind organisationsbezogene Ressourcen. Wenn Sie stattdessen ein Projekt auswählen, erstellen Sie einen Standardcluster, der auf das Projekt beschränkt ist. Weitere Informationen finden Sie unter Ressourcenhierarchie.
Wählen Sie im Navigationsmenü Kubernetes Engine > Cluster aus.
Klicken Sie auf Cluster erstellen.
Geben Sie im Feld Name einen Namen für den Cluster ein.
Wählen Sie die Kubernetes-Version für den Cluster aus.
Wählen Sie die Zone aus, in der der Cluster erstellt werden soll.
Klicken Sie auf Projekt anhängen und wählen Sie ein vorhandenes Projekt aus, das Sie an Ihren Cluster anhängen möchten. Klicken Sie dann auf Speichern. Sie können Projekte nach dem Erstellen des Clusters auf der Projekt-Detailseite anhängen oder trennen. Sie müssen ein Projekt an Ihren Cluster anhängen, bevor Sie Containerarbeitslasten darin bereitstellen können.
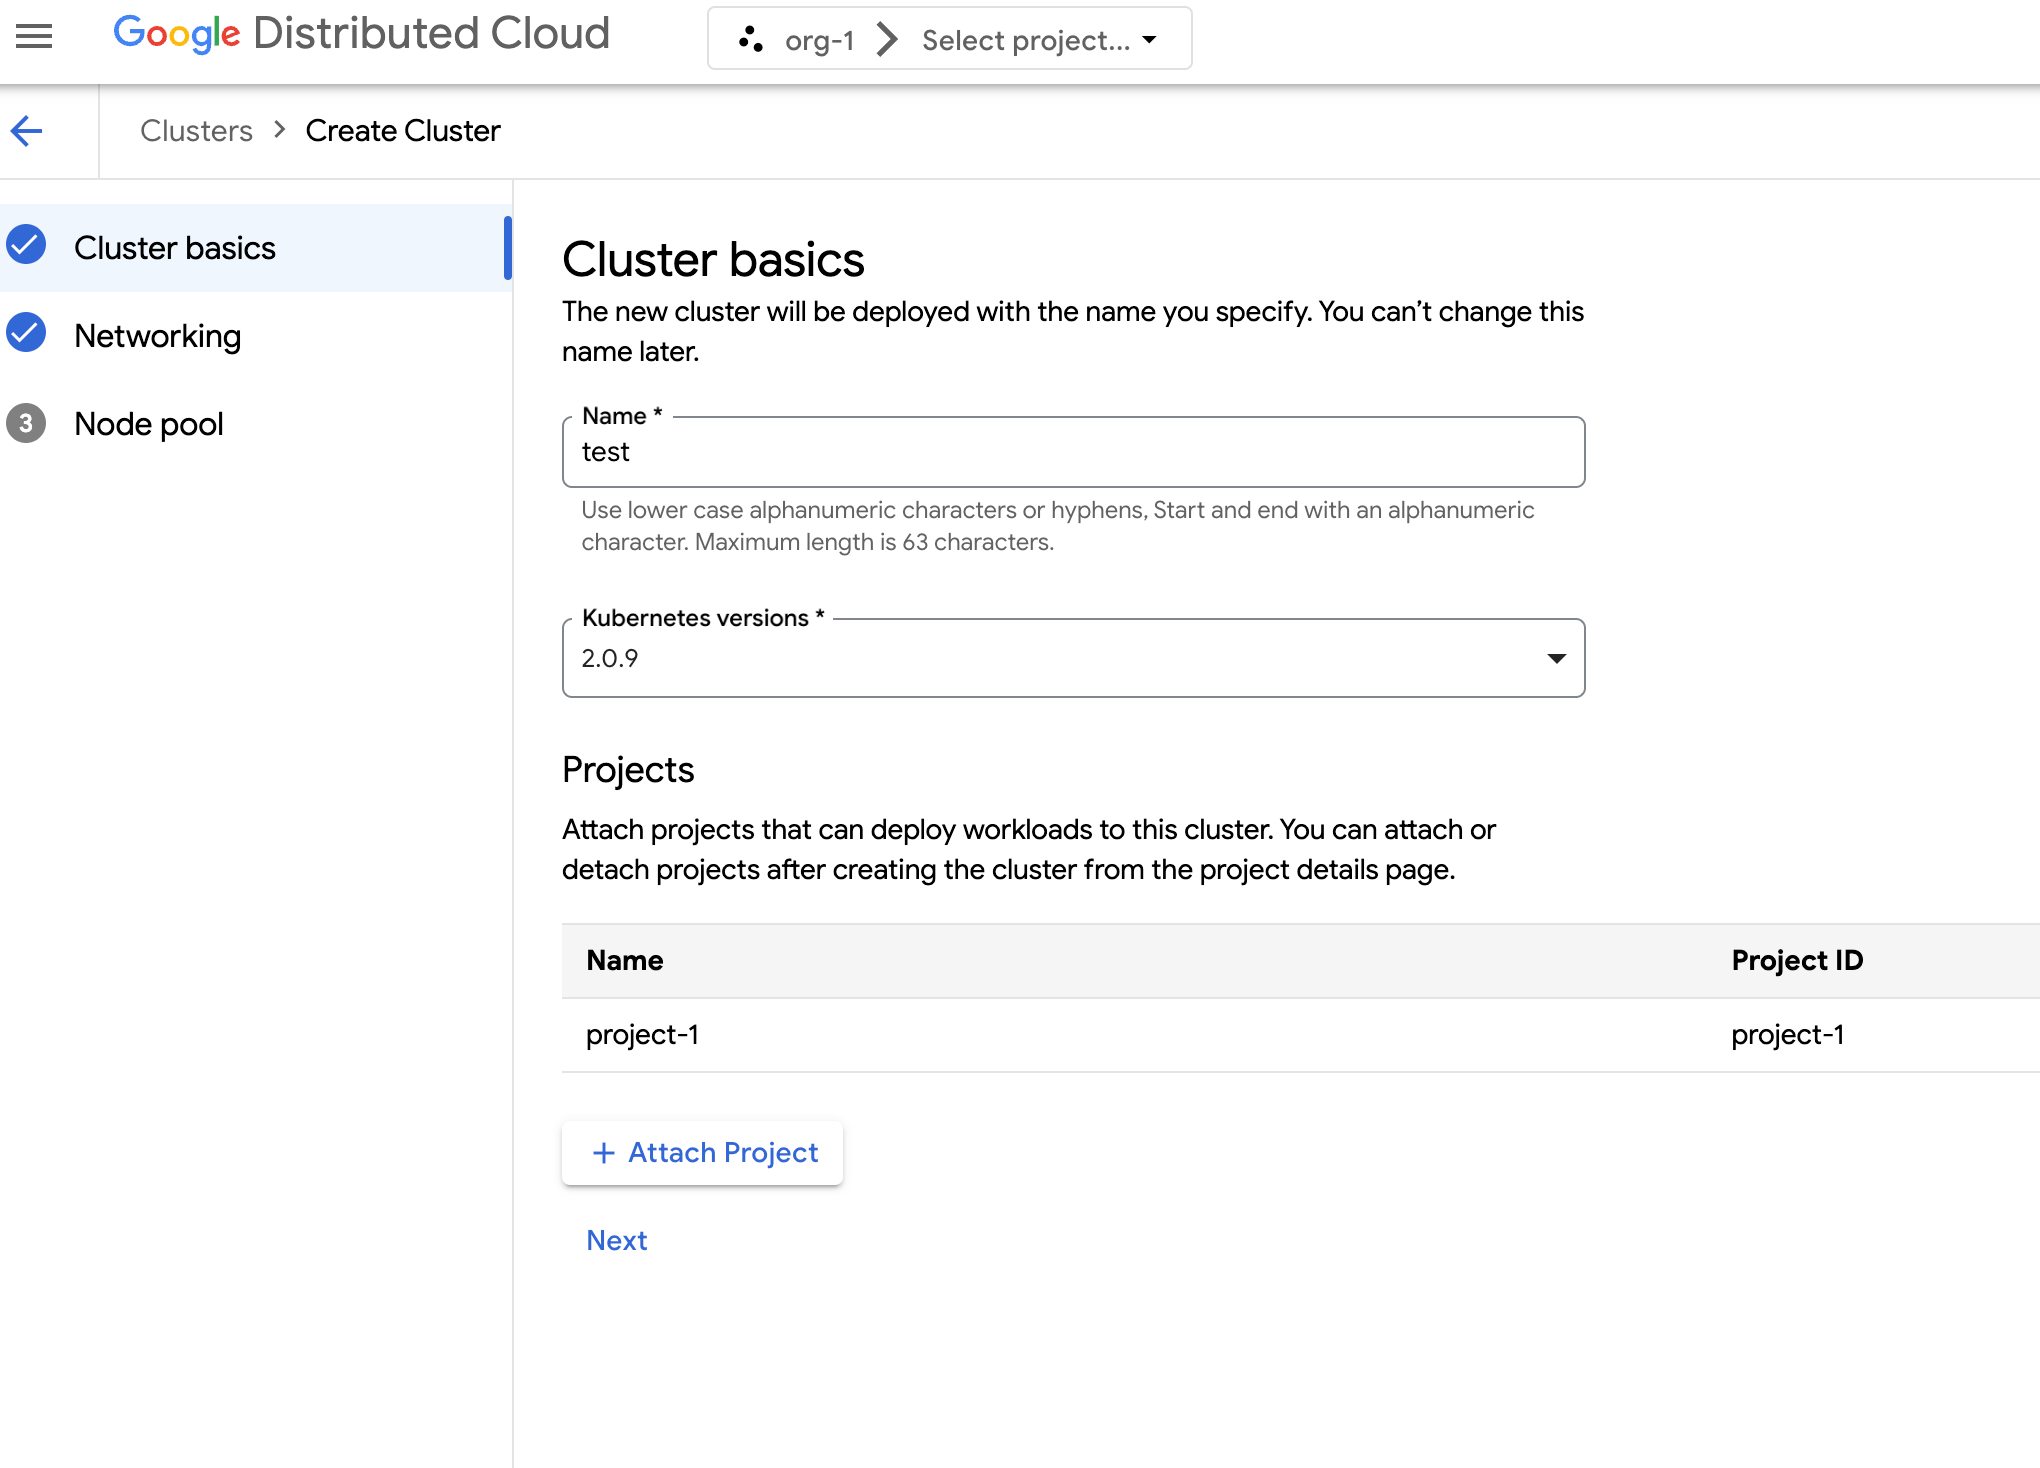
Klicken Sie auf Weiter.
Konfigurieren Sie die Netzwerkeinstellungen für Ihren Cluster. Sie können diese Netzwerkeinstellungen nach dem Erstellen des Clusters nicht mehr ändern. Das standardmäßige und einzige unterstützte Internetprotokoll für Kubernetes-Cluster ist Internet Protocol Version 4 (IPv4).
Wenn Sie dedizierte Load-Balancer-Knoten erstellen möchten, geben Sie die Anzahl der zu erstellenden Knoten ein. Standardmäßig erhalten Sie keine Knoten und der Load-Balancer-Traffic wird über die Steuerungsknoten geleitet.
Wählen Sie die zu verwendende Dienst-CIDR (Classless Inter-Domain Routing) aus. Ihren bereitgestellten Diensten wie Load Balancern werden IP-Adressen aus diesem Bereich zugewiesen.
Wählen Sie den zu verwendenden Pod-CIDR aus. Der Cluster weist Ihren Pods und VMs IP-Adressen aus diesem Bereich zu.
Klicken Sie auf Weiter.
Prüfen Sie die Details des automatisch generierten Standardknotenpools für den Cluster. Klicken Sie auf edit Bearbeiten, um den Standardknotenpool zu ändern.
Wenn Sie weitere Knotenpools erstellen möchten, wählen Sie Knotenpool hinzufügen aus. Wenn Sie den Standardknotenpool bearbeiten oder einen neuen Knotenpool hinzufügen, können Sie ihn mit den folgenden Optionen anpassen:
- Weisen Sie dem Knotenpool einen Namen zu. Sie können den Namen nicht mehr ändern, nachdem Sie den Knotenpool erstellt haben.
- Geben Sie die Anzahl der Worker-Knoten an, die im Knotenpool erstellt werden sollen.
Wählen Sie die Maschinenklasse aus, die am besten zu Ihren Arbeitslastanforderungen passt. Sehen Sie sich die Liste der folgenden Einstellungen an:
- Maschinentyp
- CPU
- Arbeitsspeicher
Klicken Sie auf Speichern.
Klicken Sie auf Erstellen, um den Cluster zu erstellen.
Die Erstellung eines freigegebenen Clusters kann bis zu 90 Minuten dauern.
API
Erstellen Sie die benutzerdefinierte Ressource
Cluster:kubectl --kubeconfig MANAGEMENT_API_SERVER apply -f - <<EOF apiVersion: cluster.gdc.goog/v1 kind: Cluster metadata: name: CLUSTER_NAME namespace: platform spec: clusterNetwork: podCIDRSize: POD_CIDR serviceCIDRSize: SERVICE_CIDR initialVersion: kubernetesVersion: KUBERNETES_VERSION nodePools: - machineTypeName: MACHINE_TYPE name: NODE_POOL_NAME nodeCount: NUMBER_OF_WORKER_NODES taints: TAINTS labels: LABELS acceleratorOptions: gpuPartitionScheme: GPU_PARTITION_SCHEME releaseChannel: channel: UNSPECIFIED EOFErsetzen Sie Folgendes:
MANAGEMENT_API_SERVER: der kubeconfig-Pfad des zonalen API-Servers.CLUSTER_NAMEist der Name des Clusters. Der Clustername darf nicht mit-systemenden. Das Suffix-systemist für Cluster reserviert, die von GDC erstellt wurden.POD_CIDR: die Größe der Netzwerkbereiche, aus denen virtuelle Pod-IP-Adressen zugewiesen werden. Wenn keine Angabe gemacht wird, wird der Standardwert21verwendet.SERVICE_CIDR: die Größe der Netzwerkbereiche, aus denen virtuelle Dienst-IP-Adressen zugewiesen werden. Wenn keine Angabe gemacht wird, wird der Standardwert23verwendet.KUBERNETES_VERSION: die Kubernetes-Version des Clusters, z. B.1.26.5-gke.2100. Eine Liste der verfügbaren Kubernetes-Versionen, die konfiguriert werden können, finden Sie unter Verfügbare Kubernetes-Versionen für einen Cluster auflisten.MACHINE_TYPE: der Maschinentyp für die Worker-Knoten des Knotenpools. Sehen Sie sich die verfügbaren Maschinentypen an, um zu erfahren, was konfiguriert werden kann.NODE_POOL_NAMEist der Name des Knotenpools.NUMBER_OF_WORKER_NODES: die Anzahl der Worker-Knoten, die im Knotenpool bereitgestellt werden sollen.TAINTS: Die Markierungen, die auf die Knoten dieses Knotenpools angewendet werden sollen. Dieses Feld ist optional.LABELS: die Labels, die auf die Knoten dieses Knotenpools angewendet werden sollen. Sie enthält eine Liste von Schlüssel/Wert-Paaren. Dieses Feld ist optional.GPU_PARTITION_SCHEME: das GPU-Partitionierungsschema, wenn Sie GPU-Arbeitslasten ausführen. Dieses Feld ist optional. Beispiel:mixed-2. Die GPU wird nicht partitioniert, wenn dieses Feld nicht festgelegt ist. Weitere Informationen zu verfügbaren MIG-Profilen (Multi-Instanz-GPU) finden Sie unter Unterstützte MIG-Profile.
Die Erstellung eines freigegebenen Clusters kann bis zu 90 Minuten dauern.
Erstellen Sie die benutzerdefinierte Ressource
ProjectBinding:kubectl --kubeconfig MANAGEMENT_API_SERVER apply -f - <<EOF apiVersion: resourcemanager.gdc.goog/v1 kind: ProjectBinding metadata: name: CLUSTER_NAME-PROJECT_NAME namespace: platform labels: resourcemanager.gdc.goog/projectbinding-for-user-project: "true" spec: clusterRef: name: CLUSTER_NAME selector: nameSelector: matchNames: - PROJECT_NAME EOFErsetzen Sie Folgendes:
MANAGEMENT_API_SERVER: der kubeconfig-Pfad des zonalen API-Servers.CLUSTER_NAMEist der Name des Clusters.PROJECT_NAME: der Name des Projekts, an das gebunden werden soll. JedeProjectBinding-Ressource kann nur einem Cluster zugeordnet werden. Wenn ein Projekt Zugriff auf mehrere Cluster benötigt, muss für jeden Cluster ein eindeutigesProjectBindingerstellt werden.
Sie müssen ein Projekt an Ihren Cluster anhängen, bevor ein Entwickler Containerarbeitslasten im Cluster bereitstellen kann.
Terraform
Fügen Sie in einer Terraform-Konfigurationsdatei das folgende Code-Snippet ein, um die benutzerdefinierte Ressource
Clusterzu erstellen:provider "kubernetes" { config_path = "MANAGEMENT_API_SERVER" } resource "kubernetes_manifest" "CLUSTER_RESOURCE_NAME" { manifest = { "apiVersion" = "cluster.gdc.goog/v1" "kind" = "Cluster" "metadata" = { "name" = "CLUSTER_NAME" "namespace" = "platform" } "spec" = { "clusterNetwork" = { "podCIDRSize" = "POD_CIDR" "serviceCIDRSize" = "SERVICE_CIDR" } "initialVersion" = { "kubernetesVersion" = "KUBERNETES_VERSION" } "nodePools" = [{ "machineTypeName" = "MACHINE_TYPE" "name" = "NODE_POOL_NAME" "nodeCount" = "NUMBER_OF_WORKER_NODES" "taints" = "TAINTS" "labels" = "LABELS" "acceleratorOptions" = { "gpuPartitionScheme" = "GPU_PARTITION_SCHEME" } }] "releaseChannel" = { "channel" = "UNSPECIFIED" } } } }Ersetzen Sie Folgendes:
MANAGEMENT_API_SERVER: der kubeconfig-Pfad des zonalen API-Servers.CLUSTER_RESOURCE_NAME: der eindeutige Terraform-Ressourcenname des Clusters, z. B.cluster-1. Dieser Name wird von Terraform verwendet, um Ihren Cluster zu identifizieren, und wird nicht von GDC verwendet.CLUSTER_NAMEist der Name des Clusters. Der Clustername darf nicht mit-systemenden. Das Suffix-systemist für Cluster reserviert, die von GDC erstellt wurden.POD_CIDR: die Größe der Netzwerkbereiche, aus denen virtuelle Pod-IP-Adressen zugewiesen werden. Wenn keine Angabe gemacht wird, wird der Standardwert21verwendet.SERVICE_CIDR: die Größe der Netzwerkbereiche, aus denen virtuelle Dienst-IP-Adressen zugewiesen werden. Wenn keine Angabe gemacht wird, wird der Standardwert23verwendet.KUBERNETES_VERSION: die Kubernetes-Version des Clusters, z. B.1.26.5-gke.2100. Eine Liste der verfügbaren Kubernetes-Versionen, die konfiguriert werden können, finden Sie unter Verfügbare Kubernetes-Versionen für einen Cluster auflisten.MACHINE_TYPE: der Maschinentyp für die Worker-Knoten des Knotenpools. Sehen Sie sich die verfügbaren Maschinentypen an, um zu erfahren, was konfiguriert werden kann.NODE_POOL_NAMEist der Name des Knotenpools.NUMBER_OF_WORKER_NODES: die Anzahl der Worker-Knoten, die im Knotenpool bereitgestellt werden sollen.TAINTS: Die Markierungen, die auf die Knoten dieses Knotenpools angewendet werden sollen. Dieses Feld ist optional.LABELS: die Labels, die auf die Knoten dieses Knotenpools angewendet werden sollen. Sie enthält eine Liste von Schlüssel/Wert-Paaren. Dieses Feld ist optional.GPU_PARTITION_SCHEME: das GPU-Partitionierungsschema, wenn Sie GPU-Arbeitslasten ausführen. Dieses Feld ist optional. Beispiel:mixed-2. Die GPU wird nicht partitioniert, wenn dieses Feld nicht festgelegt ist. Weitere Informationen zu verfügbaren MIG-Profilen (Multi-Instanz-GPU) finden Sie unter Unterstützte MIG-Profile.
Fügen Sie in einer Terraform-Konfigurationsdatei das folgende Code-Snippet ein, um die benutzerdefinierte Ressource
ProjectBindingzu erstellen:provider "kubernetes" { config_path = "MANAGEMENT_API_SERVER" } resource "kubernetes_manifest" "PROJECT_BINDING_RESOURCE_NAME" { manifest = { "apiVersion" = "resourcemanager.gdc.goog/v1" "kind" = "ProjectBinding" "metadata" = { "name" = "CLUSTER_NAME-PROJECT_NAME" "namespace" = "platform" "labels" = { "resourcemanager.gdc.goog/projectbinding-for-user-project" = "true" } } "spec" = { "clusterRef" = { "name" = "CLUSTER_NAME" } "selector" = { "nameSelector" = { "matchNames" = [ "PROJECT_NAME", ] } } } } }Ersetzen Sie Folgendes:
MANAGEMENT_API_SERVER: der kubeconfig-Pfad des zonalen API-Servers.PROJECT_BINDING_RESOURCE_NAME: der Terraform-Ressourcenname der Projektbindung, z. B.project-binding-1. Dieser Name wird von Terraform verwendet, um Ihre Projektbindung zu identifizieren, und wird nicht von GDC verwendet.CLUSTER_NAMEist der Name des Clusters.PROJECT_NAME: der Name des Projekts, an das gebunden werden soll. JedeProjectBinding-Ressource kann nur einem Cluster zugeordnet werden. Wenn ein Projekt Zugriff auf mehrere Cluster benötigt, muss für jeden Cluster ein eindeutigesProjectBindingerstellt werden.
Sie müssen ein Projekt an Ihren Cluster anhängen, bevor ein Entwickler Containerarbeitslasten im Cluster bereitstellen kann.
Wenden Sie die neuen benutzerdefinierten Ressourcen mit Terraform an:
terraform apply
Die Erstellung eines freigegebenen Clusters kann bis zu 90 Minuten dauern.