


Definição do problema
As organizações que operam em ambientes com isolamento físico enfrentam um desafio significativo: elas precisam de modelos de linguagem grandes, mas são estritamente proibidas de se conectar a APIs externas baseadas na nuvem devido a protocolos de segurança rigorosos. Para preencher essa lacuna, esses clientes precisam de um ecossistema robusto e independente, capaz de hospedar e gerenciar modelos de pesos abertos diretamente na infraestrutura do Google Distributed Cloud (GDC) com isolamento físico. Essa implantação localizada é essencial para manter a soberania de dados absoluta, garantindo que as informações sensíveis nunca saiam das instalações físicas. Ao integrar ambientes de execução seguros com back-ends de exibição, os usuários podem usar recursos avançados de IA e, ao mesmo tempo, manter o controle administrativo total sobre os dados, os pesos do modelo e a postura de segurança interna.
Embora o Gemini no GDC ofereça recursos de fronteira gerenciados e avançados, os clientes geralmente implantam modelos de peso aberto, como o Gemma 4 ou o Llama 4, para maior granularidade e controle. A implantação de modelos de pesos abertos em ambientes do GDC com isolamento físico oferece vantagens de custo significativas em relação aos serviços proprietários gerenciados. Ao serem proprietárias dos pesos do modelo, as organizações eliminam as taxas de API recorrentes por token, que podem se tornar proibitivas para cargas de trabalho automatizadas de alto volume. Além disso, os modelos de pesos abertos permitem a quantização (por exemplo, 4 ou 8 bits), o que possibilita o raciocínio de alto desempenho em hardware menor e mais barato no edge. Essa otimização vertical, combinada com a capacidade de compartilhar infraestrutura entre vários aplicativos internos sem custos extras de licenciamento, resulta em um custo total de propriedade (TCO) significativamente menor para operações de inferência sustentadas e em grande escala.
Solução proposta
Este documento descreve a arquitetura de referência para implantar e gerenciar modelos de linguagem grandes (LLMs) de peso aberto em ambientes com isolamento físico do Google Distributed Cloud (GDC). Muitos clientes, especialmente aqueles em setores altamente regulamentados, não podem usar APIs de LLM baseadas na nuvem devido a requisitos rígidos de soberania e segurança de dados. Essa arquitetura atende à necessidade de executar LLMs avançados localmente na própria instância segura do GDC.
O que está incluído:essa arquitetura abrange a implantação de modelos de pesos abertos (como Gemma 4, Llama, DeepSeek, Mistral) usando os back-ends de veiculação vLLM ou Ollama. Ele inclui o uso do Kubernetes para
orquestração, do Harbor para armazenamento de artefatos, de volumes persistentes para pesos de
modelo, de políticas de rede (NetworkPolicy / ProjectNetworkPolicy) para segurança
de rede e da Open WebUI como um front-end de navegador opcional.
O que não está incluído:essa arquitetura não abrange serviços gerenciados do gateway de IA, modelos proprietários como o Gemini do Google, processos de ajuste de modelos ou modelos de IA generativa para outras modalidades, como geração de imagens.
Público-alvo:o público-alvo principal deste documento inclui administradores de plataforma responsáveis por implantar e gerenciar serviços no GDC e arquitetos técnicos que projetam soluções de IA no ambiente com isolamento físico. Os usuários finais e os desenvolvedores que vão interagir com os modelos implantados são públicos secundários que se beneficiam da compreensão da estrutura subjacente.
Arquitetura
A solução implanta o vLLM, o Ollama ou ambos como back-ends de disponibilização de inferência em contêineres (Deployments) em um cluster padrão. Os pesos do modelo são armazenados em
volumes permanentes que são preenchidos na estação de trabalho por um carregador de modelo
Pod. Os Services do Kubernetes do tipo LoadBalancer expõem as APIs de back-end, os objetos NetworkPolicy / ProjectNetworkPolicy protegem o acesso a elas, e a Open WebUI pode ser implantada como um front-end de navegador para as APIs compatíveis com a OpenAI.
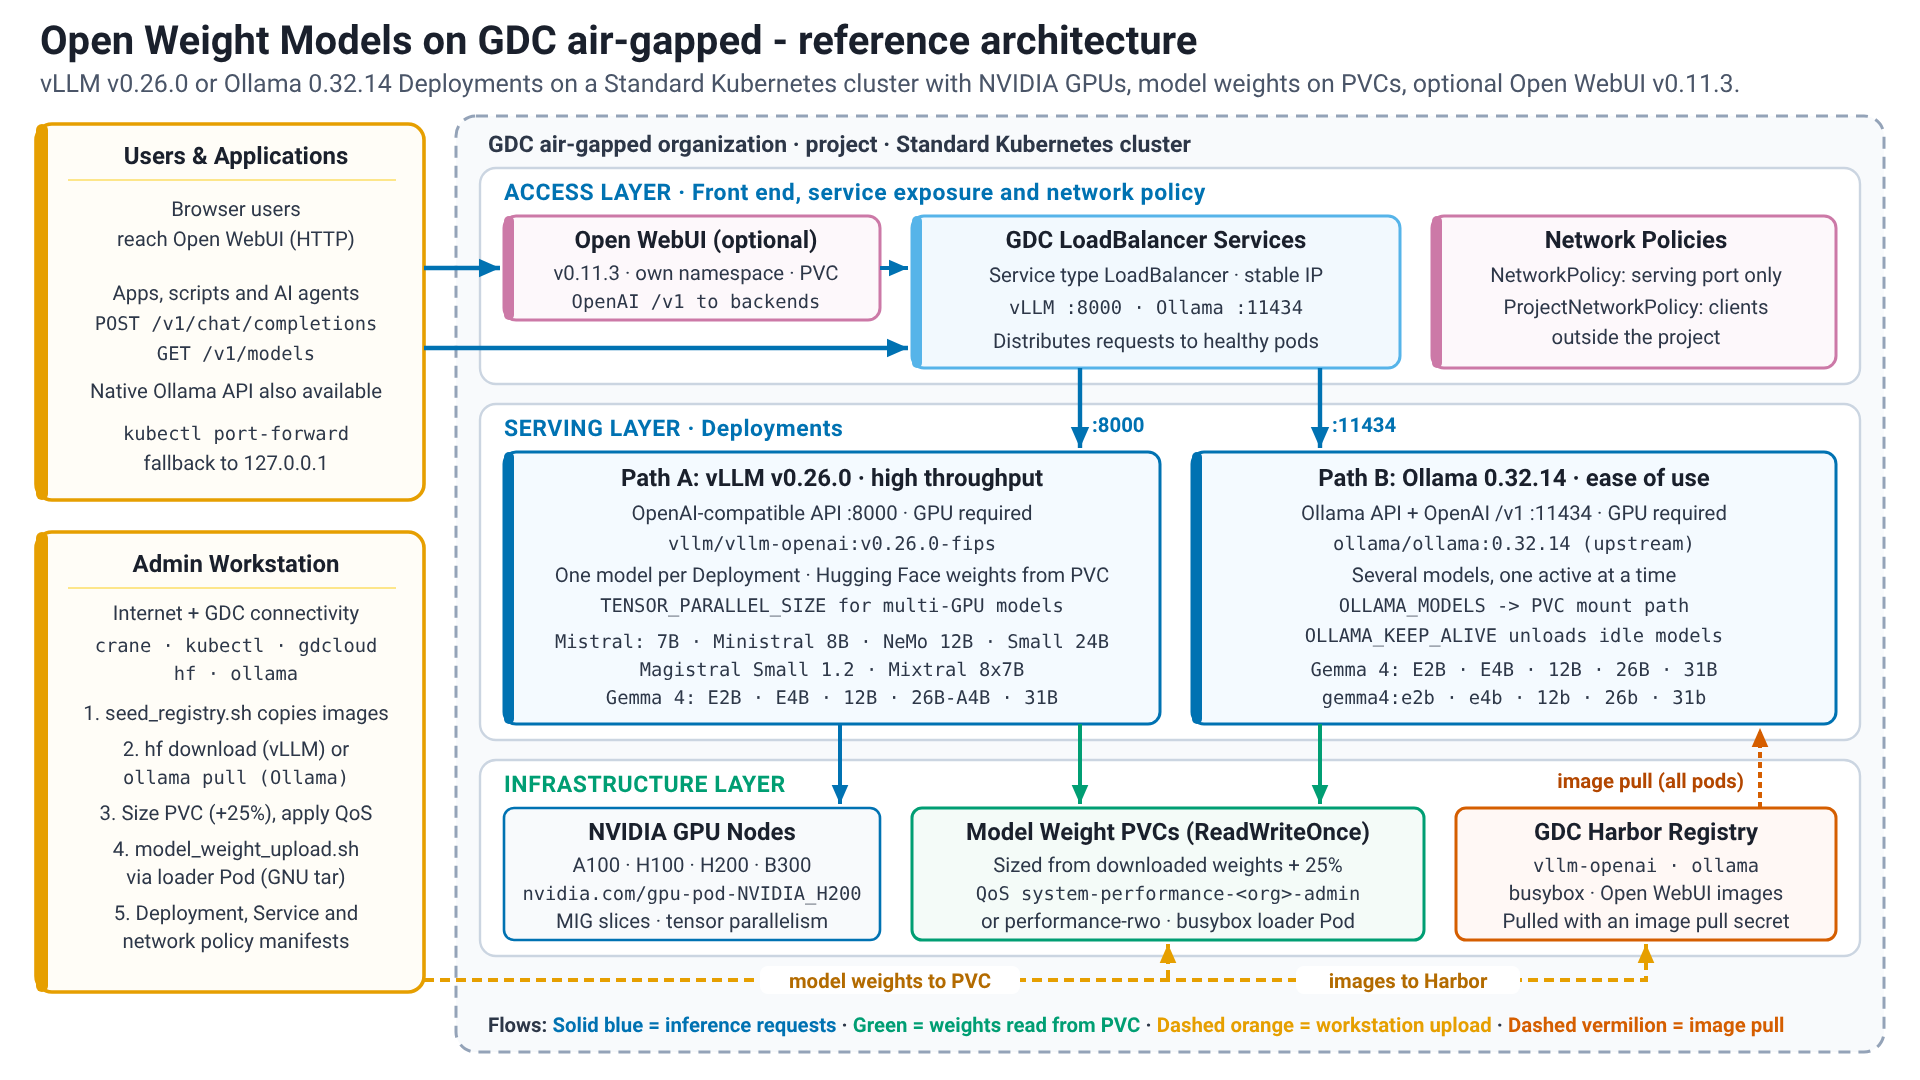
Componentes da solução
A solução usa os seguintes componentes:
| Componente da solução | Responsabilidades | Fluxo de dados | Interfaces |
|---|---|---|---|
| Zona do cliente do GDC com isolamento físico | Hospeda os clusters do Kubernetes, a rede e a infraestrutura de armazenamento | Plataforma básica | Interfaces de gerenciamento de infraestrutura para a IO. API Kubernetes para administradores e usuários da plataforma |
| Balanceador de carga | Expõe os pods de exibição de LLM (vLLM, Ollama) ao tráfego de fora do cluster do Kubernetes, fornecendo um endereço IP estável. | As solicitações de clientes externos são enviadas para o IP externo do LoadBalancer. O LoadBalancer distribui as solicitações entre os pods de back-end íntegros (vLLM ou Ollama) com base no seletor do serviço. | API Kubernetes Service. Provisiona automaticamente um balanceador de carga de rede no ambiente do GDC. |
| vLLM | Disponibilização de inferência de LLM de alta capacidade de processamento. Otimizado para baixa latência usando técnicas como PagedAttention. Normalmente, disponibiliza um modelo por instância. | Recebe solicitações de inferência HTTP de clientes. Carrega os pesos do modelo do PVC montado. Realiza cálculos em GPUs anexadas. Retorna respostas HTTP com texto gerado. | API RESTful compatível com a OpenAI para inferência. Aceita solicitações JSON. |
| Ollama | Disponibilização de inferência de LLM, projetada para facilitar o uso. Uma instância pode disponibilizar vários modelos e carregá-los sob demanda. | Recebe solicitações de inferência HTTP. Carrega modelos do PVC montado (OLLAMA_MODELS). Realiza cálculos em GPUs anexadas. Retorna respostas HTTP. Os modelos são descarregados após um período configurável de inatividade (OLLAMA_KEEP_ALIVE). |
API RESTful do Ollama e API compatível com a OpenAI (/v1). Aceita solicitações JSON. Também tem uma CLI. |
| GPUs NVIDIA e MIG | Oferecer aceleração de hardware para inferência de LLM. | Os back-ends de LLM (vLLM, Ollama) transferem as computações intensivas do modelo (como multiplicações de matrizes) para as GPUs para acelerar a inferência. A MIG permite particionar uma única GPU para ser usada por várias instâncias de modelo menores. | Exposto como um tipo de recurso no Kubernetes (por exemplo, nvidia.com/gpu-pod-NVIDIA_H200; o nome exato do recurso depende do modelo de GPU instalado e é descoberto nos nós). Os pods solicitam esses recursos |
| Harbor | Armazena e gerencia com segurança imagens de contêiner para vLLM, Ollama, Open WebUI e todos os pods auxiliares (como o busybox) | As imagens de contêiner são copiadas de registros públicos para o Harbor com seed_registry.sh (crane) de uma estação de trabalho com acesso à Internet. Os nós do Kubernetes extraem essas imagens do Harbor para executar contêineres. |
API Docker Registry. Os nós do Kubernetes interagem com o Harbor para extrair imagens durante a criação de pods. Os usuários usam a interface do usuário crane, a CLI do Docker ou a interface do Harbor para enviar imagens. |
| Reivindicações de volume permanente | Oferece armazenamento permanente para pesos de modelos de LLM, dissociado dos ciclos de vida dos pods. | Os arquivos de modelo são baixados na estação de trabalho, usados para calcular dinamicamente o tamanho do PVC com 25% de sobrecarga e transmitidos para o volume permanente por um pod de carregador de modelo temporário (busybox) com model_weight_upload.sh. O PVC é provisionado com performance-rwo em que o armazenamento em blocos de alto desempenho está ativado. Caso contrário, um operador de infraestrutura aplica a política de QoS system-performance-<org>-admin ao volume de backup. As duas opções oferecem 30 IOPS por GiB (mínimo de 6.148 IOPS). Os dois back-ends leem os pesos do modelo desse volume montado na inicialização: o vLLM carrega o diretório do modelo do Hugging Face, e o Ollama aponta OLLAMA_MODELS para o caminho de montagem. Nenhum kubectl cp é usado, e nenhum modelo é agrupado em imagens do contêiner. |
API Storage do Kubernetes. Definidos em YAML (ReadWriteOnce) e montados em pods como volumes. |
| Políticas de rede | Aplicar o isolamento de rede e controlar o fluxo de tráfego para os serviços de LLM. Um namespace NetworkPolicy (networking.k8s.io/v1) permite o tráfego para a porta de exibição de dentro do cluster. Um ProjectNetworkPolicy (networking.gdc.goog/v1) também é necessário para o acesso de fora do projeto. |
O tráfego de rede de entrada e saída dos pods no namespace é inspecionado. As regras de política determinam se as conexões com as portas de serviço do LLM (por exemplo, 8000 para vLLM, 11434 para Ollama) são permitidas, geralmente com base em intervalos de IP de origem ou outros rótulos. | APIs networking.k8s.io/v1 e networking.gdc.goog/v1 do Kubernetes. Definido em YAML. |
| Abrir a WebUI | Front-end opcional baseado em navegador para usuários finais. Conversa com as APIs compatíveis com a OpenAI do vLLM e do Ollama. Ele não tem pesos de modelo e não precisa de acelerador. | Os usuários acessam a Open WebUI pelo serviço do Kubernetes. A Open WebUI encaminha as solicitações de chat para os serviços vLLM e Ollama pela API /v1 compatível com a OpenAI e mantém o próprio estado (usuários, chats, configurações) em um volume permanente. |
HTTP (navegador) para usuários, API REST compatível com a OpenAI para os back-ends. Carga de trabalho com estado implantada no próprio namespace. |
Recursos e funcionalidades
Essa arquitetura de referência oferece os seguintes recursos principais:
- Disponibilização de LLMs de peso aberto:permite a hospedagem e a inferência de vários modelos de peso aberto (por exemplo, Gemma 4, Llama, DeepSeek, Mistral).
- Componentes:back-ends de exibição de LLM (vLLM, Ollama), implantações/pods do Kubernetes.
- Responsabilidades:carregar pesos de modelos, gerenciar o processo de inferência, executar modelos em aceleradores de hardware e expor endpoints.
- Interfaces:APIs REST (compatíveis com OpenAI para vLLM e Ollama, além da API específica do Ollama) para solicitações de inferência, normalmente usando JSON.
- Traga seu próprio modelo (BYOM, na sigla em inglês): os usuários podem importar e implantar os LLMs de pesos abertos
que escolherem no ambiente com isolamento físico.
- Componentes:Harbor, declarações de volume permanente, pod do carregador de modelos, Kubernetes.
- Responsabilidades:armazenamento seguro de imagens de contêiner e pesos de modelo. Mecanismo para transferir modelos para o ambiente
(
model_weight_upload.shpelo pod do carregador) e disponibilizá-los para os mecanismos de exibição. - Interfaces:API Docker Registry (para Harbor), API Kubernetes (para PVCs e montagens de volume).
- Inferência acelerada por hardware:usa GPUs NVIDIA no cluster do GDC para executar inferências de LLM de maneira eficiente.
- Componentes:GPUs NVIDIA, Kubernetes, plug-ins de dispositivo.
- Responsabilidades:programar pods em nós com recursos de GPU.
Exposição do hardware da GPU aos contêineres de back-end do LLM. Oferece suporte à
GPU de várias instâncias (MIG) para particionamento e paralelismo de tensor de várias GPUs (
TENSOR_PARALLEL_SIZE) para modelos grandes, como o Mixtral 8x7Bbf16. - Interfaces:API Kubernetes (para solicitar recursos de GPU, como
nvidia.com/gpu-pod-NVIDIA_H200ounvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE).
- Acesso controlado por rede:garante que o acesso aos endpoints de inferência de LLM seja controlado e isolado no ambiente do GDC.
- Componentes:serviços do Kubernetes (LoadBalancer), NetworkPolicy, ProjectNetworkPolicy.
- Responsabilidades:expor serviços de inferência usando um IP estável. Definir e aplicar regras de rede para permitir ou negar o tráfego para os back-ends do LLM com base na origem, no destino e nas portas.
- Interfaces:API Kubernetes (para Services, NetworkPolicy e ProjectNetworkPolicy).
- Disponibilização escalonável:permite ajustar a capacidade com base na demanda.
- Componentes:implantações do Kubernetes.
- Responsabilidades:ativar o escalonamento horizontal aumentando o número de réplicas para os pods de back-end do LLM. Escalonamento vertical ajustando solicitações de recurso/limites.
- Interfaces:API Kubernetes (para gerenciar réplicas e recursos de implantação).
- Front-end do navegador (opcional): permite que os usuários finais conversem com os modelos
implantados sem escrever chamadas de API.
- Componentes:implantação, serviço e declaração de volume persistente da Open WebUI.
- Responsabilidades:apresentar a disponibilização dos modelos pelo vLLM e pelo Ollama em uma interface; persistir usuários, chats e configurações.
- Interfaces:HTTP (navegador); API
/v1compatível com a OpenAI para os back-ends.
Princípios de arquitetura
- Segurança em primeiro lugar: todos os componentes e dados residem no
limite do GDC com isolamento físico, garantindo o máximo de segurança
e controle de dados. O acesso à rede é restrito usando objetos
NetworkPolicyeProjectNetworkPolicy. - Soberania de dados: os clientes mantêm o controle total sobre os modelos e dados, sem necessidade de conectividade externa para a operação.
- Aberta e flexível: a arquitetura usa back-ends de disponibilização de código aberto (vLLM, Ollama) e oferece suporte a uma variedade de LLMs de pesos abertos, oferecendo aos clientes opções e evitando a dependência de fornecedores para o mecanismo de inferência.
- Desacoplamento de componentes: funções importantes, como armazenamento de modelos (PVCs), gerenciamento de imagens (Harbor), disponibilização de inferência (pods vLLM/Ollama) e interface do usuário (Open WebUI), são componentes distintos, o que permite o gerenciamento e as atualizações independentes.
- Escalonabilidade e desempenho: projetado para escalonamento horizontal, aumentando o número de réplicas de pods, e vertical, ajustando os recursos de CPU/GPU (incluindo paralelismo de tensor de várias GPUs) para atender às demandas de desempenho. O vLLM é escolhido para cenários de alta capacidade de processamento e baixa latência.
- Otimização de recursos: oferece suporte à GPU de várias instâncias (MIG) da NVIDIA para permitir que modelos menores compartilhem recursos de GPU de maneira eficiente e dimensionamento dinâmico de PVC (+25% de sobrecarga) combinado com QoS de armazenamento de alto desempenho para eliminar o provisionamento excessivo de armazenamento sem sacrificar a velocidade de carregamento do modelo.
- Interfaces padrão: criadas com base nos padrões do Kubernetes para orquestração, implantação e exposição de serviços. Os endpoints de inferência fornecem APIs REST, com o vLLM e o Ollama oferecendo compatibilidade com a OpenAI.
- Resiliência: usa verificações de integridade e replicação do Kubernetes para garantir a disponibilidade do serviço.
Considerações
- Escalonabilidade e desempenho:
- O escalonamento horizontal é alcançado aumentando o número de réplicas na
implantação do Kubernetes para vLLM e Ollama. Sem um
StorageClass
ReadOnlyMany, uma implantação de modelo é limitada a uma réplica (o volume do modelo éReadWriteOnce). A capacidade extra vem de outras implantações, cada uma com o próprio PVC. - O escalonamento vertical envolve a alocação de mais CPU/memória e frações de GPU maiores, até GPUs completas ou paralelismo de tensor de várias GPUs
(
TENSOR_PARALLEL_SIZE) em várias GPUs no mesmo nó. - O vLLM disponibiliza um modelo por instância, exigindo novas implantações para outros modelos. O Ollama pode disponibilizar vários modelos de uma instância. Nestes guias, cada implantação do Ollama disponibiliza um modelo.
- O PVC de cada modelo é dimensionado dinamicamente com base nos pesos baixados, com
25% de sobrecarga, e configurado com a política de QoS de armazenamento de alto desempenho
(
system-performance-<org>-admin, 30 IOPS por GiB com um mínimo de 6.148 IOPS ouperformance-rwo, em que o armazenamento em blocos de alto desempenho está ativado) para que os tempos de carregamento do modelo não sejam limitados pelo limite padrão destandard-rwo3 IOPS por GiB.
- O escalonamento horizontal é alcançado aumentando o número de réplicas na
implantação do Kubernetes para vLLM e Ollama. Sem um
StorageClass
- Gerenciamento de recursos:
- É essencial planejar os recursos de GPU com cuidado. A NVIDIA MIG pode ser usada
para particionar GPUs para modelos menores, melhorando a utilização, enquanto
modelos maiores (como o Mixtral 8x7B em
bf16) podem fragmentar pesos em várias GPUs usando o paralelismo de tensor. - É necessário alocar CPU e memória adequadas para lidar com a sobrecarga de inferência e gerenciamento de modelos. O vLLM e o Ollama disponibilizam modelos com aceleração de GPU.
- É necessário provisionar armazenamento suficiente para que os PVCs acomodem os tamanhos dos modelos e garantam o desempenho.
- É essencial planejar os recursos de GPU com cuidado. A NVIDIA MIG pode ser usada
para particionar GPUs para modelos menores, melhorando a utilização, enquanto
modelos maiores (como o Mixtral 8x7B em
- Disponibilidade e confiabilidade:
- As implantações do Kubernetes oferecem recursos de autorrecuperação e atualização gradual.
- Os serviços LoadBalancer distribuem o tráfego entre pods íntegros, mascarando falhas individuais de pods.
- Armazenar pesos de modelo em PVCs garante a persistência em reinicializações de pods.
- Complexidade operacional:
- Gerenciar imagens de contêiner para diferentes back-ends e versões no Harbor.
- Procedimentos para transferir com segurança os pesos do modelo para o ambiente com isolamento físico.
- Criar e gerenciar manifestos do Kubernetes (implantações, serviços, PVCs, políticas de rede) para cada modelo e back-end.
- Monitoramento do uso da GPU, da latência de inferência e das taxas de erro.
- Segurança e compliance:
- Toda a solução opera dentro do perímetro de segurança com isolamento físico do GDC.
- As políticas de rede são obrigatórias para aplicar um isolamento de rede rigoroso e
controlar o acesso aos endpoints do LLM: um namespace
NetworkPolicypara acesso no cluster e umProjectNetworkPolicypara acesso de fora do projeto. - As contas de robô do Harbor e os secrets de extração de imagens do Kubernetes garantem o acesso seguro às imagens de contêiner.
- As políticas de rede restringem quais clientes podem acessar os endpoints. Os dados em repouso em PVCs dependem da criptografia de armazenamento do GDC.
Decisões de design
As seguintes decisões de design importantes foram tomadas para esta arquitetura de referência:
Decisão 1: oferecer o vLLM e o Ollama em vez de um back-end de disponibilização
| Contexto | Decisão importante | Justificativa |
|---|---|---|
| Oferecer um back-end de veiculação (vLLM ou Ollama) ou ambos. | Ofereça as duas, porque os usuários e os casos de uso têm requisitos diferentes de desempenho, compatibilidade de API e facilidade de gerenciamento de modelos. | O vLLM oferece alta capacidade de processamento, baixa latência e compatibilidade com a API OpenAI, sendo adequado para aplicativos de produção. O Ollama oferece uma configuração mais simples, gerenciamento mais fácil de vários modelos e facilidade de uso, o que é melhor para desenvolvimento e experimentação. Oferecer suporte a ambos proporciona flexibilidade. |
Decisão 2: pesos do modelo em PersistentVolumeClaims
| Contexto | Decisão importante | Justificativa |
|---|---|---|
| O vLLM e o Ollama exigem pesos de modelo no sistema de arquivos no momento da execução. Em um ambiente com isolamento físico, os modelos não podem ser baixados sob demanda. | Armazenar os pesos de cada modelo no próprio PersistentVolumeClaim ReadWriteOnce, preenchido pela estação de trabalho usando um pod temporário de carregamento de modelos. |
Os PersistentVolumeClaims fornecem uma camada de armazenamento permanente e resiliente para arquivos de modelos grandes, dissociada do ciclo de vida do pod de inferência. Isso permite que os modelos sejam carregados rapidamente na inicialização do pod. |
Decisão 3: pesos de modelo em PersistentVolumes para o Ollama (pod do carregador) em vez de agrupá-los na imagem
| Contexto | Decisão importante | Justificativa |
|---|---|---|
| O Ollama pode baixar modelos, mas isso requer acesso à Internet, que não está disponível em ambientes com isolamento físico. Agrupar os modelos em uma imagem personalizada do Ollama exige uma imagem recriada para cada modelo e armazena imagens de vários GB no Harbor. | O Ollama usa o mesmo fluxo de trabalho de pod de carregador que o vLLM: o modelo é extraído na estação de trabalho (ollama pull por meio de ollama_model_weight_download.sh), transmitido para o PVC pelo pod de carregador de modelo com model_weight_upload.sh (GNU tar) e OLLAMA_MODELS é apontado para o caminho de montagem. |
Um fluxo de trabalho para os dois back-ends. Os modelos podem ser adicionados ou atualizados sem recriar imagens. A imagem upstream não modificada do Ollama permanece pequena no Harbor. |
Decisão 4: expor o vLLM e o Ollama usando serviços do LoadBalancer em vez de nenhum balanceador de carga
| Contexto | Decisão importante | Justificativa |
|---|---|---|
| As APIs de LLM precisam ser acessíveis para aplicativos no ambiente do GDC. | Exponha cada back-end por meio de um serviço do tipo LoadBalancer, a abordagem padrão do Kubernetes. Isso depende do provisionamento do balanceador de carga da plataforma do GDC com isolamento físico. |
Os serviços do Kubernetes do tipo LoadBalancer oferecem um método padrão e confiável para expor os back-ends de LLM, fornecendo um endereço IP estável e distribuindo a carga. |
Decisão 5: aplicar políticas de rede obrigatórias (NetworkPolicy e ProjectNetworkPolicy)
| Contexto | Decisão importante | Justificativa |
|---|---|---|
| A segurança e o isolamento são essenciais nas implantações do GDC com isolamento físico. | Aplique políticas de rede em cada endpoint de LLM (um namespace NetworkPolicy que aceita apenas a porta de disponibilização, complementado por um ProjectNetworkPolicy quando clientes fora do projeto precisam de acesso) para melhorar a postura de segurança dos serviços de LLM implantados. |
Os objetos NetworkPolicy oferecem uma maneira nativa do Kubernetes de aplicar o isolamento de rede no nível do namespace, e os objetos ProjectNetworkPolicy estendem isso ao limite do projeto, garantindo que apenas o tráfego autorizado chegue aos serviços de LLM. |
Decisão 6: dimensionamento dinâmico de PVC (+25% de sobrecarga) combinado com política de QoS de armazenamento de alto desempenho
| Contexto | Decisão importante | Justificativa |
|---|---|---|
O standard-rwo StorageClass padrão aplica a política de QoS adaptável do ONTAP standard-<org>-admin (3,072 IOPS per TiB ou 3 IOPS per GiB, com um piso mínimo de 75 IOPS). Dimensionar um PVC do standard-rwo estritamente para o tamanho do peso de um modelo limita as leituras de peso sequenciais a 5 a 21 MBps, e o provisionamento excessivo de PVCs estáticos de 300 a 500 GiB desperdiça armazenamento, mas ainda limita a capacidade de leitura sequencial em cerca de 60 MBps. |
Baixe os pesos do modelo primeiro, calcule dinamicamente GDCS_MODEL_PVC_SIZE do diretório baixado com 25% de sobrecarga arredondada para o próximo GiB inteiro e use storageClassName: performance-rwo em que o armazenamento em blocos de alto desempenho está ativado ou peça a um operador de infraestrutura para aplicar a política de QoS system-performance-${GDC_ORG}-admin ao volume de backup. |
A política de QoS system-performance-<org>-admin fornece 30,720 IOPS per TiB (30 IOPS per GiB, 10 vezes maior que standard) com um piso mínimo de 6,148 IOPS (limite de ONTAP de ~393 MBps) para qualquer volume de até 204 GiB. Combinar o dimensionamento dinâmico de 25% de overhead com o system-performance elimina o provisionamento excessivo de armazenamento de 3x a 40x (12Gi a 109Gi em vez de 100Gi a 500Gi), além de aumentar a velocidade de leitura sequencial do KubeVirt virtio-scsi de LUN único para ~150 MBps (inicialização de modelo de 2,5x a 30x mais rápida). |
Suposições e limitações
- O ambiente do GDC com isolamento físico 1.16.2 hotfix 1
(
1.16.2-gdch.1353-1) ou posterior está disponível (os pools de nós de GPU em clusters padrão exigem essa versão; as versões anteriores oferecem GPUs apenas em clusters compartilhados). - Recursos de hardware suficientes (incluindo GPUs NVIDIA) estão presentes no cluster padrão. O vLLM e o Ollama exigem uma GPU.
- A instância do Harbor está configurada e acessível.
- Uma estação de trabalho com acesso à Internet e conectividade com o ambiente do GDC (API Harbor e Kubernetes) está disponível para propagar imagens e fazer upload de pesos de modelo.
- Os usuários têm as permissões necessárias: papéis de projeto de Leitor de Instância do Harbor e Administrador de Cluster Padrão, além de um StandardClusterRoleBinding (cluster-admin) no cluster padrão. Consulte os SRIs.
- Os modelos são compatíveis com os back-ends de exibição escolhidos (vLLM/Ollama).
- Limitação:o PVC de peso do modelo é
ReadWriteOnce. Sem um StorageClassReadOnlyMany, cada implantação de modelo é limitada a uma réplica.
Fluxo do usuário
Veja a seguir um fluxo de usuário abrangente para implantar modelos de linguagem grandes (LLMs) de peso aberto em ambientes com isolamento físico do Google Distributed Cloud (GDC). O fluxo é dividido em configuração comum, dois caminhos de implantação (vLLM e Ollama), um front-end opcional e validação final.
1. Configuração comum: gerenciamento de imagens
Antes de implantar qualquer LLM, configure como o ambiente do GDC vai extrair imagens de contêiner do seu registro particular do Harbor.
- Criar contas de robô do Harbor:gere contas de robô na interface do Harbor:
uma com permissões de envio para
crane(propagação de imagens) e outra com permissões de extração para o secret de extração de imagens do Kubernetes. - Autenticar imagens do Crane e do seed:use as credenciais da conta de robô para fazer login no Harbor em uma estação de trabalho com acesso à internet (
crane auth login) e copie as imagens do contêiner necessárias (busybox,ollama/ollama,vllm/vllm-openai, opcionalmente, Open WebUI) para o Harbor comseed_registry.sh. - Criar um secret do Kubernetes:crie um secret de registro do Docker no namespace da carga de trabalho usando kubectl para armazenar as credenciais da conta do robô de pull para o cluster usar.
2. Caminho de implantação A: vLLM para alta capacidade de processamento
Esse caminho é recomendado para disponibilizar modelos orientados ao desempenho, como o Mistral 7B Instruct em GPUs.
- Adquirir imagem:propagar a imagem vLLM (
vllm/vllm-openai:v0.26.0) no Harbor comseed_registry.sh, depois criar e enviar a tag de imagem corrigidav0.26.0-fips, conforme descrito no SRI. - Preparar o armazenamento do modelo:
- Faça o download dos pesos do Hugging Face na estação de trabalho (
hf download). - Calcule o tamanho de PVC necessário com base nos pesos baixados (com 25%
de sobrecarga), crie uma declaração de volume permanente (PVC, na sigla em inglês)
ReadWriteOncepara armazenar os pesos do modelo e aplique a política de QoS de alto desempenho. - Inicie um pod de carregador de modelo temporário (
busybox) que monta o PVC e transmita os pesos para ele commodel_weight_upload.sh(GNU tar sobrekubectl exec;kubectl cpnão é usado porque o BusyBox tar não pode ler os cabeçalhos PAX para arquivos maiores que 8 GiB) e, em seguida, exclua o pod do carregador.
- Faça o download dos pesos do Hugging Face na estação de trabalho (
- Implantar o back-end:aplique um manifesto de implantação do Kubernetes que faça referência
à imagem do vLLM, solicite o recurso de acelerador descoberto nos nós
(por exemplo,
nvidia.com/gpu-pod-NVIDIA_H200) e monte o PVC de peso do modelo. - Expor serviço:crie um serviço LoadBalancer para fornecer um IP externo para a API vLLM.
- Rede segura:aplique uma NetworkPolicy de namespace para permitir o tráfego de entrada na porta de serviço (8000). Adicione uma ProjectNetworkPolicy quando clientes fora do projeto precisarem de acesso.
3. Caminho de implantação B: Ollama para facilitar o uso
Esse caminho se concentra em uma configuração simplificada. Ele usa a imagem upstream do Ollama inalterada e o mesmo fluxo de trabalho do carregador de modelos do vLLM.
- Imagem de sugestão:copie a imagem upstream do Ollama (
ollama/ollama:0.32.14) para o Harbor comseed_registry.sh. - Preparar o armazenamento do modelo:
- Extraia o modelo (por exemplo,
gemma4:e4b) na estação de trabalho comollama_model_weight_download.sh, que executa umollama servelocal temporário comOLLAMA_MODELSapontado para o diretório de download. - Calcule o tamanho de PVC necessário com base nos pesos baixados (com 25%
de sobrecarga), crie um PVC
ReadWriteOnce, aplique a política de QoS de alto desempenho e inicie um pod temporário de carregador de modelos que o monte. - Faça upload do diretório de download no PVC com
model_weight_upload.she exclua o pod do carregador.
- Extraia o modelo (por exemplo,
- Implantação e exposição:crie uma implantação do Ollama com
OLLAMA_MODELSapontado para o caminho de montagem do PVC (solicitando o recurso de acelerador descoberto nos nós) e um serviço LoadBalancer. - Rede segura:aplique uma NetworkPolicy de namespace para a porta do Ollama (11434). Adicione uma ProjectNetworkPolicy quando clientes fora do projeto precisarem de acesso.
4. Opcional: abrir a WebUI
- Implantar a Open WebUI:propagar a imagem da Open WebUI no Harbor e implantá-la
no próprio namespace com armazenamento permanente para o estado dela. Direcione-a para os
endpoints
/v1compatíveis com a OpenAI do serviço vLLM, do serviço Ollama ou de ambos. As etapas estão no guia do usuário do Open WebUI para modelos de pesos abertos.
5. Validação e teste
Depois da implantação, as etapas finais envolvem verificar se os serviços estão funcionando.
- Verificar o status:confira se os pods estão em execução e se os serviços receberam endereços IP externo.
- Inferência de teste:
- vLLM:envie uma solicitação curl para o IP do LoadBalancer do vLLM usando os endpoints
/v1/modelse/v1/chat/completionscompatíveis com a OpenAI. - Ollama:envie uma solicitação curl para o IP do LoadBalancer do Ollama usando os mesmos endpoints
/v1/modelse/v1/chat/completionscompatíveis com a OpenAI.
- vLLM:envie uma solicitação curl para o IP do LoadBalancer do vLLM usando os endpoints
- Fallback de encaminhamento de porta:quando o IP do LoadBalancer não pode ser acessado na
estação de trabalho (por exemplo, porque nenhuma ProjectNetworkPolicy está em vigor),
use
kubectl port-forwardpara o serviço e envie as mesmas solicitações para127.0.0.1.
6. Operações e escalonamento
- Escalonamento vertical:aumente as frações de GPU ou mude para configurações de várias GPUs para modelos maiores.
- Escalonamento horizontal:aumente o número de réplicas na implantação
(requer um volume de modelo
ReadOnlyMany) ou implante mais implantações de modelo para processar mais solicitações simultâneas de usuários. - Solução de problemas:monitore os registros usando
kubectl logse verifique se há problemas comuns, como falhas no autoteste do FIPS ou restrições de política de rede.
As etapas detalhadas estão na implementação de referência de modelos de pesos abertos com o Ollama, na implementação de referência de modelos de pesos abertos com o vLLM e nos guias do usuário.
Outros recursos
- Modelos de peso aberto com implementação de referência do Ollama
- Modelos de pesos abertos com implementação de referência do vLLM
- Guia do usuário do Gemma 4 E4B com o Ollama
- [SUG] Mistral 7B Instruct com vLLM no GDC com isolamento físico
- [SUG] Mistral NeMo 12B Instruct com vLLM no GDC com isolamento físico
- [SUG] Mistral Small 3.2 24B Instruct com vLLM no GDC com isolamento físico
- [SUG] Ministral 8B Instruct com vLLM no GDC com isolamento físico
- [SUG] Mixtral 8x7B Instruct com vLLM no GDC com isolamento físico
- [SUG] Magistral Small 1.2 24B com vLLM no GDC com isolamento físico
- Guia do usuário do Open WebUI para modelos de pesos abertos
- Documentação do vLLM
- Ollama
- Abrir a WebUI
- Documentação do Google Distributed Cloud com isolamento físico