


Dichiarazione del problema
Le organizzazioni che operano in ambienti con air gap devono affrontare una sfida significativa: hanno bisogno di modelli linguistici di grandi dimensioni, ma è severamente vietato connettersi ad API esterne basate su cloud a causa di rigorosi protocolli di sicurezza. Per colmare questo divario, questi clienti hanno bisogno di un ecosistema solido e autonomo in grado di ospitare e gestire i modelli open weight direttamente sulla loro infrastruttura Google Distributed Cloud (GDC) con air gap. Questo deployment localizzato è essenziale per mantenere l'assoluta sovranità dei dati, garantendo che le informazioni sensibili non lascino mai i locali fisici. Integrando ambienti di esecuzione sicuri con i backend di gestione, gli utenti possono utilizzare funzionalità di AI avanzate mantenendo il pieno controllo amministrativo sui propri dati, sui pesi dei modelli e sulla security posture interna.
Sebbene Gemini su GDC fornisca funzionalità di frontiera potenti e gestite, i clienti spesso eseguono il deployment di modelli open-weight come Gemma 4 o Llama 4 per una maggiore granularità e un maggiore controllo. Il deployment di modelli open-weight in ambienti GDC con air gap offre vantaggi significativi in termini di costi rispetto ai servizi proprietari gestiti. Con la proprietà dei pesi del modello, le organizzazioni eliminano le tariffe API per token ricorrenti, che possono diventare proibitive per i workload automatizzati ad alto volume. Inoltre, i modelli open weight consentono la quantizzazione (ad esempio, a 4 o 8 bit), consentendo un ragionamento ad alte prestazioni su hardware più piccoli ed economici a livello perimetrale. Questa ottimizzazione verticale, combinata con la possibilità di condividere l'infrastruttura tra più applicazioni interne senza costi di licenza aggiuntivi, si traduce in un costo totale di proprietà (TCO) significativamente inferiore per operazioni di inferenza sostenute e su larga scala.
Soluzione proposta
Questo documento descrive l'architettura di riferimento per il deployment e la gestione di modelli linguistici di grandi dimensioni (LLM) con pesi aperti in ambienti Google Distributed Cloud (GDC) con air gap. Molti clienti, in particolare quelli che operano in settori altamente regolamentati, non possono utilizzare le API LLM basate su cloud a causa di requisiti rigorosi di sovranità e sicurezza dei dati. Questa architettura risponde alla necessità di eseguire LLM potenti localmente all'interno della propria istanza GDC sicura.
Cosa è incluso: questa architettura copre il deployment di modelli con pesi aperti (come Gemma 4, Llama, DeepSeek, Mistral) utilizzando i backend di distribuzione vLLM o Ollama. Include l'utilizzo di Kubernetes per l'orchestrazione, Harbor per l'archiviazione degli artefatti, volumi permanenti per i pesi del modello, policy di rete (NetworkPolicy / ProjectNetworkPolicy) per la sicurezza di rete e Open WebUI come frontend del browser facoltativo.
Cosa non è incluso: questa architettura non copre i servizi AI Gateway gestiti, i modelli proprietari come il modello Gemini di Google, i processi di ottimizzazione dei modelli o i modelli di AI generativa per altre modalità come la generazione di immagini.
Pubblico: il pubblico principale di questo documento include gli amministratori della piattaforma responsabili del deployment e della gestione dei servizi su GDC e gli architetti tecnici che progettano soluzioni di AI nell'ambiente con air gap. Gli utenti finali e gli sviluppatori che interagiranno con i modelli di cui è stato eseguito il deployment sono segmenti di pubblico secondari che traggono vantaggio dalla comprensione della struttura sottostante.
Architettura
La soluzione esegue il deployment di vLLM, Ollama o entrambi come backend di gestione delle inferenze containerizzati (Deployment) all'interno di un cluster standard. I pesi del modello sono archiviati su volumi permanenti che vengono compilati dalla workstation tramite un caricatore di modelli Pod. I Service Kubernetes di tipo LoadBalancer espongono le API di backend, gli oggetti NetworkPolicy / ProjectNetworkPolicy ne proteggono l'accesso e Open WebUI può essere facoltativamente distribuito come frontend del browser per le API compatibili con OpenAI.
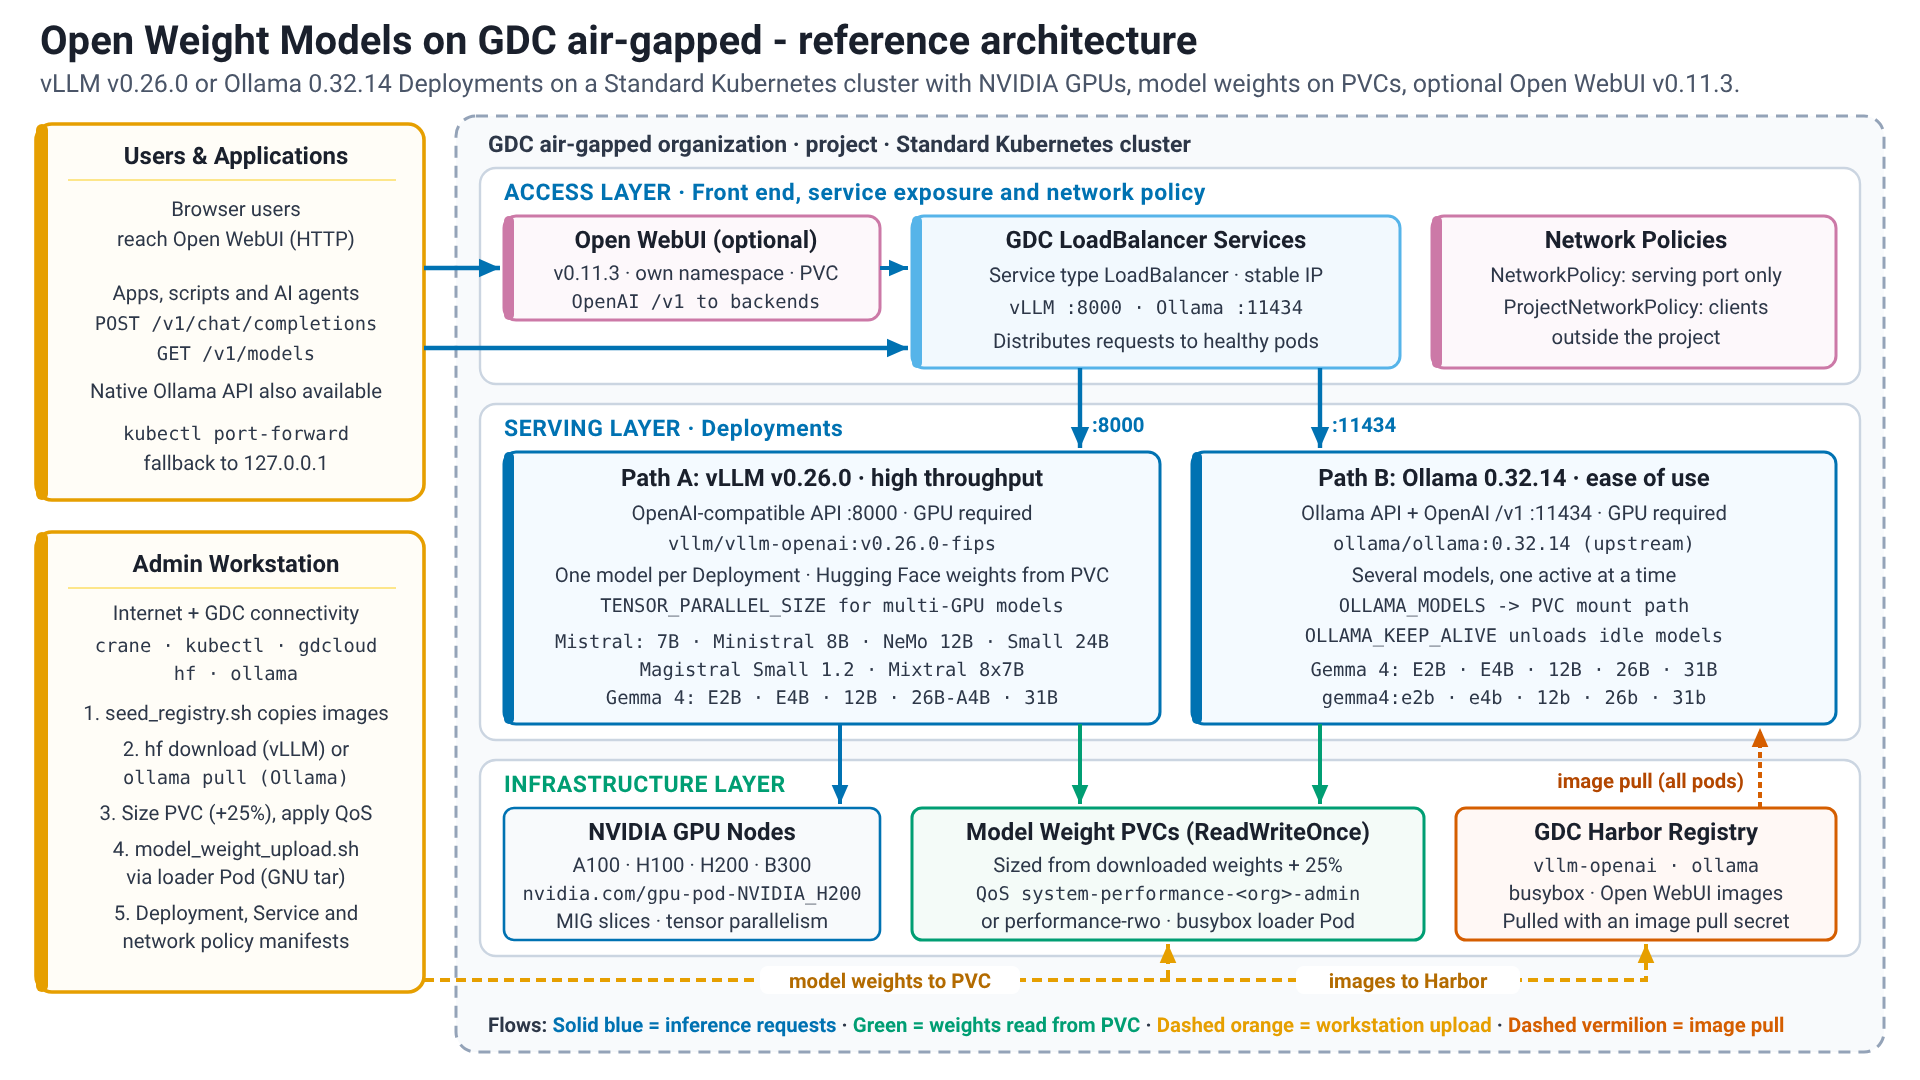
Componenti della soluzione
La soluzione utilizza i seguenti componenti:
| Componente della soluzione | Responsabilità | Flusso di dati | Interfacce |
|---|---|---|---|
| Zona cliente GDC con air gap | Ospita i cluster Kubernetes, il networking e l'infrastruttura di archiviazione | Piattaforma di base | Interfacce di gestione dell'infrastruttura per l'I/O. API Kubernetes per amministratori e utenti della piattaforma |
| Bilanciatore del carico | Espone i pod di distribuzione LLM (vLLM, Ollama) al traffico proveniente dall'esterno del cluster Kubernetes, fornendo un indirizzo IP stabile. | Le richieste dei client esterni vengono inviate all'IP esterno del LoadBalancer. Il bilanciatore del carico distribuisce le richieste tra i pod di backend integri (vLLM o Ollama) in base al selettore del servizio. | API Kubernetes Service. Esegue automaticamente il provisioning di un bilanciatore del carico di rete all'interno dell'ambiente GDC. |
| vLLM | Servizio di inferenza LLM con throughput elevato. Ottimizzato per una bassa latenza utilizzando tecniche come PagedAttention. In genere gestisce un modello per istanza. | Riceve richieste di inferenza HTTP dai client. Carica i pesi del modello dal PVC montato. Esegue calcoli sulle GPU collegate. Restituisce risposte HTTP con testo generato. | API RESTful compatibile con OpenAI per l'inferenza. Accetta richieste JSON. |
| Ollama | Gestione dell'inferenza LLM, progettata per essere facile da usare; un'istanza può gestire diversi modelli e caricarli on demand. | Riceve richieste di inferenza HTTP. Carica i modelli dal PVC montato (OLLAMA_MODELS). Esegue i calcoli sulle GPU collegate. Restituisce risposte HTTP. I modelli vengono scaricati dopo un periodo di inattività configurabile (OLLAMA_KEEP_ALIVE). |
API RESTful Ollama e API compatibile con OpenAI (/v1). Accetta richieste JSON. Dispone anche di un'interfaccia a riga di comando. |
| GPU NVIDIA e MIG | Forniscono l'accelerazione hardware per l'inferenza LLM. | I backend LLM (vLLM, Ollama) trasferiscono i calcoli intensivi del modello (come le moltiplicazioni di matrici) alle GPU per accelerare l'inferenza. MIG consente di partizionare una singola GPU per utilizzarla con più istanze di modelli più piccoli. | Esposta come tipo di risorsa in Kubernetes (ad esempio, nvidia.com/gpu-pod-NVIDIA_H200; il nome esatto della risorsa dipende dal modello di GPU installato e viene rilevato dai nodi). I pod richiedono queste risorse |
| Harbor | Archivia e gestisce in modo sicuro le immagini container per vLLM, Ollama, Open WebUI e qualsiasi pod helper (come busybox) | Le immagini container vengono copiate dai registri pubblici in Harbor con seed_registry.sh (crane) da una workstation con accesso a internet. I nodi Kubernetes eseguono il pull di queste immagini da Harbor per eseguire i container. |
API Docker Registry. I nodi Kubernetes interagiscono con Harbor per eseguire il pull delle immagini durante la creazione dei pod. Gli utenti interagiscono utilizzando crane, l'interfaccia a riga di comando Docker o l'interfaccia utente di Harbor per eseguire il push delle immagini. |
| Richieste di volumi permanenti | Fornisce archiviazione permanente per i pesi dei modelli LLM, disaccoppiata dai cicli di vita dei pod. | I file del modello vengono scaricati sulla workstation, utilizzati per calcolare dinamicamente le dimensioni del PVC con un overhead del 25% e trasmessi in streaming nel volume permanente tramite un pod di caricamento del modello temporaneo (busybox) con model_weight_upload.sh. Il PVC viene eseguito il provisioning con performance-rwo dove è abilitata l'archiviazione a blocchi ad alte prestazioni; in caso contrario, un operatore dell'infrastruttura applica la policy QoS system-performance-<org>-admin al volume di backup. Entrambe le opzioni forniscono 30 IOPS per GiB (minimo 6148 IOPS). Entrambi i backend leggono i pesi del modello da questo volume montato all'avvio: vLLM carica la directory del modello Hugging Face, Ollama punta OLLAMA_MODELS al percorso di montaggio. Non viene utilizzato kubectl cp e non vengono raggruppati modelli nelle immagini container. |
API Storage di Kubernetes. Definiti in YAML (ReadWriteOnce) e montati nei pod come volumi. |
| Policy di rete | Imponi l'isolamento della rete e controlla il flusso di traffico verso i servizi LLM. Uno spazio dei nomi NetworkPolicy (networking.k8s.io/v1) ammette il traffico alla porta di distribuzione dall'interno del cluster; è inoltre richiesto un ProjectNetworkPolicy (networking.gdc.goog/v1) per l'accesso dall'esterno del progetto. |
Il traffico di rete da e verso i pod all'interno dello spazio dei nomi viene ispezionato. Le regole della policy stabiliscono se le connessioni alle porte del servizio LLM (ad esempio 8000 per vLLM, 11434 per Ollama) sono consentite, in genere in base agli intervalli IP di origine o ad altre etichette. | API Kubernetes networking.k8s.io/v1 e networking.gdc.goog/v1. Definito in YAML. |
| Open WebUI | Frontend facoltativo basato su browser per gli utenti finali. Comunica con le API compatibili con OpenAI di vLLM e Ollama; non contiene pesi del modello e non richiede un acceleratore. | Gli utenti accedono a Open WebUI tramite il relativo servizio Kubernetes. Open WebUI inoltra le richieste di chat ai servizi vLLM e Ollama tramite l'API /v1 compatibile con OpenAI e mantiene il proprio stato (utenti, chat, impostazioni) su un volume permanente. |
HTTP (browser) verso gli utenti, API REST compatibile con OpenAI verso i backend. Workload stateful di cui è stato eseguito il deployment nel proprio spazio dei nomi. |
Caratteristiche e funzionalità
Questa architettura di riferimento offre le seguenti funzionalità principali:
- Erogazione di LLM con pesi aperti: consente l'hosting e l'inferenza di vari modelli con pesi aperti (ad esempio Gemma 4, Llama, DeepSeek, Mistral).
- Componenti: backend di gestione LLM (vLLM, Ollama), deployment/pod Kubernetes.
- Responsabilità: caricamento dei pesi del modello, gestione del processo di inferenza, esecuzione dei modelli su acceleratori hardware ed esposizione degli endpoint.
- Interfacce: API REST (compatibili con OpenAI per vLLM e Ollama, oltre all'API specifica di Ollama) per le richieste di inferenza, in genere utilizzando JSON.
- Bring Your Own Model (BYOM): gli utenti possono importare ed eseguire il deployment degli LLM open weight scelti nell'ambiente con air gap.
- Componenti: Harbor, richieste di volumi permanenti, pod del caricatore di modelli, Kubernetes.
- Responsabilità: archiviazione sicura delle immagini container e dei pesi del modello. Meccanismo per trasferire i modelli nell'ambiente (
model_weight_upload.shtramite il pod del caricatore) e renderli accessibili ai motori di gestione. - Interfacce: API Docker Registry (per Harbor), API Kubernetes (per PVC e montaggi di volumi).
- Inferenza con accelerazione hardware: utilizza le GPU NVIDIA all'interno del cluster GDC per eseguire le inferenze LLM in modo efficiente.
- Componenti: GPU NVIDIA, Kubernetes, plug-in dei dispositivi.
- Responsabilità: pianificazione dei pod sui nodi con risorse GPU.
Esposizione dell'hardware GPU ai container di backend LLM. Supporta la GPU multi-istanza (MIG) per il partizionamento e il parallelismo dei tensori multi-GPU (
TENSOR_PARALLEL_SIZE) per modelli di grandi dimensioni come Mixtral 8x7Bbf16. - Interfacce: API Kubernetes (per richiedere risorse GPU come
nvidia.com/gpu-pod-NVIDIA_H200onvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE).
- Accesso controllato alla rete: garantisce che l'accesso agli endpoint di inferenza LLM sia controllato e isolato all'interno dell'ambiente GDC.
- Componenti: servizi Kubernetes (LoadBalancer), NetworkPolicy, ProjectNetworkPolicy.
- Responsabilità: esposizione dei servizi di inferenza utilizzando un IP stabile. Definizione e applicazione di regole di rete per consentire o negare il traffico ai backend LLM in base a origine, destinazione e porte.
- Interfacce: API Kubernetes (per servizi, NetworkPolicy e ProjectNetworkPolicy).
- Scalabilità: consente di regolare la capacità in base alla domanda.
- Componenti: deployment Kubernetes.
- Responsabilità: abilitare la scalabilità orizzontale aumentando il numero di repliche per i pod di backend LLM. Scalabilità verticale tramite la modifica di richieste/limiti di risorse.
- Interfacce: API Kubernetes (per la gestione delle repliche e delle risorse del deployment).
- Frontend del browser (facoltativo): consente agli utenti finali di chattare con i modelli di cui è stato eseguito il deployment senza scrivere chiamate API.
- Componenti: deployment, servizio e richiesta di volume permanente di Open WebUI.
- Responsabilità: presentare l'erogazione dei modelli forniti da vLLM e Ollama in un'unica interfaccia; rendere persistenti utenti, chat e impostazioni.
- Interfacce: HTTP (browser); API
/v1compatibile con OpenAI verso i backend.
Principi di architettura
- Sicurezza innanzitutto: tutti i componenti e i dati risiedono all'interno del confine di GDC con air gap, garantendo la massima sicurezza e il massimo controllo dei dati. L'accesso alla rete è limitato utilizzando gli oggetti
NetworkPolicyeProjectNetworkPolicy. - Sovranità dei dati: i clienti mantengono il controllo completo sui propri modelli e dati, senza necessità di connettività esterna per il funzionamento.
- Aperta e flessibile: l'architettura utilizza backend di distribuzione open source (vLLM, Ollama) e supporta una varietà di LLM con pesi aperti, offrendo ai clienti la possibilità di scegliere ed evitando il vendor lock-in per il motore di inferenza.
- Disaccoppiamento dei componenti: le funzioni chiave come l'archiviazione dei modelli (PVC), la gestione delle immagini (Harbor), l'inferenza (pod vLLM/Ollama) e l'interfaccia utente (Open WebUI) sono componenti distinti, il che consente la gestione e gli aggiornamenti indipendenti.
- Scalabilità e prestazioni: progettato per scalare sia orizzontalmente, aumentando il numero di repliche dei pod, sia verticalmente, regolando le risorse CPU/GPU (incluso il parallelismo dei tensori multi-GPU) per soddisfare le esigenze di prestazioni. vLLM è scelto per scenari con throughput elevato e bassa latenza.
- Ottimizzazione delle risorse: supporta la GPU multi-istanza (MIG) NVIDIA per consentire ai modelli più piccoli di condividere le risorse GPU in modo efficiente e il dimensionamento dinamico del PVC (+25% di overhead) abbinato alla QoS di archiviazione ad alte prestazioni per eliminare l'overprovisioning dello spazio di archiviazione senza sacrificare la velocità di caricamento del modello.
- Interfacce standard: basate sugli standard Kubernetes per l'orchestrazione, il deployment e l'esposizione dei servizi. Gli endpoint di inferenza forniscono API REST, con vLLM e Ollama che offrono compatibilità con OpenAI.
- Resilienza: utilizza i controlli di integrità e la replica di Kubernetes per garantire la disponibilità del servizio.
Considerazioni
- Scalabilità e prestazioni:
- La scalabilità orizzontale si ottiene aumentando il numero di repliche nel deployment Kubernetes sia per vLLM che per Ollama. Senza una StorageClass
ReadOnlyMany, un deployment del modello è limitato a una replica (il volume del modello èReadWriteOnce); la capacità aggiuntiva proviene quindi da deployment aggiuntivi, ciascuno con la propria PVC. - La scalabilità verticale prevede l'allocazione di più CPU/memoria e di sezioni di GPU più grandi, fino a GPU complete o al parallelismo dei tensori multi-GPU (
TENSOR_PARALLEL_SIZE) su più GPU nello stesso nodo. - vLLM gestisce un modello per istanza, richiedendo nuovi deployment per modelli aggiuntivi. Ollama può pubblicare diversi modelli da un'istanza; in queste guide, ogni deployment Ollama pubblica un modello.
- La PVC di ogni modello viene dimensionata dinamicamente in base ai pesi scaricati con un overhead del 25% e configurata con la policy QoS di archiviazione ad alte prestazioni (
system-performance-<org>-admin, 30 IOPS per GiB con un minimo di 6148 IOPS operformance-rwodove è abilitata l'archiviazione a blocchi ad alte prestazioni) in modo che i tempi di caricamento del modello non vengano limitati dal limite predefinito distandard-rwo3 IOPS per GiB.
- La scalabilità orizzontale si ottiene aumentando il numero di repliche nel deployment Kubernetes sia per vLLM che per Ollama. Senza una StorageClass
- Gestione delle risorse:
- Un'attenta pianificazione delle risorse GPU è essenziale. NVIDIA MIG può essere utilizzato per partizionare le GPU per modelli più piccoli, migliorando l'utilizzo, mentre i modelli più grandi (come Mixtral 8x7B in
bf16) possono eseguire lo sharding dei pesi su più GPU utilizzando il parallelismo dei tensori. - È necessario allocare CPU e memoria adeguate per gestire l'overhead di inferenza e gestione dei modelli; vLLM e Ollama gestiscono i modelli con l'accelerazione GPU.
- È necessario eseguire il provisioning di spazio di archiviazione sufficiente per i PVC per adattarsi alle dimensioni del modello e garantire le prestazioni.
- Un'attenta pianificazione delle risorse GPU è essenziale. NVIDIA MIG può essere utilizzato per partizionare le GPU per modelli più piccoli, migliorando l'utilizzo, mentre i modelli più grandi (come Mixtral 8x7B in
- Disponibilità e affidabilità:
- I deployment Kubernetes offrono funzionalità di auto-riparazione e aggiornamento in sequenza.
- I servizi LoadBalancer distribuiscono il traffico tra i pod integri, mascherando gli errori dei singoli pod.
- L'archiviazione dei pesi del modello su PVC garantisce la persistenza durante i riavvii dei pod.
- Complessità operativa:
- Gestione delle immagini container per backend e versioni diversi in Harbor.
- Procedure per trasferire in modo sicuro i pesi del modello nell'ambiente con air gap.
- Creazione e gestione dei manifest Kubernetes (deployment, servizi, PVC, policy di rete) per ogni modello e backend.
- Monitoraggio dell'utilizzo della GPU, della latenza di inferenza e dei tassi di errore.
- Sicurezza e conformità:
- L'intera soluzione opera all'interno del perimetro di sicurezza di GDC con air gap.
- Le policy di rete sono obbligatorie per applicare un isolamento di rete rigoroso e controllare l'accesso agli endpoint LLM: uno spazio dei nomi
NetworkPolicyper l'accesso all'interno del cluster e unProjectNetworkPolicyper l'accesso dall'esterno del progetto. - Gli account robot Harbor e i secret di pull delle immagini Kubernetes garantiscono un accesso sicuro alle immagini container.
- Le policy di rete limitano i client che possono raggiungere gli endpoint. I dati at-rest sulle PVC si basano sulla crittografia dello spazio di archiviazione di GDC.
Decisioni di progettazione
Per questa architettura di riferimento sono state prese le seguenti decisioni chiave di progettazione:
Decisione 1: offrire sia vLLM che Ollama anziché un unico backend di distribuzione
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Offrire un backend di distribuzione (vLLM o Ollama) o entrambi. | Offri entrambe le opzioni, perché gli utenti e i casi d'uso differiscono nei requisiti di prestazioni, compatibilità con le API e facilità di gestione dei modelli. | vLLM offre un servizio con throughput elevato e bassa latenza, oltre alla compatibilità con l'API OpenAI, adatto per le applicazioni di produzione. Ollama offre una configurazione più semplice, una gestione più facile di più modelli e una maggiore facilità d'uso, il che lo rende più adatto allo sviluppo e alla sperimentazione. Il supporto di entrambi i tipi di route offre flessibilità. |
Decisione 2: pesi del modello su PersistentVolumeClaim
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| vLLM e Ollama richiedono i pesi del modello nel file system in fase di runtime. In un ambiente con air gap, i modelli non possono essere scaricati on demand. | Archivia i pesi di ogni modello nel proprio PersistentVolumeClaim ReadWriteOnce, compilato dalla workstation tramite un pod di caricamento temporaneo del modello. |
I PersistentVolumeClaim forniscono un livello di archiviazione permanente e resiliente per i file di modelli di grandi dimensioni, disaccoppiato dal ciclo di vita del pod di inferenza. In questo modo i modelli possono essere caricati rapidamente all'avvio del pod. |
Decisione 3: pesi del modello su PersistentVolume per Ollama (pod del loader) anziché raggrupparli nell'immagine
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Ollama può scaricare i modelli, ma ciò richiede l'accesso a internet, che non è disponibile negli ambienti con air gap. Il raggruppamento dei modelli in un'immagine Ollama personalizzata richiede invece la ricostruzione di un'immagine per ogni modello e l'archiviazione di immagini di più GB in Harbor. | Ollama utilizza lo stesso flusso di lavoro del pod del caricatore di vLLM: il modello viene scaricato sulla workstation (da ollama pull a ollama_model_weight_download.sh), trasmesso in streaming nel PVC tramite il pod del caricatore del modello con model_weight_upload.sh (GNU tar) e OLLAMA_MODELS viene indirizzato al percorso di montaggio. |
Un unico workflow per entrambi i backend; i modelli possono essere aggiunti o aggiornati senza dover ricreare le immagini; l'immagine Ollama upstream non modificata rimane di piccole dimensioni in Harbor. |
Decisione 4: esposizione di vLLM e Ollama utilizzando i servizi LoadBalancer rispetto a nessun bilanciatore del carico
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Le API LLM devono essere accessibili alle applicazioni all'interno dell'ambiente GDC. | Esponi ogni backend tramite un servizio di tipo LoadBalancer, l'approccio standard di Kubernetes. Questo si basa sul provisioning del bilanciatore del carico della piattaforma GDC con air gap. |
I servizi Kubernetes di tipo LoadBalancer forniscono un metodo standard e affidabile per esporre i backend LLM, fornendo un indirizzo IP stabile e distribuendo il carico. |
Decisione 5: Applicazione delle politiche di rete obbligatorie (NetworkPolicy e ProjectNetworkPolicy)
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| La sicurezza e l'isolamento sono fondamentali nei deployment GDC con air gap. | Applica policy di rete su ogni endpoint LLM (uno spazio dei nomi NetworkPolicy che ammette solo la porta di distribuzione, integrato da un ProjectNetworkPolicy quando i client esterni al progetto hanno bisogno di accedere) per migliorare la security posture dei servizi LLM di cui è stato eseguito il deployment. |
Gli oggetti NetworkPolicy forniscono un modo nativo di Kubernetes per applicare l'isolamento della rete a livello di spazio dei nomi, mentre gli oggetti ProjectNetworkPolicy lo estendono al confine del progetto, garantendo che solo il traffico autorizzato possa raggiungere i servizi LLM. |
Decisione 6: dimensionamento ottimale dinamico del PVC (+25% di overhead) abbinato alla policy QoS di archiviazione ad alte prestazioni
| Contesto | Decisione chiave | Rationale |
|---|---|---|
La classe di archiviazione standard-rwo predefinita applica la policy di QoS adattiva di ONTAP standard-<org>-admin (3,072 IOPS per TiB o 3 IOPS per GiB, con un limite minimo di 75 IOPS). Il dimensionamento di un PVC standard-rwo in base alle dimensioni del peso di un modello limita le letture sequenziali del peso a 5-21 MBps, mentre l'overprovisioning di PVC statici da 300 a 500 GiB spreca spazio di archiviazione, limitando comunque il throughput di lettura sequenziale a circa 60 MBps. |
Scarica prima i pesi del modello, calcola dinamicamente GDCS_MODEL_PVC_SIZE dalla directory scaricata con un overhead del 25% arrotondato per eccesso al GiB intero successivo e utilizza storageClassName: performance-rwo dove è abilitata l'archiviazione a blocchi ad alte prestazioni oppure chiedi a un operatore dell'infrastruttura di applicare la policy QoS system-performance-${GDC_ORG}-admin al volume di backup. |
La policy QoS system-performance-<org>-admin fornisce 30,720 IOPS per TiB (30 IOPS per GiB, 10 volte superiore a standard) con un floor minimo di 6,148 IOPS (ceiling ONTAP di ~393 MBps) per qualsiasi volume fino a 204 GiB. L'abbinamento del dimensionamento dinamico con overhead del 25% con system-performance elimina l'overprovisioning dello spazio di archiviazione da 3x a 40x (da 12Gi a 109Gi invece che da 100Gi a 500Gi), aumentando al contempo la velocità di lettura sequenziale di KubeVirt virtio-scsi con LUN singolo a circa 150 MBps (avvio del modello da 2,5x a 30x più veloce). |
Ipotesi e limitazioni
- È disponibile l'ambiente GDC con air gap 1.16.2 hotfix 1 (
1.16.2-gdch.1353-1) o versioni successive (i node pool GPU nei cluster standard richiedono questa release; le release precedenti offrono GPU solo nei cluster condivisi). - Nel cluster standard sono presenti risorse hardware sufficienti (incluse le GPU NVIDIA). Sia vLLM che Ollama richiedono una GPU.
- L'istanza Harbor è configurata e accessibile.
- È disponibile una workstation con accesso a internet e connettività all'ambiente GDC (API Harbor e Kubernetes) per il seeding delle immagini e il caricamento dei pesi del modello.
- Gli utenti dispongono delle autorizzazioni necessarie: i ruoli di progetto Harbor Instance Viewer e Standard Cluster Admin, oltre a un StandardClusterRoleBinding (cluster-admin) sul cluster standard, consulta gli SRI.
- I modelli sono compatibili con i backend di distribuzione scelti (vLLM/Ollama).
- Limitazione: il PVC dei pesi del modello è
ReadWriteOnce; senza una StorageClassReadOnlyMany, ogni deployment del modello è limitato a una replica.
Flusso utente
Di seguito è riportato un flusso utente completo per il deployment di modelli linguistici di grandi dimensioni (LLM) con pesi aperti in ambienti con air gap di Google Distributed Cloud (GDC). Il flusso è suddiviso in configurazione comune, due percorsi di deployment (vLLM e Ollama), un frontend facoltativo e convalida finale.
1. Configurazione comune: gestione delle immagini
Prima di eseguire il deployment di qualsiasi LLM, devi configurare il modo in cui l'ambiente GDC eseguirà il pull delle immagini container dal tuo registry Harbor privato.
- Crea account robot Harbor: genera account robot nell'interfaccia utente di Harbor: uno con autorizzazioni di push per
crane(seeding delle immagini) e uno con autorizzazioni di pull per il secret di pull delle immagini Kubernetes. - Autentica le immagini di Crane e Seed: utilizza le credenziali dell'account robot per accedere ad Harbor da una workstation con accesso a internet (
crane auth login) e copia le immagini container richieste (busybox,ollama/ollama,vllm/vllm-openai, facoltativamente Open WebUI) in Harbor conseed_registry.sh. - Crea un secret Kubernetes: crea un secret docker-registry nello spazio dei nomi del workload utilizzando kubectl per archiviare le credenziali dell'account robot di pull che il cluster deve utilizzare.
2. Percorso di deployment A: vLLM per un throughput elevato
Questo percorso è consigliato per l'inferenza di modelli orientati alle prestazioni come Mistral 7B Instruct su GPU.
- Acquisisci l'immagine: esegui il seeding dell'immagine vLLM (
vllm/vllm-openai:v0.26.0) in Harbor conseed_registry.sh, quindi crea ed esegui il push del tag dell'immagine con patchv0.26.0-fipscome descritto nell'SRI. - Prepara lo spazio di archiviazione del modello:
- Scarica i pesi da Hugging Face sulla workstation (
hf download). - Calcola la dimensione della PVC richiesta dai pesi scaricati (con un overhead del 25%), crea una richiesta di volume permanente (PVC)
ReadWriteOnceper archiviare i pesi del modello e applica la policy QoS ad alte prestazioni. - Avvia un pod di caricamento temporaneo del modello (
busybox) che monta il PVC e trasmetti i pesi al suo interno conmodel_weight_upload.sh(GNU tar sukubectl exec;kubectl cpnon viene utilizzato perché BusyBox tar non può leggere le sue intestazioni PAX per file di dimensioni superiori a 8 GiB), quindi elimina il pod di caricamento.
- Scarica i pesi da Hugging Face sulla workstation (
- Esegui il deployment del backend: applica un manifest di deployment Kubernetes che fa riferimento all'immagine vLLM, richiede la risorsa dell'acceleratore rilevata dai nodi (ad esempio
nvidia.com/gpu-pod-NVIDIA_H200) e monta il PVC dei pesi del modello. - Esponi il servizio: crea un servizio LoadBalancer per fornire un IP esterno per l'API vLLM.
- Rete sicura: applica un NetworkPolicy dello spazio dei nomi per consentire il traffico in entrata sulla porta di servizio (8000); aggiungi un ProjectNetworkPolicy quando i client esterni al progetto devono accedere.
3. Percorso di deployment B: Ollama per facilità d'uso
Questo percorso si concentra su una configurazione semplificata. Utilizza l'immagine Ollama upstream invariata e lo stesso workflow del caricatore di modelli di vLLM.
- Immagine di origine: copia l'immagine Ollama upstream (
ollama/ollama:0.32.14) in Harbor conseed_registry.sh. - Prepara lo spazio di archiviazione del modello:
- Esegui il pull del modello (ad esempio
gemma4:e4b) sulla workstation conollama_model_weight_download.sh, che esegue unollama servelocale temporaneo conOLLAMA_MODELSche punta alla directory di download. - Calcola la dimensione del PVC richiesta dai pesi scaricati (con un overhead del 25%), crea un PVC
ReadWriteOnce, applica la policy QoS ad alte prestazioni e avvia un pod di caricamento del modello temporaneo che lo monta. - Carica la directory di download nella PVC con
model_weight_upload.sh, quindi elimina il pod del caricatore.
- Esegui il pull del modello (ad esempio
- Esegui il deployment ed esponi: crea un deployment Ollama con
OLLAMA_MODELSindirizzato al percorso di montaggio della PVC (richiedendo la risorsa acceleratore scoperta dai nodi) e un servizio LoadBalancer. - Rete sicura: applica un NetworkPolicy dello spazio dei nomi per la porta Ollama (11434); aggiungi un ProjectNetworkPolicy quando i client esterni al progetto devono accedere.
4. (Facoltativo) Apri la WebUI
- Esegui il deployment di Open WebUI: inserisci l'immagine Open WebUI in Harbor ed eseguine il deployment nel proprio spazio dei nomi con archiviazione permanente per il suo stato; indirizzala agli endpoint
/v1compatibili con OpenAI del servizio vLLM, del servizio Ollama o di entrambi. I passaggi sono descritti nella guida dell'utente di Open WebUI per i modelli con pesi aperti.
5. Convalida e test
Una volta eseguito il deployment, i passaggi finali prevedono la verifica del funzionamento dei servizi.
- Controlla lo stato: verifica che i pod siano in esecuzione e che ai servizi siano stati assegnati indirizzi IP esterni.
- Testa l'inferenza:
- vLLM: invia una richiesta curl all'IP del bilanciatore del carico vLLM utilizzando gli endpoint
/v1/modelse/v1/chat/completionscompatibili con OpenAI. - Ollama: invia una richiesta curl all'IP del bilanciatore del carico Ollama utilizzando gli stessi endpoint
/v1/modelse/v1/chat/completionscompatibili con OpenAI.
- vLLM: invia una richiesta curl all'IP del bilanciatore del carico vLLM utilizzando gli endpoint
- Fallback del port forwarding: se l'IP del bilanciatore del carico non è raggiungibile dalla workstation (ad esempio perché non è ancora presente un ProjectNetworkPolicy), utilizza
kubectl port-forwardper il servizio e invia le stesse richieste a127.0.0.1.
6. Operazioni e scalabilità
- Scalabilità verticale: aumenta le sezioni di GPU o passa a configurazioni multi-GPU per modelli più grandi.
- Scalabilità orizzontale: aumenta il numero di repliche nel deployment (richiede un volume del modello
ReadOnlyMany) o esegui il deployment di altri deployment del modello per gestire più richieste utente contemporanee. - Risoluzione dei problemi: monitora i log utilizzando
kubectl logse verifica la presenza di problemi comuni, come errori di diagnostica automatica FIPS o limitazioni delle policy di rete.
I passaggi dettagliati sono riportati nell'implementazione di riferimento dei modelli open weight con Ollama, nell'implementazione di riferimento dei modelli open weight con vLLM e nelle relative guide dell'utente.
Materiali aggiuntivi
- Modelli con pesi aperti con implementazione di riferimento Ollama
- Modelli con pesi aperti con implementazione di riferimento vLLM
- Gemma 4 E4B with Ollama user guide
- [SUG] Mistral 7B Instruct con vLLM su GDC air-gapped
- [SUG] Mistral NeMo 12B Instruct con vLLM su GDC con air gap
- [SUG] Mistral Small 3.2 24B Instruct con vLLM su GDC con air gap
- [SUG] Ministral 8B Instruct con vLLM su GDC con air gap
- [SUG] Mixtral 8x7B Instruct con vLLM su GDC con air gap
- [SUG] Magistral Small 1.2 24B con vLLM su GDC air-gapped
- Guida dell'utente di Open WebUI per i modelli con pesi aperti
- Documentazione di vLLM
- Ollama
- Open WebUI
- Documentazione di Google Distributed Cloud con air gap