


Pernyataan masalah
Organisasi yang beroperasi di lingkungan air-gapped menghadapi tantangan yang signifikan: mereka memerlukan model bahasa besar, tetapi dilarang keras terhubung ke API berbasis cloud eksternal karena protokol keamanan yang ketat. Untuk menjembatani kesenjangan ini, pelanggan tersebut memerlukan ekosistem yang tangguh dan mandiri yang mampu menghosting dan mengelola model open weight langsung di infrastruktur Google Distributed Cloud (GDC) dengan air gap mereka. Deployment yang dilokalkan ini sangat penting untuk mempertahankan kedaulatan data absolut, sehingga memastikan informasi sensitif tidak pernah keluar dari lokasi fisik. Dengan mengintegrasikan lingkungan eksekusi yang aman dengan backend inferensi, pengguna dapat menggunakan kemampuan AI tingkat lanjut sekaligus mempertahankan kontrol administratif penuh atas data, bobot model, dan postur keamanan internal mereka.
Meskipun Gemini di GDC menyediakan kemampuan frontier yang canggih dan terkelola, pelanggan sering kali men-deploy model open-weight seperti Gemma 4 atau Llama 4 untuk mendapatkan perincian dan kontrol yang lebih besar. Men-deploy model open-weight di lingkungan GDC dengan air-gap menawarkan keunggulan biaya yang signifikan dibandingkan layanan eksklusif terkelola. Dengan memiliki bobot model, organisasi menghilangkan biaya API per token berulang, yang dapat menjadi penghalang untuk workload otomatis bervolume tinggi. Selain itu, model bobot terbuka memungkinkan kuantisasi (misalnya, 4-bit atau 8-bit), sehingga penalaran berperforma tinggi dapat dijalankan pada jejak hardware yang lebih kecil dan lebih murah di edge. Pengoptimalan vertikal ini, yang dikombinasikan dengan kemampuan untuk berbagi infrastruktur di beberapa aplikasi internal tanpa biaya lisensi tambahan, menghasilkan Total Biaya Kepemilikan (TCO) yang jauh lebih rendah untuk operasi inferensi skala besar yang berkelanjutan.
Solusi yang diusulkan
Dokumen ini menguraikan arsitektur referensi untuk men-deploy dan mengelola Model Bahasa Besar (LLM) berbobot terbuka di lingkungan Google Distributed Cloud (GDC) dengan air gap. Banyak pelanggan, terutama di sektor yang sangat diatur, tidak dapat menggunakan API LLM berbasis cloud karena persyaratan kedaulatan dan keamanan data yang ketat. Arsitektur ini memenuhi kebutuhan untuk menjalankan LLM yang canggih secara lokal dalam instance GDC yang aman.
Yang disertakan: Arsitektur ini mencakup deployment model open-weight (seperti Gemma 4, Llama, DeepSeek, Mistral) menggunakan backend inferensi
vLLM atau Ollama. Solusi ini mencakup penggunaan Kubernetes untuk
orkestrasi, Harbor untuk penyimpanan artefak, Persistent Volume untuk bobot
model, kebijakan jaringan (NetworkPolicy / ProjectNetworkPolicy) untuk keamanan
jaringan, dan Open WebUI sebagai frontend browser opsional.
Yang tidak disertakan: Arsitektur ini tidak mencakup layanan AI Gateway terkelola, model eksklusif seperti Gemini Google, proses penyesuaian model, atau model GenAI untuk modalitas lain seperti pembuatan gambar.
Audiens: Audiens utama untuk dokumen ini mencakup Administrator Platform yang bertanggung jawab untuk men-deploy dan mengelola layanan di GDC, serta technical architect yang merancang solusi AI dalam lingkungan air gap. Pengguna akhir dan developer yang akan berinteraksi dengan model yang di-deploy adalah audiens sekunder yang mendapatkan manfaat dari pemahaman struktur yang mendasarinya.
Arsitektur
Solusi ini men-deploy vLLM, Ollama, atau keduanya sebagai backend penyaluran inferensi dalam container (Deployment) dalam cluster standar. Bobot model disimpan di Persistent Volume yang diisi dari workstation melalui loader model Pod. Service Kubernetes berjenis LoadBalancer mengekspos API backend, objek NetworkPolicy / ProjectNetworkPolicy mengamankan akses ke API tersebut, dan Open WebUI dapat di-deploy secara opsional sebagai frontend browser untuk API yang kompatibel dengan OpenAI.
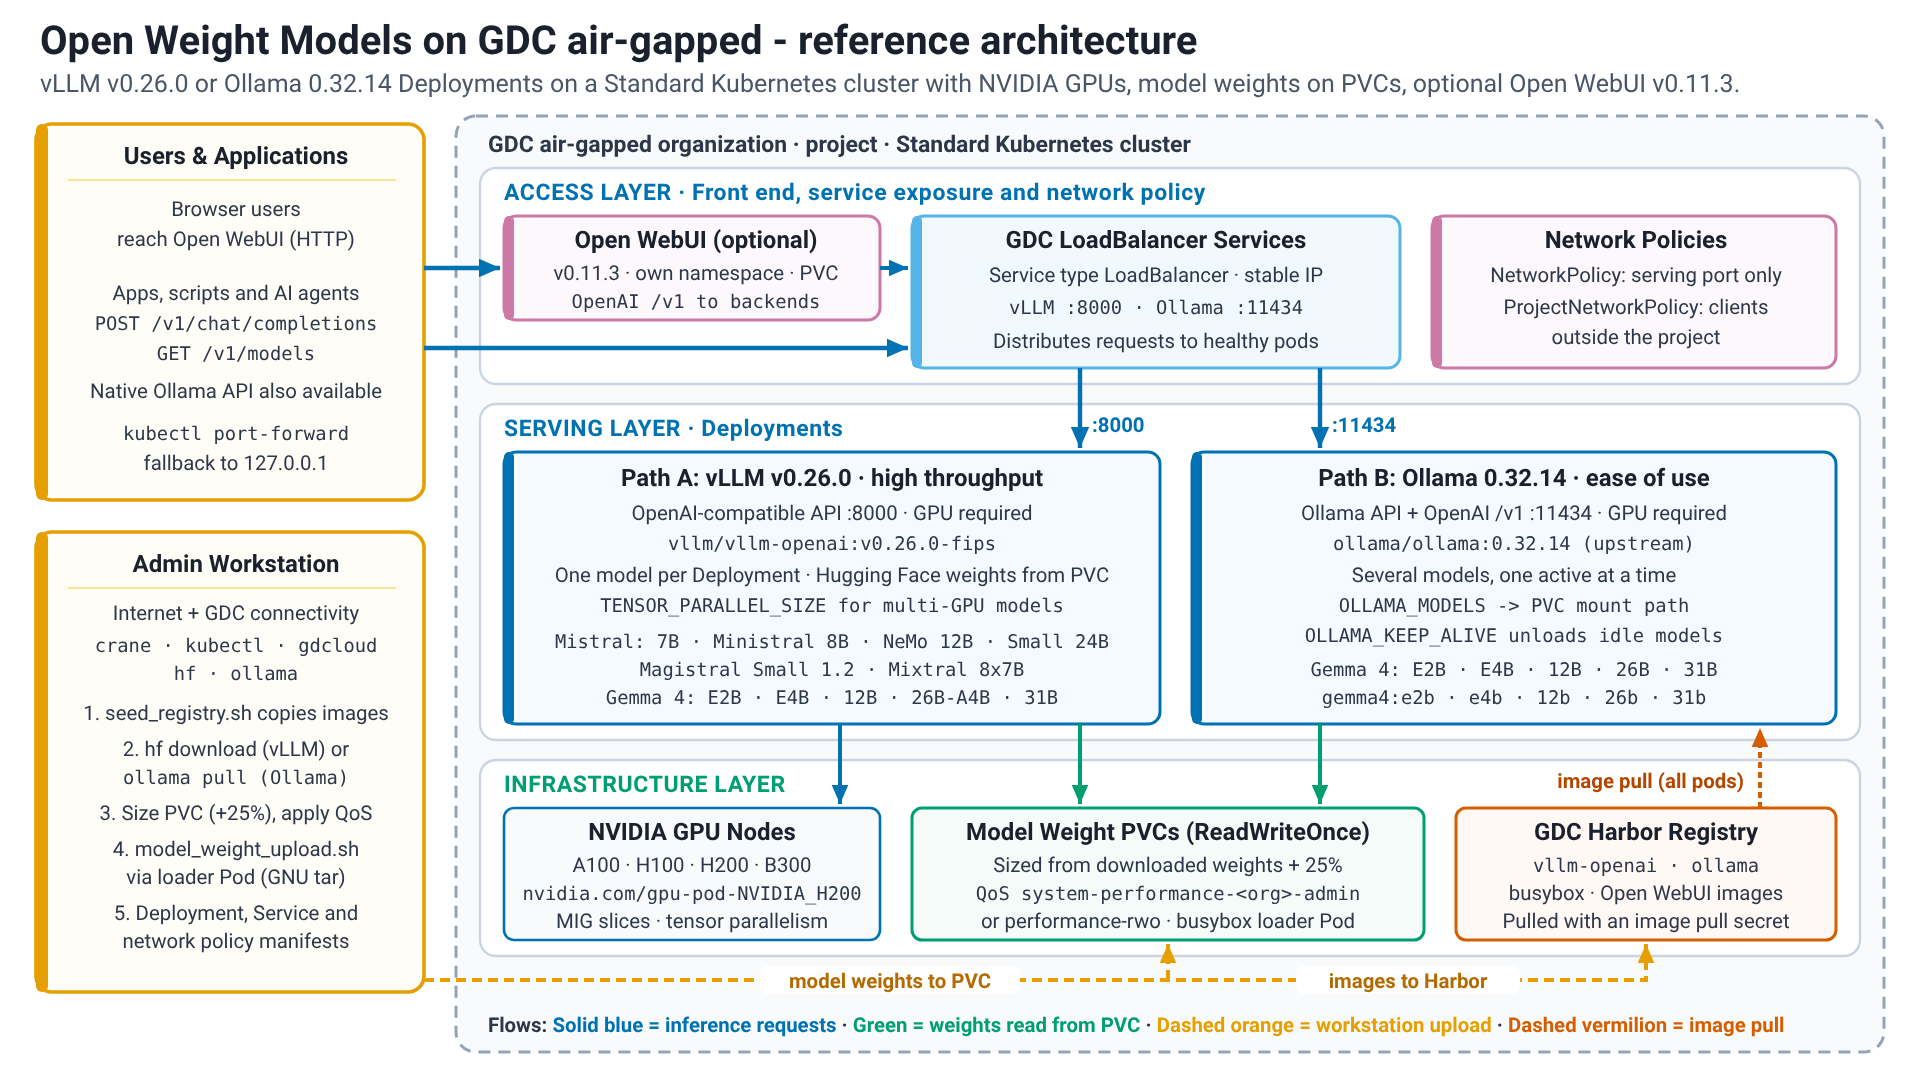
Komponen solusi
Solusi ini menggunakan komponen berikut:
| Komponen Solusi | Tanggung Jawab | Aliran Data | Antarmuka |
|---|---|---|---|
| Zona pelanggan GDC dengan air gap | Menghosting cluster Kubernetes, jaringan, dan infrastruktur penyimpanan | Platform Dasar | Antarmuka pengelolaan infrastruktur untuk IO. Kubernetes API untuk Administrator Platform dan pengguna |
| Load Balancer | Mengekspos pod penyaluran LLM (vLLM, Ollama) ke traffic dari luar cluster Kubernetes, sehingga memberikan alamat IP yang stabil. | Permintaan klien eksternal dikirim ke IP Eksternal LoadBalancer. LoadBalancer mendistribusikan permintaan di seluruh pod backend yang responsif (vLLM atau Ollama) berdasarkan pemilih Service | Kubernetes Service API. Menyediakan load balancer jaringan secara otomatis dalam lingkungan GDC. |
| vLLM | Inferensi LLM dengan throughput tinggi. Dioptimalkan untuk latensi rendah menggunakan teknik seperti PagedAttention. Biasanya menyajikan satu model per instance. | Menerima permintaan inferensi HTTP dari klien. Memuat bobot model dari PVC yang terpasang. Melakukan komputasi pada GPU yang terpasang. Menampilkan respons HTTP dengan teks yang dihasilkan. | RESTful API yang kompatibel dengan OpenAI untuk inferensi. Menerima permintaan JSON. |
| Ollama | Layanan inferensi LLM, yang dirancang untuk kemudahan penggunaan; satu instance dapat melayani beberapa model dan memuatnya sesuai permintaan. | Menerima permintaan inferensi HTTP. Memuat model dari PVC yang terpasang (OLLAMA_MODELS). Melakukan komputasi pada GPU yang terpasang. Menampilkan respons HTTP. Model akan dihapus setelah periode tidak aktif yang dapat dikonfigurasi (OLLAMA_KEEP_ALIVE). |
RESTful API Ollama dan API yang kompatibel dengan OpenAI (/v1). Menerima permintaan JSON. Juga memiliki CLI. |
| GPU NVIDIA dan MIG | Menyediakan akselerasi hardware untuk inferensi LLM. | Backend LLM (vLLM, Ollama) mengalihkan komputasi model yang intensif (seperti perkalian matriks) ke GPU untuk mempercepat inferensi. MIG memungkinkan partisi satu GPU untuk digunakan oleh beberapa instance model yang lebih kecil. | Diekspos sebagai jenis resource di Kubernetes (misalnya, nvidia.com/gpu-pod-NVIDIA_H200; nama resource yang tepat bergantung pada model GPU yang diinstal dan ditemukan dari node). Pod meminta resource ini |
| Harbor | Menyimpan dan mengelola image container dengan aman untuk vLLM, Ollama, Open WebUI, dan pod bantuan apa pun (seperti busybox) | Image container disalin dari registry publik ke Harbor dengan seed_registry.sh (crane) dari workstation dengan akses internet. Node Kubernetes mengambil image ini dari Harbor untuk menjalankan container. |
Docker Registry API. Node Kubernetes berinteraksi dengan Harbor untuk mengambil image selama pembuatan pod. Pengguna berinteraksi menggunakan crane, Docker CLI, atau antarmuka pengguna Harbor untuk mengirim image. |
| Klaim Volume Persisten | Menyediakan penyimpanan persisten untuk bobot model LLM, yang dipisahkan dari siklus proses pod. | File model didownload di workstation, digunakan untuk menghitung ukuran PVC secara dinamis dengan overhead 25%, dan di-streaming ke Persistent Volume melalui Pod pemuat model sementara (busybox) dengan model_weight_upload.sh. PVC disediakan dengan performance-rwo tempat block storage berperforma tinggi diaktifkan; jika tidak, Operator Infrastruktur akan menerapkan kebijakan QoS system-performance-<org>-admin ke volume pendukungnya. Kedua opsi ini memberikan 30 IOPS per GiB (batas minimum 6.148 IOPS). Kedua backend membaca bobot modelnya dari volume yang terpasang ini saat startup: vLLM memuat direktori model Hugging Face, Ollama mengarahkan OLLAMA_MODELS ke jalur pemasangan. Tidak ada kubectl cp yang digunakan dan tidak ada model yang dipaketkan ke dalam image container. |
API penyimpanan Kubernetes. Didefinisikan dalam YAML (ReadWriteOnce) dan dipasang ke pod sebagai volume. |
| Kebijakan Jaringan | Menerapkan isolasi jaringan dan mengontrol alur traffic ke layanan LLM. Namespace NetworkPolicy (networking.k8s.io/v1) mengizinkan traffic ke port penyaluran dari dalam cluster; ProjectNetworkPolicy (networking.gdc.goog/v1) juga diperlukan untuk akses dari luar project. |
Traffic jaringan ke dan dari pod dalam namespace diperiksa. Aturan kebijakan menentukan apakah koneksi ke port layanan LLM (misalnya, 8000 untuk vLLM, 11434 untuk Ollama) diizinkan, biasanya berdasarkan rentang IP sumber atau label lainnya. | Kubernetes API networking.k8s.io/v1 dan networking.gdc.goog/v1. Didefinisikan dalam YAML. |
| Open WebUI | Frontend opsional berbasis browser untuk pengguna akhir. Berkomunikasi dengan API vLLM dan Ollama yang kompatibel dengan OpenAI; tidak memiliki bobot model dan tidak memerlukan akselerator. | Pengguna menjangkau Open WebUI melalui Service Kubernetes-nya. Open WebUI meneruskan permintaan chat ke Layanan vLLM dan Ollama melalui API /v1 yang kompatibel dengan OpenAI dan mempertahankan statusnya sendiri (pengguna, chat, setelan) di Persistent Volume. |
HTTP (browser) untuk pengguna, REST API yang kompatibel dengan OpenAI untuk backend. Workload stateful yang di-deploy di namespace-nya sendiri. |
Fitur dan kemampuan
Arsitektur referensi ini menyediakan kemampuan inti berikut:
- Penyajian LLM Open Weight: Memungkinkan hosting dan inferensi berbagai model open weight (misalnya, Gemma 4, Llama, DeepSeek, Mistral).
- Komponen: Backend Penyajian LLM (vLLM, Ollama), Deployment/Pod Kubernetes.
- Tanggung jawab: Memuat bobot model, mengelola proses inferensi, menjalankan model pada akselerator hardware, dan mengekspos endpoint.
- Antarmuka: REST API (kompatibel dengan OpenAI untuk vLLM dan Ollama, serta API khusus Ollama) untuk permintaan inferensi, biasanya menggunakan JSON.
- Bring Your Own Model (BYOM): Pengguna dapat mengimpor dan men-deploy LLM open weight pilihan mereka ke lingkungan air-gapped.
- Komponen: Harbor, Persistent Volume Claims, Pod pemuat model, Kubernetes.
- Tanggung jawab: Penyimpanan yang aman untuk image container dan bobot model. Mekanisme untuk mentransfer model ke lingkungan
(
model_weight_upload.shmelalui Pod loader) dan membuatnya dapat diakses oleh mesin inferensi. - Antarmuka: Docker Registry API (untuk Harbor), Kubernetes API (untuk PVC dan pemasangan volume).
- Akselerasi Hardware untuk Inferensi: Menggunakan GPU NVIDIA dalam cluster GDC untuk menjalankan inferensi LLM secara efisien.
- Komponen: GPU NVIDIA, Kubernetes, Plugin Perangkat.
- Tanggung jawab: Menjadwalkan pod pada node dengan resource GPU.
Mengekspos hardware GPU ke container backend LLM. Mendukung
Multi-Instance GPU (MIG) untuk partisi dan paralelisme tensor multi-GPU (
TENSOR_PARALLEL_SIZE) untuk model besar seperti Mixtral 8x7Bbf16. - Antarmuka: Kubernetes API (untuk meminta resource GPU seperti
nvidia.com/gpu-pod-NVIDIA_H200ataunvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE).
- Akses yang Dikontrol Jaringan: Memastikan bahwa akses ke endpoint inferensi LLM dikontrol dan diisolasi dalam lingkungan GDC.
- Komponen: Service Kubernetes (LoadBalancer), NetworkPolicy, ProjectNetworkPolicy.
- Tanggung jawab: Mengekspos layanan inferensi menggunakan IP yang stabil. Menentukan dan menerapkan aturan jaringan untuk mengizinkan atau menolak traffic ke backend LLM berdasarkan sumber, tujuan, dan port.
- Antarmuka: Kubernetes API (untuk Services, NetworkPolicy, dan ProjectNetworkPolicy).
- Penyajian yang Skalabel: Memungkinkan penyesuaian kapasitas berdasarkan permintaan.
- Komponen: Deployment Kubernetes.
- Tanggung jawab: Memungkinkan penskalaan horizontal dengan meningkatkan jumlah replika untuk pod backend LLM. Penskalaan vertikal dengan menyesuaikan permintaan/batas resource.
- Antarmuka: Kubernetes API (untuk mengelola replika dan resource Deployment).
- Browser Front End (opsional): Memungkinkan pengguna akhir melakukan chat dengan model yang di-deploy tanpa menulis panggilan API.
- Komponen: Deployment, Service, dan Persistent Volume Claim Open WebUI.
- Tanggung jawab: Menampilkan model yang disajikan oleh vLLM dan Ollama dalam satu antarmuka; mempertahankan pengguna, chat, dan setelan.
- Antarmuka: HTTP (browser); API
/v1yang kompatibel dengan OpenAI ke backend.
Prinsip arsitektur
- Mengutamakan Keamanan: Semua komponen dan residensi data berada dalam batas GDC dengan air gap, sehingga memastikan keamanan dan kontrol data yang maksimal. Akses jaringan dibatasi menggunakan objek
NetworkPolicydanProjectNetworkPolicy. - Kedaulatan Data: Pelanggan mempertahankan kontrol penuh atas model dan data mereka, tanpa memerlukan konektivitas eksternal untuk pengoperasian.
- Terbuka & Fleksibel: Arsitektur ini menggunakan backend penyaluran open source (vLLM, Ollama) dan mendukung berbagai LLM open weight, sehingga memberikan pilihan kepada pelanggan dan menghindari keterikatan pada vendor untuk mesin inferensi.
- Pemisahan Komponen: Fungsi utama seperti penyimpanan model (PVC), pengelolaan image (Harbor), inferensi (pod vLLM/Ollama), dan antarmuka pengguna (Open WebUI) adalah komponen yang berbeda, sehingga memungkinkan pengelolaan dan update independen.
- Skalabilitas & Performa: Dirancang untuk melakukan penskalaan secara horizontal dengan meningkatkan jumlah replika pod dan secara vertikal dengan menyesuaikan resource CPU/GPU (termasuk paralelisme tensor multi-GPU) untuk memenuhi permintaan performa. vLLM dipilih untuk skenario throughput tinggi dan latensi rendah.
- Pengoptimalan Resource: Mendukung Multi-Instance GPU (MIG) NVIDIA untuk memungkinkan model yang lebih kecil berbagi resource GPU secara efisien, dan ukuran PVC dinamis (overhead +25%) yang dipasangkan dengan QoS penyimpanan berperforma tinggi untuk menghilangkan penyediaan penyimpanan berlebih tanpa mengorbankan kecepatan pemuatan model.
- Antarmuka Standar: Dibuat berdasarkan standar Kubernetes untuk orkestrasi, deployment, dan eksposur layanan. Endpoint inferensi menyediakan REST API, dengan vLLM dan Ollama yang menawarkan kompatibilitas OpenAI.
- Ketahanan: Menggunakan health check dan replikasi Kubernetes untuk memastikan ketersediaan layanan.
Pertimbangan
- Skalabilitas dan Performa:
- Penskalaan horizontal dicapai dengan meningkatkan jumlah replika di Deployment Kubernetes untuk vLLM dan Ollama. Tanpa
ReadOnlyManyStorageClass, Deployment model dibatasi hingga satu replika (volume model adalahReadWriteOnce); kapasitas tambahan kemudian berasal dari Deployment tambahan, masing-masing dengan PVC-nya sendiri. - Penskalaan vertikal melibatkan alokasi lebih banyak CPU/memori dan slice GPU yang lebih besar, hingga GPU penuh atau paralelisme tensor multi-GPU (
TENSOR_PARALLEL_SIZE) di beberapa GPU pada node yang sama. - vLLM menyajikan satu model per instance, sehingga memerlukan Deployment baru untuk model tambahan. Ollama dapat menyajikan beberapa model dari satu instance; dalam panduan ini, setiap Deployment Ollama menyajikan satu model.
- PVC setiap model diukur secara dinamis dari bobot yang didownload dengan
overhead 25% dan dikonfigurasi dengan kebijakan QoS penyimpanan berperforma tinggi
(
system-performance-<org>-admin, 30 IOPS per GiB dengan batas minimum 6.148 IOPS, atauperformance-rwojika block storage berperforma tinggi diaktifkan) sehingga waktu pemuatan model tidak dibatasi oleh batas defaultstandard-rwo3 IOPS per GiB.
- Penskalaan horizontal dicapai dengan meningkatkan jumlah replika di Deployment Kubernetes untuk vLLM dan Ollama. Tanpa
- Pengelolaan Resource:
- Perencanaan resource GPU yang cermat sangatlah penting. NVIDIA MIG dapat digunakan
untuk mempartisi GPU untuk model yang lebih kecil, sehingga meningkatkan pemanfaatan, sementara
model yang lebih besar (seperti Mixtral 8x7B di
bf16) dapat melakukan sharding bobot di beberapa GPU menggunakan paralelisme tensor. - CPU dan memori yang memadai harus dialokasikan untuk menangani overhead inferensi dan pengelolaan model; vLLM dan Ollama menyajikan model dengan akselerasi GPU.
- Penyimpanan yang memadai harus disediakan untuk PVC guna mengakomodasi ukuran model dan memastikan performa.
- Perencanaan resource GPU yang cermat sangatlah penting. NVIDIA MIG dapat digunakan
untuk mempartisi GPU untuk model yang lebih kecil, sehingga meningkatkan pemanfaatan, sementara
model yang lebih besar (seperti Mixtral 8x7B di
- Ketersediaan dan Keandalan:
- Deployment Kubernetes menyediakan kemampuan pemulihan mandiri dan update berkelanjutan.
- Service LoadBalancer mendistribusikan traffic ke seluruh pod yang responsif, sehingga menyamarkan kegagalan pod individual.
- Menyimpan bobot model di PVC memastikan persistensi saat pod dimulai ulang.
- Kompleksitas Operasional:
- Mengelola image container untuk berbagai backend dan versi di Harbor.
- Prosedur untuk mentransfer bobot model dengan aman ke lingkungan air-gapped.
- Membuat dan mengelola manifes Kubernetes (Deployment, Service, PVC, kebijakan jaringan) untuk setiap model dan backend.
- Memantau pemakaian GPU, latensi inferensi, dan tingkat error.
- Keamanan dan Kepatuhan:
- Seluruh solusi beroperasi dalam perimeter keamanan GDC dengan air gap.
- Kebijakan jaringan wajib diterapkan untuk menerapkan isolasi jaringan yang ketat dan
mengontrol akses ke endpoint LLM: namespace
NetworkPolicyuntuk akses dalam cluster danProjectNetworkPolicyuntuk akses dari luar project. - Akun robot Harbor dan secret pull image Kubernetes memastikan akses yang aman ke image container.
- Kebijakan jaringan membatasi klien mana yang dapat menjangkau endpoint. Data dalam penyimpanan di PVC mengandalkan enkripsi penyimpanan GDC.
Keputusan desain
Keputusan desain utama berikut telah dibuat untuk arsitektur referensi ini:
Keputusan 1: Menawarkan vLLM dan Ollama, bukan satu backend inferensi
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Menawarkan satu backend inferensi (vLLM atau Ollama) atau keduanya. | Tawarkan keduanya, karena pengguna dan kasus penggunaan memiliki persyaratan yang berbeda untuk performa, kompatibilitas API, dan kemudahan pengelolaan model. | vLLM menyediakan penyaluran dengan throughput tinggi dan latensi rendah serta kompatibilitas API OpenAI, yang cocok untuk aplikasi produksi. Ollama menawarkan penyiapan yang lebih sederhana, pengelolaan beberapa model yang lebih mudah, dan kemudahan penggunaan, yang lebih baik untuk pengembangan dan eksperimen. Mendukung keduanya memberikan fleksibilitas. |
Keputusan 2: bobot model di PersistentVolumeClaim
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| vLLM dan Ollama memerlukan bobot model pada sistem file saat runtime. Dalam lingkungan dengan air-gap, model tidak dapat didownload sesuai permintaan. | Simpan bobot setiap model di PersistentVolumeClaim ReadWriteOnce-nya sendiri, yang diisi dari workstation melalui Pod pemuat model sementara. |
PersistentVolumeClaims menyediakan lapisan penyimpanan persisten yang tangguh untuk file model besar, yang dipisahkan dari siklus proses pod inferensi. Hal ini memungkinkan model dimuat dengan cepat saat pod dimulai. |
Keputusan 3: Bobot model di PersistentVolume untuk Ollama (Pod loader), bukan menggabungkannya dalam image
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Ollama dapat mendownload model, tetapi hal ini memerlukan akses internet, yang tidak tersedia di lingkungan dengan air gap. Menggabungkan model ke dalam image Ollama kustom memerlukan image yang di-build ulang untuk setiap model dan menyimpan image berukuran multi-GB di Harbor. | Ollama menggunakan alur kerja Pod loader yang sama dengan vLLM: model ditarik di workstation (ollama pull hingga ollama_model_weight_download.sh), di-streaming ke PVC melalui Pod loader model dengan model_weight_upload.sh (GNU tar), dan OLLAMA_MODELS diarahkan ke jalur pemasangan. |
Satu alur kerja untuk kedua backend; model dapat ditambahkan atau diperbarui tanpa membangun ulang image; image Ollama upstream yang tidak dimodifikasi tetap berukuran kecil di Harbor. |
Keputusan 4: Mengekspos vLLM dan Ollama menggunakan Service LoadBalancer versus tanpa load balancer
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| API LLM harus dapat diakses oleh aplikasi dalam lingkungan GDC. | Mengekspos setiap backend melalui Service jenis LoadBalancer, pendekatan standar Kubernetes. Hal ini bergantung pada penyediaan load balancer platform GDC dengan air gap. |
Service Kubernetes jenis LoadBalancer menyediakan metode standar dan andal untuk mengekspos backend LLM, yang menyediakan alamat IP stabil dan mendistribusikan beban. |
Keputusan 5: Menerapkan Kebijakan Jaringan Wajib (NetworkPolicy dan ProjectNetworkPolicy)
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Keamanan dan isolasi sangat penting dalam deployment GDC dengan air gap. | Terapkan kebijakan jaringan di setiap endpoint LLM (namespace NetworkPolicy yang hanya mengizinkan port inferensi, dilengkapi dengan ProjectNetworkPolicy saat klien di luar project memerlukan akses) untuk meningkatkan postur keamanan layanan LLM yang di-deploy. |
Objek NetworkPolicy menyediakan cara native Kubernetes untuk menerapkan isolasi jaringan di level namespace dan objek ProjectNetworkPolicy memperluasnya ke batas project, sehingga memastikan hanya traffic yang diizinkan yang dapat menjangkau layanan LLM. |
Keputusan 6: Penyesuaian Ukuran PVC Dinamis (+Overhead 25%) Dipasangkan dengan Kebijakan QoS Penyimpanan Performa Tinggi
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
StorageClass standard-rwo default menerapkan kebijakan QoS Adaptif ONTAP standard-<org>-admin (3,072 IOPS per TiB, atau 3 IOPS per GiB, dengan batas minimum 75 IOPS). Menentukan ukuran PVC standard-rwo secara ketat sesuai dengan ukuran bobot model akan membatasi pembacaan bobot berurutan menjadi 5 hingga 21 MBps, dan penyediaan berlebih PVC statis 300 hingga 500 GiB akan memboroskan penyimpanan sekaligus membatasi throughput pembacaan berurutan pada ~60 MBps. |
Download bobot model terlebih dahulu, hitung GDCS_MODEL_PVC_SIZE secara dinamis dari direktori yang didownload dengan overhead 25% yang dibulatkan ke atas ke GiB utuh berikutnya, dan gunakan storageClassName: performance-rwo tempat block storage berperforma tinggi diaktifkan, atau minta Operator Infrastruktur untuk menerapkan kebijakan QoS system-performance-${GDC_ORG}-admin ke volume pendukung. |
Kebijakan QoS system-performance-<org>-admin menyediakan 30,720 IOPS per TiB (30 IOPS per GiB, 10x lebih tinggi dari standard) dengan batas minimum 6,148 IOPS (batas ONTAP ~393 MBps) untuk volume apa pun hingga 204 GiB. Memasangkan ukuran overhead 25% dinamis dengan system-performance menghilangkan penyediaan penyimpanan berlebih 3x hingga 40x (12Gi hingga 109Gi, bukan 100Gi hingga 500Gi) sekaligus meningkatkan kecepatan baca berurutan virtio-scsi KubeVirt LUN tunggal menjadi ~150 MBps (startup model 2,5x hingga 30x lebih cepat). |
Asumsi dan batasan
- Lingkungan GDC dengan air gap 1.16.2 hotfix 1 (
1.16.2-gdch.1353-1) atau yang lebih baru tersedia (node pool GPU di cluster standar memerlukan rilis ini; rilis sebelumnya hanya menawarkan GPU di cluster bersama). - Resource hardware yang memadai (termasuk GPU NVIDIA) tersedia di cluster standar. vLLM dan Ollama memerlukan GPU.
- Instance Harbor telah disiapkan dan dapat diakses.
- Workstation dengan akses internet dan konektivitas ke lingkungan GDC (Harbor dan Kubernetes API) tersedia untuk melakukan seeding image dan mengupload bobot model.
- Pengguna memiliki izin yang diperlukan: peran project Harbor Instance Viewer dan Standard Cluster Admin serta StandardClusterRoleBinding (cluster-admin) pada cluster standar, lihat SRI.
- Model kompatibel dengan backend inferensi yang dipilih (vLLM/Ollama).
- Batasan: PVC bobot model adalah
ReadWriteOnce; tanpa StorageClassReadOnlyMany, setiap Deployment model dibatasi hingga satu replika.
Alur penggunaan
Berikut adalah alur pengguna yang komprehensif untuk men-deploy Model Bahasa Besar (LLM) berbobot terbuka di lingkungan Google Distributed Cloud (GDC) dengan air gap. Alur ini dibagi menjadi penyiapan umum, dua jalur deployment (vLLM dan Ollama), frontend opsional, dan validasi akhir.
1. Penyiapan umum: pengelolaan gambar
Sebelum men-deploy LLM apa pun, Anda harus mengonfigurasi cara lingkungan GDC akan mengambil image container dari registry Harbor pribadi Anda.
- Membuat Akun Robot Harbor: Buat akun robot di UI Harbor:
satu dengan izin push untuk
crane(penyemaian image) dan satu dengan izin pull untuk secret pull image Kubernetes. - Mengautentikasi image crane dan seed: Gunakan kredensial akun robot untuk
login ke Harbor dari workstation dengan akses internet
(
crane auth login) dan salin image container yang diperlukan (busybox,ollama/ollama,vllm/vllm-openai, secara opsional Open WebUI) ke Harbor denganseed_registry.sh. - Membuat Secret Kubernetes: Buat secret docker-registry di namespace workload menggunakan kubectl untuk menyimpan kredensial akun robot pull yang akan digunakan cluster.
2. Jalur deployment A: vLLM untuk throughput tinggi
Jalur ini direkomendasikan untuk menyajikan model yang berorientasi pada performa seperti Mistral 7B Instruct di GPU.
- Dapatkan Image: Masukkan image vLLM (
vllm/vllm-openai:v0.26.0) ke Harbor denganseed_registry.sh, lalu build dan kirim tag image yang telah di-patchv0.26.0-fipsseperti yang dijelaskan dalam SRI. - Menyiapkan Penyimpanan Model:
- Download bobot dari Hugging Face di workstation (
hf download). - Hitung ukuran PVC yang diperlukan dari bobot yang didownload (dengan overhead 25%), buat Persistent Volume Claim (PVC)
ReadWriteOnceuntuk menyimpan bobot model, dan terapkan kebijakan QoS berperforma tinggi. - Mulai Pod pemuat model sementara (
busybox) yang memasang PVC dan melakukan streaming bobot ke dalamnya denganmodel_weight_upload.sh(GNU tar melaluikubectl exec;kubectl cptidak digunakan karena BusyBox tar tidak dapat membaca header PAX-nya untuk file yang lebih besar dari 8 GiB), lalu hapus Pod pemuat.
- Download bobot dari Hugging Face di workstation (
- Men-deploy Backend: Terapkan manifes Deployment Kubernetes yang mereferensikan
image vLLM, meminta resource akselerator yang ditemukan dari node
(misalnya,
nvidia.com/gpu-pod-NVIDIA_H200), dan memasang PVC bobot model. - Mengekspos Service: Buat layanan LoadBalancer untuk menyediakan IP eksternal bagi API vLLM.
- Jaringan Aman: Terapkan NetworkPolicy namespace untuk mengizinkan traffic masuk di port layanan (8000); tambahkan ProjectNetworkPolicy saat klien di luar project memerlukan akses.
3. Jalur deployment B: Ollama untuk kemudahan penggunaan
Jalur ini berfokus pada penyiapan yang disederhanakan. Model ini menggunakan image Ollama upstream yang tidak diubah dan alur kerja pemuat model yang sama seperti vLLM.
- Gambar Seed: Salin image Ollama upstream (
ollama/ollama:0.32.14) ke Harbor denganseed_registry.sh. - Menyiapkan Penyimpanan Model:
- Tarik model (misalnya,
gemma4:e4b) di workstation denganollama_model_weight_download.sh, yang menjalankanollama servelokal sementara denganOLLAMA_MODELSyang mengarah ke direktori download. - Hitung ukuran PVC yang diperlukan dari bobot yang didownload (dengan overhead 25%), buat PVC
ReadWriteOnce, terapkan kebijakan QoS berperforma tinggi, dan mulai Pod pemuat model sementara yang memasangnya. - Upload direktori download ke PVC dengan
model_weight_upload.sh, lalu hapus Pod loader.
- Tarik model (misalnya,
- Deploy & Ekspos: Buat Deployment Ollama dengan
OLLAMA_MODELSyang mengarah ke jalur pemasangan PVC (meminta resource akselerator yang ditemukan dari node) dan layanan LoadBalancer. - Jaringan Aman: Terapkan NetworkPolicy namespace untuk port Ollama (11434); tambahkan ProjectNetworkPolicy saat klien di luar project memerlukan akses.
4. Opsional: buka WebUI
- Men-deploy Open WebUI: Masukkan image Open WebUI ke Harbor dan deploy
di namespace-nya sendiri dengan penyimpanan persisten untuk statusnya; arahkan ke
endpoint
/v1yang kompatibel dengan OpenAI dari Layanan vLLM, Layanan Ollama, atau keduanya. Langkah-langkahnya ada di panduan pengguna Open WebUI untuk Model Open Weight.
5. Validasi dan pengujian
Setelah di-deploy, langkah terakhir adalah memverifikasi bahwa layanan berfungsi.
- Periksa Status: Pastikan pod Berjalan dan layanan telah diberi alamat IP eksternal.
- Inferensi Pengujian:
- vLLM: Kirim permintaan curl ke IP LoadBalancer vLLM menggunakan endpoint
/v1/modelsdan/v1/chat/completionsyang kompatibel dengan OpenAI. - Ollama: Kirim permintaan curl ke IP LoadBalancer Ollama menggunakan endpoint
/v1/modelsdan/v1/chat/completionsyang kompatibel dengan OpenAI.
- vLLM: Kirim permintaan curl ke IP LoadBalancer vLLM menggunakan endpoint
- Penggantian penerusan port: Jika IP LoadBalancer tidak dapat dijangkau dari workstation (misalnya karena belum ada ProjectNetworkPolicy), gunakan
kubectl port-forwardke Service dan kirim permintaan yang sama ke127.0.0.1.
6. Operasi dan penskalaan
- Penskalaan Vertikal: Tingkatkan slice GPU atau beralih ke konfigurasi multi-GPU untuk model yang lebih besar.
- Penskalaan Horizontal: Tingkatkan jumlah replika dalam deployment
(memerlukan volume model
ReadOnlyMany) atau deploy Deployment model tambahan untuk menangani lebih banyak permintaan pengguna serentak. - Pemecahan masalah: Pantau log menggunakan
kubectl logsdan periksa masalah umum seperti kegagalan uji mandiri FIPS atau batasan kebijakan jaringan.
Langkah-langkah mendetailnya ada dalam implementasi referensi Model Bobot Terbuka dengan Ollama, implementasi referensi Model Bobot Terbuka dengan vLLM, dan panduan pengguna masing-masing.
Materi tambahan
- Implementasi referensi Model Bobot Terbuka dengan Ollama
- Model Bobot Terbuka dengan implementasi referensi vLLM
- Panduan pengguna Gemma 4 E4B dengan Ollama
- [SUG] Mistral 7B Instruct dengan vLLM di GDC dengan air gap
- [SUG] Mistral NeMo 12B Instruct dengan vLLM di GDC dengan air gap
- [SUG] Mistral Small 3.2 24B Instruct dengan vLLM di GDC dengan air gap
- [SUG] Ministral 8B Instruct dengan vLLM di GDC dengan air gap
- [SUG] Mixtral 8x7B Instruct dengan vLLM di GDC dengan air gap
- [SUG] Mistral Small 1.2 24B dengan vLLM di GDC dengan air gap
- Panduan pengguna Open WebUI untuk Model Bobot Terbuka
- Dokumentasi vLLM
- Ollama
- Open WebUI
- Dokumentasi Google Distributed Cloud dengan air gap