


תיאור הבעיה
ארגונים שפועלים בסביבות עם air gap מתמודדים עם אתגר משמעותי: הם צריכים מודלים גדולים של שפה (LLM), אבל אסור להם להתחבר לממשקי API חיצוניים שמבוססים-ענן בגלל פרוטוקולי אבטחה מחמירים. כדי לגשר על הפער הזה, הלקוחות האלה צריכים סביבה חזקה ועצמאית שמאפשרת לארח ולנהל מודלים פתוחים ישירות בתשתית של Google Distributed Cloud (GDC) עם air gap. פריסה מקומית זו חיונית לשמירה על ריבונות הנתונים המוחלטת, כדי להבטיח שמידע רגיש לא ייצא מהמקום הפיזי. השילוב של סביבות הרצה מאובטחות עם שירותי בקצה העורפי מאפשר למשתמשים להשתמש ביכולות מתקדמות של AI, ועדיין לשמור על שליטה ניהולית מלאה בנתונים, במשקלי המודלים ובמצב האבטחה הפנימי שלהם.
Gemini ב-GDC מספק יכולות מתקדמות ומנוהלות, אבל הלקוחות בדרך כלל פורסים מודלים עם משקלים פתוחים כמו Gemma 4 או Llama 4 כדי לקבל רמת פירוט ושליטה גבוהה יותר. פריסת מודלים פתוחים בסביבות GDC עם air gap מציעה יתרונות משמעותיים מבחינת עלויות בהשוואה לשירותים מנוהלים קנייניים. כשמשקלי המודל נמצאים בבעלות הארגון, הוא לא צריך לשלם עמלות API חוזרות לכל טוקן, שיכולות להיות גבוהות מאוד בעומסי עבודה אוטומטיים בנפח גדול. בנוסף, מודלים פתוחים מאפשרים כימות (לדוגמה, 4 ביט או 8 ביט), כך שאפשר להריץ הסקת מסקנות עם ביצועים גבוהים על חומרה קטנה וזולה יותר בקצה. האופטימיזציה האנכית הזו, בשילוב עם היכולת לשתף תשתית בין כמה אפליקציות פנימיות בלי עלויות רישוי נוספות, מובילה לעלות בעלות כוללת (TCO) נמוכה משמעותית לפעולות הסקה מתמשכות בקנה מידה גדול.
הצעה לפתרון
במאמר הזה מוסבר על ארכיטקטורת העזר לפריסה ולניהול של מודלי שפה גדולים (LLM) עם משקלים פתוחים בסביבות עם פער אוויר של Google Distributed Cloud (GDC). לקוחות רבים, במיוחד במגזרים עם רגולציה מחמירה, לא יכולים להשתמש בממשקי API של LLM מבוססי-ענן בגלל דרישות מחמירות של אבטחה וריבונות הנתונים. הארכיטקטורה הזו נותנת מענה לצורך להריץ מודלים גדולים של שפה (LLM) באופן מקומי במכונה מאובטחת של GDC.
מה כלול: הארכיטקטורה הזו כוללת פריסה של מודלים עם פרמטרים שזמינים לכולם (כמו Gemma 4, Llama, DeepSeek, Mistral) באמצעות הקצה העורפי של vLLM או Ollama. הוא כולל שימוש ב-Kubernetes לתזמור, ב-Harbor לאחסון פריטי מידע שנוצרו בתהליך הפיתוח (Artifact), ב-Persistent Volumes למשקלי מודלים, במדיניות רשת ב-Kubernetes (NetworkPolicy / ProjectNetworkPolicy) לאבטחת רשת וב-Open WebUI כממשק אופציונלי לדפדפן.
מה לא כלול: הארכיטקטורה הזו לא כוללת שירותים מנוהלים של שער AI, מודלים קנייניים כמו Gemini של Google, תהליכים של כוונון מודלים או מודלים של GenAI לאופנים אחרים כמו יצירת תמונות.
קהל היעד: קהל היעד העיקרי של המסמך הזה כולל מנהלי פלטפורמות שאחראים לפריסה ולניהול של שירותים ב-GDC, ואדריכלים טכניים שמתכננים פתרונות AI בסביבה עם air gap. משתמשי קצה ומפתחים שישתמשו במודלים שנפרסו הם קהלים משניים, שיכולים להפיק תועלת מהבנת המבנה הבסיסי.
ארכיטקטורה
הפתרון פורס את vLLM, את Ollama או את שניהם כ-backend להצגת הסקות בקונטיינרים (Deployment) בתוך אשכול רגיל. משקלי המודלים מאוחסנים בנפחי אחסון קבועים שמאוכלסים מתחנת העבודה באמצעות טוען מודלים Pod. Service של Kubernetes מסוג LoadBalancer חושפים את ממשקי ה-API לקצה העורפי, אובייקטים של NetworkPolicy / ProjectNetworkPolicy מאבטחים את הגישה אליהם, ואפשר לפרוס את Open WebUI כקצה קדמי של דפדפן לממשקי ה-API שתואמים ל-OpenAI.
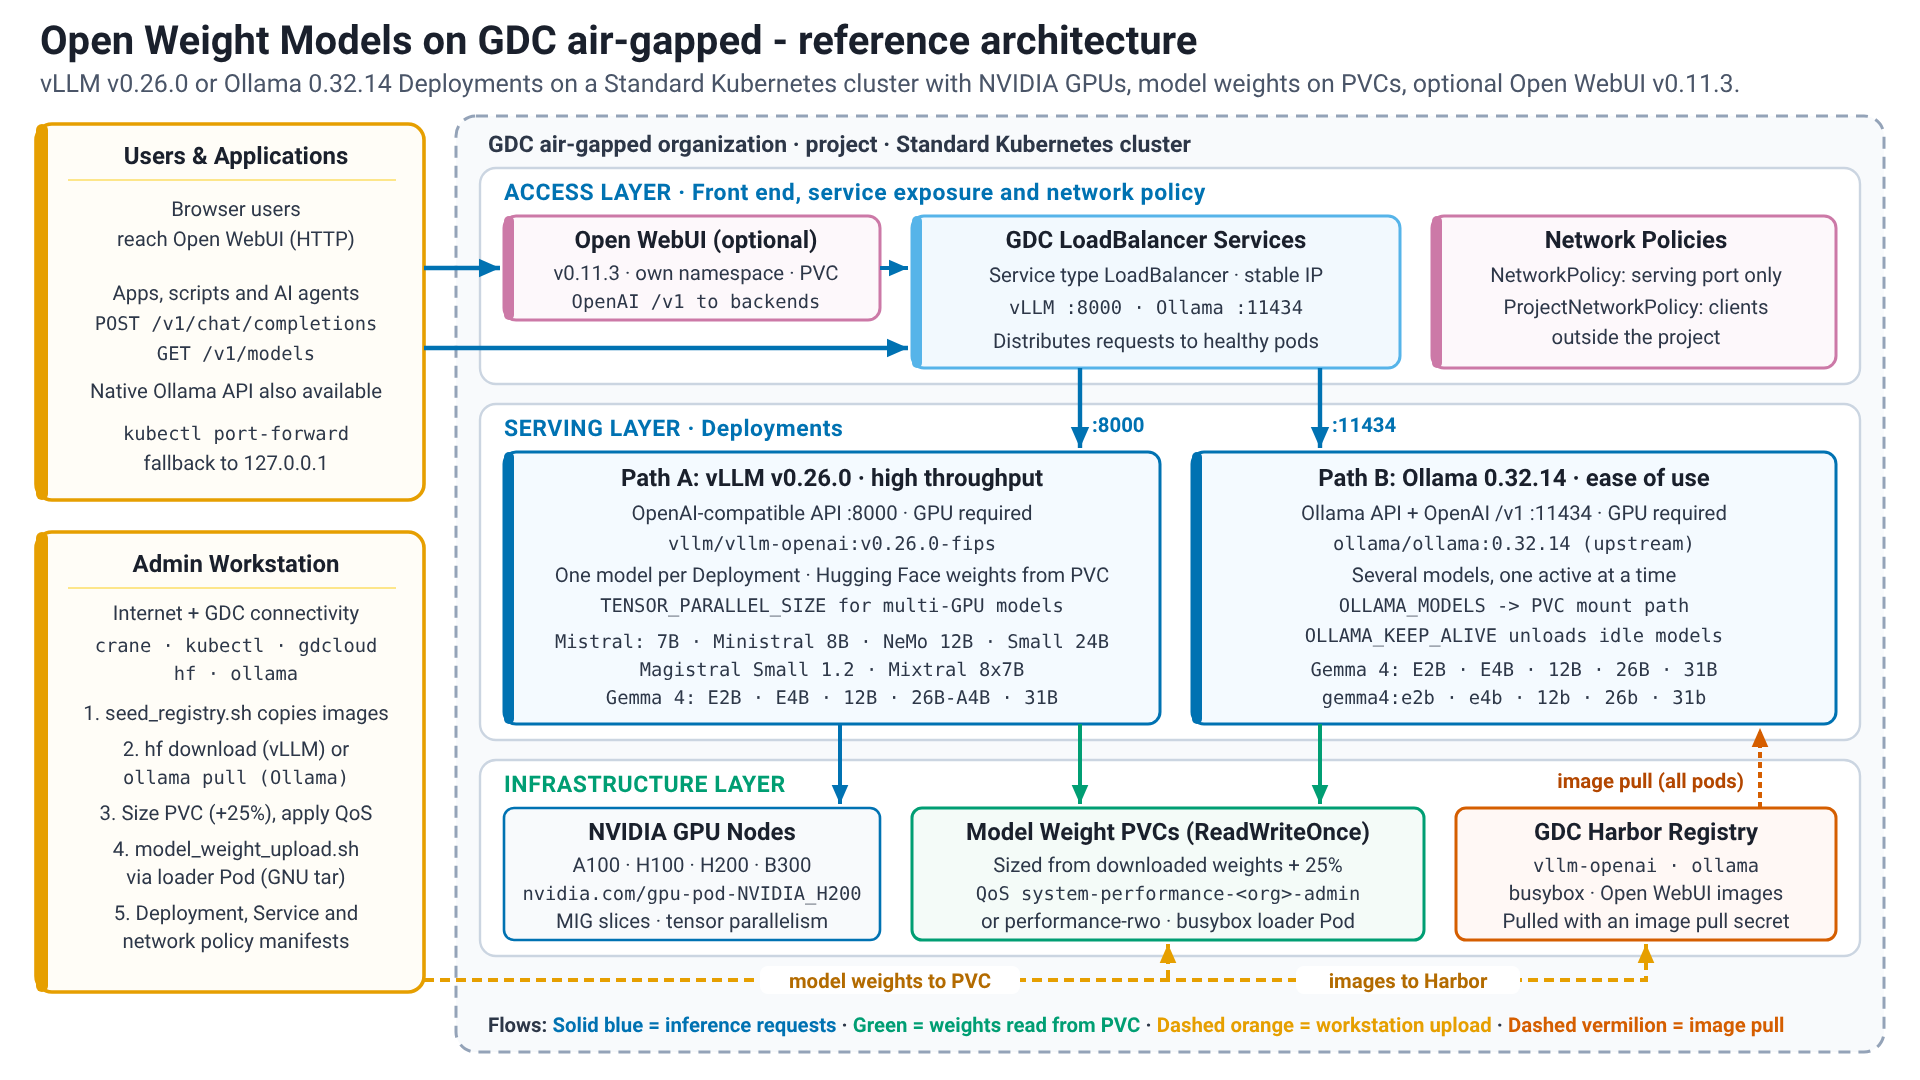
רכיבי הפתרון
הפתרון משתמש ברכיבים הבאים:
| רכיב הפתרון | תחומי האחריות | זרימת נתונים | ממשקים |
|---|---|---|---|
| אזור הלקוח ב-GDC עם air gap | מארח את אשכולות Kubernetes, את הרשת ואת תשתית האחסון | פלטפורמה בסיסית | ממשקים לניהול התשתיות של ה-IO. Kubernetes API למנהלי פלטפורמות ולמשתמשים |
| מאזן עומסים | חושף את הפודים שמשרתים את ה-LLM (vLLM, Ollama) לתנועה מחוץ לאשכול Kubernetes, ומספק כתובת IP יציבה. | בקשות של לקוחות חיצוניים נשלחות לכתובת ה-IP החיצונית של LoadBalancer. ה-LoadBalancer מפיץ את הבקשות בין הפודים התקינים של הקצה העורפי (vLLM או Ollama) על סמך הסלקטור של השירות. | Kubernetes Service API. הקצאה אוטומטית של מאזן עומסי רשת בסביבת GDC. |
| vLLM | הצגת הסקות של מודל שפה גדול (LLM) עם תפוקה גבוהה. אופטימיזציה לזמן אחזור קצר באמצעות שיטות כמו PagedAttention. בדרך כלל מציג מודל אחד לכל מכונה. | מקבל בקשות להסקת מסקנות ב-HTTP מלקוחות. טוען את משקלי המודל מה-PVC שנטען. מבצע חישובים במעבדי GPU מצורפים. מחזירה תגובות HTTP עם טקסט דינמי מבוסס-AI. | API בארכיטקטורת REST שתואם ל-OpenAI להסקה. מקבל בקשות JSON. |
| Ollama | הצגת הסקות של LLM, שנועדה להיות קלה לשימוש. מכונה אחת יכולה להציג כמה מודלים ולטעון אותם על פי דרישה. | מקבל בקשות להסקת מסקנות ב-HTTP. טוען מודלים מה-PVC המותקן (OLLAMA_MODELS). מבצע חישובים במעבדי GPU מחוברים. מחזיר תגובות HTTP. המודלים נפרקים אחרי תקופה של חוסר פעילות (OLLAMA_KEEP_ALIVE) שאפשר להגדיר. |
Ollama RESTful API ו-API שתואם ל-OpenAI (/v1). מקבל בקשות JSON. יש גם CLI. |
| מעבדי GPU של NVIDIA ו-MIG | לספק שיפור מהירות באמצעות חומרה להסקת מסקנות של LLM. | רכיבי ה-backend של ה-LLM (vLLM, Ollama) מעבירים את החישובים האינטנסיביים של המודל (כמו כפל מטריצות) למעבדי ה-GPU כדי להאיץ את ההיקש. באמצעות MIG אפשר לחלק GPU אחד למחיצות, כדי שכמה מכונות של מודלים קטנים יותר יוכלו להשתמש בו. | הם נחשפים כסוג משאב ב-Kubernetes (לדוגמה, nvidia.com/gpu-pod-NVIDIA_H200; שם המשאב המדויק תלוי בדגם ה-GPU המותקן ומתגלה מהצמתים). פודים מבקשים את המשאבים האלה |
| Harbor | אחסון וניהול מאובטחים של קובצי אימג' של קונטיינרים ל-vLLM, ל-Ollama, ל-Open WebUI ולכל pod עזר (כמו busybox) | קובצי אימג' של קונטיינר מועתקים ממרשמים ציבוריים ל-Harbor באמצעות seed_registry.sh (crane) מתחנת עבודה עם גישה לאינטרנט. צומתי Kubernetes שולפים את קובצי האימג' האלה מ-Harbor כדי להריץ קונטיינרים. |
Docker Registry API. צומתי Kubernetes מתממשקים עם Harbor כדי לשלוף קובצי אימג' במהלך יצירת pod. המשתמשים משתמשים בממשק של crane, ב-CLI של Docker או בממשק המשתמש של Harbor כדי להעביר קובצי אימג'. |
| בקשות לאחסון מתמיד (PVC) | מספק אחסון מתמיד למשקלים של מודל LLM, בנפרד ממחזורי החיים של Pods. | קובצי המודל יורדים לתחנת העבודה, משמשים לחישוב דינמי של גודל ה-PVC עם תקורה של 25%, ומועברים בסטרימינג ל-Persistent Volume דרך פוד זמני לטעינת מודלים (busybox) עם model_weight_upload.sh. ה-PVC מוקצה עם performance-rwo כשאחסון בלוקים (block storage) בעל ביצועים גבוהים מופעל. אחרת, מפעיל התשתית מחיל את מדיניות ה-QoS של system-performance-<org>-admin על נפח הגיבוי שלו. כל אחת מהאפשרויות מספקת 30 IOPS לכל GiB (מינימום של 6,148 IOPS). שני ה-backends קוראים את משקלי המודל שלהם מהאחסון המחובר הזה בזמן ההפעלה: vLLM טוען את ספריית המודלים של Hugging Face, ו-Ollama מפנה את OLLAMA_MODELS לנתיב האחסון. לא נעשה שימוש ב-kubectl cp, ואין מודלים שמצורפים לקובצי אימג' של קונטיינרים. |
API לאחסון ב-Kubernetes. מוגדרים ב-YAML (ReadWriteOnce) ונטענים לפודים כנפחים. |
| מדיניות רשת ב-Kubernetes | לאכוף בידוד רשת ולשלוט בתעבורת הנתונים לשירותי ה-LLM. מרחב שמות NetworkPolicy (networking.k8s.io/v1) מאפשר תנועה ליציאת השירות מתוך האשכול. בנוסף, נדרש ProjectNetworkPolicy (networking.gdc.goog/v1) כדי לגשת מחוץ לפרויקט. |
מתבצעת בדיקה של התנועה ברשת אל Pods בתוך מרחב השמות וממנו. כללי המדיניות קובעים אם מותר להתחבר ליציאות של שירות ה-LLM (לדוגמה, 8000 ל-vLLM, 11434 ל-Ollama), בדרך כלל על סמך טווחי כתובות ה-IP של המקור או תוויות אחרות. | ממשקי ה-API של Kubernetes networking.k8s.io/v1 ו-networking.gdc.goog/v1. מוגדר ב-YAML. |
| Open WebUI | ממשק משתמש אופציונלי מבוסס-דפדפן למשתמשי קצה. הוא מתקשר עם ממשקי ה-API של vLLM ו-Ollama שתואמים ל-OpenAI, לא מכיל משקלי מודל ולא צריך מאיץ. | המשתמשים מגיעים ל-Open WebUI דרך שירות Kubernetes. Open WebUI מעביר בקשות צ'אט לשירותי vLLM ו-Ollama דרך ה-API של /v1 שתואם ל-OpenAI, ושומר את המצב שלו (משתמשים, צ'אטים, הגדרות) בנפח אחסון מתמיד. |
HTTP (דפדפן) למשתמשים, API בארכיטקטורת REST שתואם ל-OpenAI לקצה העורפי. עומס עבודה עם שמירת מצב שנפרס במרחב שמות משלו. |
תכונות ויכולות
ארכיטקטורת העזר הזו מספקת את היכולות העיקריות הבאות:
- הצגת מודלים גדולים של שפה (LLM) עם משקלים פתוחים: מאפשרת לארח מודלים שונים עם משקלים פתוחים (לדוגמה, Gemma 4, Llama, DeepSeek, Mistral) ולהסיק מהם מסקנות.
- רכיבים: קצוות עורפיים להצגת LLM (vLLM, Ollama), פריסות/Pods של Kubernetes.
- תחומי אחריות: טעינת משקלי המודל, ניהול תהליך ההסקה, הפעלת מודלים בשיפור מהירות באמצעות חומרה וחשיפת נקודות קצה.
- ממשקים: ממשקי API בארכיטקטורת REST (תואמים ל-OpenAI בשביל vLLM ו-Ollama, וגם ה-API הספציפי ל-Ollama) לבקשות הסקה, בדרך כלל באמצעות JSON.
- הביאו את המודל האישי (BYOM): המשתמשים יכולים לייבא ולפרוס את המודלים של LLM עם משקלים פתוחים שהם בחרו בסביבה עם air gap.
- רכיבים: Harbor, בקשות לנפח אחסון מתמיד, Pod לטעינת מודלים, Kubernetes.
- תחומי אחריות: אחסון מאובטח של קובצי אימג' של קונטיינרים ומשקלי מודלים. מנגנון להעברת מודלים לסביבה (
model_weight_upload.shדרך ה-Pod של הטעינה) והפיכתם לנגישים למנועי ההצגה. - ממשקים: Docker Registry API (ל-Harbor), Kubernetes API (ל-PVCs ול-volume mounts).
- הסקה מואצת באמצעות חומרה: שימוש במעבדים גרפיים של NVIDIA באשכול GDC כדי להריץ הסקות של LLM ביעילות.
- רכיבים: יחידות GPU של NVIDIA, Kubernetes, פלאגינים של מכשירים.
- תחומי אחריות: תזמון Pods בצמתים עם משאבי GPU.
חשיפת חומרת ה-GPU לקונטיינרים של הקצה העורפי של ה-LLM. תמיכה ב-Multi-Instance GPU (MIG) לחלוקה למחיצות וב-multi-GPU tensor parallelism (
TENSOR_PARALLEL_SIZE) למודלים גדולים כמו Mixtral 8x7Bbf16. - ממשקים: Kubernetes API (לבקשת משאבי GPU כמו
nvidia.com/gpu-pod-NVIDIA_H200אוnvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE).
- גישה מבוקרת לרשת: מוודאת שהגישה לנקודות הקצה של הסקת ה-LLM מבוקרת ומבודדת בסביבת GDC.
- רכיבים: שירותי Kubernetes (LoadBalancer), NetworkPolicy, ProjectNetworkPolicy.
- תחומי אחריות: חשיפת שירותי הסקה באמצעות כתובת IP יציבה. הגדרה ואכיפה של כללי רשת כדי לאפשר או לדחות תנועה לקצוות העורפיים של ה-LLM על סמך מקור, יעד ויציאות.
- ממשקים: Kubernetes API (לשירותים, ל-NetworkPolicy ול-ProjectNetworkPolicy).
- הצגה ניתנת להתאמה: מאפשרת להתאים את הקיבולת לפי הביקוש.
- רכיבים: פריסות של Kubernetes.
- תחומי אחריות: הפעלת התאמה אופקית לעומס (horizontal scaling) על ידי הגדלת מספר הרפליקות של ה-pods בקצה העורפי של ה-LLM. שינוי קנה מידה אנכי על ידי התאמת הקצאת המשאבים/המגבלות.
- ממשקים: Kubernetes API (לניהול רפליקות ומשאבים של פריסה).
- ממשק קצה (front-end) לדפדפן (אופציונלי): מאפשר למשתמשי הקצה להתכתב בצ'אט עם המודלים שנפרסו בלי לכתוב קריאות ל-API.
- רכיבים: פריסת Open WebUI, שירות ו-Persistent Volume Claim.
- תחומי אחריות: הצגת המודלים שמוגשים על ידי vLLM ו-Ollama בממשק אחד, שמירה על המשתמשים, הצ'אטים וההגדרות.
- ממשקים: HTTP (דפדפן); API של
/v1תואם ל-OpenAI לקצוות העורפיים.
עקרונות ארכיטקטוניים
- אבטחה לפני הכול: כל הרכיבים והנתונים נמצאים בתוך הגבולות של GDC עם air gap, כדי להבטיח אבטחה ושליטה מקסימליות בנתונים. הגישה לרשת מוגבלת באמצעות אובייקטים מסוג
NetworkPolicyו-ProjectNetworkPolicy. - ריבונות הנתונים: הלקוחות שומרים על שליטה מלאה במודלים ובנתונים שלהם, בלי צורך בקישוריות חיצונית לצורך הפעלה.
- פתוחה וגמישה: הארכיטקטורה משתמשת בקצוות עורפיים בקוד פתוח (vLLM, Ollama) ותומכת במגוון מודלי LLM עם משקלים פתוחים, כך שהלקוחות יכולים לבחור ולא צריכים להתחייב לספק אחד למנוע ההסקה.
- הפרדת רכיבים: פונקציות עיקריות כמו אחסון מודלים (PVC), ניהול תמונות (Harbor), הצגת הסקות (vLLM/Ollama pods) וממשק המשתמש (Open WebUI) הן רכיבים נפרדים, שמאפשרים ניהול ועדכונים עצמאיים.
- יכולת התאמה לעומס וביצועים: המערכת מותאמת לעומס גם אופקית, על ידי הגדלת מספר הרפליקות של ה-pod, וגם אנכית, על ידי התאמת משאבי המעבד (CPU) או המעבד הגרפי (GPU) (כולל מקביליות של טנזורים בכמה מעבדים גרפיים) כדי לעמוד בדרישות הביצועים. vLLM נבחר לתרחישים של תפוקה גבוהה וזמן אחזור קצר.
- אופטימיזציה של משאבים: תמיכה ב-NVIDIA Multi-Instance GPU (MIG) כדי לאפשר למודלים קטנים יותר לשתף משאבי GPU ביעילות, ושינוי דינמי של גודל ה-PVC (תוספת של 25% לתקורה) בשילוב עם QoS של אחסון בביצועים גבוהים כדי למנוע הקצאת יתר של אחסון בלי לפגוע במהירות הטעינה של המודל.
- ממשקים סטנדרטיים: מבוססים על תקני Kubernetes לתזמור, לפריסה ולחשיפת שירותים. נקודות קצה להסקת מסקנות מספקות ממשקי API בארכיטקטורת REST, וגם vLLM וגם Ollama מציעים תאימות ל-OpenAI.
- עמידות: שימוש בבדיקות תקינות וברפליקציה של Kubernetes כדי להבטיח את זמינות השירות.
לתשומת ליבכם
- יכולת התאמה לעומס וביצועים:
- כדי להשיג התאמה אופקית, מגדילים את מספר הרפליקות בפריסת Kubernetes גם ל-vLLM וגם ל-Ollama. בלי
ReadOnlyManyStorageClass, פריסת המודל מוגבלת לרפליקה אחת (נפח המודל הואReadWriteOnce). קיבולת נוספת מגיעה מפריסות נוספות, שלכל אחת מהן יש PVC משלה. - התאמה אנכית לעומס כוללת הקצאה של יותר מעבדי CPU או זיכרון ופרוסות GPU גדולות יותר, עד למעבדי GPU מלאים או מקביליות טנזור מרובת מעבדי GPU (
TENSOR_PARALLEL_SIZE) בכמה מעבדי GPU באותו צומת. - ב-vLLM מופעל מודל אחד לכל מכונה, וצריך ליצור פריסות חדשות למודלים נוספים. ב-Ollama אפשר להפעיל כמה מודלים ממכונה אחת. במדריכים האלה, כל פריסה של Ollama מפעילה מודל אחד.
- הגודל של ה-PVC של כל מודל נקבע באופן דינמי לפי המשקלים שהורדו, עם תקורת אחסון של 25%. הוא מוגדר עם מדיניות ה-QoS של אחסון בביצועים גבוהים (
system-performance-<org>-admin, 30 IOPS לכל GiB עם רצפה של 6,148 IOPS, אוperformance-rwoכשאחסון בלוקים בביצועים גבוהים מופעל) כדי שזמני הטעינה של המודל לא יוגבלו על ידי המכסה שמוגדרת כברירת מחדל שלstandard-rwo3 IOPS לכל GiB.
- כדי להשיג התאמה אופקית, מגדילים את מספר הרפליקות בפריסת Kubernetes גם ל-vLLM וגם ל-Ollama. בלי
- ניהול משאבים:
- חשוב לתכנן בקפידה את משאבי ה-GPU. אפשר להשתמש ב-NVIDIA MIG כדי לחלק את ה-GPU למודלים קטנים יותר ולשפר את הניצול, ובמודלים גדולים יותר (כמו Mixtral 8x7B ב-
bf16) אפשר לפצל את המשקלים בין כמה יחידות GPU באמצעות מקביליות של טנזורים. - צריך להקצות מספיק מעבד (CPU) וזיכרון כדי לטפל בתקורה של ניהול ההסקה והמודל. vLLM ו-Ollama מציגים מודלים עם האצת GPU.
- צריך להקצות מספיק נפח אחסון ל-PVC כדי להתאים לגודל המודל ולהבטיח ביצועים טובים.
- חשוב לתכנן בקפידה את משאבי ה-GPU. אפשר להשתמש ב-NVIDIA MIG כדי לחלק את ה-GPU למודלים קטנים יותר ולשפר את הניצול, ובמודלים גדולים יותר (כמו Mixtral 8x7B ב-
- זמינות ואמינות:
- פריסות של Kubernetes מספקות יכולות של ריפוי עצמי ועדכון בהדרגה (rolling).
- שירותי LoadBalancer מחלקים את התנועה בין Pods תקינים, ומסתירים כשלים ב-Pods ספציפיים.
- אחסון משקלי המודל ב-PVC מבטיח שהם יישמרו גם אחרי הפעלה מחדש של Pod.
- מורכבות תפעולית:
- ניהול קובצי אימג' של קונטיינרים לגרסאות ולרכיבי backend שונים ב-Harbor.
- הליכים להעברה מאובטחת של משקלי המודל לסביבה עם air gap.
- יצירה וניהול של מניפסטים של Kubernetes (פריסות, שירותים, PVC, מדיניות רשת ב-Kubernetes) לכל מודל ו-backend.
- מעקב אחרי ניצול ה-GPU, זמן האחזור של ההסקה ושיעורי השגיאות.
- אבטחה ותאימות:
- כל הפתרון פועל בתוך היקף האבטחה של GDC עם air gap.
- כדי לאכוף בידוד קפדני של הרשת ולשלוט בגישה לנקודות הקצה של ה-LLM, חובה להגדיר מדיניות רשת ב-Kubernetes: מרחב שמות
NetworkPolicyלגישה בתוך האשכול ו-ProjectNetworkPolicyלגישה מחוץ לפרויקט. - חשבונות רובוט של Harbor וסודות לשליפת קובצי אימג' של Kubernetes מבטיחים גישה מאובטחת לקובצי אימג' של קונטיינרים.
- מדיניות רשת ב-Kubernetes מגבילה את הלקוחות שיכולים להגיע לנקודות הקצה. הנתונים במנוחה ב-PVC מסתמכים על הצפנת האחסון של GDC.
החלטות לגבי העיצוב
אלה החלטות התכנון העיקריות שהתקבלו לגבי ארכיטקטורת העזר הזו:
החלטה 1: להציע גם את vLLM וגם את Ollama במקום שרת backend אחד
| הקשר | החלטה חשובה | הסבר לגבי ההנחיה |
|---|---|---|
| להציע קצה עורפי אחד להצגת מודעות (vLLM או Ollama) או את שניהם. | כדאי להציע את שתי האפשרויות, כי למשתמשים ולתרחישי שימוש שונים יש דרישות שונות לגבי ביצועים, תאימות ל-API וקלות הניהול של המודלים. | vLLM מספק עיבוד עם תפוקה גבוהה וזמן אחזור קצר, ותאימות ל-OpenAI API, שמתאימה לאפליקציות בסביבת ייצור. קל יותר להגדיר את Ollama, לנהל כמה מודלים ולהשתמש בהם, והיא מתאימה יותר לפיתוח ולניסויים. התמיכה בשתי האפשרויות מספקת גמישות. |
החלטה 2: משקלי מודלים ב-PersistentVolumeClaims
| הקשר | החלטה חשובה | הסבר לגבי ההנחיה |
|---|---|---|
| ב-vLLM וב-Ollama צריך משקלי מודל במערכת הקבצים בזמן הריצה. בסביבה עם air gap, אי אפשר להוריד מודלים לפי דרישה. | מאחסנים את המשקולות של כל מודל ב-ReadWriteOnce PersistentVolumeClaim משלו, שמאוכלס מתחנת העבודה דרך Pod זמני לטעינת מודלים. |
PersistentVolumeClaims מספק שכבת אחסון עמידה ומתמידה לקובצי מודלים גדולים, שמנותקת ממחזור החיים של pod ההסקה. כך אפשר לטעון מודלים במהירות כשה-pod מופעל. |
החלטה 3: משקלי מודלים ב-PersistentVolumes ל-Ollama (פוד של טוען) במקום לארוז אותם באימג'
| הקשר | החלטה חשובה | הסבר לגבי ההנחיה |
|---|---|---|
| אפשר להוריד מודלים ב-Ollama, אבל לשם כך נדרשת גישה לאינטרנט, שלא זמינה בסביבות עם air gap. לעומת זאת, אם מאגדים את המודלים ל-image מותאם אישית של Ollama, צריך ליצור מחדש image לכל מודל ולאחסן ב-Harbor קובצי image בגודל של כמה גיגה-בייט. | ב-Ollama משתמשים באותו תהליך עבודה של Pod לטעינת מודלים כמו ב-vLLM: המודל נשלף בתחנת העבודה (ollama pull עד ollama_model_weight_download.sh), מועבר בסטרימינג ל-PVC דרך ה-Pod לטעינת מודלים באמצעות model_weight_upload.sh (GNU tar), ו-OLLAMA_MODELS מופנה לנתיב הטעינה. |
תהליך עבודה אחד לשני הקצוות העורפיים; אפשר להוסיף או לעדכן מודלים בלי לבנות מחדש את קובצי האימג'; קובץ האימג' של Ollama במעלה הזרם שלא השתנה נשאר קטן ב-Harbor. |
החלטה 4: חשיפת vLLM ו-Ollama באמצעות שירותי LoadBalancer לעומת ללא מאזן עומסים
| הקשר | החלטה חשובה | הסבר לגבי ההנחיה |
|---|---|---|
| ממשקי ה-API של ה-LLM צריכים להיות נגישים לאפליקציות בסביבת GDC. | חושפים כל קצה עורפי באמצעות שירות מסוג LoadBalancer, הגישה הרגילה של Kubernetes. הפעולה הזו מסתמכת על הקצאת מאזן העומסים של פלטפורמת GDC עם air gap. |
שירותי Kubernetes מסוג LoadBalancer מספקים שיטה סטנדרטית ואמינה לחשיפת הקצוות העורפיים של ה-LLM, ומספקים כתובת IP יציבה וחלוקת עומסים. |
החלטה 5: אכיפת מדיניות רשת חובה (NetworkPolicy ו-ProjectNetworkPolicy)
| הקשר | החלטה חשובה | הסבר לגבי ההנחיה |
|---|---|---|
| אבטחה ובידוד הם קריטיים בפריסות של GDC עם air gap. | כדי לשפר את מצב האבטחה של שירותי ה-LLM שנפרסו, אוכפים מדיניות רשת ב-Kubernetes בכל נקודת קצה של LLM (מרחב שמות NetworkPolicy שמאפשר רק את יציאת השירות, בתוספת ProjectNetworkPolicy כשלקוחות מחוץ לפרויקט צריכים גישה). |
אובייקטים של NetworkPolicy מספקים דרך מותאמת ל-Kubernetes לאכוף בידוד רשת ברמת מרחב השמות, ואובייקטים של ProjectNetworkPolicy מרחיבים את הבידוד לגבולות הפרויקט, כדי להבטיח שרק תנועה מורשית תוכל להגיע לשירותי ה-LLM. |
החלטה 6: התאמה דינמית של גודל ה-PVC (תוספת של 25% לתקורה) בשילוב עם מדיניות QoS לאחסון בביצועים גבוהים
| הקשר | החלטה חשובה | הסבר לגבי ההנחיה |
|---|---|---|
ברירת המחדל של standard-rwo StorageClass אוכפת את מדיניות ה-Adaptive QoS של standard-<org>-admin ONTAP (3,072 IOPS per TiB או 3 IOPS per GiB, עם מינימום של 75 IOPS). אם מגדירים את הגודל של PVC בנפח standard-rwo בהתאם לגודל המודל, קצב הקריאה הסדרתית של המשקלים מוגבל ל-5 עד 21MBps. אם מקצים יותר מדי משאבים ל-PVC סטטיים בנפח 300 עד 500GiB, נפח האחסון מתבזבז וקצב הקריאה הסדרתית עדיין מוגבל ל-60MBps בערך. |
קודם מורידים את משקלי המודל, מחשבים באופן דינמי את GDCS_MODEL_PVC_SIZE מהספרייה שהורדה עם תקורה של 25% מעוגלת כלפי מעלה ל-GiB השלם הבא, ומשתמשים ב-storageClassName: performance-rwo כאשר אחסון בלוקים עם ביצועים גבוהים מופעל, או מבקשים ממפעיל התשתית להחיל את מדיניות ה-QoS של system-performance-${GDC_ORG}-admin על נפח הגיבוי. |
מדיניות ה-QoS של system-performance-<org>-admin מספקת 30,720 IOPS per TiB (30 IOPS per GiB, פי 10 יותר מ-standard) עם רצפת מינימום של 6,148 IOPS (תקרה של כ-393MBps ב-ONTAP) לכל נפח של עד 204GiB. שילוב של הקצאת נפח דינמית עם תקורה של 25% עם system-performance מבטל הקצאת יתר של נפח אחסון פי 3 עד פי 40 (12Gi עד 109Gi במקום 100Gi עד 500Gi), תוך הגדלת מהירות הקריאה הרציפה של virtio-scsi ב-KubeVirt עם LUN יחיד לכ-150MBps (הפעלה מהירה יותר של המודל פי 2.5 עד פי 30). |
הנחות ומגבלות
- סביבה של GDC עם air gap בגרסה 1.16.2 תיקון חם 1 (
1.16.2-gdch.1353-1) או גרסה חדשה יותר (מאגרי צמתים של GPU באשכולות רגילים דורשים את הגרסה הזו, גרסאות קודמות מציעות מעבדי GPU רק באשכולות משותפים). - באשכול הרגיל יש מספיק משאבי חומרה (כולל מעבדים גרפיים של NVIDIA). גם vLLM וגם Ollama דורשים GPU.
- מופע Harbor מוגדר ונגיש.
- תחנת עבודה עם גישה לאינטרנט וקישוריות לסביבת GDC (Harbor ו-Kubernetes API) זמינה להוספת תמונות ולהעלאת משקלי מודלים.
- למשתמשים יש את ההרשאות הנדרשות: תפקידי הפרויקט "צפייה במכונה של Harbor" ו"אדמין של אשכול רגיל", וגם StandardClusterRoleBinding (אדמין של אשכול) באשכול הרגיל, ראו את ה-SRI.
- המודלים תואמים לקצה העורפי של השרת שנבחר (vLLM או Ollama).
- מגבלה: ה-PVC של משקולות המודל הוא
ReadWriteOnce. בליReadOnlyManyStorageClass, כל פריסת מודל מוגבלת לרפליקה אחת.
מסלול המשתמש באפליקציה
כאן מפורט מסלול המשתמש המלא לפריסת מודלי שפה גדולים (LLM) עם משקלים פתוחים בסביבות Google Distributed Cloud עם air gap. התהליך מחולק להגדרה כללית, שני נתיבי פריסה (vLLM ו-Ollama), ממשק אופציונלי ואימות סופי.
1. הגדרה נפוצה: ניהול תמונות
לפני שפורסים מודל LLM, צריך להגדיר איך סביבת GDC תמשוך קובצי אימג' של קונטיינרים מהמרשם הפרטי של Harbor.
- יצירת חשבונות רובוט ב-Harbor: יוצרים חשבונות רובוט בממשק המשתמש של Harbor: אחד עם הרשאות דחיפה ל-
crane(הזנת קובץ אימג') ואחד עם הרשאות משיכה לסוד של משיכת קובץ אימג' ב-Kubernetes. - אימות של קובצי האימג' של Crane ו-Seed: משתמשים בפרטי הכניסה של חשבון הרובוט כדי להיכנס ל-Harbor מתחנת עבודה עם גישה לאינטרנט (
crane auth login), ומעתיקים את קובצי האימג' הנדרשים של הקונטיינר (busybox,ollama/ollama,vllm/vllm-openai, ואופציונלית Open WebUI) ל-Harbor באמצעותseed_registry.sh. - יצירת סוד של Kubernetes: יוצרים סוד של docker-registry במרחב השמות של עומס העבודה באמצעות kubectl, כדי לאחסן את פרטי הכניסה לחשבון של חשבון הרובוט לשליפה שבהם האשכול ישתמש.
2. נתיב פריסה א': vLLM לתפוקה גבוהה
הדרך הזו מומלצת להצגת מודלים שמתמקדים בביצועים, כמו Mistral 7B Instruct, ב-GPU.
- השגת קובץ האימג': מאכלסים את קובץ האימג' של vLLM (
vllm/vllm-openai:v0.26.0) ב-Harbor באמצעותseed_registry.sh, ואז יוצרים ודוחפים את תג קובץ האימג' המתוקןv0.26.0-fipsכמו שמתואר ב-SRI. - הכנת נפח האחסון של המודל:
- מורידים את המשקלים מ-Hugging Face בתחנת העבודה (
hf download). - מחשבים את הגודל הנדרש של ה-PVC מהמשקלים שהורדו (עם 25% תקורה), יוצרים
ReadWriteOncePersistent Volume Claim (PVC) לאחסון משקלי המודל ומחילים את מדיניות ה-QoS לביצועים גבוהים. - מפעילים Pod זמני לטעינת מודלים (
busybox) שמחבר את ה-PVC ומעביר אליו את המשקלים באמצעותmodel_weight_upload.sh(GNU tar מעלkubectl exec; לא משתמשים ב-kubectl cpכי BusyBox tar לא יכול לקרוא את כותרות ה-PAX שלו לקבצים שגדולים מ-8GiB), ואז מוחקים את ה-Pod לטעינה.
- מורידים את המשקלים מ-Hugging Face בתחנת העבודה (
- פריסת קצה עורפי: מחילים מניפסט של פריסת Kubernetes שמפנה לתמונת ה-vLLM, מבקשים את משאב המאיץ שנמצא מהצמתים (לדוגמה,
nvidia.com/gpu-pod-NVIDIA_H200) ומחברים את ה-PVC של משקל המודל. - חשיפת השירות: יוצרים שירות LoadBalancer כדי לספק כתובת IP חיצונית ל-vLLM API.
- רשת מאובטחת: מחילים NetworkPolicy של מרחב שמות כדי לאפשר תעבורת נתונים נכנסת (ingress) ביציאת השירות (8000). מוסיפים ProjectNetworkPolicy כשלקוחות מחוץ לפרויקט צריכים גישה.
3. מסלול פריסה ב': Ollama – קל לשימוש
המסלול הזה מתמקד בהגדרה פשוטה. הוא משתמש באותו קובץ אימג' של Ollama במעלה הזרם ללא שינוי, ובאותו תהליך עבודה של טעינת מודלים כמו vLLM.
- תמונת המקור: מעתיקים את תמונת ה-Ollama במעלה הזרם (
ollama/ollama:0.32.14) ל-Harbor באמצעותseed_registry.sh. - הכנת נפח האחסון של המודל:
- מושכים את המודל (לדוגמה,
gemma4:e4b) בתחנת העבודה באמצעותollama_model_weight_download.sh, שמריץollama serveמקומי זמני עםOLLAMA_MODELSשמצביע על ספריית ההורדות. - מחשבים את גודל ה-PVC הנדרש מהמשקלים שהורדו (עם 25% תקורה), יוצרים PVC של
ReadWriteOnce, מחילים את מדיניות ה-QoS עם הביצועים הגבוהים ומפעילים Pod זמני לטעינת מודלים שמחבר אותו. - מעלים את ספריית ההורדה ל-PVC באמצעות
model_weight_upload.sh, ואז מוחקים את ה-Pod של ה-loader.
- מושכים את המודל (לדוגמה,
- פריסה וחשיפה: יוצרים פריסת Ollama עם
OLLAMA_MODELSשמצביע על נתיב הטעינה של ה-PVC (מבקשים את משאב המאיץ שזוהה מהצמתים) ושירות LoadBalancer. - רשת מאובטחת: צריך להחיל NetworkPolicy של מרחב שמות על היציאה של Ollama (11434), ולהוסיף ProjectNetworkPolicy כשלקוחות מחוץ לפרויקט צריכים גישה.
4. אופציונלי: פתיחת ממשק המשתמש באינטרנט
- פריסת Open WebUI: מעבירים את קובץ האימג' של Open WebUI ל-Harbor ופורסים אותו במרחב שמות משלו עם אחסון מתמיד למצב שלו. מפנים אותו לנקודות הקצה (endpoints) של
/v1שתואמות ל-OpenAI של שירות vLLM, שירות Ollama או שניהם. השלבים מפורטים במדריך למשתמש של Open WebUI for Open Weight Models.
5. אימות ובדיקה
אחרי הפריסה, השלבים האחרונים כוללים אימות שהשירותים פועלים.
- בדיקת הסטטוס: מוודאים שהפודים פועלים ושהוקצו לשירותים כתובות IP חיצוניות.
- הסקה לבדיקה:
- vLLM: שולחים בקשת curl לכתובת ה-IP של מאזן העומסים של vLLM באמצעות נקודות הקצה
/v1/modelsו-/v1/chat/completionsשתואמות ל-OpenAI. - Ollama: שולחים בקשת curl לכתובת ה-IP של Ollama LoadBalancer באמצעות אותן נקודות קצה (
/v1/modelsו-/v1/chat/completions) שתואמות ל-OpenAI.
- vLLM: שולחים בקשת curl לכתובת ה-IP של מאזן העומסים של vLLM באמצעות נקודות הקצה
- חלופה להעברה ליציאה אחרת: אם אי אפשר להגיע לכתובת ה-IP של LoadBalancer מתחנת העבודה (לדוגמה, כי עדיין אין ProjectNetworkPolicy), משתמשים ב-
kubectl port-forwardלשירות ושולחים את אותן בקשות אל127.0.0.1.
6. תפעול והתאמה לעומס (scaling)
- שינוי קנה מידה אנכי: הגדלת פרוסות ה-GPU או מעבר להגדרות של כמה יחידות GPU בשביל מודלים גדולים יותר.
- שינוי קנה מידה אופקי: הגדילו את מספר הרפליקות בפריסה (נדרש נפח מודל של
ReadOnlyMany) או פרסו פריסות מודלים נוספות כדי לטפל ביותר בקשות משתמשים בו-זמנית. - פתרון בעיות: עוקבים אחרי היומנים באמצעות
kubectl logsובודקים אם יש בעיות נפוצות כמו כשלים בבדיקה העצמית של FIPS או הגבלות של מדיניות הרשת ב-Kubernetes.
השלבים המפורטים מופיעים בהטמעת עזר של מודלים במשקל פתוח עם Ollama, בהטמעת עזר של מודלים במשקל פתוח עם vLLM ובמדריכים למשתמש שלהם.
חומרים נוספים
- מודלים של משקלים פתוחים עם הטמעת עזר של Ollama
- מודלים של משקלים פתוחים עם הטמעת עזר של vLLM
- מדריך למשתמש ב-Gemma 4 E4B עם Ollama
- [SUG] Mistral 7B Instruct עם vLLM ב-GDC עם air gap
- [SUG] Mistral NeMo 12B Instruct עם vLLM ב-GDC עם air gap
- [SUG] Mistral Small 3.2 24B Instruct עם vLLM ב-GDC עם air gap
- [SUG] Ministral 8B Instruct עם vLLM ב-GDC עם air gap
- [SUG] Mixtral 8x7B Instruct עם vLLM ב-GDC עם air gap
- [SUG] Magistral Small 1.2 24B עם vLLM ב-GDC עם air gap
- מדריך למשתמש ב-Open WebUI למודלים עם משקלים פתוחים
- המסמכים של vLLM
- Ollama
- Open WebUI
- מסמכי התיעוד של Google Distributed Cloud במודל Air-gapped