


Planteamiento del problema
Las organizaciones que operan en entornos aislados se enfrentan a un desafío importante: necesitan modelos de lenguaje grandes, pero tienen prohibido conectarse a APIs externas basadas en la nube debido a protocolos de seguridad rigurosos. Para cerrar esta brecha, estos clientes necesitan un ecosistema sólido y autónomo capaz de alojar y administrar modelos de pesos abiertos directamente en su infraestructura aislada de Google Distributed Cloud (GDC). Esta implementación localizada es esencial para mantener la soberanía absoluta de los datos, lo que garantiza que la información sensible nunca salga de las instalaciones físicas. Cuando se integran entornos de ejecución seguros con backends de entrega, los usuarios pueden usar funciones de IA avanzadas y, al mismo tiempo, conservar el control administrativo total sobre sus datos, pesos de modelos y postura de seguridad interna.
Si bien Gemini en GDC proporciona capacidades de frontera potentes y administradas, los clientes suelen implementar modelos de pesos abiertos, como Gemma 4 o Llama 4, para obtener una mayor granularidad y control. Implementar modelos de pesos abiertos en entornos de GDC con aislamiento físico ofrece ventajas de costos significativas en comparación con los servicios propietarios administrados. Al poseer los pesos del modelo, las organizaciones eliminan las tarifas recurrentes de la API por token, que pueden ser prohibitivas para las cargas de trabajo automatizadas de gran volumen. Además, los modelos de pesos abiertos permiten la cuantización (por ejemplo, de 4 u 8 bits), lo que permite que el razonamiento de alto rendimiento se ejecute en huellas de hardware más pequeñas y económicas en el perímetro. Esta optimización vertical, combinada con la capacidad de compartir infraestructura entre múltiples aplicaciones internas sin costos de licencia adicionales, da como resultado un costo total de propiedad (TCO) significativamente menor para operaciones de inferencia sostenidas y a gran escala.
Solución propuesta
En este documento, se describe la arquitectura de referencia para implementar y administrar modelos de lenguaje grandes (LLM) de pesos abiertos en entornos aislados de Google Distributed Cloud (GDC). Muchos clientes, en especial aquellos que se encuentran en sectores muy regulados, no pueden usar las APIs de LLM basadas en la nube debido a los requisitos estrictos de seguridad y soberanía de los datos. Esta arquitectura aborda la necesidad de ejecutar LLM potentes de forma local dentro de su propia instancia segura de GDC.
Qué se incluye: Esta arquitectura abarca la implementación de modelos de pesos abiertos (como Gemma 4, Llama, DeepSeek y Mistral) con los backends de entrega
vLLM u Ollama. Incluye el uso de Kubernetes para
la organización, Harbor para el almacenamiento de artefactos, volúmenes persistentes para los pesos
del modelo, políticas de red (NetworkPolicy / ProjectNetworkPolicy) para la seguridad
de la red y Open WebUI como un frontend opcional del navegador.
Qué no se incluye: Esta arquitectura no abarca los servicios administrados de AI Gateway, los modelos de propiedad, como el modelo de Gemini de Google, los procesos de ajuste de modelos ni los modelos de IA generativa para otras modalidades, como la generación de imágenes.
Público: El público principal de este documento incluye a los administradores de plataformas responsables de implementar y administrar servicios en GDC, y a los arquitectos técnicos que diseñan soluciones de IA en el entorno aislado. Los usuarios finales y los desarrolladores que interactuarán con los modelos implementados son públicos secundarios que se benefician de comprender la estructura subyacente.
Arquitectura
La solución implementa vLLM, Ollama o ambos como backends de entrega de inferencia en contenedores (Deployment) dentro de un clúster estándar. Los pesos del modelo se almacenan en
volúmenes persistentes que se propagan desde la estación de trabajo a través de un cargador
de modelos Pod. Los Service de Kubernetes de tipo LoadBalancer exponen las APIs
de backend, los objetos NetworkPolicy / ProjectNetworkPolicy protegen el acceso a ellas
y Open WebUI se puede implementar de forma opcional como un frontend de navegador para las
APIs compatibles con OpenAI.
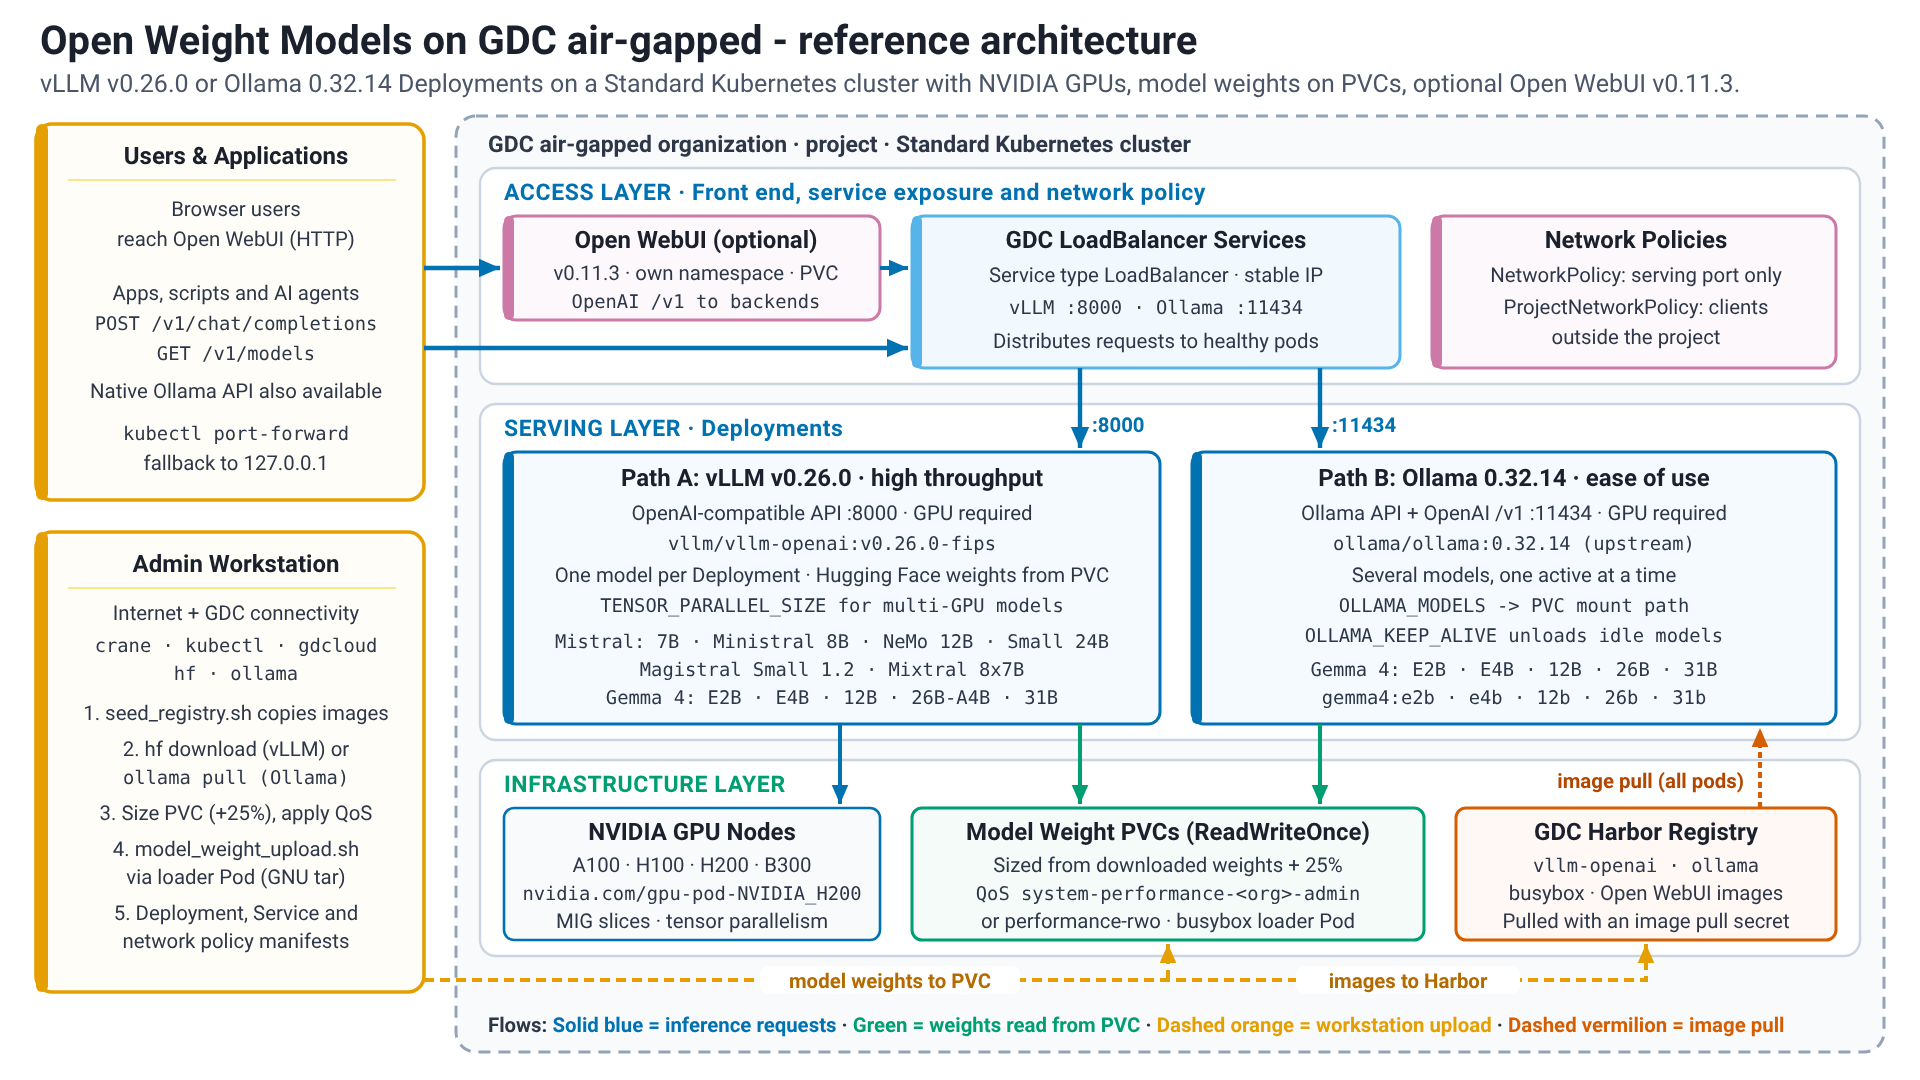
Componentes de la solución
La solución usa los siguientes componentes:
| Componente de la solución | Responsabilidades | Flujo de datos | Interfaces |
|---|---|---|---|
| Zona del cliente de GDC aislado | Aloja los clústeres de Kubernetes, las herramientas de redes y la infraestructura de almacenamiento | Plataforma básica | Interfaces de administración de infraestructura para el IO API de Kubernetes para administradores y usuarios de la plataforma |
| Balanceador de cargas | Expone los Pods de entrega de LLM (vLLM, Ollama) al tráfico desde fuera del clúster de Kubernetes, lo que proporciona una dirección IP estable. | Las solicitudes de clientes externos se envían a la IP externa del LoadBalancer. El LoadBalancer distribuye las solicitudes entre los Pods de backend en buen estado (vLLM u Ollama) según el selector del Service. | API de Service de Kubernetes. Aprovisiona automáticamente un balanceador de cargas de red dentro del entorno de GDC. |
| vLLM | Entrega de inferencia de LLM de alta capacidad de procesamiento. Optimizado para una latencia baja con técnicas como PagedAttention. Por lo general, entrega un modelo por instancia. | Recibe solicitudes de inferencia HTTP de los clientes. Carga los pesos del modelo desde la PVC activada. Realiza cálculos en las GPU conectadas. Devuelve respuestas HTTP con texto generado. | API de RESTful compatible con OpenAI para la inferencia. Acepta solicitudes JSON. |
| Ollama | Entrega de inferencias de LLM, diseñada para facilitar el uso; una instancia puede entregar varios modelos y cargarlos a pedido. | Recibe solicitudes de inferencia HTTP. Carga modelos desde la PVC activada (OLLAMA_MODELS) y realiza cálculos en las GPU conectadas. Devuelve respuestas HTTP. Los modelos se descargan después de un período de inactividad configurable (OLLAMA_KEEP_ALIVE). |
API de REST de Ollama y API compatible con OpenAI (/v1). Acepta solicitudes JSON. También tiene una CLI. |
| GPU de NVIDIA y MIG | Proporcionar aceleración de hardware para la inferencia de LLM | Los backends de LLM (vLLM, Ollama) descargan los cálculos intensivos del modelo (como las multiplicaciones de matrices) en las GPUs para acelerar la inferencia. MIG permite particionar una sola GPU para que la usen varias instancias de modelos más pequeños. | Se expone como un tipo de recurso en Kubernetes (por ejemplo, nvidia.com/gpu-pod-NVIDIA_H200; el nombre exacto del recurso depende del modelo de GPU instalado y se descubre a partir de los nodos). Los Pods solicitan estos recursos |
| Harbor | Almacena y administra de forma segura imágenes de contenedor para vLLM, Ollama, Open WebUI y cualquier Pod auxiliar (como busybox) | Las imágenes de contenedor se copian de los registros públicos a Harbor con seed_registry.sh (crane) desde una estación de trabajo con acceso a Internet. Los nodos de Kubernetes extraen estas imágenes de Harbor para ejecutar contenedores. |
API de Docker Registry Los nodos de Kubernetes interactúan con Harbor para extraer imágenes durante la creación de Pods. Los usuarios interactúan con crane, la CLI de Docker o la interfaz de usuario de Harbor para enviar imágenes. |
| Reclamaciones de volúmenes persistentes | Proporciona almacenamiento persistente para los pesos de los modelos de LLM, desvinculado de los ciclos de vida de los Pods. | Los archivos de modelo se descargan en la estación de trabajo, se usan para calcular de forma dinámica el tamaño de la PVC con un 25% de sobrecarga y se transmiten al volumen persistente a través de un Pod de cargador de modelos temporal (busybox) con model_weight_upload.sh. La PVC se aprovisiona con performance-rwo cuando se habilita el almacenamiento en bloque de alto rendimiento. De lo contrario, un operador de infraestructura aplica la política de QoS system-performance-<org>-admin a su volumen de respaldo. Cualquiera de las opciones proporciona 30 IOPS por GiB (mínimo de 6,148 IOPS). Ambos backends leen los pesos de sus modelos desde este volumen activado durante el inicio: vLLM carga el directorio del modelo de Hugging Face y Ollama apunta OLLAMA_MODELS a la ruta de activación. No se usa kubectl cp y no se agrupan modelos en imágenes de contenedor. |
API de almacenamiento de Kubernetes. Se definen en YAML (ReadWriteOnce) y se activan en los Pods como volúmenes. |
| Políticas de red | Aplicar el aislamiento de red y controlar el flujo de tráfico a los servicios de LLM Un espacio de nombres NetworkPolicy (networking.k8s.io/v1) admite tráfico al puerto de entrega desde dentro del clúster; además, se requiere un ProjectNetworkPolicy (networking.gdc.goog/v1) para el acceso desde fuera del proyecto. |
Se inspecciona el tráfico de red hacia y desde los Pods dentro del espacio de nombres. Las reglas de la política determinan si se permiten las conexiones a los puertos de servicio del LLM (por ejemplo, 8000 para vLLM, 11434 para Ollama), por lo general, según los rangos de IP de origen o de otras etiquetas. | Las APIs de Kubernetes networking.k8s.io/v1 y networking.gdc.goog/v1. Se define en YAML. |
| Open WebUI | Frontend opcional basado en el navegador para los usuarios finales. Se comunica con las APIs compatibles con OpenAI de vLLM y Ollama, no contiene pesos de modelos y no necesita acelerador. | Los usuarios acceden a Open WebUI a través de su Service de Kubernetes. Open WebUI reenvía las solicitudes de chat a los servicios de vLLM y Ollama a través de la API de /v1 compatible con OpenAI y mantiene su propio estado (usuarios, chats y configuración) en un volumen persistente. |
HTTP (navegador) para los usuarios y API de REST compatible con OpenAI para los backends. Carga de trabajo con estado implementada en su propio espacio de nombres. |
Características y funciones
Esta arquitectura de referencia proporciona las siguientes capacidades principales:
- Entrega de LLM de ponderación abierta: Permite el hosting y la inferencia de varios modelos de ponderación abierta (por ejemplo, Gemma 4, Llama, DeepSeek y Mistral).
- Componentes: Backends de entrega de LLM (vLLM, Ollama), Deployments/Pods de Kubernetes.
- Responsabilidades: Cargar pesos de modelos, administrar el proceso de inferencia, ejecutar modelos en aceleradores de hardware y exponer extremos.
- Interfaces: APIs de REST (compatibles con OpenAI para vLLM y Ollama, además de la API específica de Ollama) para solicitudes de inferencia, por lo general, con JSON.
- Usa tu propio modelo (BYOM): Los usuarios pueden importar e implementar los LLM de pesos abiertos
que elijan en el entorno aislado.
- Componentes: Harbor, reclamaciones de volúmenes persistentes, Pod de cargador de modelos, Kubernetes.
- Responsabilidades: Almacenamiento seguro de imágenes de contenedor y pesos de modelos. Mecanismo para transferir modelos al entorno
(
model_weight_upload.sha través del Pod del cargador) y hacer que los motores de entrega puedan acceder a ellos. - Interfaces: API de Docker Registry (para Harbor), API de Kubernetes (para PVC y activaciones de volúmenes).
- Inferencia acelerada por hardware: Usa GPUs de NVIDIA dentro del
clúster de GDC para ejecutar inferencias de LLM de manera eficiente.
- Componentes: GPU de NVIDIA, Kubernetes y complementos de dispositivos.
- Responsabilidades: Programar Pods en nodos con recursos de GPU.
Exponer el hardware de GPU a los contenedores de backend de LLM. Admite
GPU de instancias múltiples (MIG) para partición y paralelismo de tensores
de varias GPU (
TENSOR_PARALLEL_SIZE) para modelos grandes, como Mixtral 8x7Bbf16. - Interfaces: API de Kubernetes (para solicitar recursos de GPU, como
nvidia.com/gpu-pod-NVIDIA_H200onvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE).
- Acceso controlado por la red: Garantiza que el acceso a los extremos de inferencia de LLM esté controlado y aislado dentro del entorno de GDC.
- Componentes: Servicios de Kubernetes (LoadBalancer), NetworkPolicy, ProjectNetworkPolicy.
- Responsabilidades: Exponer servicios de inferencia con una IP estable. Definir y aplicar reglas de red para permitir o rechazar el tráfico a los backends de LLM en función del origen, el destino y los puertos
- Interfaces: API de Kubernetes (para Services, NetworkPolicy y ProjectNetworkPolicy).
- Entrega escalable: Permite ajustar la capacidad según la demanda.
- Componentes: Deployments de Kubernetes.
- Responsabilidades: Habilitar el escalamiento horizontal aumentando la cantidad de réplicas para los Pods de backend del LLM. Escalamiento vertical mediante el ajuste de las solicitudes y los límites de recursos
- Interfaces: API de Kubernetes (para administrar réplicas y recursos de Deployment).
- Frontend del navegador (opcional): Permite que los usuarios finales chateen con los modelos
implementados sin escribir llamadas a la API.
- Componentes: Implementación, Service y PersistentVolumeClaim de Open WebUI.
- Responsabilidades: Presentar los modelos que entregan vLLM y Ollama en una interfaz; conservar usuarios, chats y parámetros de configuración.
- Interfaces: HTTP (navegador); API de
/v1compatible con OpenAI hacia los backends.
Principios de arquitectura
- La seguridad es lo primero: Todos los componentes y datos residen dentro del
límite de GDC aislado, lo que garantiza la máxima seguridad
y el control de los datos. El acceso a la red se restringe con los objetos
NetworkPolicyyProjectNetworkPolicy. - Soberanía de los datos: Los clientes conservan el control total sobre sus modelos y datos, sin necesidad de conectividad externa para la operación.
- Abierta y flexible: La arquitectura usa backends de entrega de código abierto (vLLM, Ollama) y admite una variedad de LLM de pesos abiertos, lo que les brinda a los clientes opciones y evita la dependencia de un proveedor para el motor de inferencia.
- Desacoplamiento de componentes: Las funciones clave, como el almacenamiento de modelos (PVC), la administración de imágenes (Harbor), la entrega de inferencias (pods de vLLM/Ollama) y la interfaz de usuario (Open WebUI), son componentes distintos, lo que permite la administración y las actualizaciones independientes.
- Escalabilidad y rendimiento: Se diseñó para escalar de forma horizontal aumentando la cantidad de réplicas de Pods y de forma vertical ajustando los recursos de CPU y GPU (incluido el paralelismo de tensores de varias GPU) para satisfacer las demandas de rendimiento. vLLM se elige para situaciones de alta capacidad de procesamiento y baja latencia.
- Optimización de recursos: Admite la GPU de instancias múltiples (MIG) de NVIDIA para permitir que los modelos más pequeños compartan recursos de GPU de manera eficiente y el ajuste de tamaño dinámico de PVC (sobrecarga de +25%) junto con la QoS de almacenamiento de alto rendimiento para eliminar el aprovisionamiento excesivo de almacenamiento sin sacrificar la velocidad de carga del modelo.
- Interfaces estándar: Se basan en los estándares de Kubernetes para la organización, la implementación y la exposición de servicios. Los extremos de inferencia proporcionan APIs de REST, y tanto vLLM como Ollama ofrecen compatibilidad con OpenAI.
- Resiliencia: Usa las verificaciones de estado y la replicación de Kubernetes para garantizar la disponibilidad del servicio.
Consideraciones
- Escalabilidad y rendimiento:
- El escalamiento horizontal se logra aumentando la cantidad de réplicas en
el Deployment de Kubernetes para vLLM y Ollama. Sin una
StorageClass de
ReadOnlyMany, un Deployment de modelo se limita a una réplica (el volumen del modelo esReadWriteOnce); la capacidad adicional proviene de Deployments adicionales, cada uno con su propio PVC. - El escalamiento vertical implica asignar más CPU o memoria y porciones de GPU más grandes, hasta GPU completas o paralelismo de tensores de varias GPU
(
TENSOR_PARALLEL_SIZE) en varias GPU del mismo nodo. - vLLM entrega un modelo por instancia, lo que requiere implementaciones nuevas para modelos adicionales. Ollama puede entregar varios modelos desde una instancia. En estas guías, cada implementación de Ollama entrega un modelo.
- El tamaño de la PVC de cada modelo se ajusta de forma dinámica a partir de sus pesos descargados con
un 25% de sobrecarga y se configura con la política de QoS de almacenamiento de alto rendimiento
(
system-performance-<org>-admin, 30 IOPS por GiB con un mínimo de 6,148 IOPS, operformance-rwodonde se habilita el almacenamiento en bloque de alto rendimiento) para que los tiempos de carga del modelo no se limiten por el límite predeterminado destandard-rwo3 IOPS por GiB.
- El escalamiento horizontal se logra aumentando la cantidad de réplicas en
el Deployment de Kubernetes para vLLM y Ollama. Sin una
StorageClass de
- Administración de recursos:
- Es fundamental planificar con cuidado los recursos de GPU. NVIDIA MIG se puede usar
para particionar las GPU para modelos más pequeños, lo que mejora el uso, mientras que
los modelos más grandes (como Mixtral 8x7B en
bf16) pueden fragmentar los pesos en varias GPU con el paralelismo de tensores. - Se deben asignar la CPU y la memoria adecuadas para controlar la sobrecarga de inferencia y administración de modelos. vLLM y Ollama entregan modelos con aceleración por GPU.
- Se debe aprovisionar suficiente almacenamiento para que las PVC se adapten a los tamaños de los modelos y garanticen el rendimiento.
- Es fundamental planificar con cuidado los recursos de GPU. NVIDIA MIG se puede usar
para particionar las GPU para modelos más pequeños, lo que mejora el uso, mientras que
los modelos más grandes (como Mixtral 8x7B en
- Disponibilidad y confiabilidad:
- Los Deployments de Kubernetes proporcionan capacidades de reparación automática y actualización progresiva.
- Los objetos Service de tipo LoadBalancer distribuyen el tráfico entre los Pods en buen estado, lo que enmascara las fallas individuales de los Pods.
- Almacenar los pesos del modelo en PVC garantiza la persistencia en los reinicios de los Pods.
- Complejidad operativa:
- Administrar imágenes de contenedor para diferentes backends y versiones en Harbor
- Procedimientos para transferir de forma segura los pesos del modelo al entorno aislado.
- Crear y administrar manifiestos de Kubernetes (Deployments, Services, PVC y políticas de red) para cada modelo y backend
- Supervisar el uso de GPU, la latencia de inferencia y las tasas de error.
- Seguridad y cumplimiento:
- Toda la solución funciona dentro del perímetro de seguridad aislado de GDC.
- Las políticas de red son obligatorias para aplicar un aislamiento de red estricto y
controlar el acceso a los extremos del LLM: un espacio de nombres
NetworkPolicypara el acceso dentro del clúster y unProjectNetworkPolicypara el acceso desde fuera del proyecto. - Las cuentas de robot de Harbor y los secretos de extracción de imágenes de Kubernetes garantizan el acceso seguro a las imágenes de contenedor.
- Las políticas de red restringen qué clientes pueden acceder a los extremos. Los datos en reposo en las PVC dependen de la encriptación de almacenamiento de GDC.
Decisiones de diseño
Se tomaron las siguientes decisiones de diseño clave para esta arquitectura de referencia:
Decisión 1: Ofrecer vLLM y Ollama en lugar de un solo backend de entrega
| Contexto | Decisión clave | Razones |
|---|---|---|
| Ofrecer un backend de entrega (vLLM u Ollama) o ambos. | Ofrece ambas opciones, ya que los usuarios y los casos de uso difieren en sus requisitos de rendimiento, compatibilidad con APIs y facilidad de administración de modelos. | vLLM proporciona entrega de alta capacidad de procesamiento y baja latencia, y compatibilidad con la API de OpenAI, lo que es adecuado para aplicaciones de producción. Ollama ofrece una configuración más sencilla, una administración más fácil de varios modelos y facilidad de uso, lo que es mejor para el desarrollo y la experimentación. Admitir ambas opciones proporciona flexibilidad. |
Decisión 2: Pesos del modelo en PersistentVolumeClaims
| Contexto | Decisión clave | Razones |
|---|---|---|
| vLLM y Ollama requieren pesos de modelo en el sistema de archivos durante el tiempo de ejecución. En un entorno aislado, los modelos no se pueden descargar a pedido. | Almacena los pesos de cada modelo en su propio PersistentVolumeClaim de ReadWriteOnce, que se propaga desde la estación de trabajo a través de un Pod de cargador de modelos temporal. |
Las PersistentVolumeClaims proporcionan una capa de almacenamiento resiliente y persistente para archivos de modelos grandes, desvinculada del ciclo de vida del Pod de inferencia. Esto permite que los modelos se carguen con rapidez cuando se inicia el Pod. |
Decisión 3: Pesos del modelo en PersistentVolumes para Ollama (Pod de cargador) en lugar de agruparlos en la imagen
| Contexto | Decisión clave | Razones |
|---|---|---|
| Ollama puede descargar modelos, pero esto requiere acceso a Internet, que no está disponible en entornos aislados. En cambio, empaquetar los modelos en una imagen personalizada de Ollama requiere una imagen reconstruida para cada modelo y almacena imágenes de varios gigabytes en Harbor. | Ollama usa el mismo flujo de trabajo de Pod de cargador que vLLM: el modelo se extrae en la estación de trabajo (de ollama pull a ollama_model_weight_download.sh), se transmite al PVC a través del Pod de cargador de modelos con model_weight_upload.sh (GNU tar) y OLLAMA_MODELS se apunta a la ruta de activación. |
Un flujo de trabajo para ambos backends; los modelos se pueden agregar o actualizar sin volver a compilar las imágenes; la imagen de Ollama upstream sin modificar se mantiene pequeña en Harbor. |
Decisión 4: Expón vLLM y Ollama con servicios de LoadBalancer en comparación con ningún balanceador de cargas
| Contexto | Decisión clave | Razones |
|---|---|---|
| Las APIs de LLM deben ser accesibles para las aplicaciones dentro del entorno de GDC. | Exponer cada backend a través de un Service de tipo LoadBalancer, el enfoque estándar de Kubernetes Esto depende del aprovisionamiento del balanceador de cargas de la plataforma de GDC aislado. |
Los Services de Kubernetes de tipo LoadBalancer proporcionan un método estándar y confiable para exponer los backends de LLM, lo que proporciona una dirección IP estable y distribuye la carga. |
Decisión 5: Aplica políticas de red obligatorias (NetworkPolicy y ProjectNetworkPolicy)
| Contexto | Decisión clave | Razones |
|---|---|---|
| La seguridad y el aislamiento son fundamentales en las implementaciones de GDC aislado. | Aplica políticas de red en cada extremo de LLM (un espacio de nombres NetworkPolicy que solo admita el puerto de entrega, complementado por un ProjectNetworkPolicy cuando los clientes fuera del proyecto necesiten acceso) para mejorar la postura de seguridad de los servicios de LLM implementados. |
Los objetos NetworkPolicy proporcionan una forma nativa de Kubernetes de aplicar el aislamiento de red a nivel de espacio de nombres, y los objetos ProjectNetworkPolicy lo extienden al límite del proyecto, lo que garantiza que solo el tráfico autorizado pueda llegar a los servicios de LLM. |
Decisión 6: Ajuste dinámico del tamaño de PVC (sobrecarga de +25%) vinculado con la política de QoS de almacenamiento de alto rendimiento
| Contexto | Decisión clave | Razones |
|---|---|---|
La StorageClass standard-rwo predeterminada aplica la política de QoS adaptable de ONTAP standard-<org>-admin (3,072 IOPS per TiB o 3 IOPS per GiB, con un mínimo de 75 IOPS). Ajustar el tamaño de una PVC de standard-rwo estrictamente al tamaño de los pesos de un modelo limita las lecturas secuenciales de pesos a entre 5 MBps y 21 MBps, y aprovisionar en exceso PVCs estáticas de 300 GiB a 500 GiB desperdicia almacenamiento, a la vez que limita la capacidad de procesamiento de lectura secuencial a ~60 MBps. |
Primero, descarga los pesos del modelo, calcula de forma dinámica GDCS_MODEL_PVC_SIZE desde el directorio descargado con un 25% de sobrecarga redondeado al siguiente GiB entero y usa storageClassName: performance-rwo donde esté habilitado el almacenamiento en bloque de alto rendimiento, o pídele a un operador de infraestructura que aplique la política de QoS system-performance-${GDC_ORG}-admin al volumen de respaldo. |
La política de QoS system-performance-<org>-admin proporciona 30,720 IOPS per TiB (30 IOPS per GiB, 10 veces más que standard) con un mínimo de 6,148 IOPS (límite de ONTAP de ~393 MBps) para cualquier volumen de hasta 204 GiB. La vinculación del dimensionamiento dinámico de sobrecarga del 25% con system-performance elimina el aprovisionamiento excesivo de almacenamiento de 3x a 40x (de 12Gi a 109Gi en lugar de 100Gi a 500Gi), a la vez que aumenta la velocidad de lectura secuencial de virtio-scsi de KubeVirt de un solo LUN a ~150 MBps (inicio del modelo de 2.5x a 30x más rápido). |
Suposiciones y limitaciones
- Está disponible el entorno de GDC aislado 1.16.2 con la corrección de hotfix 1
(
1.16.2-gdch.1353-1) o una versión posterior (los grupos de nodos de GPU en clústeres estándar requieren esta versión; las versiones anteriores ofrecen GPU solo en clústeres compartidos). - Hay suficientes recursos de hardware (incluidas las GPU de NVIDIA) en el clúster estándar. Tanto vLLM como Ollama requieren una GPU.
- La instancia de Harbor está configurada y es accesible.
- Una estación de trabajo con acceso a Internet y conectividad al entorno de GDC (API de Harbor y Kubernetes) está disponible para propagar imágenes y subir pesos de modelos.
- Los usuarios tienen los permisos necesarios: los roles de proyecto de visualizador de instancias de Harbor y administrador de clústeres estándar, además de un StandardClusterRoleBinding (cluster-admin) en el clúster estándar. Consulta los SRI.
- Los modelos son compatibles con los backends de entrega elegidos (vLLM/Ollama).
- Limitación: La PVC del peso del modelo es
ReadWriteOnce. Sin una StorageClassReadOnlyMany, cada Deployment de modelo se limita a una réplica.
Flujo de usuarios
A continuación, se muestra un flujo de usuarios completo para implementar modelos de lenguaje grandes (LLM) de pesos abiertos en entornos aislados de Google Distributed Cloud (GDC). El flujo se divide en una configuración común, dos rutas de implementación (vLLM y Ollama), un frontend opcional y una validación final.
1. Configuración común: administración de imágenes
Antes de implementar cualquier LLM, debes configurar cómo el entorno de GDC extraerá las imágenes de contenedor de tu registro privado de Harbor.
- Crea cuentas de robot de Harbor: Genera cuentas de robot en la IU de Harbor:
una con permisos de envío para
crane(propagación de imágenes) y otra con permisos de extracción para el Secret de extracción de imágenes de Kubernetes. - Autentica las imágenes de Crane y Seed: Usa las credenciales de la cuenta de robot para
acceder a Harbor desde una estación de trabajo con acceso a Internet
(
crane auth login) y copia las imágenes de contenedor requeridas (busybox,ollama/ollama,vllm/vllm-openai, de forma opcional, Open WebUI) en Harbor conseed_registry.sh. - Crea un Secret de Kubernetes: Crea un Secret de docker-registry en el espacio de nombres de la carga de trabajo con kubectl para almacenar las credenciales de la cuenta de robot de extracción que usará el clúster.
2. Ruta de Deployment A: vLLM para alta capacidad de procesamiento
Se recomienda esta ruta para entregar modelos orientados al rendimiento, como Mistral 7B Instruct, en GPUs.
- Adquiere la imagen: Propaga la imagen de vLLM (
vllm/vllm-openai:v0.26.0) en Harbor conseed_registry.shy, luego, compila y envía la etiqueta de imagen con parchesv0.26.0-fipscomo se describe en el SRI. - Prepara el almacenamiento del modelo:
- Descarga los pesos de Hugging Face en la estación de trabajo (
hf download). - Calcula el tamaño de PVC requerido a partir de los pesos descargados (con un 25%
de sobrecarga), crea una reclamación de volumen persistente (PVC) de
ReadWriteOncepara almacenar los pesos del modelo y aplica la política de QoS de alto rendimiento. - Inicia un Pod de cargador de modelos temporal (
busybox) que active la PVC y transmite los pesos en él conmodel_weight_upload.sh(GNU tar sobrekubectl exec; no se usakubectl cpporque BusyBox tar no puede leer sus encabezados PAX para archivos de más de 8 GiB) y, luego, borra el Pod del cargador.
- Descarga los pesos de Hugging Face en la estación de trabajo (
- Implementa el backend: Aplica un manifiesto de Deployment de Kubernetes que haga referencia
a la imagen de vLLM, solicite el recurso de acelerador descubierto de los nodos
(por ejemplo,
nvidia.com/gpu-pod-NVIDIA_H200) y active la PVC de pesos del modelo. - Exponer el Service: Crea un Service LoadBalancer para proporcionar una IP externa para la API de vLLM.
- Red segura: Aplica una NetworkPolicy de espacio de nombres para permitir el tráfico de entrada en el puerto de servicio (8000). Agrega una ProjectNetworkPolicy cuando los clientes fuera del proyecto necesiten acceso.
3. Ruta de Deployment B: Ollama para facilitar el uso
Esta ruta se enfoca en una configuración simplificada. Usa la imagen de Ollama upstream sin cambios y el mismo flujo de trabajo del cargador de modelos que vLLM.
- Imagen de origen: Copia la imagen de Ollama ascendente (
ollama/ollama:0.32.14) en Harbor conseed_registry.sh. - Prepara el almacenamiento del modelo:
- Extrae el modelo (por ejemplo,
gemma4:e4b) en la estación de trabajo conollama_model_weight_download.sh, que ejecuta unollama servelocal temporal conOLLAMA_MODELSapuntando al directorio de descarga. - Calcula el tamaño de PVC requerido a partir de los pesos descargados (con un 25%
de sobrecarga), crea una PVC de
ReadWriteOnce, aplica la política de QoS de alto rendimiento y, luego, inicia un Pod de cargador de modelos temporal que la active. - Sube el directorio de descarga al PVC con
model_weight_upload.shy, luego, borra el Pod del cargador.
- Extrae el modelo (por ejemplo,
- Implementa y expón: Crea un Deployment de Ollama con
OLLAMA_MODELSque apunte a la ruta de activación de PVC (solicitando el recurso de acelerador descubierto de los nodos) y un servicio LoadBalancer. - Red segura: Aplica una NetworkPolicy de espacio de nombres para el puerto de Ollama (11434); agrega una ProjectNetworkPolicy cuando los clientes fuera del proyecto necesiten acceso.
4. Opcional: Abre la WebUI
- Implementa Open WebUI: Propaga la imagen de Open WebUI en Harbor y, luego, impleméntala
en su propio espacio de nombres con almacenamiento persistente para su estado. Apúntala a los
extremos de
/v1compatibles con OpenAI del servicio de vLLM, el servicio de Ollama o ambos. Los pasos se encuentran en la guía del usuario de Open WebUI para modelos de pesos abiertos.
5. Validación y prueba
Una vez implementados, los pasos finales implican verificar que los servicios sean funcionales.
- Verifica el estado: Comprueba que los Pods se estén ejecutando y que se hayan asignado direcciones IP externas a los Services.
- Inferencia de prueba:
- vLLM: Envía una solicitud curl a la IP del LoadBalancer de vLLM con los
extremos
/v1/modelsy/v1/chat/completionscompatibles con OpenAI. - Ollama: Envía una solicitud curl a la IP del LoadBalancer de Ollama con los mismos endpoints
/v1/modelsy/v1/chat/completionscompatibles con OpenAI.
- vLLM: Envía una solicitud curl a la IP del LoadBalancer de vLLM con los
extremos
- Resguardo de redirección de puertos: Cuando no se puede acceder a la IP de LoadBalancer desde la
estación de trabajo (por ejemplo, porque aún no hay una ProjectNetworkPolicy),
usa
kubectl port-forwardpara el Service y envía las mismas solicitudes a127.0.0.1.
6. Operaciones y escalamiento
- Escalamiento vertical: Aumenta las porciones de GPU o cambia a configuraciones de varias GPU para modelos más grandes.
- Escalamiento horizontal: Aumenta la cantidad de réplicas en la implementación
(requiere un volumen de modelo
ReadOnlyMany) o implementa implementaciones de modelos adicionales para controlar más solicitudes de usuarios simultáneas. - Solución de problemas: Supervisa los registros con
kubectl logsy verifica si hay problemas comunes, como fallas en la autoprueba de FIPS o restricciones de políticas de red.
Los pasos detallados se encuentran en la implementación de referencia de modelos de pesos abiertos con Ollama, la implementación de referencia de modelos de pesos abiertos con vLLM y sus guías del usuario.
Materiales adicionales
- Modelos de pesos abiertos con la implementación de referencia de Ollama
- Implementación de referencia de modelos de pesos abiertos con vLLM
- Guía del usuario de Gemma 4 E4B con Ollama
- [SUG] Mistral 7B Instruct con vLLM en GDC aislado
- [SUG] Mistral NeMo 12B Instruct con vLLM en GDC aislado
- [SUG] Mistral Small 3.2 24B Instruct con vLLM en GDC aislado
- [SUG] Ministral 8B Instruct con vLLM en GDC aislado
- [SUG] Mixtral 8x7B Instruct con vLLM en GDC aislado
- [SUG] Mistral Small 1.2 24B con vLLM en GDC aislado
- Guía del usuario de Open WebUI para modelos de pesos abiertos
- Documentación de vLLM
- Ollama
- Open WebUI
- Documentación de Google Distributed Cloud aislado