


En este documento, se proporcionan instrucciones paso a paso para implementar modelos de pesos abiertos en entornos aislados de Google Distributed Cloud (GDC). Se explica cómo usar vLLM para la entrega de alta capacidad de procesamiento con las capacidades de la plataforma de GDC, incluidos los recursos de Kubernetes, Harbor y acelerador (GPU).
Arquitectura
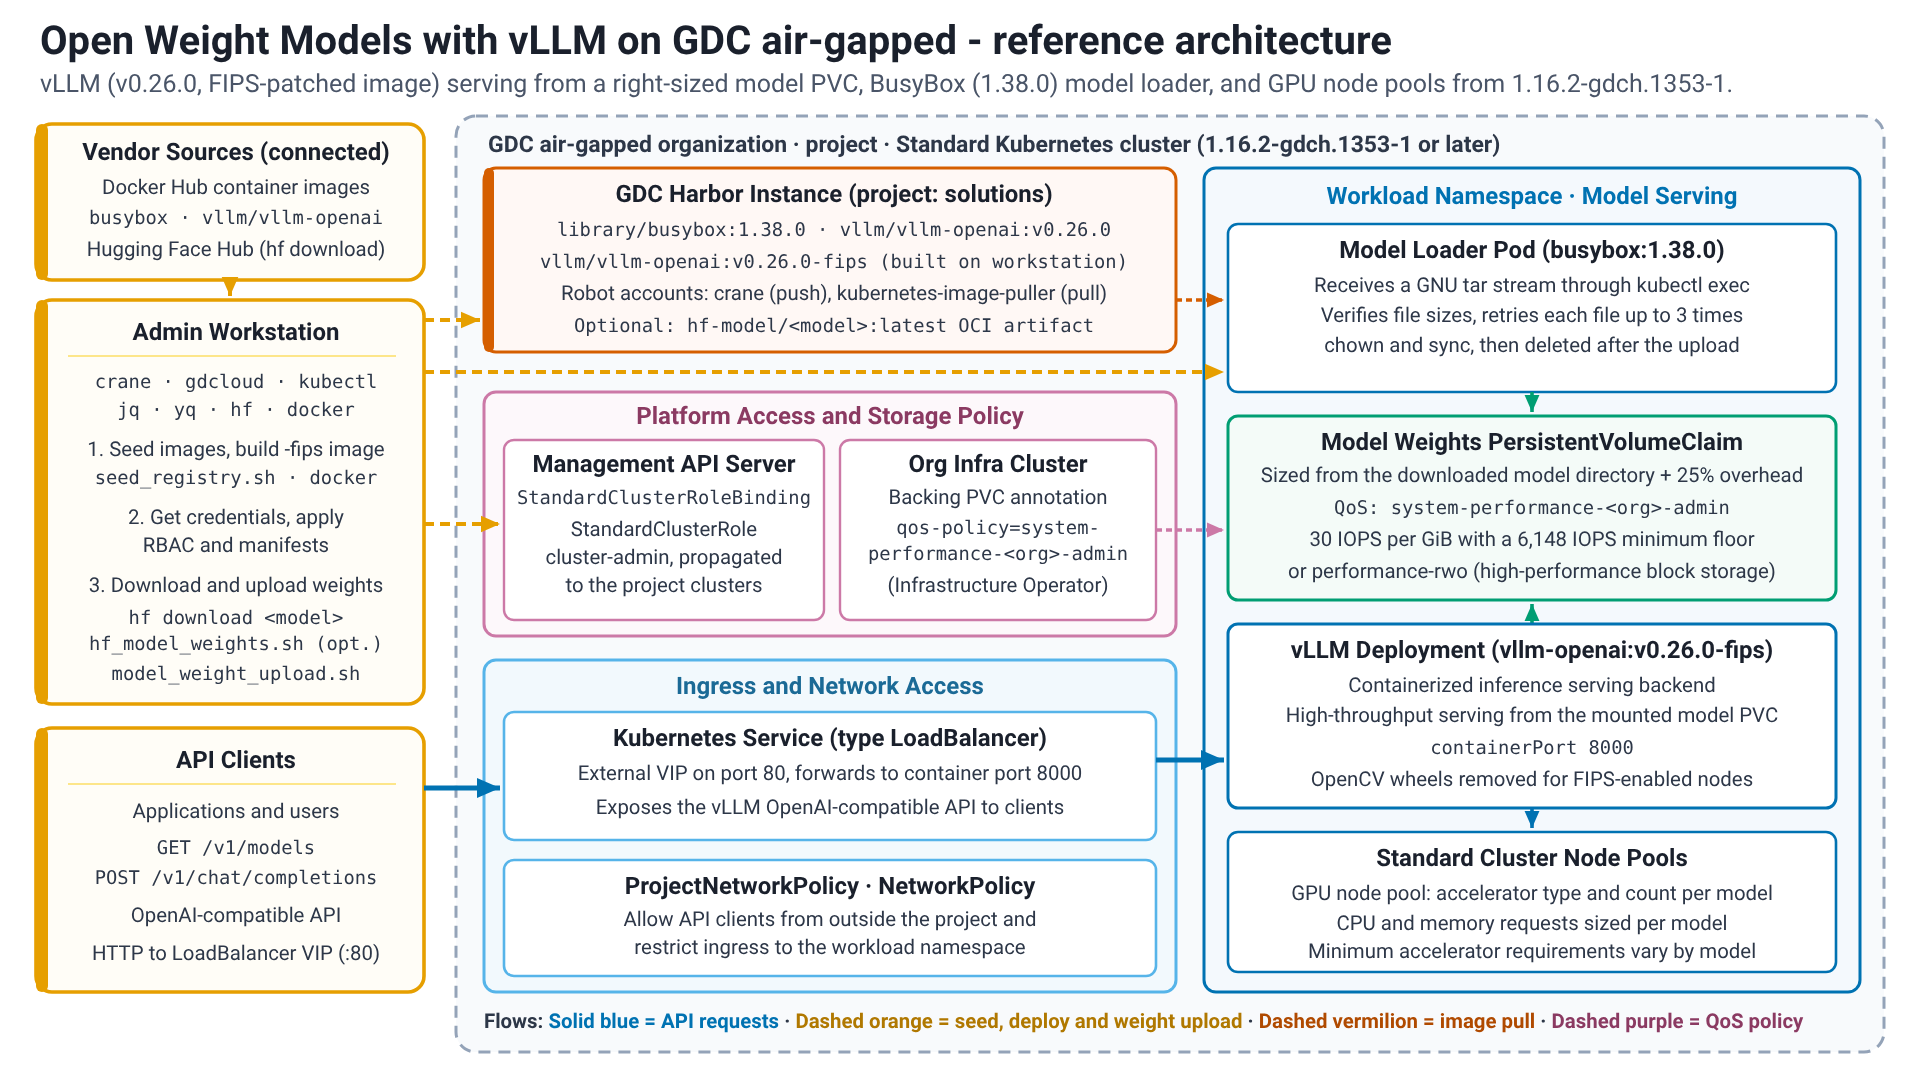
La solución implica implementar vLLM como un backend de entrega de inferencias alojado en contenedores (Deployment) dentro de un clúster estándar. Las ponderaciones del modelo se almacenan en
volúmenes persistentes que se dimensionan de forma dinámica a partir del directorio del modelo descargado
con una sobrecarga del 25%, configurados con la
política de QoS de almacenamiento system-performance-<org>-admin (30 IOPS por GiB con un
mínimo de 6,148 IOPS, o performance-rwo donde se habilita el almacenamiento en bloque
de alto rendimiento) y se propagan con un flujo de trabajo de cargador de modelos. Los Service de Kubernetes de tipo LoadBalancer exponen la API de backend, y los objetos NetworkPolicy /
ProjectNetworkPolicy protegen el acceso a ella.
Antes de comenzar
Antes de continuar con la implementación, asegúrate de que tu entorno cumpla con todos los requisitos previos necesarios y de que las utilidades de línea de comandos requeridas estén configuradas correctamente. Configurar estas herramientas en tu estación de trabajo es fundamental para administrar Container Registry, interactuar con clústeres y automatizar el proceso de implementación.
- Clúster estándar creado con recursos suficientes (CPU, memoria y acelerador). Los requisitos mínimos del acelerador variarán según el modelo.
- La instancia de Harbor debe estar disponible y accesible.
- Se aplicó la IAM necesaria.
- Estación de trabajo con la conectividad necesaria al entorno y a Internet
- Token de Hugging Face y condiciones aceptadas si se usan modelos controlados.
Configuración del entorno
Identity and Access Management
Asegúrate de que las cuentas, los roles y los permisos de IAM necesarios estén configurados de forma correcta.
Roles de usuario de GDC en la organización:
- Opcional: Administrador de clústeres estándar (visualiza clústeres desde la consola)
Roles de usuario de GDC en el proyecto (RoleBinding en el
espacio de nombres del proyecto, otorgado por un administrador de IAM del proyecto):
- Visualizador de instancias de Harbor (
harbor-instance-viewer) - Creador de proyectos de Harbor (
harbor-project-creator, solo si el proyecto de Harbor aún no existe) - Administrador de clústeres estándar (
standard-cluster-admin, obligatorio paragdcloud clusters get-credentials)
Rol de usuario de GDC en el clúster estándar: Los roles de proyecto anteriores no otorgan permisos dentro del clúster. Además, un administrador de IAM del proyecto debe vincular al usuario al StandardClusterRole cluster-admin con un StandardClusterRoleBinding en el espacio de nombres del proyecto en el servidor de la API de administración. La vinculación se propaga a los clústeres estándar del proyecto en cuestión de segundos (status.clusters[].conditions muestra Propagated=True).
cat <<EOF | kubectl apply --kubeconfig MANAGEMENT_API_SERVER -f -
apiVersion: iam.gdc.goog/v1
kind: StandardClusterRoleBinding
metadata:
  name: BINDING_NAME
  namespace: PROJECT
spec:
  roleRef:
    apiGroup: iam.gdc.goog
    kind: StandardClusterRole
    name: cluster-admin
  subjects:
    - apiGroup: rbac.authorization.k8s.io
      kind: User
      name: USER
EOF
Reemplaza lo siguiente:
MANAGEMENT_API_SERVER: Es la ruta de acceso al archivo kubeconfig del servidor de la API de administración.BINDING_NAME: un nombre para la vinculación, por ejemplo,alex-cluster-admin(letras minúsculas, dígitos y guiones).PROJECT: el nombre del proyecto.USER: Es el nombre de usuario que se vinculará, exactamente como lo informa tu proveedor de identidad (por ejemplo, una dirección de correo electrónico).
Asistencia del operador de infraestructura (solo cuando performance-rwo no está
disponible en el clúster estándar): Las guías del usuario crean el modelo
PersistentVolumeClaim con la StorageClass standard-rwo predeterminada, que
limita los volúmenes de modelos con el tamaño correcto a 3 IOPS por GiB. Pídele al operador de infraestructura
que aplique la política de QoS system-performance-<ORG>-admin al volumen
que respalda el modelo PersistentVolumeClaim para que reciba el mínimo de 6,148 IOPS. Las guías del usuario imprimen los valores que necesita el operador de infraestructura.
Permisos de la cuenta de robot de Harbor para crane:
- Enumera el repositorio
- Repositorio de extracción
- Repositorio de envío
- Lee el artefacto
- Enumera el artefacto
- Crear etiqueta
- Etiqueta de lista
Permisos de la cuenta de robot de Harbor para las extracciones de imágenes de Kubernetes:
- Enumera el repositorio
- Repositorio de extracción
- Lee el artefacto
- Enumera el artefacto
- Etiqueta de lista
Estación de trabajo
Ejecuta todos los comandos de esta guía desde una estación de trabajo con las herramientas y la conectividad necesarias para el entorno y la Internet, a menos que un paso indique lo contrario.
Requisitos
Las siguientes herramientas deben estar instaladas en la estación de trabajo:
crane: Administra y copia imágenes de contenedor entre registros (documentación).docker: Compila y envía la imagen de contenedor de vLLM con parches.gdcloud: Es la interfaz de línea de comandos (CLI) para administrar recursos de GDC (documentación).hf: Es la interfaz de línea de comandos (CLI) que se usa para acceder a Hugging Face.kubectl: Es la interfaz de línea de comandos (CLI) que se usa para comunicarse con un clúster de Kubernetes y administrarlo.jq: Procesador JSON de línea de comandos ligero y flexible.yq: Es un procesador YAML portátil de línea de comandos.
Configuración de la estación de trabajo
La siguiente información sobre el entorno es necesaria para la configuración de la estación de trabajo:
GDC_STANDARD_CLUSTER_NAME: Es el nombre del clúster estándar de GDC.GDC_DOMAIN_SUFFIX: Es el sufijo de dominio para el entorno de GDC (por ejemplo,gdc.example.com).GDC_ORG: Es el nombre de la organización de GDC.GDC_PROJECT: Es el nombre del proyecto de GDC.GDC_ZONE: Es el nombre de la zona de implementación de GDC.GDC_HARBOR_INSTANCE_NAME: Es el nombre de la instancia de Harbor en el proyecto.GDCS_HARBOR_PROJECT_NAME: Es el nombre del proyecto de Harbor que se usará para las imágenes (predeterminado:solutions).GDCS_HARBOR_CRANE_ROBOT_NAME: Es el nombre de la cuenta de robot de Harborcrane.GDCS_HARBOR_CRANE_ROBOT_TOKEN: Es el token de autenticación de la cuenta de robot de Harborcrane.GDCS_HARBOR_K8S_ROBOT_NAME: Es el nombre de la cuenta de robot de extracción de imágenes de Kubernetes de Harbor.GDCS_HARBOR_K8S_ROBOT_TOKEN: Es el token de autenticación de la cuenta de robot de extracción de imágenes de Harbor para Kubernetes.
Una vez que hayas recopilado los valores de todas las variables requeridas, genera el archivo de variables de entorno. Después de crearlo, puedes editarlo de forma manual en cualquier momento.
Crea los directorios de la solución raíz y la carpeta de secretos:
mkdir -p ${HOME}/gdcag-solutions/env.d
mkdir -p ${HOME}/gdcag-solutions/secrets

touch ${HOME}/gdcag-solutions/secrets/harbor_crane_robot_token
touch ${HOME}/gdcag-solutions/secrets/harbor_k8s_robot_token

chmod u=rwx,go= ${HOME}/gdcag-solutions/secrets
chmod -R u=rw,go= ${HOME}/gdcag-solutions/secrets/*
Crea el archivo de configuración del entorno de la plataforma:
cat << 'EOF' > ${HOME}/gdcag-solutions/env.d/platform.sh && echo "Successfully created." || echo "Failed to create!"
# Infrastructure (Platform Native)
export GDC_STANDARD_CLUSTER_NAME="STANDARD_CLUSTER_NAME"
export GDC_DOMAIN_SUFFIX="DOMAIN_SUFFIX"
export GDC_ORG="ORG"
export GDC_PROJECT="PROJECT"
export GDC_ZONE="ZONE"
export GDC_HARBOR_INSTANCE_NAME="HARBOR_INSTANCE_NAME"

# Derived platform values
export GDC_ZONAL_HOSTNAME="${GDC_ORG}.${GDC_ZONE}.${GDC_DOMAIN_SUFFIX}"
export GDC_ZONAL_CONSOLE_URL="https://console.${GDC_ZONAL_HOSTNAME}"
export GDC_HARBOR_HOST="${GDC_HARBOR_INSTANCE_NAME}-${GDC_PROJECT}.${GDC_ORG}.${GDC_ZONE}.${GDC_DOMAIN_SUFFIX}"
EOF
Reemplaza lo siguiente:
STANDARD_CLUSTER_NAME: Es el nombre del clúster estándar de GDC.DOMAIN_SUFFIX: Es el sufijo del dominio de GDC.ORG: Es la organización de GDC.PROJECT: Es el proyecto de GDC.ZONE: Es la zona de GDC.HARBOR_INSTANCE_NAME: Es el nombre de la instancia de GDC Harbor.
Crea el archivo de configuración del entorno del registro:
cat << 'EOF' > ${HOME}/gdcag-solutions/env.d/registry.sh && echo "Successfully created." || echo "Failed to create!"
# GDC Solutions Registry & Secrets
export GDCS_HARBOR_PROJECT_NAME="solutions"
export GDCS_HARBOR_CRANE_ROBOT_NAME='HARBOR_CRANE_ROBOT_NAME'
export GDCS_HARBOR_CRANE_ROBOT_TOKEN="$(cat ${GDCS_ROOT_HOME}/secrets/harbor_crane_robot_token)"
export GDCS_HARBOR_K8S_ROBOT_NAME='HARBOR_K8S_ROBOT_NAME'
export GDCS_HARBOR_K8S_ROBOT_TOKEN="$(cat ${GDCS_ROOT_HOME}/secrets/harbor_k8s_robot_token)"
export GDCS_HARBOR_K8S_PULL_SECRET="gdcs-image-pull-secret"

# Derived registry values
export GDCS_HARBOR_PROJECT_URI="${GDC_HARBOR_HOST}/${GDCS_HARBOR_PROJECT_NAME}"
export GDCS_HARBOR_CHART_OCI_URI="oci://${GDCS_HARBOR_PROJECT_URI}"
EOF
Reemplaza lo siguiente:
HARBOR_CRANE_ROBOT_NAME: Es el nombre completo de la cuenta de robot de Harbor paracrane, como lo muestra Harbor, incluido el prefijorobot$. Conserva las comillas simples para que la shell no expanda$.HARBOR_K8S_ROBOT_NAME: Es el nombre completo de la cuenta de robot de Harbor para las extracciones de imágenes de Kubernetes, como lo muestra Harbor, incluido el prefijorobot$. Mantén las comillas simples para que la shell no expanda$.
Agrega tus tokens a los archivos de Secrets:
set +o history

echo "CRANE_ROBOT_TOKEN" > ${HOME}/gdcag-solutions/secrets/harbor_crane_robot_token
echo "KUBERNETES_ROBOT_TOKEN" > ${HOME}/gdcag-solutions/secrets/harbor_k8s_robot_token

set -o history
Reemplaza lo siguiente:
CRANE_ROBOT_TOKEN: Es el secreto de la cuenta de robot decrane.KUBERNETES_ROBOT_TOKEN: Es el secreto de la cuenta de robot de extracción de imágenes de Kubernetes.
Crea el archivo de carga del entorno raíz:
cat << 'EOF' > ${HOME}/gdcag-solutions/env.sh && echo "Successfully created." || echo "Failed to create!"
export GDCS_ROOT_HOME="${HOME}/gdcag-solutions"
echo "GDCS_ROOT_HOME=${GDCS_ROOT_HOME}"

# Sourced in dependency order
source "${GDCS_ROOT_HOME}/env.d/platform.sh"
source "${GDCS_ROOT_HOME}/env.d/registry.sh"
EOF
Configura las variables de la solución
Crea el directorio de implementación de la solución y la carpeta de Secrets:
mkdir -p ${HOME}/gdcag-solutions/open-weight-models/vllm/env.d
mkdir -p ${HOME}/gdcag-solutions/open-weight-models/vllm/secrets

touch ${HOME}/gdcag-solutions/open-weight-models/vllm/secrets/huggingface_token
chmod u=rwx,go= ${HOME}/gdcag-solutions/open-weight-models/vllm/secrets
chmod -R u=rw,go= ${HOME}/gdcag-solutions/open-weight-models/vllm/secrets/*
Agrega tu token de Hugging Face al archivo de Secret:
set +o history

echo "HUGGINGFACE_TOKEN" > ${HOME}/gdcag-solutions/open-weight-models/vllm/secrets/huggingface_token

set -o history
Reemplaza lo siguiente:
HUGGINGFACE_TOKEN: Tu token de acceso de Hugging Face.
Crea el archivo de configuración del acelerador:
cat << 'EOF' > ${HOME}/gdcag-solutions/open-weight-models/vllm/env.d/accelerator.sh && echo "Successfully created." || echo "Failed to create!"
# Workload Accelerator (NVIDIA GPU)
export GDCS_WORKLOAD_ACCELERATOR_TYPE="WORKLOAD_ACCELERATOR_TYPE"
export GDCS_WORKLOAD_ACCELERATOR_COUNT="1"
EOF
Reemplaza lo siguiente:
WORKLOAD_ACCELERATOR_TYPE: Es el nombre del recurso de GPU que exponen tus nodos de GPU, por ejemplo,nvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE. En las guías del usuario, se indica el nombre del recurso de cada GPU que ofrece GDC aislado. Después de recuperar las credenciales del clúster, puedes enumerar los nombres en tu clúster conkubectl get nodes --output=json | jq -r '[.items[].status.allocatable | keys[] | select(startswith("nvidia.com/"))] | unique[]'.
Crea el archivo de configuración del entorno de la solución:
cat << 'EOF' > ${HOME}/gdcag-solutions/open-weight-models/vllm/env.d/vllm.sh && echo "Successfully created." || echo "Failed to create!"
# Hugging Face
export HF_TOKEN="$(cat ${GDCS_IMPLEMENTATION_HOME}/secrets/huggingface_token 2>/dev/null || echo '')"

# Images
export GDCS_BUSYBOX_IMAGE_TAG="1.38.0"
export GDCS_VLLM_IMAGE_TAG="v0.26.0"

# Docker configuration directories for crane and Kubernetes
export GDCS_HARBOR_CRANE_DOCKER_CONFIG="${GDCS_IMPLEMENTATION_HOME}/docker/crane"
export GDCS_HARBOR_K8S_DOCKER_CONFIG="${GDCS_IMPLEMENTATION_HOME}/docker/k8s"
EOF
Crea el archivo del cargador del entorno de implementación:
cat << 'EOF' > ${HOME}/gdcag-solutions/open-weight-models/vllm/env.sh && echo "Successfully created." || echo "Failed to create!"
source "${HOME}/gdcag-solutions/env.sh"

export GDCS_IMPLEMENTATION_HOME="${HOME}/gdcag-solutions/open-weight-models/vllm"
echo "GDCS_IMPLEMENTATION_HOME=${GDCS_IMPLEMENTATION_HOME}"

# Sourced in dependency order
source "${GDCS_IMPLEMENTATION_HOME}/env.d/accelerator.sh"
source "${GDCS_IMPLEMENTATION_HOME}/env.d/vllm.sh"
EOF
Edita y revisa los archivos de entorno con tu editor preferido:
${EDITOR:-vi} ${HOME}/gdcag-solutions/env.d/platform.sh
${EDITOR:-vi} ${HOME}/gdcag-solutions/env.d/registry.sh
${EDITOR:-vi} ${HOME}/gdcag-solutions/open-weight-models/vllm/env.d/accelerator.sh
${EDITOR:-vi} ${HOME}/gdcag-solutions/open-weight-models/vllm/env.d/vllm.sh
Carga el archivo de entorno:
source ${HOME}/gdcag-solutions/open-weight-models/vllm/env.shEl resultado es similar a lo siguiente:
GDCS_ROOT_HOME=HOME_DIRECTORY_PATH/gdcag-solutions
GDCS_IMPLEMENTATION_HOME=HOME_DIRECTORY_PATH/gdcag-solutions/open-weight-models/vllm
GDC
En esta guía, se supone que tu estación de trabajo está configurada para confiar en los certificados TLS de tu entorno de GDC y tu instancia de Harbor.
Configura
gdcloud:gdcloud config set core/account "default-user" gdcloud config set core/organization_console_url "${GDC_ZONAL_CONSOLE_URL}" gdcloud config set core/project "${GDC_PROJECT}" gdcloud config set core/zone "${GDC_ZONE}"Autentícate en el entorno de GDC:
gdcloud auth login
Clúster
Recupera las credenciales del clúster:
gdcloud clusters get-credentials "${GDC_STANDARD_CLUSTER_NAME}" \
--project="${GDC_PROJECT}" \
--standard \
--zone="${GDC_ZONE}"
Verifica la conectividad con el clúster:
kubectl get nodes -L node.cluster.private.gdc.goog/machine-class
Preparación para la migración de artefactos
- Verifica la conectividad y la configuración de Artifact Registry.
Crea un archivo de configuración de Docker para crane. Se usa una cuenta de robot para enviar capas de imágenes grandes y evitar tiempos de espera de tokens de autenticación cuando se usa el asistente de credenciales del servicio de Harbor administrado (MHS) (docker-credential-mhs) con una cuenta de usuario:
export DOCKER_CONFIG="${GDCS_HARBOR_CRANE_DOCKER_CONFIG}"

crane auth login "${GDC_HARBOR_HOST}" \
--password="${GDCS_HARBOR_CRANE_ROBOT_TOKEN}" \
--username="${GDCS_HARBOR_CRANE_ROBOT_NAME}"
Crea un archivo de configuración de Docker para Kubernetes:
export DOCKER_CONFIG="${GDCS_HARBOR_K8S_DOCKER_CONFIG}"

crane auth login "${GDC_HARBOR_HOST}" \
--password="${GDCS_HARBOR_K8S_ROBOT_TOKEN}" \
--username="${GDCS_HARBOR_K8S_ROBOT_NAME}"
Crea la secuencia de comandos
seed_registry.sh:cat << 'EOF' > ${GDCS_IMPLEMENTATION_HOME}/seed_registry.sh && echo "Successfully created." || echo "Failed to create!" #!/bin/bash # seed_registry.sh: Modular artifact migration for GDC Solutions # Requires the env.sh file to be sourced first. SCRIPT_DIR="$(cd "$(dirname "${BASH_SOURCE[0]}")" && pwd)" set -o nounset source "${SCRIPT_DIR}/env.sh" # Set the Docker config export DOCKER_CONFIG="${GDCS_HARBOR_CRANE_DOCKER_CONFIG}" eval "${SERIALIZED_IMAGES}" # Ensure GDCS_REGISTRY_IMAGES is set if [[ ${#GDCS_REGISTRY_IMAGES[@]} -eq 0 ]]; then echo "GDCS_REGISTRY_IMAGES must be set, exiting..." exit 1 fi # Migrate the images for source_image in "${GDCS_REGISTRY_IMAGES[@]}"; do # Strip the registry host only when the first path segment is a host (contains a dot or a port) first_segment="${source_image%%/*}" if [[ "${first_segment}" == *.* || "${first_segment}" == *:* ]]; then image_path="${source_image#*/}" else image_path="${source_image}" fi destination_image="${GDCS_HARBOR_PROJECT_URI}/${image_path}" # Ensure the folder structure is created crane append \ --new_layer=<(tar czf - -T /dev/null) \ --new_tag="${destination_image%:*}:create" \ --oci-empty-base 2> /dev/null || true # Copy the linux/amd64 platform only to avoid transferring multi-arch layers over air-gapped links crane copy --platform linux/amd64 "${source_image}" "${destination_image}" || { echo "Failed to copy ${source_image} to ${destination_image}"; exit 1; } done echo "Migration complete: Images are available at ${GDCS_HARBOR_PROJECT_URI}" EOF chmod u+x "${GDCS_IMPLEMENTATION_HOME}/seed_registry.sh"Define la lista de imágenes de contenedor necesarias para la solución:
declare -a GDCS_REGISTRY_IMAGES=(
  "docker.io/library/busybox:${GDCS_BUSYBOX_IMAGE_TAG}"
  "docker.io/vllm/vllm-openai:${GDCS_VLLM_IMAGE_TAG}"
)
export SERIALIZED_IMAGES=$(declare -p GDCS_REGISTRY_IMAGES)
Propaga las imágenes de contenedor requeridas al Artifact Registry:
${GDCS_IMPLEMENTATION_HOME}/seed_registry.sh
Crea un Dockerfile para aplicar parches al contenedor de vLLM hasta que se implementen los cambios ascendentes:
cat <<EOF > ${GDCS_IMPLEMENTATION_HOME}/docker/vllm-${GDCS_VLLM_IMAGE_TAG}-patch.dockerfile && echo "Successfully created." || echo "Failed to create!" FROM docker.io/vllm/vllm-openai:${GDCS_VLLM_IMAGE_TAG} RUN pip install --upgrade "opencv-python-headless<=4.12.0.88" EOFCompila y envía la imagen con parches:
context_dir="${GDCS_IMPLEMENTATION_HOME}/docker/empty-context"
image="${GDCS_HARBOR_PROJECT_URI}/vllm/vllm-openai:${GDCS_VLLM_IMAGE_TAG}-fips"

mkdir -p "${context_dir}"
rm -rf "${context_dir}"/*

export DOCKER_CONFIG="${GDCS_HARBOR_CRANE_DOCKER_CONFIG}"

docker build \
--file="${GDCS_IMPLEMENTATION_HOME}/docker/vllm-${GDCS_VLLM_IMAGE_TAG}-patch.dockerfile" \
--tag="${image}" \
"${context_dir}"

docker push "${image}"
Crea la secuencia de comandos
model_weight_upload.shCopia un directorio de modelos local en elPersistentVolumea través del cargador de modelosPod(transmisión de GNUtar, incluidos los archivos de más de 8 GiB) y omite los archivos que ya están presentes con el mismo tamaño:cat << 'EOF' > ${GDCS_IMPLEMENTATION_HOME}/model_weight_upload.sh && echo "Successfully created." || echo "Failed to create!" #!/bin/bash # model_weight_upload.sh: copy LOCAL_MODEL_DIR into REMOTE_MODEL_DIR on the PersistentVolume mounted in the loader Pod. # Requires: GDCS_WORKLOAD_NAMESPACE, GDCS_MODEL_LOADER_POD_NAME, LOCAL_MODEL_DIR, REMOTE_MODEL_DIR # Optional: REMOTE_MOUNT_DIR (PersistentVolume mount path, defaults to REMOTE_MODEL_DIR) - its lost+found directory is removed. SCRIPT_DIR="$(cd "$(dirname "${BASH_SOURCE[0]}")" && pwd)" set -o errexit set -o nounset set -o pipefail # Ensure LOCAL_MODEL_DIR is set if [[ -z "${LOCAL_MODEL_DIR:-}" ]]; then echo "LOCAL_MODEL_DIR must be set, exiting..." exit 1 fi # Ensure REMOTE_MODEL_DIR is set if [[ -z "${REMOTE_MODEL_DIR:-}" ]]; then echo "REMOTE_MODEL_DIR must be set, exiting..." exit 1 fi REMOTE_MOUNT_DIR="${REMOTE_MOUNT_DIR:-${REMOTE_MODEL_DIR}}" KEEPALIVE_INTERVAL_SEC=300 start_session_keepalive() { echo "[KeepAlive] Started background heartbeat (every ${KEEPALIVE_INTERVAL_SEC}s)." while true; do sleep "${KEEPALIVE_INTERVAL_SEC}" # Lightweight API request to prevent session inactivity logout if kubectl get namespace "${GDCS_WORKLOAD_NAMESPACE}" >/dev/null 2>&1; then echo "[KeepAlive] Session heartbeat sent at $(date)" else echo "[KeepAlive] Heartbeat failed or context expired at $(date)" fi done } start_session_keepalive & MY_KEEPALIVE_PID=$! cleanup() { echo "[Cleanup] Stopping keep-alive process (PID: ${MY_KEEPALIVE_PID})..." kill "${MY_KEEPALIVE_PID}" 2>/dev/null || true wait "${MY_KEEPALIVE_PID}" 2>/dev/null || true echo "[Cleanup] Session keep-alive terminated." } trap cleanup EXIT INT TERM # Remove the lost+found directory kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- rm -rf "${REMOTE_MOUNT_DIR}/lost+found" # Create the model directory kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- mkdir -p "${REMOTE_MODEL_DIR}" # Loop through all files in the local directory FAILED_FILES=() MAX_UPLOAD_ATTEMPTS="${MAX_UPLOAD_ATTEMPTS:-3}" remote_size_of() { # Prints the remote file size (0 if the file does not exist) kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" --namespace="${GDCS_WORKLOAD_NAMESPACE}" -- stat -c%s "$1" 2>/dev/null || echo 0 } # Loop through all files in the local directory (process substitution keeps FAILED_FILES in this shell) while read -r local_file; do # Get relative path rel_path="${local_file#"${LOCAL_MODEL_DIR}"/}" remote_file="${REMOTE_MODEL_DIR}/${rel_path}" # Get local file size local_size=$(stat -L -c%s "${local_file}") # Get remote file size (returns 0 if file does not exist) remote_size=$(remote_size_of "${remote_file}") if [ "${local_size}" -eq "${remote_size}" ]; then echo "[Loader] Skipping: ${rel_path} (Size matches)" continue fi if [ "${remote_size}" -ne "0" ]; then echo "[Loader] Mismatch: ${rel_path} (${remote_size} remote vs ${local_size} local)" fi # Ensure remote parent subdirectories exist if your model has folders remote_parent=$(dirname "${remote_file}") kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- mkdir -p "${remote_parent}" attempt=1 while [ "${attempt}" -le "${MAX_UPLOAD_ATTEMPTS}" ]; do echo "[Loader] Uploading: ${rel_path} (${local_size} bytes, attempt ${attempt}/${MAX_UPLOAD_ATTEMPTS})..." # Copy the individual file using GNU tar streaming. # Note: 'kubectl cp' uses Go's archive/tar, which defaults to PAX format for files > 8 GiB. # BusyBox's tar in the loader pod does not parse PAX size headers and fails with 'tar: invalid tar magic'. # Streaming via GNU tar (--format=gnu) uses base-256 binary encoding for files > 8 GiB, which BusyBox tar supports. tar --format=gnu -C "$(dirname "${local_file}")" -cf - "$(basename "${local_file}")" | \ kubectl exec -i "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- tar -xf - -C "${remote_parent}" || true # Verify: an interrupted exec stream leaves a truncated file behind without an error remote_size=$(remote_size_of "${remote_file}") if [ "${local_size}" -eq "${remote_size}" ]; then echo "[Loader] Verified: ${rel_path} (${remote_size} bytes)" break fi echo "[Loader] Incomplete upload: ${rel_path} (${remote_size} remote vs ${local_size} local), retrying..." attempt=$((attempt + 1)) done if [ "${local_size}" -ne "${remote_size}" ]; then FAILED_FILES+=("${rel_path}") fi done < <(find -L "${LOCAL_MODEL_DIR}" -type f) if [ "${#FAILED_FILES[@]}" -ne 0 ]; then echo "[Loader] FAILED: ${#FAILED_FILES[@]} file(s) could not be uploaded completely after ${MAX_UPLOAD_ATTEMPTS} attempts:" printf '[Loader] %s\n' "${FAILED_FILES[@]}" exit 1 fi echo "[Loader] Completed" # Fix file permissions kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- chown 0:0 -R "${REMOTE_MODEL_DIR}" # Flush the volume before the loader Pod is deleted (a detached volume with unwritten page cache loses data) kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- sync EOF chmod u+x "${GDCS_IMPLEMENTATION_HOME}/model_weight_upload.sh"
Implementar un modelo
- Guía del usuario de modelos de Gemma con vLLM: Gemma 4 E2B, E4B, 12B, 26B-A4B y 31B, con las opciones de GPU de GDC aislado
- Guía del usuario de modelos de Mistral con vLLM: Mistral 7B Instruct, Mistral NeMo 12B, Mistral Small 3.2 24B, Ministral 8B, Mixtral 8x7B y Magistral Small 1.2, con las opciones de GPU de GDC aislado