


Descripción general
En esta arquitectura de referencia, se define el diseño conceptual para implementar Elastic Stack (Elasticsearch y Kibana) en Google Distributed Cloud (GDC) aislado y para integrarlo con un servicio de modelo de lenguaje grande (LLM) para habilitar las funciones potenciadas por IA generativa de Elastic.
El Elastic Stack es una plataforma de búsqueda, observabilidad y análisis de seguridad ampliamente adoptada. Las versiones recientes de Elastic agregan capacidades de IA generativa a Kibana, incluido el Elastic AI Agent, agentes personalizados creados con Agent Builder, y Attack Discovery. Estas funciones se basan en un LLM para traducir solicitudes de lenguaje natural en consultas de Elasticsearch, organizar llamadas a herramientas de varios pasos y correlacionar alertas de seguridad.
Esta arquitectura implementa Elastic Stack con el operador oficial de Elastic Cloud on Kubernetes (ECK) disponible en GDC aislado y conecta Kibana a un extremo de inferencia de LLM alojado dentro del límite de GDC, ya sea el servicio administrado de Gemini en GDC o un servidor de inferencia autoadministrado compatible con OpenAI, como Ollama o vLLM.
Características y funciones
La solución proporciona varios componentes funcionales principales para la búsqueda, la observabilidad y el análisis de seguridad asistidos por IA:
- Administración del ciclo de vida basada en Marketplace: Instala el operador de ECK desde
GDC aislado Marketplace en un espacio de nombres del proyecto
en un clúster compartido y permite que automatice el aprovisionamiento,
la configuración y la conciliación de
ElasticsearchyKibanarecursos personalizados. - Investigación de datos en lenguaje natural: Usa el agente de IA de Elastic para explorar datos de Elasticsearch en lenguaje natural. El agente descubre índices y asignaciones, genera y ejecuta consultas de ES|QL, y sintetiza hallazgos sin requerir conocimientos previos del esquema subyacente.
- Agentes personalizados y flujos de trabajo automatizados: Usa Agent Builder para crear agentes específicos que combinen instrucciones personalizadas con herramientas integradas, herramientas personalizadas de ES|QL y flujos de trabajo de Kibana (por ejemplo, abrir automáticamente casos de seguridad de Kibana con hallazgos de investigación).
- Correlación de alertas de seguridad basada en IA: Usa Attack Discovery para analizar alertas abiertas de Elastic Security, asignarlas al framework de MITRE ATT&CK y correlacionar alertas relacionadas, direcciones IP y cuentas de usuario en cadenas de ataque.
- Compatibilidad con el aislamiento: El operador de ECK, Elasticsearch y las imágenes de contenedor de Kibana se extraen del registro local de Harbor de GDC, y todo el tráfico de inferencia de LLM permanece en la red interna de GDC.
- Backends de LLM conectables: Conecta Kibana a Gemini administrado en
GDC o a cualquier servidor de inferencia autoadministrado que exponga
una API compatible con OpenAI
/v1/chat/completionsa través del conector de OpenAI de Kibana.
Principios de arquitectura
- Modelo de responsabilidad compartida: GDC proporciona el clúster compartido, el paquete de Marketplace, el registro de Harbor y la red. El cliente opera la implementación de Elastic Stack, administra las licencias de Elastic y es propietario de la selección y la operación del servicio de LLM autoadministrado (si se usa).
- Soberanía de datos: Todos los datos operativos y de seguridad, las instrucciones y las respuestas del modelo permanecen dentro del límite aislado de GDC. No se envía tráfico a los servicios de LLM públicos o alojados en Elastic.
- Operaciones nativas de la nube: Usa el patrón de operador de Kubernetes para administrar las cargas de trabajo de Elastic con estado de forma declarativa, lo que garantiza implementaciones coherentes y repetibles
- Estandarización de protocolos: Se basa en la API de finalización de chat compatible con OpenAI ampliamente compatible con la llamada a funciones nativas, lo que desacopla Kibana de cualquier motor de inferencia o proveedor de modelos específico.
Arquitectura
La arquitectura consta de una implementación de Elastic Stack administrada por el operador de ECK dentro de un espacio de nombres del proyecto en un clúster de usuario compartido de GDC. Kibana se comunica a través de la red interna de GDC con un extremo de inferencia de LLM.
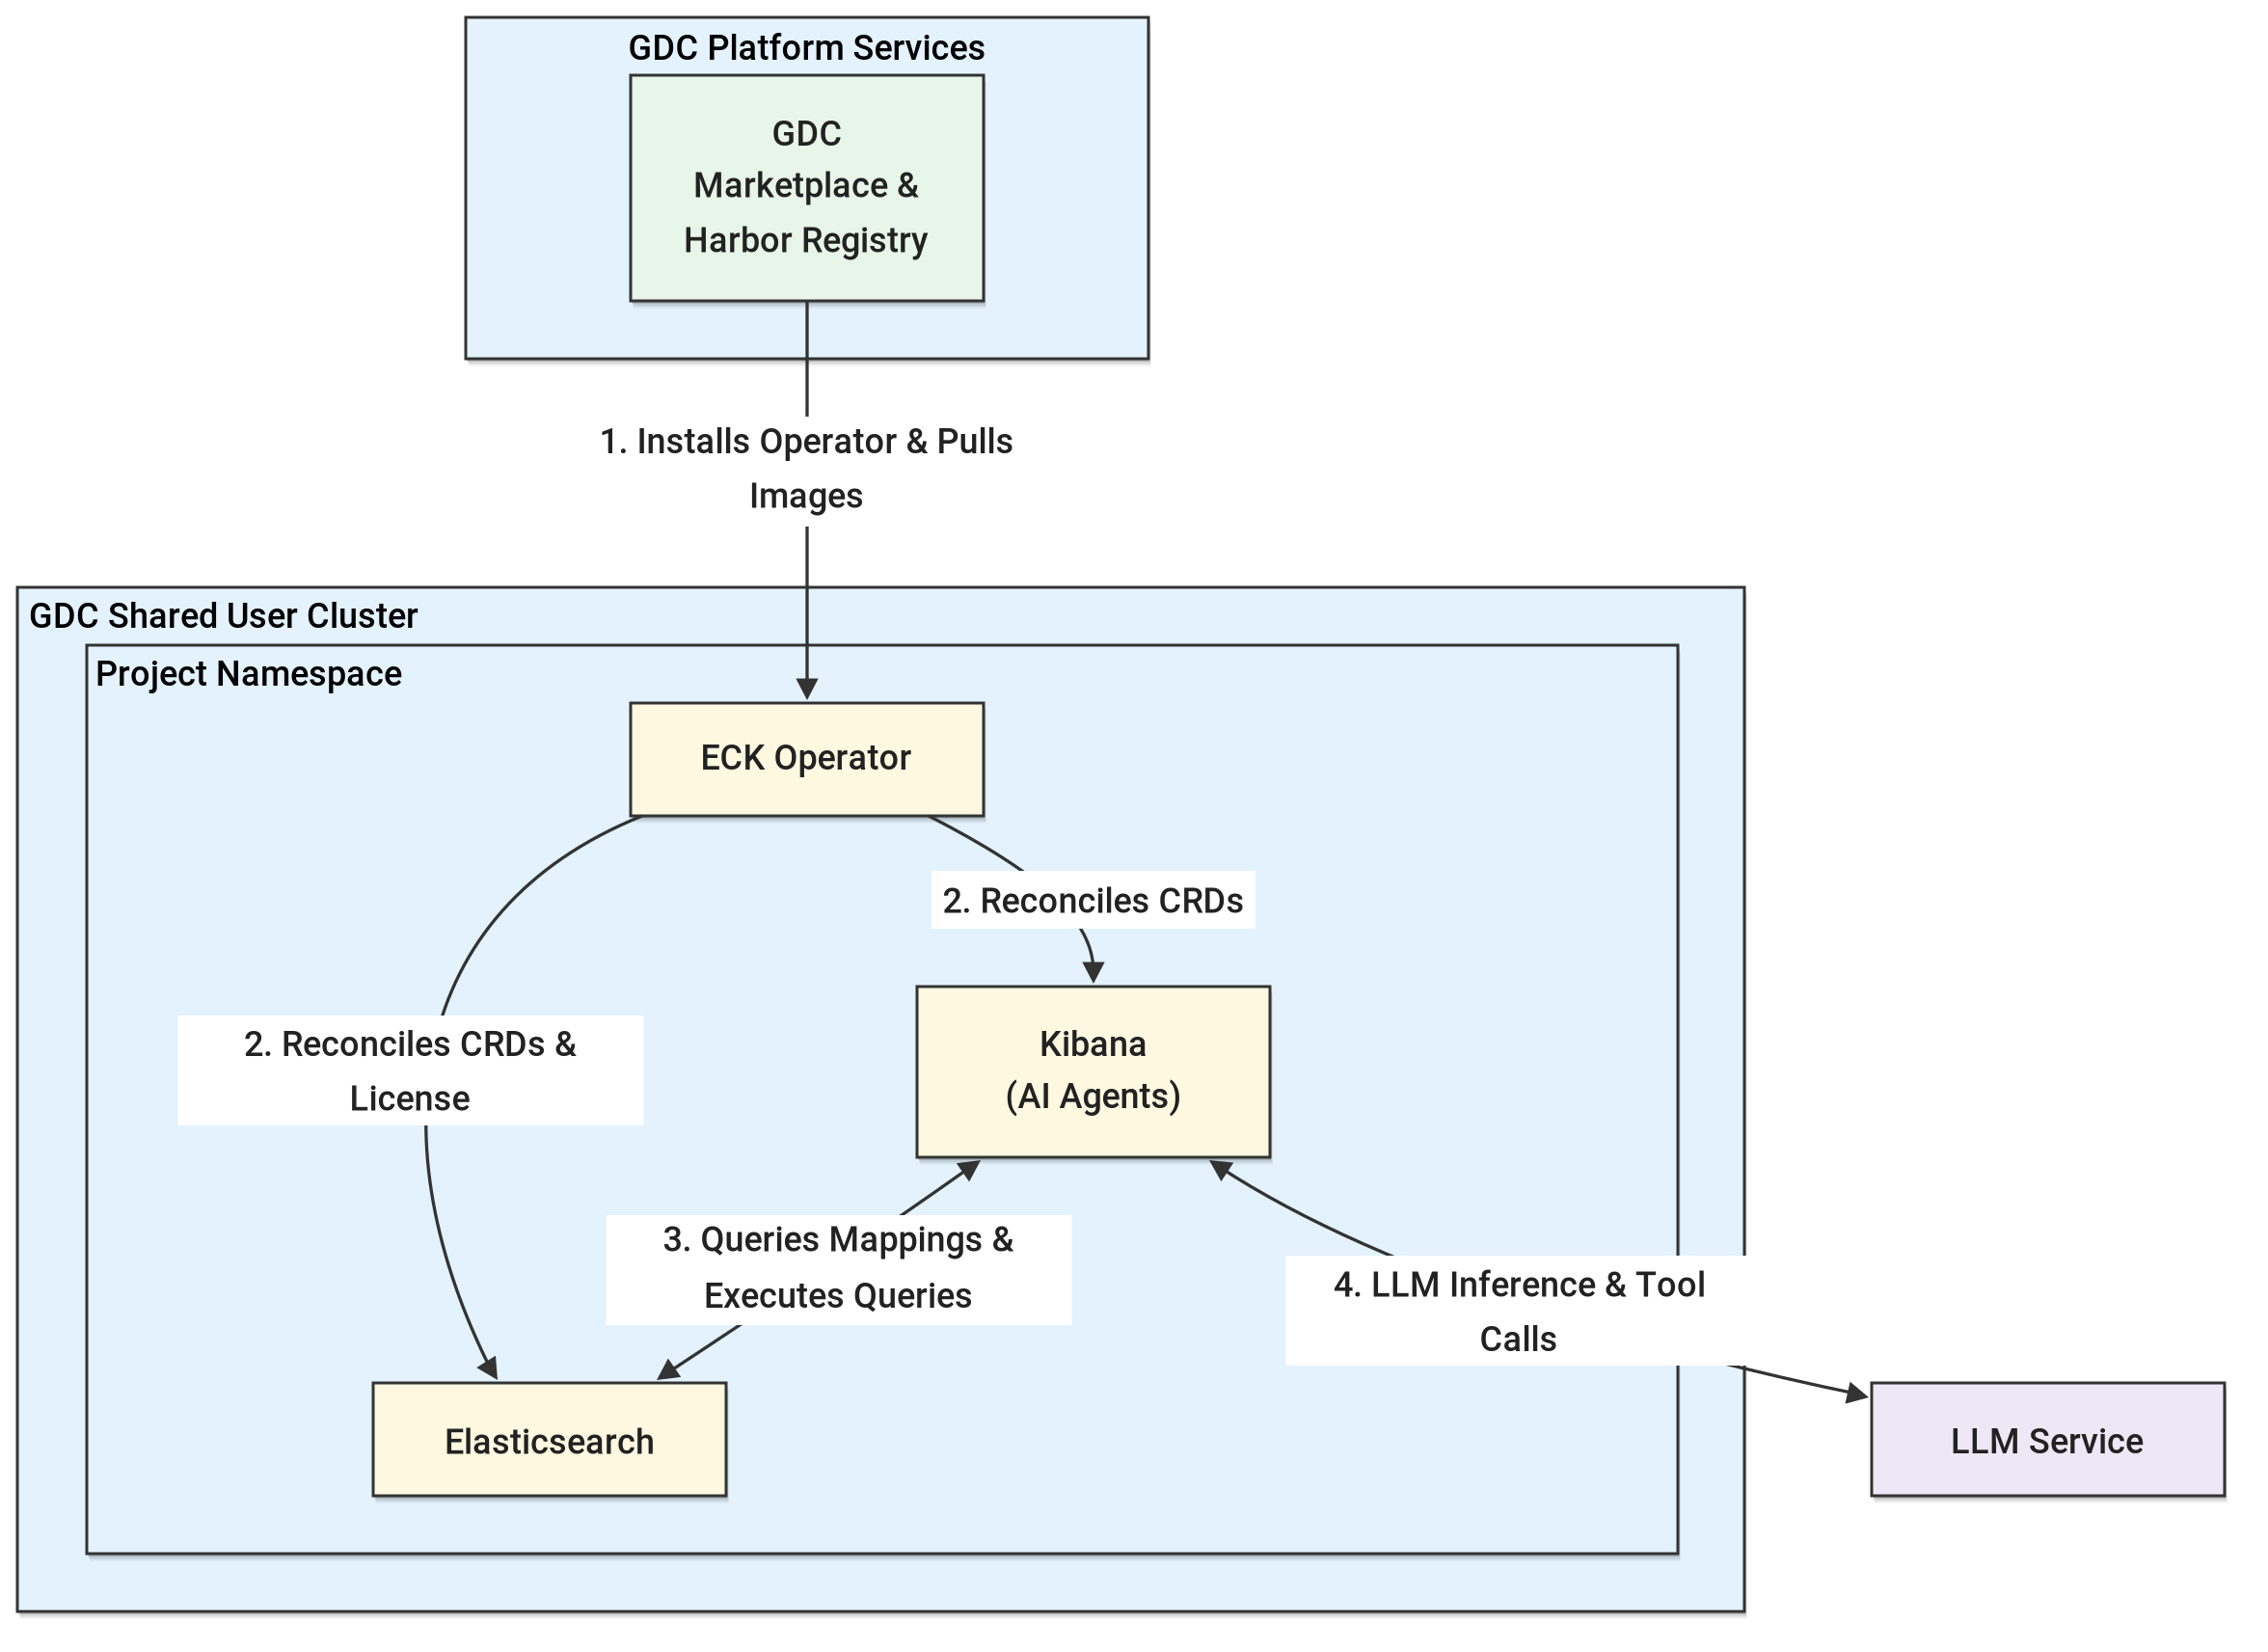
Entre los componentes clave de esta arquitectura, se incluyen los siguientes:
- Clúster compartido de GDC: Un clúster de Kubernetes compartido con alcance de la organización adjunto a varios proyectos, que aloja paquetes de software de GDC Marketplace y cargas de trabajo de aplicaciones.
- Proyecto de GDC: El espacio de nombres del proyecto en el clúster compartido que aísla el operador de ECK, el clúster de Elasticsearch, la instancia de Kibana y los objetos Secret y NetworkPolicy de Kubernetes asociados.
- Operador de Elastic Cloud on Kubernetes (ECK): Instalado desde
GDC Marketplace en el espacio de nombres del proyecto, el
operador administra los recursos personalizados de
ElasticsearchyKibana, y concilia la licencia de Elastic requerida para las funciones potenciadas por IA generativa y los conectores de LLM externos. - Elasticsearch: Almacena y, además, indexa datos operativos y de seguridad, y ejecuta búsquedas y consultas de ES|QL generadas por las funciones de IA y los agentes de Kibana.
- Kibana: Aloja las funciones de IA generativa de Elastic (Elastic AI Agent, Agent Builder y Attack Discovery) y administra los conectores de acciones de LLM que organizan la llamada a herramientas de varios pasos entre el usuario, Elasticsearch y el servicio de LLM.
- Servicio de LLM: Un servicio de LLM administrado (como Gemini en GDC) o un servidor de inferencia autoadministrado (como Ollama o vLLM) que proporciona finalización de chat y capacidades de llamada a herramientas a Kibana a través de la red interna de GDC.
Conceptos y tecnologías
En esta sección, se detallan los componentes funcionales, sus responsabilidades y cómo se comunican dentro del sistema.
Infraestructura y plataforma
- Clúster compartido de GDC: El entorno de procesamiento principal en el que residen el operador de ECK, Elasticsearch y los pods de Kibana dentro de un espacio de nombres del proyecto.
- GDC Marketplace: El catálogo que se usa para instalar y
actualizar el paquete de Elastic Marketplace, que registra las CustomResourceDefinitions
de Elastic y, además, implementa el
elastic-operatorStatefulSet. - Registro de Harbor: La fuente de información segura y local para el operador de ECK, Elasticsearch y las imágenes de contenedor de Kibana en el entorno aislado.
- Almacenamiento persistente: Las PersistentVolumeClaims aprovisionadas a través de
Elasticsearch
volumeClaimTemplatesproporcionan almacenamiento en bloque duradero para los datos de Elasticsearch. - Redes de GDC: Los servicios LoadBalancer exponen
Elasticsearch (puerto
9200) y Kibana (puerto5601), mientras que los recursosNetworkPolicyde Kubernetes yProjectNetworkPolicyglobales rigen el tráfico entrante y entre proyectos, incluida la conectividad al servicio de LLM.
Servicios y lógica
- Operador de ECK: El controlador que observa los recursos personalizados de
ElasticsearchyKibanay los concilia en StatefulSets, implementaciones, servicios y objetos Secret. Sulicense-controllerconcilia continuamente la licencia del clúster con los objetos Secret de licencia en el espacio de nombres del operador. - Elastic AI Agent: El agente conversacional predeterminado en Kibana. Usa herramientas integradas de Agent Builder (
platform.core.list_indices,platform.core.get_index_mapping,platform.core.searchyplatform.core.execute_esql) para descubrir datos, generar ES|QL y resumir resultados. - Agent Builder: El framework para crear agentes personalizados que combinan
instrucciones personalizadas del sistema con herramientas integradas y definidas por el usuario
(
esql,index_search,workflow, ymcp). - Flujos de trabajo de Kibana: Automatizaciones declarativas definidas en YAML (por ejemplo,
cases.createCase) que se pueden registrar como herramientas de Agent Builder para permitir que los101agentes realicen acciones como abrir casos de seguridad de Kibana. - Attack Discovery: Una función de Elastic Security que envía contexto de alerta anonimizado
al LLM para correlacionar alertas del índice
.alerts-security.alerts-defaulten cadenas de ataque asignadas a tácticas de MITRE ATT&CK. - Servicio de LLM: Proporciona finalizaciones de chat ajustadas por instrucciones con compatibilidad nativa para llamadas a herramientas. El modelo debe generar de forma confiable invocaciones de herramientas válidas, JSON estructurado y consultas de ES|QL.
Flujo de datos e interfaces
- API de finalización de chat compatible con OpenAI (
/v1/chat/completions): La interfaz entre el conector de OpenAI (.gen-ai) de Kibana y el servicio de LLM, configurada con el proveedor Other (OpenAI Compatible Service), la llamada a funciones nativas habilitada y la transmisión de eventos enviados por el servidor. - APIs de REST y ES|QL de Elasticsearch: Kibana y sus agentes las usan para inspeccionar asignaciones, ejecutar búsquedas y ejecutar agregaciones de ES|QL.
- APIs de REST de Kibana: Se usan para la administración programática de conectores
(
/api/actions), agentes y herramientas (/api/agent_builder), flujos de trabajo (/api/workflows), reglas de detección (/api/detection_engine) y Attack Discovery (/api/attack_discovery). - HTTPS con autenticación integrada: Los extremos de Elasticsearch y Kibana se entregan a través de TLS con certificados generados por ECK, con credenciales almacenadas en objetos Secret de Kubernetes administrados por ECK.
Consideraciones
- Escalabilidad y rendimiento:
- Las solicitudes de recursos, los límites, los recuentos de nodos y los tamaños de almacenamiento de Elasticsearch y Kibana se deben ajustar de los valores predeterminados de evaluación para que coincidan con los volúmenes de datos de producción y la simultaneidad de consultas.
- El conector de OpenAI de Kibana aplica un tiempo de espera predeterminado de 60 segundos por turno de transmisión. El servicio de LLM debe ejecutarse en la aceleración de GPU con optimizaciones como Flash Attention para mantener cada turno dentro de este límite.
- Un solo turno de agente puede activar subllamadas anidadas de LLM. El servidor de inferencia debe mantener varias ranuras de caché KV paralelas (por ejemplo,
OLLAMA_NUM_PARALLEL=2) para evitar que las subllamadas desalojen el contexto almacenado en caché de la conversación principal.
- Requisitos del modelo de LLM:
- El modelo debe estar ajustado por instrucciones con compatibilidad nativa para llamadas a funciones. La llamada a funciones nativas debe estar habilitada en el conector de Kibana, ya que la llamada a funciones simuladas basada en instrucciones es menos confiable para las llamadas a herramientas anidadas.
- Se recomienda un contexto de al menos 128,000 tokens, ya que las investigaciones de varios pasos que combinan definiciones de herramientas, esquemas de índice, documentación de ES|QL y resultados de la búsqueda pueden superar los 70,000 tokens.
- Se recomienda un límite de tokens de salida de al menos 8,192 tokens y una penalización de repetición suave para los modelos con capacidad de razonamiento, ya que Kibana trata un motivo de finalización
lengthcomo un error fatal y usa la decodificación greedy. - Attack Discovery requiere un modelo de clase 30B o superior (como
gemma4:31b) para sintetizar de forma confiable resultados estructurados de varias alertas.
- Seguridad y cumplimiento:
- Todas las instrucciones, los datos recuperados y las respuestas del modelo permanecen en la red interna de GDC.
- Las políticas de red deben reforzarse desde la configuración de evaluación permisiva para restringir el acceso entrante a Elasticsearch y Kibana a clientes autorizados y limitar la salida al extremo del servicio de LLM.
- El acceso a Kibana y Elasticsearch debe regirse a través de los controles de acceso basados en roles de Elastic en lugar del superusuario
elastic.
- Administración de recursos y licencias:
- Las funciones de IA generativa de Elastic y los conectores de LLM externos requieren una licencia Enterprise (o una prueba Enterprise activa de 30 días), que se debe aprovisionar a través de un objeto Secret de licencia de ECK para que persista en los ciclos de conciliación del operador.
- Disponibilidad y confiabilidad:
- Las implementaciones de producción deben usar varios nodos de Elasticsearch con fragmentos de réplica y varias instancias de Kibana para evitar puntos únicos de falla.
- La disponibilidad de las funciones de IA depende de la disponibilidad y la latencia del servicio de LLM.
- Administración operativa:
- El cliente es responsable de actualizar el paquete de Elastic Marketplace y las versiones de Elastic Stack, administrar licencias y hacer copias de seguridad de los datos de Elasticsearch.
- Cuando se usa un servicio de LLM autoadministrado, el cliente es propietario de su implementación, la planificación de la capacidad de GPU, las actualizaciones del modelo y el ajuste.
Decisión de diseño
Las principales opciones de arquitectura para esta solución se centran en habilitar las funciones potenciadas por IA generativa de Elastic dentro de las restricciones del entorno aislado.
Operador de ECK de GDC Marketplace
El operador de ECK se instala desde GDC Marketplace aislado en lugar de implementarse de forma manual. El paquete de Marketplace viene preconfigurado para extraer imágenes de contenedor del registro local de Harbor, registra las CustomResourceDefinitions requeridas y se integra con los roles de IAM a nivel del proyecto de GDC. Esto reduce el esfuerzo de duplicación de imágenes y mantiene la implementación alineada con el ciclo de vida del software de GDC.
Implementación de clúster compartido
La solución implementa Elastic Stack en un espacio de nombres del proyecto en un clúster compartido de GDC. Esto permite a los clientes consumir software de Marketplace junto con otras cargas de trabajo del proyecto sin aprovisionar ni operar un clúster dedicado, mientras que el espacio de nombres del proyecto proporciona aislamiento de recursos, objetos Secret y políticas de red.
Opciones de servicio de LLM
Gemini administrado en GDC es la opción preferida cuando está disponible, ya que quita la carga operativa de alojar la infraestructura de inferencia. Cuando no está disponible o cuando los clientes requieren un modelo abierto específico, Kibana puede conectarse a cualquier servidor de inferencia autoadministrado que exponga un extremo /v1/chat/completions compatible con OpenAI. La estandarización en esta API mantiene la configuración de Elastic independiente del motor de inferencia (como Ollama o vLLM).
Llamada a funciones nativas
La llamada a funciones nativas está habilitada en el conector de Kibana para que el formato de llamada a herramientas se delegue en el protocolo tools de OpenAI del servidor de inferencia.
La llamada a funciones simuladas basada en instrucciones predeterminada de Kibana es menos confiable durante las llamadas a herramientas anidadas y puede fallar con errores de análisis.
Conciliación de licencias administradas por ECK
La licencia Enterprise (o de prueba) se declara como un objeto Secret de licencia de ECK en lugar de activarse directamente a través de la API de licencia de Elasticsearch. Debido a que ECK concilia continuamente la licencia del clúster, las licencias aplicadas fuera de ECK se revierten a basic en el próximo ciclo de conciliación.
Suposiciones y limitaciones
Suposiciones
- Un clúster compartido de GDC y un proyecto adjunto están disponibles, con suficiente capacidad de procesamiento y almacenamiento persistente para el operador de ECK, Elasticsearch y Kibana.
- El paquete de Elastic Marketplace y las imágenes de contenedor de Elasticsearch y Kibana correspondientes están disponibles en GDC Marketplace aislado y en el registro local de Harbor.
- Los usuarios tienen los roles de proyecto requeridos (
namespace-admin,project-viewer,marketplace-editoryproject-networkpolicy-admin). - Se implementa un servicio de LLM (Gemini administrado en GDC o un servidor de inferencia autoadministrado compatible con OpenAI) y se puede acceder a él desde el pod de Kibana a través de la red interna de GDC.
- Está disponible una licencia de Elastic Enterprise, o bien se usa la prueba Enterprise de 30 días para la evaluación.
Limitaciones
- Servicio de LLM fuera del alcance: Esta arquitectura no cubre la implementación ni la operación de un servicio de LLM autoadministrado, incluida la infraestructura de GPU.
- No hay servicios de IA alojados en Elastic: Los LLM administrados de Elastic y otros servicios de IA de Elastic alojados en la nube no están disponibles en el entorno aislado.
- Calidad dependiente del modelo: La precisión y la confiabilidad de los resultados del agente de IA, Agent Builder y Attack Discovery dependen de las capacidades del modelo seleccionado y su configuración de tiempo de ejecución.
- Valores predeterminados de nivel de evaluación: La implementación de referencia usa un clúster de Elasticsearch de un solo nodo, certificados autofirmados y políticas de red permisivas, que se deben reforzar para el uso en producción.
- Especificidad de la versión: La solución se validó con Elastic v9.4.0, el Elastic Kubernetes Operator v3.4.0 y GDC v1.16.2. Es posible que otras versiones requieran ajustes.
Materiales adicionales
Implementación de referencia de la solución (SRI): Implementación de las funciones potenciadas por IA generativa de Elastic Stack en GDC aislado