


Die optische Zeichenerkennung (Optical Character Recognition, OCR) ist eine vortrainierte Vertex AI API in Google Distributed Cloud (GDC) mit Air Gap, mit der Sie Text aus unterstützten Dateitypen wie Bildern, Dokumenten und handschriftlichen Notizen erkennen und extrahieren können. Sie können Inline-Anfragen für die Textextraktion verarbeiten oder asynchrone Batchjobs für Dateien ausführen, die in Buckets in unterstützten Sprachen gespeichert sind.
Methoden zur optischen Zeichenerkennung
OCR bietet die folgenden Methoden in Distributed Cloud zum Erkennen von Text:
| Methode | Beschreibung |
|---|---|
BatchAnnotateImages |
Text aus einem Batch von JPEG- oder PNG-Bildern erkennen, die in einer Inline-Anfrage bereitgestellt werden. |
BatchAnnotateFiles |
Text aus einem Batch von PDF- oder TIFF-Dateien erkennen, die in einer Inline-Anfrage bereitgestellt werden. |
AsyncBatchAnnotateFiles |
Text aus einem Batch von PDF- oder TIFF-Dateien in einem Storage-Bucket für Offlineanfragen erkennen. |
Funktionen zur optischen Zeichenerkennung
Mithilfe der OCR API können Sie Text in Bildern erkennen und extrahieren. Die folgenden beiden Annotationsfeatures unterstützen die optische Zeichenerkennung:
TEXT_DETECTIONerkennt und extrahiert Text aus beliebigen Bildern. Ein Foto kann beispielsweise ein Straßen- oder Verkehrsschild enthalten. Der OCR-Dienst gibt eine JSON-Datei mit dem extrahierten String, einzelnen Wörtern und ihren Begrenzungsrahmen zurück.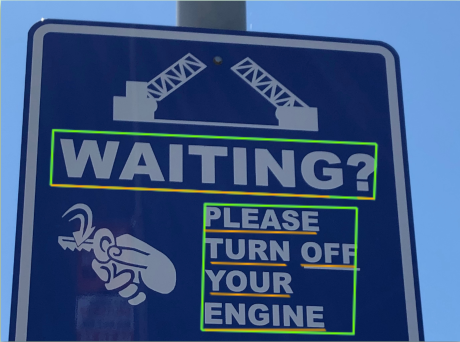
Abbildung 1. Foto eines Straßenschilds, auf dem die OCR API Wörter und ihre Begrenzungsrahmen erkennt.
DOCUMENT_TEXT_DETECTIONextrahiert ebenfalls Text aus einem Bild, optimiert die Antwort jedoch für Fließtext und Dokumente. Ein gescanntes Bild mit getipptem Text kann beispielsweise mehrere Absätze und Überschriften enthalten. Der OCR-Dienst gibt eine JSON-Datei mit Informationen zu Seite, Block, Absatz, Wort und Worttrennung zurück.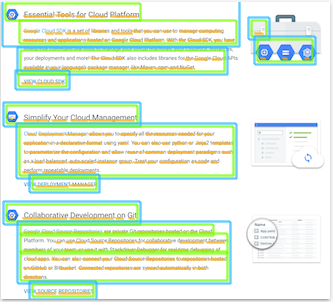
Abbildung 2. Gescannter Text, in dem die OCR API Informationen wie Wörter, Seiten und Absätze erkennt.
Handschriftlicher Text
Abbildung 3 ist ein Bild mit handschriftlichem Text. Die OCR API erkennt und extrahiert Text aus diesen Bildern. Eine Liste der Handschriftsysteme, die die Handschrifterkennung unterstützen, finden Sie unter Handschriftsysteme.
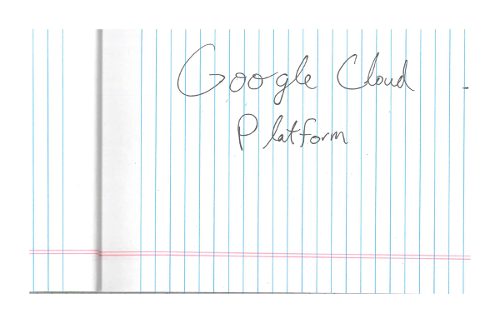
Abbildung 3. Bild mit Handschrift, in dem die OCR API Text erkennt.
Limits für die optische Zeichenerkennung (OCR)
Die API-Methoden BatchAnnotateImages und BatchAnnotateFiles unterstützen nur eine einzelne Anfrage pro Batchaufruf.
In der folgenden Tabelle sind die aktuellen Limits des OCR-Dienstes in Distributed Cloud aufgeführt.
| Dateilimit für OCR | Wert |
|---|---|
| Maximale Anzahl von Seiten | Fünf |
| Maximale Dateigröße | 20 MB |
| Maximale Bildgröße | 20 Millionen Pixel (Länge × Breite) |
Für die OCR API eingereichte Dateien, die die maximale Anzahl von Seiten oder die maximale Dateigröße überschreiten, geben einen Fehler zurück. Eingereichte Dateien, die die maximale Bildgröße überschreiten, werden auf 20 Millionen Pixel verkleinert.
Unterstützte Dateitypen für OCR
Die vortrainierte OCR API erkennt und transkribiert Text aus den folgenden Dateitypen:
- TIFF
- JPG
- PNG
Sie müssen die Dateien lokal in Ihrer Distributed Cloud-Umgebung speichern. Sie können nicht auf Dateien zugreifen, die in Cloud Storage gehostet werden, oder auf öffentlich verfügbare Dateien für die Texterkennung.