


El propósito de una configuración de alta disponibilidad es reducir el tiempo de inactividad cuando una instancia de clúster de base de datos deja de estar disponible. Esto puede suceder cuando una instancia se queda sin memoria. Con la alta disponibilidad, tus datos siguen estando disponibles para las aplicaciones cliente.
Dentro de un sitio, la configuración se compone de una instancia principal y una réplica en espera. Todas las operaciones de escritura realizadas en la instancia principal se replican en la réplica en espera antes de que una transacción se informe como confirmada. Si la instancia principal deja de estar disponible, GDC asciende automáticamente la réplica en espera para que actúe como la nueva instancia principal. Luego, el tráfico de la aplicación se redirige a la nueva instancia principal. Este proceso se denomina conmutación por error.
La conmutación por error automática se inicia después de 3 fallas consecutivas de la verificación de estado en la instancia principal, con un intervalo de 30 segundos entre cada una.
GDC admite la conmutación por error automática y manual. La conmutación por error automática está habilitada de forma predeterminada, y puedes inhabilitarla si es necesario. También puedes activar una conmutación por error de forma manual en cualquier momento para recuperarte de una falla inesperada y minimizar el tiempo de inactividad.
La conmutación por error implica el siguiente proceso, en orden:
GDC desconecta la instancia principal.
GDC convierte la réplica en espera en el nuevo clúster de base de datos activo.
GDC borra el clúster de base de datos activo anterior.
GDC crea una nueva réplica en espera.
Actualiza un clúster existente
Puedes actualizar la configuración de alta disponibilidad de un clúster de base de datos existente:
Console
En el menú de navegación, selecciona Database Service.
En la lista de clústeres de bases de datos, haz clic en el clúster de bases de datos que deseas actualizar.
Selecciona Editar Editar en la sección Alta disponibilidad.
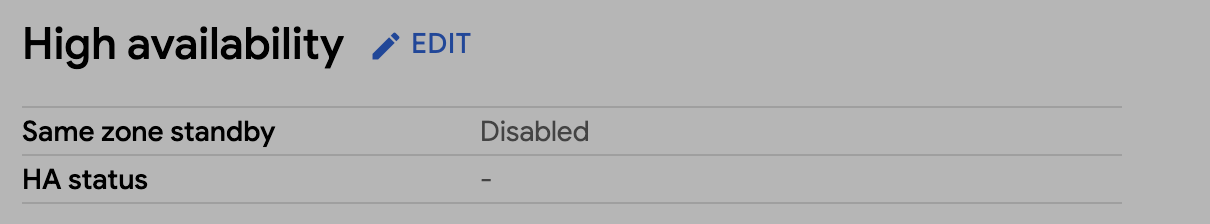
Selecciona Habilitar la instancia en espera en la misma zona para activar o desactivar la disponibilidad de una instancia en espera en la misma zona que tu clúster de base de datos principal.
Haz clic en Guardar.
Para verificar que el clúster de base de datos refleje la actualización de alta disponibilidad, consulta su estado en la columna Alta disponibilidad de la lista de clústeres de base de datos.
gdcloud
Actualiza la configuración de alta disponibilidad de tu clúster de base de datos:
gdcloud database clusters update CLUSTER_NAME \
    --availability-type HA_TYPE
Reemplaza lo siguiente:
CLUSTER_NAME: Es el nombre del clúster de la base de datos.HA_TYPE: Es el nivel de alta disponibilidad para el clúster de la base de datos. Puedes establecerzonalozonal_ha. El valorzonalse establece de forma predeterminada.
Verifica que tu clúster de base de datos refleje la actualización de alta disponibilidad:
gdcloud database clusters list
API
Actualiza la configuración de alta disponibilidad de tu clúster de base de datos:
  kubectl patch dbcluster.postgresql.dbadmin.gdc.goog DBCLUSTER_NAME \
    -n USER_PROJECT \
    -p '{"spec": {"availability": {"enableHighAvailability": HA_ENABLED}}}' \
    --type=merge
Reemplaza las siguientes variables:
DBCLUSTER_NAME: Es el nombre del clúster de la base de datos.USER_PROJECT: Es el nombre del proyecto de usuario en el que se creó el clúster de la base de datos.HA_ENABLED: Es el nivel de alta disponibilidad del clúster de base de datos. Puedes establecertrueofalse. El valorfalsese establece de forma predeterminada.
Verifica que tu clúster de base de datos refleje la actualización de alta disponibilidad:
kubectl get dbcluster.DBENGINE_NAME.dbadmin.gdc.goog DBCLUSTER_NAME \
  -n USER_PROJECT \
  -o yaml
Migra a la implementación de alta disponibilidad más reciente
Para verificar que tu clúster de base de datos de alta disponibilidad use la implementación más reciente, comprueba si la anotación dbcluster.dbadmin.goog/raasEnabled existe en el CR del clúster de base de datos de alta disponibilidad. Esta anotación solo aparecerá en los clústeres que usen la implementación nueva. Si no tienes esta anotación, puedes habilitarla y migrar tu clúster con los siguientes pasos:
- Consulta con tu operador de infraestructura si tu entorno de GDC se actualizó a la versión 1.15.1 o una posterior.
- Inhabilitar la alta disponibilidad en tu clúster de base de datos Espera a que desaparezca la condición
HAReadyy, luego, vuelve a habilitar la alta disponibilidad. - Después de ver
HAReady in progressoHAReady setup complete, verifica la CR del clúster de base de datos para ver la anotacióndbcluster.dbadmin.goog/raasEnabled. Si aparece, significa que el clúster de la base de datos se migró correctamente.
Activa una conmutación por error
Si configuraste la alta disponibilidad para tu clúster de base de datos, puedes activar una conmutación por error. Para activar una conmutación por error, completa los siguientes pasos:
Console
En el menú de navegación, selecciona Database Service.
En la lista de clústeres de bases de datos, haz clic en el clúster de bases de datos para el que deseas activar una conmutación por error. El clúster de base de datos debe tener habilitada la alta disponibilidad para poder realizar una conmutación por error.
Haz clic en Conmutación por error.
Escribe el ID del clúster para la frase de confirmación y haz clic en Conmutación por error para activar el proceso de conmutación por error.
gdcloud
Activa la conmutación por error para el clúster de base de datos:
gdcloud database clusters failover CLUSTER_NAME
Reemplaza CLUSTER_NAME por el nombre del clúster de la base de datos.
API
  apiVersion: fleet.dbadmin.gdc.goog/v1
  kind: Failover
  metadata:
    name: FAILOVER_NAME
    namespace: USER_PROJECT
  spec:
    dbclusterRef: DBCLUSTER_NAME
Reemplaza las siguientes variables:
DBCLUSTER_NAME, el nombre del clúster de la base de datos.USER_PROJECT: Es el nombre del proyecto de usuario en el que se creó el clúster de la base de datos.FAILOVER_NAME, el nombre único de la conmutación por error, por ejemplo,failover-sample.
Inhabilitar la conmutación por error automática
La conmutación por error automática está habilitada de forma predeterminada en los clústeres de bases de datos de alta disponibilidad.
Para inhabilitar la conmutación por error automática, configura enableAutoFailover como false en el
manifiesto del clúster de la base de datos:
spec:
  availability:
    enableAutoFailover: false
Para actualizar la configuración de conmutación por error automática de un clúster de base de datos existente con la API, ejecuta el siguiente comando:
kubectl patch dbcluster.postgresql.dbadmin.gdc.goog DBCLUSTER_NAME \
  -n USER_PROJECT \
  -p '{"spec": {"availability": {"enableAutoFailover": AUTO_FAILOVER_ENABLED}}}' \
  --type=merge
Reemplaza las siguientes variables:
DBCLUSTER_NAME: Es el nombre del clúster de la base de datos.USER_PROJECT: Es el nombre del proyecto de usuario en el que se creó el clúster de la base de datos.AUTO_FAILOVER_ENABLED: Es el parámetro de configuración de conmutación por error automática para el clúster de base de datos. Puedes establecertrueofalse. El valortruese establece de forma predeterminada.