


使用時間序列資料
在 BigQuery 分析時間序列資料,可從一段時間內的資料點序列中,擷取有意義的趨勢。您可以使用專門的 SQL 函式匯總時間 bucket、填補缺少的資料,以及對齊未對齊的指標,為複雜的彙整和分析作業做好準備。
時間序列資料表
時間序列是一連串資料點,每個資料點都包含時間和與該時間相關聯的值。時間序列通常也有專屬 ID。
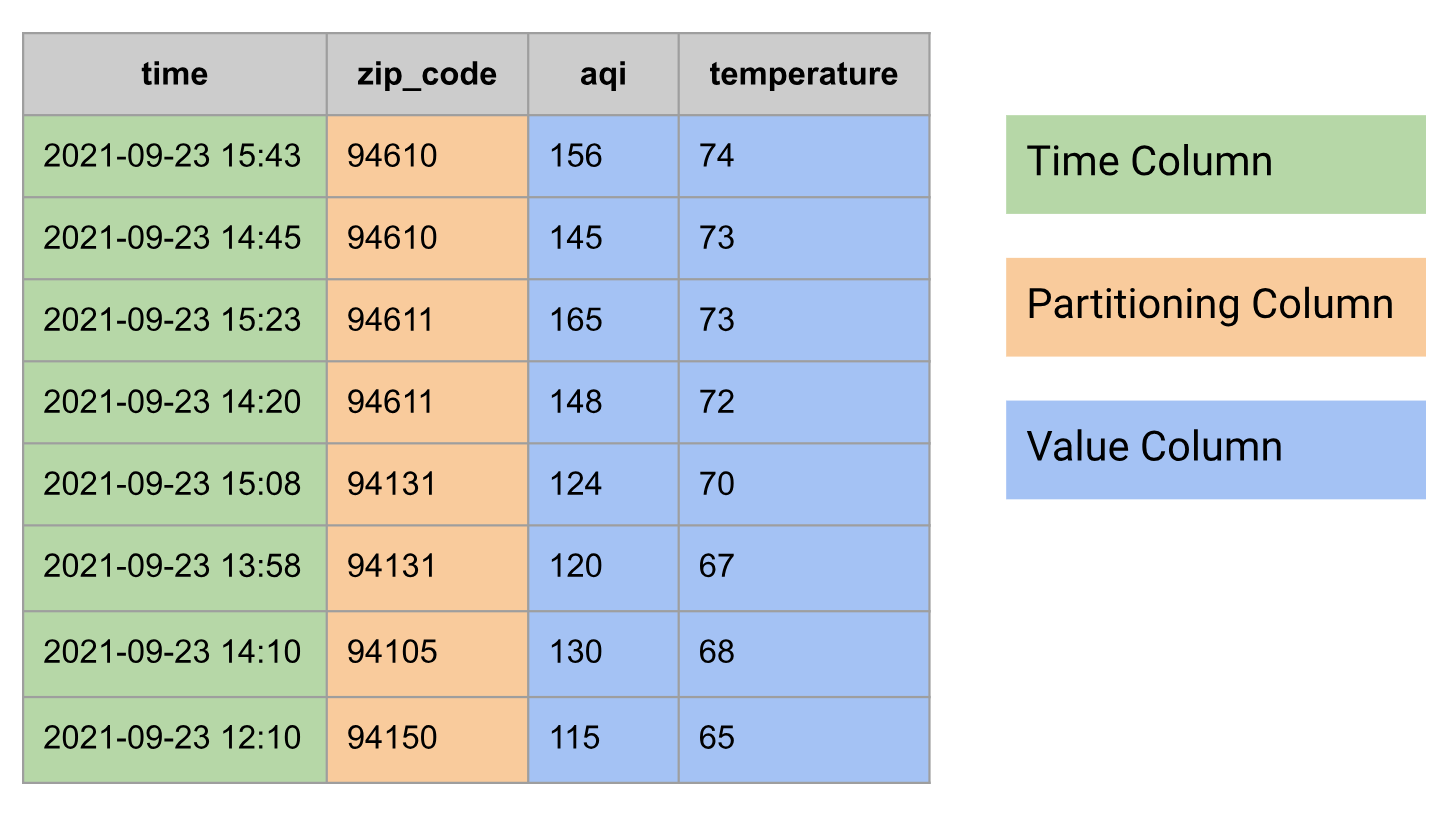
在關聯式資料庫中,時間序列會模擬為具有下列資料欄群組的資料表:
- 時間欄
- 可能含有分區資料欄,例如郵遞區號
- 一或多個值欄,或結合多個值的
STRUCT類型,例如溫度和 AQI
以下範例是以資料表形式建立的時間序列資料模型:
匯總時間序列
在時間序列分析中,時間匯總是沿著時間軸執行的匯總。
您可以使用時間分桶函式 (TIMESTAMP_BUCKET、DATE_BUCKET 和 DATETIME_BUCKET),在 BigQuery 中執行時間匯總。時間分桶函式會將輸入時間值對應至所屬的分桶。
一般來說,時間匯總會使用匯總函式 (例如 AVG、MIN、MAX、COUNT 或 SUM),將時間範圍內的多個資料點合併為單一資料點。例如 15 分鐘平均要求延遲時間、每日最低和最高溫度,以及每日計程車行程數。
請為本節中的查詢建立名為 mydataset.environmental_data_hourly 的資料表:
CREATE OR REPLACE TABLE mydataset.environmental_data_hourly AS
SELECT * FROM UNNEST(
  ARRAY<STRUCT<zip_code INT64, time TIMESTAMP, aqi INT64, temperature INT64>>[
    STRUCT(60606, TIMESTAMP '2020-09-08 00:30:51', 22, 66),
    STRUCT(60606, TIMESTAMP '2020-09-08 01:32:10', 23, 63),
    STRUCT(60606, TIMESTAMP '2020-09-08 02:30:35', 22, 60),
    STRUCT(60606, TIMESTAMP '2020-09-08 03:29:39', 21, 58),
    STRUCT(60606, TIMESTAMP '2020-09-08 04:33:05', 21, 59),
    STRUCT(60606, TIMESTAMP '2020-09-08 05:32:01', 21, 57),
    STRUCT(60606, TIMESTAMP '2020-09-08 06:31:14', 22, 56),
    STRUCT(60606, TIMESTAMP '2020-09-08 07:31:06', 28, 55),
    STRUCT(60606, TIMESTAMP '2020-09-08 08:29:59', 30, 55),
    STRUCT(60606, TIMESTAMP '2020-09-08 09:29:34', 31, 55),
    STRUCT(60606, TIMESTAMP '2020-09-08 10:31:24', 38, 56),
    STRUCT(60606, TIMESTAMP '2020-09-08 11:31:24', 38, 56),
    STRUCT(60606, TIMESTAMP '2020-09-08 12:32:38', 38, 57),
    STRUCT(60606, TIMESTAMP '2020-09-08 13:29:59', 38, 56),
    STRUCT(60606, TIMESTAMP '2020-09-08 14:31:22', 43, 59),
    STRUCT(60606, TIMESTAMP '2020-09-08 15:31:38', 42, 63),
    STRUCT(60606, TIMESTAMP '2020-09-08 16:34:22', 43, 65),
    STRUCT(60606, TIMESTAMP '2020-09-08 17:33:23', 42, 68),
    STRUCT(60606, TIMESTAMP '2020-09-08 18:28:47', 36, 69),
    STRUCT(60606, TIMESTAMP '2020-09-08 19:30:28', 34, 67),
    STRUCT(60606, TIMESTAMP '2020-09-08 20:30:53', 29, 67),
    STRUCT(60606, TIMESTAMP '2020-09-08 21:32:28', 27, 67),
    STRUCT(60606, TIMESTAMP '2020-09-08 22:31:45', 25, 65),
    STRUCT(60606, TIMESTAMP '2020-09-08 23:31:02', 22, 63),
    STRUCT(94105, TIMESTAMP '2020-09-08 00:07:11', 60, 74),
    STRUCT(94105, TIMESTAMP '2020-09-08 01:07:24', 61, 73),
    STRUCT(94105, TIMESTAMP '2020-09-08 02:08:07', 60, 71),
    STRUCT(94105, TIMESTAMP '2020-09-08 03:11:05', 69, 69),
    STRUCT(94105, TIMESTAMP '2020-09-08 04:07:26', 72, 67),
    STRUCT(94105, TIMESTAMP '2020-09-08 05:08:11', 70, 66),
    STRUCT(94105, TIMESTAMP '2020-09-08 06:07:30', 68, 65),
    STRUCT(94105, TIMESTAMP '2020-09-08 07:07:10', 77, 64),
    STRUCT(94105, TIMESTAMP '2020-09-08 08:06:35', 81, 64),
    STRUCT(94105, TIMESTAMP '2020-09-08 09:10:18', 82, 63),
    STRUCT(94105, TIMESTAMP '2020-09-08 10:08:10', 107, 62),
    STRUCT(94105, TIMESTAMP '2020-09-08 11:08:01', 115, 62),
    STRUCT(94105, TIMESTAMP '2020-09-08 12:07:39', 120, 62),
    STRUCT(94105, TIMESTAMP '2020-09-08 13:06:03', 125, 61),
    STRUCT(94105, TIMESTAMP '2020-09-08 14:08:37', 129, 62),
    STRUCT(94105, TIMESTAMP '2020-09-08 15:09:19', 150, 62),
    STRUCT(94105, TIMESTAMP '2020-09-08 16:06:39', 151, 62),
    STRUCT(94105, TIMESTAMP '2020-09-08 17:08:01', 155, 63),
    STRUCT(94105, TIMESTAMP '2020-09-08 18:09:23', 154, 64),
    STRUCT(94105, TIMESTAMP '2020-09-08 19:08:43', 151, 67),
    STRUCT(94105, TIMESTAMP '2020-09-08 20:07:19', 150, 69),
    STRUCT(94105, TIMESTAMP '2020-09-08 21:07:37', 148, 72),
    STRUCT(94105, TIMESTAMP '2020-09-08 22:08:01', 143, 76),
    STRUCT(94105, TIMESTAMP '2020-09-08 23:08:41', 137, 75)
]);
上述資料有一個有趣的觀察結果,那就是測量是在任意時間範圍內進行,稱為「未對齊的時間序列」。匯總是校正時間序列的方法之一。
取得 3 小時平均值
下列查詢會計算每個郵遞區號的 3 小時平均空氣品質指數 (AQI) 和溫度。TIMESTAMP_BUCKET 函式會將每個時間值指派給特定日期,藉此執行時間匯總。
SELECT
  TIMESTAMP_BUCKET(time, INTERVAL 3 HOUR) AS time,
  zip_code,
  CAST(AVG(aqi) AS INT64) AS aqi,
  CAST(AVG(temperature) AS INT64) AS temperature
FROM mydataset.environmental_data_hourly
GROUP BY zip_code, time
ORDER BY zip_code, time;

/*---------------------+----------+-----+-------------+
 |        time         | zip_code | aqi | temperature |
 +---------------------+----------+-----+-------------+
 | 2020-09-08 00:00:00 |    60606 |  22 |          63 |
 | 2020-09-08 03:00:00 |    60606 |  21 |          58 |
 | 2020-09-08 06:00:00 |    60606 |  27 |          55 |
 | 2020-09-08 09:00:00 |    60606 |  36 |          56 |
 | 2020-09-08 12:00:00 |    60606 |  40 |          57 |
 | 2020-09-08 15:00:00 |    60606 |  42 |          65 |
 | 2020-09-08 18:00:00 |    60606 |  33 |          68 |
 | 2020-09-08 21:00:00 |    60606 |  25 |          65 |
 | 2020-09-08 00:00:00 |    94105 |  60 |          73 |
 | 2020-09-08 03:00:00 |    94105 |  70 |          67 |
 | 2020-09-08 06:00:00 |    94105 |  75 |          64 |
 | 2020-09-08 09:00:00 |    94105 | 101 |          62 |
 | 2020-09-08 12:00:00 |    94105 | 125 |          62 |
 | 2020-09-08 15:00:00 |    94105 | 152 |          62 |
 | 2020-09-08 18:00:00 |    94105 | 152 |          67 |
 | 2020-09-08 21:00:00 |    94105 | 143 |          74 |
 +---------------------+----------+-----+-------------*/
取得 3 小時內的最低和最高值
在下列查詢中,您會計算每個郵遞區號的 3 小時最低和最高溫度:
SELECT
  TIMESTAMP_BUCKET(time, INTERVAL 3 HOUR) AS time,
  zip_code,
  MIN(temperature) AS temperature_min,
  MAX(temperature) AS temperature_max,
FROM mydataset.environmental_data_hourly
GROUP BY zip_code, time
ORDER BY zip_code, time;

/*---------------------+----------+-----------------+-----------------+
 |        time         | zip_code | temperature_min | temperature_max |
 +---------------------+----------+-----------------+-----------------+
 | 2020-09-08 00:00:00 |    60606 |              60 |              66 |
 | 2020-09-08 03:00:00 |    60606 |              57 |              59 |
 | 2020-09-08 06:00:00 |    60606 |              55 |              56 |
 | 2020-09-08 09:00:00 |    60606 |              55 |              56 |
 | 2020-09-08 12:00:00 |    60606 |              56 |              59 |
 | 2020-09-08 15:00:00 |    60606 |              63 |              68 |
 | 2020-09-08 18:00:00 |    60606 |              67 |              69 |
 | 2020-09-08 21:00:00 |    60606 |              63 |              67 |
 | 2020-09-08 00:00:00 |    94105 |              71 |              74 |
 | 2020-09-08 03:00:00 |    94105 |              66 |              69 |
 | 2020-09-08 06:00:00 |    94105 |              64 |              65 |
 | 2020-09-08 09:00:00 |    94105 |              62 |              63 |
 | 2020-09-08 12:00:00 |    94105 |              61 |              62 |
 | 2020-09-08 15:00:00 |    94105 |              62 |              63 |
 | 2020-09-08 18:00:00 |    94105 |              64 |              69 |
 | 2020-09-08 21:00:00 |    94105 |              72 |              76 |
 +---------------------+----------+-----------------+-----------------*/
自訂對齊方式,平均 3 小時即可完成
執行時間序列匯總時,您會隱含或明確地使用時間序列視窗的特定校正。上述查詢使用隱含對齊,產生的值區起始時間為 00:00:00、03:00:00 和 06:00:00 等。如要在 TIMESTAMP_BUCKET 函式中明確設定這個對齊方式,請傳遞指定原點的選用引數。
在下列查詢中,起點設為 2020-01-01 02:00:00。這會變更對齊方式,並產生從 02:00:00、05:00:00 和 08:00:00 等時間開始的值區:
SELECT
  TIMESTAMP_BUCKET(time, INTERVAL 3 HOUR, TIMESTAMP '2020-01-01 02:00:00') AS time,
  zip_code,
  CAST(AVG(aqi) AS INT64) AS aqi,
  CAST(AVG(temperature) AS INT64) AS temperature
FROM mydataset.environmental_data_hourly
GROUP BY zip_code, time
ORDER BY zip_code, time;

/*---------------------+----------+-----+-------------+
 |        time         | zip_code | aqi | temperature |
 +---------------------+----------+-----+-------------+
 | 2020-09-07 23:00:00 |    60606 |  23 |          65 |
 | 2020-09-08 02:00:00 |    60606 |  21 |          59 |
 | 2020-09-08 05:00:00 |    60606 |  24 |          56 |
 | 2020-09-08 08:00:00 |    60606 |  33 |          55 |
 | 2020-09-08 11:00:00 |    60606 |  38 |          56 |
 | 2020-09-08 14:00:00 |    60606 |  43 |          62 |
 | 2020-09-08 17:00:00 |    60606 |  37 |          68 |
 | 2020-09-08 20:00:00 |    60606 |  27 |          66 |
 | 2020-09-08 23:00:00 |    60606 |  22 |          63 |
 | 2020-09-07 23:00:00 |    94105 |  61 |          74 |
 | 2020-09-08 02:00:00 |    94105 |  67 |          69 |
 | 2020-09-08 05:00:00 |    94105 |  72 |          65 |
 | 2020-09-08 08:00:00 |    94105 |  90 |          63 |
 | 2020-09-08 11:00:00 |    94105 | 120 |          62 |
 | 2020-09-08 14:00:00 |    94105 | 143 |          62 |
 | 2020-09-08 17:00:00 |    94105 | 153 |          65 |
 | 2020-09-08 20:00:00 |    94105 | 147 |          72 |
 | 2020-09-08 23:00:00 |    94105 | 137 |          75 |
 +---------------------+----------+-----+-------------*/
匯總時間序列並填補缺口
有時匯總時間序列後,資料可能會有缺口,需要填入一些值,才能進一步分析或呈現資料。填補這些缺漏的技術稱為「填補缺漏」。在 BigQuery 中,您可以使用 GAP_FILL 資料表函式,填補時間序列資料中的缺口,並使用下列其中一種缺口填補方法:
- NULL,也稱為常數
- LOCF (last observation carried forward)
- 線性,兩個相鄰資料點之間的線性插值
針對本節中的查詢,請根據上一節使用的資料建立名為 mydataset.environmental_data_hourly_with_gaps 的資料表,但其中有缺漏。在實際情境中,資料可能會因為氣象站短暫故障而缺少資料點。
CREATE OR REPLACE TABLE mydataset.environmental_data_hourly_with_gaps AS
SELECT * FROM UNNEST(
  ARRAY<STRUCT<zip_code INT64, time TIMESTAMP, aqi INT64, temperature INT64>>[
    STRUCT(60606, TIMESTAMP '2020-09-08 00:30:51', 22, 66),
    STRUCT(60606, TIMESTAMP '2020-09-08 01:32:10', 23, 63),
    STRUCT(60606, TIMESTAMP '2020-09-08 02:30:35', 22, 60),
    STRUCT(60606, TIMESTAMP '2020-09-08 03:29:39', 21, 58),
    STRUCT(60606, TIMESTAMP '2020-09-08 04:33:05', 21, 59),
    STRUCT(60606, TIMESTAMP '2020-09-08 05:32:01', 21, 57),
    STRUCT(60606, TIMESTAMP '2020-09-08 06:31:14', 22, 56),
    STRUCT(60606, TIMESTAMP '2020-09-08 07:31:06', 28, 55),
    STRUCT(60606, TIMESTAMP '2020-09-08 08:29:59', 30, 55),
    STRUCT(60606, TIMESTAMP '2020-09-08 09:29:34', 31, 55),
    STRUCT(60606, TIMESTAMP '2020-09-08 10:31:24', 38, 56),
    STRUCT(60606, TIMESTAMP '2020-09-08 11:31:24', 38, 56),
    -- No data points between hours 12 and 15.
    STRUCT(60606, TIMESTAMP '2020-09-08 16:34:22', 43, 65),
    STRUCT(60606, TIMESTAMP '2020-09-08 17:33:23', 42, 68),
    STRUCT(60606, TIMESTAMP '2020-09-08 18:28:47', 36, 69),
    STRUCT(60606, TIMESTAMP '2020-09-08 19:30:28', 34, 67),
    STRUCT(60606, TIMESTAMP '2020-09-08 20:30:53', 29, 67),
    STRUCT(60606, TIMESTAMP '2020-09-08 21:32:28', 27, 67),
    STRUCT(60606, TIMESTAMP '2020-09-08 22:31:45', 25, 65),
    STRUCT(60606, TIMESTAMP '2020-09-08 23:31:02', 22, 63),
    STRUCT(94105, TIMESTAMP '2020-09-08 00:07:11', 60, 74),
    STRUCT(94105, TIMESTAMP '2020-09-08 01:07:24', 61, 73),
    STRUCT(94105, TIMESTAMP '2020-09-08 02:08:07', 60, 71),
    STRUCT(94105, TIMESTAMP '2020-09-08 03:11:05', 69, 69),
    STRUCT(94105, TIMESTAMP '2020-09-08 04:07:26', 72, 67),
    STRUCT(94105, TIMESTAMP '2020-09-08 05:08:11', 70, 66),
    STRUCT(94105, TIMESTAMP '2020-09-08 06:07:30', 68, 65),
    STRUCT(94105, TIMESTAMP '2020-09-08 07:07:10', 77, 64),
    STRUCT(94105, TIMESTAMP '2020-09-08 08:06:35', 81, 64),
    STRUCT(94105, TIMESTAMP '2020-09-08 09:10:18', 82, 63),
    STRUCT(94105, TIMESTAMP '2020-09-08 10:08:10', 107, 62),
    STRUCT(94105, TIMESTAMP '2020-09-08 11:08:01', 115, 62),
    STRUCT(94105, TIMESTAMP '2020-09-08 12:07:39', 120, 62),
    STRUCT(94105, TIMESTAMP '2020-09-08 13:06:03', 125, 61),
    STRUCT(94105, TIMESTAMP '2020-09-08 14:08:37', 129, 62),
    -- No data points between hours 15 and 18.
    STRUCT(94105, TIMESTAMP '2020-09-08 19:08:43', 151, 67),
    STRUCT(94105, TIMESTAMP '2020-09-08 20:07:19', 150, 69),
    STRUCT(94105, TIMESTAMP '2020-09-08 21:07:37', 148, 72),
    STRUCT(94105, TIMESTAMP '2020-09-08 22:08:01', 143, 76),
    STRUCT(94105, TIMESTAMP '2020-09-08 23:08:41', 137, 75)
]);
取得 3 小時平均值 (包含間隔)
下列查詢會計算每個郵遞區號的 3 小時平均 AQI 和溫度:
SELECT
  TIMESTAMP_BUCKET(time, INTERVAL 3 HOUR) AS time,
  zip_code,
  CAST(AVG(aqi) AS INT64) AS aqi,
  CAST(AVG(temperature) AS INT64) AS temperature
FROM mydataset.environmental_data_hourly_with_gaps
GROUP BY zip_code, time
ORDER BY zip_code, time;

/*---------------------+----------+-----+-------------+
 |        time         | zip_code | aqi | temperature |
 +---------------------+----------+-----+-------------+
 | 2020-09-08 00:00:00 |    60606 |  22 |          63 |
 | 2020-09-08 03:00:00 |    60606 |  21 |          58 |
 | 2020-09-08 06:00:00 |    60606 |  27 |          55 |
 | 2020-09-08 09:00:00 |    60606 |  36 |          56 |
 | 2020-09-08 15:00:00 |    60606 |  43 |          67 |
 | 2020-09-08 18:00:00 |    60606 |  33 |          68 |
 | 2020-09-08 21:00:00 |    60606 |  25 |          65 |
 | 2020-09-08 00:00:00 |    94105 |  60 |          73 |
 | 2020-09-08 03:00:00 |    94105 |  70 |          67 |
 | 2020-09-08 06:00:00 |    94105 |  75 |          64 |
 | 2020-09-08 09:00:00 |    94105 | 101 |          62 |
 | 2020-09-08 12:00:00 |    94105 | 125 |          62 |
 | 2020-09-08 18:00:00 |    94105 | 151 |          68 |
 | 2020-09-08 21:00:00 |    94105 | 143 |          74 |
 +---------------------+----------+-----+-------------*/
請注意,輸出內容在特定時間間隔內有缺漏。舉例來說,郵遞區號 60606 的時間序列在 2020-09-08 12:00:00 沒有資料點,而郵遞區號 94105 的時間序列在 2020-09-08 15:00:00 沒有資料點。
取得 3 小時平均值 (填補空檔)
使用上一節的查詢,並新增 GAP_FILL 函式來填補缺口:
WITH aggregated_3_hr AS (
  SELECT
    TIMESTAMP_BUCKET(time, INTERVAL 3 HOUR) AS time,
    zip_code,
    CAST(AVG(aqi) AS INT64) AS aqi,
    CAST(AVG(temperature) AS INT64) AS temperature
   FROM mydataset.environmental_data_hourly_with_gaps
   GROUP BY zip_code, time)

SELECT *
FROM GAP_FILL(
  TABLE aggregated_3_hr,
  ts_column => 'time',
  bucket_width => INTERVAL 3 HOUR,
  partitioning_columns => ['zip_code']
)
ORDER BY zip_code, time;

/*---------------------+----------+------+-------------+
 |        time         | zip_code | aqi  | temperature |
 +---------------------+----------+------+-------------+
 | 2020-09-08 00:00:00 |    60606 |   22 |          63 |
 | 2020-09-08 03:00:00 |    60606 |   21 |          58 |
 | 2020-09-08 06:00:00 |    60606 |   27 |          55 |
 | 2020-09-08 09:00:00 |    60606 |   36 |          56 |
 | 2020-09-08 12:00:00 |    60606 | NULL |        NULL |
 | 2020-09-08 15:00:00 |    60606 |   43 |          67 |
 | 2020-09-08 18:00:00 |    60606 |   33 |          68 |
 | 2020-09-08 21:00:00 |    60606 |   25 |          65 |
 | 2020-09-08 00:00:00 |    94105 |   60 |          73 |
 | 2020-09-08 03:00:00 |    94105 |   70 |          67 |
 | 2020-09-08 06:00:00 |    94105 |   75 |          64 |
 | 2020-09-08 09:00:00 |    94105 |  101 |          62 |
 | 2020-09-08 12:00:00 |    94105 |  125 |          62 |
 | 2020-09-08 15:00:00 |    94105 | NULL |        NULL |
 | 2020-09-08 18:00:00 |    94105 |  151 |          68 |
 | 2020-09-08 21:00:00 |    94105 |  143 |          74 |
 +---------------------+----------+------+-------------*/
輸出表格現在包含 2020-09-08 12:00:00 處郵遞區號 60606 的遺漏資料列,以及 2020-09-08 15:00:00 處郵遞區號 94105 的遺漏資料列,且對應的指標欄中含有 NULL 值。由於您未指定任何填補方法,GAP_FILL 使用了預設填補方法 NULL。
使用線性填補和 LOCF 填補法填補缺口
在下列查詢中,GAP_FILL 函式會與 aqi 欄的 LOCF 填補方法和 temperature 欄的線性內插法搭配使用:
WITH aggregated_3_hr AS (
  SELECT
    TIMESTAMP_BUCKET(time, INTERVAL 3 HOUR) AS time,
    zip_code,
    CAST(AVG(aqi) AS INT64) AS aqi,
    CAST(AVG(temperature) AS INT64) AS temperature
   FROM mydataset.environmental_data_hourly_with_gaps
   GROUP BY zip_code, time)

SELECT *
FROM GAP_FILL(
  TABLE aggregated_3_hr,
  ts_column => 'time',
  bucket_width => INTERVAL 3 HOUR,
  partitioning_columns => ['zip_code'],
  value_columns => [
    ('aqi', 'locf'),
    ('temperature', 'linear')
  ]
)
ORDER BY zip_code, time;

/*---------------------+----------+-----+-------------+
 |        time         | zip_code | aqi | temperature |
 +---------------------+----------+-----+-------------+
 | 2020-09-08 00:00:00 |    60606 |  22 |          63 |
 | 2020-09-08 03:00:00 |    60606 |  21 |          58 |
 | 2020-09-08 06:00:00 |    60606 |  27 |          55 |
 | 2020-09-08 09:00:00 |    60606 |  36 |          56 |
 | 2020-09-08 12:00:00 |    60606 |  36 |          62 |
 | 2020-09-08 15:00:00 |    60606 |  43 |          67 |
 | 2020-09-08 18:00:00 |    60606 |  33 |          68 |
 | 2020-09-08 21:00:00 |    60606 |  25 |          65 |
 | 2020-09-08 00:00:00 |    94105 |  60 |          73 |
 | 2020-09-08 03:00:00 |    94105 |  70 |          67 |
 | 2020-09-08 06:00:00 |    94105 |  75 |          64 |
 | 2020-09-08 09:00:00 |    94105 | 101 |          62 |
 | 2020-09-08 12:00:00 |    94105 | 125 |          62 |
 | 2020-09-08 15:00:00 |    94105 | 125 |          65 |
 | 2020-09-08 18:00:00 |    94105 | 151 |          68 |
 | 2020-09-08 21:00:00 |    94105 | 143 |          74 |
 +---------------------+----------+-----+-------------*/
在這項查詢中,第一個填補缺口資料列的 aqi 值為 36,取自這個時間序列 (郵遞區號 60606) 在 2020-09-08 09:00:00 的前一個資料點。temperature 值 62 是資料點 2020-09-08 09:00:00 和 2020-09-08 15:00:00 之間線性內插的結果。另一個遺漏的資料列也是以類似方式建立:aqi 值 125 是從這個時間序列 (郵遞區號 94105) 的前一個資料點沿用而來,而溫度值 65 則是前一個和下一個可用資料點之間的線性內插結果。
使用缺口填補功能校正時間序列
時間序列可以對齊或不對齊。如果資料點只在固定時間間隔出現,時間序列就會對齊。
在實際情況下,收集到的時間序列很少會對齊,通常需要進一步處理才能對齊。
舉例來說,假設 IoT 裝置每分鐘都會將指標傳送至集中式收集器。如果要求裝置在完全相同的時間點傳送指標,並不合理。通常,每部裝置都會以相同的頻率 (週期) 傳送指標,但時間偏移 (對齊) 不同。下圖說明這個範例。您可以看到每部裝置每隔一分鐘傳送資料,其中有些資料遺失 (裝置 3 於 9:36:39),有些資料延遲 (裝置 1 於 9:37:28)。

您可以使用時間匯總,對未對齊的資料執行時間序列對齊。如要變更時間序列的取樣週期,例如從原本的 1 分鐘取樣週期變更為 15 分鐘,這項功能就非常實用。您可以對齊資料,以便進一步處理時間序列 (例如彙整時間序列資料),或用於顯示用途 (例如繪製圖表)。
您可以使用 GAP_FILL 資料表函式,搭配 LOCF 或線性填補方法,執行時間序列對齊。這個做法是使用 GAP_FILL,並選取輸出週期和對齊方式 (由選用的原點引數控制)。作業結果會產生一個包含對齊時間序列的資料表,其中每個資料點的值都是從輸入時間序列衍生而來,並使用該特定值資料欄的缺口填補方法 (LOCF 或線性)。
建立資料表 mydataset.device_data,類似於上圖:
CREATE OR REPLACE TABLE mydataset.device_data AS
SELECT * FROM UNNEST(
  ARRAY<STRUCT<device_id INT64, time TIMESTAMP, signal INT64, state STRING>>[
    STRUCT(2, TIMESTAMP '2023-11-01 09:35:07', 87, 'ACTIVE'),
    STRUCT(1, TIMESTAMP '2023-11-01 09:35:26', 82, 'ACTIVE'),
    STRUCT(3, TIMESTAMP '2023-11-01 09:35:39', 74, 'INACTIVE'),
    STRUCT(2, TIMESTAMP '2023-11-01 09:36:07', 88, 'ACTIVE'),
    STRUCT(1, TIMESTAMP '2023-11-01 09:36:26', 82, 'ACTIVE'),
    STRUCT(2, TIMESTAMP '2023-11-01 09:37:07', 88, 'ACTIVE'),
    STRUCT(1, TIMESTAMP '2023-11-01 09:37:28', 80, 'ACTIVE'),
    STRUCT(3, TIMESTAMP '2023-11-01 09:37:39', 77, 'ACTIVE'),
    STRUCT(2, TIMESTAMP '2023-11-01 09:38:07', 86, 'ACTIVE'),
    STRUCT(1, TIMESTAMP '2023-11-01 09:38:26', 81, 'ACTIVE'),
    STRUCT(3, TIMESTAMP '2023-11-01 09:38:39', 77, 'ACTIVE')
]);
以下是依 time 和 device_id 資料欄排序的實際資料:
SELECT * FROM mydataset.device_data ORDER BY time, device_id;

/*-----------+---------------------+--------+----------+
 | device_id |        time         | signal |  state   |
 +-----------+---------------------+--------+----------+
 |         2 | 2023-11-01 09:35:07 |     87 | ACTIVE   |
 |         1 | 2023-11-01 09:35:26 |     82 | ACTIVE   |
 |         3 | 2023-11-01 09:35:39 |     74 | INACTIVE |
 |         2 | 2023-11-01 09:36:07 |     88 | ACTIVE   |
 |         1 | 2023-11-01 09:36:26 |     82 | ACTIVE   |
 |         2 | 2023-11-01 09:37:07 |     88 | ACTIVE   |
 |         1 | 2023-11-01 09:37:28 |     80 | ACTIVE   |
 |         3 | 2023-11-01 09:37:39 |     77 | ACTIVE   |
 |         2 | 2023-11-01 09:38:07 |     86 | ACTIVE   |
 |         1 | 2023-11-01 09:38:26 |     81 | ACTIVE   |
 |         3 | 2023-11-01 09:38:39 |     77 | ACTIVE   |
 +-----------+---------------------+--------+----------*/
表格包含每部裝置的時間序列,並有兩個指標欄:
signal:裝置在取樣時觀察到的信號等級,以0到100之間的整數值表示。state:取樣時的裝置狀態,以任意形式的字串表示。
在下列查詢中,GAP_FILL 函式用於以 1 分鐘為間隔對齊時間序列。請注意,系統會使用線性內插法計算 signal 欄的值,並使用 LOCF 計算 state 欄的值。以這個範例資料來說,線性內插法是計算輸出值的合適選擇。
SELECT *
FROM GAP_FILL(
  TABLE mydataset.device_data,
  ts_column => 'time',
  bucket_width => INTERVAL 1 MINUTE,
  partitioning_columns => ['device_id'],
  value_columns => [
    ('signal', 'linear'),
    ('state', 'locf')
  ]
)
ORDER BY time, device_id;

 /*---------------------+-----------+--------+----------+
 |        time         | device_id | signal |  state   |
 +---------------------+-----------+--------+----------+
 | 2023-11-01 09:36:00 |         1 |     82 | ACTIVE   |
 | 2023-11-01 09:36:00 |         2 |     88 | ACTIVE   |
 | 2023-11-01 09:36:00 |         3 |     75 | INACTIVE |
 | 2023-11-01 09:37:00 |         1 |     81 | ACTIVE   |
 | 2023-11-01 09:37:00 |         2 |     88 | ACTIVE   |
 | 2023-11-01 09:37:00 |         3 |     76 | INACTIVE |
 | 2023-11-01 09:38:00 |         1 |     81 | ACTIVE   |
 | 2023-11-01 09:38:00 |         2 |     86 | ACTIVE   |
 | 2023-11-01 09:38:00 |         3 |     77 | ACTIVE   |
 +---------------------+-----------+--------+----------*/
輸出資料表包含每個裝置和值資料欄 (signal 和 state) 的對齊時間序列,這些資料欄是使用函式呼叫中指定的填補方法計算得出。
彙整時間序列資料
您可以使用視窗化彙整或 AS OF 彙整,彙整時間序列資料。
視窗化彙整
有時您需要彙整兩個以上的時間序列資料表。請參考以下兩個表格:
mydataset.sensor_temperatures,其中包含每個感應器每 15 秒回報的溫度資料。mydataset.sensor_fuel_rates,其中包含每個感應器每 15 秒測得的燃料消耗率。
如要建立這些資料表,請執行下列查詢:
CREATE OR REPLACE TABLE mydataset.sensor_temperatures AS
SELECT * FROM UNNEST(
  ARRAY<STRUCT<sensor_id INT64, ts TIMESTAMP, temp FLOAT64>>[
  (1, TIMESTAMP '2020-01-01 12:00:00.063', 37.1),
  (1, TIMESTAMP '2020-01-01 12:00:15.024', 37.2),
  (1, TIMESTAMP '2020-01-01 12:00:30.032', 37.3),
  (2, TIMESTAMP '2020-01-01 12:00:01.001', 38.1),
  (2, TIMESTAMP '2020-01-01 12:00:15.082', 38.2),
  (2, TIMESTAMP '2020-01-01 12:00:31.009', 38.3)
]);

CREATE OR REPLACE TABLE mydataset.sensor_fuel_rates AS
SELECT * FROM UNNEST(
  ARRAY<STRUCT<sensor_id INT64, ts TIMESTAMP, rate FLOAT64>>[
    (1, TIMESTAMP '2020-01-01 12:00:11.016', 10.1),
    (1, TIMESTAMP '2020-01-01 12:00:26.015', 10.2),
    (1, TIMESTAMP '2020-01-01 12:00:41.014', 10.3),
    (2, TIMESTAMP '2020-01-01 12:00:08.099', 11.1),
    (2, TIMESTAMP '2020-01-01 12:00:23.087', 11.2),
    (2, TIMESTAMP '2020-01-01 12:00:38.077', 11.3)
]);
以下是資料表中的實際資料:
SELECT * FROM mydataset.sensor_temperatures ORDER BY sensor_id, ts;

 /*-----------+---------------------+------+
 | sensor_id |         ts          | temp |
 +-----------+---------------------+------+
 |         1 | 2020-01-01 12:00:00 | 37.1 |
 |         1 | 2020-01-01 12:00:15 | 37.2 |
 |         1 | 2020-01-01 12:00:30 | 37.3 |
 |         2 | 2020-01-01 12:00:01 | 38.1 |
 |         2 | 2020-01-01 12:00:15 | 38.2 |
 |         2 | 2020-01-01 12:00:31 | 38.3 |
 +-----------+---------------------+------*/

SELECT * FROM mydataset.sensor_fuel_rates ORDER BY sensor_id, ts;

 /*-----------+---------------------+------+
 | sensor_id |         ts          | rate |
 +-----------+---------------------+------+
 |         1 | 2020-01-01 12:00:11 | 10.1 |
 |         1 | 2020-01-01 12:00:26 | 10.2 |
 |         1 | 2020-01-01 12:00:41 | 10.3 |
 |         2 | 2020-01-01 12:00:08 | 11.1 |
 |         2 | 2020-01-01 12:00:23 | 11.2 |
 |         2 | 2020-01-01 12:00:38 | 11.3 |
 +-----------+---------------------+------*/
如要查看各感應器回報溫度時的燃料消耗率,可以彙整兩個時間序列。
雖然兩個時間序列中的資料未對齊,但取樣間隔相同 (15 秒),因此這類資料適合用於視窗化彙整。使用時間分桶函式,對齊做為彙整鍵的時間戳記。
下列查詢說明如何使用 TIMESTAMP_BUCKET 函式,將每個時間戳記指派給 15 秒的時間範圍:
SELECT *, TIMESTAMP_BUCKET(ts, INTERVAL 15 SECOND) ts_window
FROM mydataset.sensor_temperatures
ORDER BY sensor_id, ts;

/*-----------+---------------------+------+---------------------+
 | sensor_id |         ts          | temp |      ts_window      |
 +-----------+---------------------+------+---------------------+
 |         1 | 2020-01-01 12:00:00 | 37.1 | 2020-01-01 12:00:00 |
 |         1 | 2020-01-01 12:00:15 | 37.2 | 2020-01-01 12:00:15 |
 |         1 | 2020-01-01 12:00:30 | 37.3 | 2020-01-01 12:00:30 |
 |         2 | 2020-01-01 12:00:01 | 38.1 | 2020-01-01 12:00:00 |
 |         2 | 2020-01-01 12:00:15 | 38.2 | 2020-01-01 12:00:15 |
 |         2 | 2020-01-01 12:00:31 | 38.3 | 2020-01-01 12:00:30 |
 +-----------+---------------------+------+---------------------*/

SELECT *, TIMESTAMP_BUCKET(ts, INTERVAL 15 SECOND) ts_window
FROM mydataset.sensor_fuel_rates
ORDER BY sensor_id, ts;

/*-----------+---------------------+------+---------------------+
 | sensor_id |         ts          | rate |      ts_window      |
 +-----------+---------------------+------+---------------------+
 |         1 | 2020-01-01 12:00:11 | 10.1 | 2020-01-01 12:00:00 |
 |         1 | 2020-01-01 12:00:26 | 10.2 | 2020-01-01 12:00:15 |
 |         1 | 2020-01-01 12:00:41 | 10.3 | 2020-01-01 12:00:30 |
 |         2 | 2020-01-01 12:00:08 | 11.1 | 2020-01-01 12:00:00 |
 |         2 | 2020-01-01 12:00:23 | 11.2 | 2020-01-01 12:00:15 |
 |         2 | 2020-01-01 12:00:38 | 11.3 | 2020-01-01 12:00:30 |
 +-----------+---------------------+------+---------------------*/
您可以使用這個概念,將油耗率資料與各感應器回報的溫度彙整:
SELECT
  t1.sensor_id AS sensor_id,
  t1.ts AS temp_ts,
  t1.temp AS temp,
  t2.ts AS rate_ts,
  t2.rate AS rate
FROM mydataset.sensor_temperatures t1
LEFT JOIN mydataset.sensor_fuel_rates t2
ON TIMESTAMP_BUCKET(t1.ts, INTERVAL 15 SECOND) =
     TIMESTAMP_BUCKET(t2.ts, INTERVAL 15 SECOND)
   AND t1.sensor_id = t2.sensor_id
ORDER BY sensor_id, temp_ts;

/*-----------+---------------------+------+---------------------+------+
 | sensor_id |       temp_ts       | temp |       rate_ts       | rate |
 +-----------+---------------------+------+---------------------+------+
 |         1 | 2020-01-01 12:00:00 | 37.1 | 2020-01-01 12:00:11 | 10.1 |
 |         1 | 2020-01-01 12:00:15 | 37.2 | 2020-01-01 12:00:26 | 10.2 |
 |         1 | 2020-01-01 12:00:30 | 37.3 | 2020-01-01 12:00:41 | 10.3 |
 |         2 | 2020-01-01 12:00:01 | 38.1 | 2020-01-01 12:00:08 | 11.1 |
 |         2 | 2020-01-01 12:00:15 | 38.2 | 2020-01-01 12:00:23 | 11.2 |
 |         2 | 2020-01-01 12:00:31 | 38.3 | 2020-01-01 12:00:38 | 11.3 |
 +-----------+---------------------+------+---------------------+------*/
AS OF join
在本節中,請使用 mydataset.sensor_temperatures 資料表,並建立新的資料表 mydataset.sensor_location。
mydataset.sensor_temperatures 資料表包含不同感應器的溫度資料,每 15 秒回報一次:
SELECT * FROM mydataset.sensor_temperatures ORDER BY sensor_id, ts;

/*-----------+---------------------+------+
 | sensor_id |         ts          | temp |
 +-----------+---------------------+------+
 |         1 | 2020-01-01 12:00:00 | 37.1 |
 |         1 | 2020-01-01 12:00:15 | 37.2 |
 |         1 | 2020-01-01 12:00:30 | 37.3 |
 |         2 | 2020-01-01 12:00:45 | 38.1 |
 |         2 | 2020-01-01 12:01:01 | 38.2 |
 |         2 | 2020-01-01 12:01:15 | 38.3 |
 +-----------+---------------------+------*/
如要建立 mydataset.sensor_location,請執行下列查詢:
CREATE OR REPLACE TABLE mydataset.sensor_locations AS
SELECT * FROM UNNEST(
  ARRAY<STRUCT<sensor_id INT64, ts TIMESTAMP, location GEOGRAPHY>>[
  (1, TIMESTAMP '2020-01-01 11:59:47.063', ST_GEOGPOINT(-122.022, 37.406)),
  (1, TIMESTAMP '2020-01-01 12:00:08.185', ST_GEOGPOINT(-122.021, 37.407)),
  (1, TIMESTAMP '2020-01-01 12:00:28.032', ST_GEOGPOINT(-122.020, 37.405)),
  (2, TIMESTAMP '2020-01-01 07:28:41.239', ST_GEOGPOINT(-122.390, 37.790))
]);

/*-----------+---------------------+------------------------+
 | sensor_id |         ts          |        location        |
 +-----------+---------------------+------------------------+
 |         1 | 2020-01-01 11:59:47 | POINT(-122.022 37.406) |
 |         1 | 2020-01-01 12:00:08 | POINT(-122.021 37.407) |
 |         1 | 2020-01-01 12:00:28 |  POINT(-122.02 37.405) |
 |         2 | 2020-01-01 07:28:41 |   POINT(-122.39 37.79) |
 +-----------+---------------------+------------------------*/
現在,請將 mydataset.sensor_temperatures 的資料與 mydataset.sensor_location 的資料彙整。
在這種情況下,您無法使用視窗化 join,因為溫度資料和位置資料的回報間隔不同。
在 BigQuery 中,其中一種做法是使用 RANGE 資料類型,將時間戳記資料轉換為範圍。這個範圍代表資料列的時間有效性,提供資料列有效的開始和結束時間。
使用 LEAD 視窗函式,找出時間序列中相對於目前資料點的下一個資料點,這也是目前資料列時間有效性的結束邊界。下列查詢示範如何將位置資料轉換為有效範圍:
WITH locations_ranges AS (
  SELECT
    sensor_id,
    RANGE(ts, LEAD(ts) OVER (PARTITION BY sensor_id ORDER BY ts ASC)) AS ts_range,
    location
  FROM mydataset.sensor_locations
)
SELECT * FROM locations_ranges ORDER BY sensor_id, ts_range;

/*-----------+--------------------------------------------+------------------------+
 | sensor_id |                  ts_range                  |        location        |
 +-----------+--------------------------------------------+------------------------+
 |         1 | [2020-01-01 11:59:47, 2020-01-01 12:00:08) | POINT(-122.022 37.406) |
 |         1 | [2020-01-01 12:00:08, 2020-01-01 12:00:28) | POINT(-122.021 37.407) |
 |         1 |           [2020-01-01 12:00:28, UNBOUNDED) |  POINT(-122.02 37.405) |
 |         2 |           [2020-01-01 07:28:41, UNBOUNDED) |   POINT(-122.39 37.79) |
 +-----------+--------------------------------------------+------------------------*/
現在,您可以將溫度資料 (左) 與位置資料 (右) 彙整:
WITH locations_ranges AS (
  SELECT
    sensor_id,
    RANGE(ts, LEAD(ts) OVER (PARTITION BY sensor_id ORDER BY ts ASC)) AS ts_range,
    location
  FROM mydataset.sensor_locations
)
SELECT
  t1.sensor_id AS sensor_id,
  t1.ts AS temp_ts,
  t1.temp AS temp,
  t2.location AS location
FROM mydataset.sensor_temperatures t1
LEFT JOIN locations_ranges t2
ON RANGE_CONTAINS(t2.ts_range, t1.ts)
AND t1.sensor_id = t2.sensor_id
ORDER BY sensor_id, temp_ts;

/*-----------+---------------------+------+------------------------+
 | sensor_id |       temp_ts       | temp |        location        |
 +-----------+---------------------+------+------------------------+
 |         1 | 2020-01-01 12:00:00 | 37.1 | POINT(-122.022 37.406) |
 |         1 | 2020-01-01 12:00:15 | 37.2 | POINT(-122.021 37.407) |
 |         1 | 2020-01-01 12:00:30 | 37.3 |  POINT(-122.02 37.405) |
 |         2 | 2020-01-01 12:00:01 | 38.1 |   POINT(-122.39 37.79) |
 |         2 | 2020-01-01 12:00:15 | 38.2 |   POINT(-122.39 37.79) |
 |         2 | 2020-01-01 12:00:31 | 38.3 |   POINT(-122.39 37.79) |
 +-----------+---------------------+------+------------------------*/
合併及分割範圍資料
在本節中,您將合併範圍重疊的範圍資料,並將範圍資料分割成較小的範圍。
合併範圍資料
含有範圍值的資料表可能會有重疊的範圍。在下列查詢中,時間範圍會以大約 5 分鐘的間隔擷取感應器狀態:
CREATE OR REPLACE TABLE mydataset.sensor_metrics AS
SELECT * FROM UNNEST(
  ARRAY<STRUCT<sensor_id INT64, duration RANGE<DATETIME>, flow INT64, spins INT64>>[
  (1, RANGE<DATETIME> "[2020-01-01 12:00:01, 2020-01-01 12:05:23)", 10, 1),
  (1, RANGE<DATETIME> "[2020-01-01 12:05:12, 2020-01-01 12:10:46)", 10, 20),
  (1, RANGE<DATETIME> "[2020-01-01 12:10:27, 2020-01-01 12:15:56)", 11, 4),
  (1, RANGE<DATETIME> "[2020-01-01 12:16:00, 2020-01-01 12:20:58)", 11, 9),
  (1, RANGE<DATETIME> "[2020-01-01 12:20:33, 2020-01-01 12:25:08)", 11, 8),
  (2, RANGE<DATETIME> "[2020-01-01 12:00:19, 2020-01-01 12:05:08)", 21, 31),
  (2, RANGE<DATETIME> "[2020-01-01 12:05:08, 2020-01-01 12:10:30)", 21, 2),
  (2, RANGE<DATETIME> "[2020-01-01 12:10:22, 2020-01-01 12:15:42)", 21, 10)
]);
對資料表執行下列查詢,會顯示多個重疊的範圍:
SELECT * FROM mydataset.sensor_metrics;

/*-----------+--------------------------------------------+------+-------+
 | sensor_id |                  duration                  | flow | spins |
 +-----------+--------------------------------------------+------+-------+
 |         1 | [2020-01-01 12:00:01, 2020-01-01 12:05:23) | 10   |     1 |
 |         1 | [2020-01-01 12:05:12, 2020-01-01 12:10:46) | 10   |    20 |
 |         1 | [2020-01-01 12:10:27, 2020-01-01 12:15:56) | 11   |     4 |
 |         1 | [2020-01-01 12:16:00, 2020-01-01 12:20:58) | 11   |     9 |
 |         1 | [2020-01-01 12:20:33, 2020-01-01 12:25:08) | 11   |     8 |
 |         2 | [2020-01-01 12:00:19, 2020-01-01 12:05:08) | 21   |    31 |
 |         2 | [2020-01-01 12:05:08, 2020-01-01 12:10:30) | 21   |     2 |
 |         2 | [2020-01-01 12:10:22, 2020-01-01 12:15:42) | 21   |    10 |
 +-----------+--------------------------------------------+------+-------*/
部分重疊範圍的 flow 欄值相同。舉例來說,第 1 列和第 2 列重疊,且 flow 讀數相同。您可以合併這兩列,減少表格中的列數。您可以使用 RANGE_SESSIONIZE 資料表函式,找出與每個資料列重疊的範圍,並提供額外的 session_range 資料欄,其中包含所有重疊範圍的聯集。如要顯示每個資料列的工作階段範圍,請執行下列查詢:
SELECT sensor_id, session_range, flow
FROM RANGE_SESSIONIZE(
  # Input data.
  (SELECT sensor_id, duration, flow FROM mydataset.sensor_metrics),
  # Range column.
  "duration",
  # Partitioning columns. Ranges are sessionized only within these partitions.
  ["sensor_id", "flow"],
  # Sessionize mode.
  "OVERLAPS")
ORDER BY sensor_id, session_range;

/*-----------+--------------------------------------------+------+
 | sensor_id |                session_range               | flow |
 +-----------+--------------------------------------------+------+
 |         1 | [2020-01-01 12:00:01, 2020-01-01 12:10:46) | 10   |
 |         1 | [2020-01-01 12:00:01, 2020-01-01 12:10:46) | 10   |
 |         1 | [2020-01-01 12:10:27, 2020-01-01 12:15:56) | 11   |
 |         1 | [2020-01-01 12:16:00, 2020-01-01 12:25:08) | 11   |
 |         1 | [2020-01-01 12:16:00, 2020-01-01 12:25:08) | 11   |
 |         2 | [2020-01-01 12:00:19, 2020-01-01 12:05:08) | 21   |
 |         2 | [2020-01-01 12:05:08, 2020-01-01 12:15:42) | 21   |
 |         2 | [2020-01-01 12:05:08, 2020-01-01 12:15:42) | 21   |
 +-----------+--------------------------------------------+------*/
請注意,如果 sensor_id 的值為 2,則第一列的結束邊界與第二列的開始邊界具有相同的日期時間值。不過,由於結束邊界不包含在內,因此不會重疊 (僅相交),因此不在相同的會話群組範圍內。如要將這兩列放在同一個工作階段範圍內,請使用 MEETS 工作階段化模式。
如要合併範圍,請依 session_range 和分區資料欄 (sensor_id 和 flow) 將結果分組:
SELECT sensor_id, session_range, flow
FROM RANGE_SESSIONIZE(
  (SELECT sensor_id, duration, flow FROM mydataset.sensor_metrics),
  "duration",
  ["sensor_id", "flow"],
  "OVERLAPS")
GROUP BY sensor_id, session_range, flow
ORDER BY sensor_id, session_range;

/*-----------+--------------------------------------------+------+
 | sensor_id |                session_range               | flow |
 +-----------+--------------------------------------------+------+
 |         1 | [2020-01-01 12:00:01, 2020-01-01 12:10:46) | 10   |
 |         1 | [2020-01-01 12:10:27, 2020-01-01 12:15:56) | 11   |
 |         1 | [2020-01-01 12:16:00, 2020-01-01 12:25:08) | 11   |
 |         2 | [2020-01-01 12:00:19, 2020-01-01 12:05:08) | 21   |
 |         2 | [2020-01-01 12:05:08, 2020-01-01 12:15:42) | 21   |
 +-----------+--------------------------------------------+------*/
最後,使用 SUM 匯總工作階段資料,新增 spins 資料欄。
SELECT sensor_id, session_range, flow, SUM(spins) as spins
FROM RANGE_SESSIONIZE(
  TABLE mydataset.sensor_metrics,
  "duration",
  ["sensor_id", "flow"],
  "OVERLAPS")
GROUP BY sensor_id, session_range, flow
ORDER BY sensor_id, session_range;

/*-----------+--------------------------------------------+------+-------+
 | sensor_id |                session_range               | flow | spins |
 +-----------+--------------------------------------------+------+-------+
 |         1 | [2020-01-01 12:00:01, 2020-01-01 12:10:46) | 10   |    21 |
 |         1 | [2020-01-01 12:10:27, 2020-01-01 12:15:56) | 11   |     4 |
 |         1 | [2020-01-01 12:16:00, 2020-01-01 12:25:08) | 11   |    17 |
 |         2 | [2020-01-01 12:00:19, 2020-01-01 12:05:08) | 21   |    31 |
 |         2 | [2020-01-01 12:05:08, 2020-01-01 12:15:42) | 21   |    12 |
 +-----------+--------------------------------------------+------+-------*/
分割範圍資料
您也可以將範圍分割成較小的範圍。在本範例中,請使用下列含有範圍資料的表格:
/*-----------+--------------------------+------+-------+
 | sensor_id |         duration         | flow | spins |
 +-----------+--------------------------+------+-------+
 |         1 | [2020-01-01, 2020-12-31) | 10   |    21 |
 |         1 | [2021-01-01, 2021-12-31) | 11   |     4 |
 |         2 | [2020-04-15, 2021-04-15) | 21   |    31 |
 |         2 | [2021-04-15, 2021-04-15) | 21   |    12 |
 +-----------+--------------------------+------+-------*/
現在,請將原始範圍拆分為 3 個月的間隔:
WITH sensor_data AS (
  SELECT * FROM UNNEST(
    ARRAY<STRUCT<sensor_id INT64, duration RANGE<DATE>, flow INT64, spins INT64>>[
    (1, RANGE<DATE> "[2020-01-01, 2020-12-31)", 10, 21),
    (1, RANGE<DATE> "[2021-01-01, 2021-12-31)", 11, 4),
    (2, RANGE<DATE> "[2020-04-15, 2021-04-15)", 21, 31),
    (2, RANGE<DATE> "[2021-04-15, 2022-04-15)", 21, 12)
  ])
)
SELECT sensor_id, expanded_range, flow, spins
FROM sensor_data, UNNEST(GENERATE_RANGE_ARRAY(duration, INTERVAL 3 MONTH)) AS expanded_range;

/*-----------+--------------------------+------+-------+
 | sensor_id |      expanded_range      | flow | spins |
 +-----------+--------------------------+------+-------+
 |         1 | [2020-01-01, 2020-04-01) |   10 |    21 |
 |         1 | [2020-04-01, 2020-07-01) |   10 |    21 |
 |         1 | [2020-07-01, 2020-10-01) |   10 |    21 |
 |         1 | [2020-10-01, 2020-12-31) |   10 |    21 |
 |         1 | [2021-01-01, 2021-04-01) |   11 |     4 |
 |         1 | [2021-04-01, 2021-07-01) |   11 |     4 |
 |         1 | [2021-07-01, 2021-10-01) |   11 |     4 |
 |         1 | [2021-10-01, 2021-12-31) |   11 |     4 |
 |         2 | [2020-04-15, 2020-07-15) |   21 |    31 |
 |         2 | [2020-07-15, 2020-10-15) |   21 |    31 |
 |         2 | [2020-10-15, 2021-01-15) |   21 |    31 |
 |         2 | [2021-01-15, 2021-04-15) |   21 |    31 |
 |         2 | [2021-04-15, 2021-07-15) |   21 |    12 |
 |         2 | [2021-07-15, 2021-10-15) |   21 |    12 |
 |         2 | [2021-10-15, 2022-01-15) |   21 |    12 |
 |         2 | [2022-01-15, 2022-04-15) |   21 |    12 |
 +-----------+--------------------------+------+-------*/
在先前的查詢中,每個原始範圍都會細分為較小的範圍,寬度設為 INTERVAL 3 MONTH。不過,3 個月的範圍並未對齊共同原點。如要將這些範圍對齊共同原點 2020-01-01,請執行下列查詢:
WITH sensor_data AS (
  SELECT * FROM UNNEST(
    ARRAY<STRUCT<sensor_id INT64, duration RANGE<DATE>, flow INT64, spins INT64>>[
    (1, RANGE<DATE> "[2020-01-01, 2020-12-31)", 10, 21),
    (1, RANGE<DATE> "[2021-01-01, 2021-12-31)", 11, 4),
    (2, RANGE<DATE> "[2020-04-15, 2021-04-15)", 21, 31),
    (2, RANGE<DATE> "[2021-04-15, 2022-04-15)", 21, 12)
  ])
)
SELECT sensor_id, expanded_range, flow, spins
FROM sensor_data
JOIN UNNEST(GENERATE_RANGE_ARRAY(RANGE<DATE> "[2020-01-01, 2022-12-31)", INTERVAL 3 MONTH)) AS expanded_range
ON RANGE_OVERLAPS(duration, expanded_range);

/*-----------+--------------------------+------+-------+
 | sensor_id |      expanded_range      | flow | spins |
 +-----------+--------------------------+------+-------+
 |         1 | [2020-01-01, 2020-04-01) |   10 |    21 |
 |         1 | [2020-04-01, 2020-07-01) |   10 |    21 |
 |         1 | [2020-07-01, 2020-10-01) |   10 |    21 |
 |         1 | [2020-10-01, 2021-01-01) |   10 |    21 |
 |         1 | [2021-01-01, 2021-04-01) |   11 |     4 |
 |         1 | [2021-04-01, 2021-07-01) |   11 |     4 |
 |         1 | [2021-07-01, 2021-10-01) |   11 |     4 |
 |         1 | [2021-10-01, 2022-01-01) |   11 |     4 |
 |         2 | [2020-04-01, 2020-07-01) |   21 |    31 |
 |         2 | [2020-07-01, 2020-10-01) |   21 |    31 |
 |         2 | [2020-10-01, 2021-01-01) |   21 |    31 |
 |         2 | [2021-01-01, 2021-04-01) |   21 |    31 |
 |         2 | [2021-04-01, 2021-07-01) |   21 |    31 |
 |         2 | [2021-04-01, 2021-07-01) |   21 |    12 |
 |         2 | [2021-07-01, 2021-10-01) |   21 |    12 |
 |         2 | [2021-10-01, 2022-01-01) |   21 |    12 |
 |         2 | [2022-01-01, 2022-04-01) |   21 |    12 |
 |         2 | [2022-04-01, 2022-07-01) |   21 |    12 |
 +-----------+--------------------------+------+-------*/
在先前的查詢中,範圍為 [2020-04-15, 2021-04-15) 的資料列會分割為 5 個範圍,從 [2020-04-01, 2020-07-01) 開始。請注意,起始邊界現在會延伸至原始起始邊界之外,以便與共同原點對齊。如果不想讓起始邊界超出原始起始邊界,可以限制 JOIN 條件:
WITH sensor_data AS (
  SELECT * FROM UNNEST(
    ARRAY<STRUCT<sensor_id INT64, duration RANGE<DATE>, flow INT64, spins INT64>>[
    (1, RANGE<DATE> "[2020-01-01, 2020-12-31)", 10, 21),
    (1, RANGE<DATE> "[2021-01-01, 2021-12-31)", 11, 4),
    (2, RANGE<DATE> "[2020-04-15, 2021-04-15)", 21, 31),
    (2, RANGE<DATE> "[2021-04-15, 2022-04-15)", 21, 12)
  ])
)
SELECT sensor_id, expanded_range, flow, spins
FROM sensor_data
JOIN UNNEST(GENERATE_RANGE_ARRAY(RANGE<DATE> "[2020-01-01, 2022-12-31)", INTERVAL 3 MONTH)) AS expanded_range
ON RANGE_CONTAINS(duration, RANGE_START(expanded_range));

/*-----------+--------------------------+------+-------+
 | sensor_id |      expanded_range      | flow | spins |
 +-----------+--------------------------+------+-------+
 |         1 | [2020-01-01, 2020-04-01) |   10 |    21 |
 |         1 | [2020-04-01, 2020-07-01) |   10 |    21 |
 |         1 | [2020-07-01, 2020-10-01) |   10 |    21 |
 |         1 | [2020-10-01, 2021-01-01) |   10 |    21 |
 |         1 | [2021-01-01, 2021-04-01) |   11 |     4 |
 |         1 | [2021-04-01, 2021-07-01) |   11 |     4 |
 |         1 | [2021-07-01, 2021-10-01) |   11 |     4 |
 |         1 | [2021-10-01, 2022-01-01) |   11 |     4 |
 |         2 | [2020-07-01, 2020-10-01) |   21 |    31 |
 |         2 | [2020-10-01, 2021-01-01) |   21 |    31 |
 |         2 | [2021-01-01, 2021-04-01) |   21 |    31 |
 |         2 | [2021-04-01, 2021-07-01) |   21 |    31 |
 |         2 | [2021-07-01, 2021-10-01) |   21 |    12 |
 |         2 | [2021-10-01, 2022-01-01) |   21 |    12 |
 |         2 | [2022-01-01, 2022-04-01) |   21 |    12 |
 |         2 | [2022-04-01, 2022-07-01) |   21 |    12 |
 +-----------+--------------------------+------+-------*/
現在您會看到範圍 [2020-04-15, 2021-04-15) 已分割為 4 個範圍,從範圍 [2020-07-01, 2020-10-01) 開始。
儲存資料的最佳做法
儲存時間序列資料時,請務必考量資料儲存資料表所使用的查詢模式。一般來說,查詢時間序列資料時,您可以篩選特定日期範圍的資料。
如要最佳化這些使用模式,建議您將時間序列資料儲存在分區資料表中,並依時間欄或擷取時間分區資料。這項做法可讓 BigQuery 排除不含查詢資料的分區,大幅提升時間序列資料的查詢時間效能。
您可以對時間、範圍或其中一個分區資料欄啟用分群,進一步縮短查詢時間。