


סקירה כללית על האחסון ב-BigQuery
האחסון ב-BigQuery מותאם להרצת שאילתות ניתוח על מערכי נתונים גדולים. הוא גם תומך בהטמעת עדכונים בזמן אמת בתפוקה גבוהה ובקריאות בתפוקה גבוהה. הבנת האחסון ב-BigQuery יכולה לעזור לכם לבצע אופטימיזציה של עומסי העבודה.
סקירה כללית
אחד מהמאפיינים העיקריים של הארכיטקטורה של BigQuery הוא ההפרדה בין האחסון למחשוב. כך אפשר להגדיל את נפח האחסון ואת יכולת המחשוב ב-BigQuery באופן עצמאי, בהתאם לדרישה.
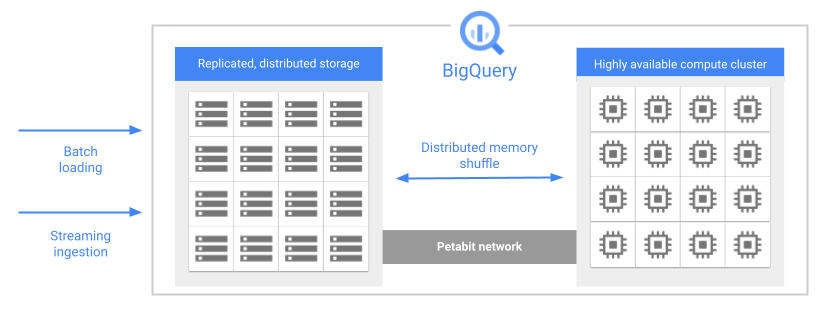
כשמריצים שאילתה, מנוע השאילתות מחלק את העבודה במקביל בין כמה וורקרים, שסורקים את הטבלאות הרלוונטיות באחסון, מעבדים את השאילתה ואז אוספים את התוצאות. השאילתות ב-BigQuery מבוצעות כולן בזיכרון, באמצעות רשת פטה-ביט, כדי להבטיח שהנתונים יועברו במהירות רבה לצומתי העובדים.
אלה כמה מהתכונות העיקריות של האחסון ב-BigQuery:
מנוהל. האחסון ב-BigQuery הוא שירות מנוהל לחלוטין. אין צורך להקצות משאבי אחסון או להזמין יחידות אחסון. כשאתם טוענים נתונים למערכת, BigQuery מקצה לכם נפח אחסון באופן אוטומטי. אתם משלמים רק על נפח האחסון שאתם משתמשים בו. במודל התמחור של BigQuery, החיוב על מחשוב ועל אחסון מתבצע בנפרד. פרטים נוספים זמינים במאמר תמחור ב-BigQuery.
Durable. האחסון ב-BigQuery מיועד לספק עמידות שנתית של 99.999999999% (או 11 תשיעיות). כדי להגן על הנתונים מפני אובדן בגלל כשלים ברמת המכונה או כשלים באזור, BigQuery משכפל את הנתונים בכמה אזורי זמינות. מידע נוסף זמין במאמר אמינות: תכנון למקרה של אסון.
מוצפנים. ב-BigQuery כל הנתונים מוצפנים באופן אוטומטי לפני שהם נכתבים בדיסק. אתם יכולים לספק מפתח הצפנה משלכם או לאפשר ל-Google לנהל את מפתח ההצפנה. מידע נוסף זמין במאמר הצפנה במנוחה.
יעילות. האחסון ב-BigQuery משתמש בפורמט קידוד יעיל שמותאם לעומסי עבודה של ניתוח נתונים. בפוסט בבלוג Inside Capacitor, BigQuery's next-generation columnar storage format תוכלו לקרוא מידע נוסף על פורמט האחסון של BigQuery.
נתוני הטבלה
רוב הנתונים שמאוחסנים ב-BigQuery הם נתוני טבלאות. נתוני הטבלה כוללים טבלאות רגילות, שיבוטי טבלאות, תמונות מצב של טבלאות ותצוגות מהותיות. אתם מחויבים על האחסון שאתם משתמשים בו למשאבים האלה. למידע נוסף, ראו תמחור של Storage.
טבלאות רגילות מכילות נתונים מובְנים. לכל טבלה יש סכימה, ולכל עמודה בסכימה יש סוג נתונים. ב-BigQuery הנתונים נשמרים בפורמט של עמודות. פריסת האחסון
שיבוטי טבלאות הם עותקים קלים וניתנים לכתיבה של טבלאות רגילות. ב-BigQuery נשמר רק ההפרש בין טבלה משוכפלת לבין מסד הנתונים הטבלאי שלה.
תמונות מצב של טבלאות הן עותקים של טבלאות בנקודת זמן מסוימת. תמונות מצב של טבלאות הן לקריאה בלבד, אבל אפשר לשחזר טבלה מתמונת מצב של טבלה. ב-BigQuery נשמר רק ההפרש בין תמונת המצב של הטבלה לבין טבלת הבסיס שלה.
תצוגות מהותיות הן תצוגות שחושבו מראש, ששומרות במטמון באופן תקופתי את התוצאות של שאילתת התצוגה. התוצאות שנשמרו במטמון מאוחסנות ב-BigQuery.
בנוסף, תוצאות של שאילתות שנשמרו במטמון נשמרות כטבלאות זמניות. אתם לא מחויבים על תוצאות של שאילתות במטמון שמאוחסנות בטבלאות זמניות.
טבלאות חיצוניות הן סוג מיוחד של טבלאות, שבהן מיקום אחסון הנתונים נמצא במאגר נתונים חיצוני ל-BigQuery, כמו Cloud Storage. לטבלה חיצונית יש סכימת טבלה, בדיוק כמו לטבלה רגילה, אבל הגדרת הטבלה מפנה למאגר הנתונים החיצוני. במקרה כזה, רק המטא-נתונים של הטבלה נשמרים באחסון של BigQuery. ב-BigQuery לא מחייבים על אחסון של טבלאות חיצוניות, אבל יכול להיות שמאגר הנתונים החיצוני מחייב על אחסון.
ב-BigQuery, טבלאות ומשאבים אחרים מאורגנים בקונטיינרים לוגיים שנקראים מערכי נתונים. האופן שבו אתם מקבצים את המשאבים ב-BigQuery משפיע על ההרשאות, המכסות, החיוב והיבטים אחרים של עומסי העבודה ב-BigQuery. למידע נוסף ולשיטות מומלצות, קראו את המאמר מבוא להיררכיית המשאבים.
מדיניות שמירת הנתונים שמשמשת לטבלה נקבעת לפי ההגדרות של מערך הנתונים שמכיל את הטבלה. מידע נוסף זמין במאמר שמירת נתונים באמצעות Time Travel ו-Fail-safe.
מטא-נתונים
בנוסף, באחסון ב-BigQuery נשמרים מטא-נתונים על המשאבים שלכם ב-BigQuery. אתם לא מחויבים על אחסון מטא-נתונים.
כשיוצרים ישות קבועה ב-BigQuery, כמו טבלה, תצוגה או פונקציה בהגדרת המשתמש (UDF), BigQuery מאחסן מטא-נתונים על הישות. זה נכון גם לגבי משאבים שלא מכילים נתונים בטבלה, כמו פונקציות מוגדרות על ידי המשתמש (UDF) ותצוגות לוגיות.
המטא-נתונים כוללים מידע כמו סכימת הטבלה, מפרטי החלוקה למחיצות והאשכולות, זמני התפוגה של הטבלה ומידע נוסף. סוג המטא-נתונים הזה גלוי למשתמש, ואפשר להגדיר אותו כשיוצרים את המשאב. בנוסף, BigQuery מאחסן מטא-נתונים שמשמשים אותו באופן פנימי לאופטימיזציה של שאילתות. המשתמשים לא רואים את המטא-נתונים האלה באופן ישיר.
פריסת האחסון
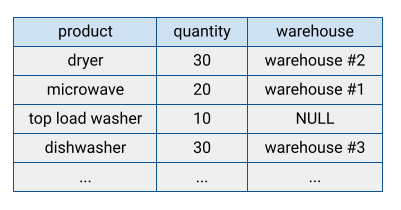
במערכות רבות של מסדי נתונים מסורתיים, הנתונים מאוחסנים בפורמט שמוכוון לשורות. כלומר, השורות מאוחסנות יחד, והשדות בכל שורה מופיעים ברצף בדיסק. מסדי נתונים מבוססי-שורות יעילים בחיפוש רשומות בודדות. עם זאת, יכול להיות שהם יהיו פחות יעילים בביצוע פונקציות של ניתוח נתונים ברשומות רבות, כי המערכת צריכה לקרוא כל שדה כשהיא ניגשת לרשומה.
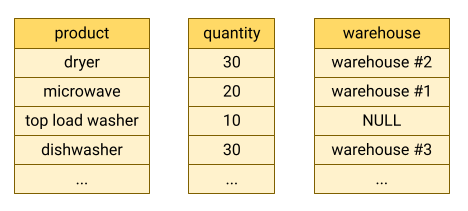
ב-BigQuery, נתוני הטבלה נשמרים בפורמט עמודתי, כלומר כל עמודה נשמרת בנפרד. מסדי נתונים מבוססי-עמודות יעילים במיוחד בסריקת עמודות בודדות במערך נתונים שלם.
מסדי נתונים מבוססי-עמודות מותאמים לעומסי עבודה של ניתוח נתונים, שצוברים נתונים ממספר גדול מאוד של רשומות. במקרים רבים, שאילתת ניתוח צריכה לקרוא רק כמה עמודות מטבלה. לדוגמה, אם רוצים לחשב את הסכום של עמודה עם מיליוני שורות, BigQuery יכול לקרוא את נתוני העמודה בלי לקרוא כל שדה בכל שורה.
יתרון נוסף של מסדי נתונים מבוססי-עמודות הוא שבדרך כלל יש יותר יתירות בנתונים שבעמודה מאשר בנתונים שבשורה. המאפיין הזה מאפשר דחיסת נתונים טובה יותר באמצעות שיטות כמו קידוד אורך-ריצה (run-length encoding), שיכול לשפר את ביצועי הקריאה.
מודלים של חיוב על אחסון
ב-BigQuery יש שני מודלים לחיוב על אחסון: לוגי (לא דחוס) ופיזי (דחוס).
שינוי מודל החיוב על האחסון משנה רק את הגדרת המדידה. הוא לא כולל העברת נתונים, המרה של פורמט קבצים או שינויים בתשתית. הנתונים תמיד מאוחסנים באותו פורמט פיזי דחוס. שינוי ההגדרה הזו לא משפיע על ביצועי השאילתות, זמן האחזור או השילוב עם אפליקציות אחרות, כמו Looker.
המודל שתבחרו קובע רק איך נמדדים הבייטים המאוחסנים ואיך הם מתומחרים לפי תמחור האחסון:
- חיוב לוגי: החיוב מבוסס על גודל הנתונים לפני הדחיסה. זהו מודל ברירת המחדל.
- חיוב פיזי: החיוב מבוסס על הגודל הדחוס של הנתונים בדיסק.
לא משנה באיזה מודל חיוב תבחרו, הנתונים שלכם מאוחסנים כבייטים פיזיים.
אתם מגדירים את מודל החיוב על אחסון ברמת מערך הנתונים. אם לא תציינו מודל חיוב על אחסון כשאתם יוצרים מערך נתונים, כברירת מחדל המערכת תשתמש בחיוב על אחסון לוגי. עם זאת, אחרי שיוצרים מערך נתונים אפשר לשנות את מודל החיוב על האחסון שלו. אם משנים את מודל החיוב על אחסון של מערך נתונים, צריך להמתין 14 ימים לפני שאפשר לשנות שוב את מודל החיוב על אחסון.
כשמשנים את מודל החיוב של מערך נתונים, השינוי נכנס לתוקף תוך 24 שעות. טבלאות או מחיצות של טבלאות באחסון לטווח ארוך לא מאופסות לאחסון פעיל כשמשנים את מודל החיוב של מערך נתונים. שינוי מודל החיוב של מערך נתונים לא משפיע על ביצועי השאילתות ועל זמן האחזור שלהן.
במערכי נתונים נעשה שימוש במסע בזמן ובאחסון בטוח מפני כשלים לשמירת נתונים. כשמשתמשים בחיוב על נפח אחסון פיזי, החיוב על Time Travel ועל אחסון ב-Fail-safe מתבצע בנפרד לפי התעריפים של אחסון פעיל. לעומת זאת, כשמשתמשים בחיוב על נפח אחסון לוגי, החיוב על Time Travel ועל אחסון ב-Fail-safe כלול בתעריף הבסיס. כדי לאזן בין עלויות האחסון הפיזי לבין שמירת הנתונים, אתם יכולים לשנות את חלון הזמן של המסע בזמן שבו אתם משתמשים במערך נתונים. אי אפשר לשנות את חלון ההמרות למקרה חירום. למידע נוסף על שמירת נתונים של מערך נתונים, ראו שמירת נתונים באמצעות Time Travel ו-Fail-safe. איך יוצרים תחזית של החיובים על אחסון
אי אפשר לרשום מערך נתונים לחיוב על אחסון פיזי אם לארגון יש התחייבויות קיימות מדור קודם למשבצות בתעריף קבוע שנמצאות באותו אזור של מערך הנתונים. ההנחה לא חלה על התחייבויות שנרכשו עם מהדורת BigQuery.אופטימיזציה של האחסון
אופטימיזציה של האחסון ב-BigQuery משפרת את ביצועי השאילתות ומאפשרת לשלוט בעלויות. כדי לראות את המטא-נתונים של נפח האחסון של הטבלה, שולחים שאילתה לתצוגות הבאות של INFORMATION_SCHEMA:
למידע נוסף על אופטימיזציה של האחסון, קראו את המאמר אופטימיזציה של האחסון ב-BigQuery.
טעינת נתונים
יש כמה דפוסים בסיסיים להטמעת נתונים ב-BigQuery.
טעינה באצווה: טעינת נתוני המקור לטבלה ב-BigQuery בפעולת אצווה אחת. אפשר לבצע את הפעולה הזו באופן חד-פעמי או להגדיר אותה כך שתתבצע באופן אוטומטי לפי לוח זמנים. פעולת טעינה באצווה יכולה ליצור טבלה חדשה או להוסיף נתונים לטבלה קיימת.
סטרימינג: הזרמה רציפה של קבוצות קטנות יותר של נתונים, כך שהנתונים זמינים לשאילתות כמעט בזמן אמת.
נתונים שנוצרו: אפשר להשתמש בהצהרות SQL כדי להוסיף שורות לטבלה קיימת או לכתוב את תוצאות השאילתה בטבלה.
למידע נוסף על המקרים שבהם כדאי לבחור בכל אחת משיטות ההטמעה האלה, קראו את המאמר מבוא לטעינת נתונים. למידע על מחירים, ראו תמחור הטמעת נתונים.
קריאת נתונים מאחסון ב-BigQuery
ברוב המקרים, מאחסנים נתונים ב-BigQuery כדי להריץ שאילתות אנליטיות על הנתונים האלה. אבל לפעמים תרצו לקרוא רשומות ישירות מטבלה. ב-BigQuery יש כמה דרכים לקרוא נתונים מטבלאות:
BigQuery API: גישה סינכרונית עם חלוקה לדפים באמצעות השיטה
tabledata.list. הנתונים נקראים באופן סדרתי, דף אחד בכל הפעלה. למידע נוסף, קראו את המאמר עיון בנתוני טבלה.BigQuery Storage API: גישה בסטרימינג עם תפוקה גבוהה, שתומכת גם בהקרנה ובסינון של עמודות בצד השרת. אפשר לבצע פעולות קריאה במקביל על פני קוראים רבים על ידי חלוקה שלהם למספר זרמים נפרדים.
ייצוא: העתקה אסינכרונית עם תפוקה גבוהה ל-Google Cloud Storage, באמצעות משימות חילוץ או ההצהרה
EXPORT DATA. אם אתם צריכים להעתיק נתונים ב-Cloud Storage, אתם יכולים לייצא את הנתונים באמצעות משימת חילוץ או הצהרתEXPORT DATA.העתקה: העתקה אסינכרונית של מערכי נתונים ב-BigQuery. ההעתקה מתבצעת באופן לוגי כשמיקום המקור ומיקום היעד זהים.
למידע על מחירים, ראו תמחור של חילוץ נתונים.
בהתאם לדרישות של האפליקציה, אתם יכולים לקרוא את הנתונים בטבלה:
- קריאה והעתקה: אם אתם צריכים עותק במצב מנוחה ב-Cloud Storage, אתם יכולים לייצא את הנתונים באמצעות משימת חילוץ או הצהרת
EXPORT DATA. אם אתם רוצים רק לקרוא את הנתונים, השתמשו ב-BigQuery Storage API. אם אתם רוצים ליצור עותק בתוך BigQuery, אתם יכולים להשתמש במשימת העתקה. - קנה מידה: BigQuery API הוא השיטה הכי פחות יעילה, ולא כדאי להשתמש בה לקריאות בנפח גבוה. אם אתם צריכים לייצא יותר מ-50TB של נתונים ביום, השתמשו בהצהרה
EXPORT DATAאו ב-BigQuery Storage API. - הזמן להחזרת השורה הראשונה: BigQuery API הוא השיטה המהירה ביותר להחזרת השורה הראשונה, אבל צריך להשתמש בו רק כדי לקרוא כמויות קטנות של נתונים. ב-BigQuery Storage API, החזרת השורה הראשונה איטית יותר, אבל הקיבולת גבוהה בהרבה. פעולות הייצוא וההעתקה חייבות להסתיים לפני שאפשר לקרוא שורות כלשהן, כך שהזמן עד לשורה הראשונה בסוגי המשימות האלה יכול להיות בסדר גודל של דקות.
מחיקה
כשמוחקים טבלה, הנתונים נשמרים לפחות למשך חלון הזמן של הנסיעה בזמן.
לאחר מכן, הנתונים נמחקים מהדיסק במסגרת Google Cloud ציר הזמן למחיקה.
חלק מפעולות המחיקה, כמו ההצהרה DROP COLUMN, הן פעולות של מטא-נתונים בלבד. במקרה כזה, נפח האחסון מתפנה בפעם הבאה שמשנים את השורות המושפעות. אם לא תשנו את הטבלה, אין זמן מובטח שבו האחסון יתפנה.
מידע נוסף זמין במאמר מחיקת נתונים ב- Google Cloud.
המאמרים הבאים
- מידע נוסף על עבודה עם טבלאות
- איך מבצעים אופטימיזציה של האחסון
- איך שולחים שאילתות על נתונים ב-BigQuery
- מידע על אבטחה ומשילות מידע