


מבוא לתצוגות מהותיות
תצוגות חומריות (materialized views) ב-BigQuery הן טבלאות שמחושבות מראש כדי לשפר את ביצועי השאילתות ולצמצם את עלויות הביצוע של שאילתות שמופעלות לעיתים קרובות ושאפשר לצפות את התוצאות שלהן. תצוגות חומריות פותרות בעיות של זמן אחזור בשאילתות ועלויות סריקה גבוהות כששולחים שוב ושוב שאילתות במערכי נתונים גדולים עם דפוסי צבירה צפויים. התצוגות החומריות ממזגות באופן אוטומטי נתונים שחושבו מראש עם שינויים שבוצעו לאחרונה בטבלאות הבסיס, וכך מבטיחות תוצאות עדכניות של שאילתות בלי שנדרשים צינורות נתונים ידניים.
המסמך הזה מיועד למהנדסי נתונים, לאדמינים של מסדי נתונים ולמפתחי בינה עסקית (BI) שתפקידם לתכנן צינורות ניתוח נתונים עם ביצועים גבוהים. כדי להטמיע תצוגות חומריות בהצלחה, צריך להכיר את מבני מערכי הנתונים ב-BigQuery, את פונקציות הצבירה של GoogleSQL ואת מבני העלויות של השאילתות.
היתרונות של תצוגות מהותיות
תרחישי השימוש הבאים מדגישים את היתרונות של תצוגות חומריות:
- עיבוד מוקדם של הנתונים. כדי לשפר את ביצועי השאילתות, כדאי להכין צבירות, מסננים, צירופים ואשכולות.
- האצה של לוח הבקרה. העצמת כלי BI כמו Looker ששולחים שאילתות לעיתים קרובות לגבי אותם מדדים מצטברים – לדוגמה, משתמשים פעילים ביום.
- ניתוח נתונים בזמן אמת בשידורים גדולים. יכול לספק תשובות מהירות יותר לגבי טבלאות שמקבלות נתונים בסטרימינג במהירות גבוהה.
- ניהול עלויות. להקטין את העלות של שאילתות חוזרות ויקרות במערכי נתונים גדולים.
מאפיינים מרכזיים
המאפיינים העיקריים של תצוגות חומריות כוללים את הדברים הבאים:
- אפס תחזוקה. BigQuery מבצע חישוב מראש של תצוגות חומריות ברקע כשיש שינויים בטבלאות הבסיס. מערכת BigQuery מוסיפה באופן אוטומטי שינויים מצטברים בנתונים מטבלאות בסיס לתצוגות חומריות, ללא צורך בפעולה מצד המשתמש.
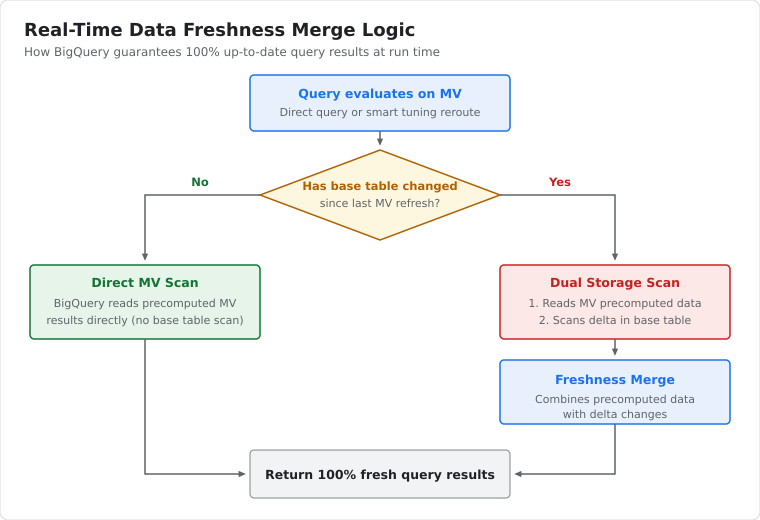
נתונים עדכניים. תצוגות מהותיות מחזירות נתונים עדכניים. אם שינויים בטבלאות הבסיס עלולים לפגוע בתצוגה החומרית, BigQuery קורא את הנתונים ישירות מטבלאות הבסיס. אם השינויים בטבלאות הבסיסיות לא פוסלים את התצוגה החומרית, BigQuery קורא את שאר הנתונים מהתצוגה החומרית וקורא רק את השינויים מהטבלאות הבסיסיות.
בתרשים הבא מוצגת הלוגיקה שמשמשת למיזוג שינויים בנתונים בזמן אמת:
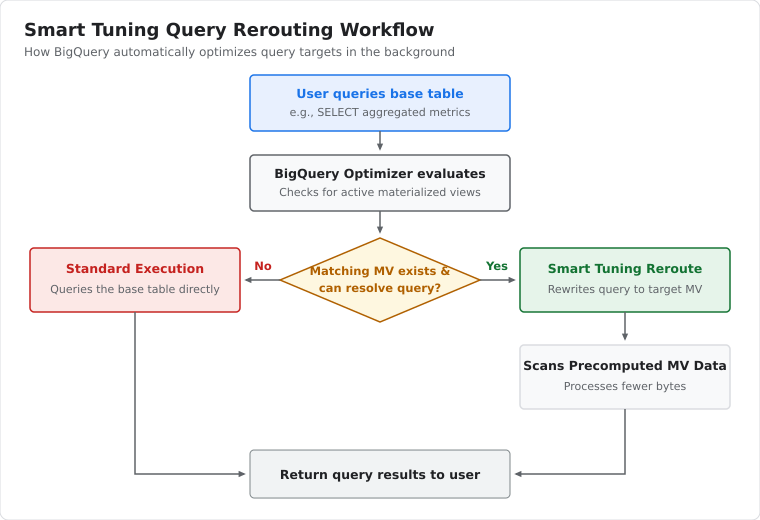
התאמה חכמה. אם אפשר לפתור חלק כלשהו בשאילתה שמופנית למסד נתונים טבלאי באמצעות שליחת שאילתה של התצוגה החומרית, BigQuery מפנה מחדש את השאילתה לשימוש בתצוגה החומרית כדי לשפר את הביצועים והיעילות. מידע על האופן שבו כוונון חכם יכול לשפר את השאילתות ועל המקרים שבהם הוא יכול לעשות זאת זמין במאמר שימוש בתצוגות חומריות.
התרשים הבא מציג את תהליך העבודה של ניתוב מחדש של שאילתות באמצעות התאמה חכמה:
סוגים של תצוגות מהותיות
יש שני סוגים בסיסיים של תצוגות חומריות:
- תצוגות חומריות מצטברות תומכות בקבוצה מוגבלת של תכונות. מידע נוסף על תחביר SQL נתמך לתצוגות מהותיות זמין במאמר יצירת תצוגות מהותיות. רק תצוגות חומריות מצטברות יכולות להפיק תועלת מהתאמה חכמה.
- תצוגות חומריות לא מצטברות תומכות ברוב התחביר שתצוגות חומריות מצטברות לא תומכות בו.
כשיוצרים תצוגות מהותיות, כברירת מחדל BigQuery מאפשר ליצור תצוגות רק על סמך שאילתות מצטברות. כדי ליצור תצוגה לא מצטברת, אפשר לציין allow_non_incremental_definition = true בהגדרה של התצוגה המהותית.
הסוג הכי טוב של תצוגה חומרית שמתאים לכם תלוי במצב שלכם. בטבלה הבאה מוצגת השוואה בין התכונות של תצוגות חומריות מצטברות ולא מצטברות:
| קטגוריה | מצטבר | לא מצטבר |
|---|---|---|
| השאילתה נתמכת | מוגבלת | רוב השאילתות |
| עלות התחזוקה | יכולה להפחית את העלות של שאילתות שנמצאות בשימוש תדיר. במאמר עדכונים מצטברים מוסבר איך מתעדכנים תצוגות חומריות. | כל רענון מריץ את השאילתה המלאה. |
| תמיכה בכוונון חכם | נתמך ברוב השאילתות של תצוגות מפורטות. | לא |
| תוצאות תמיד עדכניות | יש תמיכה. תצוגות מצטברות מחזירות תוצאות עדכניות של שאילתות גם אם טבלאות הבסיס השתנו מאז הרענון האחרון. | לא |
תצוגות מהותיות מורשות
אתם יכולים ליצור תצוגה חומרית מורשית כדי לשתף קבוצת משנה של נתונים ממערך נתונים של מקור לתצוגה במערך נתונים משני. אחר כך תוכלו לשתף את התצוגה הזו עם משתמשים וקבוצות ספציפיים (גורמים ראשיים). החשבונות הראשיים יכולים להריץ שאילתות על הנתונים שאתם מספקים בתצוגה, אבל הם לא יכולים לגשת ישירות למערך הנתונים של המקור.
תצוגות מורשות ותצוגות מהותיות מורשות מקבלות הרשאה באותו אופן. פרטים נוספים מופיעים במאמר בנושא תצוגות מורשות.
אינטראקציה עם תכונות אחרות של BigQuery
התכונות הבאות של BigQuery פועלות באופן שקוף עם תצוגות חומריות:
הסבר על תוכנית לביצוע שאילתה. תוכנית השאילתה מראה אילו תצוגות חומריות נסרקות (אם יש כאלה), וכמה בייטים נקראים מהתצוגות החומריות ומהטבלאות הבסיסיות יחד.
שמירת שאילתות במטמון. אפשר לשמור במטמון את התוצאות של שאילתה ש-BigQuery כותב מחדש באמצעות תצוגה חומרית, בכפוף למגבלות הרגילות (שימוש בפונקציות דטרמיניסטיות, ללא סטרימינג לטבלאות הבסיס וכו').
הגבלת עלויות. אם מציינים מגבלת בייטים לחיוב, ושאילתה קוראת נתונים שחורגים מהמגבלה הזו, השאילתה תיכשל ולא יחויב עליה תשלום, בין אם השאילתה משתמשת בתצוגות חומריות, בטבלאות הבסיס או בשניהם.
אומדן עלויות באמצעות הרצת בדיקה. הרצת בדיקה חוזרת על הלוגיקה של שכתוב השאילתה באמצעות התצוגות החומריות הזמינות, ומספקת אומדן עלות. אתם יכולים להשתמש בתכונה הזו כדי לבדוק אם שאילתה ספציפית משתמשת בתצוגות חומריות.
שכפול נתונים בין אזורים. אפשר ליצור תצוגות חומריות על טבלאות BigQuery שמופעלת בהן רפליקציה בכמה אזורים, אבל רק באזור הראשי. אם משתמשים באזור המשני, יכול להיות שתופיע הודעת השגיאה הבאה:
The dataset replica of the cross region dataset {PROJECT}:{DATASET} in region {REGION} is read-only because it's not the primary replica.
בנוסף לתכונות האלה, אפשר ליצור תצוגות חומריות מעל טבלאות עם תכונות ספציפיות, כמו שמתואר בקטעים הבאים.
טבלאות עם סימון נתונים שהשתנו (CDC)
אפשר ליצור תצוגות חומריות על טבלאות עם סימון נתונים שהשתנו (CDC) פעיל – תבנית שמשמשת להטמעה רציפה של שינויים במסד נתונים או בטבלה. התצוגות המפורטות האלה פועלות כמו תצוגות מפורטות בטבלאות BigQuery, כולל היתרונות של רענון אוטומטי. תצוגות מהותיות לא יכולות לבצע שאילתות מיזוג בזמן ריצה, ולכן צריך להגדיר תצוגות מהותיות עם max_staleness מספיק כדי להימנע מעבודות מיזוג בזמן ריצה. מידע נוסף מופיע בקטע מגבלות של תצוגות חומריות על טבלאות עם סימון נתונים שהשתנו (CDC) פעיל.
טבלאות שמופעל בהן מטמון של מטא-נתונים ב-BigLake
תצוגות חומריות מעל טבלאות עם הפעלה של מטמון מטא-נתונים של BigLake יכולות להפנות לנתונים מובנים שמאוחסנים ב-Cloud Storage וב-Amazon Simple Storage Service (Amazon S3). התצוגות הממומשות האלה פועלות כמו תצוגות ממומשות בטבלאות אחסון שמנוהלות על ידי BigQuery, כולל היתרונות של רענון אוטומטי וכוונון חכם. יתרונות נוספים כוללים צבירה מראש, סינון מראש וצירוף מראש של נתונים שמאוחסנים מחוץ ל-BigQuery. תצוגות חומריות של טבלאות BigLake מאוחסנות באחסון מנוהל של BigQuery וכוללות את כל המאפיינים שלו.
כשיוצרים תצוגה מהותית על טבלת BigLake ב-Amazon S3, הנתונים בתצוגה המהותית לא זמינים לשאילתות איחוד עם נתונים ב-BigQuery. כדי להפוך נתונים מ-Amazon S3 בתצוגה מהותית לזמינים לצירופים, צריך ליצור רפליקה של התצוגה המהותית. אפשר ליצור העתקים של תצוגות מהותיות רק על בסיס תצוגות מהותיות מורשות.
מגבלות
תצוגות חומריות ב-BigQuery כפופות למגבלות הפונקציונליות והתפעול שמתוארות בקטעים הבאים.
הגבלות על SQL ועל תחביר
- דיאלקט. יש תמיכה רק בניב GoogleSQL.
- תחביר SQL. תצוגות חומריות משתמשות בתחביר SQL מוגבל ובקבוצה מוגבלת של פונקציות צבירה. מידע נוסף זמין במאמר בנושא תמיכה בשאילתות של תצוגות חומריות.
- משתני מערכת. תצוגות חומריות לא תומכות במשתני מערכת – לדוגמה, משתנה המערכת
@@session_id. - סוגי נתונים עם פרמטרים. תצוגות חומריות לא יכולות לקבל בירושה או להגדיר באופן מפורש סוגי נתונים עם פרמטרים, כמו
STRING(n), כי סוגי נתונים עם פרמטרים נתמכים רק בעמודות של מסד נתונים טבלאי ובמשתני סקריפט. - תיאורי העמודות. אפשר להגדיר תיאורים לתצוגות חומריות, אבל לא לעמודות ספציפיות בתצוגה החומרית.
- שינויים בשאילתות. אחרי שיוצרים תצוגה חומרית, אי אפשר לעדכן את השאילתה שלה.
- שינויים בנתונים. אי אפשר לעדכן או לשנות נתונים של תצוגה חומרית באופן ישיר באמצעות פעולות כמו
COPY,EXPORT,LOAD,WRITEאו באמצעות הצהרות של שפת מניפולציה של נתונים (DML). אופרטורים שדורשים הרבה משאבי CPU. אופרטורים שדורשים הרבה משאבי CPU (כמוUNPIVOTאו טרנספורמציות כבדות שלUNNEST) עלולים לגרום לכשלים ברענון בחיוב על פי דרישה. כדי לפתור את הבעיה, אפשר לעבור לתמחור לפי קיבולת, ליצור את הנתונים שעברו טרנספורמציה במסד הנתונים הטבלאי לפני שיוצרים את התצוגה או להשתמש בשאילתות מתוזמנות.
מגבלות על מסדי נתונים טבלאיים ועל קינון
- קינון. אי אפשר להטמיע תצוגות מהותיות בתוך תצוגות מהותיות אחרות.
- סוגי מקורות. תצוגות חומריות לא יכולות לשלוח שאילתות לטבלאות חיצוניות (חוץ מטבלאות BigLake), לטבלאות עם תווים כלליים, לתצוגות לוגיות1 או לתמונות מצב.
- התנהגות המחיקה. אם מוחקים מסד נתונים טבלאי בלי למחוק קודם את התצוגה החומרית, השאילתות והרענונים של התצוגה החומרית ייכשלו. אם יוצרים מחדש את מסד הנתונים הטבלאי, צריך ליצור מחדש גם את התצוגה החומרית.
- מערכי נתונים חיצוניים של Spanner. רק לתצוגות חומריות לא מצטברות יכולות להיות טבלאות בסיס של מערכי נתונים חיצוניים ב-Spanner. אם הרענון האחרון של תצוגה חומרית לא מצטברת התרחש מחוץ למרווח
max_staleness, השאילתה קוראת את טבלאות מערך הנתונים החיצוני הבסיסי של Spanner. פרטים נוספים זמינים במאמר יצירת תצוגות חומריות על מערכי נתונים חיצוניים של Spanner. - שמירה במטמון באמצעות Spanner. מערכת BigQuery לא שומרת במטמון תוצאות של שאילתות אם השאילתה מופעלת על תצוגות חומריות לא מצטברות שמפנות אל טבלאות של מערכי נתונים חיצוניים ב-Spanner.
היקף ומגבלות אזוריות
- הגבולות של הארגון. תצוגה חומרית חייבת להיות באותו פרויקט או באותו בלוק ארגוני כמו טבלאות הבסיס שלה.
- הגדרות של נתונים לא עדכניים. הערך של האפשרות
max_stalenessצריך להיות בין 30 דקות ל-3 ימים, כולל. - שאילתות משאבים. יכול להיות שיחולו הגבלות על הפניות לטבלת הבסיס והגבלות אחרות. מידע נוסף מופיע במאמר בנושא מכסות ומגבלות.
1התמיכה בהפניה לתצוגה לוגית היא בגרסת Preview. מידע נוסף מופיע בקטע הפניות לתצוגות לוגיות.
מגבלות של תצוגות חומריות על טבלאות עם CDC פעיל
לתצוגות חומריות עם טבלאות בסיס פעילות של לכידת נתוני שינוי (CDC) יש את המגבלות הבאות:
- אם לתצוגה חומרית יש טבלת בסיס עם לכידת נתונים של שינויים פעילה, אי אפשר להפנות לטבלה הזו בשאילתה שמפנה גם לתצוגה החומרית.
- כשיוצרים תצוגה חומרית מעל טבלה עם לכידת נתוני שינוי פעילה, התצוגה החומרית לא יכולה לבצע את עבודות המיזוג בזמן הריצה של טבלת ה-CDC הבסיסית.
מגדירים את הערך של
max_stalenessבתצוגה החומרית לפחות כפול מהערך שלmax_stalenessבמסד הנתונים הטבלאי. שאילתות שמופעלות על תצוגה מהותית נכשלות אם הגרסה הנוכחית של טבלת ה-CDC הבסיסית ישנה יותר מהתצוגה המהותיתmax_staleness. - אי אפשר להשתמש בהתאמה חכמה לתצוגות חומריות בטבלאות עם לכידת נתונים פעילה של שינויים.
מגבלות של תצוגות חומריות בטבלאות BigLake
לתצוגות חומריות של טבלאות BigLake יש את המגבלות הבאות:
- אי אפשר לבצע חלוקה למחיצות של התצוגה המהותית. טבלאות הבסיס יכולות להשתמש בחלוקה למחיצות של Apache Hive, אבל אי אפשר לחלק למחיצות את האחסון של תצוגות חומריות בטבלאות BigLake. כלומר, כל מחיקה במסד נתונים טבלאי גורמת לרענון מלא של התצוגה החומרית. פרטים נוספים זמינים במאמר בנושא עדכונים מצטברים.
- הערך של
--max_stalenessהאפשרות בתצוגה החומרית צריך להיות גדול מהערך של טבלת הבסיס של BigLake. - אי אפשר לבצע הצטרפות בין טבלאות מנוהלות ב-BigQuery לבין טבלאות BigLake בהגדרה אחת של תצוגה חומרית.
- מנוע הבינה העסקית (BI) של BigQuery (שירות ניתוח מהיר בזיכרון) לא תומך בהאצה של תצוגות חומריות בטבלאות BigLake.
תמחור של תצוגות מהותיות
העלויות של תצוגות מהותיות נובעות מהפעולות הבאות:
- שליחת שאילתות לתצוגות מהותיות.
- תחזוקה של תצוגות מהותיות, למשל כשמבצעים רענון של תצוגות מהותיות. העלות של רענון אוטומטי מחויבת בפרויקט שבו התצוגה נמצאת. העלות של רענון ידני מחויבת בפרויקט שבו מופעלת משימת הרענון הידני. מידע נוסף על שליטה בעלויות התחזוקה זמין במאמר תחזוקה של עבודות רענון.
- אחסון של טבלאות תצוגה מהותיות.
בטבלה הבאה מפורטים רכיבי התמחור של תצוגות חומריות:
| רכיב | תמחור על פי דרישה | תמחור מבוסס-קיבולת |
|---|---|---|
| שליחת שאילתות | מספר הבייטים שעברו עיבוד על ידי תצוגות מהותיות וכל החלקים הנדרשים של טבלאות הבסיס.1 | יחידות הקיבולת נצרכות בזמן השאילתה. |
| תחזוקה | בייטים שעובדו במהלך זמן הרענון. | יחידות הקיבולת (Slots) נצרכות במהלך זמן הרענון. |
| אחסון | בייטים שמאוחסנים בתצוגות מהותיות. | בייטים שמאוחסנים בתצוגות מהותיות. |
1במקרים שבהם הדבר אפשרי, BigQuery קורא רק את השינויים שבוצעו מאז הפעם האחרונה שבה התצוגה רועננה. מידע נוסף זמין במאמר בנושא עדכונים מצטברים.
פרטים על עלות האחסון
הדרך שבה BigQuery מאחסן ערכים מצטברים מסוימים משפיעה על אופן החישוב של גודל האחסון. במקרה של AVG, ARRAY_AGG ו-APPROX_COUNT_DISTINCT, ערכים מצטברים בתצוגה חומרית, הערך הסופי לא מאוחסן ישירות. במקום זאת, מערכת BigQuery מאחסנת באופן פנימי תצוגה חומרית כסקיצה ביניים, שמשמשת ליצירת הערך הסופי.
לדוגמה, נניח שיצרתם תצוגה מהותית באמצעות הפקודה הבאה:
CREATE MATERIALIZED VIEW project-id.my_dataset.my_mv_table AS
SELECT date, AVG(net_paid) AS avg_paid
FROM project-id.my_dataset.my_base_table
GROUP BY date
העמודה avg_paid מופיעה כ-NUMERIC או כ-FLOAT64, אבל
היא מאוחסנת באופן פנימי כ-BYTES, והתוכן שלה הוא סקיצה ביניים בפורמט קנייני. בחישוב גודל הנתונים, העמודה נחשבת כ-BYTES.
תהליך העבודה 'תחילת העבודה'
הגדרת תצוגות חומריות כוללת את תהליך העבודה הבא:
- עיצוב ואימות של שאילתה. מנסחים את שאילתת הצבירה לפי ההנחיות של GoogleSQL.
- יצירת תצוגה מהותית. מריצים את ההצהרה
CREATE MATERIALIZED VIEWבאמצעות Google Cloud המסוף, כלי שורת הפקודה של BigQuery או BigQuery API. - הרצה של כוונון חכם. מערכת BigQuery מפנה אוטומטית שאילתות שמופעלות על מסד נתונים טבלאי לשימוש בתצוגה החומרית – אין צורך לשכתב יעדים של שאילתות או אפליקציות.
כדי להתחיל ליצור, אפשר לעיין במאמר יצירת תצוגות מהותיות.
המאמרים הבאים
- סקירה כללית על תצוגות לוגיות ותצוגות מהותיות
- יצירת תצוגות מהותיות
- שימוש בתצוגות מהותיות
- ניהול תצוגות מהותיות
- פתרון בעיות בתצוגות חומריות