


驗證資料倉儲遷移作業
BigQuery 移轉服務的驗證服務可讓您確認從來源資料倉儲遷移的資料表,與 BigQuery 中的目標資料表相符。您可以比較結構定義和資料表資料,找出遷移期間的差異。
驗證服務用戶端會連線至來源資料庫,並將來源結構定義和資料列資料擷取至您控管的 Cloud Storage bucket。擷取完成後,驗證服務會比較 Cloud Storage bucket 中擷取的結構定義和資料,以及遷移的 BigQuery 資料表。
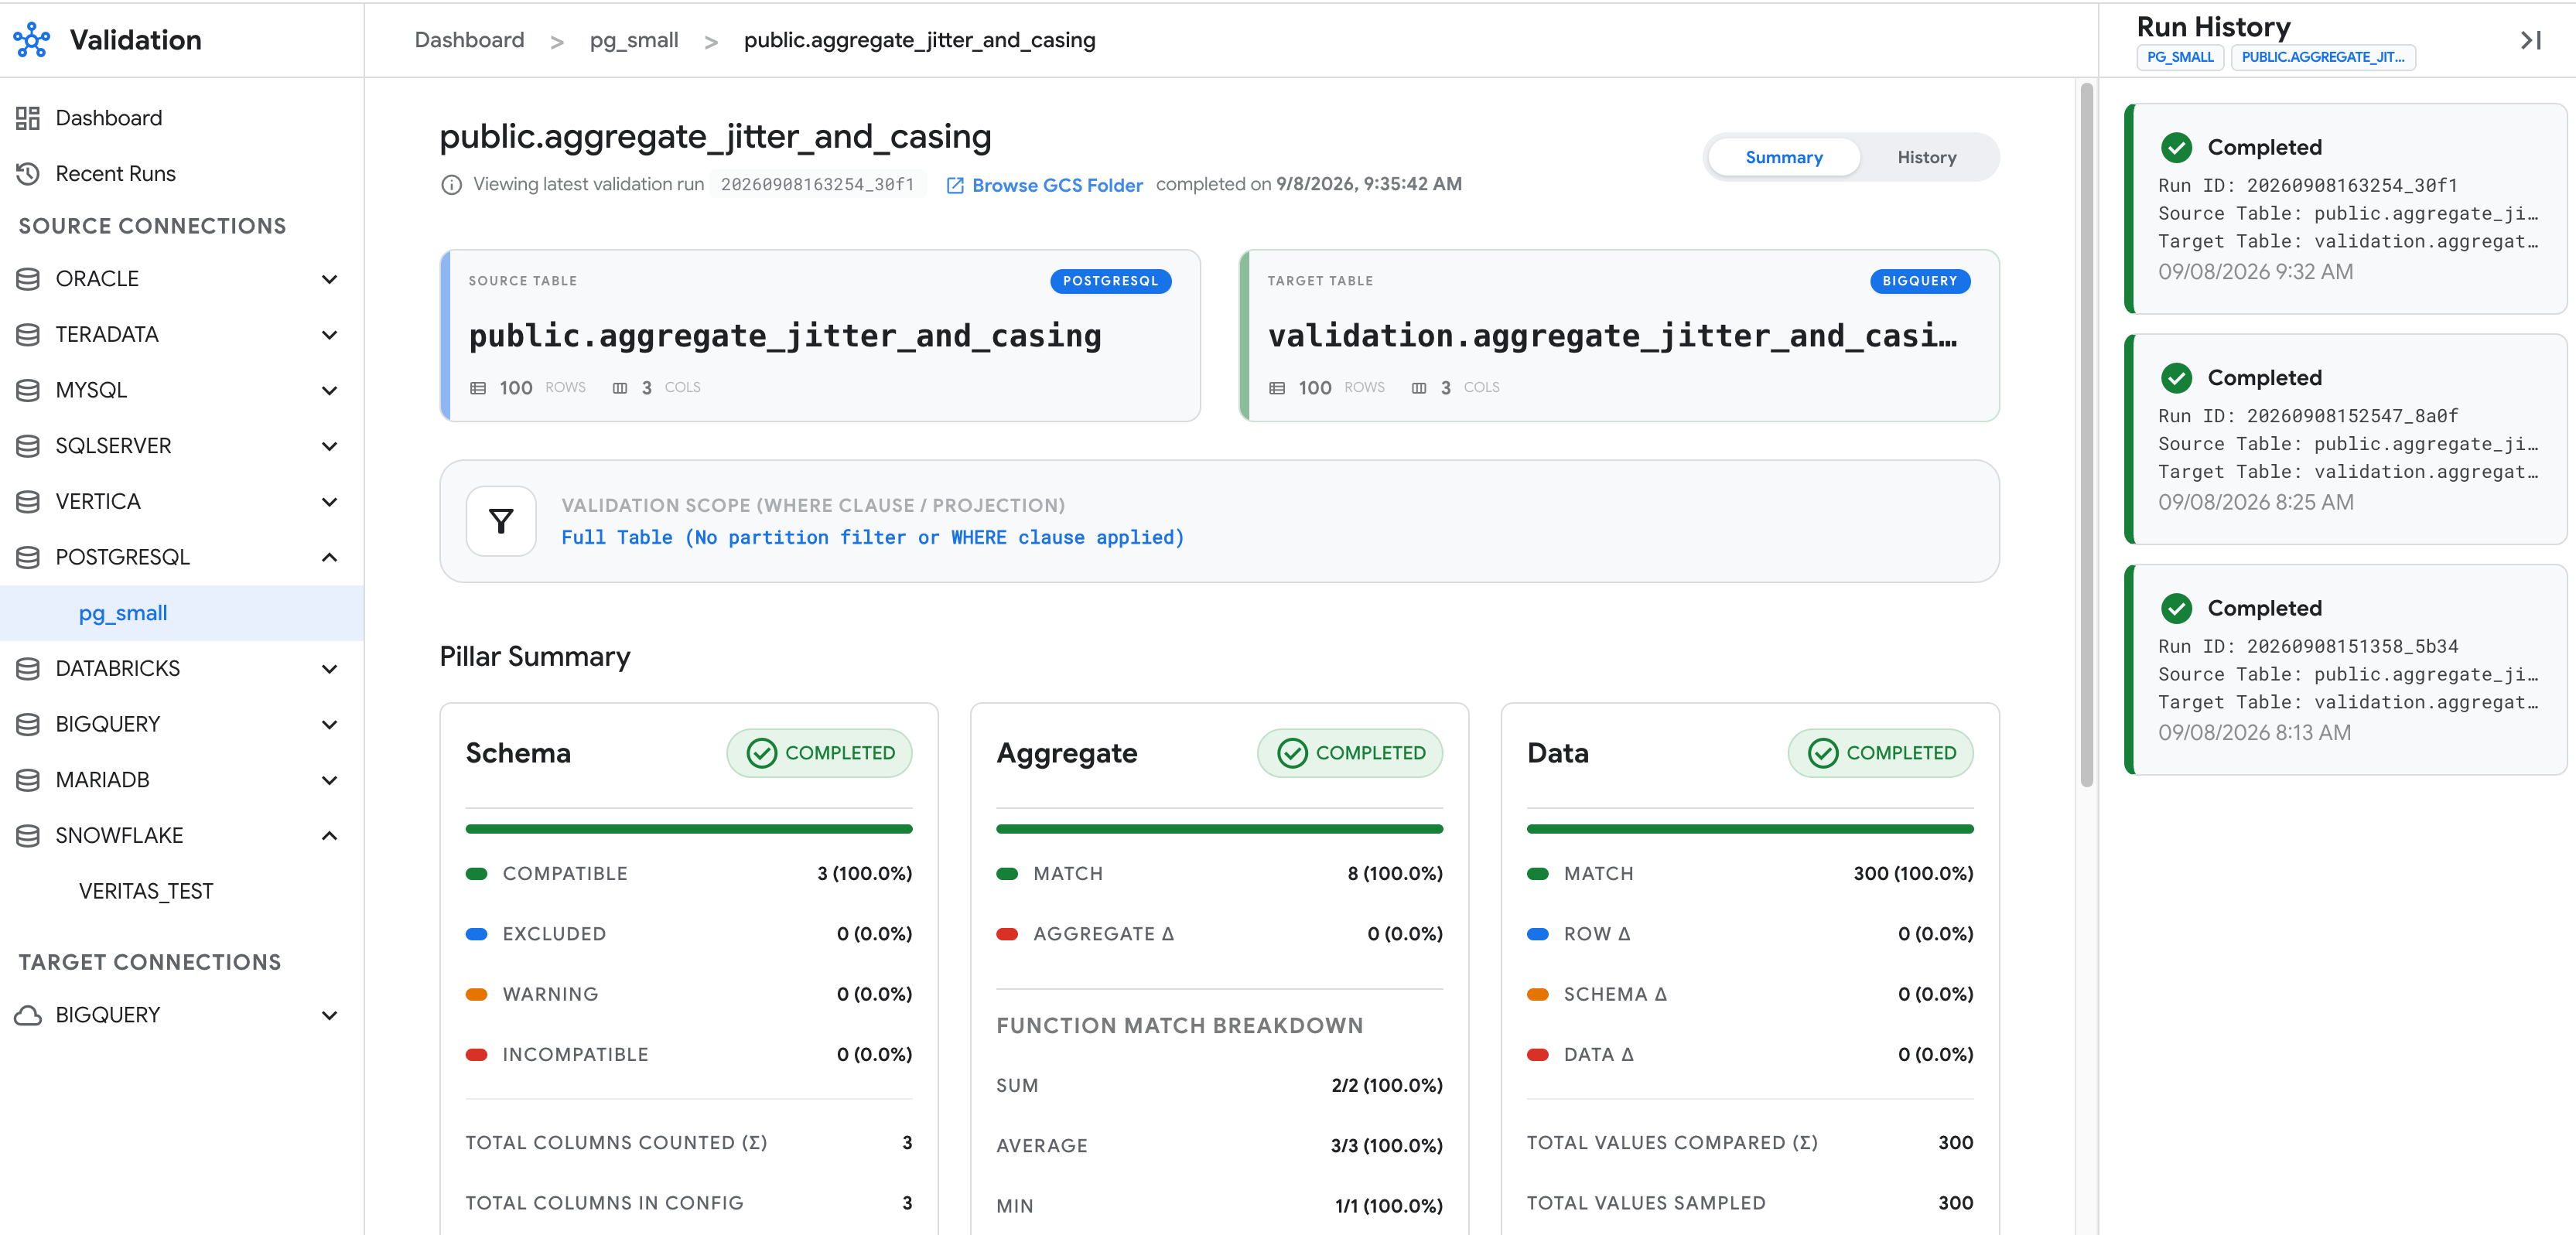
驗證工作流程會根據下列三個驗證要素,比較來源資料表和目標 BigQuery 資料表:
- 結構定義驗證 (
--schema):比較來源資料表和目標 BigQuery 資料表的資料欄名稱、資料類型和類型相容性。 - 匯總驗證 (
--aggregate):計算並比較整個資料表的資料表層級和資料欄層級匯總指標,例如資料列計數、SUM、AVG、MIN、MAX、布林值分布和字串長度。 - 資料驗證 (
--data):使用詳盡的全資料表掃描 (BRUTE_FORCE) 或隨機鍵式取樣 (SAMPLE),逐列比較資料,偵測缺少的資料列和儲存格層級值偏移。
支援的地區
驗證服務僅在特定地區提供。詳情請參閱「BigQuery 移轉服務位置」。
資料處理和安全性考量
驗證服務會根據您執行的驗證要素,擷取及暫存不同的資料:
- 結構定義驗證 (
--schema):只會將資料欄名稱、資料類型和資料表統計資料上傳至source_query_result.json檔案,不會擷取儲存格值。 - 匯總驗證 (
--aggregate):將計算出的匯總指標上傳至source_aggregates.parquet檔案,包括所含資料欄的實際MIN和MAX儲存格值。 - 資料驗證 (
--data):從取樣資料列中擷取原始、未遮罩的儲存格值,或在使用BRUTE_FORCE策略時從所有資料列中擷取。並以 Apache Parquet 或 CSV 格式,將這些值上傳至 Cloud Storage 暫存 bucket,然後載入 BigQuery 的validation_results資料集。
為保護資料並確保驗證環境安全,請進行下列設定:
- 排除機密資料欄:將機密資料欄新增至
columnSettings.exclude欄位,即可在來源擷取查詢、目標比較和驗證報表中省略這些資料欄。 - 盡量減少本地資料儲存:在
settings.yaml檔案中設定googleCloudStorage.gcsPath欄位,直接將取樣資料列串流至 Cloud Storage,而不寫入本機磁碟。在共用主機上,請在每次執行後刪除本機--output-dir目前使用的目錄,以移除本機中繼資料、匯總和記錄檔。 - 加密暫存資料和結果:執行驗證前,請在 Cloud Storage 暫存 bucket 和 BigQuery 結果資料集 (預設為
validation_results,或results.dataset欄位中指定的資料集),透過 Cloud Key Management Service 設定客戶自行管理的加密金鑰 (CMEK)。 - 限制設定存取權:將驗證設定檔儲存在需要程式碼審查的版本控管存放區,或只有信任的使用者具備
storage.objects.create權限的 Cloud Storage bucket。 - 強制執行最小權限存取權:僅針對要驗證的目標資料集或資料表,授予工作流程建立者
roles/bigquery.dataViewer角色,而非針對專案。請按照「設定來源資料庫權限」一節的說明,使用唯讀來源資料庫使用者。
事前準備
在 Google Cloud 控制台的專案選取器頁面,選取或建立包含目標 BigQuery 資料集的 Google Cloud 專案。
確認 Google Cloud 專案已啟用計費功能。
啟用 BigQuery、BigQuery Migration Service、Cloud Storage 和 Secret Manager API (如果將資料庫密碼儲存在 Secret Manager)。
在目標 BigQuery 資料集所在位置,建立或選取 Cloud Storage bucket,用於暫存擷取的中繼資料和資料樣本。詳情請參閱「建立 bucket」。
必要角色和權限
驗證執行作業包含三個部分,每個部分可由不同的主體執行:
- 資料收集:驗證用戶端會讀取來源資料庫,並將中繼資料、匯總資料和取樣資料列上傳至 Cloud Storage 暫存 bucket。不會呼叫 BigQuery。
- 驗證:BigQuery 遷移服務驗證工作流程會比較暫存資料與目標資料表。工作流程會使用建立者的憑證執行,無論建立者是驗證用戶端、
gcloud,還是 Google Cloud 控制台。 - 查看結果:讀取結果資料集和 Cloud Storage 報表。
「generate-config」不需要任何 Google Cloud 權限。
資料收集
如要取得收集來源資料所需的權限,請要求管理員授予您下列 IAM 角色:
- 暫存 bucket 的 Storage 物件建立者 (
roles/storage.objectCreator) - 暫存 bucket 的 Storage 物件檢視者 (
roles/storage.objectViewer) -
從 Cloud Storage 讀取設定檔:設定 bucket 的 Storage 物件檢視者 (
roles/storage.objectViewer) -
從 Secret Manager 讀取資料庫密碼:密鑰的 Secret Manager 密鑰存取者 (
roles/secretmanager.secretAccessor)
如要進一步瞭解如何授予角色,請參閱「管理專案、資料夾和組織的存取權」。
這些預先定義的角色具備收集來源資料所需的權限。如要查看確切的必要權限,請展開「Required permissions」(必要權限) 部分:
所需權限
必須具備下列權限,才能收集來源資料:
-
storage.objects.create暫存 bucket -
暫存 bucket 上的
storage.objects.get -
從 Cloud Storage 讀取設定檔:
-
storage.objects.get設定 bucket -
storage.objects.list設定值區
-
-
從 Secret Manager 讀取資料庫密碼:
secretmanager.versions.access密鑰
使用 --extract-only 時,資料收集作業不需要任何 BigQuery 或 BigQuery Migration Service 權限。如果沒有這個角色,用戶端也會建立驗證工作流程,並需要驗證角色。
驗證
如要取得建立及執行驗證工作流程所需的權限,請要求管理員授予您下列 IAM 角色:
- 專案的 MigrationWorkflow 編輯者 (
roles/bigquerymigration.editor) - 專案的 BigQuery 工作使用者 (
roles/bigquery.jobUser) - 每個目標資料集的 BigQuery 資料檢視者 (
roles/bigquery.dataViewer) - 結果資料集的 BigQuery 資料編輯者 (
roles/bigquery.dataEditor) - 暫存 bucket 的 Storage 物件使用者 (
roles/storage.objectUser) -
如果結果資料集不存在:專案的 BigQuery 使用者 (
roles/bigquery.user)
這些預先定義的角色具備建立及執行驗證工作流程所需的權限。如要查看確切的必要權限,請展開「Required permissions」(必要權限) 部分:
所需權限
您必須具備下列權限,才能建立及執行驗證工作流程:
-
專案的
bigquerymigration.workflows.create -
專案的
bigquerymigration.workflows.get -
專案的
bigquery.jobs.create -
bigquery.tables.get每個目標資料集 -
每個目標資料集上的
bigquery.tables.getData -
bigquery.datasets.get結果資料集 -
bigquery.tables.get結果資料集 -
bigquery.tables.create結果資料集 -
bigquery.tables.update結果資料集 -
bigquery.tables.updateData結果資料集 -
bigquery.tables.getData結果資料集 -
storage.objects.get暫存 bucket -
storage.objects.create暫存 bucket -
storage.objects.delete暫存 bucket -
如果結果資料集不存在:
bigquery.datasets.create專案
roles/bigquerymigration.editor 包含許多驗證作業不會使用的權限。為落實最小權限原則,請授予僅具備 bigquerymigration.workflows.create 和 bigquerymigration.workflows.get 的自訂角色。
驗證作業只會讀取目標資料表,且只會寫入結果資料集。建議您事先建立結果資料集,這樣一來,主體就不需要具備在專案中建立資料集的權限。
查看結果
如要取得查看驗證結果所需的權限,請要求管理員授予您下列 IAM 角色:
- 結果資料集所在專案的 BigQuery 工作使用者 (
roles/bigquery.jobUser) - 結果資料集的 BigQuery 資料檢視者 (
roles/bigquery.dataViewer) -
讀取 Cloud Storage 中的報表:預備 bucket 的儲存空間物件檢視者 (
roles/storage.objectViewer) -
在 Google Cloud 控制台列出及查看驗證工作流程:專案的遷移工作流程檢視者 (
roles/bigquerymigration.viewer)
這些預先定義的角色具備查看驗證結果所需的權限。如要查看確切的必要權限,請展開「Required permissions」(必要權限) 部分:
所需權限
必須具備下列權限,才能查看驗證結果:
-
專案的
bigquery.jobs.create -
bigquery.tables.get結果資料集 -
bigquery.tables.getData結果資料集 -
在 Cloud Storage 中讀取報表:
-
暫存值區上的
storage.objects.get -
暫存值區上的
storage.objects.list
-
暫存值區上的
-
在 Google Cloud 控制台中列出及查看驗證工作流程:
-
專案的
bigquerymigration.workflows.list -
專案的
bigquerymigration.workflows.get
-
專案的
設定來源資料庫權限
您必須設定來源資料庫使用者的唯讀存取權,並具備下列權限:
- 對每個要驗證的來源資料表,具備
SELECT權限。 - 用於探索結構定義和主鍵的系統目錄檢視表讀取權限 (例如 Oracle 上的
information_schema資料表、ALL_CONSTRAINTS和ALL_TAB_COLUMNS,或 Amazon Redshift 上的SVV_COLUMNS和pg_attribute)。
請勿授予這個使用者寫入、DDL 或管理員權限。驗證用戶端會以該使用者的身分,執行驗證設定中的 SQL。詳情請參閱「資料處理和安全性考量」。
限制
驗證服務有下列限制:
- BigQuery 是唯一支援的目標資料庫。不支援在兩個非 BigQuery 資料庫之間進行驗證,或使用 BigQuery 做為驗證來源。
- 目標 BigQuery 資料集、結果資料集 (預設為
validation_results,或在settings.yaml的results下設定的自訂資料集)、Cloud Storage 暫存 bucket 和驗證工作流程位置 (BQMS_VALIDATION_LOCATION) 必須位於相同位置。驗證服務建立結果資料集時,會預設將資料集位置設為 Cloud Storage 暫存 bucket 和目標 BigQuery 資料集使用的區域,或明確設定的results.location。 - 支援的資料類型因來源而異。系統會排除不支援類型的資料欄,不進行驗證。詳情請參閱「支援的資料倉儲」。
- 在 BigQuery 中建立的每次執行比較表會根據
settings.yaml中的resultTtlHours自動到期,預設為168.0小時或七天。請勿在validation_results資料集上設定資料集層級的預設資料表到期時間,因為這樣做也會導致長期稽核資料表 (例如run_history、run_metrics和column_history) 到期。 - BigQuery 資料表名稱區分大小寫。
generate-config從dwh-migration-dumper工具中繼資料封存檔建立設定時,如果沒有翻譯tables.yaml對應,目標資料表名稱會保留來源 ID 的大小寫。例如,Oracle 或 Snowflake 的大寫資料表名稱。確認targetTable.name與 BigQuery 資料表的大小寫完全一致。
支援的資料倉儲
驗證服務支援下列來源資料庫。每個部分都會說明安裝時隨附的 JDBC 驅動程式、是否能從 dwh-migration-dumper 工具中繼資料封存檔自動產生資料表設定、這個資料庫的大型資料表支援哪些分區類型,以及支援哪些資料類型驗證。
- Teradata
- Snowflake
- Amazon Redshift
- Databricks
- Apache Hive
- SQL Server
- MariaDB
- MySQL
- Oracle
- PostgreSQL
系統也支援 VARCHAR(255) 或 DECIMAL(10,2) 等支援資料類型的參數化變化版本。
驗證服務會先載入 drivers/ 目錄中的所有 JAR 檔案,再載入自動下載的驅動程式,因此您也可以使用 drivers/ 覆寫隨附的驅動程式版本。
如果自動產生驗證設定檔,系統會自動將資料類型不受支援的資料欄新增至 columnSettings.exclude。如果是手動設定,則必須在 columnSettings.exclude 中明確排除。
對於大多數支援的來源資料庫,驗證工具會在首次使用時,自動從 Maven Central 下載必要的 JDBC 驅動程式、驗證其 SHA-256 核對和,並在本機快取至 ~/.cache/google-cloud-bqms/drivers/ (或 $XDG_CACHE_HOME/google-cloud-bqms/drivers/)。如果資料倉儲使用專屬驅動程式 (例如 Teradata),或是在離線或實體隔離環境中執行,請按照下列步驟操作:
- 將必要的驅動程式 JAR 檔案放在
./drivers/、<sdk_root>/platform/bqms/drivers/或BQMS_DRIVER_DIR環境變數指定的目錄中。放置在這些本機目錄中的任何驅動程式 JAR,優先順序高於自動 Maven Central 下載。 - 如要在實體隔離環境中完全停用自動網路下載功能,請設定
BQMS_AUTO_DOWNLOAD_DRIVERS=false,或將BQMS_MAVEN_MIRROR設為指向內部 Maven 存放區鏡像。
如要瞭解驗證服務支援的各項資料來源,請選取下列其中一個選項:
Teradata
Teradata 遷移作業支援下列驗證:
dialect值:teradata- JDBC 驅動程式:由使用者提供。從 Teradata 下載 Teradata JDBC 驅動程式 JAR (例如
terajdbc4.jar或terajdbc.jar),並複製到drivers/目錄或BQMS_DRIVER_DIR指定的目錄。 - 自動產生設定:支援
dwh-migration-dumper工具中繼資料封存檔 (--connector teradata)。 - 分區擷取:
INTEGER_RANGE、PHYSICAL
| 類別 | 資料類型 |
|---|---|
| 數字 | BYTEINT、SMALLINT、INTEGER、INT、BIGINT、DECIMAL、DEC、NUMERIC、NUMBER、FLOAT、REAL、DOUBLE PRECISION |
| 字串 | CHAR、CHARACTER、VARCHAR、CHARACTER VARYING、LONG VARCHAR |
| 日期與時間 | DATE、TIME、TIME WITH TIME ZONE、TIMESTAMP、TIMESTAMP WITH TIME ZONE |
驗證從 Teradata 遷移的作業時,請考量下列事項:
- 如果資料表沒有明確的主鍵,系統會從不重複的主索引 (
UPI) 或不重複的次要索引 (USI) 找出比較鍵。非不重複的主索引 (NUPI) 不會做為比較鍵。 - 支援固定精確度的
NUMBER(P,S),但不支援不受限制的NUMBER(無精確度)。generate-config會自動排除不受限制的NUMBER、CLOB、BLOB、BYTE、VARBYTE、INTERVAL、PERIOD、JSON和XML資料欄 (如果是手動設定,則必須列在columnSettings.exclude中)。 - 固定寬度的
CHAR欄會自動裁剪。系統支援LATIN和UNICODE字元集,以及CASESPECIFIC/NOT CASESPECIFIC屬性。 TIME WITH TIME ZONE和TIMESTAMP WITH TIME ZONE值會先正規化為世界標準時間 (AT 0),然後再進行比較。
Snowflake
Snowflake 遷移作業支援下列驗證:
dialect值:snowflake- JDBC 驅動程式:首次使用時自動下載 (
net.snowflake:snowflake-jdbc),或由使用者在離線環境的drivers/目錄中提供。 - 自動產生設定:支援
dwh-migration-dumper工具中繼資料封存檔 (--connector snowflake)。 - 分區擷取:
INTEGER_RANGE、DATE_RANGE
驗證服務支援下列 Snowflake 遷移作業的資料類型:
| 類別 | 資料類型 |
|---|---|
| 數字 | NUMBER、DECIMAL、NUMERIC、FLOAT、REAL、DOUBLE |
| 字串 | CHAR、VARCHAR、STRING、TEXT |
| 日期與時間 | DATE、TIME、TIMESTAMP_NTZ、TIMESTAMP_LTZ、TIMESTAMP_TZ |
| 布林值 | BOOLEAN |
驗證從 Snowflake 遷移的資料時,請考量下列事項:
- 系統會自動修剪固定寬度的
CHAR欄。 - 如果您使用 BigQuery 資料移轉服務複製資料,請設定
tolerances.timestamp: 0.001,以吸收毫秒以下的四捨五入。
Amazon Redshift
Amazon Redshift 遷移作業支援下列驗證:
dialect值:redshift- JDBC 驅動程式:首次使用時自動下載 (
com.amazon.redshift:redshift-jdbc42),或由使用者在離線環境的drivers/目錄中提供。 - 自動產生設定:支援
dwh-migration-dumper工具中繼資料封存檔 (--connector redshift)。 - 分區擷取:
INTEGER_RANGE、PHYSICAL
驗證服務支援下列 Amazon Redshift 遷移作業資料類型:
| 類別 | 資料類型 |
|---|---|
| 數字 | SMALLINT,INTEGER,BIGINT,DECIMAL,NUMERIC,REAL,DOUBLE PRECISION |
| 字串 | CHAR、VARCHAR、TEXT |
| 日期與時間 | DATE、TIME、TIMETZ、TIMESTAMP、TIMESTAMPTZ |
| 布林值 | BOOLEAN |
| 半結構化 | SUPER |
驗證從 Amazon Redshift 遷移的作業時,請考量下列事項:
- 結構定義檢查會使用
SVV_COLUMNS,因此支援延遲繫結檢視表。 - 如果資料表沒有主鍵,比較鍵會自動改用單一資料欄
DISTKEY或SORTKEY。 - 不支援
GEOMETRY欄。
Databricks
Databricks 遷移作業支援下列驗證:
dialect值:databricks- JDBC 驅動程式:首次使用時自動下載 (
com.databricks:databricks-jdbc),或由使用者在離線環境的drivers/目錄中提供。 - 自動產生設定:不支援。建立手動資料表設定檔。
- 分區擷取:
INTEGER_RANGE
驗證服務支援下列 Databricks 遷移作業資料類型:
| 類別 | 資料類型 |
|---|---|
| 數字 | BYTE、TINYINT、SHORT、SMALLINT、INT、INTEGER、LONG、BIGINT、FLOAT、DOUBLE、DECIMAL、NUMERIC |
| 字串 | CHAR、VARCHAR、STRING |
| 日期與時間 | DATE、TIMESTAMP |
| 布林值 | BOOLEAN |
| 二進位檔 | BINARY |
| 複雜 | ARRAY、MAP、STRUCT |
驗證從 Databricks 遷移的資料時,請考量下列事項:
- 使用個人存取權杖進行驗證:設定
user: token,並透過passwordSecret提供權杖。 - 結構定義檢查是以查詢為基礎 (
SELECT * ... WHERE 1=0),因此 Unity Catalog 和 Hive metastore 工作區都支援。
Apache Hive
Apache Hive 遷移作業支援下列驗證:
dialect值:hive- JDBC 驅動程式:首次使用時自動下載 (
org.apache.hive:hive-jdbc獨立 JAR),或由使用者在離線環境的drivers/目錄中提供。 - 自動產生設定:支援
dwh-migration-dumper工具中繼資料封存檔 (--connector hiveql)。 - 分區擷取:
INTEGER_RANGE
驗證服務支援下列 Hive 遷移資料類型:
| 類別 | 資料類型 |
|---|---|
| 數字 | TINYINT、SMALLINT、INT、INTEGER、BIGINT、FLOAT、DOUBLE、DECIMAL、NUMERIC |
| 字串 | CHAR、VARCHAR、STRING |
| 日期與時間 | DATE、TIMESTAMP |
| 布林值 | BOOLEAN |
| 二進位檔 | BINARY |
| 複雜 | ARRAY、MAP、STRUCT |
驗證從 Hive 遷移的作業時,請考量下列事項:
- 結構定義檢查是以查詢為基礎 (
SELECT * ... WHERE 1=0)。 - Hive 資料表很少定義主鍵。如果資料表沒有比較鍵,系統會自動對資料欄使用全列雜湊匯總。
SQL Server
SQL Server 遷移作業支援下列驗證:
dialect值:sqlserver- JDBC 驅動程式:首次使用時自動下載 (
com.microsoft.sqlserver:mssql-jdbc),或由使用者在離線環境的drivers/目錄中提供。 - 自動產生設定:支援
dwh-migration-dumper工具中繼資料封存檔 (--connector sqlserver)。 - 分區擷取:
INTEGER_RANGE
驗證服務支援下列 SQL Server 遷移資料類型:
| 類別 | 資料類型 |
|---|---|
| 數字 | INT、BIGINT、DECIMAL、NUMERIC、FLOAT、REAL |
| 字串 | CHAR、VARCHAR、TEXT |
| 日期與時間 | DATE、DATETIME、TIMESTAMP |
| 布林值 | BIT |
驗證從 SQL Server 遷移的作業時,請考量下列事項:
- 預設 JDBC 網址會設定
encrypt=true;trustServerCertificate=true;。如需嚴格的 TLS 憑證驗證,請使用url連線金鑰覆寫。
MariaDB
MariaDB 遷移作業支援下列驗證:
dialect值:mariadb- JDBC 驅動程式:首次使用時自動下載 (
org.mariadb.jdbc:mariadb-java-client),或由使用者在離線環境的drivers/目錄中提供。 - 自動產生設定:建立手動資料表設定檔。
- 分區擷取:
INTEGER_RANGE
驗證服務支援下列 MariaDB 遷移作業資料類型:
| 類別 | 資料類型 |
|---|---|
| 數字 | TINYINT、SMALLINT、MEDIUMINT、INT、INTEGER、BIGINT、FLOAT、DOUBLE、DECIMAL、NUMERIC |
| 字串 | CHAR、VARCHAR、TINYTEXT、TEXT、MEDIUMTEXT、LONGTEXT、ENUM、SET |
| 日期與時間 | DATE、TIME、DATETIME、TIMESTAMP、YEAR |
| 二進位和大型物件 | BINARY、VARBINARY、TINYBLOB、BLOB、MEDIUMBLOB、LONGBLOB |
MySQL
MySQL 遷移作業支援下列驗證:
dialect值:mysql- JDBC 驅動程式:首次使用時自動下載 (
com.mysql:mysql-connector-j),或由使用者在離線環境的drivers/目錄中提供。 - 自動產生設定:建立手動資料表設定檔。
- 分區擷取:
INTEGER_RANGE
驗證服務支援下列 MySQL 遷移資料類型:
| 類別 | 資料類型 |
|---|---|
| 數字 | INT、BIGINT、DECIMAL、FLOAT、DOUBLE |
| 字串 | CHAR、VARCHAR、TEXT |
| 日期與時間 | DATE、TIME、DATETIME、TIMESTAMP |
| 布林值 | BOOLEAN |
Oracle
Oracle 遷移作業支援的驗證項目如下:
dialect值:oracle- JDBC 驅動程式:首次使用時自動下載 (
com.oracle.database.jdbc:ojdbc11),或由使用者在離線環境的drivers/目錄中提供。 - 自動產生設定:支援
dwh-migration-dumper工具中繼資料封存檔 (--connector oracle)。 - 分區擷取:
INTEGER_RANGE、PHYSICAL
驗證服務支援下列 Oracle 遷移作業資料類型:
| 類別 | 資料類型 |
|---|---|
| 數字 | NUMBER、NUMERIC、INTEGER、FLOAT、DOUBLE |
| 字串 | CHAR、NCHAR、VARCHAR、VARCHAR2、NVARCHAR2 |
| 日期與時間 | DATE、TIMESTAMP、TIMESTAMP WITH TIME ZONE |
| 二進位和大型物件 | RAW、BINARY、BLOB、CLOB、NCLOB |
驗證從 Oracle 遷移的資料時,請考量下列事項:
DATE資料欄在 Oracle 中包含時間元件。驗證工具會以天為單位 (YYYY-MM-DD) 擷取 OracleDATE資料欄,因此會截斷時間差異。
PostgreSQL
PostgreSQL 遷移作業支援下列驗證:
dialect值:postgresql- JDBC 驅動程式:首次使用時自動下載 (
org.postgresql:postgresql),或由使用者在離線環境的drivers/目錄中提供。 - 自動產生設定:支援
dwh-migration-dumper工具中繼資料封存檔 (--connector postgres)。 - 分區擷取:
INTEGER_RANGE、DATE_RANGE、PHYSICAL
PostgreSQL 遷移作業的驗證服務支援下列資料類型:
| 類別 | 資料類型 |
|---|---|
| 數字 | SMALLINT、INTEGER、BIGINT、NUMERIC、DOUBLE PRECISION |
| 字串 | CHAR、CHARACTER、VARCHAR、CHARACTER VARYING、TEXT |
| 日期與時間 | DATE、TIME、TIMESTAMP、TIMESTAMP WITHOUT TIME ZONE、TIMESTAMP WITH TIME ZONE、TIMESTAMPTZ |
| 布林值 | BOOLEAN |
| 其他 | UUID |
驗證從 PostgreSQL 遷移的作業時,請考量下列事項:
- 如果
BIGINT值大於 253,AVG()可能會顯示些微的精確度差異;SUM和COUNT則會保持精確。
設定驗證設定目錄和檔案
驗證服務會從名為 validation_config/ 的模組化設定目錄讀取資料,其中包含下列檔案:
- 資料庫連線檔案:定義
source資料倉儲連線設定檔和targetBigQuery 連線設定檔。 - 暫存和結果設定檔:定義 Cloud Storage 暫存路徑 (
googleCloudStorage)、BigQuery 結果資料集設定 (results)、每次執行的比較資料表到期時間 (resultTtlHours),以及選用的全域預設值 (tolerances、aggregate、labels)。 - 資料表驗證設定檔:包含各資料表的對應 (
sourceTable和targetTable)、比較鍵 (comparisonKeys)、驗證策略 (strategy)、分區擷取設定 (partitioning) 和資料欄設定 (columnSettings)。
以下各節說明如何設定驗證設定目錄,以及如何建立遷移驗證所需的設定檔。
建立驗證設定目錄
建立名為 validation_config/ 的驗證設定目錄,用於儲存驗證設定檔。您可以將這個目錄儲存在執行驗證服務的機器上,或儲存在 Cloud Storage bucket 中,讓團隊在不同執行作業中共用一個設定。
建立資料庫連線檔案
在驗證設定目錄中,建立名為 connections.yaml 的檔案,並設定連線至來源資料庫和目標 BigQuery 資料庫的資訊。
建立資料庫連線檔案時,請考量各個資料倉儲來源的特定功能和需求。如要進一步瞭解各個資料來源,請參閱「支援的資料倉儲」。
在連線設定檔中指定 passwordSecret 時,驗證服務會使用本機應用程式預設憑證 (ADC),從用戶端機器上的 Secret Manager 擷取密鑰版本,並將解析後的密碼直接傳遞至本機 JDBC 驅動程式。來源資料庫不需要 Google Cloud的網路存取權或 IAM 存取權,因此passwordSecret適用於地端部署資料庫,以及託管於其他雲端的資料庫,例如 Amazon Redshift 或 Snowflake。或者,您也可以省略 passwordSecret,並在執行驗證服務的機器上設定 BQMS_VALIDATION_SOURCE_PASSWORD 環境變數。
如要為資料倉儲建立資料庫連線檔案,請選取下列其中一個選項:
Teradata
如要驗證 Teradata 遷移作業,請在資料庫連線檔案中設定下列資訊:
connections:
source:
  dialect: teradata
  host: SOURCE_HOST
  port: 1025
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
更改下列內容:
SOURCE_HOST: Teradata 系統的主機名稱或 IP 位址。SOURCE_DATABASE:必要的 Teradata 資料庫名稱。SOURCE_USER:Teradata 使用者名稱。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密碼的專案 ID 和密鑰 ID,或設為BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目標 Google Cloud專案 ID。TARGET_DATASET:目標 BigQuery 資料集名稱。
Snowflake
如要驗證 Snowflake 遷移作業,請使用下列資訊設定資料庫連線檔案:
connections:
source:
  dialect: snowflake
  account: SNOWFLAKE_ACCOUNT
  warehouse: SNOWFLAKE_WAREHOUSE
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  role: SNOWFLAKE_ROLE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
更改下列內容:
SNOWFLAKE_ACCOUNT:Snowflake 帳戶 ID (例如myorg-myaccount)。SNOWFLAKE_WAREHOUSE:用於執行擷取查詢的虛擬倉儲。SOURCE_DATABASE:必要的 Snowflake 資料庫名稱。SOURCE_SCHEMA:必要的 Snowflake 結構定義名稱。SNOWFLAKE_ROLE:選用的 Snowflake 角色。SOURCE_USER:Snowflake 使用者名稱。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密碼的專案 ID 和密鑰 ID,或設為BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目標 Google Cloud專案 ID。TARGET_DATASET:目標 BigQuery 資料集名稱。
Amazon Redshift
如要驗證 Amazon Redshift 遷移作業,請在資料庫連線檔案中設定下列資訊:
connections:
source:
  dialect: redshift
  host: SOURCE_HOST
  port: 5439
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
更改下列內容:
SOURCE_HOST:Amazon Redshift 叢集端點主機名稱。SOURCE_DATABASE:必要的 Amazon Redshift 資料庫名稱。SOURCE_SCHEMA:預設結構定義名稱 (如省略,則預設為public)。SOURCE_USER:資料庫使用者名稱。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密碼的專案 ID 和密鑰 ID,或設為BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目標 Google Cloud專案 ID。TARGET_DATASET:目標 BigQuery 資料集名稱。
Databricks
如要驗證 Databricks 遷移作業,請在資料庫連線檔案中設定下列資訊:
connections:
source:
  dialect: databricks
  host: DATABRICKS_HOST
  port: 443
  httpPath: HTTP_PATH
  catalog: CATALOG_NAME
  schema: SCHEMA_NAME
  user: token
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
更改下列內容:
DATABRICKS_HOST:Databricks SQL 倉儲或叢集的伺服器主機名稱。HTTP_PATH:Databricks SQL 倉儲的 HTTP 路徑 (例如sql/protocolv1/o/1234567890/0123-456789-abcdef)。CATALOG_NAME:必要的 Unity Catalog 名稱 (或hive_metastore)。SCHEMA_NAME:必要的結構定義名稱。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含 Databricks 個人存取權杖 (PAT) 的專案 ID 和 Secret ID,或省略passwordSecret並設定BQMS_VALIDATION_SOURCE_PASSWORD。搭配使用user: token和passwordSecret,可確保權杖不會寫入暫存中繼資料檔案。TARGET_PROJECT_ID:目標 Google Cloud專案 ID。TARGET_DATASET:目標 BigQuery 資料集名稱。
Apache Hive
如要驗證 Apache Hive 遷移作業,請在資料庫連線檔案中設定下列資訊:
connections:
source:
  dialect: hive
  host: SOURCE_HOST
  port: 10000
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
更改下列內容:
SOURCE_HOST:SOURCE_HOST:HiveServer2 主機名稱或 IP 位址。SOURCE_DATABASE:必要的 Hive 資料庫名稱 (例如default)。SOURCE_USER:Hive 使用者名稱。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密碼的專案 ID 和密鑰 ID,或設為BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目標 Google Cloud專案 ID。TARGET_DATASET:目標 BigQuery 資料集名稱。
SQL Server
如要驗證 SQL Server 遷移作業,請在資料庫連線檔案中設定下列資訊:
connections:
source:
  dialect: sqlserver
  host: SOURCE_HOST
  port: 1433
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
更改下列內容:
SOURCE_HOST:SQL Server 執行個體的主機名稱或 IP 位址 (可視需要為具名執行個體指定instanceName)。SOURCE_DATABASE:必要的資料庫名稱。SOURCE_SCHEMA:預設結構定義名稱 (如省略,則預設為dbo)。SOURCE_USER:資料庫使用者名稱。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密碼的專案 ID 和密鑰 ID,或設為BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目標 Google Cloud專案 ID。TARGET_DATASET:目標 BigQuery 資料集名稱。
MariaDB
如要驗證 MariaDB 遷移作業,請使用下列資訊設定資料庫連線檔案:
connections:
source:
  dialect: mariadb
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
更改下列內容:
SOURCE_HOST:MariaDB 伺服器的主機名稱或 IP 位址。SOURCE_DATABASE:必要的 MariaDB 資料庫名稱。SOURCE_USER:MariaDB 使用者名稱。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密碼的專案 ID 和密鑰 ID,或設為BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目標 Google Cloud專案 ID。TARGET_DATASET:目標 BigQuery 資料集名稱。
MySQL
如要驗證 MySQL 遷移作業,請在資料庫連線檔案中設定下列資訊:
connections:
source:
  dialect: mysql
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
更改下列內容:
SOURCE_HOST:MySQL 伺服器的主機名稱或 IP 位址。SOURCE_DATABASE:必要的 MySQL 資料庫名稱。SOURCE_USER:MySQL 使用者名稱。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含密碼的專案 ID 和密鑰 ID,或設為BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目標 Google Cloud專案 ID。TARGET_DATASET:目標 BigQuery 資料集名稱。
Oracle
如要驗證 Oracle 遷移作業,請使用下列資訊設定資料庫連線檔案:
connections:
source:
  dialect: oracle
  host: SOURCE_HOST
  port: 1521
  database: SERVICE_NAME
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
更改下列內容:
SOURCE_HOST:: Oracle 伺服器的主機名稱或 IP 位址。SERVICE_NAME:Oracle 服務名稱 (用於建構jdbc:oracle:thin:@//HOST:PORT/SERVICE_NAME)。如果是自訂 TNS 或 SID 連線,請改為使用完整 JDBC 網址指定url。SOURCE_SCHEMA:選用的預設結構定義名稱。SOURCE_USER:必要的 Oracle 使用者名稱。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含資料庫密碼的專案 ID 和密鑰 ID,或設定BQMS_VALIDATION_SOURCE_PASSWORD。TARGET_PROJECT_ID:目標 Google Cloud專案 ID。TARGET_DATASET:目標 BigQuery 資料集名稱。
PostgreSQL
如要驗證 PostgreSQL 遷移作業,請使用下列資訊設定資料庫連線檔案:
connections:
source:
  dialect: postgresql
  host: SOURCE_HOST
  port: 5432
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
更改下列內容:
SOURCE_HOST:PostgreSQL 伺服器的主機名稱或 IP 位址。SOURCE_DATABASE:必要的 PostgreSQL 資料庫名稱。SOURCE_SCHEMA:預設結構定義名稱 (如省略,則預設為public)。SOURCE_USER:資料庫使用者名稱。SECRET_PROJECT_ID和SECRET_ID:Secret Manager 中包含資料庫密碼的專案 ID 和密鑰 ID。或者,您也可以省略passwordSecret,並設定BQMS_VALIDATION_SOURCE_PASSWORD環境變數。TARGET_PROJECT_ID: Google Cloud 專案 ID,其中包含已遷移的 BigQuery 資料表,且將建立validation_results資料集。TARGET_DATASET:目標 BigQuery 資料集名稱。
建立設定檔
在驗證設定目錄中,建立名為 settings.yaml 的暫存和結果設定檔,設定 Cloud Storage 暫存路徑、BigQuery 結果資料集、每次執行的資料表到期時間,以及選用的全域預設值。
使用下列設定,設定暫存和結果設定檔:
googleCloudStorage:
  gcsPath: gs://BUCKET_NAME/PATH_PREFIX
  format: FORMAT

results:
  projectId: RESULTS_PROJECT_ID
  dataset: RESULTS_DATASET
  location: RESULTS_LOCATION

resultTtlHours: RESULT_TTL_HOURS
results: RESULTS_CONFIG
更改下列內容:
BUCKET_NAME:Cloud Storage 暫存 bucket 的名稱。PATH_PREFIX:bucket 中的 Cloud Storage URI 前置字元,用於暫存擷取的結構定義中繼資料、匯總指標、取樣資料列和摘要報告。FORMAT:暫存資料樣本的檔案格式。支援的值為parquet(預設) 和csv。RESULTS_PROJECT_ID:寫入驗證結果和執行記錄資料表的 Google Cloud 專案 ID。如省略,則預設為connections.yaml的target.projectId。RESULTS_DATASET:BigQuery 資料集名稱,用於寫入驗證結果和執行記錄資料表 (run_history、run_metrics和column_history)。如省略,則預設為validation_results。如果資料集不存在,驗證服務會自動建立。RESULTS_LOCATION:結果資料集的 BigQuery 位置。如未指定,自動建立的結果資料集預設會位於 Cloud Storage 暫存 bucket 和目標 BigQuery 資料集的區域。RESULT_TTL_HOURS:在結果資料集中建立的每次執行比較和不相符資料表的存留時間 (以小時為單位)。預設為168.0小時 (7 天)。長期觀測能力資料表 (run_history、run_metrics和column_history) 不受resultTtlHours影響。RESULTS_CONFIG:設定比較結果和稽核記錄的目的地 BigQuery 資料集。支援的值為projectId、dataset和location。如省略,驗證服務會寫入TARGET_PROJECT_ID.validation_results`,並在目標資料集和 Cloud Storage 暫存 bucket 所在區域自動建立資料集 (如果尚未建立)。
您也可以在 settings.yaml 或 validation-config.yaml 的頂層指定 tolerances、aggregate 或 labels,藉此指定全域資料表預設值。除非在個別資料表設定中覆寫,否則這些預設值會套用至所有資料表。
生成資料表驗證設定
設定連線和設定檔後,請定義資料表驗證設定。generate-config 指令會在 validation_config/databases/DATABASE/SCHEMA/TABLE.yaml 建立每個資料表一個 YAML 檔案,並包含頂層 table: 鍵,您也可以手動建立 validation_config/tables.yaml 檔案。
選取下列其中一個選項,瞭解如何為來源資料庫產生資料表驗證設定:
Teradata
如要驗證 Teradata 遷移作業,請按照下列步驟操作,產生來源結構定義的 dwh-migration-dumper 工具中繼資料封存檔:
- 安裝
dwh-migration-dumper工具。 - 對來源資料庫執行
dwh-migration-dumper,產生dwh-migration-dumper工具中繼資料封存檔。
使用中繼資料封存檔,執行 generate-config 產生各資料表的設定檔。您可以使用 --update 旗標,保留在 validation_config/ 中建立的現有 connections.yaml 和 settings.yaml 檔案。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您也有批次 SQL 轉譯器的 tables.yaml 結構定義對應檔案,請單獨加入 --tables-yaml 旗標,或與 --metadata 一併加入,以便使用中繼資料封存中的來源分區中繼資料和資料類型排除項目,補充轉譯的資料表對應。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 指令支援下列旗標:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具中繼資料封存檔 (ZIP 檔案) 的路徑,或包含中繼資料封存檔的目錄。--tables-yaml PATH_TO_TABLES_YAML:一或多個翻譯tables.yaml檔案或目錄的路徑 (以半形逗號分隔)。--target-dataset TARGET_DATASET:目標 BigQuery 資料集名稱,會加在產生的targetTable.name項目之前。-o, --output-dir DIRECTORY:模組化設定檔的輸出目錄。預設值為validation_config。--schemas SCHEMA_LIST:以半形逗號分隔的清單,列出要納入的來源結構定義或資料庫 (區分大小寫,支援*萬用字元)。--tables TABLE_LIST:以半形逗號分隔的資料表名稱清單 (TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE),用於指定要納入的資料表 (區分大小寫,支援*萬用字元)。--filter-file PATH:以換行符號分隔的檔案路徑,其中包含要納入的資料表名稱 (系統會忽略以#開頭的行)。--update:將探索到的資料表合併至現有的validation_config/目錄,同時保留現有的connections.yaml、settings.yaml和自訂個別資料表覆寫。--force:允許將新發現的資料表檔案寫入非空白輸出目錄,同時保留現有的資料表設定檔。--clean:在寫入新發現的檔案之前,刪除輸出目錄中的所有現有檔案。
Snowflake
如要驗證 Snowflake 遷移作業,請按照下列步驟操作,產生來源結構定義的 dwh-migration-dumper 工具中繼資料封存檔:
- 安裝
dwh-migration-dumper工具。 - 對來源資料庫執行
dwh-migration-dumper,產生dwh-migration-dumper工具中繼資料封存檔。
使用中繼資料封存檔,執行 generate-config 產生各資料表的設定檔。您可以使用 --update 旗標,保留在 validation_config/ 中建立的現有 connections.yaml 和 settings.yaml 檔案。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您也有批次 SQL 翻譯工具的 tables.yaml 結構定義對應檔案,請單獨加入 --tables-yaml 旗標,或與 --metadata 一併加入,以便使用來源叢集鍵 (用於分區資料表,不含主鍵)、實體分區中繼資料,以及中繼資料封存中的資料類型排除項目,補充翻譯後的資料表對應。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 指令支援下列旗標:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具中繼資料封存檔 (ZIP 檔案) 的路徑,或包含中繼資料封存檔的目錄。--tables-yaml PATH_TO_TABLES_YAML:一或多個翻譯tables.yaml檔案或目錄的路徑 (以半形逗號分隔)。--target-dataset TARGET_DATASET:目標 BigQuery 資料集名稱,會加在產生的targetTable.name項目之前。-o, --output-dir DIRECTORY:模組化設定檔的輸出目錄。預設值為validation_config。--schemas SCHEMA_LIST:以半形逗號分隔的清單,列出要納入的來源結構定義或資料庫 (區分大小寫,支援*萬用字元)。--tables TABLE_LIST:以半形逗號分隔的資料表名稱清單 (TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE),用於指定要納入的資料表 (區分大小寫,支援*萬用字元)。--filter-file PATH:以換行符號分隔的檔案路徑,其中包含要納入的資料表名稱 (系統會忽略以#開頭的行)。--update:將探索到的資料表合併至現有的validation_config/目錄,同時保留現有的connections.yaml、settings.yaml和自訂個別資料表覆寫。--force:允許將新發現的資料表檔案寫入非空白輸出目錄,同時保留現有的資料表設定檔。--clean:在寫入新發現的檔案之前,刪除輸出目錄中的所有現有檔案。
Amazon Redshift
如要驗證 Amazon Redshift 遷移作業,請按照下列步驟操作,產生來源結構定義的中繼資料 ZIP 封存檔:
- 安裝
dwh-migration-dumper工具。 - 對來源資料庫執行
dwh-migration-dumper,產生dwh-migration-dumper工具中繼資料封存檔。
使用中繼資料封存檔,執行 generate-config 產生各資料表的設定檔。您可以使用 --update 旗標,保留在 validation_config/ 中建立的現有 connections.yaml 和 settings.yaml 檔案。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您也有批次 SQL 轉譯器的 tables.yaml 結構定義對應檔案,請單獨加入 --tables-yaml 旗標,或與 --metadata 一併加入,以便使用中繼資料封存中的來源分區中繼資料和資料類型排除項目,補充轉譯的資料表對應。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 指令支援下列旗標:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具中繼資料封存檔 (ZIP 檔案) 的路徑,或包含中繼資料封存檔的目錄。--tables-yaml PATH_TO_TABLES_YAML:一或多個翻譯tables.yaml檔案或目錄的路徑 (以半形逗號分隔)。--target-dataset TARGET_DATASET:目標 BigQuery 資料集名稱,會加在產生的targetTable.name項目之前。-o, --output-dir DIRECTORY:模組化設定檔的輸出目錄。預設值為validation_config。--schemas SCHEMA_LIST:以半形逗號分隔的清單,列出要納入的來源結構定義或資料庫 (區分大小寫,支援*萬用字元)。--tables TABLE_LIST:以半形逗號分隔的資料表名稱清單 (TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE),用於指定要納入的資料表 (區分大小寫,支援*萬用字元)。--filter-file PATH:以換行符號分隔的檔案路徑,其中包含要納入的資料表名稱 (系統會忽略以#開頭的行)。--update:將探索到的資料表合併至現有的validation_config/目錄,同時保留現有的connections.yaml、settings.yaml和自訂個別資料表覆寫。--force:允許將新發現的資料表檔案寫入非空白輸出目錄,同時保留現有的資料表設定檔。--clean:在寫入新發現的檔案之前,刪除輸出目錄中的所有現有檔案。
Databricks
Databricks 不支援自動產生設定。在 validation_config/ 目錄中手動建立 tables.yaml 檔案,並加入下列設定:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Apache Hive
如要驗證 Apache Hive 遷移作業,請按照下列步驟操作,產生來源結構定義的中繼資料 ZIP 封存檔:
- 安裝
dwh-migration-dumper工具。 - 對來源資料庫執行
dwh-migration-dumper,產生dwh-migration-dumper工具中繼資料封存檔。
使用中繼資料封存檔,執行 generate-config 產生各資料表的設定檔。您可以使用 --update 旗標,保留在 validation_config/ 中建立的現有 connections.yaml 和 settings.yaml 檔案。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您也有批次 SQL 轉譯器的 tables.yaml 結構定義對應檔案,請單獨加入 --tables-yaml 旗標,或與 --metadata 一併加入,以便使用中繼資料封存中的來源分區中繼資料和資料類型排除項目,補充轉譯的資料表對應。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 指令支援下列旗標:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具中繼資料封存檔 (ZIP 檔案) 的路徑,或包含中繼資料封存檔的目錄。--tables-yaml PATH_TO_TABLES_YAML:一或多個翻譯tables.yaml檔案或目錄的路徑 (以半形逗號分隔)。--target-dataset TARGET_DATASET:目標 BigQuery 資料集名稱,會加在產生的targetTable.name項目之前。-o, --output-dir DIRECTORY:模組化設定檔的輸出目錄。預設值為validation_config。--schemas SCHEMA_LIST:以半形逗號分隔的清單,列出要納入的來源結構定義或資料庫 (區分大小寫,支援*萬用字元)。--tables TABLE_LIST:以半形逗號分隔的資料表名稱清單 (TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE),用於指定要納入的資料表 (區分大小寫,支援*萬用字元)。--filter-file PATH:以換行符號分隔的檔案路徑,其中包含要納入的資料表名稱 (系統會忽略以#開頭的行)。--update:將探索到的資料表合併至現有的validation_config/目錄,同時保留現有的connections.yaml、settings.yaml和自訂個別資料表覆寫。--force:允許將新發現的資料表檔案寫入非空白輸出目錄,同時保留現有的資料表設定檔。--clean:在寫入新發現的檔案之前,刪除輸出目錄中的所有現有檔案。
SQL Server
如要驗證 SQL Server 遷移作業,請按照下列步驟操作,產生來源結構定義的 dwh-migration-dumper 工具中繼資料封存檔:
- 安裝
dwh-migration-dumper工具。 - 對來源資料庫執行
dwh-migration-dumper,產生dwh-migration-dumper工具中繼資料封存檔。
使用中繼資料封存檔,執行 generate-config 產生各資料表的設定檔。您可以使用 --update 旗標,保留在 validation_config/ 中建立的現有 connections.yaml 和 settings.yaml 檔案。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您也有批次 SQL 轉譯器的 tables.yaml 結構定義對應檔案,請單獨加入 --tables-yaml 旗標,或與 --metadata 一併加入,以便使用中繼資料封存中的來源分區中繼資料和資料類型排除項目,補充轉譯的資料表對應。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 指令支援下列旗標:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具中繼資料封存檔 (ZIP 檔案) 的路徑,或包含中繼資料封存檔的目錄。--tables-yaml PATH_TO_TABLES_YAML:一或多個翻譯tables.yaml檔案或目錄的路徑 (以半形逗號分隔)。--target-dataset TARGET_DATASET:目標 BigQuery 資料集名稱,會加在產生的targetTable.name項目之前。-o, --output-dir DIRECTORY:模組化設定檔的輸出目錄。預設值為validation_config。--schemas SCHEMA_LIST:以半形逗號分隔的清單,列出要納入的來源結構定義或資料庫 (區分大小寫,支援*萬用字元)。--tables TABLE_LIST:以半形逗號分隔的資料表名稱清單 (TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE),用於指定要納入的資料表 (區分大小寫,支援*萬用字元)。--filter-file PATH:以換行符號分隔的檔案路徑,其中包含要納入的資料表名稱 (系統會忽略以#開頭的行)。--update:將探索到的資料表合併至現有的validation_config/目錄,同時保留現有的connections.yaml、settings.yaml和自訂個別資料表覆寫。--force:允許將新發現的資料表檔案寫入非空白輸出目錄,同時保留現有的資料表設定檔。--clean:在寫入新發現的檔案之前,刪除輸出目錄中的所有現有檔案。
MariaDB
MariaDB 不支援自動產生設定。在 validation_config/ 目錄中手動建立 tables.yaml 檔案,並加入下列設定:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
MySQL
MySQL 不支援自動產生設定。在 validation_config/ 目錄中手動建立 tables.yaml 檔案,並加入下列設定:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Oracle
如要驗證 Oracle 遷移作業,請按照下列步驟操作,產生來源結構定義的 dwh-migration-dumper 工具中繼資料封存檔:
- 安裝
dwh-migration-dumper工具。 - 對來源資料庫執行
dwh-migration-dumper,產生dwh-migration-dumper工具中繼資料封存檔。
使用中繼資料封存檔,執行 generate-config 產生各資料表的設定檔。您可以使用 --update 旗標,保留在 validation_config/ 中建立的現有 connections.yaml 和 settings.yaml 檔案。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您也有批次 SQL 轉譯器的 tables.yaml 結構定義對應檔案,請單獨加入 --tables-yaml 旗標,或與 --metadata 一併加入,以便使用中繼資料封存中的來源分區中繼資料和資料類型排除項目,補充轉譯的資料表對應。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 指令支援下列旗標:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具中繼資料封存檔 (ZIP 檔案) 的路徑,或包含中繼資料封存檔的目錄。--tables-yaml PATH_TO_TABLES_YAML:一或多個翻譯tables.yaml檔案或目錄的路徑 (以半形逗號分隔)。--target-dataset TARGET_DATASET:目標 BigQuery 資料集名稱,會加在產生的targetTable.name項目之前。-o, --output-dir DIRECTORY:模組化設定檔的輸出目錄。預設值為validation_config。--schemas SCHEMA_LIST:以半形逗號分隔的清單,列出要納入的來源結構定義或資料庫 (區分大小寫,支援*萬用字元)。--tables TABLE_LIST:以半形逗號分隔的資料表名稱清單 (TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE),用於指定要納入的資料表 (區分大小寫,支援*萬用字元)。--filter-file PATH:以換行符號分隔的檔案路徑,其中包含要納入的資料表名稱 (系統會忽略以#開頭的行)。--update:將探索到的資料表合併至現有的validation_config/目錄,同時保留現有的connections.yaml、settings.yaml和自訂個別資料表覆寫。--force:允許將新發現的資料表檔案寫入非空白輸出目錄,同時保留現有的資料表設定檔。--clean:在寫入新發現的檔案之前,刪除輸出目錄中的所有現有檔案。
PostgreSQL
如要驗證 PostgreSQL 遷移作業,請按照下列步驟產生來源結構定義的 dwh-migration-dumper 工具中繼資料封存檔:
- 安裝
dwh-migration-dumper工具。 - 對來源資料庫執行
dwh-migration-dumper,產生dwh-migration-dumper工具中繼資料封存檔。
使用中繼資料封存檔,執行 generate-config 產生各資料表的設定檔。您可以使用 --update 旗標,保留在 validation_config/ 中建立的現有 connections.yaml 和 settings.yaml 檔案。例如:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
如果您也有批次 SQL 翻譯工具的 tables.yaml 結構定義對應檔案,請單獨加入 --tables-yaml 旗標,或與 --metadata 一併加入,以便使用中繼資料封存中的來源分區中繼資料和資料類型排除項目,補充翻譯後的資料表對應。例如:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 指令支援下列旗標:
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper工具中繼資料封存檔 (ZIP 檔案) 的路徑,或包含中繼資料封存檔的目錄。--tables-yaml PATH_TO_TABLES_YAML:一或多個翻譯tables.yaml檔案或目錄的路徑 (以半形逗號分隔)。--target-dataset TARGET_DATASET:目標 BigQuery 資料集名稱,會加在產生的targetTable.name項目之前。-o, --output-dir DIRECTORY:模組化設定檔的輸出目錄。預設值為validation_config。--schemas SCHEMA_LIST:以半形逗號分隔的清單,列出要納入的來源結構定義或資料庫 (區分大小寫,支援*萬用字元)。--tables TABLE_LIST:以半形逗號分隔的資料表名稱清單 (TABLE、SCHEMA.TABLE或DB.SCHEMA.TABLE),用於指定要納入的資料表 (區分大小寫,支援*萬用字元)。--filter-file PATH:以換行符號分隔的檔案路徑,其中包含要納入的資料表名稱 (系統會忽略以#開頭的行)。--update:將探索到的資料表合併至現有的validation_config/目錄,同時保留現有的connections.yaml、settings.yaml和自訂個別資料表覆寫。--force:允許將新發現的資料表檔案寫入非空白輸出目錄,同時保留現有的資料表設定檔。--clean:在寫入新發現的檔案之前,刪除輸出目錄中的所有現有檔案。
自訂表格設定
generate-config 產生的每個表格檔案都包含 table: 區段,您可以在執行驗證前自訂該區段。下表列出每個表格項目支援的所有選用鍵。
| 選用 YAML 鍵 | 預設值 | 說明 |
|---|---|---|
runSchema、runAggregate、runData |
true |
如果未傳遞任何支柱指令列旗標,則可使用個別資料表的布林值,啟用或停用個別驗證支柱。 |
maxColumnsPerTile |
100 |
寬資料表中,單一比較圖塊可分組的資料欄數量上限。 |
strategy |
SMART |
資料驗證執行策略:SMART (BRUTE_FORCE,如果資料列少於 100,000 列,否則為 SAMPLE)、SAMPLE 或 BRUTE_FORCE。 |
sampleSize |
70000 |
解析策略為 SAMPLE 時,要擷取的資料列數量 (分區時為每個切片)。預設值為 70,000 列,當缺失率為 0.01% (每 10,000 列有 1 列) 以上時,偵測到至少一列不相符資料的機率超過 99.9%。 |
whereClause |
無 | SQL 述詞 (不含 WHERE 關鍵字) 會套用至來源擷取和目標比較查詢。也可以在 sourceTable.whereClause 和 targetTable.whereClause 上分別設定。 |
skipRandomization |
false |
如果設為 true,系統會按照自然資料表順序讀取最多 sampleSize 列,而不是依隨機函式排序,進而降低大型資料表的查詢成本。 |
maxConcurrency |
1 |
分區資料表平行擷取切片的執行緒數量上限。 |
maxSlices |
0 (不限) |
分區資料表允許的分區配量數量上限。如果計算出的切片數量超過 maxSlices (大於 0),分區規劃就會失敗並傳回錯誤。 |
disablePartitioning |
false |
如果設為 true,即使已設定 partitioning 區塊或資料列數量超過 1000000,系統也會停用資料表的分區切片功能。 |
labels |
空白地圖 | 附加至 validation_results 中驗證執行作業指標的鍵/值字串標籤。 |
下列各節說明如何使用這些 YAML 鍵自訂驗證執行作業。
選取驗證策略
在資料表項目上使用 strategy 鍵,選取驗證策略,控制 --data 柱如何擷取及比較資料列。支援下列值:
SMART(預設):先計算來源資料表中的資料列。如果資料表少於 100,000 列,則會執行BRUTE_FORCE;如果資料表有 100,000 列以上,則會執行SAMPLE。SAMPLE:根據sampleSize的值 (預設為70,000) 擷取隨機資料列樣本,並使用comparisonKeys將這些資料列與目標資料表彙整。如果至少有 0.01% 的資料列 (1/10,000) 含有不相符項目,則 70,000 個資料列的樣本可提供超過 99.9% 的信賴水準,確保至少能找出一個有瑕疵的資料列。BRUTE_FORCE:在單一未分區查詢中,擷取並比較每個資料列。使用BRUTE_FORCE時,系統會忽略分區設定。
設定比較鍵
比較鍵是一或多個資料欄,用於明確識別及彙整來源和目標系統之間的資料列。比較鍵會說明哪些屬性具有足夠的獨特性,可確保彙整作業穩定。
執行資料列層級資料比較時,您可以透過下列方式設定比較鍵:
- 自動探索:從
sourceTable區段中省略comparisonKeys,讓驗證工具在預檢期間自動偵測來源資料庫中的主鍵 (在 Oracle 和 Snowflake 上改用NOT NULL專屬限制、在 Teradata 上改用專屬索引,或在 Amazon Redshift 上改用單欄DISTKEY或SORTKEY)。 手動複合或自訂鍵:在
sourceTable下方的comparisonKeys中列出來源鍵欄名稱,手動指定複合或自訂比較鍵。系統會自動比對來源和目標鍵資料欄名稱的大小寫差異;如果 BigQuery 中的比較鍵資料欄已重新命名,請在columnSettings.columns.SOURCE_COLUMN.targetColumn下方對應。以下範例設定了複合比較鍵:table: sourceTable: name: sales_db.public.order_items comparisonKeys: - order_id - line_number targetTable: name: migrated_sales.order_items
沒有不重複索引鍵的資料表雜湊比較:如果資料表沒有主鍵,請在
sourceTable下方設定useAllColumnsAsKey: true。如果預檢中繼資料檢查未找到主鍵,系統也會自動選取這個選項。
設定大型資料表的分區擷取
如果資料表的策略解析為 SAMPLE,且資料表設定中存在 partitioning 區塊 (generate-config 預設會寫入),或資料表的資料列數量超過 1,000,000,驗證工具會將資料表分割成多個切片,讓取樣查詢掃描限定範圍,而不是一次排序整個資料表。如果資料表已分區,則每個切片最多可擷取 sampleSize 列。如要限制只驗證部分資料列,請改用 whereClause。
如要設定分區擷取,請在 table: 區段中使用 partitioning 區塊。例如:
table:
  sourceTable:
    name: sales_db.public.orders
    comparisonKeys:
      - order_id
  targetTable:
    name: migrated_sales.orders
  strategy: SAMPLE
  maxConcurrency: 4
  maxSlices: 100
  partitioning:
    type: INTEGER_RANGE
    column: order_id
    partitionSize: 1000000
partitioning 區塊支援下列欄位:
type:INTEGER_RANGE:將資料表切分為數值鍵/值間隔 (COLUMN BETWEEN START AND END)。這是預設值。DATE_RANGE:將資料表切分為日期或時間戳記間隔。支援 PostgreSQL 和 Snowflake。PHYSICAL:如果存在實體分區中繼資料,則會使用 Oracle 和 Amazon Redshift 資料表的資料庫分區。
column:指定來源資料表中的索引數值、日期或時間戳記資料欄,用於計算切片邊界。分區欄中含有NULL值的資料列會從範圍型切片 (INTEGER_RANGE和DATE_RANGE) 中排除。partitionSize:如果是INTEGER_RANGE類型,這個值會指定每個切片數值鍵/值範圍的寬度,預設值為1000000。如果是DATE_RANGE類型,這個值會指定每個切片的天數,預設值為30。maxSlices:指定資料表允許的切片總數上限 (在table:下設定)。如果資料表需要的切片數量超過maxSlices,分區規劃就會失敗,並顯示錯誤訊息,要求提供更大的partitionSize或maxSlices。maxConcurrency:指定用於擷取切片的平行背景工作執行緒數量,預設值為1。設定低於table:。
自訂匯總檢查
匯總分析功能預設為啟用,可透過巨觀層級的匯總檢查,補足資料列層級取樣的不足。如果資料表很大,隨機取樣可能會遺漏細微的資料偏斜,這時就很適合使用這項設定。
如果未自訂欄設定,驗證工具會根據資料欄類型,自動套用標準匯總檢查:
- 精確數值 (
INTEGER、NUMERIC、BIGNUMERIC):COUNT、SUM、AVG、MIN、MAX - 浮點 (
FLOAT、DOUBLE、REAL):COUNT、MIN、MAX - 布林值 (
BOOLEAN):COUNT、COUNT_TRUE、COUNT_FALSE、COUNT_NULL - 字串 (
STRING、VARCHAR、CHAR、TEXT):COUNT、SUM_LENGTH - 日期、時間和時間戳記:
COUNT、MIN、MAX
您可以使用 columnSettings 區段自訂或停用匯總檢查。以下範例說明如何設定匯總容許值,以及覆寫特定資料欄檢查:
table:
  sourceTable:
    name: sales_db.public.orders
  targetTable:
    name: migrated_sales.orders
  # Set aggregate: false here to disable aggregate checks for the entire table
  columnSettings:
    aggregate:
      tolerance: 0.01
    columns:
      amount:
        aggregate:
          functions:
            - COUNT
            - SUM
            - AVG
          tolerance: 0.05
      internal_notes:
        aggregate: false
以下是匯總設定規則:
columnSettings.columns下方的資料欄索引鍵必須與來源資料欄名稱完全相符 (區分大小寫)。- 匯總
tolerance是絕對差異門檻 (ABS(target - source) <= tolerance)。如果未設定匯總tolerance(在資料欄層級或columnSettings.aggregate.tolerance),且資料欄具有資料列層級tolerances.numeric設定,則AVG、MIN和MAX會直接沿用tolerances.numeric,而SUM會將沿用的資料列層級容許值乘以COUNT。 - 在
columnSettings.columns.SOURCE_COLUMN.aggregate.functions下,每個資料欄只能覆寫functions。
排除資料欄、對應資料欄名稱,以及套用 SQL 比較運算式
您可以使用 columnSettings 排除資料欄、設定數值或時間容許值、對應重新命名的目標資料欄,或在比較前套用 SQL 轉換。columnSettings.columns 下方的每個鍵都是來源資料欄名稱。如果資料欄在 BigQuery 中有不同的名稱,請使用該項目中的 targetColumn 屬性。例如:
table:
  sourceTable:
    name: sales_db.public.customers
    comparisonKeys:
      - customer_id
  targetTable:
    name: migrated_sales.customers
  columnSettings:
    exclude:
      - etl_loaded_at
      - "temp_*"
    tolerances:
      numeric: 0.0001
      timestamp: 0.001
      date: 1
    columns:
      SOURCE_COLUMN_1:
        targetColumn: customer_full_name
        transform: TRIM
      SOURCE_COLUMN_2:
        transformExpression: "ROUND(SOURCE_COLUMN_2, 4)"
columnSettings 支援下列欄位:
exclude:指定不區分大小寫的資料欄名稱或 glob 模式 (*) 清單,從所有驗證要素中排除。tolerances:numeric:數值資料欄的容許值 (ABS(target - source) <= tolerance用於鍵值比較,或在useAllColumnsAsKey: true時四捨五入至ceil(-log10(tolerance))小數位數)。timestamp:時間戳記資料欄的容許值 (以秒為單位)。例如,0.001代表 1 毫秒。date:日期欄的容許值 (以天為單位)。
columns:各資料欄設定的對應關係,以來源資料欄名稱 (SOURCE_COLUMN) 為索引鍵:targetColumn:將來源資料欄對應至 BigQuery 中名稱不同的目標資料欄。transform:比較前套用的內建轉換:TRIM、UPPER、LOWER:所有方言都支援。EMPTY_TO_NULL、NULL_TO_EMPTY、CAST_TO_STRING:支援 PostgreSQL、Amazon Redshift、Oracle 和 Teradata 來源的來源查詢。
transformExpression:參照常值來源資料欄名稱的自訂 SQL 運算式。例如:"ROUND(SOURCE_COLUMN, 4)"。由於系統會同時對來源查詢和 BigQuery 比較查詢評估運算式,因此請使用在來源方言和 GoogleSQL 中都有效的 SQL 函式。
值正規化
在資料列層級比較 (--data) 期間,驗證服務會正規化值,以免來源引擎和 BigQuery 之間的表示法差異導致不相符。驗證服務會以下列方式正規化值:
- 精確數值類型 (
INTEGER、NUMERIC、DECIMAL、BIGNUMERIC):在鍵式比較中,系統會比較完整的值 (NUMERIC最多 9 個小數位數,BIGNUMERIC最多 38 個小數位數),如果設定tolerances.numeric,則ABS(target - source) <= tolerance時值會相符。在完整資料列雜湊比較 (useAllColumnsAsKey: true) 中,值預設會四捨五入至小數點後 9 位,或在設定數值容許值時四捨五入至小數點後ceil(-log10(tolerance))位。 - 浮點類型 (
FLOAT、DOUBLE、REAL):預設正規化為 6 位小數 (1e-6)。 - 時間戳記:正規化為世界標準時間,精確度為微秒。
- 固定寬度字元類型 (
CHAR、NCHAR、CHARACTER):系統會自動修剪開頭和結尾的空格,以符合 BigQuerySTRING語意。
執行驗證服務
設定驗證設定後,請執行 validate 指令,啟動遷移驗證工具。您可以傳遞本機路徑或指向 validation_config/ 目錄的 Cloud Storage gs:// URI。
下列範例會在本機儲存的驗證設定檔上執行驗證服務:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG
將 PATH_TO_VALIDATION_CONFIG 替換為模組化 validation_config/ 目錄的路徑。
如果驗證設定儲存在 Cloud Storage,請傳遞設定目錄的 gs:// URI:
gcloud bq migration validate gs://BUCKET_NAME/validation_config
將 BUCKET_NAME 替換為 Cloud Storage bucket 名稱。
根據預設,驗證服務會針對下列三個驗證要素執行驗證服務:
--schema:僅驗證結構定義--aggregate:僅驗證匯總資料--data:僅驗證資料列層級資料
您可以使用支柱旗標,在特定驗證支柱上執行驗證服務。下列範例會使用自訂 WHERE 篩選器,對兩個特定資料表執行結構定義和匯總驗證:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG \
  --schema \
  --aggregate \
  --tables orders,customers \
  --where "order_date >= '2026-01-01'"
validate 指令支援下列選用旗標:
--table或--tables:以半形逗號分隔的資料表名稱清單,用於驗證。--tables比對會區分大小寫,且必須與sourceTable.name或targetTable.name中使用的大小寫相符。--where SQL_PREDICATE:在這次執行期間,覆寫來源和目標資料表的whereClause。--source-where SQL_PREDICATE:僅覆寫來源資料表的whereClause。--target-where SQL_PREDICATE:僅覆寫目標資料表的whereClause。--gcs-path:覆寫googleCloudStorage.gcsPath。例如:--gcs-path gs://my-bucket/validation。--max-concurrency、--concurrency或--threads:覆寫maxConcurrency,用於平行切片擷取。--no-partition或--disable-partitioning:停用執行作業中所有資料表的分區切片擷取功能。--labels KEY=VALUE[,KEY=VALUE...]:將自訂鍵/值標籤附加至執行結果。--output-dir:暫時執行 中繼資料和狀態檔案的本機目錄。預設值為/tmp/validation_outputs。-v、--verbose、-d或--debug:啟用詳細或偵錯記錄。
非同步工作流程交接
validate 會同步執行來源擷取作業,然後為每個資料表觸發非同步 BigQuery Migration Service 工作流程。
如果目標資料集位於
us以外的位置 (例如eu),請先設定BQMS_VALIDATION_LOCATION環境變數,再執行validate:export BQMS_VALIDATION_LOCATION=LOCATION
確認每個資料表的輸出內容都包含
Workflow:行,其中含有建立的工作流程資源名稱。例如:Run ID: 20261012T180000Z_a1b2c3d4 GCS Path: gs://my-bucket/validation/validationOutputs/sales_db/public/orders/20261012T180000Z_a1b2c3d4 Workflow: projects/my-project/locations/us/workflows/12345678-abcd-ef01-2345-6789abcdef01 Results: my-project.validation_results (populated after target validation)
結束代碼
0表示來源擷取和上傳成功,不代表目標比較已完成或資料相符。如果工作流程建立失敗 (例如缺少權限),CLI 會記錄警告,指出觸發驗證工作流程失敗,並列印手動gcloud備用指令,且省略Workflow:行,即使程序以0結束也一樣。
查看驗證結果
驗證執行作業完成後,您可以在Google Cloud 控制台查看驗證結果,方法是查詢結果資料集validation_results、查詢在settings.yaml中results下設定的 BigQuery 資料集,或讀取 Cloud Storage 中的摘要報表。選取下列選項之一:
Google Cloud 控制台
前往 Google Cloud 控制台的「Migration services」(遷移服務) 頁面。
在「驗證遷移作業」下方,點選「查看近期項目」。
按一下「Select a project」(選取專案),然後選取儲存
validation_results資料集的專案。
GoogleSQL
查詢 TARGET_PROJECT_ID.validation_results.run_history,查看近期驗證執行的狀態:
SELECT
run_id,
source_table,
target_table,
status,
started_at,
finished_at,
gcs_uri,
error_message
FROM `TARGET_PROJECT_ID.validation_results.run_history`
ORDER BY started_at DESC
LIMIT 20;
將 TARGET_PROJECT_ID 替換為儲存 validation_results 資料集的專案 ID。
如要查看詳細的各欄指標和歷來趨勢,請使用下列查詢:
<var>TARGET_PROJECT_ID</var>.validation_results.run_metrics:每次執行、每欄不相符的計數、匯總比較,以及通過或失敗狀態<var>TARGET_PROJECT_ID</var>.validation_results.column_history:各次執行作業的縱向資料欄稽核記錄<var>TARGET_PROJECT_ID</var>.validation_results.run_<var>RUN_ID</var>_mismatches_details:來源和目標值不同的取樣資料列和資料欄
Cloud Storage 報表
每次執行完成後,系統會將下列報表構件寫入執行的 gcs_uri 目錄 (gs://<var>BUCKET</var>/<var>PREFIX</var>/validationOutputs/<var>SOURCE_TABLE_PATH</var>/<var>RUN_ID</var>/):
validation_summary.txt:結構定義、匯總和資料列比較結果的內容提要column_details.txt:不相符和匯總差異的逐欄細目results.json:所有驗證結果的結構化 JSON 報表queries.sql:驗證執行期間執行的確切 SQL 查詢
如要列印執行作業的摘要報表,請執行下列指令:
gcloud storage cat gs://BUCKET/PREFIX/validationOutputs/SOURCE_TABLE_PATH/RUN_ID/validation_summary.txt
解讀驗證結果
validation_results.run_history 中的每項驗證執行作業都會回報下列其中一種執行狀態或 status 值:
| 狀態 | 說明 | 建議做法 |
|---|---|---|
IN_PROGRESS |
驗證工作流程仍在 BigQuery 中執行。 | 等待 finished_at 填入資料,然後再次查詢 run_history。 |
COMPLETED |
驗證管道已完成,沒有任何資料列層級資料或匯總不相符。結構定義類型相容性詳細資料會分別記錄在 validation_summary.txt 和 column_history 中。 |
您無須採取任何行動。資料表已通過驗證。 |
HEALED |
驗證管道已完成,沒有遺漏任何資料列,且所有偵測到的值差異都是微小的浮點表示法抖動 (儲存格層級比較為 < 1e-4,匯總為 < 1e-6),驗證器會自動協調。 |
視為通過。如要抑制上游抖動,可以選擇設定明確的數值 tolerance。 |
COMPLETED_WITH_MISMATCHES |
驗證管道已完整執行,並發現來源和目標資料表之間有遺漏的資料列、遺漏的目標資料欄、匯總差異或儲存格層級資料差異。這表示驗證執行作業已完成,而非系統當機。 | 檢查 column_details.txt、run_metrics 和 run_RUN_ID_mismatches_details,查看不相符的資料欄和資料列。詳情請參閱「資料欄層級不相符類型」。 |
ERROR |
系統或設定錯誤,導致驗證管道無法完成。例如缺少目標資料表、權限錯誤,或自訂 whereClause 或 transformExpression 中的 SQL 無效。 |
查看 run_history 中的 error_message 欄。如要進一步瞭解如何解決常見錯誤,請參閱「疑難排解」。 |
資料欄層級不相符類型
執行作業完成並顯示 COMPLETED_WITH_MISMATCHES 時,每次執行的不相符資料表會將各資料欄比較結果分類為下列其中一種:
EXACT_MATCH:資料欄的比較儲存格值在設定的容許範圍內相符DATA_DRIFT:comparisonKeys上的資料列相符,但儲存格值差異超出設定的容許範圍SCHEMA:來源資料表中有該資料欄,但目標資料表沒有ROW:在comparisonKeys彙整時,目標資料表缺少來源資料列,或來源資料表缺少目標資料列
疑難排解常見錯誤
下表列出常見的指令列和工作流程錯誤,以及解決方法:
| 錯誤訊息或問題 | 原因 | 解析度 |
|---|---|---|
Failed to load or parse YAML |
表格、partitioning、columnSettings 或 googleCloudStorage 區塊包含無法辨識的鍵或無效的列舉值,例如 SAMPLING 而非 SAMPLE。 |
請根據表格設定選項,確認 YAML 縮排和欄位名稱。 |
Connection name '...' is invalid. Must be alphanumeric. |
connections: 下方的設定檔名稱包含底線或連字號。例如:my_source。 |
將連線設定檔重新命名為英數字元名稱,例如 source 和 target。 |
googleCloudStorage cannot be null |
validation_config/settings.yaml 缺少 googleCloudStorage.gcsPath,且未傳遞 --gcs-path。 |
在 validation_config/settings.yaml 中設定 googleCloudStorage.gcsPath: gs://BUCKET/PREFIX,結尾不加斜線。 |
Target discovery directory 'validation_config/' is non-empty |
validation_config/ 已包含 YAML 檔案,但執行 generate-config 時未指定 --update、--force 或 --clean。 |
傳遞 --update 即可合併探索到的資料表,同時保留現有的 connections.yaml 和 settings.yaml。 |
執行 validate 時發生 tables is required |
目前使用的目錄中存在不含 tables: 清單的舊版 validation-config.yaml 檔案,且優先順序高於 validation_config/,或 validation_config/ 下方沒有資料表 YAML 檔案。 |
刪除目前使用的目錄中任何不相關的 validation-config.yaml 檔案,讓 validate 載入 validation_config/。 |
| 單一低基數比較鍵的預檢錯誤 | 資料表有超過 1,000 個篩除資料列,並設定單一低基數比較鍵,這會導致多對多 join 爆炸。 | 請在 comparisonKeys 中指定構成不重複複合索引鍵的所有資料欄,或在 sourceTable 下方設定 useAllColumnsAsKey: true。 |
Failed to initialize MemoryUtil或InaccessibleObjectException: Unable to make field long java.nio.Buffer.address accessible |
JVM 為 Java 17 以上版本,且啟動時未加上 --add-opens=java.base/java.nio=ALL-UNNAMED,通常是因為指令列是透過自訂包裝函式啟動,或直接使用 java -jar 啟動。 |
請在環境中設定 JDK_JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED",或使用 gcloud bq migration validate 指令。 |
WARNING: Failed to trigger validation workflow |
來源擷取成功,但因缺少 IAM 權限、未啟用 API 或位置不受支援,導致呼叫 CreateMigrationWorkflow 失敗。 |
請確認 bigquerymigration.googleapis.com 已啟用、您的帳戶具備 roles/bigquerymigration.editor,且 BQMS_VALIDATION_LOCATION 與資料集位置相符。 |
清除驗證構件
查看驗證結果後,如要管理儲存空間費用,請按照下列步驟操作:
- 在 Cloud Storage 中,刪除暫存 bucket 內
gcsPath前置字串下的舊執行目錄,或在 bucket 上設定物件生命週期管理規則。 - 在 BigQuery 中,結果資料集 (預設為
validation_results) 內每次執行的比較表會在resultTtlHours(預設為168.0小時或 7 天) 後自動到期。調整settings.yaml中的resultTtlHours,縮短或延長保留時間,或手動捨棄每次執行的資料表,同時保留共用記錄資料表和檢視表 (run_history、run_metrics和column_history)。 - 處理本機檔案時,請移除驗證工具在
--output-dir下寫入的本機目前使用的目錄。預設目錄為/tmp/validation_outputs。
定價
驗證服務會使用專案中的下列資源:
- BigQuery 運算和儲存空間:
validation_results資料集中資料表的目標匯總查詢、資料列比較 join 和儲存空間,會按照標準 BigQuery 定價,向您的 Google Cloud 專案或billingProjectId(如果在target連線上設定) 收費。 - Cloud Storage 儲存空間和網路:bucket 中暫存的 Parquet 或 CSV 範例檔案和結果報表,會依據標準 Cloud Storage 定價計費。
- 來源資料庫負載:擷取查詢會直接對來源資料庫執行。如要盡量減少大型來源資料表的負載,請使用
strategy: SAMPLE、透過whereClause篩選,或在不希望產生隨機排序負擔時設定skipRandomization: true。
後續步驟
- 瞭解如何使用
dwh-migration-dumper工具產生翻譯和評估中繼資料。 - 批次轉譯 SQL 查詢,將來源 SQL 指令碼和 DDL 轉換為 GoogleSQL。
- 使用遷移歷程規劃遷移作業,以視覺化方式呈現來源資料倉儲中的資料依賴。