


אימות ההעברה של מחסן הנתונים
שירות האימות של שירות ההעברה ל-BigQuery מאפשר לכם לוודא שהטבלאות שהועברו ממחסן הנתונים (data warehouse) של המקור תואמות לטבלאות היעד ב-BigQuery. אתם יכולים להשוות בין סכימות ונתוני טבלאות כדי לזהות פערים במהלך ההעברה.
הלקוח של שירות האימות מתחבר למסד הנתונים של המקור, ומחלץ את הסכימה של המקור ואת נתוני השורות לקטגוריה של Cloud Storage שבשליטתכם. אחרי החילוץ, שירות האימות משווה בין הסכימה והנתונים שחולצו בקטגוריה של Cloud Storage לבין הטבלאות שהועברו ל-BigQuery.
תהליך עבודה של אימות משווה בין טבלאות המקור לבין טבלאות היעד ב-BigQuery, לפי שלושה עמודי תווך של אימות:
- אימות סכימה (
--schema): השוואה בין שמות העמודות, סוגי הנתונים והתאימות של הסוגים בין טבלת המקור לבין טבלה ב-BigQuery. - אימות צבירה (
--aggregate): חישוב והשוואה של מדדי צבירה ברמת הטבלה וברמת העמודה – כמו ספירת שורות,SUM,AVG,MIN,MAX, התפלגויות בוליאניות ואורכי מחרוזות – בכל הטבלה. - אימות נתונים (
--data): מבצע השוואה בין שורות באמצעות סריקה מקיפה של טבלה מלאה (BRUTE_FORCE) או דגימה אקראית שמבוססת על מפתחות (SAMPLE) כדי לזהות שורות חסרות ושינויים בערכים ברמת התא.
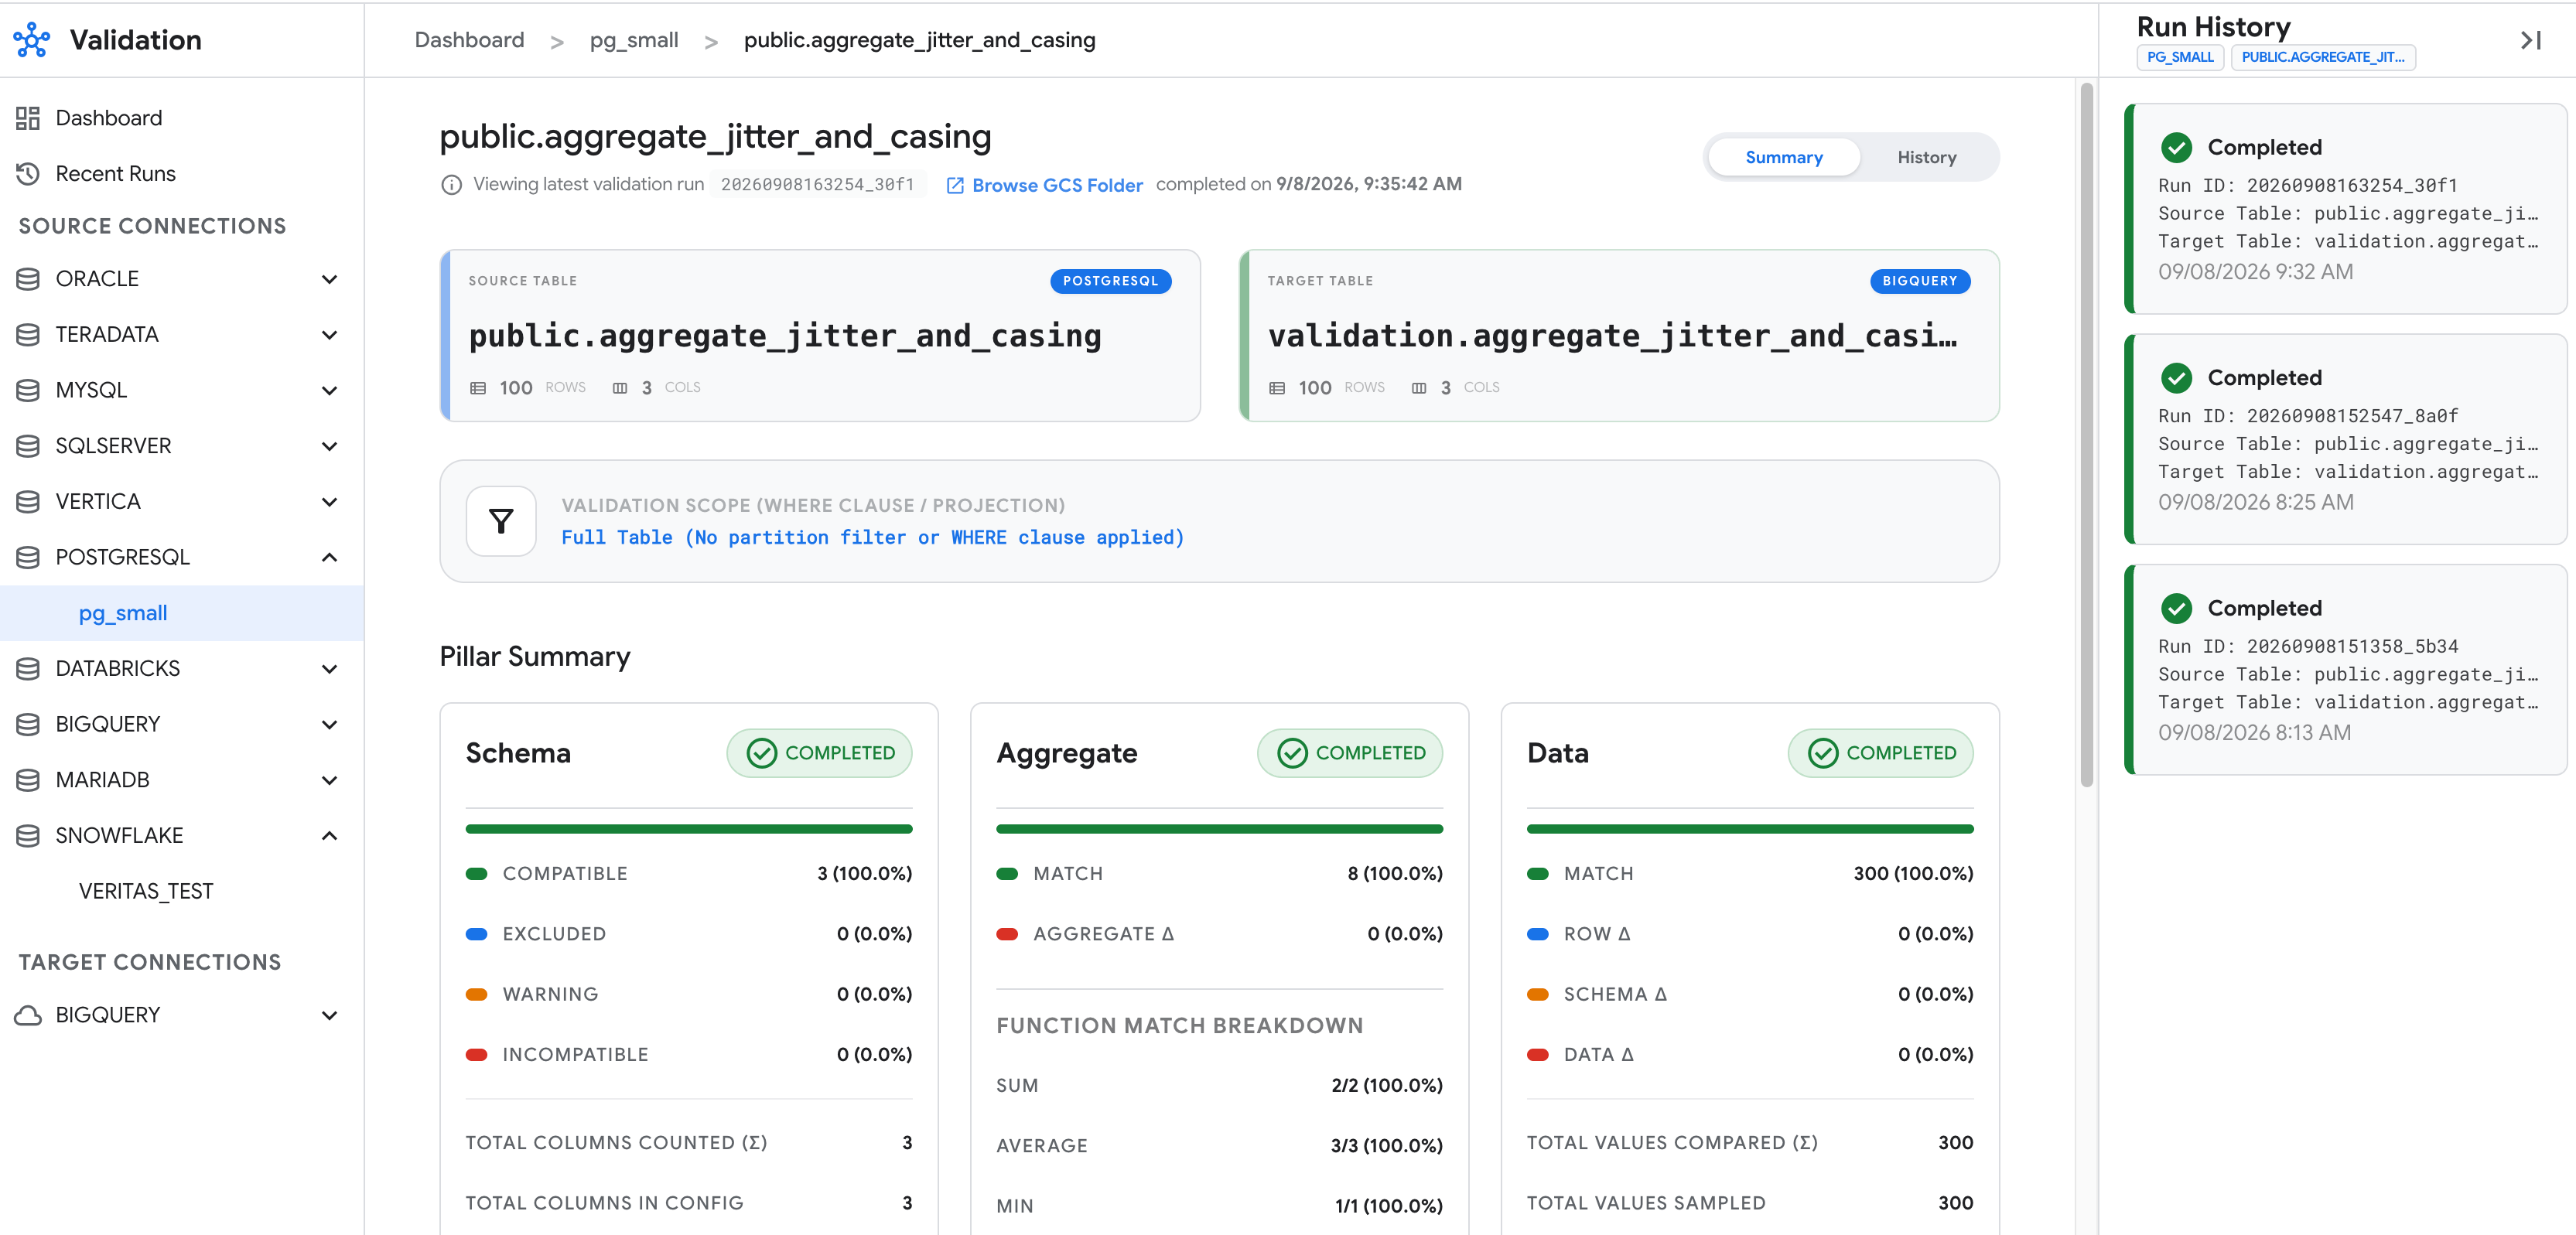
מיקומים נתמכים
שירות האימות זמין במיקומים נבחרים. למידע נוסף, קראו את המאמר מיקומים של שירות ההעברה ל-BigQuery.
שיקולים לגבי טיפול בנתונים ואבטחה
שירות האימות מחלץ ומכין נתונים שונים בהתאם לעמוד התווך של האימות שאתם מריצים:
- אימות סכימה (
--schema): העלאה של שמות עמודות, סוגי נתונים ונתונים סטטיסטיים של טבלאות בלבד לקובץsource_query_result.json, בלי לחלץ ערכי תאים. - אימות מצטבר (
--aggregate): מעלה מדדים מצטברים מחושבים לקובץsource_aggregates.parquet, כולל ערכי תאים בפועל שלMINו-MAXמהעמודות הכלולות. - אימות נתונים (
--data): חילוץ ערכי תאים גולמיים ולא מוסתרים משורות שנדגמו, או מכל השורות כשמשתמשים באסטרטגיהBRUTE_FORCE. הוא מעלה את הערכים האלה בפורמט Apache Parquet או CSV לקטגוריית ה-Staging ב-Cloud Storage, וטוען אותם למערך הנתוניםvalidation_resultsב-BigQuery.
כדי להגן על הנתונים ולאבטח את סביבת האימות, צריך לקבוע את ההגדרות הבאות:
- החרגת עמודות רגישות: מוסיפים עמודות רגישות לשדה
columnSettings.excludeכדי להשמיט אותן משאילתות לחילוץ מקורות, מהשוואות של יעדים ומדוחות אימות. - צמצום שמירת נתונים במאגר מקומי: מגדירים את השדה
googleCloudStorage.gcsPathבקובץsettings.yamlכדי להעביר שורות שנדגמו ישירות ל-Cloud Storage בלי לכתוב אותן בדיסק המקומי. במארחים משותפים, מחקו את ספריית העבודה המקומית של--output-dirאחרי כל הפעלה כדי להסיר מטא-נתונים מקומיים, קובצי צבירה וקובצי יומן. - הצפנת נתונים ותוצאות בשלב הביניים: לפני שמריצים את האימות, מגדירים מפתחות הצפנה בניהול הלקוח (CMEK) באמצעות Cloud Key Management Service בקטגוריית ה-Staging של Cloud Storage ובמערך הנתונים של התוצאות ב-BigQuery (כברירת מחדל
validation_results, או מערך הנתונים שצוין בשדהresults.dataset). - הגבלת הגישה להגדרות האישיות: מאחסנים את קובצי התצורה של האימות במאגר עם ניהול גרסאות שדורש סקירת קוד, או בקטגוריה של Cloud Storage שבה רק למשתמשים מהימנים יש את ההרשאה
storage.objects.create. - אכיפת גישה עם הרשאות מינימליות: מקצים ליוצר תהליך העבודה את התפקיד
roles/bigquery.dataViewerרק בקבוצות הנתונים או בטבלאות היעד שעוברות אימות, ולא בפרויקט. משתמשים במשתמש של מסד נתונים לקריאה בלבד, כמו שמתואר בקטע הגדרת הרשאות למסד הנתונים של המקור.
לפני שמתחילים
במסוף Google Cloud , בדף לבחירת הפרויקט, בוחרים או יוצרים פרויקט ב- Google Cloud שמכיל את מערכי הנתונים שלכם ב-BigQuery.
מוודאים שהחיוב מופעל בפרויקט ב- Google Cloud .
מפעילים את ממשקי ה-API של BigQuery, BigQuery Migration Service, Cloud Storage ו-Secret Manager (אם מאחסנים סיסמאות של מסדי נתונים ב-Secret Manager).
יוצרים או בוחרים קטגוריה של Cloud Storage באותו מיקום של מערך הנתונים של היעד ב-BigQuery, כדי להעביר את המטא-נתונים שחולצו ואת דגימות הנתונים. מידע נוסף זמין במאמר יצירת קטגוריה.
תפקידים והרשאות נדרשים
הרצת אימות כוללת שלושה חלקים, וכל אחד מהם יכול להתבצע על ידי חשבון משתמש אחר:
- איסוף נתונים: לקוח האימות קורא את מסד הנתונים של המקור ומעלה מטא-נתונים, צבירות ושורות שנדגמו לקטגוריית ה-staging של Cloud Storage. הוא לא קורא ל-BigQuery.
- אימות: תהליך עבודה לאימות של שירות ההעברה ל-BigQuery משווה בין הנתונים בשלב הביניים לבין טבלאות היעד. תהליך העבודה פועל עם פרטי הכניסה של חשבון המשתמש שיצר אותו, בין אם חשבון המשתמש הוא לקוח האימות,
gcloudאו מסוף Google Cloud . - צפייה בתוצאות: קריאת מערך הנתונים של התוצאות והדוחות של Cloud Storage.
לאפליקציה generate-config לא נדרשות Google Cloud הרשאות.
איסוף נתונים
כדי לקבל את ההרשאות שצריך בשביל לאסוף נתוני מקור, אתם צריכים לבקש מהאדמין לתת לכם את התפקידים הבאים ב-IAM:
- יצירת אובייקטים באחסון (
roles/storage.objectCreator) בקטגוריית ה-Staging - צפייה באובייקטים באחסון (
roles/storage.objectViewer) בקטגוריית ה-Staging -
קריאת קובצי תצורה מ-Cloud Storage:
צפייה באובייקטים באחסון (
roles/storage.objectViewer) בקטגוריית התצורה -
קריאת סיסמאות של מסד נתונים מ-Secret Manager:
גישה לסודות ב-Secret Manager (
roles/secretmanager.secretAccessor) בסוד
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
התפקידים המוגדרים מראש כוללים את ההרשאות שנדרשות לאיסוף נתוני מקור. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי לאסוף נתוני מקור, נדרשות ההרשאות הבאות:
-
storage.objects.createבקטגוריית ה-staging -
storage.objects.getבקטגוריית ה-staging -
קריאת קובצי תצורה מ-Cloud Storage:
-
storage.objects.getבקטגוריית ההגדרות האישיות -
storage.objects.listבקטגוריית ההגדרות האישיות
-
-
קריאת סיסמאות של מסד נתונים מ-Secret Manager:
secretmanager.versions.accessבסוד
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
ב---extract-only, לא נדרשות הרשאות של BigQuery או של BigQuery Migration Service כדי לאסוף נתונים. בלעדיו, הלקוח גם יוצר את תהליכי העבודה של האימות וצריך את תפקידי האימות.
אימות
כדי לקבל את ההרשאות שדרושות ליצירה ולהפעלה של תהליכי עבודה לאימות, בקשו מהאדמין להקצות לכם את התפקידים הבאים ב-IAM:
- עריכת MigrationWorkflow (
roles/bigquerymigration.editor) בפרויקט - BigQuery Job User (
roles/bigquery.jobUser) בפרויקט - BigQuery Data Viewer (
roles/bigquery.dataViewer) בכל מערך נתונים לטירגוט - BigQuery Data Editor (
roles/bigquery.dataEditor) במערך הנתונים של התוצאות - משתמש באובייקטים באחסון (
roles/storage.objectUser) בקטגוריית ה-Staging -
אם מערך הנתונים של התוצאות לא קיים:
משתמש BigQuery (
roles/bigquery.user) בפרויקט
התפקידים המוגדרים מראש האלה כוללים את ההרשאות שנדרשות כדי ליצור ולהריץ תהליכי עבודה של אימות. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי ליצור ולהריץ תהליכי עבודה של אימות, נדרשות ההרשאות הבאות:
-
bigquerymigration.workflows.createבפרויקט -
bigquerymigration.workflows.getבפרויקט -
bigquery.jobs.createבפרויקט -
bigquery.tables.getבכל קבוצת נתונים של יעד -
bigquery.tables.getDataבכל קבוצת נתונים של יעד -
bigquery.datasets.getבמערך הנתונים של התוצאות -
bigquery.tables.getבמערך הנתונים של התוצאות -
bigquery.tables.createבמערך הנתונים של התוצאות -
bigquery.tables.updateבמערך הנתונים של התוצאות -
bigquery.tables.updateDataבמערך הנתונים של התוצאות -
bigquery.tables.getDataבמערך הנתונים של התוצאות -
storage.objects.getבקטגוריית ה-staging -
storage.objects.createבקטגוריית ה-staging -
storage.objects.deleteבקטגוריית ה-staging -
אם מערך הנתונים של התוצאות לא קיים:
bigquery.datasets.createבפרויקט
התפקיד roles/bigquerymigration.editor מכיל הרבה הרשאות שלא משמשות לאימות. כדי להעניק הרשאות מינימליות, מקצים תפקיד בהתאמה אישית עם ההרשאות bigquerymigration.workflows.create ו-bigquerymigration.workflows.get בלבד.
האימות רק קורא את טבלאות היעד וכותב רק במערך הנתונים של התוצאות. מומלץ ליצור מראש את מערך הנתונים של התוצאות, כדי שאף חשבון משתמש לא יצטרך הרשאה ליצירת מערכי נתונים בפרויקט.
צפייה בתוצאות
כדי לקבל את ההרשאות שדרושות לצפייה בתוצאות האימות, אתם צריכים לבקש מהאדמין לתת לכם את התפקידים הבאים ב-IAM:
- BigQuery Job User (
roles/bigquery.jobUser) בפרויקט שמכיל את מערך הנתונים של התוצאות - BigQuery Data Viewer (
roles/bigquery.dataViewer) במערך הנתונים של התוצאות -
קריאת דוחות ב-Cloud Storage:
צפייה באובייקטים באחסון (
roles/storage.objectViewer) בקטגוריית ה-Staging -
הצגה של רשימת תהליכי העבודה לאימות במסוף Google Cloud :
MigrationWorkflow Viewer (
roles/bigquerymigration.viewer) בפרויקט
התפקידים המוגדרים מראש האלה כוללים את ההרשאות שנדרשות כדי לראות את תוצאות האימות. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי לראות את תוצאות האימות, צריך את ההרשאות הבאות:
-
bigquery.jobs.createבפרויקט -
bigquery.tables.getבמערך הנתונים של התוצאות -
bigquery.tables.getDataבמערך הנתונים של התוצאות -
קריאת דוחות ב-Cloud Storage:
-
storage.objects.getבקטגוריית ה-staging -
storage.objects.listבקטגוריית ה-staging
-
-
מציגים את תהליכי העבודה של האימות במסוף Google Cloud :
-
bigquerymigration.workflows.listבפרויקט -
bigquerymigration.workflows.getבפרויקט
-
הגדרת הרשאות למסד הנתונים של המקור
צריך להגדיר הרשאת קריאה בלבד למשתמש במסד הנתונים של המקור עם ההרשאות הבאות:
SELECTבכל טבלת מקור שעוברת אימות.- גישת קריאה לתצוגות של קטלוג המערכת שמשמשות לגילוי סכימה ומפתח ראשי (כמו טבלאות
information_schema,ALL_CONSTRAINTSו-ALL_TAB_COLUMNSב-Oracle, אוSVV_COLUMNSו-pg_attributeב-Amazon Redshift).
אל תתנו למשתמש הזה הרשאות כתיבה, DDL או הרשאות אדמין. לקוח האימות מריץ SQL מהגדרות האימות שלכם בתור המשתמש הזה. מידע נוסף זמין במאמר שיקולים בנושא טיפול בנתונים ואבטחה.
מגבלות
שירות האימות כפוף למגבלות הבאות:
- מסד הנתונים היחיד שאפשר להשתמש בו כיעד הוא BigQuery. אי אפשר לאמת בין שני מסדי נתונים שהם לא BigQuery, או להשתמש ב-BigQuery כמקור לאימות.
- מערך הנתונים שלכם ב-BigQuery, מערך הנתונים של התוצאות (
validation_resultsכברירת מחדל, או מערך הנתונים בהתאמה אישית שהוגדר בקטעresultsב-settings.yaml), קטגוריית ה-Staging ב-Cloud Storage והמיקום של תהליך העבודה לאימות (BQMS_VALIDATION_LOCATION) צריכים להיות באותו מיקום. כששירות האימות יוצר את מערך הנתונים של התוצאות, הוא מגדיר כברירת מחדל את מיקום מערך הנתונים לאזור שבו נמצאים קטגוריית ה-Staging ב-Cloud Storage ומערך הנתונים של היעד ב-BigQuery, או ל-results.locationאם הוא הוגדר באופן מפורש. - התמיכה בסוגי הנתונים משתנה בהתאם למקור. עמודות עם סוגים לא נתמכים לא נכללות באימות. לפרטים נוספים, ראו מחסני נתונים נתמכים.
- התפוגה של טבלאות ההשוואה שנוצרו ב-BigQuery לכל הרצה מתרחשת באופן אוטומטי על סמך
resultTtlHoursב-settings.yaml, שמוגדר כברירת מחדל ל-168.0שעות או לשבעה ימים. אל תגדירו תפוגת ברירת מחדל לטבלה ברמת מערך הנתונים במערך הנתוניםvalidation_results, כי זה יגרום גם לתפוגה של טבלאות ביקורת עם משך חיים ארוך, כמוrun_history,run_metricsו-column_history. - שמות של טבלאות ב-BigQuery הם תלויי אותיות רישיות. כש-
generate-configיוצר הגדרות מארכיון מטא-נתונים של כליdwh-migration-dumperבלי מיפוי תרגום שלtables.yaml, שמות טבלאות היעד שומרים על אותיות רישיות או קטנות של מזהה המקור. לדוגמה, שמות של טבלאות באותיות רישיות מ-Oracle או מ-Snowflake. מוודאים שהערך שלtargetTable.nameתואם בדיוק לאותיות הרישיות והקטנות של הטבלה ב-BigQuery.
מחסני נתונים נתמכים
שירות האימות תומך במסדי הנתונים הבאים כמקור. כל קטע כולל את מנהל ההתקן של JDBC שמצורף להתקנה, אם אפשר ליצור הגדרות של טבלאות באופן אוטומטי מארכיון מטא-נתונים של כלי dwh-migration-dumper, סוגי החלוקה למחיצות שנתמכים בטבלאות גדולות ממסד הנתונים הזה וסוגי הנתונים שנתמכים לאימות.
- Teradata
- פתית שלג
- Amazon Redshift
- Databricks
- Apache Hive
- שרת SQL
- MariaDB
- MySQL
- Oracle
- PostgreSQL
יש גם תמיכה בווריאציות עם פרמטרים של סוגי הנתונים הנתמכים, כמו VARCHAR(255) או DECIMAL(10,2).
שירות האימות טוען את כל קובצי ה-JAR בספרייה drivers/ לפני מנהלי ההתקנים שהורדו באופן אוטומטי, כך שאפשר גם להשתמש ב-drivers/ כדי לשנות גרסה של מנהל התקן שמצורף לחבילה.
אם יוצרים באופן אוטומטי קובץ תצורה של אימות, עמודות עם סוגי נתונים לא נתמכים מתווספות באופן אוטומטי אל columnSettings.exclude. בהגדרות ידניות, צריך להחריג אותם באופן מפורש ב-columnSettings.exclude.
ברוב מסדי הנתונים הנתמכים של המקור, כלי האימות מוריד באופן אוטומטי את מנהל ההתקן הנדרש של JDBC מ-Maven Central בשימוש הראשון, מאמת את סיכום הביקורת (checksum) שלו ב-SHA-256 ושומר אותו במטמון באופן מקומי ב-~/.cache/google-cloud-bqms/drivers/ (או ב-$XDG_CACHE_HOME/google-cloud-bqms/drivers/). במחסני נתונים שמשתמשים במנהלי התקנים קנייניים, כמו Teradata, או כשפועלים בסביבה אופליין או עם air gap, צריך לבצע את הפעולות הבאות:
- ממקמים את קובץ ה-JAR של הדרייבר הנדרש ב-
./drivers/, ב-<sdk_root>/platform/bqms/drivers/או בספרייה שצוינה על ידי משתנה הסביבהBQMS_DRIVER_DIR. כל קובץ JAR של מנהל התקן שמוצב בספריות המקומיות האלה מקבל עדיפות על פני הורדות אוטומטיות של Maven Central. - כדי להשבית לחלוטין הורדות אוטומטיות מהרשת בסביבות עם air gap, צריך להגדיר את
BQMS_AUTO_DOWNLOAD_DRIVERS=falseאו להגדיר אתBQMS_MAVEN_MIRRORכך שיצביע על מאגר Maven פנימי.
כדי לקבל מידע על כל מקור נתונים שנתמך בשירות האימות, בוחרים באחת מהאפשרויות הבאות:
Teradata
האימותים של העברות מ-Teradata נתמכים באופן הבא:
- ערך
dialect:teradata - מנהל התקן JDBC: מסופק על ידי המשתמש. מורידים את קובץ ה-JAR של מנהל ההתקן של Teradata JDBC, כמו
terajdbc4.jarאוterajdbc.jar, מ-Teradata ומעתיקים אותו לספרייהdrivers/או לספרייה שצוינה על ידיBQMS_DRIVER_DIR. - יצירת הגדרות באופן אוטומטי: נתמכת מארכיון מטא-נתונים של כלי
dwh-migration-dumper(--connector teradata). - חילוץ מחולק למחיצות:
INTEGER_RANGE,PHYSICAL
| קטגוריה | סוגי הנתונים |
|---|---|
| Numeric | BYTEINT, SMALLINT, INTEGER, INT, BIGINT, DECIMAL, DEC, NUMERIC, NUMBER, FLOAT, REAL, DOUBLE PRECISION |
| String | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, LONG VARCHAR |
| תאריך ושעה | DATE, TIME, TIME WITH TIME ZONE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
כשמאמתים העברות מ-Teradata, חשוב לשים לב לנקודות הבאות:
- אם לטבלה אין מפתח ראשי מפורש, מפתחות ההשוואה מזוהים מאינדקסים ראשיים ייחודיים (
UPI) או מאינדקסים משניים ייחודיים (USI). אינדקסים ראשיים לא ייחודיים (NUPI) לא משמשים כמפתחות השוואה. - יש תמיכה ב-
NUMBER(P,S)עם דיוק קבוע, אבל אין תמיכה ב-NUMBERללא אילוצים (בלי דיוק). עמודות לא מוגבלות מסוגNUMBER,CLOB,BLOB,BYTE,VARBYTE,INTERVAL,PERIOD,JSONו-XMLמוחרגות באופן אוטומטי על ידיgenerate-config(או שצריך לציין אותן ב-columnSettings.excludeבהגדרות ידניות). - עמודות
CHARברוחב קבוע נחתכות באופן אוטומטי. יש תמיכה בקבוצות התוויםLATINו-UNICODEובמאפייניםCASESPECIFICו-NOT CASESPECIFIC. - הערכים של
TIME WITH TIME ZONEו-TIMESTAMP WITH TIME ZONEעוברים נורמליזציה ל-UTC (AT 0) לפני ההשוואה.
פתית שלג
אלה סוגי האימותים שנתמכים בהעברות מ-Snowflake:
- ערך
dialect:snowflake - מנהל התקן JDBC: הורדה אוטומטית בשימוש הראשון (
net.snowflake:snowflake-jdbc), או שהמשתמש מספק אותו בספרייהdrivers/לסביבות אופליין. - יצירת הגדרות באופן אוטומטי: נתמכת מארכיון מטא-נתונים של כלי
dwh-migration-dumper(--connector snowflake). - חילוץ מחולק למחיצות:
INTEGER_RANGE,DATE_RANGE
שירות האימות תומך בסוגי הנתונים הבאים להעברות מ-Snowflake:
| קטגוריה | סוגי הנתונים |
|---|---|
| Numeric | NUMBER, DECIMAL, NUMERIC, FLOAT, REAL, DOUBLE |
| String | CHAR, VARCHAR, STRING, TEXT |
| תאריך ושעה | DATE, TIME, TIMESTAMP_NTZ, TIMESTAMP_LTZ, TIMESTAMP_TZ |
| בוליאני | BOOLEAN |
כשמאמתים העברות מ-Snowflake, חשוב להביא בחשבון את הדברים הבאים:
- עמודות
CHARברוחב קבוע נחתכות באופן אוטומטי. - אם שכפלתם נתונים באמצעות שירות העברת הנתונים ל-BigQuery, הגדירו את
tolerances.timestamp: 0.001כך שיספוג עיגול של פחות מאלפית השנייה.
Amazon Redshift
האימותים של העברות מ-Amazon Redshift נתמכים באופן הבא:
- ערך
dialect:redshift - מנהל התקן JDBC: הורדה אוטומטית בשימוש הראשון (
com.amazon.redshift:redshift-jdbc42), או שהמשתמש מספק אותו בספרייהdrivers/לסביבות אופליין. - יצירת הגדרות באופן אוטומטי: נתמכת מארכיון מטא-נתונים של כלי
dwh-migration-dumper(--connector redshift). - חילוץ מחולק למחיצות:
INTEGER_RANGE,PHYSICAL
שירות האימות תומך בסוגי הנתונים הבאים להעברות מ-Amazon Redshift:
| קטגוריה | סוגי הנתונים |
|---|---|
| Numeric | SMALLINT, INTEGER, BIGINT, DECIMAL, NUMERIC, REAL, DOUBLE PRECISION |
| String | CHAR, VARCHAR, TEXT |
| תאריך ושעה | DATE, TIME, TIMETZ, TIMESTAMP, TIMESTAMPTZ |
| בוליאני | BOOLEAN |
| מובנה למחצה | SUPER |
כשמאמתים העברות מ-Amazon Redshift, חשוב להביא בחשבון את הדברים הבאים:
- בדיקת הסכימה משתמשת ב-
SVV_COLUMNS, ולכן יש תמיכה בתצוגות עם קישור מאוחר. - אם בטבלה אין מפתח ראשי, מפתחות ההשוואה חוזרים באופן אוטומטי לעמודה אחת מסוג
DISTKEYאוSORTKEY. - אין תמיכה בעמודות מסוג
GEOMETRY.
Databricks
אפשר לבצע אימותים של העברות מ-Databricks באופן הבא:
- ערך
dialect:databricks - מנהל התקן JDBC: הורדה אוטומטית בשימוש הראשון (
com.databricks:databricks-jdbc), או שהמשתמש מספק אותו בספרייהdrivers/לסביבות אופליין. - יצירת הגדרות באופן אוטומטי: לא נתמכת. יוצרים קובץ תצורה ידני לטבלה.
- חילוץ מחולק למחיצות:
INTEGER_RANGE
שירות האימות תומך בסוגי הנתונים הבאים להעברות מ-Databricks:
| קטגוריה | סוגי הנתונים |
|---|---|
| Numeric | BYTE, TINYINT, SHORT, SMALLINT, INT, INTEGER, LONG, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, STRING |
| תאריך ושעה | DATE, TIMESTAMP |
| בוליאני | BOOLEAN |
| בינארי | BINARY |
| רמה למתקדמים מאוד | ARRAY, MAP, STRUCT |
כשמאמתים העברות מ-Databricks, חשוב להביא בחשבון את הדברים הבאים:
- אימות באמצעות אסימון גישה אישי: מגדירים את
user: tokenומספקים את האסימון דרךpasswordSecret. - בדיקת הסכימה מבוססת על שאילתות (
SELECT * ... WHERE 1=0), ולכן יש תמיכה גם בסביבות עבודה של Unity Catalog וגם בסביבות עבודה של Hive metastore.
Apache Hive
אלה סוגי האימותים שנתמכים בהעברות של Apache Hive:
- ערך
dialect:hive - מנהל התקן JDBC: הורדה אוטומטית בשימוש הראשון (קובץ JAR עצמאי של
org.apache.hive:hive-jdbc), או קובץ שהמשתמש מספק בספרייהdrivers/לסביבות אופליין. - יצירת הגדרות באופן אוטומטי: נתמכת מארכיון מטא-נתונים של כלי
dwh-migration-dumper(--connector hiveql). - חילוץ מחולק למחיצות:
INTEGER_RANGE
שירות האימות תומך בסוגי הנתונים הבאים להעברות מ-Hive:
| קטגוריה | סוגי הנתונים |
|---|---|
| Numeric | TINYINT, SMALLINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, STRING |
| תאריך ושעה | DATE, TIMESTAMP |
| בוליאני | BOOLEAN |
| בינארי | BINARY |
| רמה למתקדמים מאוד | ARRAY, MAP, STRUCT |
כשמאמתים העברות מ-Hive, חשוב להביא בחשבון את הדברים הבאים:
- בדיקת הסכימה מבוססת על שאילתות (
SELECT * ... WHERE 1=0). - בטבלאות Hive כמעט אף פעם לא מוגדרים מפתחות ראשיים. בטבלאות ללא מפתחות השוואה, המערכת משתמשת באופן אוטומטי בצבירת גיבוב (hash) של שורה מלאה בעמודת הנתונים.
שרת SQL
אלה סוגי האימותים שנתמכים בהעברות של SQL Server:
- ערך
dialect:sqlserver - מנהל התקן JDBC: הורדה אוטומטית בשימוש הראשון (
com.microsoft.sqlserver:mssql-jdbc), או שהמשתמש מספק אותו בספרייהdrivers/לסביבות אופליין. - יצירת הגדרות באופן אוטומטי: נתמכת מארכיון מטא-נתונים של כלי
dwh-migration-dumper(--connector sqlserver). - חילוץ מחולק למחיצות:
INTEGER_RANGE
שירות האימות תומך בסוגי הנתונים הבאים להעברות של SQL Server:
| קטגוריה | סוגי הנתונים |
|---|---|
| Numeric | INT, BIGINT, DECIMAL, NUMERIC, FLOAT, REAL |
| String | CHAR, VARCHAR, TEXT |
| תאריך ושעה | DATE, DATETIME, TIMESTAMP |
| בוליאני | BIT |
כשמאמתים העברות מ-SQL Server, חשוב לשים לב לדברים הבאים:
- כתובת ה-URL של JDBC שמוגדרת כברירת מחדל מגדירה את
encrypt=true;trustServerCertificate=true;. אם נדרש אימות מחמיר של אישור TLS, אפשר לשנות את ההגדרה הזו באמצעות מפתח החיבורurl.
MariaDB
אלה סוגי האימותים שנתמכים בהעברות של MariaDB:
- ערך
dialect:mariadb - מנהל התקן JDBC: הורדה אוטומטית בשימוש הראשון (
org.mariadb.jdbc:mariadb-java-client), או שהמשתמש מספק אותו בספרייהdrivers/לסביבות אופליין. - יצירת תצורה אוטומטית: יוצרים קובץ תצורה של טבלה ידנית.
- חילוץ מחולק למחיצות:
INTEGER_RANGE
שירות האימות תומך בסוגי הנתונים הבאים להעברות מ-MariaDB:
| קטגוריה | סוגי הנתונים |
|---|---|
| Numeric | TINYINT, SMALLINT, MEDIUMINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| String | CHAR, VARCHAR, TINYTEXT, TEXT, MEDIUMTEXT, LONGTEXT, ENUM, SET |
| תאריך ושעה | DATE, TIME, DATETIME, TIMESTAMP, YEAR |
| אובייקטים בינאריים וגדולים | BINARY, VARBINARY, TINYBLOB, BLOB, MEDIUMBLOB, LONGBLOB |
MySQL
אלה סוגי האימותים שנתמכים בהעברות של MySQL:
- ערך
dialect:mysql - מנהל התקן JDBC: הורדה אוטומטית בשימוש הראשון (
com.mysql:mysql-connector-j), או שהמשתמש מספק אותו בספרייהdrivers/לסביבות אופליין. - יצירת תצורה אוטומטית: יוצרים קובץ תצורה של טבלה ידנית.
- חילוץ מחולק למחיצות:
INTEGER_RANGE
שירות האימות תומך בסוגי הנתונים הבאים להעברות מ-MySQL:
| קטגוריה | סוגי הנתונים |
|---|---|
| Numeric | INT, BIGINT, DECIMAL, FLOAT, DOUBLE |
| String | CHAR, VARCHAR, TEXT |
| תאריך ושעה | DATE, TIME, DATETIME, TIMESTAMP |
| בוליאני | BOOLEAN |
Oracle
האימותים של העברות מ-Oracle נתמכים באופן הבא:
- ערך
dialect:oracle - מנהל התקן JDBC: הורדה אוטומטית בשימוש הראשון (
com.oracle.database.jdbc:ojdbc11), או שהמשתמש מספק אותו בספרייהdrivers/לסביבות אופליין. - יצירת הגדרות באופן אוטומטי: נתמכת מארכיון מטא-נתונים של כלי
dwh-migration-dumper(--connector oracle). - חילוץ מחולק למחיצות:
INTEGER_RANGE,PHYSICAL
שירות האימות תומך בסוגי הנתונים הבאים להעברות מ-Oracle:
| קטגוריה | סוגי הנתונים |
|---|---|
| Numeric | NUMBER, NUMERIC, INTEGER, FLOAT, DOUBLE |
| String | CHAR, NCHAR, VARCHAR, VARCHAR2, NVARCHAR2 |
| תאריך ושעה | DATE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
| אובייקטים בינאריים וגדולים | RAW, BINARY, BLOB, CLOB, NCLOB |
כשמאמתים העברות מ-Oracle, חשוב לשים לב לדברים הבאים:
- עמודות מסוג
DATEכוללות רכיב זמן ב-Oracle. כלי האימות מחלץ עמודותDATEשל Oracle ברמת דיוק של יום (YYYY-MM-DD), כך שההבדלים בשעה ביום נחתכים.
PostgreSQL
אלה סוגי האימותים שנתמכים בהעברות של PostgreSQL:
- ערך
dialect:postgresql - מנהל התקן JDBC: הורדה אוטומטית בשימוש הראשון (
org.postgresql:postgresql), או שהמשתמש מספק אותו בספרייהdrivers/לסביבות אופליין. - יצירת הגדרות באופן אוטומטי: נתמכת מארכיון מטא-נתונים של כלי
dwh-migration-dumper(--connector postgres). - חילוץ מחולק למחיצות:
INTEGER_RANGE,DATE_RANGE,PHYSICAL
שירות האימות תומך בסוגי הנתונים הבאים להעברות מ-PostgreSQL:
| קטגוריה | סוגי הנתונים |
|---|---|
| Numeric | SMALLINT, INTEGER, BIGINT, NUMERIC, DOUBLE PRECISION |
| String | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, TEXT |
| תאריך ושעה | DATE, TIME, TIMESTAMP, TIMESTAMP WITHOUT TIME ZONE, TIMESTAMP WITH TIME ZONE, TIMESTAMPTZ |
| בוליאני | BOOLEAN |
| אחר | UUID |
כשמאמתים העברות מ-PostgreSQL, חשוב לשים לב לנקודות הבאות:
- ערכי
BIGINTשגדולים מ-2 בחזקת 53 יכולים להציג הבדלים קלים ברמת הדיוק ב-AVG(). הערכים שלSUMו-COUNTנשארים מדויקים.
הגדרת ספרייה וקבצים של הגדרות אימות
שירות האימות קורא מספריית הגדרות מודולרית בשם validation_config/, שמכילה את הקבצים הבאים:
- קובץ חיבורים למסדי נתונים: מגדיר את פרופיל החיבור למחסן הנתונים ב-
sourceואת פרופיל החיבור ל-BigQuery ב-target. - קובץ הגדרות של שלב הביניים והתוצאות: מגדיר את נתיב שלב הביניים ב-Cloud Storage (
googleCloudStorage), את הגדרת מערך הנתונים של התוצאות ב-BigQuery (results), את התפוגה של טבלת ההשוואה לכל הרצה (resultTtlHours) ואת ברירות המחדל הגלובליות האופציונליות (tolerances,aggregate,labels). - קובץ תצורה לאימות טבלאות: מכיל מיפויים לכל טבלה (
sourceTableו-targetTable), מפתחות השוואה (comparisonKeys), אסטרטגיית אימות (strategy), הגדרות חילוץ מחולקות למחיצות (partitioning) והגדרות עמודות (columnSettings).
בקטעים הבאים מוסבר איך להגדיר את ספריית ההגדרות של האימות ואיך ליצור את קובצי התצורה שנדרשים לאימות ההעברה.
יצירת ספריית הגדרות אימות
יוצרים ספריית תצורת אימות בשם validation_config/ כדי לאחסן את קובצי התצורה של האימות. אתם יכולים לאחסן את הספרייה הזו במכונה שמריצה את שירות האימות, או לאחסן אותה בקטגוריה של Cloud Storage כדי שצוות יוכל לשתף הגדרה אחת בין הרצות.
יצירת קובץ חיבורים למסד נתונים
בספריית הגדרות האימות, יוצרים קובץ בשם connections.yaml ומגדירים אותו עם המידע להתחברות למסד נתונים של מקור ולמסד נתונים של יעד ב-BigQuery.
לכל מקור של מחסן נתונים יש תכונות ודרישות ספציפיות שצריך להביא בחשבון כשיוצרים את קובץ החיבורים למסד הנתונים. מידע נוסף על כל מקור נתונים זמין במאמר מחסני נתונים נתמכים.
כשמציינים את passwordSecret בפרופיל חיבור, שירות האימות מאחזר את גרסת הסוד מ-Secret Manager במכונה של הלקוח באמצעות Application Default Credentials (ADC) מקומיים, ומעביר את הסיסמה שנפתרה ישירות למנהל ההתקן המקומי של JDBC. מסד הנתונים של המקור לא צריך גישה לרשת או גישה ל-IAM אל Google Cloud, ולכן passwordSecret פועל במסדי נתונים מקומיים ובמסדי נתונים שמתארחים בעננים אחרים, כמו Amazon Redshift או Snowflake. לחלופין, אפשר להשמיט את passwordSecret ולהגדיר את משתנה הסביבה BQMS_VALIDATION_SOURCE_PASSWORD במכונה שבה פועל שירות האימות.
כדי ליצור קובץ חיבורים למסד נתונים בשביל מחסן נתונים, בוחרים באחת מהאפשרויות הבאות:
Teradata
כדי לאמת את ההעברה מ-Teradata, צריך להגדיר את קובץ החיבורים של מסד הנתונים עם הפרטים הבאים:
connections:
source:
  dialect: teradata
  host: SOURCE_HOST
  port: 1025
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
מחליפים את מה שכתוב בשדות הבאים:
-
SOURCE_HOST: שם המארח או כתובת ה-IP של מערכת Teradata. -
SOURCE_DATABASE: השם הנדרש של מסד הנתונים ב-Teradata. -
SOURCE_USER: שם המשתמש ב-Teradata. -
SECRET_PROJECT_IDו-SECRET_ID: מזהה הפרויקט ומזהה הסוד ב-Secret Manager שמכילים את הסיסמה, או הגדרתBQMS_VALIDATION_SOURCE_PASSWORD. -
TARGET_PROJECT_ID: מזהה הפרויקט ב- Google Cloud. -
TARGET_DATASET: השם של מערך הנתונים ב-BigQuery.
פתית שלג
כדי לאמת את ההעברה מ-Snowflake, צריך להגדיר את קובץ החיבורים למסד הנתונים עם הפרטים הבאים:
connections:
source:
  dialect: snowflake
  account: SNOWFLAKE_ACCOUNT
  warehouse: SNOWFLAKE_WAREHOUSE
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  role: SNOWFLAKE_ROLE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
מחליפים את מה שכתוב בשדות הבאים:
-
SNOWFLAKE_ACCOUNT: מזהה החשבון ב-Snowflake (לדוגמה:myorg-myaccount). -
SNOWFLAKE_WAREHOUSE: המחסן הווירטואלי שמשמש להרצת שאילתות החילוץ. -
SOURCE_DATABASE: השם של מסד הנתונים ב-Snowflake. -
SOURCE_SCHEMA: שם הסכימה הנדרש של Snowflake. -
SNOWFLAKE_ROLE: תפקיד אופציונלי ב-Snowflake. -
SOURCE_USER: שם המשתמש ב-Snowflake. -
SECRET_PROJECT_IDו-SECRET_ID: מזהה הפרויקט ומזהה הסוד ב-Secret Manager שמכיל את הסיסמה, או הגדרתBQMS_VALIDATION_SOURCE_PASSWORD. -
TARGET_PROJECT_ID: מזהה הפרויקט ב- Google Cloud. -
TARGET_DATASET: השם של מערך הנתונים ב-BigQuery.
Amazon Redshift
כדי לאמת את ההעברה מ-Amazon Redshift, צריך להגדיר את קובץ החיבורים של מסד הנתונים עם הפרטים הבאים:
connections:
source:
  dialect: redshift
  host: SOURCE_HOST
  port: 5439
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
מחליפים את מה שכתוב בשדות הבאים:
-
SOURCE_HOST: שם המארח של נקודת הקצה של אשכול Amazon Redshift. -
SOURCE_DATABASE: השם הנדרש של מסד הנתונים ב-Amazon Redshift. -
SOURCE_SCHEMA: שם הסכימה שמוגדרת כברירת מחדל (אם לא מציינים שם, ברירת המחדל היאpublic). -
SOURCE_USER: שם המשתמש של מסד הנתונים. -
SECRET_PROJECT_IDו-SECRET_ID: מזהה הפרויקט ומזהה הסוד ב-Secret Manager שמכילים את הסיסמה, או הגדרתBQMS_VALIDATION_SOURCE_PASSWORD. -
TARGET_PROJECT_ID: מזהה הפרויקט ב- Google Cloud. -
TARGET_DATASET: השם של מערך הנתונים ב-BigQuery.
Databricks
כדי לאמת את ההעברה של Databricks, צריך להגדיר את קובץ החיבורים של מסד הנתונים עם הפרטים הבאים:
connections:
source:
  dialect: databricks
  host: DATABRICKS_HOST
  port: 443
  httpPath: HTTP_PATH
  catalog: CATALOG_NAME
  schema: SCHEMA_NAME
  user: token
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
מחליפים את מה שכתוב בשדות הבאים:
-
DATABRICKS_HOST: שם המארח של השרת של מחסן הנתונים או האשכול של Databricks SQL. -
HTTP_PATH: נתיב ה-HTTP של מחסן הנתונים ב-Databricks SQL (לדוגמה,sql/protocolv1/o/1234567890/0123-456789-abcdef). -
CATALOG_NAME: השם הנדרש של Unity Catalog (אוhive_metastore). -
SCHEMA_NAME: שם הסכימה הנדרשת. -
SECRET_PROJECT_IDו-SECRET_ID: מזהה הפרויקט ומזהה הסוד ב-Secret Manager שמכיל את טוקן הגישה האישית (PAT) של Databricks, או השמטה שלpasswordSecretוהגדרה שלBQMS_VALIDATION_SOURCE_PASSWORD. השימוש ב-user: tokenעםpasswordSecretמבטיח שהאסימון לא ייכתב אף פעם לקובצי מטא-נתונים זמניים. -
TARGET_PROJECT_ID: מזהה הפרויקט ב- Google Cloud. -
TARGET_DATASET: השם של מערך הנתונים ב-BigQuery.
Apache Hive
כדי לאמת את ההעברה של Apache Hive, צריך להגדיר את קובץ החיבורים למסד הנתונים עם הפרטים הבאים:
connections:
source:
  dialect: hive
  host: SOURCE_HOST
  port: 10000
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
מחליפים את מה שכתוב בשדות הבאים:
-
SOURCE_HOST: שם המארח או כתובת ה-IP של HiveServer2. -
SOURCE_DATABASE: השם של מסד הנתונים הנדרש של Hive (לדוגמה,default). -
SOURCE_USER: שם המשתמש ב-Hive. -
SECRET_PROJECT_IDו-SECRET_ID: מזהה הפרויקט ומזהה הסוד ב-Secret Manager שמכילים את הסיסמה, או הגדרתBQMS_VALIDATION_SOURCE_PASSWORD. -
TARGET_PROJECT_ID: מזהה הפרויקט ב- Google Cloud. -
TARGET_DATASET: השם של מערך הנתונים ב-BigQuery.
שרת SQL
כדי לאמת את ההעברה של SQL Server, צריך להגדיר את קובץ החיבורים של מסד הנתונים עם הפרטים הבאים:
connections:
source:
  dialect: sqlserver
  host: SOURCE_HOST
  port: 1433
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
מחליפים את מה שכתוב בשדות הבאים:
-
SOURCE_HOST: שם המארח או כתובת ה-IP של המכונה של SQL Server (אפשר לציין אתinstanceNameלמכונות עם שם). -
SOURCE_DATABASE: שם מסד הנתונים הנדרש. -
SOURCE_SCHEMA: שם הסכימה שמוגדרת כברירת מחדל (אם לא מציינים שם, ברירת המחדל היאdbo). -
SOURCE_USER: שם המשתמש של מסד הנתונים. -
SECRET_PROJECT_IDו-SECRET_ID: מזהה הפרויקט ומזהה הסוד ב-Secret Manager שמכילים את הסיסמה, או הגדרתBQMS_VALIDATION_SOURCE_PASSWORD. -
TARGET_PROJECT_ID: מזהה הפרויקט ב- Google Cloud. -
TARGET_DATASET: השם של מערך הנתונים ב-BigQuery.
MariaDB
כדי לאמת את ההעברה של MariaDB, צריך להגדיר את קובץ החיבורים של מסד הנתונים עם הפרטים הבאים:
connections:
source:
  dialect: mariadb
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
מחליפים את מה שכתוב בשדות הבאים:
-
SOURCE_HOST: שם המארח או כתובת ה-IP של שרת MariaDB. -
SOURCE_DATABASE: השם של מסד הנתונים הנדרש ב-MariaDB. -
SOURCE_USER: שם המשתמש ב-MariaDB. -
SECRET_PROJECT_IDו-SECRET_ID: מזהה הפרויקט ומזהה הסוד ב-Secret Manager שמכילים את הסיסמה, או הגדרתBQMS_VALIDATION_SOURCE_PASSWORD. -
TARGET_PROJECT_ID: מזהה הפרויקט ב- Google Cloud. -
TARGET_DATASET: השם של מערך הנתונים ב-BigQuery.
MySQL
כדי לאמת את ההעברה של MySQL, צריך להגדיר את קובץ החיבורים של מסד הנתונים עם הפרטים הבאים:
connections:
source:
  dialect: mysql
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
מחליפים את מה שכתוב בשדות הבאים:
-
SOURCE_HOST: שם המארח או כתובת ה-IP של שרת MySQL. -
SOURCE_DATABASE: השם של מסד הנתונים הנדרש ב-MySQL. -
SOURCE_USER: שם המשתמש ב-MySQL. -
SECRET_PROJECT_IDו-SECRET_ID: מזהה הפרויקט ומזהה הסוד ב-Secret Manager שמכילים את הסיסמה, או הגדרתBQMS_VALIDATION_SOURCE_PASSWORD. -
TARGET_PROJECT_ID: מזהה הפרויקט ב- Google Cloud. -
TARGET_DATASET: השם של מערך הנתונים ב-BigQuery.
Oracle
כדי לאמת את ההעברה מ-Oracle, צריך להגדיר את קובץ החיבורים למסד הנתונים עם הפרטים הבאים:
connections:
source:
  dialect: oracle
  host: SOURCE_HOST
  port: 1521
  database: SERVICE_NAME
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
מחליפים את מה שכתוב בשדות הבאים:
-
SOURCE_HOST: שם המארח או כתובת ה-IP של שרת Oracle. -
SERVICE_NAME: שם השירות של Oracle (שמשמש ליצירתjdbc:oracle:thin:@//HOST:PORT/SERVICE_NAME). בחיבורים מותאמים אישית של TNS או SID, צריך לציין במקום זאת אתurlעם כתובת ה-URL המלאה של JDBC. -
SOURCE_SCHEMA: שם סכימה אופציונלי שמוגדר כברירת מחדל. -
SOURCE_USER: שם המשתמש הנדרש ב-Oracle. -
SECRET_PROJECT_IDו-SECRET_ID: מזהה הפרויקט ומזהה הסוד ב-Secret Manager שמכילים את הסיסמה למסד הנתונים, או הגדרתBQMS_VALIDATION_SOURCE_PASSWORD. -
TARGET_PROJECT_ID: מזהה הפרויקט ב- Google Cloud. -
TARGET_DATASET: השם של מערך הנתונים ב-BigQuery.
PostgreSQL
כדי לאמת את ההעברה של PostgreSQL, צריך להגדיר את קובץ החיבורים של מסד הנתונים עם הפרטים הבאים:
connections:
source:
  dialect: postgresql
  host: SOURCE_HOST
  port: 5432
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
מחליפים את מה שכתוב בשדות הבאים:
-
SOURCE_HOST: שם המארח או כתובת ה-IP של שרת PostgreSQL. -
SOURCE_DATABASE: השם של מסד הנתונים הנדרש ב-PostgreSQL. -
SOURCE_SCHEMA: שם הסכימה שמוגדרת כברירת מחדל (אם לא מציינים שם, ברירת המחדל היאpublic). -
SOURCE_USER: שם המשתמש של מסד הנתונים. -
SECRET_PROJECT_IDו-SECRET_ID: מזהה הפרויקט ומזהה הסוד ב-Secret Manager שמכיל את הסיסמה למסד הנתונים. לחלופין, אפשר להשמיט אתpasswordSecretולהגדיר את משתנה הסביבהBQMS_VALIDATION_SOURCE_PASSWORD. -
TARGET_PROJECT_ID: מזהה הפרויקט ב- Google Cloud שמכיל את הטבלאות שהועברו ל-BigQuery, ושבו ייווצר מערך הנתוניםvalidation_results. -
TARGET_DATASET: השם של מערך הנתונים ב-BigQuery.
יצירת קובץ הגדרות
כדי להגדיר את נתיב ה-staging ב-Cloud Storage, את מערך הנתונים של התוצאות ב-BigQuery, את תפוגת התוקף של הטבלה לכל הרצה ואת ברירות המחדל הגלובליות האופציונליות, יוצרים קובץ הגדרות של staging ותוצאות בשם settings.yaml בספריית ההגדרות של האימות.
מגדירים את קובץ ההגדרות של שלב הביניים והתוצאות באופן הבא:
googleCloudStorage:
  gcsPath: gs://BUCKET_NAME/PATH_PREFIX
  format: FORMAT

results:
  projectId: RESULTS_PROJECT_ID
  dataset: RESULTS_DATASET
  location: RESULTS_LOCATION

resultTtlHours: RESULT_TTL_HOURS
results: RESULTS_CONFIG
מחליפים את מה שכתוב בשדות הבאים:
-
BUCKET_NAME: השם של קטגוריית ה-Staging ב-Cloud Storage. -
PATH_PREFIX: הקידומת של ה-URI של Cloud Storage בקטגוריה שמשמשת להכנת מטא-נתונים של סכימה שחולצה, מדדים נצברים, שורות שנדגמו ודוחות סיכום. -
FORMAT: פורמט הקובץ של דגימות הנתונים בשלב הביניים. הערכים הנתמכים הםparquet(ברירת מחדל) ו-csv. -
RESULTS_PROJECT_ID: מזהה הפרויקט ב- Google Cloud שבו נכתבות טבלאות היסטוריית ההרצה ותוצאות האימות. אם לא מציינים את הפרמטר, ערך ברירת המחדל הואtarget.projectIdמ-connections.yaml. -
RESULTS_DATASET: השם של מערך הנתונים ב-BigQuery שבו נכתבות טבלאות של תוצאות האימות והיסטוריית ההרצה (run_history,run_metricsו-column_history). אם לא מציינים ערך, ברירת המחדל היאvalidation_results. אם מערך הנתונים לא קיים, שירות האימות יוצר אותו באופן אוטומטי. -
RESULTS_LOCATION: המיקום ב-BigQuery של מערך הנתונים של התוצאות. אם לא מציינים אזור, כברירת מחדל, מערך הנתונים של התוצאות שנוצר באופן אוטומטי מוגדר לאזור של קטגוריית ה-Staging ב-Cloud Storage ומערך הנתונים של היעד ב-BigQuery. -
RESULT_TTL_HOURS: משך החיים בשעות של טבלאות ההשוואה ואי-ההתאמה שנוצרו במערך הנתונים של התוצאות לכל הרצה. ברירת המחדל היא168.0שעות (7 ימים). טבלאות תצפיתיות לטווח ארוך (run_history,run_metricsו-column_history) לא מושפעות מ-resultTtlHours. -
RESULTS_CONFIG: מגדיר את קבוצת הנתונים של היעד ב-BigQuery לתוצאות ההשוואה ולהיסטוריית הביקורת. הערכים הנתמכים הםprojectId,datasetו-location. אם משמיטים את הפרמטר, שירות האימות כותב ל-TARGET_PROJECT_ID.validation_results` ויוצר באופן אוטומטי את מערך הנתונים באותו אזור של מערך הנתונים המיועד ושל קטגוריית ה-Staging ב-Cloud Storage, אם הוא עדיין לא קיים.
אפשר גם לציין ברירות מחדל גלובליות לטבלאות על ידי ציון tolerances, aggregate או labels ברמה העליונה של settings.yaml או validation-config.yaml. הגדרות ברירת המחדל האלה חלות על כל הטבלאות, אלא אם משנים אותן בהגדרות של טבלה ספציפית.
יצירת הגדרות אימות לטבלאות
אחרי שמגדירים את קובצי החיבורים וההגדרות, מגדירים את הגדרות האימות של הטבלה. הפקודה generate-config כותבת קובץ YAML אחד לכל טבלה ב-validation_config/databases/DATABASE/SCHEMA/TABLE.yaml עם מפתח table: ברמה העליונה, או שאפשר ליצור קובץ validation_config/tables.yaml באופן ידני.
כדי לקבל מידע על יצירת הגדרות לאימות טבלאות במסד הנתונים של המקור, בחרו אחת מהאפשרויות הבאות:
Teradata
כדי לאמת את ההעברה מ-Teradata, צריך ליצור ארכיון מטא-נתונים של סכימות המקור באמצעות הכלי dwh-migration-dumper:
- מתקינים את הכלי
dwh-migration-dumper. - מריצים את
dwh-migration-dumperבמסד הנתונים של המקור כדי ליצור ארכיון מטא-נתונים של הכליdwh-migration-dumper.
מריצים את הפקודה generate-config עם ארכיון המטא-נתונים כדי ליצור קובצי תצורה לכל טבלה. אתם יכולים להשתמש בדגל --update כדי לשמור את הקבצים הקיימים של connections.yaml ו-settings.yaml שיצרתם ב-validation_config/. לדוגמה:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
אם יש לכם גם קובץ מיפוי סכימה של tables.yaml מהמתרגם של SQL באצווה, צריך לכלול את הדגל --tables-yaml, לבד או יחד עם --metadata, כדי להוסיף למיפויים של הטבלאות המתורגמות מטא-נתונים של מחיצות מקור והחרגות של סוגי נתונים מארכיון המטא-נתונים. לדוגמה:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
הפקודה generate-config תומכת בדגלים הבאים:
-
--metadata PATH_TO_METADATA_ZIP: הנתיב לארכיון מטא-נתונים (קובץ ZIP) של כליdwh-migration-dumperאו לספרייה שמכילה ארכיונים של מטא-נתונים. -
--tables-yaml PATH_TO_TABLES_YAML: הנתיב לקובץ או לספרייה של קובצי התרגום (אם יש כמה, צריך להפריד ביניהם באמצעות פסיקים).tables.yaml -
--target-dataset TARGET_DATASET: השם של מערך הנתונים ב-BigQuery שרוצים להוסיף בתחילת הרשומות שנוצרו ב-targetTable.name. -
-o, --output-dir DIRECTORY: ספריית הפלט של קובצי התצורה המודולריים. ערך ברירת המחדל הואvalidation_config. -
--schemas SCHEMA_LIST: רשימה מופרדת בפסיקים של סכימות או מסדי נתונים של מקורות שצריך לכלול (תלוי אותיות רישיות, תומך בתווים כלליים לחיפוש מסוג*). -
--tables TABLE_LIST: רשימה מופרדת בפסיקים של שמות טבלאות (TABLE,SCHEMA.TABLEאוDB.SCHEMA.TABLE) שצריך לכלול (תלוית אותיות רישיות, תומכת בתווים כלליים לחיפוש מסוג*). -
--filter-file PATH: הנתיב לקובץ שמופרד בשורות חדשות של שמות הטבלאות שרוצים לכלול (שורות שמתחילות ב-#לא נכללות). -
--update: מיזוג הטבלאות שנמצאו עם ספרייתvalidation_config/קיימת, תוך שמירה על ההגדרות הקיימות שלconnections.yaml,settings.yamlוההגדרות האישיות לכל טבלה. -
--force: מאפשר לכתוב קובצי טבלאות חדשים שהתגלו לספריית פלט לא ריקה, תוך שמירה על קובצי התצורה הקיימים של הטבלאות. -
--clean: מחיקת כל הקבצים הקיימים בספריית הפלט לפני כתיבת קבצים חדשים שנמצאו.
פתית שלג
כדי לאמת את ההעברה מ-Snowflake, צריך ליצור ארכיון מטא-נתונים של סכימות המקור באמצעות הכלי dwh-migration-dumper:
- מתקינים את הכלי
dwh-migration-dumper. - מריצים את
dwh-migration-dumperבמסד הנתונים של המקור כדי ליצור ארכיון מטא-נתונים של הכליdwh-migration-dumper.
מריצים את הפקודה generate-config עם ארכיון המטא-נתונים כדי ליצור קובצי תצורה לכל טבלה. אתם יכולים להשתמש בדגל --update כדי לשמור את הקבצים הקיימים של connections.yaml ו-settings.yaml שיצרתם ב-validation_config/. לדוגמה:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
אם יש לכם גם קובץ מיפוי סכימה של tables.yaml מהמתרגם של SQL באצווה, צריך לכלול את הדגל --tables-yaml, לבד או יחד עם --metadata, כדי להוסיף למיפויים של הטבלאות המתורגמות מפתחות אשכולות של מקורות (למחיצות של טבלאות בלי מפתח ראשי), מטא-נתונים של מחיצות פיזיות והחרגות של סוגי נתונים מארכיון המטא-נתונים. לדוגמה:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
הפקודה generate-config תומכת בדגלים הבאים:
-
--metadata PATH_TO_METADATA_ZIP: הנתיב לארכיון מטא-נתונים (קובץ ZIP) של כליdwh-migration-dumperאו לספרייה שמכילה ארכיונים של מטא-נתונים. -
--tables-yaml PATH_TO_TABLES_YAML: הנתיב לקובץ או לספרייה של קובצי התרגום (אם יש כמה, צריך להפריד ביניהם באמצעות פסיקים).tables.yaml -
--target-dataset TARGET_DATASET: השם של מערך הנתונים ב-BigQuery שרוצים להוסיף בתחילת הרשומות שנוצרו ב-targetTable.name. -
-o, --output-dir DIRECTORY: ספריית הפלט של קובצי התצורה המודולריים. ערך ברירת המחדל הואvalidation_config. -
--schemas SCHEMA_LIST: רשימה מופרדת בפסיקים של סכימות או מסדי נתונים של מקורות שצריך לכלול (תלוי אותיות רישיות, תומך בתווים כלליים לחיפוש מסוג*). -
--tables TABLE_LIST: רשימה מופרדת בפסיקים של שמות טבלאות (TABLE,SCHEMA.TABLEאוDB.SCHEMA.TABLE) שצריך לכלול (תלוית אותיות רישיות, תומכת בתווים כלליים לחיפוש מסוג*). -
--filter-file PATH: הנתיב לקובץ שמופרד בשורות חדשות של שמות הטבלאות שרוצים לכלול (שורות שמתחילות ב-#לא נכללות). -
--update: מיזוג הטבלאות שנמצאו עם ספרייתvalidation_config/קיימת, תוך שמירה על ההגדרות הקיימות שלconnections.yaml,settings.yamlוההגדרות האישיות לכל טבלה. -
--force: מאפשר לכתוב קובצי טבלאות חדשים שהתגלו לספריית פלט לא ריקה, תוך שמירה על קובצי התצורה הקיימים של הטבלאות. -
--clean: מחיקת כל הקבצים הקיימים בספריית הפלט לפני כתיבת קבצים חדשים שנמצאו.
Amazon Redshift
כדי לאמת את ההעברה מ-Amazon Redshift, צריך ליצור ארכיון ZIP של המטא-נתונים של הסכימות במקור:
- מתקינים את הכלי
dwh-migration-dumper. - מריצים את
dwh-migration-dumperבמסד הנתונים של המקור כדי ליצור ארכיון מטא-נתונים של הכליdwh-migration-dumper.
מריצים את הפקודה generate-config עם ארכיון המטא-נתונים כדי ליצור קובצי תצורה לכל טבלה. אתם יכולים להשתמש בדגל --update כדי לשמור את הקבצים הקיימים של connections.yaml ו-settings.yaml שיצרתם ב-validation_config/. לדוגמה:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
אם יש לכם גם קובץ מיפוי סכימה של tables.yaml מהמתרגם של SQL באצווה, צריך לכלול את הדגל --tables-yaml, לבד או יחד עם --metadata, כדי להוסיף למיפויים של הטבלאות המתורגמות מטא-נתונים של מחיצות מקור והחרגות של סוגי נתונים מארכיון המטא-נתונים. לדוגמה:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
הפקודה generate-config תומכת בדגלים הבאים:
-
--metadata PATH_TO_METADATA_ZIP: הנתיב לארכיון מטא-נתונים (קובץ ZIP) של כליdwh-migration-dumperאו לספרייה שמכילה ארכיונים של מטא-נתונים. -
--tables-yaml PATH_TO_TABLES_YAML: הנתיב לקובץ או לספרייה של קובצי התרגום (אם יש כמה, צריך להפריד ביניהם באמצעות פסיקים).tables.yaml -
--target-dataset TARGET_DATASET: השם של מערך הנתונים ב-BigQuery שרוצים להוסיף בתחילת הרשומות שנוצרו ב-targetTable.name. -
-o, --output-dir DIRECTORY: ספריית הפלט של קובצי התצורה המודולריים. ערך ברירת המחדל הואvalidation_config. -
--schemas SCHEMA_LIST: רשימה מופרדת בפסיקים של סכימות או מסדי נתונים של מקורות שצריך לכלול (תלוי אותיות רישיות, תומך בתווים כלליים לחיפוש מסוג*). -
--tables TABLE_LIST: רשימה מופרדת בפסיקים של שמות טבלאות (TABLE,SCHEMA.TABLEאוDB.SCHEMA.TABLE) שצריך לכלול (תלוית אותיות רישיות, תומכת בתווים כלליים לחיפוש מסוג*). -
--filter-file PATH: הנתיב לקובץ שמופרד בשורות חדשות של שמות הטבלאות שרוצים לכלול (שורות שמתחילות ב-#לא נכללות). -
--update: מיזוג הטבלאות שנמצאו עם ספרייתvalidation_config/קיימת, תוך שמירה על ההגדרות הקיימות שלconnections.yaml,settings.yamlוההגדרות האישיות לכל טבלה. -
--force: מאפשר לכתוב קובצי טבלאות חדשים שהתגלו לספריית פלט לא ריקה, תוך שמירה על קובצי התצורה הקיימים של הטבלאות. -
--clean: מחיקת כל הקבצים הקיימים בספריית הפלט לפני כתיבת קבצים חדשים שנמצאו.
Databricks
אין תמיכה ביצירת הגדרות אוטומטיות ב-Databricks. יוצרים קובץ tables.yaml באופן ידני בספרייה validation_config/ עם ההגדרות הבאות:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Apache Hive
כדי לאמת את ההעברה של Apache Hive, צריך ליצור ארכיון ZIP של המטא-נתונים של הסכימות במקור:
- מתקינים את הכלי
dwh-migration-dumper. - מריצים את
dwh-migration-dumperבמסד הנתונים של המקור כדי ליצור ארכיון מטא-נתונים של הכליdwh-migration-dumper.
מריצים את הפקודה generate-config עם ארכיון המטא-נתונים כדי ליצור קובצי תצורה לכל טבלה. אתם יכולים להשתמש בדגל --update כדי לשמור את הקבצים הקיימים של connections.yaml ו-settings.yaml שיצרתם ב-validation_config/. לדוגמה:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
אם יש לכם גם קובץ מיפוי סכימה של tables.yaml מהמתרגם של SQL באצווה, צריך לכלול את הדגל --tables-yaml, לבד או יחד עם --metadata, כדי להוסיף למיפויים של הטבלאות המתורגמות מטא-נתונים של מחיצות מקור והחרגות של סוגי נתונים מארכיון המטא-נתונים. לדוגמה:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
הפקודה generate-config תומכת בדגלים הבאים:
-
--metadata PATH_TO_METADATA_ZIP: הנתיב לארכיון מטא-נתונים (קובץ ZIP) של כליdwh-migration-dumperאו לספרייה שמכילה ארכיונים של מטא-נתונים. -
--tables-yaml PATH_TO_TABLES_YAML: הנתיב לקובץ או לספרייה של קובצי התרגום (אם יש כמה, צריך להפריד ביניהם באמצעות פסיקים).tables.yaml -
--target-dataset TARGET_DATASET: השם של מערך הנתונים ב-BigQuery שרוצים להוסיף בתחילת הרשומות שנוצרו ב-targetTable.name. -
-o, --output-dir DIRECTORY: ספריית הפלט של קובצי התצורה המודולריים. ערך ברירת המחדל הואvalidation_config. -
--schemas SCHEMA_LIST: רשימה מופרדת בפסיקים של סכימות או מסדי נתונים של מקורות שצריך לכלול (תלוי אותיות רישיות, תומך בתווים כלליים לחיפוש מסוג*). -
--tables TABLE_LIST: רשימה מופרדת בפסיקים של שמות טבלאות (TABLE,SCHEMA.TABLEאוDB.SCHEMA.TABLE) שצריך לכלול (תלוית אותיות רישיות, תומכת בתווים כלליים לחיפוש מסוג*). -
--filter-file PATH: הנתיב לקובץ שמופרד בשורות חדשות של שמות הטבלאות שרוצים לכלול (שורות שמתחילות ב-#לא נכללות). -
--update: מיזוג הטבלאות שנמצאו עם ספרייתvalidation_config/קיימת, תוך שמירה על ההגדרות הקיימות שלconnections.yaml,settings.yamlוההגדרות האישיות לכל טבלה. -
--force: מאפשר לכתוב קובצי טבלאות חדשים שהתגלו לספריית פלט לא ריקה, תוך שמירה על קובצי התצורה הקיימים של הטבלאות. -
--clean: מחיקת כל הקבצים הקיימים בספריית הפלט לפני כתיבת קבצים חדשים שנמצאו.
שרת SQL
כדי לאמת את ההעברה של SQL Server, צריך ליצור ארכיון מטא-נתונים של סכימות המקור באמצעות הכלי dwh-migration-dumper:
- מתקינים את הכלי
dwh-migration-dumper. - מריצים את
dwh-migration-dumperבמסד הנתונים של המקור כדי ליצור ארכיון מטא-נתונים של הכליdwh-migration-dumper.
מריצים את הפקודה generate-config עם ארכיון המטא-נתונים כדי ליצור קובצי תצורה לכל טבלה. אתם יכולים להשתמש בדגל --update כדי לשמור את הקבצים הקיימים של connections.yaml ו-settings.yaml שיצרתם ב-validation_config/. לדוגמה:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
אם יש לכם גם קובץ מיפוי סכימה של tables.yaml מהמתרגם של SQL באצווה, צריך לכלול את הדגל --tables-yaml, לבד או יחד עם --metadata, כדי להוסיף למיפויים של הטבלאות המתורגמות מטא-נתונים של מחיצות מקור והחרגות של סוגי נתונים מארכיון המטא-נתונים. לדוגמה:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
הפקודה generate-config תומכת בדגלים הבאים:
-
--metadata PATH_TO_METADATA_ZIP: הנתיב לארכיון מטא-נתונים (קובץ ZIP) של כליdwh-migration-dumperאו לספרייה שמכילה ארכיונים של מטא-נתונים. -
--tables-yaml PATH_TO_TABLES_YAML: הנתיב לקובץ או לספרייה של קובצי התרגום (אם יש כמה, צריך להפריד ביניהם באמצעות פסיקים).tables.yaml -
--target-dataset TARGET_DATASET: השם של מערך הנתונים ב-BigQuery שרוצים להוסיף בתחילת הרשומות שנוצרו ב-targetTable.name. -
-o, --output-dir DIRECTORY: ספריית הפלט של קובצי התצורה המודולריים. ערך ברירת המחדל הואvalidation_config. -
--schemas SCHEMA_LIST: רשימה מופרדת בפסיקים של סכימות או מסדי נתונים של מקורות שצריך לכלול (תלוי אותיות רישיות, תומך בתווים כלליים לחיפוש מסוג*). -
--tables TABLE_LIST: רשימה מופרדת בפסיקים של שמות טבלאות (TABLE,SCHEMA.TABLEאוDB.SCHEMA.TABLE) שצריך לכלול (תלוית אותיות רישיות, תומכת בתווים כלליים לחיפוש מסוג*). -
--filter-file PATH: הנתיב לקובץ שמופרד בשורות חדשות של שמות הטבלאות שרוצים לכלול (שורות שמתחילות ב-#לא נכללות). -
--update: מיזוג הטבלאות שנמצאו עם ספרייתvalidation_config/קיימת, תוך שמירה על ההגדרות הקיימות שלconnections.yaml,settings.yamlוההגדרות האישיות לכל טבלה. -
--force: מאפשר לכתוב קובצי טבלאות חדשים שהתגלו לספריית פלט לא ריקה, תוך שמירה על קובצי התצורה הקיימים של הטבלאות. -
--clean: מחיקת כל הקבצים הקיימים בספריית הפלט לפני כתיבת קבצים חדשים שנמצאו.
MariaDB
אין תמיכה ביצירת הגדרות אוטומטיות ב-MariaDB. יוצרים קובץ tables.yaml באופן ידני בספרייה validation_config/ עם ההגדרות הבאות:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
MySQL
יצירת הגדרות אוטומטית לא נתמכת ב-MySQL. יוצרים קובץ tables.yaml באופן ידני בספרייה validation_config/ עם ההגדרות הבאות:
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Oracle
כדי לאמת את ההעברה מ-Oracle, צריך ליצור ארכיון מטא-נתונים של סכימות המקור באמצעות הכלי dwh-migration-dumper:
- מתקינים את הכלי
dwh-migration-dumper. - מריצים את
dwh-migration-dumperבמסד הנתונים של המקור כדי ליצור ארכיון מטא-נתונים של הכליdwh-migration-dumper.
מריצים את הפקודה generate-config עם ארכיון המטא-נתונים כדי ליצור קובצי תצורה לכל טבלה. אתם יכולים להשתמש בדגל --update כדי לשמור את הקבצים הקיימים של connections.yaml ו-settings.yaml שיצרתם ב-validation_config/. לדוגמה:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
אם יש לכם גם קובץ מיפוי סכימה של tables.yaml מהמתרגם של SQL באצווה, צריך לכלול את הדגל --tables-yaml, לבד או יחד עם --metadata, כדי להוסיף למיפויים של הטבלאות המתורגמות מטא-נתונים של מחיצות מקור והחרגות של סוגי נתונים מארכיון המטא-נתונים. לדוגמה:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
הפקודה generate-config תומכת בדגלים הבאים:
-
--metadata PATH_TO_METADATA_ZIP: הנתיב לארכיון מטא-נתונים (קובץ ZIP) של כליdwh-migration-dumperאו לספרייה שמכילה ארכיונים של מטא-נתונים. -
--tables-yaml PATH_TO_TABLES_YAML: הנתיב לקובץ או לספרייה של קובצי התרגום (אם יש כמה, צריך להפריד ביניהם באמצעות פסיקים).tables.yaml -
--target-dataset TARGET_DATASET: השם של מערך הנתונים ב-BigQuery שרוצים להוסיף בתחילת הרשומות שנוצרו ב-targetTable.name. -
-o, --output-dir DIRECTORY: ספריית הפלט של קובצי התצורה המודולריים. ערך ברירת המחדל הואvalidation_config. -
--schemas SCHEMA_LIST: רשימה מופרדת בפסיקים של סכימות או מסדי נתונים של מקורות שצריך לכלול (תלוי אותיות רישיות, תומך בתווים כלליים לחיפוש מסוג*). -
--tables TABLE_LIST: רשימה מופרדת בפסיקים של שמות טבלאות (TABLE,SCHEMA.TABLEאוDB.SCHEMA.TABLE) שצריך לכלול (תלוית אותיות רישיות, תומכת בתווים כלליים לחיפוש מסוג*). -
--filter-file PATH: הנתיב לקובץ שמופרד בשורות חדשות של שמות הטבלאות שרוצים לכלול (שורות שמתחילות ב-#לא נכללות). -
--update: מיזוג הטבלאות שנמצאו עם ספרייתvalidation_config/קיימת, תוך שמירה על ההגדרות הקיימות שלconnections.yaml,settings.yamlוההגדרות האישיות לכל טבלה. -
--force: מאפשר לכתוב קובצי טבלאות חדשים שהתגלו לספריית פלט לא ריקה, תוך שמירה על קובצי התצורה הקיימים של הטבלאות. -
--clean: מחיקת כל הקבצים הקיימים בספריית הפלט לפני כתיבת קבצים חדשים שנמצאו.
PostgreSQL
כדי לאמת את ההעברה של PostgreSQL, צריך ליצור ארכיון מטא-נתונים של הכלי dwh-migration-dumper לסכימות המקור:
- מתקינים את הכלי
dwh-migration-dumper. - מריצים את
dwh-migration-dumperבמסד הנתונים של המקור כדי ליצור ארכיון מטא-נתונים של הכליdwh-migration-dumper.
מריצים את הפקודה generate-config עם ארכיון המטא-נתונים כדי ליצור קובצי תצורה לכל טבלה. אתם יכולים להשתמש בדגל --update כדי לשמור את הקבצים הקיימים של connections.yaml ו-settings.yaml שיצרתם ב-validation_config/. לדוגמה:
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
אם יש לכם גם קובץ מיפוי סכימה של tables.yaml מהמתרגם של SQL באצווה, צריך לכלול את הדגל --tables-yaml, לבד או יחד עם --metadata, כדי להוסיף למיפויים של הטבלאות המתורגמות מטא-נתונים של מחיצות מקור והחרגות של סוגי נתונים מארכיון המטא-נתונים. לדוגמה:
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
הפקודה generate-config תומכת בדגלים הבאים:
-
--metadata PATH_TO_METADATA_ZIP: הנתיב לארכיון מטא-נתונים (קובץ ZIP) של כליdwh-migration-dumperאו לספרייה שמכילה ארכיונים של מטא-נתונים. -
--tables-yaml PATH_TO_TABLES_YAML: הנתיב לקובץ או לספרייה של קובצי התרגום (אם יש כמה, צריך להפריד ביניהם באמצעות פסיקים).tables.yaml -
--target-dataset TARGET_DATASET: השם של מערך הנתונים ב-BigQuery שרוצים להוסיף בתחילת הרשומות שנוצרו ב-targetTable.name. -
-o, --output-dir DIRECTORY: ספריית הפלט של קובצי התצורה המודולריים. ערך ברירת המחדל הואvalidation_config. -
--schemas SCHEMA_LIST: רשימה מופרדת בפסיקים של סכימות או מסדי נתונים של מקורות שצריך לכלול (תלוי אותיות רישיות, תומך בתווים כלליים לחיפוש מסוג*). -
--tables TABLE_LIST: רשימה מופרדת בפסיקים של שמות טבלאות (TABLE,SCHEMA.TABLEאוDB.SCHEMA.TABLE) שצריך לכלול (תלוית אותיות רישיות, תומכת בתווים כלליים לחיפוש מסוג*). -
--filter-file PATH: הנתיב לקובץ שמופרד בשורות חדשות של שמות הטבלאות שרוצים לכלול (שורות שמתחילות ב-#לא נכללות). -
--update: מיזוג הטבלאות שנמצאו עם ספרייתvalidation_config/קיימת, תוך שמירה על ההגדרות הקיימות שלconnections.yaml,settings.yamlוההגדרות האישיות לכל טבלה. -
--force: מאפשר לכתוב קובצי טבלאות חדשים שהתגלו לספריית פלט לא ריקה, תוך שמירה על קובצי התצורה הקיימים של הטבלאות. -
--clean: מחיקת כל הקבצים הקיימים בספריית הפלט לפני כתיבת קבצים חדשים שנמצאו.
התאמה אישית של הגדרות הטבלה
כל קובץ טבלה שנוצר על ידי generate-config מכיל קטע table: שאפשר להתאים אישית לפני שמריצים את האימות. בטבלה הבאה מפורטים כל המפתחות האופציונליים שנתמכים בכל רשומה בטבלה.
| מפתח YAML אופציונלי | ערך ברירת המחדל | תיאור |
|---|---|---|
runSchema, runAggregate, runData |
true |
ערכים בוליאניים לכל טבלה כדי להפעיל או להשבית עמודי תווך ספציפיים של אימות כשלא מועברות הגדרות flag של עמודי תווך בשורת הפקודה. |
maxColumnsPerTile |
100 |
מספר העמודות המקסימלי שמקובצות למשבצת השוואה אחת בטבלאות רחבות. |
strategy |
SMART |
אסטרטגיית הביצוע של אימות הנתונים: SMART (BRUTE_FORCE פחות מ-100,000 שורות, אחרת SAMPLE), SAMPLE או BRUTE_FORCE. |
sampleSize |
70000 |
מספר השורות לחילוץ (לכל פלח כשהוא מחולק למחיצות) כשהאסטרטגיה שנפתרה היא SAMPLE. ברירת המחדל של 70,000 שורות מספקת סבירות של יותר מ-99.9% לזיהוי של לפחות שורה אחת לא תואמת כששיעור הפגמים הוא 0.01% (שורה אחת מתוך 10,000 שורות) או יותר. |
whereClause |
ללא | פרדיקט SQL (בלי מילת המפתח WHERE) שמוחל גם על שאילתות החילוץ מהמקור וגם על שאילתות ההשוואה ליעד. אפשר גם להגדיר בנפרד ב-sourceTable.whereClause וב-targetTable.whereClause. |
skipRandomization |
false |
כאשר true, קורא עד sampleSize שורות בסדר טבעי של טבלה במקום למיין לפי פונקציה אקראית, מה שמפחית את עלות השאילתה בטבלאות גדולות. |
maxConcurrency |
1 |
המספר המקסימלי של שרשורי חילוץ פרוסות מקבילים לטבלה מחולקת למחיצות. |
maxSlices |
0 (ללא הגבלה) |
המספר המקסימלי של פרוסות מחיצה שמותרות בטבלה מחולקת למחיצות. אם מספר הפרוסות המחושב חורג מ-maxSlices (כשהוא גדול מ-0), תכנון המחיצות נכשל ומוצגת שגיאה. |
disablePartitioning |
false |
כשהערך הוא true, המדיניות משביתה את החלוקה לפרוסות של הטבלה, גם אם מוגדר בלוק partitioning או שמספר השורות חורג מ-1000000. |
labels |
מפה ריקה | תוויות של מחרוזות מפתח/ערך שמצורפות למדדי הרצת האימות ב-validation_results. |
בקטעים הבאים מוסבר איך להשתמש במפתחות ה-YAML האלה כדי להתאים אישית את הרצות האימות.
בחירת שיטת אימות
משתמשים במפתח strategy ברשומת טבלה כדי לבחור אסטרטגיית אימות שקובעת איך העמודה --data מחלצת שורות ומשווה ביניהן. אלה הערכים הנתמכים:
SMART(ברירת המחדל): קודם סופר את השורות בטבלת המקור. אם בטבלה יש פחות מ-100,000 שורות, המערכת מריצה אתBRUTE_FORCE. אם בטבלה יש 100,000 שורות או יותר, המערכת מריצה אתSAMPLE.-
SAMPLE: חילוץ מדגם אקראי של שורות על סמך הערך שלsampleSize(ברירת המחדל היא70,000) וצירוף שלהן לטבלת היעד באמצעותcomparisonKeys. מדגם של 70,000 שורות נותן רמת סמך של יותר מ-99.9% לזיהוי של לפחות שורה פגומה אחת, כשב-0.01% מהשורות (אחת מתוך 10,000) יש חוסר התאמה. -
BRUTE_FORCE: חילוץ והשוואה של כל שורה במעבר שאילתה יחיד ללא חלוקה למחיצות. המערכת מתעלמת מהגדרות החלוקה למחיצות כשמשתמשים ב-BRUTE_FORCE.
הגדרת מפתחות השוואה
מפתח השוואה הוא העמודה או העמודות שמשמשות לזיהוי ייחודי ולצירוף של שורות בין מערכת המקור למערכת היעד. מפתח ההשוואה מתאר את המאפיינים שמספקים ייחודיות מספקת לשילוב יציב.
כשמריצים השוואת נתונים ברמת השורה, אפשר להגדיר מפתחות השוואה בדרכים הבאות:
- זיהוי אוטומטי: משמיטים את
comparisonKeysמהקטעsourceTableכדי שכלי האימות יזהה באופן אוטומטי את המפתחות הראשיים במסד הנתונים של המקור במהלך הבדיקה המקדימה (חזרה לאילוצים ייחודיים שלNOT NULLב-Oracle וב-Snowflake, אינדקסים ייחודיים ב-Teradata, אוDISTKEYאוSORTKEYבעמודה אחת ב-Amazon Redshift). מפתחות מורכבים או מותאמים אישית באופן ידני: מציינים באופן ידני מפתחות השוואה מורכבים או מותאמים אישית על ידי רישום שמות העמודות של מפתחות המקור ב-
comparisonKeysבקטעsourceTable. הבדלים באותיות רישיות בין שמות עמודות המפתח במקור וביעד מותאמים באופן אוטומטי. אם שיניתם את השם של עמודת מפתח להשוואה ב-BigQuery, צריך למפות אותה בקטעcolumnSettings.columns.SOURCE_COLUMN.targetColumn. בדוגמה הבאה מוגדר מפתח השוואה מורכב:table: sourceTable: name: sales_db.public.order_items comparisonKeys: - order_id - line_number targetTable: name: migrated_sales.order_items
השוואת גיבוב (hash) לטבלאות בלי מפתח ייחודי: אם לטבלה אין מפתח ראשי, מגדירים את
useAllColumnsAsKey: trueבקטעsourceTable. האפשרות הזו נבחרת באופן אוטומטי גם אם בדיקת המטא-נתונים לפני ההעלאה לא מוצאת מפתחות ראשיים.
הגדרת חילוץ מחולק למחיצות של טבלאות גדולות
כשהאסטרטגיה של הטבלה היא SAMPLE, ובלוק partitioning קיים בהגדרות של הטבלה (שכותב generate-config כברירת מחדל) או שמספר השורות בטבלה חורג מ-1,000,000, כלי האימות מפצל את הטבלה לפרוסות כדי ששאילתות הדגימה יסרקו טווחים מוגבלים במקום למיין את כל הטבלה בבת אחת. כשמבצעים חלוקה למחיצות, המערכת מחלצת עד sampleSize שורות לכל פרוסה. כדי להגביל את האימות לקבוצת משנה של שורות, צריך להשתמש במקום זאת ב-whereClause.
כדי להגדיר חילוץ מחולק למחיצות, משתמשים בבלוק partitioning בקטע table:. לדוגמה:
table:
  sourceTable:
    name: sales_db.public.orders
    comparisonKeys:
      - order_id
  targetTable:
    name: migrated_sales.orders
  strategy: SAMPLE
  maxConcurrency: 4
  maxSlices: 100
  partitioning:
    type: INTEGER_RANGE
    column: order_id
    partitionSize: 1000000
הבלוק partitioning תומך בשדות הבאים:
type:-
INTEGER_RANGE: חלוקת הטבלה למרווחים מספריים של מפתח/ערך (COLUMN BETWEEN START AND END). זהו ערך ברירת המחדל. -
DATE_RANGE: חותך את הטבלה למרווחים של תאריך או חותמת זמן. נתמך ב-PostgreSQL וב-Snowflake. -
PHYSICAL: שימוש במחיצות של מסדי נתונים לטבלאות של Oracle ו-Amazon Redshift, כשיש מטא-נתונים של מחיצות פיזיות.
-
-
column: מציין עמודה של מספר, תאריך או חותמת זמן שנוספו לאינדקס בטבלת המקור, שמשמשת לחישוב גבולות הפרוסות. שורות עם ערכיNULLבעמודת החלוקה למחיצות לא נכללות בפרוסות שמבוססות על טווח (INTEGER_RANGEו-DATE_RANGE). -
partitionSize: לסוגINTEGER_RANGE, הערך הזה מציין את רוחב הטווח המספרי של מפתח/ערך לכל פרוסה, כאשר ערך ברירת המחדל הוא1000000. בסוגDATE_RANGE, הערך הזה מציין את מספר הימים לכל פרוסה, וערך ברירת המחדל הוא30. -
maxSlices: מציין את המספר הכולל המקסימלי של פרוסות שמותרות לטבלה (מוגדר ב-table:). אם טבלה דורשת יותר פרוסות מ-maxSlices, תכנון החלוקה למחיצות נכשל עם שגיאה שדורשת ערך גדול יותר שלpartitionSizeאוmaxSlices. -
maxConcurrency: מציין את מספר ה-threads העובדים המקבילים שמשמשים לחילוץ פרוסות, כאשר ערך ברירת המחדל הוא1. ההגדרה נמצאת בקטעtable:.
התאמה אישית של בדיקות מצטברות
ניתוח נתונים נצברים מופעל כברירת מחדל ומשלים את הדגימה ברמת השורה עם בדיקות נתונים נצברים ברמת המאקרו. ההגדרה הזו שימושית לאימות טבלאות גדולות, שבהן דגימה אקראית עלולה לפספס חלוקת נתונים לא מאוזנת (partition skew) קלה.
אם לא מגדירים עמודות בהתאמה אישית, כלי האימות מחיל באופן אוטומטי בדיקות צבירה סטנדרטיות על סמך סוגי העמודות:
- ערך מספרי מדויק (
INTEGER,NUMERIC,BIGNUMERIC):COUNT,SUM,AVG,MIN,MAX - נקודה צפה (
FLOAT,DOUBLE,REAL):COUNT,MIN,MAX - בוליאני (
BOOLEAN):COUNT,COUNT_TRUE,COUNT_FALSE,COUNT_NULL - מחרוזת (
STRING,VARCHAR,CHAR,TEXT):COUNT,SUM_LENGTH - תאריך, שעה וחותמת זמן:
COUNT,MIN,MAX
אפשר להתאים אישית או להשבית בדיקות מצטברות באמצעות הקטע columnSettings. בדוגמה הבאה מוסבר איך להגדיר את טווחי הסבילות המצטברים ולבטל בדיקות ספציפיות של עמודות:
table:
  sourceTable:
    name: sales_db.public.orders
  targetTable:
    name: migrated_sales.orders
  # Set aggregate: false here to disable aggregate checks for the entire table
  columnSettings:
    aggregate:
      tolerance: 0.01
    columns:
      amount:
        aggregate:
          functions:
            - COUNT
            - SUM
            - AVG
          tolerance: 0.05
      internal_notes:
        aggregate: false
אלה כללי ההגדרה המצטברים שחלים:
- מפתחות העמודות בקטע
columnSettings.columnsחייבים להיות זהים לשם של עמודת המקור, תלוי אותיות רישיות. - הערך המצטבר
toleranceהוא סף ההפרש המוחלט (ABS(target - source) <= tolerance). אם לא מוגדר ערך מצטברtolerance(ברמת העמודה או ב-columnSettings.aggregate.tolerance) ובעמודה יש הגדרה שלtolerances.numericברמת השורה, הערכיםAVG,MINו-MAXיורשים אתtolerances.numericישירות, ואילו הערךSUMמכפיל את הטולרנס שירש ברמת השורה ב-COUNT. - אפשר לשנות רק
functionsלכל עמודה בקטעcolumnSettings.columns.SOURCE_COLUMN.aggregate.functions.
החרגת עמודות, מיפוי שמות של עמודות והחלת ביטויי השוואה ב-SQL
אפשר להשתמש ב-columnSettings כדי להחריג עמודות, להגדיר טולרנסים מספריים או זמניים, למפות עמודות יעד ששמן השתנה או להחיל טרנספורמציות SQL לפני ההשוואה. כל מפתח ב-columnSettings.columns הוא השם של עמודת המקור. אם לעמודה יש שם אחר ב-BigQuery, משתמשים במאפיין targetColumn בתוך הרשומה הזו. לדוגמה:
table:
  sourceTable:
    name: sales_db.public.customers
    comparisonKeys:
      - customer_id
  targetTable:
    name: migrated_sales.customers
  columnSettings:
    exclude:
      - etl_loaded_at
      - "temp_*"
    tolerances:
      numeric: 0.0001
      timestamp: 0.001
      date: 1
    columns:
      SOURCE_COLUMN_1:
        targetColumn: customer_full_name
        transform: TRIM
      SOURCE_COLUMN_2:
        transformExpression: "ROUND(SOURCE_COLUMN_2, 4)"
columnSettings תומך בשדות הבאים:
-
exclude: מציינים רשימה של שמות עמודות או תבניות glob (*) לא תלויות-רישיות שרוצים להחריג מכל עמודי התווך של האימות. tolerances:-
numeric: טולרנס לעמודות מספריות (ABS(target - source) <= toleranceלהשוואה מבוססת-מפתח, או מעוגל ל-ceil(-log10(tolerance))מקומות עשרוניים כש-useAllColumnsAsKey: true). -
timestamp: טולרנטיות בשניות לעמודות של חותמות זמן. לדוגמה,0.001למילי-שנייה אחת. date: טווח סטייה בימים לעמודות של תאריכים.
-
-
columns: מפה של הגדרות לכל עמודה, עם מפתח לפי שם העמודה במקור (SOURCE_COLUMN):-
targetColumn: ממפה את עמודת המקור לעמודת יעד עם שם אחר ב-BigQuery. -
transform: טרנספורמציה מובנית שבוצעה לפני ההשוואה:-
TRIM,UPPER,LOWER: נתמכים בכל הניבים. -
EMPTY_TO_NULL,NULL_TO_EMPTY,CAST_TO_STRING: נתמכים בשאילתות מקור של PostgreSQL, Amazon Redshift, Oracle ו-Teradata.
-
-
transformExpression: ביטוי SQL בהתאמה אישית שמפנה לשם המילולי של עמודת המקור. לדוגמה,"ROUND(SOURCE_COLUMN, 4)". מכיוון שהביטוי מוערך גם בשאילתת המקור וגם בשאילתת ההשוואה של BigQuery, צריך להשתמש בפונקציות SQL שתקפות גם בניב המקור וגם ב-GoogleSQL.
-
נרמול ערכים
במהלך ההשוואה ברמת השורה (--data), שירות האימות מנרמל את הערכים כדי שההבדלים בייצוג בין מנועי המקור לבין BigQuery לא יגרמו לחוסר התאמה. שירות האימות מנרמל את הערכים בדרכים הבאות:
- סוגים מספריים מדויקים (
INTEGER,NUMERIC,DECIMAL,BIGNUMERIC): בהשוואה שמבוססת על מפתחות, הערכים מושווים בקנה מידה מלא (עד 9 ספרות אחרי הנקודה העשרונית ב-NUMERIC, או עד 38 ספרות אחרי הנקודה העשרונית ב-BIGNUMERIC), וכשמגדירים אתtolerances.numeric, הערכים תואמים כשמתקיים התנאיABS(target - source) <= tolerance. בהשוואת גיבוב (hash) של שורה מלאה (useAllColumnsAsKey: true), הערכים מעוגלים ל-9 ספרות אחרי הנקודה העשרונית כברירת מחדל, או ל-ceil(-log10(tolerance))ספרות אחרי הנקודה העשרונית כשמוגדרת סבילות מספרית. - סוגים של נקודה צפה (
FLOAT,DOUBLE,REAL): עוברים נורמליזציה ל-6 ספרות אחרי הנקודה העשרונית (1e-6) כברירת מחדל. - חותמות זמן: מנורמלות ל-UTC ברמת דיוק של מיקרו-שנייה.
- סוגי תווים ברוחב קבוע (
CHAR,NCHAR,CHARACTER): רווחים בתחילת המחרוזת ובסופה נחתכים באופן אוטומטי כדי להתאים לסמנטיקה שלSTRINGב-BigQuery.
הפעלת שירות האימות
אחרי שמגדירים את האימות, מריצים את הפקודה validate כדי להפעיל את כלי האימות של ההעברה. אפשר להעביר נתיב מקומי או URI של Cloud Storage gs:// שמפנה לספרייה validation_config/.
בדוגמה הבאה, שירות האימות מופעל על קובצי תצורה של אימות שמאוחסנים באופן מקומי:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG
מחליפים את PATH_TO_VALIDATION_CONFIG בנתיב לספריית validation_config/ המודולרית.
אם הגדרות האימות מאוחסנות ב-Cloud Storage, מעבירים את ה-URI של ספריית ההגדרות האישיות של gs://:
gcloud bq migration validate gs://BUCKET_NAME/validation_config
מחליפים את BUCKET_NAME בשם של הקטגוריה ב-Cloud Storage.
כברירת מחדל, שירות האימות פועל בכל שלושת עמודי התווך של האימות:
-
--schema: מאמת את הסכימה בלבד -
--aggregate: מאמת רק את הנתונים המצטברים --data: מאמת רק נתונים ברמת השורה
אפשר להריץ את שירות האימות על עמוד אימות ספציפי באמצעות הדגלים של העמודים. בדוגמה הבאה מריצים אימות סכימה ואימות צבירה בשתי טבלאות ספציפיות עם מסנן WHERE בהתאמה אישית:
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG \
  --schema \
  --aggregate \
  --tables orders,customers \
  --where "order_date >= '2026-01-01'"
הפקודה validate תומכת בדגלים האופציונליים הבאים:
-
--tableאו--tables: רשימה מופרדת בפסיקים של שמות הטבלאות שרוצים לאמת. ההתאמה של--tablesתלוית אותיות רישיות (case-sensitive) וצריכה להתאים לאותיות הרישיות שבהן משתמשים ב-sourceTable.nameאו ב-targetTable.name. -
--where SQL_PREDICATE: מבטל אתwhereClauseגם בטבלת המקור וגם בטבלת היעד במהלך ההפעלה הזו. -
--source-where SQL_PREDICATE: מבטל אתwhereClauseרק בטבלת המקור. -
--target-where SQL_PREDICATE: מבטל אתwhereClauseרק בטבלת היעד. -
--gcs-path: מבטל אתgoogleCloudStorage.gcsPath. לדוגמה,--gcs-path gs://my-bucket/validation. -
--max-concurrency,--concurrencyאו--threads: משנה אתmaxConcurrencyלחילוץ פרוסות מקבילות. -
--no-partitionאו--disable-partitioning: משבית את חילוץ הפרוסות המפוצלות לכל הטבלאות בהרצה. -
--labels KEY=VALUE[,KEY=VALUE...]: צירוף תוויות מותאמות אישית של מפתח/ערך לתוצאות ההרצה. -
--output-dir: ספרייה מקומית לקובצי מטא-נתונים ומצב זמניים. ערך ברירת המחדל הוא/tmp/validation_outputs. -
-v,--verbose,-dאו--debug: הפעלה של רישום מפורט או יומן ניפוי באגים.
העברת תהליך עבודה אסינכרוני
validate מבצע חילוץ מקור באופן סינכרוני, ואז מפעיל תהליך עבודה אסינכרוני של שירות ההעברה ל-BigQuery לכל טבלה.
אם קבוצת נתוני היעד נמצאת במיקום אחר
us, למשלeu, צריך להגדיר את משתנה הסביבהBQMS_VALIDATION_LOCATIONלפני שמריצים אתvalidate:export BQMS_VALIDATION_LOCATION=LOCATION
לכל טבלה, מוודאים שהפלט כולל שורה של
Workflow:שמכילה את שם המשאב של תהליך העבודה שנוצר. לדוגמה:Run ID: 20261012T180000Z_a1b2c3d4 GCS Path: gs://my-bucket/validation/validationOutputs/sales_db/public/orders/20261012T180000Z_a1b2c3d4 Workflow: projects/my-project/locations/us/workflows/12345678-abcd-ef01-2345-6789abcdef01 Results: my-project.validation_results (populated after target validation)
קוד היציאה
0מציין שהחילוץ וההעלאה של המקור הצליחו, ולא שההשוואה של היעד הושלמה או שהנתונים תואמים. אם יצירת תהליך העבודה נכשלת, למשל בגלל הרשאה חסרה, ה-CLI מתעד אזהרה שהפעלת תהליך העבודה לאימות נכשלה, מדפיס פקודת חלופית ידנית שלgcloudומשמיט את השורהWorkflow:, למרות שהתהליך מסתיים עם0.
הצגת תוצאות האימות
בסיום הרצת האימות, אפשר לראות את תוצאות האימות במסוףGoogle Cloud באמצעות שליחת שאילתה למערך הנתונים של התוצאות validation_results, באמצעות שליחת שאילתה למערך הנתונים של BigQuery שהוגדר בקטע results ב-settings.yaml, או באמצעות קריאת דוחות הסיכום ב-Cloud Storage. בוחרים באחת מהאפשרויות הבאות:
מסוף Google Cloud
נכנסים לדף Migration services במסוף Google Cloud .
בקטע אימות ההעברה, לוחצים על הצגת הפעילות האחרונה.
לוחצים על Select a project ובוחרים את הפרויקט שבו מאוחסן מערך הנתונים של
validation_results.
GoogleSQL
מריצים שאילתה על TARGET_PROJECT_ID.validation_results.run_history כדי לבדוק את הסטטוס של הרצות האימות האחרונות:
SELECT
run_id,
source_table,
target_table,
status,
started_at,
finished_at,
gcs_uri,
error_message
FROM `TARGET_PROJECT_ID.validation_results.run_history`
ORDER BY started_at DESC
LIMIT 20;
מחליפים את TARGET_PROJECT_ID במזהה הפרויקט שבו מאוחסנת קבוצת הנתונים validation_results.
כדי לקבל מדדים מפורטים לכל עמודה ומגמות היסטוריות, אפשר להריץ את השאילתה הבאה:
-
<var>TARGET_PROJECT_ID</var>.validation_results.run_metrics: מספר אי-ההתאמות לכל הרצה ולכל עמודה, השוואות מצטברות וסטטוס "עבר" או "נכשל" -
<var>TARGET_PROJECT_ID</var>.validation_results.column_history: היסטוריית הביקורת של העמודה לאורך זמן, בכל ההרצות <var>TARGET_PROJECT_ID</var>.validation_results.run_<var>RUN_ID</var>_mismatches_details: שורות ועמודות שנדגמו שבהן ערכי המקור והיעד היו שונים
דוחות של Cloud Storage
בכל הפעלה שהושלמה, פריטי המידע הבאים של הדוח נכתבים בספריית gcs_uri של ההפעלה (gs://<var>BUCKET</var>/<var>PREFIX</var>/validationOutputs/<var>SOURCE_TABLE_PATH</var>/<var>RUN_ID</var>/):
-
validation_summary.txt: תקציר מנהלים של תוצאות ההשוואה של הסכימה, הצבירה והשורות -
column_details.txt: פירוט לפי עמודה של חוסר התאמה והבדלים מצטברים -
results.json: דוח JSON מובנה של כל ממצאי האימות queries.sql: שאילתות ה-SQL המדויקות שבוצעו במהלך הרצת האימות
כדי להדפיס את דוח הסיכום של הרצה, מריצים את הפקודה הבאה:
gcloud storage cat gs://BUCKET/PREFIX/validationOutputs/SOURCE_TABLE_PATH/RUN_ID/validation_summary.txt
פירוש תוצאות האימות
כל הפעלת אימות ב-validation_results.run_history מדווחת על אחד מערכי סטטוס הביצוע הבאים, או status:
| סטטוס | תיאור | הפעולה המומלצת |
|---|---|---|
IN_PROGRESS |
תהליך העבודה של האימות עדיין פועל ב-BigQuery. | מחכים עד שהטבלה finished_at תתמלא, ואז שולחים שוב שאילתה ל-run_history. |
COMPLETED |
תהליך האימות הסתיים ללא אי-התאמות בנתונים ברמת השורה או בנתונים המצטברים. פרטי התאימות של סוג הסכימה מתועדים בנפרד ב-validation_summary.txt וב-column_history. |
לא נדרשת כל פעולה. הטבלה עברה את האימות. |
HEALED |
צינור עיבוד הנתונים לאימות הושלם בלי שורות חסרות, וכל ההבדלים שזוהו בערכים היו תנודות מיקרוסקופיות בייצוג של נקודה צפה (< 1e-4 להשוואות ברמת התא ו-< 1e-6 לצבירות) שתואמו באופן אוטומטי על ידי המאמת. |
נחשב כהרצה שעברה. אם רוצים למנוע ריצוד במעלה הזרם, אפשר להגדיר ערך מספרי מפורש של tolerance. |
COMPLETED_WITH_MISMATCHES |
צינור עיבוד הנתונים לאימות פעל עד הסוף ומצא שורות חסרות, עמודות יעד חסרות, הבדלים מצטברים או הבדלים בנתונים ברמת התא בין טבלאות המקור והיעד. ההודעה הזו מציינת שהרצת האימות הושלמה, ולא שהמערכת קרסה. | כדי לבדוק את העמודות והשורות שלא תואמות, בודקים את column_details.txt, run_metrics ו-run_RUN_ID_mismatches_details. מידע נוסף זמין במאמר סוגי חוסר התאמה ברמת העמודה. |
ERROR |
צינור עיבוד הנתונים של האימות לא הושלם בגלל שגיאת מערכת או שגיאה בהגדרה. לדוגמה, בגלל טבלת יעד חסרה, שגיאת הרשאה או SQL לא חוקי ב-whereClause או ב-transformExpression בהתאמה אישית. |
צריך לבדוק את העמודה error_message ב-run_history. למידע נוסף על פתרון שגיאות נפוצות, ראו פתרון בעיות. |
סוגי אי-התאמות ברמת העמודה
כשהרצה מסתיימת עם COMPLETED_WITH_MISMATCHES, טבלאות אי-ההתאמה של כל הרצה מסווגות כל השוואת עמודות לפי אחת מהתוצאות הבאות:
EXACT_MATCH: ערכי התאים שהושוו בעמודה תאמו בטווח הטולרנסים שהוגדרו-
DATA_DRIFT: שורות תואמות ב-comparisonKeys, אבל ערכי התאים היו שונים מעבר לטווח הסבילות שהוגדר SCHEMA: העמודה קיימת בטבלת המקור אבל חסרה בטבלת היעד-
ROW: שורות המקור היו חסרות בטבלת היעד, או ששורות היעד היו חסרות בטבלת המקור, כשצורפו ב-comparisonKeys
פתרון שגיאות נפוצות
בטבלה הבאה מפורטות שגיאות נפוצות בשורת הפקודה ובתהליך העבודה, ואיך לפתור אותן:
| הודעת השגיאה או הבעיה | מטרה | רזולוציה |
|---|---|---|
Failed to load or parse YAML |
בלוק של טבלה, partitioning, columnSettings או googleCloudStorage מכיל מפתח לא מזוהה או ערך enum לא חוקי, כמו SAMPLING במקום SAMPLE. |
בודקים את הכניסה של ה-YAML ואת שמות השדות בהתאם לאפשרויות להגדרת הטבלה. |
Connection name '...' is invalid. Must be alphanumeric. |
שם הפרופיל בקטע connections: מכיל קווים תחתונים או מקפים. לדוגמה, my_source. |
משנים את השמות של פרופילי החיבור לשמות אלפאנומריים, כמו source ו-target. |
googleCloudStorage cannot be null |
הפרמטר googleCloudStorage.gcsPath חסר ב-validation_config/settings.yaml והפרמטר --gcs-path לא הועבר. |
מגדירים את googleCloudStorage.gcsPath: gs://BUCKET/PREFIX בלי קו נטוי עוקב ב-validation_config/settings.yaml. |
Target discovery directory 'validation_config/' is non-empty |
הפקודה generate-config הופעלה בלי --update, --force או --clean כש-validation_config/ כבר הכיל קובצי YAML. |
מעבירים את --update כדי למזג טבלאות שזוהו, תוך שמירה על connections.yaml ו-settings.yaml הקיימים. |
tables is required כשמפעילים את validate |
קובץ validation-config.yaml מדור קודם בלי רשימת tables: קיים בספריית העבודה, והוא מקבל עדיפות על פני validation_config/, או שאין קובצי YAML של טבלאות ב-validation_config/. |
מוחקים את כל הקבצים המיותרים מסוג validation-config.yaml בספריית העבודה, כדי ש-validate יטען את validation_config/. |
| שגיאה בבדיקה המקדימה במפתח השוואה יחיד עם עוצמה נמוכה | טבלה עם יותר מ-1,000 שורות מסוננות מוגדרת עם מפתח השוואה יחיד בעל עוצמה נמוכה, מה שיגרום לפיצוץ של צירוף רבים לרבים. | צריך לציין את כל העמודות שיוצרות מפתח מורכב (composite key) ייחודי ב-comparisonKeys, או להגדיר את useAllColumnsAsKey: true בקטע sourceTable. |
Failed to initialize MemoryUtil או InaccessibleObjectException: Unable to make field long java.nio.Buffer.address accessible |
ה-JVM הוא Java 17 או גרסה עדכנית יותר, והוא הופעל בלי --add-opens=java.base/java.nio=ALL-UNNAMED, בדרך כלל כי שורת הפקודה הופעלה דרך wrapper בהתאמה אישית או ישירות עם java -jar. |
מגדירים את JDK_JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED" בסביבה, או משתמשים בפקודה gcloud bq migration validate. |
WARNING: Failed to trigger validation workflow |
חילוץ המקור הצליח, אבל הקריאה ל-CreateMigrationWorkflow נכשלה בגלל הרשאות IAM חסרות, API שלא הופעל או מיקום לא נתמך. |
צריך לוודא שהאפשרות bigquerymigration.googleapis.com מופעלת, שלחשבון יש roles/bigquerymigration.editor ושהמיקום של BQMS_VALIDATION_LOCATION תואם למיקום של קבוצת הנתונים. |
ניקוי פריטי אימות
כדי לנהל את עלויות האחסון אחרי שבודקים את תוצאות האימות:
- ב-Cloud Storage, מוחקים ספריות הרצה ישנות עם הקידומת
gcsPathבקטגוריית ה-staging, או מגדירים כלל של ניהול מחזור החיים של אובייקטים בקטגוריה. - ב-BigQuery, התוקף של טבלאות ההשוואה לכל הרצה במערך הנתונים של התוצאות (
validation_resultsכברירת מחדל) פג באופן אוטומטי אחריresultTtlHours(168.0שעות, או 7 ימים, כברירת מחדל). משנים את הערך שלresultTtlHoursב-settings.yamlכדי לקצר או להאריך את משך השמירה, או מסירים ידנית טבלאות של הרצות ספציפיות ומשאירים את הטבלאות והתצוגות של ההיסטוריה המשותפת (run_history,run_metricsו-column_history) כמו שהן. - כשעובדים עם קבצים מקומיים, צריך להסיר את ספריית העבודה המקומית שנכתבה על ידי כלי האימות בנתיב
--output-dir. הספרייה שמוגדרת כברירת מחדל היא/tmp/validation_outputs.
תמחור
שירות האימות משתמש במשאבים הבאים בפרויקט:
- מחשוב ואחסון ב-BigQuery: שאילתות צבירה, איחודים של השוואת שורות ואחסון של טבלאות במערך הנתונים
validation_resultsמחויבים בפרויקט Google Cloud או ב-billingProjectIdאם הוגדרו בחיבורtarget, בהתאם לתמחור הסטנדרטי של BigQuery. - אחסון ורשת ב-Cloud Storage: קובצי Parquet או CSV לדוגמה שהועלו ודוחות תוצאות בקטגוריה שלכם מחויבים לפי התמחור הרגיל של Cloud Storage.
- עומס על מסד הנתונים של המקור: שאילתות החילוץ פועלות ישירות מול מסד הנתונים של המקור. כדי לצמצם את העומס על טבלאות מקור גדולות, השתמשו ב-
strategy: SAMPLE, סננו באמצעותwhereClauseאו הגדירו אתskipRandomization: trueכשהעומס של מיון אקראי לא רצוי.
המאמרים הבאים
- איך יוצרים מטא-נתונים לתרגום ולהערכה באמצעות הכלי
dwh-migration-dumper - תרגום שאילתות SQL באצווה כדי להמיר את הסקריפטים של SQL ואת ה-DDL של המקור ל-GoogleSQL.
- תכנון העברה באמצעות שושלת העברה כדי להמחיש את התלות בנתונים במחסן הנתונים של המקור.