


Carica i dati in batch
Il caricamento in batch di BigQuery consente di importare i dati da Cloud Storage o da un file locale in una tabella nuova o esistente in un singolo job di caricamento. Puoi caricare file Avro, valori separati da virgola (CSV), JSON delimitato da nuova riga, ORC o Parquet, nonché esportazioni di Datastore e Firestore archiviate in Cloud Storage. Per automatizzare i caricamenti ricorrenti da Cloud Storage in BigQuery, puoi utilizzare BigQuery Data Transfer Service.
Provalo
Se non conosci Google Cloud, crea un account per valutare le prestazioni di BigQuery in scenari reali. I nuovi clienti ricevono anche 300 $di crediti senza costi per l'esecuzione, il test e il deployment dei workload.
Prova BigQuery senza costiPrima di iniziare
Concedi i ruoli Identity and Access Management (IAM) che forniscono agli utenti le autorizzazioni necessarie per eseguire ogni attività in questo documento e crea un set di dati per archiviare i tuoi dati.
Autorizzazioni obbligatorie
Per caricare i dati in BigQuery, devi disporre delle autorizzazioni IAM per eseguire un job di caricamento e caricare i dati nelle tabelle BigQuery e nelle partizioni. Se carichi dati da Cloud Storage, devi anche disporre delle autorizzazioni IAM per accedere al bucket che contiene i tuoi dati.
Autorizzazioni per caricare i dati in BigQuery
Per caricare i dati in una nuova tabella o partizione BigQuery o per aggiungerli o sovrascriverli in una tabella o partizione esistente, devi disporre delle seguenti autorizzazioni IAM:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
Ognuno dei seguenti ruoli IAM predefiniti include le autorizzazioni necessarie per caricare i dati in una tabella BigQuery o partizione:
roles/bigquery.dataEditorroles/bigquery.dataOwnerroles/bigquery.admin(include l'autorizzazionebigquery.jobs.create)bigquery.user(include l'autorizzazionebigquery.jobs.create)bigquery.jobUser(include l'autorizzazionebigquery.jobs.create)
Inoltre, se disponi dell'autorizzazione bigquery.datasets.create, puoi creare e aggiornare le tabelle utilizzando un job di caricamento nei set di dati che crei.
Per saperne di più sui ruoli e sulle autorizzazioni IAM in BigQuery, consulta Ruoli e autorizzazioni predefiniti.
Autorizzazioni per caricare i dati da Cloud Storage
Per ottenere le autorizzazioni necessarie per caricare i dati da un bucket Cloud Storage, chiedi all'amministratore di concederti il ruolo IAM Storage Admin (roles/storage.admin) sul bucket.
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Questo ruolo predefinito contiene le autorizzazioni necessarie per caricare i dati da un bucket Cloud Storage. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per caricare i dati da un bucket Cloud Storage sono necessarie le seguenti autorizzazioni:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
Potresti anche ottenere queste autorizzazioni con ruoli personalizzati o altri ruoli predefiniti.
Crea un set di dati
Crea un set di dati BigQuery per archiviare i tuoi dati.
Caricamento dei dati da Cloud Storage
BigQuery supporta il caricamento di dati da una delle seguenti classi di archiviazione di Cloud Storage:
- Standard
- Nearline
- Coldline
- Archivia
Per scoprire come caricare i dati in BigQuery, consulta la pagina relativa al tuo formato dei dati:
Per scoprire come configurare un caricamento ricorrente da Cloud Storage in BigQuery, consulta Trasferimenti da Cloud Storage.
Considerazioni sulla località
Non puoi modificare la località di un set di dati dopo la sua creazione, ma puoi crearne una copia o spostarlo manualmente. Per saperne di più, vedi:
Recupero dell'URI Cloud Storage
Per caricare i dati da un'origine dati Cloud Storage, devi fornire l'URI Cloud Storage.
Il percorso della risorsa Cloud Storage contiene il nome del bucket e l'oggetto (nome file). Ad esempio, se il bucket Cloud Storage si chiama mybucket e il file di dati si chiama myfile.csv, il percorso della risorsa sarà gs://mybucket/myfile.csv.
BigQuery non supporta i percorsi delle risorse Cloud Storage che includono più barre consecutive dopo la doppia barra iniziale.
I nomi degli oggetti Cloud Storage possono contenere più barre ("/") consecutive. Tuttavia, BigQuery converte più barre consecutive in una singola barra. Ad esempio, il seguente percorso della risorsa, sebbene valido in Cloud Storage, non funziona in BigQuery: gs://bucket/my//object//name.
Per recuperare il percorso della risorsa Cloud Storage:
Apri la console Cloud Storage.
Sfoglia fino alla posizione dell'oggetto (file) che contiene i dati di origine.
Fai clic sul nome dell'oggetto.
Viene visualizzata la pagina Dettagli oggetto.
Copia il valore fornito nel campo URI gsutil, che inizia con
gs://.
Per le esportazioni di Google Datastore, è possibile specificare un solo URI, che deve terminare con .backup_info o .export_metadata.
Supporto dei caratteri jolly per gli URI Cloud Storage
Se i dati sono suddivisi in più file, puoi utilizzare un carattere jolly asterisco (*) per selezionare più file. L'utilizzo del carattere jolly asterisco deve seguire queste regole:
- L'asterisco può apparire all'interno del nome dell'oggetto o alla fine del nome dell'oggetto.
- L'utilizzo di più asterischi non è supportato. Ad esempio, il percorso
gs://mybucket/fed-*/temp/*.csvnon è valido. - L'utilizzo di un asterisco con il nome del bucket non è supportato.
Esempi:
L'esempio seguente mostra come selezionare tutti i file in tutte le cartelle che iniziano con il prefisso
gs://mybucket/fed-samples/fed-sample:gs://mybucket/fed-samples/fed-sample*L'esempio seguente mostra come selezionare solo i file con estensione
.csvnella cartella denominatafed-samplese in tutte le sottocartelle difed-samples:gs://mybucket/fed-samples/*.csvL'esempio seguente mostra come selezionare i file con un pattern di denominazione di
fed-sample*.csvnella cartella denominatafed-samples. Questo esempio non seleziona i file nelle sottocartelle difed-samples.gs://mybucket/fed-samples/fed-sample*.csv
Quando utilizzi lo strumento a riga di comando bq, potrebbe essere necessario eseguire l'escape dell'asterisco su alcune piattaforme.
Non puoi utilizzare un carattere jolly asterisco quando carichi i dati di esportazione di Datastore o Firestore da Cloud Storage.
Limitazioni
Quando carichi dati in BigQuery da un bucket Cloud Storage, si applicano le seguenti limitazioni:
- BigQuery non garantisce la coerenza dei dati per le origini dati esterne. Le modifiche ai dati sottostanti durante l'esecuzione di una query possono causare comportamenti imprevisti.
- BigQuery non supporta il controllo delle versioni degli oggetti di Cloud Storage. Se includi un numero di generazione nell'URI Cloud Storage, il job di caricamento non va a buon fine.
A seconda del formato dei dati di origine di Cloud Storage, potrebbero essere applicate limitazioni aggiuntive. Per saperne di più, vedi:
- Limitazioni dei file CSV
- Limitazioni di JSON
- Limitazioni per l'esportazione di Datastore
- Limitazioni delle esportazioni di Firestore
- Limitazioni relative ai dati nidificati e ripetuti
Caricamento dei dati dai file locali
Puoi caricare i dati da un'origine dati leggibile (ad esempio la tua macchina locale) utilizzando uno dei seguenti metodi:
- La console Google Cloud
- Il comando
bq loaddello strumento a riga di comando bq - L'API
- Librerie client
Quando carichi i dati utilizzando la console Google Cloud o lo strumento a riga di comando bq, viene creato automaticamente un job di caricamento.
Per caricare i dati da un'origine dati locale:
Console
Apri la pagina BigQuery nella console Google Cloud .
Nel riquadro a sinistra, fai clic su Spazio di esplorazione:
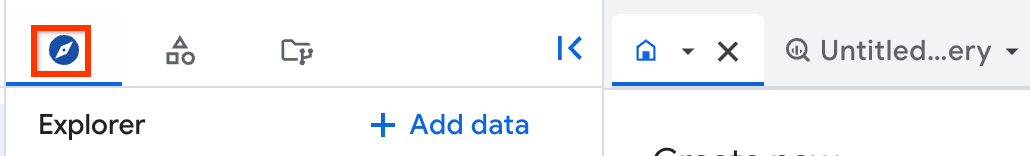
Se non vedi il riquadro a sinistra, fai clic su Espandi riquadro sinistro per aprirlo.
Nel riquadro Explorer, espandi il progetto, fai clic su Set di dati, quindi seleziona un set di dati.
Nel riquadro dei dettagli, fai clic su Crea tabella.
Nella pagina Crea tabella, nella sezione Origine:
- In Crea tabella da, seleziona Carica.
- In Seleziona file, fai clic su Sfoglia.
- Sfoglia fino al file e fai clic su Apri. Tieni presente che i caratteri jolly e gli elenchi separati da virgole non sono supportati per i file locali.
- In Formato file, seleziona CSV, JSON (delimitato da nuova riga), Avro, Parquet o ORC.
Nella pagina Crea tabella, nella sezione Destinazione:
- In Progetto, scegli il progetto appropriato.
- In Set di dati, scegli il set di dati appropriato.
- Nel campo Tabella, inserisci il nome della tabella che stai creando in BigQuery.
- Verifica che Tipo di tabella sia impostato su Tabella nativa.
Nella sezione Schema, inserisci la definizione dello schema.
Per i file CSV e JSON, puoi selezionare l'opzione Rilevamento automatico per attivare il rilevamento automatico dello schema. Le informazioni sullo schema sono autodescritte nei dati di origine per altri tipi di file supportati.
Puoi anche inserire manualmente le informazioni sullo schema:
Fai clic su Modifica come testo e inserisci lo schema della tabella come array JSON:
Utilizzando Aggiungi campo per inserire manualmente lo schema.
Seleziona gli elementi applicabili nella sezione Opzioni avanzate. Per informazioni sulle opzioni disponibili, consulta Opzioni CSV e Opzioni JSON.
(Facoltativo) Nella sezione Opzioni avanzate, scegli la disposizione di scrittura:
- Scrivi se vuota: scrive i dati solo se la tabella è vuota.
- Aggiungi alla tabella: aggiungi i dati alla fine della tabella. Questa è l'impostazione predefinita.
- Sovrascrivi tabella: cancella tutti i dati esistenti nella tabella prima di scrivere i nuovi dati.
Fai clic su Crea tabella.
bq
Utilizza il comando bq load, specifica source_format e includi il percorso del file locale.
(Facoltativo) Specifica il flag --location e imposta il valore sulla tua località.
Se carichi i dati in un progetto diverso da quello predefinito, aggiungi l'ID progetto al set di dati nel seguente formato: PROJECT_ID:DATASET.
bq --location=LOCATION load \
--source_format=FORMAT \
PROJECT_ID:DATASET.TABLE \
PATH_TO_SOURCE \
SCHEMA
Sostituisci quanto segue:
LOCATION: la tua località. Il flag--locationè facoltativo. Ad esempio, se utilizzi BigQuery nella regione di Tokyo, imposta il valore del flag suasia-northeast1. Puoi impostare un valore predefinito per la località utilizzando il file .bigqueryrc.FORMAT:CSV,AVRO,PARQUET,ORCoNEWLINE_DELIMITED_JSON.project_id: il tuo ID progetto.dataset: un set di dati esistente.table: il nome della tabella in cui stai caricando i dati.path_to_source: il percorso del file locale.schema: uno schema valido. Lo schema può essere un file JSON locale o può essere digitato in linea come parte del comando. Puoi anche utilizzare il flag--autodetectanziché fornire una definizione dello schema.
Inoltre, puoi aggiungere flag per le opzioni che ti consentono di controllare il modo in cui BigQuery analizza i dati. Ad esempio, puoi utilizzare il flag --skip_leading_rows per ignorare le righe di intestazione in un file CSV. Per saperne di più, consulta Opzioni CSV e Opzioni JSON.
Esempi:
Il seguente comando carica un file JSON locale delimitato da nuova riga (mydata.json) in una tabella denominata mytable in mydataset nel progetto predefinito. Lo schema è definito in un file di schema locale denominato myschema.json.
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    ./mydata.json \
    ./myschema.json
Il seguente comando carica un file CSV locale (mydata.csv) in una tabella denominata mytable in mydataset in myotherproject. Lo schema è definito in linea nel formato FIELD:DATA_TYPE, FIELD:DATA_TYPE.
    bq load \
    --source_format=CSV \
    myotherproject:mydataset.mytable \
    ./mydata.csv \
    qtr:STRING,sales:FLOAT,year:STRING
Il seguente comando carica un file CSV locale (mydata.csv) in una tabella denominata mytable in mydataset nel progetto predefinito. Lo schema viene definito utilizzando il rilevamento automatico dello schema.
    bq load \
    --autodetect \
    --source_format=CSV \
    mydataset.mytable \
    ./mydata.csv
C#
Prima di provare questo esempio, segui le istruzioni di configurazione di C# nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery C#.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Il seguente codice mostra come caricare un file CSV locale in una nuova tabella BigQuery. Per caricare un file locale di un altro formato, utilizza la classe delle opzioni di aggiornamento per il formato appropriato dalla classe base JobCreationOptions anzichéUploadCsvOptions.
Vai
Prima di provare questo esempio, segui le istruzioni di configurazione di Go nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Go.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Il seguente codice mostra come caricare un file CSV locale in una nuova tabella BigQuery. Per caricare un file locale di un altro formato, imposta la proprietà DataFormat diNewReaderSource sul formato appropriato.
Java
Prima di provare questo esempio, segui le istruzioni di configurazione di Java nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Java.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Il seguente codice mostra come caricare un file CSV locale in una nuova tabella BigQuery. Per caricare un file locale di un altro formato, imposta FormatOptions sul formato appropriato.
Node.js
Prima di provare questo esempio, segui le istruzioni di configurazione di Node.js nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Node.js.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Il seguente codice mostra come caricare un file CSV locale in una nuova tabella BigQuery. Per caricare un file locale di un altro formato, imposta il parametrometadata della funzione load sul formato appropriato.
PHP
Prima di provare questo esempio, segui le istruzioni di configurazione di PHP nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery PHP.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Il seguente codice mostra come caricare un file CSV locale in una nuova tabella BigQuery. Per caricare un file locale in un altro formato, imposta sourceFormat sul formato appropriato.
Python
Prima di provare questo esempio, segui le istruzioni di configurazione di Python nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Python.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Il seguente codice mostra come caricare un file CSV locale in una nuova tabella BigQuery. Per caricare un file locale in un altro formato, imposta la proprietà LoadJobConfig.source_format sul formato appropriato.
Ruby
Prima di provare questo esempio, segui le istruzioni di configurazione di Ruby nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Ruby.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Il seguente codice mostra come caricare un file CSV locale in una nuova tabella BigQuery. Per caricare un file locale di un altro formato, imposta il parametroformat del metodo Table#load_job sul formato appropriato.
Limitazioni
Il caricamento dei dati da un'origine dati locale è soggetto alle seguenti limitazioni:
- I caratteri jolly e gli elenchi separati da virgole non sono supportati quando carichi file da un'origine dati locale. I file devono essere caricati singolarmente.
- Quando utilizzi la console Google Cloud , i file caricati da un'origine dati locale non possono superare i 100 MB. Per i file di dimensioni maggiori, caricali da Cloud Storage.
Capacità dei job di caricamento
Analogamente alla modalità on demand per le query, per impostazione predefinita i job di caricamento utilizzano un pool di slot condiviso. Se un job di caricamento utilizza il pool condiviso, la prenotazione
default-pipeline viene visualizzata nei dettagli del job. BigQuery non garantisce la capacità disponibile di questo pool condiviso o la velocità effettiva del job di caricamento.
Per aumentare il throughput o controllare in modo prevedibile la capacità dei job di caricamento, puoi creare una prenotazione di slot e assegnare slot PIPELINE dedicati per eseguire i job di caricamento. Per saperne di più, consulta
Assegnazioni delle prenotazioni.
Caricamento di dati compressi e non compressi
Per i formati Avro, Parquet e ORC, BigQuery supporta il caricamento di file in cui i dati sono stati compressi utilizzando un codec supportato. Tuttavia, BigQuery non supporta il caricamento di file in questi formati che sono stati compressi, ad esempio utilizzando l'utilità gzip.
Il formato binario Avro è il formato preferito per il caricamento di dati compressi e non compressi. I dati Avro vengono caricati più velocemente perché possono essere letti in parallelo, anche quando i data block sono compressi. Per un elenco dei codec di compressione supportati, consulta Compressione Avro.
Anche il formato binario Parquet è una buona scelta perché la codifica efficiente per colonna di Parquet si traduce in genere in un rapporto di compressione migliore e in file più piccoli. I file Parquet sfruttano anche tecniche di compressione che consentono di caricare i file in parallelo. Per un elenco dei codec di compressione supportati, consulta Compressione Parquet.
Il formato binario ORC offre vantaggi simili a quelli del formato Parquet. I dati nei file ORC vengono caricati rapidamente perché gli stripe di dati possono essere letti in parallelo. Le righe di ogni stripe di dati vengono caricate in sequenza. Per ottimizzare il tempo di caricamento, utilizza una dimensione della sezione di dati di circa 256 MB o inferiore. Per un elenco dei codec di compressione supportati, consulta Compressione ORC.
Per altri formati di dati, come CSV e JSON, BigQuery può caricare i file non compressi molto più velocemente di quelli compressi, perché i file non compressi possono essere letti in parallelo. Poiché i file non compressi sono più grandi, il loro utilizzo può comportare limitazioni della larghezza di banda e costi di Cloud Storage più elevati per i dati gestiti temporaneamente in Cloud Storage prima di essere caricati in BigQuery. Tieni presente che l'ordine delle righe non è garantito per i file compressi o non compressi. È importante valutare questi compromessi in base al tuo caso d'uso.
In generale, se la larghezza di banda è limitata, comprimi i file CSV e JSON utilizzando gzip prima di caricarli su Cloud Storage. gzip è l'unico tipo di compressione dei file supportato per i file CSV e JSON durante il caricamento dei dati in BigQuery. Se la velocità di caricamento è importante per la tua app e hai molta larghezza di banda per caricare i dati, lascia i file non compressi.
Aggiunta o sovrascrittura di una tabella
Puoi caricare dati aggiuntivi in una tabella dai file di origine o aggiungendo i risultati delle query. Se lo schema dei dati non corrisponde allo schema della tabella di destinazione o della partizione, puoi aggiornare lo schema quando lo aggiungi o lo sovrascrivi.
Se aggiorni lo schema quando aggiungi dati, BigQuery ti consente di:
- Aggiungi nuovi campi
- Rilassa
REQUIREDcampi inNULLABLE
Se sovrascrivi una tabella, lo schema viene sempre sovrascritto. Gli aggiornamenti dello schema non sono limitati quando sovrascrivi una tabella.
Nella console Google Cloud , utilizza l'opzione Preferenza di scrittura per specificare l'azione da intraprendere quando carichi i dati da un file di origine o da un risultato di una query. Lo strumento a riga di comando bq e l'API includono le seguenti opzioni:
| Opzione della console | flag dello strumento bq | Proprietà API BigQuery | Descrizione |
|---|---|---|---|
| Scrivi se vuota | Nessuno | WRITE_EMPTY | Scrive i dati solo se la tabella è vuota. |
| Aggiungi a tabella | --noreplace o --replace=false; se --replace non è specificato, il valore predefinito è append |
WRITE_APPEND | (Predefinito) Aggiunge i dati alla fine della tabella. |
| Sovrascrivi tabella | --replace o --replace=true |
WRITE_TRUNCATE | Cancella tutti i dati esistenti in una tabella prima di scrivere i nuovi dati. |
Criteri per le quote
Per informazioni sulla policy sulle quote per il caricamento dei dati in batch, consulta Job di caricamento nella pagina Quote e limiti.
Visualizza l'utilizzo attuale della quota
Puoi visualizzare l'utilizzo attuale dei job di query, caricamento, estrazione o copia eseguendo una query INFORMATION_SCHEMA per visualizzare i metadati relativi ai job eseguiti in un periodo di tempo specificato. Puoi confrontare l'utilizzo attuale con il limite della quota per determinare l'utilizzo della quota per un tipo di job specifico. La seguente query di esempio utilizza la vista INFORMATION_SCHEMA.JOBS per elencare il numero di job di query, caricamento, estrazione e copia per progetto:
SELECT
  sum(case  when job_type="QUERY" then 1 else 0 end) as QRY_CNT,
  sum(case  when job_type="LOAD" then 1 else 0 end) as LOAD_CNT,
  sum(case  when job_type="EXTRACT" then 1 else 0 end) as EXT_CNT,
  sum(case  when job_type="COPY" then 1 else 0 end) as CPY_CNT
FROM `region-REGION_NAME`.INFORMATION_SCHEMA.JOBS_BY_PROJECT
WHERE date(creation_time)= CURRENT_DATE()
Prezzi
Il caricamento dei dati in batch in BigQuery utilizzando il pool di slot condivisi non prevede costi. Per saperne di più, consulta Prezzi dell'importazione dati di BigQuery.
Se tenti di caricare dati da un bucket Cloud Storage che si trova in una località diversa rispetto al set di dati BigQuery di destinazione, vengono applicati addebiti per il trasferimento di dati.
Caso d'uso di esempio
Supponiamo che esista una pipeline di elaborazione batch notturna che deve essere completata entro una scadenza fissa. I dati devono essere disponibili entro questa scadenza per un'ulteriore elaborazione batch da parte di un altro processo batch per generare report da inviare a un'autorità di regolamentazione. Questo caso d'uso è comune nei settori regolamentati come quello finanziario.
Il caricamento in batch dei dati con job di caricamento è l'approccio giusto per questo caso d'uso, perché la latenza non è un problema, a condizione che la scadenza possa essere rispettata. Assicurati che i bucket Cloud Storage soddisfino i requisiti per le località per il caricamento dei dati nel set di dati BigQuery.
Il risultato di un job di caricamento BigQuery è atomico: vengono inseriti tutti i record o nessuno. Come best practice, quando inserisci tutti i dati in un singolo job di caricamento, crea una nuova tabella utilizzando la disposizione WRITE_TRUNCATE della risorsa JobConfigurationLoad.
Questo è importante quando si riprova un job di caricamento non riuscito, poiché il client potrebbe non essere in grado di distinguere tra i job non riusciti e l'errore causato, ad esempio, dalla comunicazione dello stato di esito positivo al client.
Supponendo che i dati da importare siano già stati copiati correttamente in Cloud Storage, per risolvere gli errori di importazione è sufficiente riprovare con il backoff esponenziale.
È consigliabile che un job batch notturno non raggiunga la quota predefinita di 1500 caricamenti per tabella al giorno,anche con i nuovi tentativi. Quando carichi i dati in modo incrementale, la quota predefinita è sufficiente per eseguire un job di caricamento ogni 5 minuti e avere una quota non utilizzata per almeno un nuovo tentativo per job in media.