


Carica dati Avro da Cloud Storage
BigQuery consente di caricare i dati Avro da Cloud Storage in una nuova tabella o partizione oppure di aggiungerli o sovrascriverli in una tabella o partizione esistente. Quando carichi i dati in BigQuery, BigQuery recupera automaticamente lo schema e converte i dati caricati nel formato a colonne per Capacitor.
Per informazioni sul caricamento dei dati Avro da un file locale, consulta Caricamento dei dati in BigQuery da un'origine dati locale.
Limitazioni
Quando carichi dati in BigQuery da un bucket Cloud Storage, si applicano le seguenti limitazioni:
- BigQuery non garantisce la coerenza dei dati per le origini dati esterne. Le modifiche ai dati sottostanti durante l'esecuzione di una query possono causare comportamenti imprevisti.
- BigQuery non supporta il controllo delle versioni degli oggetti di Cloud Storage. Se includi un numero di generazione nell'URI Cloud Storage, il job di caricamento non va a buon fine.
Quando carichi file Avro in BigQuery, si applicano anche le seguenti limitazioni:
- BigQuery non supporta il caricamento di file di schema Avro (.avsc) autonomi.
- La formattazione degli array nidificati non è supportata in BigQuery. I file Avro che utilizzano questo formato devono essere convertiti prima dell'importazione.
- In un file Avro, i nomi e gli spazi dei nomi per un nome completo possono contenere solo caratteri alfanumerici e il carattere di trattino basso
_. La seguente espressione regolare mostra i caratteri consentiti:[A-Za-z_][A-Za-z0-9_]*.
Per informazioni sui limiti dei job di caricamento di BigQuery, consulta Job di caricamento.
Requisiti dei file di input
Per evitare errori resourcesExceeded durante il caricamento dei file Avro in BigQuery, segui queste linee guida:
- Mantieni le dimensioni delle righe entro i 50 MB.
- Se la riga contiene molti campi array o campi array molto lunghi, suddividi i valori dell'array in campi separati.
Prima di iniziare
Concedi i ruoli Identity and Access Management (IAM) che forniscono agli utenti le autorizzazioni necessarie per eseguire ogni attività in questo documento e crea un set di dati e una tabella per archiviare i tuoi dati.
Autorizzazioni obbligatorie
Per caricare i dati in BigQuery, devi disporre delle autorizzazioni IAM per eseguire un job di caricamento e caricare i dati nelle tabelle BigQuery e nelle partizioni. Se carichi dati da Cloud Storage, devi anche disporre delle autorizzazioni IAM per accedere al bucket che contiene i tuoi dati.
Autorizzazioni per caricare i dati in BigQuery
Per caricare i dati in una nuova tabella o partizione BigQuery o per aggiungerli o sovrascriverli in una tabella o partizione esistente, devi disporre delle seguenti autorizzazioni IAM:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
Ognuno dei seguenti ruoli IAM predefiniti include le autorizzazioni necessarie per caricare i dati in una tabella BigQuery o partizione:
roles/bigquery.dataEditorroles/bigquery.dataOwnerroles/bigquery.admin(include l'autorizzazionebigquery.jobs.create)bigquery.user(include l'autorizzazionebigquery.jobs.create)bigquery.jobUser(include l'autorizzazionebigquery.jobs.create)
Inoltre, se disponi dell'autorizzazione bigquery.datasets.create, puoi creare e aggiornare le tabelle utilizzando un job di caricamento nei set di dati che crei.
Per saperne di più sui ruoli e sulle autorizzazioni IAM in BigQuery, consulta Ruoli e autorizzazioni predefiniti.
Autorizzazioni per caricare i dati da Cloud Storage
Per ottenere le autorizzazioni necessarie per caricare i dati da un bucket Cloud Storage, chiedi all'amministratore di concederti il ruolo IAM Storage Admin (roles/storage.admin) sul bucket.
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Questo ruolo predefinito contiene le autorizzazioni necessarie per caricare i dati da un bucket Cloud Storage. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per caricare i dati da un bucket Cloud Storage sono necessarie le seguenti autorizzazioni:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
Potresti anche ottenere queste autorizzazioni con ruoli personalizzati o altri ruoli predefiniti.
Crea un set di dati e una tabella
Per archiviare i dati, devi creare un set di dati BigQuery, quindi creare una tabella BigQuery all'interno del set di dati.
Vantaggi di Avro
Avro è il formato preferito per il caricamento dei dati in BigQuery. Il caricamento dei file Avro presenta i seguenti vantaggi rispetto ai file CSV e JSON (delimitati da riga nuova):
- Il formato binario Avro:
- Si carica più velocemente. I dati possono essere letti in parallelo, anche se i blocchi di dati sono compressi.
- Non richiede la digitazione o la serializzazione.
- È più facile da analizzare perché non presenta problemi di codifica riscontrati in altri formati come ASCII.
- Quando carichi i file Avro in BigQuery, lo schema della tabella viene recuperato automaticamente dai dati di origine autodescrittivi.
Schemi Avro
Quando carichi file Avro in una nuova tabella BigQuery, lo schema della tabella viene recuperato automaticamente utilizzando i dati di origine. Quando BigQuery recupera lo schema dai dati di origine, viene utilizzato l'ultimo file in ordine alfabetico.
Ad esempio, hai i seguenti file Avro in Cloud Storage:
gs://mybucket/00/
  a.avro
  z.avro
gs://mybucket/01/
  b.avro
L'esecuzione di questo comando nello strumento a riga di comando bq carica tutti i file (come elenco separato da virgole) e lo schema viene derivato da mybucket/01/b.avro:
bq load \
--source_format=AVRO \
dataset.table \
"gs://mybucket/00/*.avro","gs://mybucket/01/*.avro"
Quando importi più file Avro con schemi Avro diversi, tutti gli schemi devono essere compatibili con la risoluzione dello schema di Avro.
Quando BigQuery rileva lo schema, alcuni tipi di dati Avro vengono convertiti in tipi di dati BigQuery per renderli compatibili con la sintassi GoogleSQL. Per saperne di più, consulta Conversioni Avro.
Per fornire uno schema di tabella per la creazione di tabelle esterne, imposta la proprietàreferenceFileSchemaUri nell'API BigQuery o il parametro --reference_file_schema_uri nello strumento a riga di comando bq sull'URL del file di riferimento.
Ad esempio, --reference_file_schema_uri="gs://mybucket/schema.avro".
Puoi anche importare lo schema in BigQuery specificando un file di schema JSON.
Compressione Avro
BigQuery supporta i seguenti codec di compressione per i contenuti dei file Avro:
SnappyDEFLATEZSTD
Caricamento dei dati Avro in una nuova tabella
Per caricare i dati Avro da Cloud Storage in una nuova tabella BigQuery, seleziona una delle seguenti opzioni:
Console
Nella console Google Cloud , apri la pagina BigQuery.
Nel riquadro a sinistra, fai clic su Spazio di esplorazione:
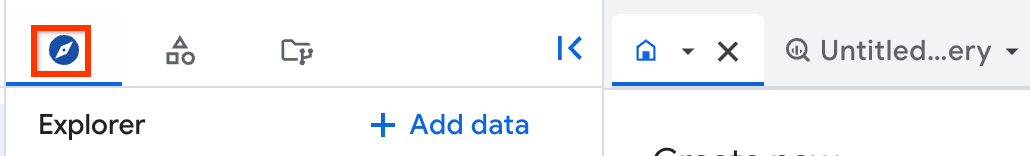
Se non vedi il riquadro a sinistra, fai clic su Espandi riquadro sinistro per aprirlo.
Nel riquadro Explorer, espandi il progetto, fai clic su Set di dati, quindi sul nome del set di dati.
Nel riquadro dei dettagli, fai clic su Crea tabella .
Nella pagina Crea tabella, nella sezione Origine:
In Crea tabella da, seleziona Google Cloud Storage.
Nel campo dell'origine, vai all'URI Cloud Storage o inseriscilo. Tieni presente che non puoi includere più URI nella consoleGoogle Cloud , ma sono supportati i caratteri jolly. Il bucket Cloud Storage deve trovarsi nella stessa località del set di dati che contiene la tabella che stai creando.
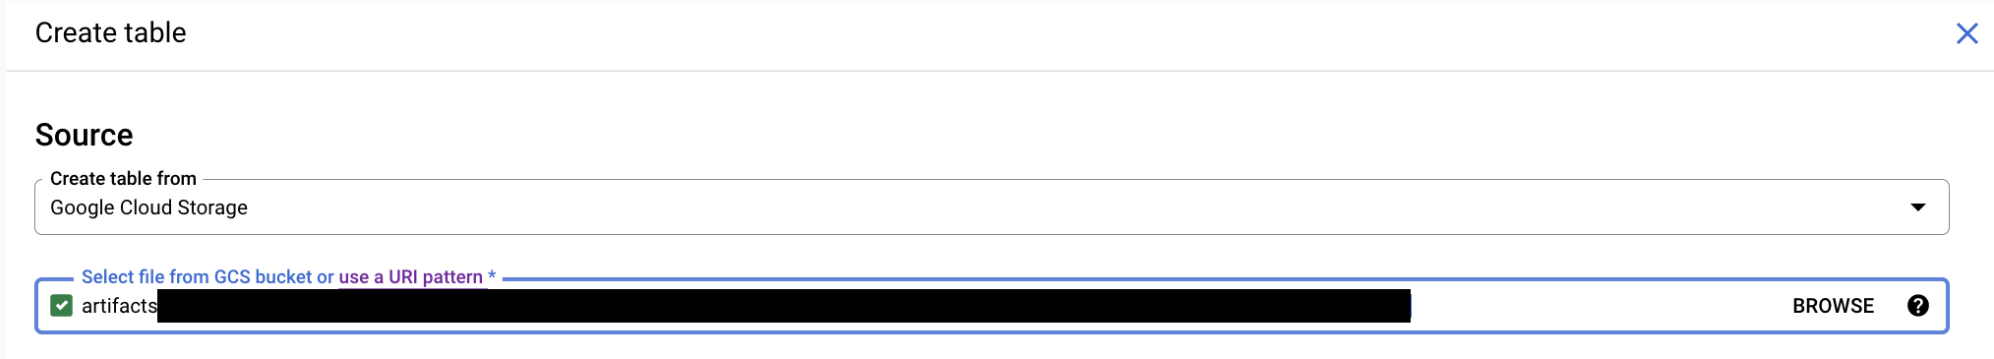
In Formato file, seleziona Avro.
Nella pagina Crea tabella, nella sezione Destinazione:
- In Nome set di dati, scegli il set di dati appropriato.
- Verifica che Tipo di tabella sia impostato su Tabella nativa.
- Nel campo Nome tabella, inserisci il nome della tabella che stai creando in BigQuery.
Nella sezione Schema, non è necessaria alcuna azione. Lo schema è autodescritto nei file Avro.
(Facoltativo) Per partizionare la tabella, scegli le opzioni in Impostazioni di partizionamento e clustering. Per saperne di più, consulta Crea tabelle partizionate.
(Facoltativo) Per Filtro di partizionamento, fai clic sulla casella Richiedi filtro di partizionamento per richiedere agli utenti di includere una clausola
WHEREche specifichi le partizioni su cui eseguire la query. Se il filtro di partizionamento è obbligatorio, i costi potrebbero ridursi e le prestazioni potrebbero migliorare. Per saperne di più, consulta Richiedi un filtro di partizione nelle query. Questa opzione non è disponibile se è selezionata l'opzione Nessun partizionamento.(Facoltativo) Per eseguire il clustering della tabella, nella casella Ordine di clustering, inserisci da uno a quattro nomi di campo.
(Facoltativo) Fai clic su Opzioni avanzate.
- In Preferenza di scrittura, lascia selezionata l'opzione Scrivi se vuota. Questa opzione crea una nuova tabella e vi carica i dati.
- Per Valori sconosciuti, lascia deselezionata l'opzione Ignora valori sconosciuti. Questa opzione si applica solo ai file CSV e JSON.
- In Crittografia, fai clic su Chiave gestita dal cliente per utilizzare una chiave di Cloud Key Management Service. Se lasci l'impostazione Google-managed key, BigQuery cripta i dati at-rest.
Fai clic su Crea tabella.
SQL
Utilizza l'istruzione DDL LOAD DATA.
L'esempio seguente carica un file Avro nella nuova tabella mytable:
Nella console Google Cloud , vai alla pagina BigQuery.
Nell'editor di query, inserisci la seguente istruzione:
LOAD DATA OVERWRITE mydataset.mytable
FROM FILES (
  format = 'avro',
  uris = ['gs://bucket/path/file.avro']);
Fai clic su Esegui.
Per saperne di più su come eseguire le query, consulta Esegui una query interattiva.
bq
Utilizza il comando bq load, specifica AVRO utilizzando il flag --source_format
e includi un URI Cloud Storage.
Puoi includere un singolo URI, un elenco separato da virgole di URI o un URI contenente un carattere jolly.
(Facoltativo) Specifica il flag --location e imposta il valore sulla tua località.
Altri flag facoltativi includono:
--time_partitioning_type: attiva il partizionamento basato sul tempo in una tabella e imposta il tipo di partizione. I valori possibili sonoHOUR,DAY,MONTHeYEAR. Questo flag è facoltativo quando crei una tabella partizionata in base a una colonnaDATE,DATETIMEoTIMESTAMP. Il tipo di partizione predefinito per il partizionamento basato sul tempo èDAY. Non puoi modificare la specifica di partizionamento di una tabella esistente.--time_partitioning_expiration: un numero intero che specifica (in secondi) quando deve essere eliminata una partizione basata sul tempo. La data/ora di scadenza viene valutata in base alla data UTC della partizione più il valore intero.--time_partitioning_field: la colonnaDATEoTIMESTAMPutilizzata per creare una tabella partizionata. Se il partizionamento basato sul tempo è abilitato senza questo valore, viene creata una tabella partizionata per data di importazione.--require_partition_filter: se abilitata, questa opzione richiede agli utenti di includere una clausolaWHEREche specifica le partizioni su cui eseguire query. Se il filtro di partizionamento è obbligatorio, i costi possono essere ridotti e le prestazioni migliorate. Per saperne di più, consulta Richiedi un filtro di partizione nelle query.--clustering_fields: un elenco separato da virgole di massimo quattro nomi di colonne utilizzati per creare una tabella in cluster.--destination_kms_key: la chiave Cloud KMS per la crittografia dei dati della tabella.Per ulteriori informazioni sulle tabelle partizionate, consulta:
Per saperne di più sulle tabelle in cluster, consulta:
Per saperne di più sulla crittografia delle tabelle, consulta:
Per caricare i dati Avro in BigQuery, inserisci il seguente comando:
bq --location=location load \
--source_format=format \
dataset.table \
path_to_source
Sostituisci quanto segue:
- location è la tua posizione. Il flag
--locationè facoltativo. Ad esempio, se utilizzi BigQuery nella regione di Tokyo, puoi impostare il valore del flag suasia-northeast1. Puoi impostare un valore predefinito per la località utilizzando il file.bigqueryrc. - format è pari a
AVRO. - dataset è un set di dati esistente.
- table è il nome della tabella in cui stai caricando i dati.
- path_to_source è un URI Cloud Storage completo o un elenco separato da virgole di URI. Sono supportati anche i caratteri jolly.
Esempi:
Il seguente comando carica i dati da gs://mybucket/mydata.avro in una tabella denominata mytable in mydataset.
    bq load \
    --source_format=AVRO \
    mydataset.mytable \
    gs://mybucket/mydata.avro
Il seguente comando carica i dati da gs://mybucket/mydata.avro in una tabella partizionata per data di importazione denominata mytable in mydataset.
    bq load \
    --source_format=AVRO \
    --time_partitioning_type=DAY \
    mydataset.mytable \
    gs://mybucket/mydata.avro
Il comando seguente carica i dati da gs://mybucket/mydata.avro in una nuova tabella partizionata denominata mytable in mydataset. La tabella è partizionata in base alla colonna mytimestamp.
    bq load \
    --source_format=AVRO \
    --time_partitioning_field mytimestamp \
    mydataset.mytable \
    gs://mybucket/mydata.avro
Il comando seguente carica i dati da più file in gs://mybucket/ in una tabella denominata mytable in mydataset. L'URI Cloud Storage utilizza un carattere jolly.
    bq load \
    --source_format=AVRO \
    mydataset.mytable \
    gs://mybucket/mydata*.avro
Il comando seguente carica i dati da più file in gs://mybucket/ in una tabella denominata mytable in mydataset. Il comando include un elenco separato da virgole di URI Cloud Storage con caratteri jolly.
    bq load \
    --source_format=AVRO \
    mydataset.mytable \
    "gs://mybucket/00/*.avro","gs://mybucket/01/*.avro"
API
Crea un job
loadche punti ai dati di origine in Cloud Storage.(Facoltativo) Specifica la tua località nella proprietà
locationnella sezionejobReferencedella risorsa job.La proprietà
source URIsdeve essere completa, nel formatogs://bucket/object. Ogni URI può contenere un carattere jolly "*".Specifica il formato dei dati Avro impostando la proprietà
sourceFormatsuAVRO.Per controllare lo stato del job, chiama
jobs.get(job_id), dove job_id è l'ID del job restituito dalla richiesta iniziale.- Se è
status.state = DONE, il job è stato completato correttamente. - Se la proprietà
status.errorResultè presente, la richiesta non è andata a buon fine e l'oggetto includerà informazioni che descrivono il problema. Se una richiesta non va a buon fine, non viene creata alcuna tabella e non vengono caricati dati. - Se
status.errorResultnon è presente, il job è stato completato correttamente, anche se potrebbero essersi verificati alcuni errori non irreversibili, ad esempio problemi di importazione di alcune righe. Gli errori non irreversibili sono elencati nella proprietàstatus.errorsdell'oggetto job restituito.
- Se è
Note sull'API:
I job di caricamento sono atomici e coerenti; se un job di caricamento non va a buon fine, non sono disponibili dati, mentre se un job di caricamento va a buon fine, sono disponibili tutti i dati.
Come best practice, genera un ID univoco e passalo come
jobReference.jobIdquando chiamijobs.insertper creare un job di caricamento. Questo approccio è più efficace in caso di errori di rete perché il client può eseguire il polling o riprovare con l'ID job noto.La chiamata di
jobs.insertsu un determinato ID job è idempotente. Puoi riprovare tutte le volte che vuoi con lo stesso ID job e al massimo una di queste operazioni andrà a buon fine.
Vai
Prima di provare questo esempio, segui le istruzioni di configurazione di Go nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Go.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Java
Prima di provare questo esempio, segui le istruzioni di configurazione di Java nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Java.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Node.js
Prima di provare questo esempio, segui le istruzioni di configurazione di Node.js nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Node.js.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Python
Prima di provare questo esempio, segui le istruzioni di configurazione di Python nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Python.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Estrai i dati JSON dai dati Avro
Esistono due modi per assicurarti che i dati Avro vengano caricati in BigQuery come dati JSON:
Annota lo schema Avro con
sqlTypeimpostato suJSON. Ad esempio, se carichi dati con il seguente schema Avro, la colonnajson_fieldviene letta come tipoJSON:{ "type": {"type": "string", "sqlType": "JSON"}, "name": "json_field" }
Specifica esplicitamente lo schema della tabella di destinazione BigQuery e imposta il tipo di colonna su
JSON. Per saperne di più, consulta Specifica uno schema.
Se non specifichi JSON come tipo nello schema Avro o nello schema della tabella BigQuery, i dati verranno letti come STRING.
Aggiunta o sovrascrittura di una tabella con dati Avro
Puoi caricare dati aggiuntivi in una tabella dai file di origine o aggiungendo i risultati delle query.
Nella console Google Cloud , utilizza l'opzione Preferenza di scrittura per specificare l'azione da intraprendere quando carichi i dati da un file di origine o da un risultato di una query.
Quando carichi dati aggiuntivi in una tabella, hai le seguenti opzioni:
| Opzione della console | flag dello strumento bq | Proprietà API BigQuery | Descrizione |
|---|---|---|---|
| Scrivi se vuota | Non supportata | WRITE_EMPTY |
Scrive i dati solo se la tabella è vuota. |
| Aggiungi a tabella | --noreplace o --replace=false; se --[no]replace non è specificato, il valore predefinito è append |
WRITE_APPEND |
(Impostazione predefinita) Aggiunge i dati alla fine della tabella. |
| Sovrascrivi tabella | --replace o --replace=true |
WRITE_TRUNCATE |
Cancella tutti i dati esistenti in una tabella prima di scrivere i nuovi dati. Questa azione elimina anche lo schema della tabella, la sicurezza a livello di riga e rimuove qualsiasi chiave Cloud KMS. |
Se carichi i dati in una tabella esistente, il job di caricamento può aggiungere i dati o sovrascrivere la tabella.
Per aggiungere o sovrascrivere una tabella con dati Avro:
Console
Nella console Google Cloud , apri la pagina BigQuery.
Nel riquadro a sinistra, fai clic su Spazio di esplorazione:
Nel riquadro Explorer, espandi il progetto, fai clic su Set di dati, quindi sul nome del set di dati.
Nel riquadro dei dettagli, fai clic su Crea tabella .
Nella pagina Crea tabella, nella sezione Origine:
- In Crea tabella da, seleziona Cloud Storage.
Nel campo di origine, vai all'URI Cloud Storage o inseriscilo. Tieni presente che non puoi includere più URI nella console Google Cloud , ma i caratteri jolly sono supportati. Il bucket Cloud Storage deve trovarsi nella stessa località del set di dati che contiene la tabella che stai aggiungendo o sovrascrivendo.
In Formato file, seleziona Avro.
Nella pagina Crea tabella, nella sezione Destinazione:
In Nome set di dati, scegli il set di dati appropriato.
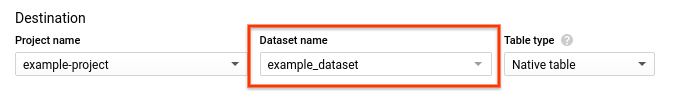
Nel campo Nome tabella, inserisci il nome della tabella che stai aggiungendo o sovrascrivendo in BigQuery.
Verifica che Tipo di tabella sia impostato su Tabella nativa.
Nella sezione Schema, non è necessaria alcuna azione. Lo schema è autodescritto nei file Avro.
In Impostazioni di partizionamento e clustering, lascia i valori predefiniti. Non puoi convertire una tabella in una tabella partizionata o in cluster aggiungendola o sovrascrivendola e la console Google Cloud non supporta l'aggiunta o la sovrascrittura di tabelle partizionate o in cluster in un job di caricamento.
Fai clic su Opzioni avanzate.
- In Preferenza di scrittura, scegli Aggiungi alla tabella o Sovrascrivi tabella.
- Per Valori sconosciuti, lascia deselezionata l'opzione Ignora valori sconosciuti. Questa opzione si applica solo ai file CSV e JSON.
- In Crittografia, fai clic su Chiave gestita dal cliente per utilizzare una chiave di Cloud Key Management Service. Se lasci l'impostazione Google-owned and managed key, BigQuery cripta i dati at-rest.
Fai clic su Crea tabella.
SQL
Utilizza l'istruzione DDL LOAD DATA.
L'esempio seguente aggiunge un file Avro alla tabella mytable:
Nella console Google Cloud , vai alla pagina BigQuery.
Nell'editor di query, inserisci la seguente istruzione:
LOAD DATA INTO mydataset.mytable
FROM FILES (
  format = 'avro',
  uris = ['gs://bucket/path/file.avro']);
Fai clic su Esegui.
Per saperne di più su come eseguire le query, consulta Esegui una query interattiva.
bq
Inserisci il comando bq load con il flag --replace per sovrascrivere la tabella. Utilizza il flag --noreplace per aggiungere dati alla tabella. Se non viene specificato alcun flag, per impostazione predefinita i dati vengono aggiunti. Specifica il flag --source_format e impostalo su AVRO. Poiché gli schemi Avro vengono recuperati automaticamente dai dati di origine autodescrittivi, non è necessario fornire una definizione dello schema.
(Facoltativo) Specifica il flag --location e imposta il valore sulla tua località.
Altri flag facoltativi includono:
--destination_kms_key: la chiave Cloud KMS per la crittografia dei dati della tabella.
bq --location=location load \
--[no]replace \
--source_format=format \
dataset.table \
path_to_source
Sostituisci quanto segue:
- location è la tua località.
Il flag
--locationè facoltativo. Puoi impostare un valore predefinito per la località utilizzando il file .bigqueryrc. - format è pari a
AVRO. - dataset è un set di dati esistente.
- table è il nome della tabella in cui stai caricando i dati.
- path_to_source è un URI Cloud Storage completo o un elenco separato da virgole di URI. Sono supportati anche i caratteri jolly.
Esempi:
Il seguente comando carica i dati da gs://mybucket/mydata.avro e sovrascrive una tabella denominata mytable in mydataset.
    bq load \
    --replace \
    --source_format=AVRO \
    mydataset.mytable \
    gs://mybucket/mydata.avro
Il seguente comando carica i dati da gs://mybucket/mydata.avro e li aggiunge a una tabella denominata mytable in mydataset.
    bq load \
    --noreplace \
    --source_format=AVRO \
    mydataset.mytable \
    gs://mybucket/mydata.avro
Per informazioni sull'aggiunta e sulla sovrascrittura di tabelle partizionate utilizzando lo strumento a riga di comando bq, consulta Aggiunta e sovrascrittura dei tabella partizionata partizionate.
API
Crea un job
loadche punti ai dati di origine in Cloud Storage.(Facoltativo) Specifica la tua località nella proprietà
locationnella sezionejobReferencedella risorsa job.La proprietà
source URIsdeve essere un nome completo nel formatogs://bucket/object. Puoi includere più URI come elenco separato da virgole. Tieni presente che sono supportati anche i caratteri jolly.Specifica il formato dei dati impostando la proprietà
configuration.load.sourceFormatsuAVRO.Specifica la preferenza di scrittura impostando la proprietà
configuration.load.writeDispositionsuWRITE_TRUNCATEoWRITE_APPEND.
Vai
Prima di provare questo esempio, segui le istruzioni di configurazione di Go nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Go.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Java
Prima di provare questo esempio, segui le istruzioni di configurazione di Java nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Java.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Node.js
Prima di provare questo esempio, segui le istruzioni di configurazione di Node.js nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Node.js.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Python
Prima di provare questo esempio, segui le istruzioni di configurazione di Python nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Python.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Caricamento dei dati Avro partizionati con Hive
BigQuery supporta il caricamento di dati Avro partizionati con Hive archiviati su Cloud Storage e compila le colonne di partizionamento Hive come colonne nella tabella gestita di BigQuery di destinazione. Per saperne di più, consulta Carica dati partizionati esternamente.
Conversioni Avro
BigQuery converte i tipi di dati Avro nei seguenti tipi di dati BigQuery:
Tipi primitivi
| Tipo di dati BigQuery | Note | |
|---|---|---|
| null | BigQuery ignora questi valori | |
| boolean | BOOLEANO | |
| int | INTEGER | |
| Lungo | INTEGER | |
| float | FLOAT | |
| double | FLOAT | |
| byte | BYTES | |
| string | STRING | Solo UTF-8 |
Tipi logici
Per impostazione predefinita, BigQuery ignora l'attributo logicalType per la maggior parte dei tipi e utilizza il tipo Avro sottostante. Per convertire i tipi logici Avro nei tipi di dati BigQuery corrispondenti, imposta il flag --use_avro_logical_types su true utilizzando lo strumento a riga di comando bq o imposta la proprietà useAvroLogicalTypes nella risorsa job quando chiami il metodo jobs.insert per creare un job di caricamento.
La tabella seguente mostra la conversione dei tipi logici Avro in tipi di dati BigQuery.
| Tipo di dati BigQuery: tipo logico disabilitato | Tipo di dati BigQuery: tipo logico abilitato | |
|---|---|---|
| data | INTEGER | DATA |
| time-millis | INTEGER | TEMPO |
| time-micros | INTEGER (convertito da LONG) | TEMPO |
| timestamp-millis | INTEGER (convertito da LONG) | TIMESTAMP |
| timestamp-micros | INTEGER (convertito da LONG) | TIMESTAMP |
| local-timestamp-millis | INTEGER (convertito da LONG) | DATETIME |
| local-timestamp-micros | INTEGER (convertito da LONG) | DATETIME |
| duration | BYTES (convertito dal tipo fixed di dimensione 12) |
BYTES (convertito dal tipo fixed di dimensione 12) |
| decimal | NUMERIC, BIGNUMERIC o STRING (consulta Tipo logico decimale) | NUMERIC, BIGNUMERIC o STRING (consulta Tipo logico decimale) |
Per ulteriori informazioni sui tipi di dati Avro, consulta la specifica Apache Avro™ 1.8.2.
Tipo logico Date
In qualsiasi file Avro che intendi caricare, devi specificare i tipi logici di data nel seguente formato:
{
       "type": {"logicalType": "date", "type": "int"},
       "name": "date_field"
}
Tipo logico decimale
I tipi logici Decimal possono essere convertiti in tipi NUMERIC, BIGNUMERIC o STRING. Il tipo convertito dipende dai parametri di precisione e scalabilità del tipo logico decimal e dai tipi di destinazione decimali specificati. Specifica il tipo di target decimale come segue:
- Per un job di caricamento che utilizza l'API
jobs.insert: utilizza il campoJobConfigurationLoad.decimalTargetTypes. - Per un job di caricamento che utilizza il comando
bq loadnello strumento a riga di comando bq: utilizza il flag--decimal_target_types. - Per una query su una tabella con origini esterne:
utilizza il campo
ExternalDataConfiguration.decimalTargetTypes. - Per una tabella esterna permanente creata con DDL:
utilizza l'opzione
decimal_target_types.
Per la compatibilità con le versioni precedenti, se i tipi di destinazione decimali non sono specificati, puoi caricare un file Avro contenente una colonna bytes con il tipo logico decimal in una colonna BYTES di una tabella esistente. In questo caso, il tipo logico decimal della colonna nel file Avro viene ignorato. Questa modalità di conversione è deprecata e potrebbe essere rimossa in futuro.
Per saperne di più sul tipo logico Avro decimal, consulta la specifica Apache Avro™ 1.8.2.
Tipo logico Time
In qualsiasi file Avro che intendi caricare, devi specificare i tipi logici di ora in uno dei seguenti formati.
Per la precisione in millisecondi:
{
       "type": {"logicalType": "time-millis", "type": "int"},
       "name": "time_millis_field"
}
Per la precisione in microsecondi:
{
       "type": {"logicalType": "time-micros", "type": "int"},
       "name": "time_micros_field"
}
Tipo logico timestamp
In qualsiasi file Avro che intendi caricare, devi specificare i tipi logici di timestamp in uno dei seguenti formati.
Per la precisione in millisecondi:
{
       "type": {"logicalType": "timestamp-millis", "type": "long"},
       "name": "timestamp_millis_field"
}
Per la precisione in microsecondi:
{
       "type": {"logicalType": "timestamp-micros", "type": "long"},
       "name": "timestamp_micros_field"
}
Tipo logico Local-Timestamp
In qualsiasi file Avro che intendi caricare, devi specificare un tipo logico local-timestamp in uno dei seguenti formati.
Per la precisione in millisecondi:
{
       "type": {"logicalType": "local-timestamp-millis", "type": "long"},
       "name": "local_timestamp_millis_field"
}
Per la precisione in microsecondi:
{
       "type": {"logicalType": "local-timestamp-micros", "type": "long"},
       "name": "local_timestamp_micros_field"
}
Tipi complessi
| Tipo di dati BigQuery | Note | |
|---|---|---|
| disco | RECORD |
|
| enum | STRING |
|
| matrice | campi ripetuti | Gli array di array non sono supportati. Gli array contenenti solo tipi NULL vengono ignorati. |
| map<T> | RECORD | BigQuery converte un campo Avro map<T> in un RECORD ripetuto che contiene due campi: una chiave e un valore. BigQuery archivia la chiave come STRING e converte il valore nel tipo di dati corrispondente in BigQuery. |
| unione |
|
|
| fisso | BYTES |
|