


Carica dati dalle esportazioni di Datastore
BigQuery ti consente di caricare le entità Datastore da un bucket Cloud Storage in una tabella BigQuery per l'analisi. Dopo aver esportato le entità utilizzando il servizio di importazione ed esportazione gestito di Datastore, puoi caricare tutti i dati delle entità o selezionare proprietà specifiche da importare.
Per caricare un'esportazione di Datastore in BigQuery, devi specificare un filtro entità nel comando di esportazione. Per saperne di più sulla creazione e sulla pianificazione delle esportazioni, consulta Esportazione e importazione di entità e Pianificazione di un'esportazione. Per eseguire query sui file di esportazione direttamente senza caricarli in BigQuery, consulta Origini dati esterne.
Limitazioni
Quando carichi i dati in BigQuery da un'esportazione di Datastore, tieni presente le seguenti limitazioni:
- Non puoi utilizzare un carattere jolly nell'URI Cloud Storage quando specifichi un file di esportazione di Datastore.
- Puoi specificare un solo URI Cloud Storage quando carichi i dati dalle esportazioni di Datastore.
- Non puoi aggiungere i dati di esportazione di Datastore a una tabella esistente con uno schema definito.
- Affinché un'esportazione di Datastore venga caricata correttamente, le entità nei dati di esportazione devono condividere uno schema coerente con meno di 10.000 nomi di proprietà univoci.
- I dati esportati senza specificare un filtro entità non possono essere caricati in BigQuery. La richiesta di esportazione deve includere uno o più nomi di tipo nel filtro delle entità.
- La dimensione massima dei campi per le esportazioni di Datastore è 64 kB. Quando carichi un'esportazione di Datastore, i campi di dimensioni superiori a 64 kB vengono troncati.
Prima di iniziare
Concedi i ruoli IAM (Identity and Access Management) che forniscono agli utenti le autorizzazioni necessarie per eseguire ogni attività in questo documento.
Autorizzazioni obbligatorie
Per caricare i dati in BigQuery, devi disporre delle autorizzazioni IAM per eseguire un job di caricamento e caricare i dati nelle tabelle BigQuery e nelle partizioni. Se carichi dati da Cloud Storage, devi anche disporre delle autorizzazioni IAM per accedere al bucket che contiene i tuoi dati.
Autorizzazioni per caricare i dati in BigQuery
Per caricare i dati in una nuova tabella o partizione BigQuery o per aggiungerli o sovrascriverli in una tabella o partizione esistente, devi disporre delle seguenti autorizzazioni IAM:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
Ognuno dei seguenti ruoli IAM predefiniti include le autorizzazioni necessarie per caricare i dati in una tabella BigQuery o partizione:
roles/bigquery.dataEditorroles/bigquery.dataOwnerroles/bigquery.admin(include l'autorizzazionebigquery.jobs.create)bigquery.user(include l'autorizzazionebigquery.jobs.create)bigquery.jobUser(include l'autorizzazionebigquery.jobs.create)
Inoltre, se disponi dell'autorizzazione bigquery.datasets.create, puoi creare e aggiornare le tabelle utilizzando un job di caricamento nei set di dati che crei.
Per saperne di più sui ruoli e sulle autorizzazioni IAM in BigQuery, consulta Ruoli e autorizzazioni predefiniti.
Autorizzazioni per caricare i dati da Cloud Storage
Per ottenere le autorizzazioni necessarie per caricare i dati da un bucket Cloud Storage, chiedi all'amministratore di concederti il ruolo IAM Storage Admin (roles/storage.admin) sul bucket.
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Questo ruolo predefinito contiene le autorizzazioni necessarie per caricare i dati da un bucket Cloud Storage. Per vedere quali sono esattamente le autorizzazioni richieste, espandi la sezione Autorizzazioni obbligatorie:
Autorizzazioni obbligatorie
Per caricare i dati da un bucket Cloud Storage sono necessarie le seguenti autorizzazioni:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
Potresti anche ottenere queste autorizzazioni con ruoli personalizzati o altri ruoli predefiniti.
Caricamento dei dati del servizio di esportazione Datastore
Per caricare i dati da un file di metadati di esportazione di Datastore:
Console
Nella console Google Cloud , vai alla pagina BigQuery.
- Nel riquadro a sinistra, fai clic su Explorer.
- Nel riquadro Explorer, espandi il progetto, fai clic su Set di dati e seleziona un set di dati.
- Nella sezione Informazioni set di dati, fai clic su Crea tabella.
- Nel riquadro Crea tabella, specifica i seguenti dettagli:
- Nella sezione Origine, seleziona Google Cloud Storage nell'elenco Crea tabella da.
Poi:
- Seleziona un file dal bucket Cloud Storage o inserisci l'URI Cloud Storage.
Non puoi includere più URI nella console Google Cloud , ma sono supportati i caratteri jolly. Il bucket Cloud Storage deve trovarsi nella stessa località del set di dati che contiene la tabella che vuoi creare, aggiungere o sovrascrivere.
L'URI del file di esportazione di Datastore deve terminare conKIND_NAME.export_metadataoexport[NUM].export_metadata. Ad esempio, indefault_namespace_kind_Book.export_metadata,Bookè il nome del tipo edefault_namespace_kind_Bookè il nome file generato da Datastore.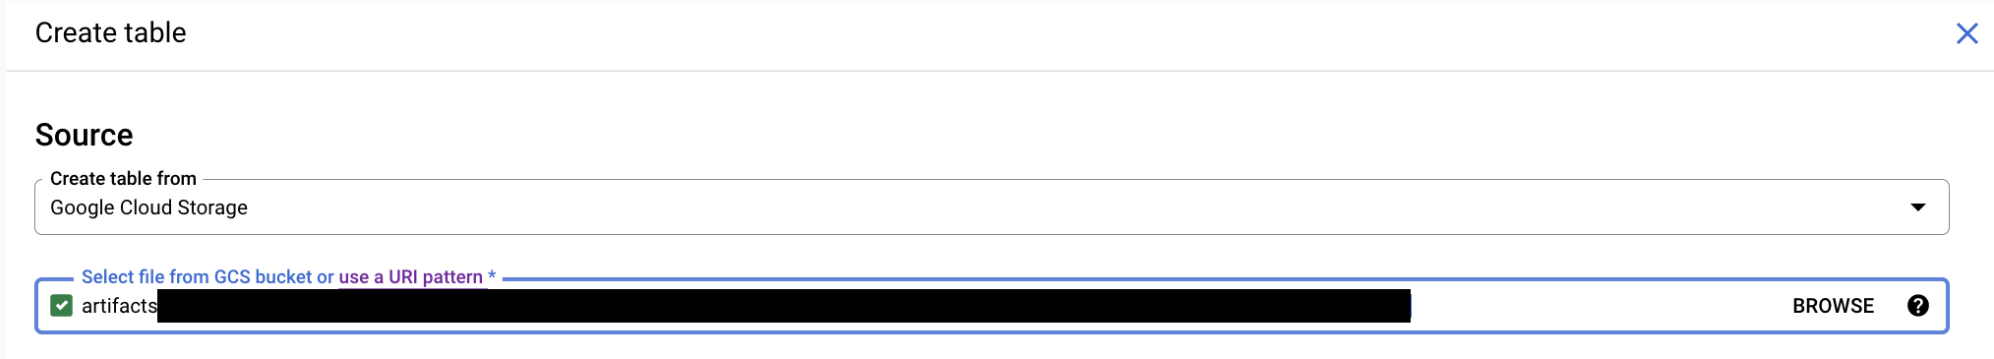
- In Formato file, seleziona Backup di Cloud Datastore.
- Seleziona un file dal bucket Cloud Storage o inserisci l'URI Cloud Storage.
Non puoi includere più URI nella console Google Cloud , ma sono supportati i caratteri jolly. Il bucket Cloud Storage deve trovarsi nella stessa località del set di dati che contiene la tabella che vuoi creare, aggiungere o sovrascrivere.
- Nella sezione Destinazione, specifica i seguenti dettagli:
- In Set di dati, seleziona il set di dati in cui vuoi creare la tabella.
- Nel campo Table (Tabella), inserisci il nome della tabella che vuoi creare.
- Verifica che il campo Tipo di tabella sia impostato su Tabella nativa.
- Nella sezione Schema, non è necessaria alcuna azione. Lo schema viene dedotto per un'esportazione di Datastore.
- (Facoltativo) Specifica le Impostazioni di partizionamento e clustering. Per saperne di più, consulta Creazione di tabelle partizionate e Creazione e utilizzo di tabelle in cluster.
- Fai clic su Opzioni avanzate e segui questi passaggi:
- In Preferenza di scrittura, lascia selezionata l'opzione Scrivi se vuota. Questa opzione crea una nuova tabella e vi carica i dati.
- Se vuoi ignorare i valori di una riga che non sono presenti nello schema della tabella, seleziona Valori sconosciuti.
- In Crittografia, fai clic su Chiave gestita dal cliente per utilizzare una chiave di Cloud Key Management Service. Se lasci l'impostazione Google-managed key, BigQuery cripta i dati at-rest. Per informazioni sulle opzioni disponibili, consulta Opzioni di Datastore.
- Fai clic su Crea tabella.
bq
Utilizza il comando bq load con source_format impostato su DATASTORE_BACKUP.
Specifica il flag --location e imposta il valore sulla tua località.
bq --location=LOCATION load \
--source_format=FORMAT \
DATASET.TABLE \
PATH_TO_SOURCE
Sostituisci quanto segue:
LOCATION: la tua località. Il flag--locationè facoltativo. Ad esempio, se utilizzi BigQuery nella regione di Tokyo, puoi impostare il valore del flag suasia-northeast1. Puoi impostare un valore predefinito per la località utilizzando il file.bigqueryrc.FORMAT:DATASTORE_BACKUP.DATASET: il set di dati che contiene la tabella in cui stai caricando i dati.TABLE: la tabella in cui stai caricando i dati. Se la tabella non esiste, viene creata.PATH_TO_SOURCE: l'URI Cloud Storage.
Ad esempio, il seguente comando carica il file di esportazione di Datastore gs://mybucket/20180228T1256/default_namespace/kind_Book/default_namespace_kind_Book.export_metadata in una tabella denominata book_data.
mybucket e mydataset sono stati creati nella località multiregionale US.
bq --location=US load \
--source_format=DATASTORE_BACKUP \
mydataset.book_data \
gs://mybucket/20180228T1256/default_namespace/kind_Book/default_namespace_kind_Book.export_metadata
API
Imposta le seguenti proprietà per caricare i dati di esportazione di Datastore utilizzando l'API.
Crea un job di caricamento che punti ai dati di origine in Cloud Storage.
Specifica la tua località nella proprietà
locationnella sezionejobReferencedella risorsa job.Gli URI di origine devono essere completi, nel formato gs://[BUCKET]/[OBJECT]. Il nome del file (oggetto) deve terminare con
[KIND_NAME].export_metadata. Per le esportazioni di Datastore è consentito un solo URI e non puoi utilizzare un carattere jolly.Specifica il formato dei dati impostando la proprietà
JobConfigurationLoad.sourceFormatsuDATASTORE_BACKUP.
Aggiunta o sovrascrittura di una tabella con dati di Datastore
Quando carichi i dati di esportazione di Datastore in BigQuery, puoi creare una nuova tabella per archiviare i dati o sovrascrivere una tabella esistente. Non puoi aggiungere dati di esportazione di Datastore a una tabella esistente.
Se tenti di aggiungere i dati di esportazione di Datastore a una tabella esistente, viene visualizzato il seguente errore: Cannot append a datastore backup to a table
that already has a schema. Try using the WRITE_TRUNCATE write disposition to
replace the existing table.
Per sovrascrivere una tabella esistente con i dati di esportazione di Datastore:
Console
Nella console Google Cloud , vai alla pagina BigQuery.
- Nel riquadro a sinistra, fai clic su Explorer.
- Nel riquadro Explorer, espandi il progetto, fai clic su Set di dati e seleziona un set di dati.
- Nella sezione Informazioni set di dati, fai clic su Crea tabella.
- Nel riquadro Crea tabella, specifica i seguenti dettagli:
- Nella sezione Origine, seleziona Google Cloud Storage nell'elenco Crea tabella da.
Poi:
- Seleziona un file dal bucket Cloud Storage o inserisci l'URI Cloud Storage.
Non puoi includere più URI nella console Google Cloud , ma sono supportati i caratteri jolly. Il bucket Cloud Storage deve trovarsi nella stessa località del set di dati che contiene la tabella che vuoi creare, aggiungere o sovrascrivere.
L'URI del file di esportazione di Datastore deve terminare conKIND_NAME.export_metadataoexport[NUM].export_metadata. Ad esempio, indefault_namespace_kind_Book.export_metadata,Bookè il nome del tipo edefault_namespace_kind_Bookè il nome file generato da Datastore. - In Formato file, seleziona Backup di Cloud Datastore.
- Seleziona un file dal bucket Cloud Storage o inserisci l'URI Cloud Storage.
Non puoi includere più URI nella console Google Cloud , ma sono supportati i caratteri jolly. Il bucket Cloud Storage deve trovarsi nella stessa località del set di dati che contiene la tabella che vuoi creare, aggiungere o sovrascrivere.
- Nella sezione Destinazione, specifica i seguenti dettagli:
- In Set di dati, seleziona il set di dati in cui vuoi creare la tabella.
- Nel campo Table (Tabella), inserisci il nome della tabella che vuoi creare.
- Verifica che il campo Tipo di tabella sia impostato su Tabella nativa.
- Nella sezione Schema, non è necessaria alcuna azione. Lo schema viene dedotto per un'esportazione di Datastore.
- (Facoltativo) Specifica le Impostazioni di partizionamento e clustering. Per saperne di più, consulta Creazione di tabelle partizionate e Creazione e utilizzo di tabelle in cluster. Non puoi convertire una tabella in una tabella partizionata o in cluster aggiungendola o sovrascrivendola. La console Google Cloud non supporta l'aggiunta o la sovrascrittura di tabelle partizionate o in cluster in un job di caricamento.
- Fai clic su Opzioni avanzate e segui questi passaggi:
- In Preferenza di scrittura, scegli Aggiungi alla tabella o Sovrascrivi tabella.
- Se vuoi ignorare i valori di una riga che non sono presenti nello schema della tabella, seleziona Valori sconosciuti.
- In Crittografia, fai clic su Chiave gestita dal cliente per utilizzare una chiave di Cloud Key Management Service. Se lasci l'impostazione Google-managed key, BigQuery cripta i dati at-rest. Per informazioni sulle opzioni disponibili, consulta Opzioni di Datastore.
- Fai clic su Crea tabella.
bq
Utilizza il comando bq load con il flag --replace e con source_format impostato su DATASTORE_BACKUP. Specifica il flag --location e imposta il valore sulla tua località.
bq --location=LOCATION load \
--source_format=FORMAT \
--replace \
DATASET.TABLE \
PATH_TO_SOURCE
Sostituisci quanto segue:
LOCATION: la tua località. Il flag--locationè facoltativo. Ad esempio, se utilizzi BigQuery nella regione di Tokyo, puoi impostare il valore del flag suasia-northeast1. Puoi impostare un valore predefinito per la località utilizzando il file.bigqueryrc.FORMAT:DATASTORE_BACKUP.DATASET: il set di dati contenente la tabella in cui stai caricando i dati.TABLE: la tabella che stai sovrascrivendo.PATH_TO_SOURCE: l'URI Cloud Storage.
Ad esempio, il seguente comando carica il file di esportazione di Datastore gs://mybucket/20180228T1256/default_namespace/kind_Book/default_namespace_kind_Book.export_metadata e sovrascrive una tabella denominata book_data:
bq load --source_format=DATASTORE_BACKUP \
--replace \
mydataset.book_data \
gs://mybucket/20180228T1256/default_namespace/kind_Book/default_namespace_kind_Book.export_metadata
API
Imposta le seguenti proprietà per caricare i dati dall'API.
Crea un job di caricamento che punti ai dati di origine in Cloud Storage.
Specifica la tua località nella proprietà
locationnella sezionejobReferencedella risorsa job.Gli URI di origine devono essere completi, nel formato gs://[BUCKET]/[OBJECT]. Il nome del file (oggetto) deve terminare con
[KIND_NAME].export_metadata. Per le esportazioni di Datastore è consentito un solo URI e non puoi utilizzare un carattere jolly.Specifica il formato dei dati impostando la proprietà
JobConfigurationLoad.sourceFormatsuDATASTORE_BACKUP.Specifica la disposizione di scrittura impostando la proprietà
JobConfigurationLoad.writeDispositionsuWRITE_TRUNCATE.
Opzioni del datastore
Puoi controllare quali proprietà vengono caricate da BigQuery e come analizza i dati di esportazione di Datastore impostando la proprietà projectionFields nell'API o utilizzando il flag --projection_fields nello strumento a riga di comando bq:
| Opzione della console | flag dello strumento bq | Proprietà API BigQuery | Descrizione |
|---|---|---|---|
| Non disponibile | --projection_fields |
projectionFields | Un elenco separato da virgole che indica quali proprietà delle entità caricare in BigQuery da un'esportazione di Datastore. I nomi delle proprietà sono sensibili alle maiuscole e devono essere proprietà di primo livello. Se non vengono specificate proprietà, BigQuery carica tutte le proprietà. Se una proprietà denominata non viene trovata nell'esportazione di Datastore, nel risultato del job viene restituito un errore non valido. Il valore predefinito è "". |
Conversione del tipo di dati
BigQuery converte i dati di ogni entità nei file di esportazione di Datastore in tipi di dati BigQuery. La tabella seguente descrive la conversione tra i tipi di dati.
| Tipo di dati Datastore | Tipo di dati BigQuery |
|---|---|
| Array | ARRAY |
| Blob | BYTES |
| Booleano | BOOLEAN |
| Data e ora | TIMESTAMP |
| Entità incorporata | RECORD |
| Numero in virgola mobile | FLOAT |
| Punto geografico |
[{"lat","DOUBLE"},
 {"long","DOUBLE"}]
|
| Numero intero | INTEGER |
| Chiave | RECORD |
| Null | STRING |
| Stringa di testo | STRING (troncato a 64 kB) |
Proprietà chiave di Datastore
Ogni entità in Datastore ha una chiave univoca che contiene informazioni come lo spazio dei nomi e il percorso. BigQuery crea un tipo di dati RECORD per la chiave, con campi nidificati per ogni informazione, come descritto nella tabella seguente.
| Proprietà della chiave | Descrizione | Tipo di dati BigQuery |
|---|---|---|
__key__.app |
Il nome dell'app Datastore. | STRING |
__key__.id |
L'ID dell'entità o null se __key__.name è impostato. |
INTEGER |
__key__.kind |
Il tipo di entità. | STRING |
__key__.name |
Il nome dell'entità o null se __key__.id è impostato. |
STRING |
__key__.namespace |
Se l'app Datastore utilizza uno spazio dei nomi personalizzato, lo spazio dei nomi dell'entità. In caso contrario, lo spazio dei nomi predefinito è rappresentato da una stringa vuota. | STRING |
__key__.path |
Il percorso ancestrale dell'entità, costituito dalla sequenza di coppie tipo-identificatore dall'entità base all'entità stessa. Ad esempio: "Country", "USA", "PostalCode",
10011, "Route", 1234. |
STRING |