


טעינת נתונים מייצוא של Datastore
ב-BigQuery אפשר לטעון ישויות של Datastore מקטגוריה של Cloud Storage לטבלה ב-BigQuery לצורך ניתוח. אחרי שמייצאים ישויות באמצעות שירות הייבוא והייצוא המנוהל של Datastore, אפשר לטעון את כל נתוני הישויות או לבחור מאפיינים ספציפיים לייבוא.
כדי לטעון ייצוא של Datastore ל-BigQuery, צריך לציין מסנן ישויות בפקודת הייצוא. למידע נוסף על יצירה ותזמון של ייצוא, ראו ייצוא וייבוא של ישויות ותזמון ייצוא. כדי לשלוח שאילתות על קובצי ייצוא ישירות בלי לטעון אותם ל-BigQuery, קראו את המאמר מקורות נתונים חיצוניים.
מגבלות
כשאתם טוענים נתונים ל-BigQuery מייצוא של Datastore, שימו לב למגבלות הבאות:
- אי אפשר להשתמש בתו כללי לחיפוש ב-URI של Cloud Storage כשמציינים קובץ ייצוא של Datastore.
- כשאתם טוענים נתונים מייצוא של Datastore, אתם יכולים לציין רק URI אחד של Cloud Storage.
- אי אפשר לצרף נתוני ייצוא של Datastore לטבלה קיימת עם סכימה מוגדרת.
- כדי שייצוא של Datastore ייטען בצורה נכונה, הישויות בנתוני הייצוא צריכות להיות בעלות סכימה עקבית עם פחות מ-10,000 שמות מאפיינים ייחודיים.
- אי אפשר לטעון ל-BigQuery נתונים שיוצאו בלי לציין מסנן ישויות. בקשת הייצוא חייבת לכלול לפחות שם אחד של סוג במסנן הישויות.
- גודל השדה המקסימלי לייצוא מ-Datastore הוא 64KB. כשאתם טוענים ייצוא של Datastore, כל שדה שגדול מ-64KB נחתך.
לפני שמתחילים
להקצות תפקידים של ניהול זהויות והרשאות גישה (IAM) שנותנים למשתמשים את ההרשאות הנדרשות כדי לבצע כל משימה שמופיעה במסמך הזה.
ההרשאות הנדרשות
כדי לטעון נתונים ל-BigQuery, אתם צריכים הרשאות IAM להרצת משימת טעינה ולטעינת נתונים לטבלאות ב-BigQuery ולמחיצות. אם אתם טוענים נתונים מ-Cloud Storage, אתם צריכים גם הרשאות IAM כדי לגשת לקטגוריה שמכילה את הנתונים.
הרשאות לטעינת נתונים ל-BigQuery
כדי לטעון נתונים לטבלה או למחיצה חדשה ב-BigQuery, או כדי להוסיף או להחליף טבלה או מחיצה קיימת, צריך את הרשאות ה-IAM הבאות:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
כל אחד מהתפקידים הבאים שמוגדרים מראש ב-IAM כולל את ההרשאות שצריך כדי לטעון נתונים לטבלה או למחיצה ב-BigQuery:
roles/bigquery.dataEditorroles/bigquery.dataOwner-
roles/bigquery.admin(כולל את ההרשאהbigquery.jobs.create) -
bigquery.user(כולל את ההרשאהbigquery.jobs.create) -
bigquery.jobUser(כולל את ההרשאהbigquery.jobs.create)
בנוסף, אם יש לכם את ההרשאה bigquery.datasets.create, אתם יכולים ליצור ולעדכן טבלאות באמצעות משימת טעינה בקבוצות הנתונים שאתם יוצרים.
למידע נוסף על תפקידים והרשאות של IAM ב-BigQuery, קראו את המאמר תפקידים והרשאות מוגדרים מראש.
הרשאות לטעינת נתונים מ-Cloud Storage
כדי לקבל את ההרשאות שנדרשות לטעינת נתונים מקטגוריה של Cloud Storage, בקשו מהאדמין לתת לכם את התפקיד אדמין של אחסון (roles/storage.admin) ב-IAM בקטגוריה.
כדי לקרוא הסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
זהו תפקיד שמוגדר מראש וכולל את ההרשאות שנדרשות לטעינת נתונים מקטגוריה של Cloud Storage. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי לטעון נתונים מקטגוריה של Cloud Storage, נדרשות ההרשאות הבאות:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
טעינת נתונים של שירות הייצוא של Datastore
כדי לטעון נתונים מקובץ מטא-נתונים של ייצוא מ-Datastore:
המסוף
נכנסים לדף BigQuery במסוף Google Cloud .
- בחלונית הימנית, לוחצים על Explorer.
- בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים מערך נתונים.
- בקטע Dataset info, לוחצים על Create table.
- בחלונית Create table, מציינים את הפרטים הבאים:
- בקטע Source, בוחרים באפשרות Google Cloud Storage ברשימה Create table from.
לאחר מכן, מבצעים את הפעולות הבאות:
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
ה-URI של קובץ הייצוא של Datastore חייב להסתיים ב-KIND_NAME.export_metadataאו ב-export[NUM].export_metadata. לדוגמה, ב-default_namespace_kind_Book.export_metadata, Bookהוא שם הסוג ו-default_namespace_kind_Bookהוא שם הקובץ שנוצר על ידי Datastore.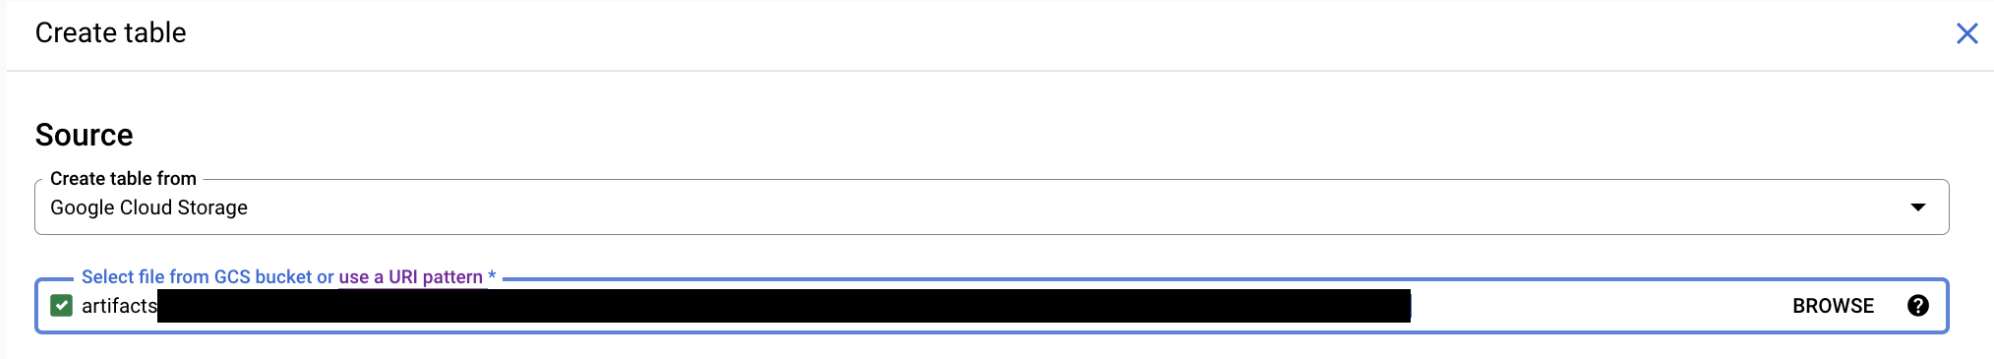
- בשדה פורמט קובץ, בוחרים באפשרות Cloud Datastore Backup.
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בקטע Destination, מציינים את הפרטים הבאים:
- בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table, מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהשדה Table type מוגדר ל-Native table.
- בקטע Schema, לא צריך לעשות כלום. הסכימה מוסקת לייצוא של Datastore.
- אופציונלי: מציינים את הגדרות המחיצה והאשכול. מידע נוסף זמין במאמרים יצירת טבלאות מחולקות למחיצות ויצירה של טבלאות מסודרות באשכולות ושימוש בהן.
- לוחצים על אפשרויות מתקדמות ומבצעים את הפעולות הבאות:
- בשדה Write preference, משאירים את האפשרות Write if empty מסומנת. This option creates a new table and loads your data into it.
- אם רוצים להתעלם מערכים בשורה שלא קיימים בסכימה של הטבלה, בוחרים באפשרות Unknown values.
- בקטע Encryption, לוחצים על Customer-managed key כדי להשתמש במפתח של Cloud Key Management Service. אם משאירים את ההגדרה Google-managed key, הנתונים מוצפנים במצב מנוחה ב-BigQuery. למידע על האפשרויות הזמינות, ראו אפשרויות Datastore.
- לוחצים על Create table.
BQ
משתמשים בפקודה bq load עם source_format שמוגדר ל-DATASTORE_BACKUP.
מציינים את הדגל --location ומגדירים את הערך למיקום שלכם.
bq --location=LOCATION load \
--source_format=FORMAT \
DATASET.TABLE \
PATH_TO_SOURCE
מחליפים את מה שכתוב בשדות הבאים:
-
LOCATION: המיקום שלכם. הדגל--locationהוא אופציונלי. לדוגמה, אם אתם משתמשים ב-BigQuery באזור טוקיו, אתם יכולים להגדיר את הערך של הדגל ל-asia-northeast1. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ bigqueryrc.. FORMAT:DATASTORE_BACKUP.-
DATASET: קבוצת הנתונים שמכילה את הטבלה שאליה אתם טוענים נתונים. -
TABLE: הטבלה שאליה אתם טוענים נתונים. אם הטבלה לא קיימת, היא נוצרת. -
PATH_TO_SOURCE: ה-URI של Cloud Storage.
לדוגמה, הפקודה הבאה טוענת את קובץ הייצוא gs://mybucket/20180228T1256/default_namespace/kind_Book/default_namespace_kind_Book.export_metadata של Datastore לטבלה בשם book_data.
mybucket ו-mydataset נוצרו במיקום US שכולל מספר אזורים.
bq --location=US load \
--source_format=DATASTORE_BACKUP \
mydataset.book_data \
gs://mybucket/20180228T1256/default_namespace/kind_Book/default_namespace_kind_Book.export_metadata
API
כדי לטעון נתוני ייצוא של Datastore באמצעות ה-API, מגדירים את המאפיינים הבאים:
יוצרים משימת טעינה שמפנה לנתוני המקור ב-Cloud Storage.
מציינים את המיקום במאפיין
locationבקטעjobReferenceשל משאב המשימה.מזהי ה-URI של המקור צריכים להיות מלאים, בפורמט gs://[BUCKET]/[OBJECT]. שם הקובץ (האובייקט) חייב להסתיים ב-
[KIND_NAME].export_metadata. אפשר להשתמש רק ב-URI אחד לייצוא של Datastore, ואי אפשר להשתמש בתו כללי לחיפוש.מציינים את פורמט הנתונים על ידי הגדרת המאפיין
JobConfigurationLoad.sourceFormatלערךDATASTORE_BACKUP.
הוספה לטבלה או החלפה של טבלה עם נתונים מ-Datastore
כשאתם טוענים נתוני ייצוא של Datastore ל-BigQuery, אתם יכולים ליצור טבלה חדשה לאחסון הנתונים או להחליף טבלה קיימת. אי אפשר לצרף נתוני ייצוא של Datastore לטבלה קיימת.
אם תנסו להוסיף נתוני ייצוא של Datastore לטבלה קיימת, תתקבל השגיאה הבאה: Cannot append a datastore backup to a table
that already has a schema. Try using the WRITE_TRUNCATE write disposition to
replace the existing table.
כדי להחליף טבלה קיימת בנתוני ייצוא של Datastore:
המסוף
נכנסים לדף BigQuery במסוף Google Cloud .
- בחלונית הימנית, לוחצים על Explorer.
- בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים מערך נתונים.
- בקטע Dataset info, לוחצים על Create table.
- בחלונית Create table, מציינים את הפרטים הבאים:
- בקטע Source, בוחרים באפשרות Google Cloud Storage ברשימה Create table from.
לאחר מכן, מבצעים את הפעולות הבאות:
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
ה-URI של קובץ הייצוא של Datastore חייב להסתיים ב-KIND_NAME.export_metadataאו ב-export[NUM].export_metadata. לדוגמה, ב-default_namespace_kind_Book.export_metadata, Bookהוא שם הסוג ו-default_namespace_kind_Bookהוא שם הקובץ שנוצר על ידי Datastore. - בשדה פורמט קובץ, בוחרים באפשרות Cloud Datastore Backup.
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בקטע Destination, מציינים את הפרטים הבאים:
- בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table, מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהשדה Table type מוגדר ל-Native table.
- בקטע Schema, לא צריך לעשות כלום. הסכימה מוסקת לייצוא של Datastore.
- אופציונלי: מציינים את הגדרות המחיצה והאשכול. מידע נוסף זמין במאמרים יצירת טבלאות מחולקות למחיצות ויצירה של טבלאות מסודרות באשכולות ושימוש בהן. אי אפשר להמיר טבלה לטבלה מחולקת למחיצות או לטבלה מסודרת באשכולות על ידי הוספה או החלפה שלה. במסוף Google Cloud אי אפשר להוסיף נתונים לטבלאות מחולקות למחיצות או לטבלאות מסודרות באשכולות, או להחליף אותן, במסגרת משימת טעינה.
- לוחצים על אפשרויות מתקדמות ומבצעים את הפעולות הבאות:
- בקטע Write preference, בוחרים באפשרות Append to table או Overwrite table.
- אם רוצים להתעלם מערכים בשורה שלא קיימים בסכימה של הטבלה, בוחרים באפשרות Unknown values.
- בקטע Encryption, לוחצים על Customer-managed key כדי להשתמש במפתח של Cloud Key Management Service. אם משאירים את ההגדרה Google-managed key, הנתונים מוצפנים במצב מנוחה ב-BigQuery. למידע על האפשרויות הזמינות, ראו אפשרויות Datastore.
- לוחצים על Create table.
BQ
משתמשים בפקודה bq load עם הדגל --replace, ומגדירים את source_format לערך DATASTORE_BACKUP. מציינים את הדגל --location ומגדירים את הערך למיקום שלכם.
bq --location=LOCATION load \
--source_format=FORMAT \
--replace \
DATASET.TABLE \
PATH_TO_SOURCE
מחליפים את מה שכתוב בשדות הבאים:
-
LOCATION: המיקום שלכם. הדגל--locationהוא אופציונלי. לדוגמה, אם אתם משתמשים ב-BigQuery באזור טוקיו, אתם יכולים להגדיר את הערך של הדגל ל-asia-northeast1. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ bigqueryrc.. FORMAT:DATASTORE_BACKUP.-
DATASET: קבוצת הנתונים שמכילה את הטבלה שאליה אתם טוענים את הנתונים. -
TABLE: הטבלה שאתם מחליפים. -
PATH_TO_SOURCE: ה-URI של Cloud Storage.
לדוגמה, הפקודה הבאה טוענת את קובץ הייצוא gs://mybucket/20180228T1256/default_namespace/kind_Book/default_namespace_kind_Book.export_metadata של Datastore ומחליפה טבלה בשם book_data:
bq load --source_format=DATASTORE_BACKUP \
--replace \
mydataset.book_data \
gs://mybucket/20180228T1256/default_namespace/kind_Book/default_namespace_kind_Book.export_metadata
API
מגדירים את המאפיינים הבאים כדי לטעון נתונים מה-API.
יוצרים משימת טעינה שמפנה לנתוני המקור ב-Cloud Storage.
מציינים את המיקום במאפיין
locationבקטעjobReferenceשל משאב המשימה.מזהי ה-URI של המקור צריכים להיות מלאים, בפורמט gs://[BUCKET]/[OBJECT]. שם הקובץ (האובייקט) חייב להסתיים ב-
[KIND_NAME].export_metadata. אפשר להשתמש רק ב-URI אחד לייצוא של Datastore, ואי אפשר להשתמש בתו כללי לחיפוש.מציינים את פורמט הנתונים על ידי הגדרת המאפיין
JobConfigurationLoad.sourceFormatלערךDATASTORE_BACKUP.מגדירים את אופן הכתיבה באמצעות הגדרת המאפיין
JobConfigurationLoad.writeDispositionלערךWRITE_TRUNCATE.
אפשרויות של מאגר הנתונים
כדי לקבוע אילו מאפיינים ייטענו ב-BigQuery ואיך ינותחו נתוני הייצוא של Datastore, מגדירים את המאפיין projectionFields ב-API או משתמשים בדגל --projection_fields בכלי שורת הפקודה של BigQuery:
| אפשרות המסוף | דגל של הכלי bq | נכס BigQuery API | תיאור |
|---|---|---|---|
| לא זמין | --projection_fields |
projectionFields | רשימה מופרדת בפסיקים שמציינת אילו מאפייני ישויות צריך לטעון ל-BigQuery מייצוא של Datastore. שמות המאפיינים תלויי אותיות רישיות (case-sensitive) וחייבים להיות מאפיינים ברמה העליונה. אם לא מציינים מאפיינים, BigQuery טוען את כל המאפיינים. אם אחד מהמאפיינים שצוינו לא נמצא בייצוא של Datastore, תוחזר שגיאה לא חוקית בתוצאת המשימה. ערך ברירת המחדל הוא ''. |
המרת סוג נתונים
BigQuery ממיר נתונים מכל ישות בקובצי הייצוא של Datastore לסוגי נתונים של BigQuery. בטבלה הבאה מתוארת ההמרה בין סוגי נתונים.
| סוג הנתונים ב-Datastore | סוג הנתונים ב-BigQuery |
|---|---|
| מערך | ARRAY |
| כתם | BYTES |
| בוליאני | BOOLEAN |
| תאריך ושעה | TIMESTAMP |
| ישות מוטמעת | RECORD |
| מספר בשיטת נקודה צפה | FLOAT |
| נקודה גיאוגרפית |
[{"lat","DOUBLE"},
 {"long","DOUBLE"}]
|
| מספר שלם | INTEGER |
| מפתח | RECORD |
| Null | STRING |
| מחרוזת טקסט | STRING (נחתך ל-64KB) |
מאפייני מפתח של מאגר הנתונים
לכל ישות ב-Datastore יש מפתח ייחודי שמכיל מידע כמו מרחב השמות והנתיב. BigQuery יוצר סוג נתונים RECORD למפתח, עם שדות בתצוגת עץ לכל פיסת מידע, כמו שמתואר בטבלה הבאה.
| מאפיין מפתח | תיאור | סוג הנתונים ב-BigQuery |
|---|---|---|
__key__.app |
שם האפליקציה ב-Datastore. | מחרוזת |
__key__.id |
מזהה הישות, או null אם מוגדר __key__.name. |
מספר שלם |
__key__.kind |
סוג הישות. | מחרוזת |
__key__.name |
שם הישות, או null אם __key__.id מוגדר. |
מחרוזת |
__key__.namespace |
אם באפליקציית Datastore נעשה שימוש במרחב שמות בהתאמה אישית, מרחב השמות של הישות. אחרת, מרחב השמות שמוגדר כברירת מחדל מיוצג על ידי מחרוזת ריקה. | מחרוזת |
__key__.path |
הנתיב השטוח של הישות, שמורכב מרצף של זוגות מזהים של סוגים מישות השורש ועד לישות עצמה. לדוגמה: "Country", "USA", "PostalCode",
10011, "Route", 1234. |
מחרוזת |