


העברת טבלאות של Apache Hive Metastore אלGoogle Cloud
במאמר הזה מוסבר איך להעביר ל-Google Cloud את טבלאות Iceberg ו-Hive שמנוהלות על ידי Apache Hive Metastore, באמצעות שירות העברת הנתונים ל-BigQuery.
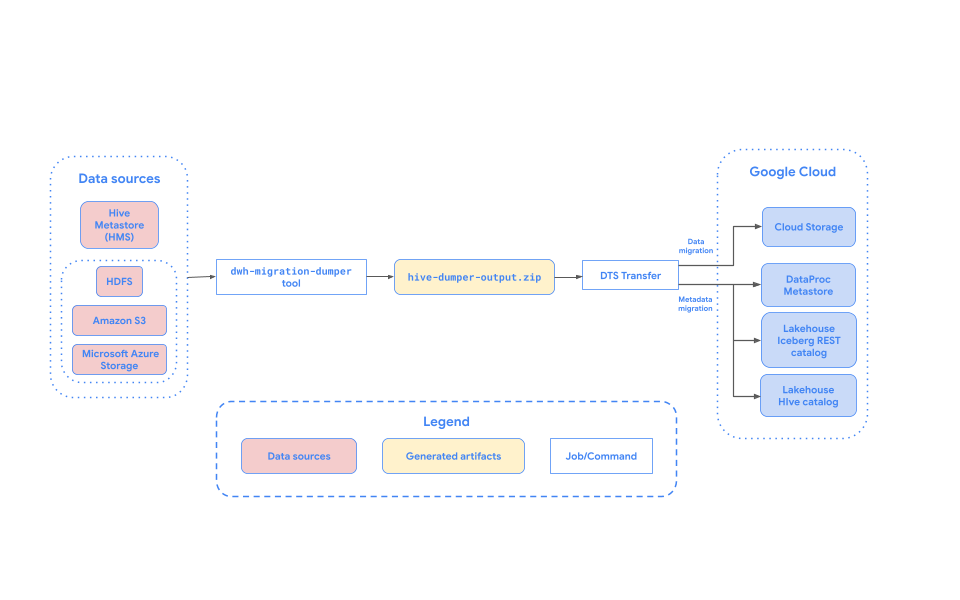
מחבר ההעברה של Apache Hive Metastore בשירות העברת הנתונים ל-BigQuery מאפשר להעביר בצורה חלקה את הטבלאות של Hive Metastore אל Google Cloud , בכל קנה מידה. המחבר הזה תומך בטבלאות Hive ו-Iceberg מהתקנות מקומיות ומסביבות ענן, כולל הגדרות Cloudera. מחבר ההעברה של Hive Metastore תומך בקבצים שמאוחסנים במקורות הנתונים הבאים:
- מערכת הקבצים המבוזרת של Apache Hadoop (HDFS)
- Amazon Simple Storage Service (Amazon S3)
- Azure Blob Storage או Azure Data Lake Storage Gen2
בעזרת מחבר ההעברה של Hive Metastore, אתם יכולים להשתמש ב-Cloud Storage בתור אחסון הקבצים ולרשום את הטבלאות של Hive Metastore באחד מהמטא-נתונים הבאים:
קטלוג ייעודי לזמן ריצה של Lakehouse, קטלוג REST של Iceberg
מומלץ להשתמש בקטלוג Iceberg REST של Lakehouse לכל נתוני Iceberg.
קטלוג REST של Iceberg, שהוא קטלוג ייעודי לזמן ריצה ב-Lakehouse, מאפשר יכולת פעולה הדדית בין מנועי השאילתות שלכם, כי הוא משמש כמקור מידע מהימן אחד לכל נתוני Iceberg. אתם יכולים להשתמש ב-BigQuery כדי לשלוח שאילתות לנתונים, בנוסף ל-Apache Spark ולמנועי OSS אחרים. הקטלוג הייעודי לזמן ריצה של Lakehouse, Iceberg REST Catalog, תומך רק בפורמטים של טבלאות Iceberg.
קטלוג Hive של קטלוג ייעודי לזמן ריצה של Lakehouse (גרסת טרום-השקה (Preview))
מומלץ להשתמש בקטלוג ייעודי לזמן ריצה של Lakehouse, קטלוג Hive, לכל טבלאות Hive.
הקטלוג של Hive בקטלוג הייעודי לזמן ריצה של Lakehouse מאפשר לכם לרשום את טבלאות Hive שהועברו בקטלוג הייעודי לזמן ריצה של Lakehouse באמצעות קטלוג של Hive. הוא מספק metastore ללא שרת (serverless) לטבלאות Apache Hive. אתם יכולים להשתמש ב-BigQuery כדי לשלוח שאילתות לגבי הנתונים (בכפוף למגבלות הפורמט), בנוסף ל-Apache Spark ולמנועי OSS אחרים.
המחבר הזה תומך בהעברות מלאות ובהעברות של מטא-נתונים בלבד. בהעברות מלאות, גם הנתונים וגם המטא-נתונים יועברו מטבלאות המקור למטא-נתונים של היעד. אם הנתונים שלכם כבר נמצאים ב-Cloud Storage ואתם רוצים רק לרשום אותם במאגר מטא-נתונים ביעד, אתם יכולים ליצור העברה של מטא-נתונים בלבד.
בתרשים הבא מוצגת סקירה כללית של תהליך ההעברה.
מגבלות
העברות של טבלאות Hive Metastore כפופות למגבלות הבאות:
- בהעברות של Hive Metastore, צריך להיות מרווח של 30 דקות לפחות בין שתי הפעלות מתוזמנות. עדיין אפשר להפעיל הרצות על פי דרישה בכל מרווח זמן.
- שמות הקבצים חייבים לעמוד בדרישות למתן שמות לאובייקטים ב-Cloud Storage.
- ב-Cloud Storage יש מגבלה של 5 TiB לאובייקטים בודדים. קבצים בטבלאות Hive Metastore שגדולים מ-5TiB לא יועברו.
- ל-Storage Transfer Service יש התנהגויות ספציפיות אם הנתונים משתנים במקור בזמן שההעברה מתבצעת. לא מומלץ לכתוב לטבלאות בזמן שהן מועברות באופן פעיל. לרשימה של מגבלות אחרות של Storage Transfer Service, קראו את המאמר מגבלות ידועות.
מגבלות של קטלוג Hive בקטלוג ייעודי לזמן ריצה של Lakehouse
כשמשתמשים ב-Hive Catalog (BIGLAKE_HIVE_CATALOG) של הקטלוג הייעודי לזמן ריצה של Lakehouse בתור מאגר המטא-נתונים של היעד, חלות המגבלות והשיקולים הבאים:
- מזהה הקטלוג של Hive בקטלוג הייעודי לזמן ריצה של Lakehouse יכול להכיל רק אותיות קטנות, מספרים וקווים תחתונים (
_). הוא לא יכול להכיל מקפים (-) או אותיות רישיות. - אי אפשר לראות או לנהל את קטלוגי Hive של קטלוג ייעודי לזמן ריצה של Lakehouse במסוף Google Cloud . עם זאת, אפשר לראות את הטבלאות שהועברו ולשלוח אליהן שאילתות בקבוצת הנתונים של BigQuery.
- כל המגבלות של Hive Catalog בקטלוג הייעודי לזמן ריצה של Lakehouse חלות על סוגי נתונים ופורמטים של מטא-נתונים בקוד פתוח.
- למידע על תאימות לפורמטים כמו CSV ו-JSON, קראו את המאמר פורמטים נתמכים של אחסון.
- למידע על סוגי נתונים שלא נתמכים (כמו
UNIONאו מערכים בתצוגת עץ) ועל נתונים סטטיסטיים של עמודות, קראו את המאמרים מגבלות של מטא-נתונים ומגבלות של מחיצות.
אפשרויות להטמעת נתונים
בקטעים הבאים מוסבר איך להגדיר את ההעברות של Hive Metastore.
העברות מצטברות
כשמגדירים העברה עם לוח זמנים קבוע, כל העברה שמתבצעת אחרי ההעברה הראשונה מעדכנת את הטבלה ב- Google Cloud עם העדכונים האחרונים שבוצעו בטבלת המקור. לדוגמה, כל עדכוני הנתונים וכל פעולות ההוספה, המחיקה או העדכון עם שינויי סכימה משתקפים ב- Google Cloud בכל העברה.
סינון מחיצות
כדי להעביר קבוצת משנה של מחיצות מטבלאות Hive, אתם יכולים לספק קובץ JSON של מסנן בהתאמה אישית שמאוחסן ב-Cloud Storage. כשמתזמנים את ההעברה, צריך לציין את הנתיב המלא של קובץ ה-JSON ב-Cloud Storage באמצעות הפרמטר partition_filter_gcs_path.
הנה דוגמה למבנה של קובץ JSON של מסנן:
{
  "filters": [
    {
      "table": "db1.table1", "condition": "IN", "partitions":
      ["partition1=value1/partition2=value2"]
    },
    {
      "table": "db1.table2", "condition": "LESS_THAN", "partitions":
      ["partition1;value1"]
    },
    {
      "table": "db1.table3", "condition": "GREATER_THAN", "partitions":
      ["partition1;value1"]
    },
    {
      "table": "db1.table4", "condition": "RANGE", "partitions":
      ["partition1;value1;value2"]
    }
  ]
}
תנאי המסנן
השדה condition בקובץ ה-JSON תומך בערכים הבאים, לכל אחד מהם יש פורמט ספציפי למערך partitions:
-
IN: מציין את הנתיבים המדויקים של המחיצות שצריך לכלול. המערךpartitionsמכיל מחרוזות שמייצגות את מבנה הספרייה המדויק של המחיצות ביחס לנתיב הבסיס של הטבלה (לדוגמה,["partition_key1=value1/partition_key2=value2"]). אפשר לציין כמה נתיבים במערך. -
LESS_THAN: כולל מחיצות שבהן הערך של מפתח המחיצה הראשי קטן מהערך שצוין או שווה לו. המערךpartitionsחייב להכיל מחרוזת אחת בפורמט["<partition_key>;<value>"]. -
GREATER_THAN: כולל מחיצות שבהן הערך של מפתח המחיצה הראשי גדול מהערך שצוין או שווה לו. המערךpartitionsחייב להכיל מחרוזת אחת בפורמט["<partition_key>;<value>"]. -
RANGE: כולל מחיצות שבהן הערך של מפתח המחיצה הראשי נמצא בטווח שצוין (כולל). המערךpartitionsחייב להכיל מחרוזת אחת בפורמט["<partition_key>;<start_value>;<end_value>"].
התנאים של המסננים כפופים לכללים ולהגבלות הבאים:
- ערכים כוללים: תנאי הסינון של
GREATER_THAN,LESS_THANו-RANGEכוללים את הערכים שצוינו. לדוגמה, מסנןLESS_THANעם הערך2023כולל מחיצות עד2023, כולל. - מחיקת מחיצות: אם מחיצת יעד קיימת עומדת בתנאי מסנן המחיצות והיא כבר לא קיימת במקור, היא תוסר מהמטא-נתונים של היעד. עם זאת, קובצי הנתונים הבסיסיים של אותה מחיצה לא נמחקים מקטגוריית היעד ב-Cloud Storage.
- הגבלות על טבלה אחת:
- אי אפשר להחיל כמה מסננים על אותה טבלה.
- אי אפשר לשלב סוגי תנאים שונים (לדוגמה:
GREATER_THANו-IN) באותה טבלה.
- עמודת המחיצה לטירגוט: תנאי הסינון כמו
GREATER_THAN,LESS_THANו-RANGEחייבים לטרגט את עמודת המחיצה הראשית. - מגבלות על קידומות: שילוב המסננים שצוין לא יכול להוביל ליותר מ-1,000 קידומות לכל טבלה. לדוגמה, מסנן כמו
year>2020בטבלה שמחולקת למחיצות לפיyear/month/dayצריך להניב פחות מ-1,000 קידומות ייחודיות שלyear=.
לפני שמתחילים
לפני שמתזמנים העברה של Hive Metastore, צריך לבצע את השלבים שבקטע הזה.
הפעלת ממשקי ה-API
מפעילים את ממשקי ה-API הבאים בפרויקט ב-Google Cloud :
- Data Transfer API
- Storage Transfer API
- BigLake API
כשמפעילים את Data Transfer API נוצר סוכן שירות.
הגדרת ההרשאות
כדי להגדיר הרשאות להעברה של Hive Metastore, בצעו את השלבים שבקטעים הבאים.
- למשתמש או לחשבון השירות שיוצרים את ההעברה צריך להיות התפקיד אדמין ב-BigQuery (
roles/bigquery.admin). אם משתמשים בחשבון שירות, הוא משמש רק ליצירת ההעברה. כשמפעילים את Data Transfer API, נוצר סוכן שירות (P4SA).
כדי לוודא שלסוכן השירות יש את ההרשאות הנדרשות להפעלת העברה של Hive Metastore, בקשו מהאדמין להקצות לסוכן השירות את תפקידי ה-IAM הבאים בפרויקט:
- אדמין של Storage Transfer (
roles/storagetransfer.admin) - Service Usage Consumer (
roles/serviceusage.serviceUsageConsumer) - אדמין באחסון (
roles/storage.admin) -
כדי להעביר מטא-נתונים לקטלוג ייעודי לזמן ריצה של Lakehouse (קטלוג REST של Iceberg או קטלוג Hive):
אדמין ב-BigLake (
roles/biglake.admin)
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
יכול להיות שהאדמין גם יוכל לתת לסוכן השירות את ההרשאות הנדרשות באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
- אדמין של Storage Transfer (
אם משתמשים בחשבון שירות, מקצים לסוכן השירות את התפקיד
roles/iam.serviceAccountTokenCreatorבאמצעות הפקודה הבאה:gcloud iam service-accounts add-iam-policy-binding SERVICE_ACCOUNT --member serviceAccount:service-PROJECT_NUMBER@gcp-sa-bigquerydatatransfer.iam.gserviceaccount.com --role roles/iam.serviceAccountTokenCreator
מקצים לסוכן השירות של Storage Transfer Service (
project-PROJECT_NUMBER@storage-transfer-service.iam.gserviceaccount.com) את התפקידים הבאים בפרויקט:roles/storage.admin- אם אתם מעבירים משרת מקומי או מ-HDFS, אתם צריכים גם להקצות את התפקיד
roles/storagetransfer.serviceAgent.
אפשר גם להגדיר הרשאות מפורטות יותר. מידע נוסף זמין במדריך הבא:
יצירת קובץ מטא-נתונים ל-Apache Hive
מריצים את הכלי dwh-migration-dumper כדי לחלץ מטא-נתונים ל-Apache Hive.
הכלי יוצר קובץ בשם hive-dumper-output.zip שאפשר להעלות לקטגוריה של Cloud Storage. הקטגוריה הזו של Cloud Storage נקראת במסמך הזה DUMPER_BUCKET.
אפשר גם לתזמן העלאות תקופתיות באמצעות סקריפט. מידע נוסף זמין במאמר הפעלה אוטומטית של כלי ה-dumper באמצעות משימת cron.
הגדרת Storage Transfer Service
בוחרים באחת מהאפשרויות הבאות:
HDFS
כדי להעביר נתונים מקומית או באמצעות HDFS, צריך סוכן להעברת נתונים.
כדי להגדיר את הנציג:
- מתקינים את Docker במכונות של הסוכנים המקומיים.
- יוצרים מאגר סוכנים של Storage Transfer Service בפרויקט ב- Google Cloud .
- מתקינים סוכנים במכונות של הסוכנים המקומיים.
Amazon S3
העברות מ-Amazon S3 הן העברות ללא סוכנים.
כדי להגדיר את Storage Transfer Service להעברה מ-Amazon S3, בצע את הפעולות הבאות:
- הגדרת פרטי כניסה ל-AWS Amazon S3.
- אחרי שמגדירים את פרטי הכניסה, חשוב לזכור את המזהה של מפתח הגישה ואת מפתח הגישה הסודי.
- אם בפרויקט ב-AWS יש הגבלות על כתובות IP, הוסיפו את טווחי כתובות ה-IP שמשמשים את ה-workers של Storage Transfer Service לרשימת כתובות ה-IP המותרות.
Microsoft Azure
העברות מ-Microsoft Azure Storage הן העברות ללא סוכנים.
כדי להגדיר את Storage Transfer Service להעברה מ-Microsoft Azure Storage:
- יוצרים אסימון Shared Access Signature (SAS) לחשבון האחסון ב-Microsoft Azure.
- שימו לב לטוקן ה-SAS אחרי שאתם יוצרים אותו.
- אם בחשבון האחסון ב-Microsoft Azure יש הגבלות על כתובות IP, הוסיפו לרשימת כתובות ה-IP המורשות את טווחי כתובות ה-IP שמשמשים את ה-workers של Storage Transfer Service.
תזמון העברה של Hive Metastore
בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף Data transfers במסוף Google Cloud .
לוחצים על Create transfer.
בקטע Source type, בוחרים באפשרות Hive Metastore מהרשימה Source.
בקטע Location, בוחרים סוג מיקום ואז בוחרים אזור.
בקטע Transfer config name, בשדה Display name, נותנים שם להעברת הנתונים.
בקטע Schedule options:
- ברשימה Repeat frequency, בוחרים אפשרות כדי לציין את התדירות שבה העברת הנתונים הזו תפעל. כדי להגדיר תדירות חזרה מותאמת אישית, לוחצים על בהתאמה אישית. אם בוחרים באפשרות על פי דרישה, ההעברה תתבצע כשתפעילו אותה ידנית.
- אם רלוונטי, בוחרים באפשרות Start now או Start at set time ומציינים תאריך התחלה וזמן ריצה.
בקטע פרטי מקור הנתונים, מבצעים את הפעולות הבאות:
- בקטע Transfer strategy, בוחרים אחת מהאפשרויות הבאות:
-
FULL_TRANSFER: העברת כל הנתונים ורישום המטא-נתונים במטא-נתונים של היעד. זו האפשרות שמוגדרת כברירת המחדל. -
METADATA_ONLY: רישום מטא-נתונים בלבד. הנתונים כבר צריכים להיות במיקום הנכון ב-Cloud Storage, שאליו מפנים המטא-נתונים.
-
- בשדה Table name patterns, מציינים את הטבלאות של אגם הנתונים ב-HDFS שרוצים להעביר. לשם כך, מזינים את שמות הטבלאות או תבניות שתואמות לטבלאות במסד הנתונים של HDFS. כדי לציין תבניות של טבלאות, צריך להשתמש בתחביר של ביטויים רגולריים ב-Java. לדוגמה:
db1..*תואם לכל הטבלאות ב-db1.-
db1.table1;db2.table2תואם ל-table1 ב-db1 ול-table2 ב-db2.
- בשדה BQMS discovery dump gcs path, מזינים את הנתיב לקובץ
hive-dumper-output.zipשיצרתם כשיצרתם קובץ מטא-נתונים ל-Apache Hive. אם אתם משתמשים באוטומציה של פלט dumper עםcron, ציינו את נתיב התיקייה ב-Cloud Storage שהוגדר ב---gcs-base-path, שמכיל קובצי ZIP של פלט dumper.- בקטע Storage type, בוחרים אחת מהאפשרויות הבאות: השדה הזה זמין רק אם Transfer strategy מוגדר לערך
FULL_TRANSFER: -
HDFS: בוחרים באפשרות הזו אם מאחסנים את הקבצים ב-HDFS. בשדה STS agent pool name, צריך לציין את השם של מאגר הסוכנים שיצרתם כשהגדרתם את Storage Transfer Agent. -
S3: בוחרים באפשרות הזו אם אחסון הקבצים הואAmazon S3. בשדות Access key ID ו-Secret access key, צריך לספק את המזהה של מפתח הגישה ואת מפתח הגישה הסודי שיצרתם כשהגדרתם את פרטי הכניסה. -
AZURE: בוחרים באפשרות הזו אם אחסון הקבצים הואAzure Blob Storage. בשדה SAS token, צריך לציין את טוקן ה-SAS שיצרתם כשהגדרתם את פרטי הכניסה.
- בקטע Storage type, בוחרים אחת מהאפשרויות הבאות: השדה הזה זמין רק אם Transfer strategy מוגדר לערך
- אופציונלי: בשדה Partition Filter gcs path, מזינים נתיב מלא ב-Cloud Storage לקובץ JSON של מסנן בהתאמה אישית כדי לסנן מחיצות מטבלאות המקור.
- בשדה Destination gcs path, מזינים נתיב לקטגוריה של Cloud Storage שבה רוצים לאחסן את הנתונים שהועברו.
- בוחרים את סוג המטא-נתונים של היעד מהרשימה הנפתחת:
-
BIGLAKE_REST_CATALOG: בוחרים באפשרות הזו כדי לאחסן את המטא-נתונים בקטלוג REST של Iceberg בקטלוג הייעודי לזמן ריצה של Lakehouse. הקטלוג נוצר על סמך קטגוריה של Cloud Storage. - <!-- (Preview): Select this option to store your metadata in the Lakehouse runtime catalog Hive Catalog. -->
BIGLAKE_HIVE_CATALOG(גרסת טרום-השקה (Preview)): בוחרים באפשרות הזו כדי לאחסן את המטא-נתונים בקטלוג Hive של הקטלוג הייעודי לזמן ריצה של Lakehouse. צריך לציין שם קטלוג ב-BigLake Metastore Hive Catalog ID. אם הקטלוג לא קיים, הוא ייווצר באופן אוטומטי.
-
- אופציונלי: בשדה Service account, מזינים את חשבון השירות שבו רוצים להשתמש בהעברת הנתונים הזו. חשבון השירות צריך להיות שייך לאותו פרויקט ב-Google Cloud שבו נוצרו הגדרות ההעברה ומערך הנתונים של היעד.
- בקטע Transfer strategy, בוחרים אחת מהאפשרויות הבאות:
BQ
כדי לתזמן העברה של Hive Metastore, מזינים את הפקודה bq mk ומציינים את הדגל ליצירת העברה --transfer_config:
  bq mk --transfer_config
  --data_source=hadoop display_name='TRANSFER_NAME'
  --service_account_name='SERVICE_ACCOUNT'
  --project_id='PROJECT_ID' location='REGION'
  --params='{
    "transfer_strategy":"TRANSFER_STRATEGY",
    "table_name_patterns":"LIST_OF_TABLES",
    "table_metadata_path":"gs://DUMPER_BUCKET/hive-dumper-output.zip",
    "target_gcs_file_path":"gs://MIGRATION_BUCKET",
    "metastore":"METASTORE",
    "destination_bigquery_dataset":"BIGLAKE_METASTORE_DATASET",
    "blms_hive_catalog_id":"HIVE_CATALOG_ID",
    "translation_output_gcs_path":"gs://TRANSLATION_OUTPUT_BUCKET/metadata/config/default_database/",
    "storage_type":"STORAGE_TYPE",
    "agent_pool_name":"AGENT_POOL_NAME",
    "aws_access_key_id":"AWS_ACCESS_KEY_ID",
    "aws_secret_access_key":"AWS_SECRET_ACCESS_KEY",
    "azure_sas_token":"AZURE_SAS_TOKEN",
    "partition_filter_gcs_path":"FILTER_GCS_PATH"
    }'
מחליפים את מה שכתוב בשדות הבאים:
-
TRANSFER_NAME: השם המוצג של הגדרות ההעברה. שם ההעברה יכול להיות כל ערך שמאפשר לכם לזהות את ההעברה אם תצטרכו לשנות אותה מאוחר יותר. -
SERVICE_ACCOUNT: השם של חשבון השירות שמשמש ליצירת ההעברה.חשבון השירות צריך להיות שייך לאותו פרויקט ב-Google Cloud שבו נוצרו הגדרות ההעברה ומערך הנתונים של היעד. -
PROJECT_ID: מזהה הפרויקט ב- Google Cloud . אם לא מציינים פרויקט מסוים באמצעות--project_id, המערכת משתמשת בפרויקט שמוגדר כברירת מחדל. REGION: המיקום של הגדרות ההעברה האלה.TRANSFER_STRATEGY: (אופציונלי) מציינים אחד מהערכים הבאים:-
FULL_TRANSFER: העברת כל הנתונים ורישום המטא-נתונים במטא-נתונים של היעד. זה ערך ברירת המחדל. -
METADATA_ONLY: רישום מטא-נתונים בלבד. הנתונים כבר צריכים להיות במיקום הנכון ב-Cloud Storage, שאליו מפנים המטא-נתונים.
-
-
LIST_OF_TABLES: רשימת הישויות שיועברו. משתמשים במפרט שמות היררכי –database.table. בשדה הזה אפשר להשתמש בביטוי רגולרי מסוג RE2 כדי לציין טבלאות. לדוגמה:-
db1..*: מציין את כל הטבלאות במסד הנתונים -
db1.table1;db2.table2: רשימה של טבלאות
-
-
DUMPER_BUCKET: הקטגוריה ב-Cloud Storage שמכילה את הקובץhive-dumper-output.zip. אם אתם משתמשים באוטומציה של פלט dumper עםcron, צריך לשנות אתtable_metadata_pathלנתיב התיקייה ב-Cloud Storage שהוגדר עם--gcs-base-pathבהגדרת cron, לדוגמה:"table_metadata_path":"<var>GCS_PATH_TO_UPLOAD_DUMPER_OUTPUT</var>". -
MIGRATION_BUCKET: הנתיב של יעד ה-GCS שאליו ייטענו כל הקבצים הבסיסיים. זמינה רק אם הערך שלtransfer_strategyהואFULL_TRANSFER. -
METASTORE: סוג המטא-נתונים שאליו רוצים להעביר. צריך להגדיר את אחד מהערכים הבאים:-
BIGLAKE_REST_CATALOG: כדי להעביר מטא-נתונים לקטלוג ייעודי לזמן ריצה של Lakehouse, קטלוג REST של Iceberg (מומלץ לטבלאות Iceberg). -
BIGLAKE_HIVE_CATALOG: כדי להעביר מטא-נתונים לקטלוג ייעודי לזמן ריצה של Lakehouse, קטלוג Hive (מומלץ לטבלאות Apache Hive) (גרסת טרום-השקה (Preview)).
-
-
HIVE_CATALOG_ID: המזהה של קטלוג Hive בקטלוג הייעודי לזמן ריצה של Lakehouse. חובה אם הערך שלmetastoreהואBIGLAKE_HIVE_CATALOG. אם הקטלוג לא קיים, הוא ייווצר באופן אוטומטי. -
STORAGE_TYPE: ציון אחסון הקבצים הבסיסי של הטבלאות. הסוגים הנתמכים הםHDFS,S3ו-AZURE. חובה אם הערך שלtransfer_strategyהואFULL_TRANSFER. -
AGENT_POOL_NAME: שם מאגר הסוכנים שמשמש ליצירת סוכנים. חובה אם הערך שלstorage_typeהואHDFS. -
AWS_ACCESS_KEY_ID: מזהה מפתח הגישה מפרטי הכניסה. חובה אם הערך שלstorage_typeהואS3. -
AWS_SECRET_ACCESS_KEY: מפתח הגישה הסודי מפרטי הכניסה. חובה אם הערך שלstorage_typeהואS3. -
AZURE_SAS_TOKEN: טוקן ה-SAS מפרטי הכניסה. חובה אם הערך שלstorage_typeהואAZURE. -
FILTER_GCS_PATH: (אופציונלי) נתיב מלא ב-Cloud Storage לקובץ JSON של מסנן בהתאמה אישית, כדי לסנן מחיצות.
מריצים את הפקודה הזו כדי ליצור את הגדרת ההעברה ולהתחיל את ההעברה של הטבלאות המנוהלות ב-Hive. כברירת מחדל, ההעברות מתוזמנות לפעול כל 24 שעות, אבל אפשר להגדיר אותן באמצעות אפשרויות תזמון ההעברות.
בסיום ההעברה, הטבלאות באשכול Hadoop יועברו אל MIGRATION_BUCKET.
אוטומציה של הפעלת כלי ה-dumper באמצעות משימת cron
כדי להפוך את ההעברות המצטברות לאוטומטיות, אפשר להשתמש במשימת cron כדי להריץ את הכלי dwh-migration-dumper. אוטומציה של חילוץ המטא-נתונים כדי לוודא שעותק עדכני ממקור הנתונים זמין להפעלות הבאות של ההעברה המצטברת.
לפני שמתחילים
לפני שמשתמשים בסקריפט האוטומציה הזה, צריך:
משלימים את כל הדרישות המוקדמות לכלי ה-dumper.
מתקינים את Google Cloud CLI. הסקריפט משתמש בכלי שורת הפקודה
gsutilכדי להעלות את הפלט של dumper ל-Cloud Storage.כדי לבצע אימות באמצעות Google Cloud ולאפשר ל-
gsutilלהעלות קבצים ל-Cloud Storage, מריצים את הפקודה הבאה:gcloud auth application-default login
תזמון הפעולה האוטומטית
שומרים את הסקריפט הבא בקובץ מקומי. הסקריפט הזה מיועד להגדרה ולהפעלה על ידי דימון (daemon) של
cronכדי להפוך את תהליך החילוץ וההעלאה של פלט ה-dumper לאוטומטי.#!/bin/bash # Exit immediately if a command exits with a non-zero status. set -e # Treat unset variables as an error when substituting. set -u # Pipelines return the exit status of the last command to exit with a non-zero status. set -o pipefail # These values are used if not overridden by command-line options. DUMPER_EXECUTABLE="DUMPER_PATH/dwh-migration-dumper" GCS_BASE_PATH="gs://PATH_TO_DUMPER_OUTPUT" LOCAL_BASE_DIR="LOCAL_BASE_DIRECTORY_PATH" # Optional arguments for cloud environments DUMPER_HOST="" DUMPER_PORT="" HIVE_KERBEROS_URL="" HIVEQL_RPC_PROTECTION="" KERBEROS_AUTHENTICATION="false" # Function to display usage information usage() { echo "Usage: $0 [options]" echo "" echo "Runs the dwh-migration-dumper tool and uploads its output to provided Cloud Storage path." echo "" echo "Required Options:" echo " --dumper-executable
The full path to the dumper executable." echo " --gcs-base-pathThe base Cloud Storage folder to upload dumper output files to. The script generates timestamped ZIP files in this folder." echo " --local-base-dirThe local base directory for logs and temp files." echo "" echo "Optional Hive connection options:" echo " --hostThe hostname for the dumper connection." echo " --portThe port number for the dumper connection." echo "" echo "To use Kerberos authentication, include the following options." echo "If --kerberos-authentication is specified, then --host, --port," echo "--hive-kerberos-url and --hiveql-rpc-protection are all required:" echo "" echo " --kerberos-authentication Enable Kerberos authentication." echo " --hive-kerberos-urlThe Hive Kerberos URL." echo " --hiveql-rpc-protection" echo " The hiveql-rpc-protection level, equal to the value of" echo " 'hadoop.rpc.protection' in '/etc/hadoop/conf/core-site.xml'," echo " with one of the following values:" echo " - authentication" echo " - integrity" echo " - privacy" echo "" echo "Other Options:" echo " -h, --help Display this help message and exit." exit 1 } # This loop processes command-line options and overrides the default configuration. while [[ "$#" -gt 0 ]]; do case $1 in --dumper-executable) DUMPER_EXECUTABLE="$2" shift # past argument shift # past value ;; --gcs-base-path) GCS_BASE_PATH="$2" shift shift ;; --local-base-dir) LOCAL_BASE_DIR="$2" shift shift ;; --host) DUMPER_HOST="$2" shift shift ;; --port) DUMPER_PORT="$2" shift shift ;; --hive-kerberos-url) HIVE_KERBEROS_URL="$2" shift shift ;; --hiveql-rpc-protection) HIVEQL_RPC_PROTECTION="$2" shift shift ;; --kerberos-authentication) KERBEROS_AUTHENTICATION="true" shift ;; -h|--help) usage ;; *) echo "Unknown option: $1" usage ;; esac done # This runs AFTER parsing arguments to ensure no placeholder values are left. if [[ "$DUMPER_EXECUTABLE" == "DUMPER_PATH"* || "$GCS_BASE_PATH" == "gs://PATH_TO_DUMPER_OUTPUT" || "$LOCAL_BASE_DIR" == "LOCAL_BASE_DIRECTORY_PATH" ]]; then echo "ERROR: One or more configuration variables have not been set. Please provide them as command-line arguments or edit the script." >&2 echo "Run with --help for more information." >&2 exit 1 fi # If Kerberos authentication is enabled, check for required fields. if [[ "$KERBEROS_AUTHENTICATION" == "true" ]]; then if [[ -z "$DUMPER_HOST" || -z "$DUMPER_PORT" || -z "$HIVE_KERBEROS_URL" || -z "$HIVEQL_RPC_PROTECTION" ]]; then echo "ERROR: If --kerberos-authentication is enabled, --host, --port, --hive-kerberos-url and --hiveql-rpc-protection must be provided." >&2 echo "Run with --help for more information." >&2 exit 1 fi fi # Remove trailing slashes from GCS_BASE_PATH, if any. GCS_BASE_PATH=$(echo "${GCS_BASE_PATH}" | sed 's:/*$::') # Create unique timestamp and directories for this run EPOCH=$(date +%s) LOCAL_LOG_DIR="${LOCAL_BASE_DIR}/logs" mkdir -p "${LOCAL_LOG_DIR}" # Ensures the base and logs directories exist # Define the unique log and zip file path for this run LOG_FILE="${LOCAL_LOG_DIR}/dumper_execution_${EPOCH}.log" ZIP_FILE_NAME="dts-cron-dumper-output_${EPOCH}.zip" LOCAL_ZIP_PATH="${LOCAL_BASE_DIR}/${ZIP_FILE_NAME}" echo "Script execution started. All subsequent output will be logged to: ${LOG_FILE}" # --- Helper Functions --- log() { echo "$(date '+%Y-%m-%d %H:%M:%S') - $@" >> "${LOG_FILE}"; } cleanup() { local path_to_remove="$1" log "Cleaning up local file/directory: ${path_to_remove}..." rm -rf "${path_to_remove}" } # This function is called when the script exits to ensure cleanup and logging happen reliably. handle_exit() { local exit_code=$? # Only run the failure logic if the script is exiting with an error if [[ ${exit_code} -ne 0 ]]; then log "ERROR: Script is exiting with a failure code (${exit_code})." local gcs_log_path_on_failure="${GCS_BASE_PATH}/logs/$(basename "${LOG_FILE}")" log "Uploading log file to ${gcs_log_path_on_failure} for debugging..." # Attempt to upload the log file on failure, but don't let this command cause the script to exit. gsutil cp "${LOG_FILE}" "${gcs_log_path_on_failure}" > /dev/null 2>&1 || log "WARNING: Failed to upload log file to Cloud Storage." else # SUCCESS PATH log "Script finished successfully. Now cleaning up local zip file...." # Clean up the local zip file ONLY on success cleanup "${LOCAL_ZIP_PATH}" fi log "*****Script End*****" exit ${exit_code} } # Trap the EXIT signal to run the handle_exit function, ensuring cleanup always happens. trap handle_exit EXIT # Validates the dumper log file based on a strict set of rules. validate_dumper_output() { local log_file_to_check="$1" # Check for the specific success message from the dumper tool. if grep -q "Dumper execution: SUCCEEDED" "${log_file_to_check}"; then log "Validation Successful: Found 'Dumper execution: SUCCEEDED' message." return 0 # Success else log "ERROR: Validation failed. The 'Dumper execution: SUCCEEDED' message was not found." return 1 # Failure fi } # --- Main Script Logic --- log "*****Script Start*****" log "Dumper Executable: ${DUMPER_EXECUTABLE}" log "Cloud Storage Base Path: ${GCS_BASE_PATH}" log "Local Base Directory: ${LOCAL_BASE_DIR}" # Use an array to build the command safely dumper_command_args=( "--connector" "hiveql" "--output" "${LOCAL_ZIP_PATH}" ) # Add optional arguments if they are provided if [[ -n "${DUMPER_HOST}" ]]; then dumper_command_args+=("--host" "${DUMPER_HOST}") log "Using Host: ${DUMPER_HOST}" fi if [[ -n "${DUMPER_PORT}" ]]; then dumper_command_args+=("--port" "${DUMPER_PORT}") log "Using Port: ${DUMPER_PORT}" fi if [[ -n "${HIVE_KERBEROS_URL}" ]]; then dumper_command_args+=("--hive-kerberos-url" "${HIVE_KERBEROS_URL}") log "Using Hive Kerberos URL: ${HIVE_KERBEROS_URL}" fi if [[ -n "${HIVEQL_RPC_PROTECTION}" ]]; then dumper_command_args+=("-Dhiveql.rpc.protection=${HIVEQL_RPC_PROTECTION}") log "Using HiveQL RPC Protection: ${HIVEQL_RPC_PROTECTION}" fi log "Starting dumper tool execution..." log "COMMAND: JAVA_OPTS=\"-Djavax.security.auth.useSubjectCredsOnly=false\" ${DUMPER_EXECUTABLE} ${dumper_command_args[*]}" JAVA_OPTS="-Djavax.security.auth.useSubjectCredsOnly=false" "${DUMPER_EXECUTABLE}" "${dumper_command_args[@]}" >> "${LOG_FILE}" 2>&1 log "Dumper process finished." # Validate the output from the dumper execution for success or failure. validate_dumper_output "${LOG_FILE}" # Upload the ZIP file to Cloud Storage gcs_zip_path="${GCS_BASE_PATH}/${ZIP_FILE_NAME}" log "Uploading ${LOCAL_ZIP_PATH} to ${gcs_zip_path}..." if [ ! -f "${LOCAL_ZIP_PATH}" ]; then log "ERROR: Expected ZIP file ${LOCAL_ZIP_PATH} not found after dumper execution." # The script will exit here with an error code, and the trap will run. exit 1 fi gsutil cp "${LOCAL_ZIP_PATH}" "${gcs_zip_path}" >> "${LOG_FILE}" 2>&1 log "Upload to Cloud Storage successful." # The script will now exit with code 0. The trap will call cleanup and log the script end.כדי להפוך את הסקריפט לניתן להפעלה, מריצים את הפקודה הבאה:
chmod +x PATH_TO_SCRIPT
מתזמנים את הסקריפט באמצעות
crontab, ומחליפים את המשתנים בערכים שמתאימים למשימה. מוסיפים רשומה כדי לתזמן את המשימה. בדוגמאות הבאות הסקריפט מופעל כל יום בשעה 2:30:אם אתם מריצים במארח שיש לו גישה ישירה ל-Hive Metastore ולא נדרש אימות Kerberos, הריצו את הפקודה הבאה:
# Run the Hive dumper daily at 2:30 AM for incremental BigQuery transfer.
30 2 * * * PATH_TO_SCRIPT \
  --dumper-executable PATH_TO_DUMPER_EXECUTABLE \
  --gcs-base-path GCS_PATH_TO_UPLOAD_DUMPER_OUTPUT \
  --local-base-dir LOCAL_PATH_TO_SAVE_INTERMEDIARY_FILES
אם המכונה של Hive Metastore דורשת אימות Kerberos, מריצים את הפקודה הבאה:
# Run the Hive dumper daily at 2:30 AM for incremental BigQuery transfer with Kerberos authentication.
30 2 * * * PATH_TO_SCRIPT \
  --dumper-executable PATH_TO_DUMPER_EXECUTABLE \
  --gcs-base-path GCS_PATH_TO_UPLOAD_DUMPER_OUTPUT \
  --local-base-dir LOCAL_PATH_TO_SAVE_INTERMEDIARY_FILES \
  --kerberos-authentication \
  --host HIVE_HOST \
  --port HIVE_PORT \
  --hive-kerberos-url HIVE_KERBEROS_URL \
  --hiveql-rpc-protection HIVEQL_RPC_PROTECTION
שיקולים בתזמון
כדי למנוע מצב שבו הנתונים לא מעודכנים, צריך להפעיל את כלי ה-dumper לפני העברת הנתונים המתוזמנת.
מומלץ להריץ את הסקריפט באופן ידני כמה פעמים כדי לקבוע את משך הזמן הממוצע שנדרש לכלי ה-dumper ליצור את הפלט שלו. כדי לוודא עדכניות הנתונים, כדאי להשתמש בתזמון הזה כדי להגדיר לוח זמנים למשימות ב-cron לפני הרצת ההעברה.
מעקב אחרי סטטוס ההעברה וצפייה בו
אתם יכולים לעקוב אחרי העברות ברמת המשאב של טבלאות ספציפיות כדי לבדוק את ההתקדמות, לראות פרטים מדויקים של שגיאות ולשאול על המצב של משאבים ספציפיים שמועברים.
כדי לראות את ההתקדמות והסטטוס של המשאבים, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף Data transfers במסוף Google Cloud .
לוחצים על הגדרת ההעברה מהרשימה.
בדף Transfer details, לוחצים על הכרטיסייה Tables transferred.
צפייה ברשימת המשאבים שמועברים. אפשר לראות פרטים כמו:
- סטטוס ההעברה האחרונה: המצב הנוכחי של המשאב על סמך העברת המשאב האחרונה, כולל התקדמות ההשלמה.
- שם הטבלה: שם המשאב שמועבר. לוחצים על שם המשאב כדי לראות תצוגה מפורטת שלו.
- ההרצה האחרונה: הרצת ההעברה האחרונה שעדכנה את המשאב.
- סיכום סטטוס: מדדי התקדמות מפורטים או הודעות שגיאה אם ההעברה נכשלה.
- Last successful run: ההרצה האחרונה שבה המשאב הועבר בהצלחה.
אפשר להשתמש בסרגל הסינון כדי לחפש משאבים ספציפיים לפי שם, או לסנן לפי הסטטוס הנוכחי שלהם, למשל Failed transfers. המסנן Table name תומך בהתאמה של תווים כלליים לחיפוש, למשל באמצעות *, אבל אין תמיכה בהתאמה של תווים כלליים לחיפוש בשדות אחרים של מסננים.
API
אתם יכולים לשלוח שאילתה לגבי הסטטוס של משאבי ההעברה באמצעות BigQuery Data Transfer Service API.
רשימה של כל המשאבים והסטטוסים שלהם
כדי להציג את כל המשאבים והסטטוסים שלהם, משתמשים ב-method projects.locations.transferConfigs.transferResources.list.
מריצים את בקשת ה-API עם הפרטים הבאים:
  GET https://bigquerydatatransfer.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/transferConfigs/CONFIG_ID/transferResources
  Example Response (abridged) (JSON):
  {
    "transferResources": [
      {
        "name": "projects/.../transferResources/table1",
        "latestStatusDetail": {
          "state": "RESOURCE_TRANSFER_SUCCEEDED",
          "completedPercentage": 100.0
        },
        "updateTime": "2026-02-03T22:42:06Z"
      }
    ]
  }
הפקודה curl:
  curl -X GET

  "https://bigquerydatatransfer.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/transferConfigs/CONFIG_ID/transferResources"

  -H "Authorization: Bearer $(gcloud auth print-access-token)"

  -H "Accept: application/json"
אפשר לסנן את התוצאות לפי שם המשאב או המצב. לדוגמה, כדי למצוא את כל ההעברות שנכשלו, מוסיפים את ?filter=latest_status_detail.state="RESOURCE_TRANSFER_FAILED" לכתובת ה-URL של הבקשה.
מחליפים את מה שכתוב בשדות הבאים:
-
CONFIG_ID: המזהה של הגדרת ההעברה. -
LOCATION: המיקום שבו נוצרו הגדרות ההעברה. -
PROJECT_ID: מזהה הפרויקט ב- Google Cloud שבו מופעלות ההעברות.
קבלת משאב ספציפי
כדי לקבל את הסטטוס של טבלה או מחיצה ספציפית, משתמשים בשיטה projects.locations.transferConfigs.transferResources.get.
מריצים את בקשת ה-API עם הפרטים הבאים:
GET https://bigquerydatatransfer.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/transferConfigs/CONFIG_ID/transferResources/RESOURCE_ID
הפקודה curl:
  curl -X GET

  "https://bigquerydatatransfer.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/transferConfigs/CONFIG_ID/transferResources/RESOURCE_ID"

  -H "Authorization: Bearer $(gcloud auth print-access-token)"

  -H "Accept: application/json"
מחליפים את מה שכתוב בשדות הבאים:
-
CONFIG_ID: המזהה של הגדרות ההעברה. -
LOCATION: המיקום שבו נוצרו הגדרות ההעברה. -
PROJECT_ID: מזהה הפרויקט ב- Google Cloud שבו מופעלות ההעברות. -
RESOURCE_ID: המזהה של המשאב, למשל שם הטבלה.
מכסות ומגבלות על מספר המשימות שאפשר להריץ בו-זמנית
בכל הפעלה של שירות העברת הנתונים ל-BigQuery, המחבר של Hive Metastore מפעיל משימה אחת של Storage Transfer Service לכל טבלה.
כשהמכסה מתמלאת, ההעברה ממתינה עד שמתפנה מקום במכסה. משימות של Storage Transfer Service נוצרות בפרויקט של הלקוח, והן כפופות למכסות ולמגבלות של Storage Transfer Service.
תמחור
השימוש במחבר של Apache Hive Metastore להעברת נתונים לא כרוך בתשלום. אחרי שהנתונים מועברים, אתם מחויבים על אחסון הנתונים ביעד. למידע נוסף, קראו את המאמרים הבאים: