


您可以在 BigQuery 中使用差異化隱私,在執行運算和取得洞察資訊的同時,保護資料中的個人資訊。這項隱私權標準會限制資料輸出內容揭露的個人資訊,協助您分享資料及推論群組資訊,同時保護個人隱私。當有重新識別的風險,或需要量化隱私風險與分析效用之間的取捨時,差異化隱私特別實用。
如要瞭解語法詳情,請參閱差異化隱私條款。如需可搭配這項語法使用的函式清單,請參閱「差異隱私匯總函式」。
差異化隱私的用途範例
為了進一步瞭解差異化隱私,我們來看一個簡單的例子。
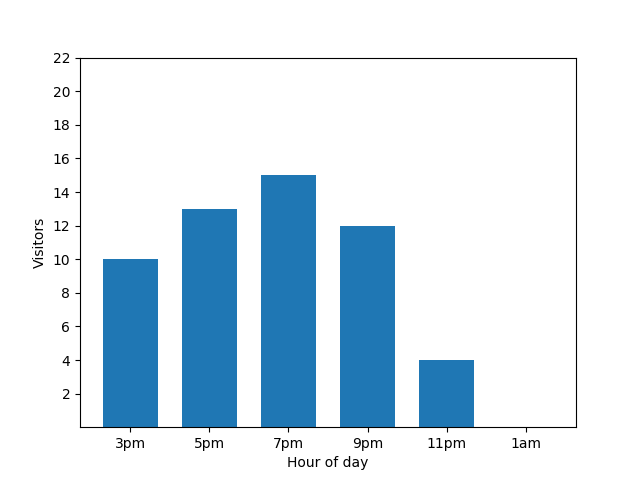
這張長條圖顯示某間小型餐廳在特定晚上的忙碌程度。許多顧客會在晚上 7 點光臨,而餐廳在凌晨 1 點完全沒有顧客:
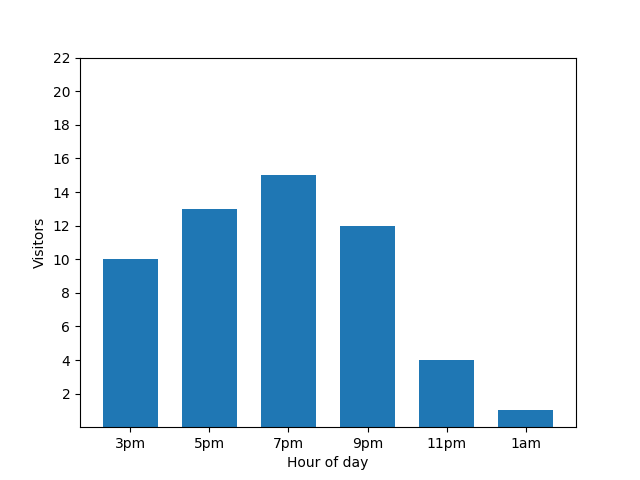
這張圖表看起來很有用,但有個小問題。有新訪客抵達時,長條圖會立即顯示這項事實。下圖清楚顯示有新訪客,且該訪客大約在凌晨 1 點抵達:
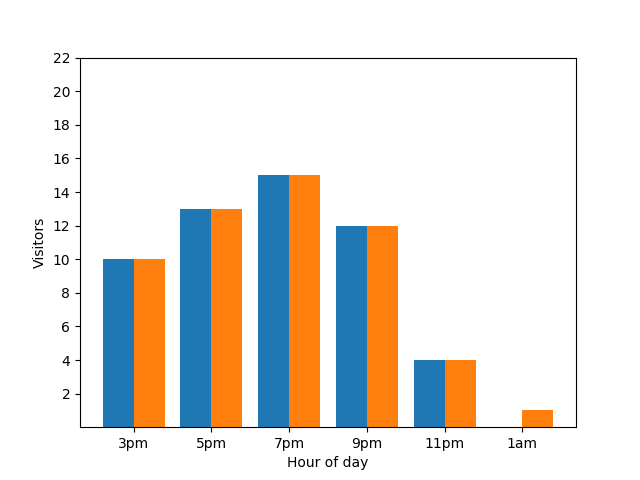
從隱私權角度來看,顯示這項詳細資料並不理想,因為匿名統計資料不應揭露個人貢獻。將這兩個圖表並列顯示,會更加明顯:橘色長條圖多了一位在凌晨 1 點左右抵達的房客:
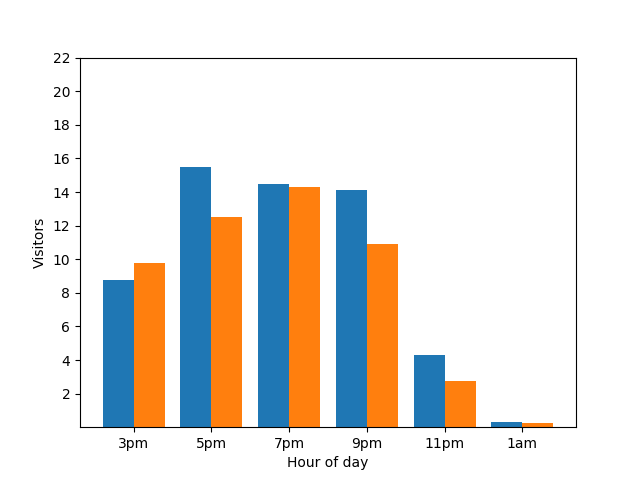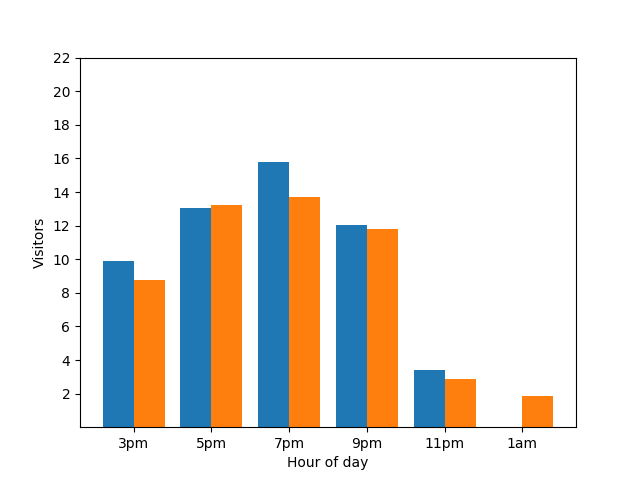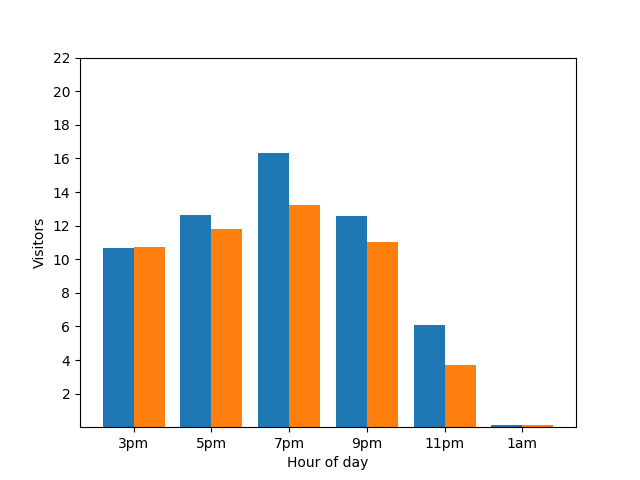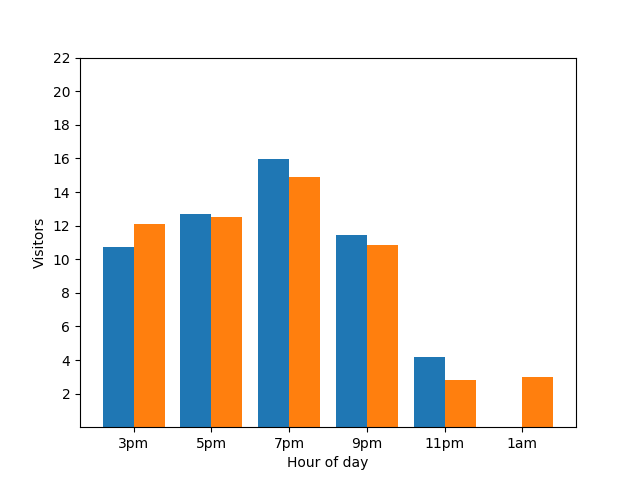
這同樣不理想。為避免這類隱私權問題,您可以使用差異化隱私技術,在長條圖中加入隨機雜訊。在下方的比較圖表中,結果會匿名處理,不再顯示個別貢獻。
查詢的差異化隱私權運作方式
差異化隱私的目標是降低資料外洩風險,防止他人取得資料集中實體的相關資訊。差異化隱私權可平衡保護隱私權的需求,以及統計分析效用的需求。隱私權越高,統計分析效用就越低,反之亦然。
您可以使用 BigQuery 的 GoogleSQL,透過差異隱私權匯總轉換查詢結果。執行查詢時,系統會執行下列操作:
- 如果使用
GROUP BY子句指定群組,則會計算每個群組的各實體匯總。根據max_groups_contributed差異化隱私權參數,限制每個實體可貢獻的群組數量。 - 限制每個實體的匯總貢獻,使其落在取值範圍內。如果未指定箝位界限,系統會以差異化隱私方式隱含計算。
- 匯總每個群組中,已限制取值範圍的每實體匯總貢獻。
- 為每個群組的最終匯總值加入雜訊。隨機雜訊的規模是所有限制取值範圍和隱私權參數的函式。
- 計算每個群組套用雜訊的實體數量,刪除實體數量過少的群組。雜訊實體計數有助於消除非確定性群組。
最終結果是一個資料集,其中每個群組的匯總結果都套用雜訊,且刪除人數較少的群體。
如要進一步瞭解差異化隱私及其用途,請參閱下列文章:
產生有效的差異化隱私查詢
差異隱私權查詢必須符合下列規則,才算有效:
定義隱私權單位欄
隱私權單位是指資料集中受差異化隱私保護的實體。實體可以是個人、公司、地點或您選擇的任何資料欄。
差異化隱私查詢必須包含一個隱私權單位資料欄,且只能有一個。隱私權單位欄是隱私權單位的專屬 ID,可存在於多個群組中。由於系統支援多個群組,隱私權單位欄的資料類型必須為「可分組」。
您可以在差異化隱私子句的 OPTIONS 子句中,使用專屬 ID privacy_unit_column 定義隱私單位欄。
在下列範例中,隱私權單位欄會新增至差異化隱私子句。id 代表來自 students 資料表的資料欄。
SELECT WITH DIFFERENTIAL_PRIVACY
  OPTIONS (epsilon=10, delta=.01, privacy_unit_column=id)
  item,
  COUNT(*, contribution_bounds_per_group=>(0, 100))
FROM students;
SELECT WITH DIFFERENTIAL_PRIVACY
  OPTIONS (epsilon=10, delta=.01, privacy_unit_column=members.id)
  item,
  COUNT(*, contribution_bounds_per_group=>(0, 100))
FROM (SELECT * FROM students) AS members;
移除差異化私人查詢中的雜訊
請參閱「查詢語法」參考資料中的「移除雜訊」一節。
在差異化隱私查詢中加入雜訊
如需「查詢語法」參考資料,請參閱新增雜訊。
限制隱私權單位 ID 可存在的群組
在「查詢語法」參考資料中,請參閱「限制隱私權單元 ID 可存在的群組」。
限制
本節說明差異化隱私的限制。
差異化隱私對成效的影響
差異隱私權查詢的執行速度比標準查詢慢,因為系統會執行實體層級的匯總作業,並套用 max_groups_contributed 限制。限制貢獻範圍有助於提升差異化私人查詢的效能。
下列查詢的效能設定檔並不相似:
SELECT
  WITH DIFFERENTIAL_PRIVACY OPTIONS(epsilon=1, delta=1e-10, privacy_unit_column=id)
  column_a, COUNT(column_b)
FROM table_a
GROUP BY column_a;
SELECT column_a, COUNT(column_b)
FROM table_a
GROUP BY column_a;
造成成效差異的原因是,差異化隱私查詢會執行額外的細微層級分組,因為也必須執行實體層級匯總。
下列查詢的效能設定檔應類似,但差異化隱私查詢的速度會稍慢:
SELECT
  WITH DIFFERENTIAL_PRIVACY OPTIONS(epsilon=1, delta=1e-10, privacy_unit_column=id)
  column_a, COUNT(column_b)
FROM table_a
GROUP BY column_a;
SELECT column_a, id, COUNT(column_b)
FROM table_a
GROUP BY column_a, id;
差異化隱私查詢的執行速度較慢,因為隱私權單位資料欄有大量不重複的值。
小型資料集的隱含邊界限制
使用大型資料集計算時,隱含邊界的效果最佳。如果資料集包含的隱私權單元數量偏低,隱含式界線可能會失敗,且不會傳回任何結果。此外,如果資料集隱私權單位數量偏低,隱含的界限可能會限制大部分非離群值,導致匯總資料低報,且結果受限縮影響的程度,會大於加入雜訊的影響。如果資料集隱私權單元數量偏低或分區稀疏,應使用明確而非隱含的鉗制。
隱私安全漏洞
任何差異化隱私演算法 (包括這個演算法) 都可能在分析師惡意操作時,面臨私密資料外洩的風險,尤其是在計算總和等基本統計資料時,因為算術限制而更容易發生。
隱私權保障的限制
雖然 BigQuery 差異化隱私會套用差異化隱私演算法,但無法保證結果資料集的隱私權屬性。
執行階段錯誤
如果分析師心懷不軌,且有能力編寫查詢或控制輸入資料,就可能對私人資料觸發執行階段錯誤。
浮點雜訊
使用差異化隱私前,應考量與捨入、重複捨入和重新排序攻擊相關的安全漏洞。如果攻擊者可以控制資料集的部分內容或資料集中的內容順序,這些安全漏洞就特別令人擔憂。
在浮點資料類型上加入差異化隱私雜訊時,可能會受到「Widespread Underestimation of Sensitivity in Differentially Private Libraries and How to Fix It」(差異化隱私程式庫中普遍低估敏感度的問題及修正方式) 中所述的漏洞影響。整數資料類型加入的雜訊不會受到論文所述安全漏洞的影響。
時序攻擊風險
惡意分析師可能會執行相當複雜的查詢,根據查詢執行時間推論輸入資料。
分類錯誤
建立差異化隱私查詢時,系統會假設您的資料採用已知且易於理解的結構。如果對錯誤的 ID (例如代表交易 ID 而非個人 ID) 套用差異化隱私,可能會洩漏機密資料。
如需協助解讀資料,建議使用下列服務和工具:
定價
使用差異化隱私功能不會產生額外費用,但分析時仍須支付標準 BigQuery 費用。