


您可以搭配使用差異化隱私和 BigQuery,在執行運算及取得洞察資訊時,保護資料中的個人資訊。這項隱私權標準會限制資料輸出內容中揭露的個人資訊,協助您共用資料及推論群組,而不會揭露個人資訊。當有重新識別的風險,或需要量化隱私風險與分析效用之間的權衡時,差異化隱私特別實用。
如需語法詳細資料,請參閱差異化隱私子句。如需可與此語法搭配使用的函式清單,請參閱「差異私密匯總函式」。
差異化隱私的用途範例
為了進一步瞭解差異化隱私,我們來看一個簡單的例子。
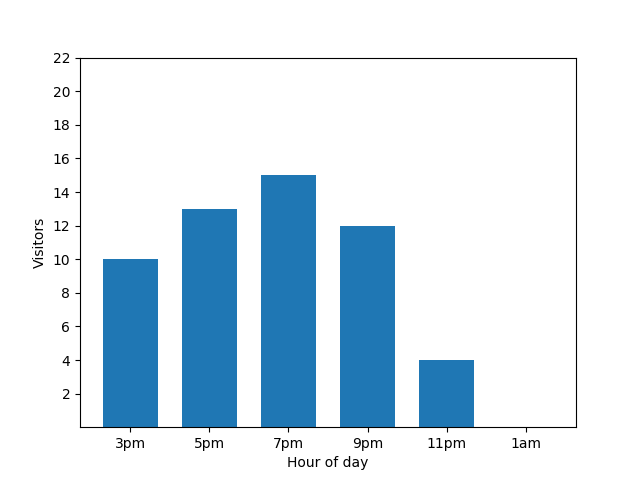
這張長條圖顯示某間小型餐廳在特定晚上的忙碌程度。晚上 7 點有許多顧客光顧,凌晨 1 點則完全沒有人:
這張圖表看起來很有用,但有個問題。當有新訪客抵達時,長條圖會立即反映這項事實。下圖清楚顯示有新訪客,且該訪客大約在凌晨 1 點抵達:
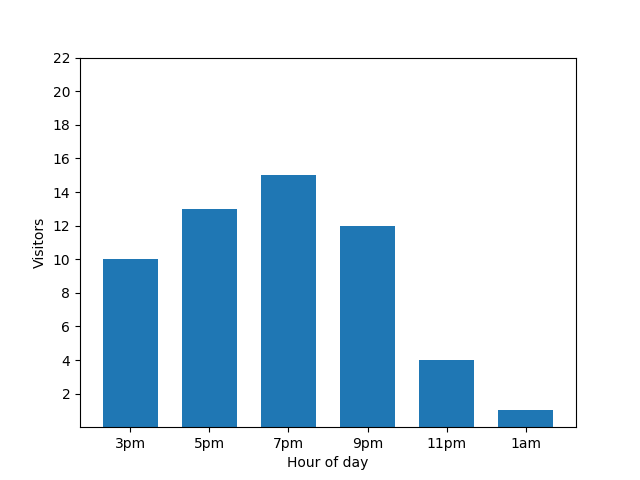
從隱私權的角度來看,顯示這項詳細資料並不理想,因為匿名統計資料不應透露個別貢獻。將這兩張圖表並排顯示,差異就更明顯了:橘色長條圖多了一位在凌晨 1 點左右抵達的賓客:
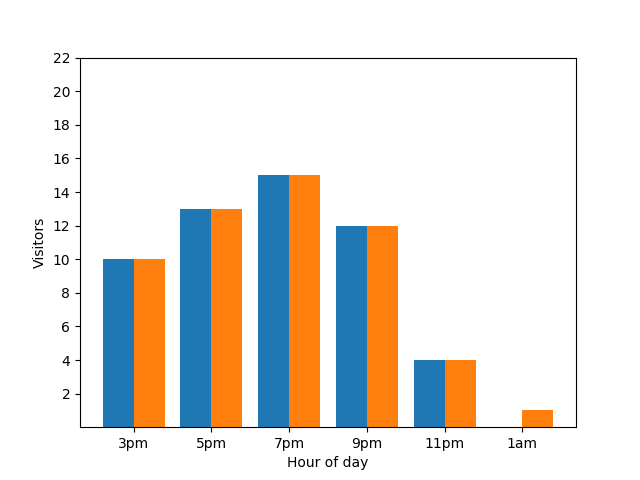
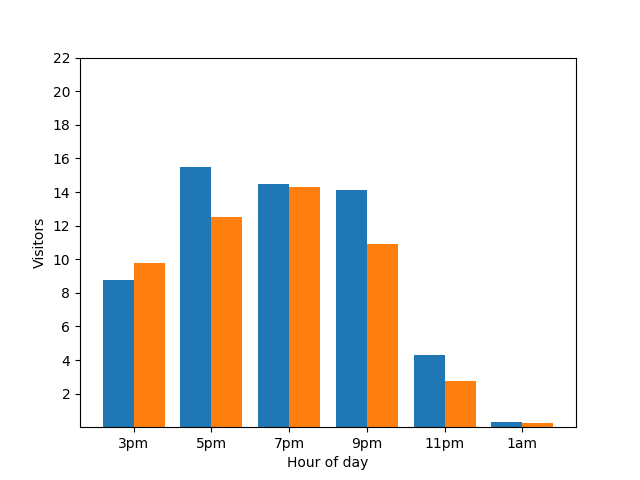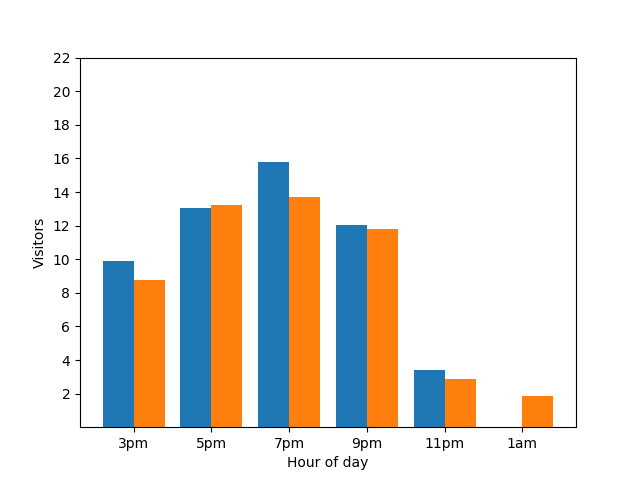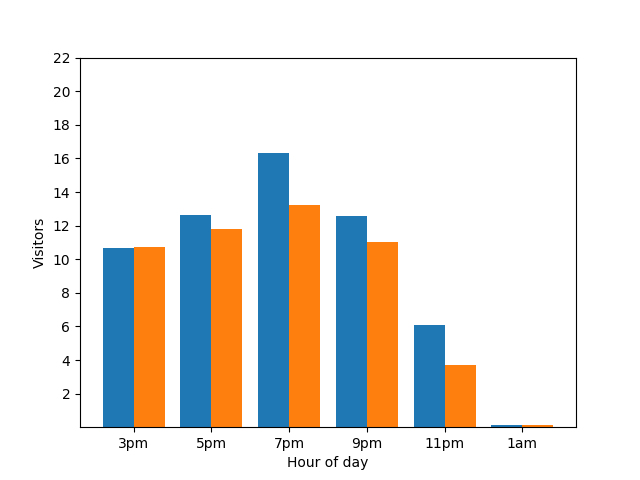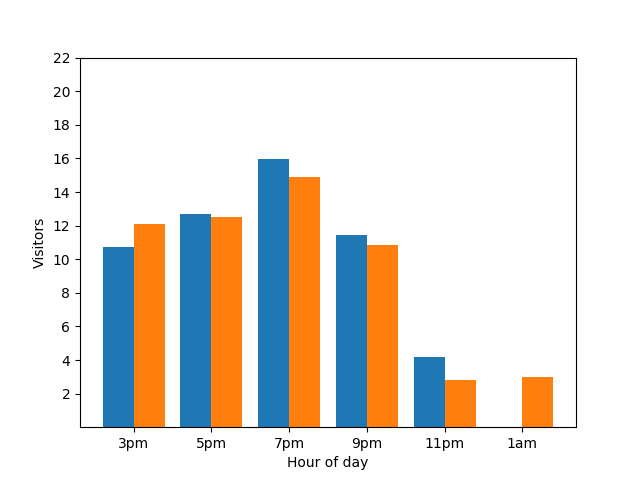
這同樣不理想。為避免這類隱私問題,您可以使用差異化隱私技術,在長條圖中加入隨機雜訊。在下方的比較圖表中,結果會匿名處理,不再顯示個別貢獻。
差異化隱私如何套用至查詢
差異化隱私的目標是降低揭露風險,也就是防止他人取得資料集中實體的相關資訊。差異化隱私權可平衡保護隱私權的需求,以及統計分析效用的需求。隱私權越高,統計分析效用越低,反之亦然。
您可以使用 BigQuery 適用的 GoogleSQL,透過差異化隱私匯總轉換查詢結果。執行查詢時,系統會執行下列操作:
- 如果使用
GROUP BY子句指定群組,則會計算每個群組的各實體匯總。根據max_groups_contributed差異化隱私參數,限制每個實體可貢獻的群組數量。 - 限制每個實體的匯總貢獻,使其落在取值範圍限制內。如果未指定箝位界限,系統會以差異化隱私方式隱含計算。
- 匯總每個群組中,已限制取值範圍的每實體匯總貢獻。
- 為每個群組的最終匯總值加入雜訊。隨機雜訊的規模,是所有限制取值範圍和隱私權參數的函式。
- 計算每個群組套用雜訊的實體數量,刪除實體數量過少的群組。雜訊實體計數有助於消除非確定性群組。
最終結果是一個資料集,其中每個群組的匯總結果都套用雜訊,且刪除人數較少的群體。
如要進一步瞭解差異化隱私及其用途,請參閱下列文章:
產生有效的差異化隱私查詢
差異化隱私查詢必須符合下列規則,才算有效:
定義隱私權單位欄
隱私權單位是資料集中受差異化隱私保護的實體。實體可以是個人、公司、位置或您選擇的任何資料欄。
差異化隱私查詢必須包含一個隱私權單位欄,且只能有一個。隱私權單位欄是隱私權單位的專屬 ID,可存在於多個群組中。由於支援多個群組,隱私權單位欄的資料類型必須可分組。
您可以在差異化隱私子句的 OPTIONS 子句中,使用專屬 ID privacy_unit_column 定義隱私權單位資料欄。
在以下範例中,隱私權單位欄會新增至差異化隱私子句。id 代表來自 students 資料表的資料欄。
SELECT WITH DIFFERENTIAL_PRIVACY
  OPTIONS (epsilon=10, delta=.01, privacy_unit_column=id)
  item,
  COUNT(*, contribution_bounds_per_group=>(0, 100))
FROM students;
SELECT WITH DIFFERENTIAL_PRIVACY
  OPTIONS (epsilon=10, delta=.01, privacy_unit_column=members.id)
  item,
  COUNT(*, contribution_bounds_per_group=>(0, 100))
FROM (SELECT * FROM students) AS members;
從差異化私人查詢中移除雜訊
請參閱「查詢語法」參考資料中的「移除雜訊」一節。
在差異化隱私查詢中加入雜訊
請參閱「查詢語法」參考資料中的「新增雜訊」一節。
限制隱私權單位 ID 可存在的群組
請參閱「查詢語法」參考資料中的「限制隱私權單位 ID 可存在的群組」一節。
限制
本節說明差異化隱私的限制。
差異化隱私對效能的影響
差異化隱私查詢的執行速度比標準查詢慢,因為系統會執行個別實體匯總,並套用 max_groups_contributed 限制。限制貢獻範圍有助於提升差異化私人查詢的效能。
下列查詢的效能剖析結果不相似:
SELECT
  WITH DIFFERENTIAL_PRIVACY OPTIONS(epsilon=1, delta=1e-10, privacy_unit_column=id)
  column_a, COUNT(column_b)
FROM table_a
GROUP BY column_a;
SELECT column_a, COUNT(column_b)
FROM table_a
GROUP BY column_a;
效能差異的原因在於,差異化隱私查詢會執行額外的更精細分組,因為也必須執行各實體匯總。
下列查詢的效能剖析應類似,但差異化隱私查詢的速度稍慢:
SELECT
  WITH DIFFERENTIAL_PRIVACY OPTIONS(epsilon=1, delta=1e-10, privacy_unit_column=id)
  column_a, COUNT(column_b)
FROM table_a
GROUP BY column_a;
SELECT column_a, id, COUNT(column_b)
FROM table_a
GROUP BY column_a, id;
差異化隱私查詢的執行速度較慢,因為隱私權單位資料欄有大量不重複的值。
小型資料集的隱含界限限制
使用大型資料集計算時,隱含邊界的效果最佳。如果資料集包含的隱私權單位數量偏低,隱含繫結可能會失敗,不會傳回任何結果。此外,如果資料集的隱私權單位數量較少,隱含限制可能會限制大部分的非離群值,導致匯總結果偏低,且結果受限制的影響大於雜訊。如果資料集的隱私權單位數量較少或分區較少,應使用明確限制,而非隱含限制。
隱私安全漏洞
任何差異化隱私演算法 (包括這個演算法) 都可能在分析師惡意操作時,面臨私密資料外洩的風險,尤其是在計算總和等基本統計資料時,因為算術限制。
隱私權保障限制
雖然 BigQuery 差異化隱私會套用差異化隱私演算法,但無法保證結果資料集的隱私權屬性。
執行階段錯誤
如果分析師有惡意,且能編寫查詢或控制輸入資料,就可能在私人資料上觸發執行階段錯誤。
浮點雜訊
使用差異化隱私前,應考量與捨入、重複捨入和重新排序攻擊相關的安全漏洞。如果攻擊者可以控制資料集的部分內容或資料集中的內容順序,這些安全漏洞就特別令人擔憂。
在浮點資料類型上新增差異化隱私雜訊,可能會受到「Widespread Underestimation of Sensitivity in Differentially Private Libraries and How to Fix It」中所述的漏洞影響。整數資料類型加入雜訊後,不會受到論文所述的安全漏洞影響。
時序攻擊風險
惡意分析師可能會執行相當複雜的查詢,根據查詢執行時間推論輸入資料。
分類錯誤
建立差異化隱私查詢時,系統會假設您的資料結構是已知且可理解的。如果對錯誤的 ID (例如代表交易 ID 而非個人 ID 的 ID) 套用差異化隱私,可能會導致機密資料外洩。
如需協助解讀資料,建議使用下列服務和工具:
定價
使用差異化隱私功能不需額外付費,但分析作業會產生標準 BigQuery 費用。