


データ エージェントを作成する
このドキュメントでは、BigQuery でデータ エージェントを作成、編集、管理、削除する方法について説明します。
BigQuery では、データ エージェントと会話し、自然言語で BigQuery データに関する質問をすることができます。データ エージェントには、テーブル メタデータとユースケース固有のクエリ処理の指示が含まれています。これらにより、選択した一連のナレッジソース(テーブル、ビュー、ユーザー定義関数(UDF)など)に関するユーザーからの質問に答える最適な方法を定義します。
始める前に
-
BigQuery、Gemini Data Analytics、Gemini for Google Cloud、Knowledge Catalog の各 API を有効にします(まだ有効になっていない場合)。
API を有効にするために必要なロール
API を有効にするには、
serviceusage.services.enable権限が必要です。プロジェクトを作成した場合は、オーナーロール(roles/owner)を介してこの権限がすでに付与されている可能性があります。それ以外の場合は、Service Usage 管理者ロール(roles/serviceusage.serviceUsageAdmin)を介してこの権限を取得できます。ロールを付与する方法を確認する。
必要なロール
データ エージェントを使用するには、ユースケースに一致する Identity and Access Management(IAM)権限が必要です。以降のセクションでは、エージェントの作成と公開、Gemini Enterprise でのエージェントのプロビジョニング、さまざまなサーフェスでのエージェントの検出と使用に基づいて、必要なロールを示します。詳細については、Conversational Analytics API の IAM ロールをご覧ください。
- エージェントの作成、編集、公開、共有、削除:
- プロジェクトにデータ エージェントを作成する: プロジェクトに対する Gemini データ分析データ エージェント作成者(
roles/geminidataanalytics.dataAgentCreator)。このロールにより、作成したデータ エージェントに対する Gemini データ分析データ エージェント オーナーのロールが自動的に付与されます。 - データ エージェントを編集、共有、削除する: エージェントまたはプロジェクトに対する Gemini データ分析 Data Agent Owner(
roles/geminidataanalytics.dataAgentOwner)。 - プロジェクト内のデータ エージェントを編集する: プロジェクトに対する Gemini データ分析データ エージェント編集者(
roles/geminidataanalytics.dataAgentEditor)。 - プロジェクト内のデータ エージェントを表示する: プロジェクトに対する Gemini データ分析データ エージェント閲覧者(
roles/geminidataanalytics.dataAgentViewer)。
- プロジェクトにデータ エージェントを作成する: プロジェクトに対する Gemini データ分析データ エージェント作成者(
- Gemini Enterprise でエージェントをプロビジョニングする:
- 公開されたエージェントを Gemini Enterprise のユーザーが利用できるようにするには、カスタム エージェントを登録して管理し、Gemini Enterprise 管理コンソールで Agent Gateway を構成する権限が必要です。
- エージェントを見つけて使用する:
- データ エージェントとチャットする: Gemini データ分析データ エージェント ユーザー(
roles/geminidataanalytics.dataAgentUser)。 - プロジェクト内のすべてのデータ エージェントを表示する: Gemini データ分析データ エージェント閲覧者(
roles/geminidataanalytics.dataAgentViewer)。 - データポータルで Gemini を活用したチャット インターフェースを操作するには、BigQuery Studio ユーザー(
roles/bigquery.studioUser)または Gemini for Google Cloud ユーザー(roles/cloudaicompanion.user)が必要です。それぞれにcloudaicompanion.topics.create権限が付与されます。これらのロールは、プロジェクト レベルで付与します。ユーザーには、データポータル アセット閲覧者(roles/datastudio.viewer)のロールも必要です。
- データ エージェントとチャットする: Gemini データ分析データ エージェント ユーザー(
- エージェントにナレッジソースを追加する:
- プロジェクトの Data Catalog 閲覧者(
roles/datacatalog.viewer)。
- プロジェクトの Data Catalog 閲覧者(
- 会話ログを構成して表示する:
- ログ データセットを作成し、エージェントのプロジェクトでアクセス権を付与するには:
bigquery.datasets.create、およびログ データセットに対する BigQuery データオーナー(roles/bigquery.dataOwner)または BigQuery 管理者(roles/bigquery.admin)。 - エージェントの会話ロギング設定を変更する:
geminidataanalytics.dataAgents.update(Gemini データ分析データ エージェント編集者(roles/geminidataanalytics.dataAgentEditor)に含まれています)。 - Conversational Analytics API サービス エージェント(
service-PROJECT_NUMBER@gcp-sa-geminidataanalytics.iam.gserviceaccount.com)がログテーブルを作成して行を書き込む場合: ログ データセットに対する BigQuery データ編集者(roles/bigquery.dataEditor)。ログ データセットで顧客管理の Cloud KMS 鍵(CMEK)を使用している場合は、BigQuery 暗号化サービス アカウント(bq-PROJECT_NUMBER@bigquery-encryption.iam.gserviceaccount.com)に Cloud KMS 鍵に対する Cloud KMS CryptoKey の暗号化 / 復号(roles/cloudkms.cryptoKeyEncrypterDecrypter)ロールを付与します。 - 会話ログをクエリするアナリストの場合: ログ データセットに対する BigQuery データ閲覧者(
roles/bigquery.dataViewer)と、クエリを実行するプロジェクトに対する BigQuery ジョブユーザー(roles/bigquery.jobUser)。
- ログ データセットを作成し、エージェントのプロジェクトでアクセス権を付与するには:
会話を行うには、会話に必要なロールをご覧ください。
エージェントはユーザーに代わって動作し、ユーザーの権限を使用します。エージェントは、アクセス権限を持つデータとリソースにのみアクセスできます。
ベスト プラクティス
会話分析は、ユーザーに代わってクエリを自動的に実行し、質問に回答します。クエリ費用が増加する可能性がある次の要因を考慮してください。
- テーブルサイズが大きい
- クエリでのデータ結合の使用
- クエリ内で AI 関数を頻繁に呼び出す
分析情報を生成する
必要に応じて、Knowledge Catalog でナレッジソースとして使用するテーブルのデータ分析情報を生成できます。
生成インサイトは、データ エージェントが質問に対する回答を生成するために利用できるテーブル メタデータを提供します。
分析情報を事前に生成していない場合は、データ エージェントの作成時にテーブルをナレッジソースとして選択したときに、システムによって分析情報が自動的に生成されます。
サンプル データ エージェントを操作する
会話分析用のエージェントの構成に慣れていない場合は、必要に応じて、Google Cloud プロジェクトごとに生成される事前定義済みのサンプル エージェントを表示できます。チャットしたり、パラメータを表示して作成方法を確認したりできますが、変更はできません。
サンプル エージェントを表示するには、次の操作を行います。
Google Cloud コンソールで、BigQuery の [エージェント] ページに移動します。
[エージェント カタログ] タブを選択します。
[Google によるサンプル エージェント] セクションで、サンプル エージェント カードをクリックします。
データ エージェントを作成する
以降のセクションでは、データ エージェントの作成方法について説明します。
エージェントを作成したら、その設定を編集できます。
最初の手順
Google Cloud コンソールで、BigQuery の [エージェント] ページに移動します。
[エージェント カタログ] タブを選択します。
[新しいエージェント] をクリックします。[新しいエージェント] ページが開きます。
[エディタ] セクションの [エージェント名] フィールドに、データ エージェントのわかりやすい名前(
Q4 sales dataやUser activity logsなど)を入力します。[エージェントの説明] フィールドに、データ エージェントの説明を入力します。適切な説明を付けておくと、エージェントの動作や使用するデータが説明され、チャット相手とするデータ エージェントを選択する際に役立ちます(例:
Ask questions about customer orders and revenue)。[ナレッジソース] セクションで、[ソースを追加] をクリックします。[ナレッジソースを追加] ページが開きます。
[最近使用したアイテム] セクションで、ナレッジソースとして使用するテーブル、ビュー、グラフ、UDF を選択します。 Google Cloud コンソールでは、UDF に「fx」インジケーターが接頭辞として付加されます。
他のナレッジソースを表示するには、 [さらに表示] を選択します。
省略可: [最近使用したアイテム] セクションにリストされていないナレッジソースを追加します。
[検索] セクションの [テーブルを検索] フィールドにソース名を入力し、Enter キーを押します。ソース名は正確でなくてもかまいません。
[検索結果] セクションで、1 つ以上のソースを選択します。
[追加] をクリックします。新しいエージェント ページが再度開きます。
テーブルとフィールドの説明をカスタマイズする
データ エージェントの正確さを高めるために、追加のテーブル メタデータを提供できます。このメタデータはデータ エージェントによってのみ使用されるもので、ソーステーブルには影響しません。
テーブルとフィールドの説明を作成する際は、次のベスト プラクティスに従ってください。
これらの説明は、データ エージェントがスキーマをどのように理解しているかを把握するためのガイドとして使用してください。エージェントが提案した説明が正しい場合は、承認できます。
これらの説明を構成してもデータ エージェントがスキーマを理解していない場合は、説明を手動で調整して正しい情報を提供します。
テーブルとフィールドの説明を構成する手順は次のとおりです。
[ナレッジソース] セクションで、テーブルの [カスタマイズ] リンクをクリックします。
テーブルの説明を作成します。[テーブルの説明] フィールドに説明を入力するか、Gemini からの提案を受け入れます。
[フィールド] セクションで、Gemini から提案されたフィールドの説明を確認します。
受け入れるフィールドの説明を選択して、[提案を承認する] をクリックします。却下する説明を選択して、[提案を拒否] をクリックします。
フィールドの説明を手動で編集するには、フィールドの横にある [編集] をクリックします。[フィールドを編集] ペインが開きます。
- [説明] フィールドに、フィールドの説明を入力します。
- フィールドの説明を保存するには、[更新] をクリックします。
説明とフィールドの更新を保存するには、[更新] をクリックします。新しいエージェント ページが再度開きます。
カスタマイズが必要なテーブルごとに、この手順を繰り返します。
エージェントへの指示を作成する
エージェントは、カスタム指示を必要とせずに、ユーザーからの質問のコンテキストを理解する必要があります。エージェントの動作を変更する必要がある場合や、他のコンテキスト機能(カスタム テーブルとフィールドのメタデータ、検証済みクエリなど)でサポートされていない方法でコンテキストを改善する必要がある場合にのみ、エージェントのカスタム指示を作成します。
[手順] セクションの [エージェントへの指示] フィールドに、データ エージェントへの指示を入力します。データ エージェントは、これらの指示に基づいてユーザーからの質問のコンテキストを理解し、回答を提供するため、指示はできるだけ明確にしてください。
エージェントから満足のいく回答が得られない場合は、説明、例、用語集の用語などの構造化されたコンテキストを追加します。それでも満足のいく回答が得られない場合は、次の表の例のようにカスタム指示を追加します。
指示の例をさらに表示するには、[例を表示] をクリックします。
| 情報の種類 | 説明 | 例 |
|---|---|---|
| 主なフィールド | 分析に関して最も重要なフィールド。 | 「このテーブルで最も重要なフィールドは、[お客様 ID]、[商品 ID]、[注文日] です。」 |
| フィルタリングとグループ化 | エージェントがデータのフィルタリングとグループ化に使用するフィールド。 | 「質問がタイムラインまたは「時間の経過」に関するものである場合は、常に order_created_date 列を使用します。」「『商品別』と言われたら、product_category 列でグループ化する。」 |
| デフォルトのフィルタリング | デフォルトでフィルタリングするフィールド。 | 「特に指定がない限り、常に order_status = 'Complete' でデータをフィルタします。」 |
| 類義語とビジネス用語 | 主なフィールドの代替用語。 | 「『収益』または『売上』について質問された場合は、total_sale_amount 列を使用します。」"「ロイヤル」顧客とは、purchase_count が 5 を超える顧客のことです。" |
| 除外済みフィールド | データ エージェントが使用を避けるべきフィールド。 | 「[取得された取引日]、[取得された市区町村] のフィールドは使用しないでください。」 |
| 結合関係 | 2 つ以上のテーブルが互いにどのように関連付けられているか、およびどの列で結合されているか。エージェントは、列ペアで標準 SQL 結合を使用してデータを結合する必要があります。例の列をご覧ください。 |
お客様のアクティビティ
|
検証済みクエリを作成する
エージェントは、検証済みクエリを次の 2 つの方法で使用します。
- エージェントが検証済みのクエリを使用して質問に回答できる場合、信頼できる回答を確保するために、エージェントはクエリを記述どおりに呼び出します。
- エージェントが検証済みのクエリを使用して質問に回答できない場合でも、クエリを参考にしてデータを理解し、クエリのベスト プラクティスを把握します。
システムによって生成されたリストから検証済みクエリを選択することも、独自のクエリを作成することもできます。
データ エージェントの検証済みクエリ(以前はゴールデン クエリと呼ばれていました)を作成する手順は次のとおりです。
Gemini から提案された検証済みクエリを 1 つ以上選択します。
- [検証済みクエリ] セクションで、[候補の確認] をクリックします。[提案された検証済みクエリを確認する] ページが開きます。
- 検証済みクエリの候補を確認します。目的のユースケースに該当するものを選択します。
- [追加] をクリックします。新しいエージェント ページが再度開きます。
独自の検証済みクエリを作成するには、[クエリを追加] をクリックします。[検証済みクエリを追加] ページが開きます。
- [質問] フィールドに、検証済みクエリが回答するユーザーからの質問を入力します。
- [SQL を生成] をクリックして、指定したユーザーの質問に対応する検証済みクエリを Gemini に生成させます。
- 必要に応じて、検証済みクエリを修正します。
- [実行] をクリックし、クエリが想定どおりの結果を返すことを確認します。
- [追加] をクリックします。新しいエージェント ページが再度開きます。
必要に応じて、上記の手順を繰り返して追加の検証済みクエリを作成します。
パラメータ化された検証済みクエリを作成する
パラメータ化された検証済みクエリは、会話分析エージェントのユーザーの質問から値を抽出し、カスタマイズされた結果を提供します。
アナリストとビルダーは、これらの値のプレースホルダを含む再利用可能な SQL テンプレートを作成できます。テンプレートは、実行時にパラメータを動的に置き換えて、通常の検証済みクエリよりも幅広いユーザーの質問に回答します。
ユーザーがテンプレートのパターンに一致する質問をすると、会話分析エージェントは質問からパラメータ値(商品名、リージョン、日付など)を抽出します。次に、これらの値をパラメータ化されたクエリに挿入します。クエリ テンプレートから一致するレスポンスが検証済みとして表示されます。
パラメータ化された検証済みクエリを使用すると、検証済みクエリの機能と柔軟性が大幅に向上します。これにより、さまざまな入力に対して一貫性のある信頼性の高い回答が得られ、維持する必要がある個々のクエリの数が削減されます。
仕組み
データ アナリストなどのエキスパートが、テンプレートの質問(「@region の @product の売上はいくらですか?」など)を使用して、検証済みクエリを定義します。次に、エキスパートは、次の例に示すように、SQL パラメータを使用して検証済みクエリを作成または変更します。
SELECT * FROM sales WHERE region = @region AND product = @product
検証済みのクエリが保存されると、ユーザーは会話分析エージェントに自然言語で質問できます(例: 「北米でのノートパソコンの売上はいくらでしたか?」)。
ユーザーの質問に回答するため、エージェントは次の手順を実行します。
- 質問を、パラメータ化された検証済みクエリに関連付けられたパターンと照合します。エージェントは、自然言語理解(NLU)を使用して、ユーザーの質問から
@region(北米)と@product(ノートパソコン)の値を識別して抽出します。 - 抽出された値を SQL テンプレートの
@regionプレースホルダと@productプレースホルダに代入します。 - 完全な SQL クエリを実行します(例:
SELECT * FROM sales WHERE
region = 'North America' AND product = 'Laptops'
)。 - 結果をユーザーに返します。一致は常に確認済みとしてマークされます。
効果的なパラメータ化されたクエリを作成するためのヒント
- わかりやすいパラメータ名を使用する。パラメータにはわかりやすい名前を使用します(例:
@d1ではなく@start_date)。 - 詳細なパラメータの説明を作成する。会話分析の大規模言語モデル(LLM)は、パラメータの説明を使用して、ユーザーの質問からパラメータとその値を識別します。たとえば、
num_enrollmentsは有効なパラメータ名ですが、number of student enrollments from ages 5-14はクエリに関するより詳細なコンテキストを提供するパラメータの説明です。 - 一貫性のあるデータ型を確保する。SQL クエリで想定されるデータ型が、ユーザーの質問から抽出される可能性のあるデータ型と一致していることを確認します。
- 明確に定義されたスコープを提供する。クエリの構造が複雑な場合や、ロジックが直感的でない場合は、一般的で重要な質問パターンのテンプレートを作成します。これにより、LLM は最適な結果を返すことができます。
- 徹底的にテストする。さまざまな自然言語のフレーズでテストして、パラメータが正しく抽出されることを確認します。
パラメータ化された検証済みクエリを作成する
システムによって生成されたリストから検証済みクエリを選択することも、独自のクエリを作成することもできます。
クエリを作成または変更する前に、自然言語パターンと質問を考慮してクエリをドラフトします。たとえば、「US-EAST 倉庫のオーガニック バナナの合計在庫はわかりますか?」という質問を、パラメータ化された検証済みクエリとして「@region 倉庫の @product の合計在庫はいくつですか?」に書き換えることができます。エージェントは、この質問を SQL クエリに変換します。このクエリは、デフォルト値で更新します。
データ エージェントのパラメータ化された検証済みクエリを作成するには、新しいエージェントの作成時に新しいクエリを作成するか、新しいエージェントまたは既存のエージェントの既存の検証済みクエリを編集します。
次の手順では、検証済みのサンプルクエリを使用してパラメータを構成します。
Gemini から提案された既存の検証済みクエリを選択する
- 新規または既存のエージェントの [検証済みクエリ] セクションで、[候補の確認] をクリックします。[提案された検証済みクエリを確認する] ページが開きます。
- 提案された検証済みクエリの横にあるチェックボックスをオンにします。
- クエリ ウィンドウで、 [もっと見る] をクリックして、クエリの説明を開きます。
- 既存のクエリを開くには、[編集] をクリックします。
- クエリの構成を完了するには、検証済みクエリのパラメータを構成するをご覧ください。
エージェントを作成してから、検証済みクエリを作成する
- 最初の手順を確認し、残りの構成手順を検証済みクエリまで進めます。
- Google Cloud コンソールで、新しいエージェントの [検証済みのクエリ] セクションの [クエリを追加] をクリックします。[検証済みクエリの追加] ページが開きます。
- クエリの構成を完了するには、検証済みクエリのパラメータを構成するをご覧ください。
検証済みクエリのパラメータを構成する
- [質問] フィールドに、検証済みクエリで回答するユーザーからの質問を入力します。
- パラメータを指定するには、
@記号の後にパラメータ名を続けます。この構文は、ユーザーの質問から値を取り込むプレースホルダを識別します。ユーザーの質問でパラメータがどのように使用されるかを示す自然言語の質問を使用します。例: 「@region 倉庫の @product の合計在庫はいくらですか?」 [SQL を生成] をクリックします。SQL は次の例のようになります。
SELECT SUM(stock) AS total_stock FROM inventory WHERE product_id = @product AND region = @region;クエリのプレースホルダにデフォルト値を追加するには、[クエリ パラメータを管理] をクリックし、[クエリ パラメータを追加] をクリックします。
最初のパラメータには、[名前]、[タイプ]、[値]、[説明] の 4 つのフィールドが表示されます。
- [名前] に、質問から
@productをコピーして貼り付けます。 - [タイプ] で [STRING] を選択します。
- [値] に「
organic bananas」と入力します。 - [説明] に、できるだけ具体的な説明を入力します。たとえば、地域倉庫にある商品。
- [名前] に、質問から
2 つ目のパラメータとして、[クエリ パラメータを追加] をクリックします。
- [名前] に、質問から
@regionをコピーして貼り付けます。 - [タイプ] で [STRING] を選択します。
- [値] に「
US-EAST」と入力します。 - [説明] に、できるだけ具体的な説明を入力します(例:
a regional warehouse where products are located.)。
- [名前] に、質問から
両方のパラメータのフィールドに入力したら、[保存] をクリックします。
パラメータ化された検証済みクエリをテストする
- [実行] をクリックし、クエリが想定どおりの結果を返すことを確認します。
- 後の画面でユーザーのクエリをテストするには、質問フィールド全体をコピーします。
- [保存] をクリックして [クエリを追加] 画面を終了し、エージェントの [編集] ページに戻ります。
- エージェントの [編集] ページで、前にコピーした質問フィールドを [プレビュー] ウィンドウに貼り付けます。
@product変数をorganic bananasに置き換えます。@region変数をUS-EASTに置き換えます。
- Enter キーを押します。結果を確認してみましょう。この場合、有効な回答は、US-EAST リージョンのバナナの合計在庫数(1,000 など)です。
- 追加の検証済みクエリを作成または編集するには、必要に応じて上記の手順を繰り返します。
クエリを保存したので、ユーザーは「US-EAST 倉庫の有機バナナの合計在庫はわかりますか?」という質問をすることができます。会話分析は次の処理を行います。
- この質問をパターンに一致させます。
- 質問から
@productパラメータを@product= "organic bananas"、@regionパラメータを "US-EAST" として抽出します。 - クエリ
SELECT SUM(stock) AS total_stock FROM inventory WHERE product_id = 'organic bananas' AND region = 'US-EAST';を実行します。 - 計算された
total_stockを返します。
用語集の用語を作成または確認する
エージェントにローカルな BigQuery カスタム用語集の用語を作成したり、エージェントに選択したナレッジソースに適用される Knowledge Catalog からインポートされたビジネス用語集の用語を確認したりできます。
- Knowledge Catalog のビジネス用語集の用語は BigQuery リソースにグローバルに適用されるため、Knowledge Catalog を使用する場合は、個々のエージェントではなく、Knowledge Catalog でビジネス用語集の用語を作成して管理します。
- Knowledge Catalog からインポートしたビジネス用語集の用語を変更する必要がある場合は、Knowledge Catalog で編集し、BigQuery に戻って確認する必要があります。
- BigQuery のカスタム用語集の用語は BigQuery に残ります。Knowledge Catalog には表示されない。
- Knowledge Catalog を使用していない場合は、特定のエージェントに定義する必要がある用語に対して BigQuery のカスタム用語集の用語を作成できます。
エージェントのカスタム用語集の用語を作成する手順は次のとおりです。
- エージェントの [エディタ] ページの [用語集] セクションで、[用語を追加] をクリックします。
- [カスタム規約] セクションでは、既存のカスタム規約を編集または削除できます。
- 1 つ以上の新しい用語を作成するには、[用語を作成] をクリックします。
- 用語、定義、1 つ以上の類義語をカンマで区切って入力します。
- [追加] をクリックして、用語を作成します。
- 新しい用語を削除する場合は、[削除] をクリックします。
- カスタム用語をさらに作成するには、上記の手順を繰り返します。
Knowledge Catalog からインポートされたビジネス用語集の用語を表示する手順は次のとおりです。
- エージェントの [エディタ] ページの [用語集] セクションで、[用語を追加] をクリックします。
- [Dataplex からインポート済み] というページ セクションに移動します。
- Knowledge Catalog でインポートされた用語を変更するには、[Dataplex の用語集に移動] をクリックします。
- Knowledge Catalog で用語を変更したら、エージェントの [エディタ] ページに戻り、変更された用語を確認できます。
構成の設定
[設定] セクションでは、次のオプション設定を構成できます。
[モデル] セクションで、エージェントとの会話でユーザーが利用できるモデルのタイプを選択します。デフォルトでは、プレビュー版と一般提供版の両方のモデルを使用できます。プレビュー版のモデルは、グローバル エンドポイントを使用する場合があります。
ラベルを作成して、Google Cloud リソースを整理します。ラベルは、関連するオブジェクトをまとめてグループ化したり、他の Google Cloud リソースと組み合わせてグループ化できる Key-Value ペアです。
- [設定] セクションで [ラベルを管理] をクリックします。
- [ラベルを追加] をクリックします。
- [キー] フィールドと [値] フィールドに、ラベルの Key-Value ペアを入力します。
- ラベルをさらに追加する場合は、[ラベルを追加] をもう一度クリックします。
- ラベルを削除するには、[削除] をクリックします。
- 完了したら、[追加] をクリックします。新しいエージェント ページが再度開きます。
モニタリングと分析のために、エージェントのプロジェクトの BigQuery テーブルにエージェントの会話イベントを書き込むには、[会話ロギング] セクションで [会話ロギングを有効にする] をオンにします。
既存のエージェントを編集するときに会話ロギングの設定を使用できない場合は、ビュー セレクタを [ドラフト] に切り替え、特定の BigQuery テーブルがナレッジソースとして選択されていることを確認します。
[ログを保存する宛先を設定する] で、[データセット ID] のエージェントのプロジェクトにある既存の宛先データセットを選択します。[テーブル ID] で、既存のテーブルを選択するか、[テーブルを選択または作成] > [+ 新しいテーブル] をクリックし、[新しいテーブルを指定] にテーブル名(
agent_eventsなど)を入力して、[保存] をクリックします。データ ロギングとユーザーへの開示に関する通知を確認します。
設定が検証されるまで待ちます。データセットが存在しない場合は、まず BigQuery で作成します。会話型分析 API サービス エージェント(
service-PROJECT_NUMBER@gcp-sa-geminidataanalytics.iam.gserviceaccount.com)にデータセットへのアクセス権がない場合は、[アクセス権を付与] をクリックしてデータセットにroles/bigquery.dataEditorを付与するか、管理者に付与を依頼します。
エージェントを公開したら、公開されたエージェントのメイン チャット画面からテスト用の質問を行い([プレビュー] セクションはログに記録されません)、BigQuery Studio で宛先データセットを更新して、ログテーブルが表示されることを確認します。後で宛先を更新するか、ロギングをオフにするには、エージェントを編集して変更を公開します(既存の行は削除されません)。詳細については、会話ロギングの概要をご覧ください。
データ エージェントによって処理されるクエリのサイズ上限を設定します。[設定] セクションの [課金される最大バイト数] フィールドに値を入力します。この上限は
10485760以上に設定する必要があります。そうしないと、次のエラー メッセージが表示されます。
Value error. In BigQuery on-demand pricing charges are
rounded up to the nearest MB, with a minimum of 10 MB of data processed
per query. So, max bytes billed must be set to greater or equal to
10485760.
値を指定しない場合、maximum bytes billed はデフォルトでプロジェクトの 1 日あたりのクエリ使用量の割り当てに設定されます。カスタム割り当てを指定していない限り、1 日あたりの使用量の割り当ては無制限です。
次のセクションに進み、エージェントをドラフト モードにするか、エージェントを公開します。
エージェントをプレビューして公開する
[プレビュー] セクションの [質問する] フィールドにユーザーからの質問の例を入力し、Enter キーを押します。データ エージェントが想定どおりのデータを返していることを確認するには、エージェントの回答を確認します。回答が期待どおりでない場合は、[エディタ] セクションの設定を変更して、満足のいく回答が得られるまでデータ エージェントの構成を調整します。エージェントのテストと修正を反復することで、エージェントの結果を改善できます。
[保存] をクリックします。
データ エージェントをドラフトモードにして、後で再編集できるようにするには、 [戻る] をクリックして [エージェント カタログ] ページに戻ります。エージェントはドラフト モードになっているため、[エージェント カタログ] タブの [ドラフト エージェント] セクションに表示されます。
エージェントを公開するには、エージェント作成ページを開いたまま、次のステップに進みます。
[公開] をクリックして [公開チャネル] ペインを開き、データ エージェントを公開して、プロジェクトで使用できるようにします。
省略可: [エージェントが公開されました] ダイアログで [共有] をクリックして、データ エージェントを他のユーザーと共有します。
[共有権限] ペインで、[プリンシパルを追加] をクリックします。
[新しいプリンシパル] フィールドに、1 つ以上のプリンシパルを入力します。
[ロールを選択] リストをクリックします。
[ロール] リストで、次のいずれかのロールを選択します。
- Gemini データ分析データ エージェント ユーザー(
roles/geminidataanalytics.dataAgentUser): データ エージェントとチャットする権限を付与します。 - Gemini データ分析データ エージェント編集者(
roles/geminidataanalytics.dataAgentEditor): データ エージェントを編集する権限を付与します。 - Gemini データ分析 Data Agent Viewer(
roles/geminidataanalytics.dataAgentViewer): データ エージェントを表示する権限を付与します。
- Gemini データ分析データ エージェント ユーザー(
[保存] をクリックします。
新しいエージェント ページに戻るには、[閉じる] をクリックします。エージェントを保存または公開すると、すぐにエージェント カタログに表示されます。
BigQuery Studio またはデータポータルを使用して、データ エージェントとの会話を作成できます。また、Conversational Analytics API を使用して、データ エージェントとチャットする独自のインターフェースを構築することもできます。データポータルへの公開については、データポータルでデータ エージェントを公開するをご覧ください。Gemini Enterprise への公開については、Gemini Enterprise でデータ エージェントを公開するをご覧ください。
データ エージェントを管理する
既存のエージェントは [エージェント カタログ] タブで確認できます。このタブは次の 3 つのセクションで構成されています。
- マイ エージェント: 作成して公開したすべてのエージェントのリスト。公開されたエージェントを変更して、他のユーザーと共有できます。
- 下書きのエージェント: まだ公開していないエージェント。ドラフト エージェントは共有できません。
- 組織内の他のユーザーが共有: 他のユーザーが作成して共有したエージェント。他のユーザーから権限を付与されている場合は、これらの共有エージェントを編集できます。
データ エージェントを編集する
データ エージェントを編集する手順は次のとおりです。
BigQuery の [エージェント] ページに移動します。
[エージェント カタログ] タブを選択します。
変更するデータ エージェントのエージェント カードを見つけます。
エージェント エディタでデータ エージェントを開くには、 [アクションを開く] > エージェント カードの [編集] をクリックします。
データ エージェントの構成を必要に応じて編集します。
変更を公開せずに保存するには、[保存] をクリックします。
変更内容を公開するには、[公開] をクリックします。[共有] ダイアログで、エージェントを他のユーザーと共有するか、[キャンセル] をクリックします。
[エージェント] ペインに戻るには、 [戻る] をクリックします。
データ エージェントを共有する
公開されたデータ エージェントを共有する手順は次のとおりです。ドラフト エージェントは共有できません。
BigQuery の [エージェント] ページに移動します。
[エージェント カタログ] タブを選択します。
変更するデータ エージェントのエージェント カードを見つけます。
エージェント エディタでデータ エージェントを開くには、 [アクションを開く] > エージェント カードの [編集] をクリックします。
データ エージェントを他のユーザーと共有するには、[共有] をクリックします。
[共有権限] ペインで、[プリンシパルを追加] をクリックします。
[新しいプリンシパル] フィールドに、1 つ以上のプリンシパルを入力します。
[ロールを選択] リストをクリックします。
[ロール] リストで、次のいずれかのロールを選択します。
- Gemini データ分析データ エージェント ユーザー(
roles/geminidataanalytics.dataAgentUser): データ エージェントとチャットする権限を付与します。 - Gemini データ分析データ エージェント編集者(
roles/geminidataanalytics.dataAgentEditor): データ エージェントを編集する権限を付与します。 - Gemini データ分析データ エージェント閲覧者(
roles/geminidataanalytics.dataAgentViewer): データ エージェントを表示する権限を付与します。
- Gemini データ分析データ エージェント ユーザー(
[保存] をクリックします。
エージェントの編集ページに戻るには、[閉じる] をクリックします。
[エージェント] ペインに戻るには、 [戻る] をクリックします。
データ エージェントを削除する
BigQuery の [エージェント] ページに移動します。
[エージェント カタログ] タブを選択します。
[エージェント カタログ] タブの [自分のエージェント] セクションまたは [自分のドラフト エージェント] セクションで、削除するデータ エージェントのエージェント カードを見つけます。
[アクションを開く] > [削除] をクリックします。
[エージェントを削除しますか?] ダイアログで、[削除] をクリックします。
データポータルでデータ エージェントを公開する
エージェントを公開してデータポータル ユーザーと共有すると、エージェントはデータポータルの [データとチャットする] ページに自動的に表示され、ユーザーはエージェントとチャットできるようになります。
エージェントを作成してデータポータルに公開する
データ アナリストは、次の手順でエージェントを作成、編集し、データポータルに公開できます。
- BigQuery でデータ エージェントを作成または編集します。
- エージェントを公開します。エージェントを公開するときに、公開オプションとして [データポータル] を選択します。
- 手順に沿ってエージェントを共有し、適切な Identity and Access Management ロールをデータポータル ユーザーに付与します。
エージェントをデータポータルのユーザーと共有する
データポータルでエージェントとの会話を開くリンクをコピーして、データポータル ユーザーとエージェントを直接共有できます。また、エージェントにアクセスできることをユーザーに通知するメールを送信することもできます。
エージェントへの直接リンクを共有するには、次の方法でエージェント専用の URL をコピーします。
- エージェント カタログから: [アクションを開く] > [リンクをコピー] > [データポータル] を選択します。
- エージェントの詳細ビューから: [エージェントのリンクをコピー] を選択 > [データポータル] を選択します。
- [共有] オーバーフロー メニューから、[データポータルのエージェントへのリンクをコピー] を選択します。
- [共有権限] パネルで [保存] をクリックした後、[リンクをコピー] を選択します。
エージェントへのアクセス権を受信者に通知するメールを送信するには、[権限を共有] パネルで [メールを送信] を選択します。メール通知は、その編集セッションでエージェントを共有したユーザーまたはグループにのみ送信されます。グループのすべてのメンバーがメール通知を受け取ります。これは、特定のユーザーがすでにエージェントに対してエージェント レベルの権限を持っている場合でも同様です。メールには、エージェントを共有したユーザーの名前、エージェントの名前、データポータルでエージェントを開くためのリンクが記載されています。
Gemini Enterprise でデータ エージェントを公開する
BigQuery データ エージェントを Gemini Enterprise で公開すると、ビジネス ユーザーは Gemini Enterprise 内で直接、自然言語を使用してデータのクエリと分析を行うことができます。このプロセスでは通常、データ アナリスト、Gemini Enterprise 管理者、ビジネス ユーザーが連携します。これらのユーザーに必要なロールの詳細については、必要なロールをご覧ください。
Gemini Enterprise でデータ エージェントを公開する手順は次のとおりです。
- 前提条件を確認してください。
- BigQuery でデータ エージェントを作成して公開します。
- Gemini Enterprise でエージェントをプロビジョニングします。
- エージェントを検索してチャットします。
前提条件を確認
BigQuery 会話分析エージェントを公開するには、Agent Registry を使用することをおすすめします。このセクションの前提条件に沿って、Gemini Enterprise でエージェントが検出可能であることを確認してください。
または、A2A カード JSON を使用してエージェントを公開することもできます。この方法を使用する場合は、BigQuery でデータ エージェントを作成して公開するをご覧ください。
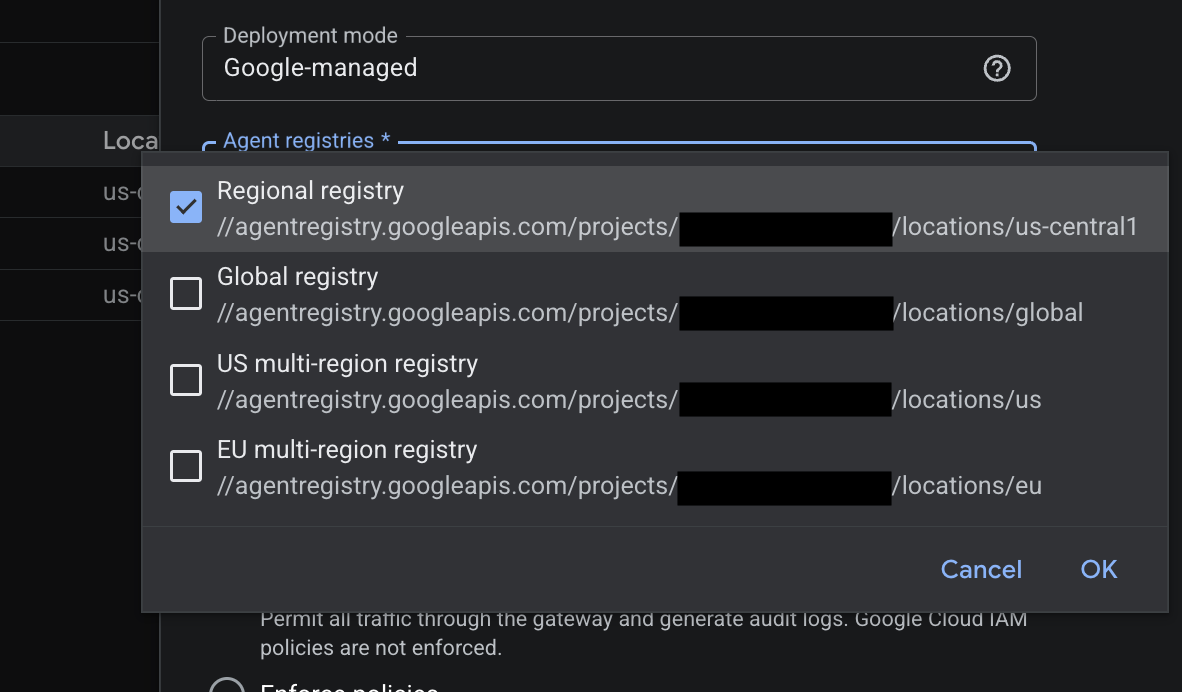
Agent Registry を使用するには、まず適切なリージョン マッピングで Agent Gateway を構成する必要があります。BigQuery データ エージェントのストレージ リージョンと、Gemini Enterprise の Agent Gateway レジストリ バインディングが一致している必要があります。
エージェントのストレージ リージョンは、BigQuery ウェブ UI のエージェント エディタの [リージョン] セクションで構成します。エージェントを保存した後は、リージョンを変更できません。
次の図は、Agent Gateway で使用可能なリージョン オプションを示しています。
Gemini Enterprise 管理者は、次の手順で Gemini Enterprise アプリケーションの Agent Gateway を構成します。
- データ エージェントのリージョンに一致する Agent Registry バインディングを含む Agent Gateway を設定します。選択できるオプションは、[米国]、[EU]、[グローバル] です。
- Gemini Enterprise でアプリケーションを開き、[セキュリティ] > [構成] に移動して、[Agent Gateway の構成] セクションにゲートウェイ リソース名を入力します。詳細な手順については、Agent Gateway を介して Gemini Enterprise トラフィックをルーティングするをご覧ください。
BigQuery でデータ エージェントを作成して公開する
データ アナリストは、次の手順で BigQuery でエージェントを作成、構成、公開します。
- BigQuery で、データ エージェントを作成または編集します。
- [リージョン] セクションで、ストレージ リージョンがデータソースと Agent Gateway の構成と一致していることを確認します。オプションには、US、EU、Global があります。
- [Publish] をクリックします。エージェントが以前に公開されている場合は、[Publish updates] をクリックします。
- [チャンネルの公開] ペインの [その他のチャンネル] で、公開方法を選択します。
- BigQuery と Gemini Enterprise が同じプロジェクトにある場合は、[エージェント レジストリ] セクションで [このエージェントを登録する] チェックボックスをオンにします。
- レジストリからエージェントを削除する場合は、[登録解除] をクリックします。
- BigQuery と Gemini Enterprise が異なるプロジェクトにある場合は、[A2A(Agent2Agent)を介して統合する] セクションで [JSON をコピー] をクリックして A2A エンドポイントの JSON データをコピーし、その JSON データを Gemini Enterprise 管理者と共有します。この JSON データは、Gemini Enterprise でエージェントをプロビジョニングするセクションで使用します。
- BigQuery と Gemini Enterprise が同じプロジェクトにある場合は、[エージェント レジストリ] セクションで [このエージェントを登録する] チェックボックスをオンにします。
- [公開] または [アップデートを公開] をクリックします。
- アクセスが必要なユーザーやグループとエージェントを共有し、Gemini データ分析データ エージェント ユーザー(
roles/geminidataanalytics.dataAgentUser)ロールを付与します。
Gemini Enterprise でエージェントをプロビジョニングする
Gemini Enterprise 管理者は、次のいずれかの方法で、アプリケーションのユーザーがデータ エージェントを利用できるようにします。
オプション 1: Agent Registry からインポートする
登録済みエージェントをインポートする手順は次のとおりです。
- Gemini Enterprise が BigQuery プロジェクトとは異なるプロジェクトにある場合は、次の手順に沿って、Agent Registry にエージェントを手動で登録します。それ以外の場合は、この手順をスキップします。
- Google Cloud コンソールで、Gemini Enterprise と同じプロジェクトの [エージェント レジストリ] に移動し、[エージェント] タブを選択して、[エージェントを追加] をクリックします。
- [エージェントの詳細] ペインの [タイプ] で、[A2A] を選択します。
- [リージョン] で、データ エージェントと Agent Gateway の構成に一致するリージョンを選択します。
- [JSON を貼り付け] を選択し、BigQuery から A2A エンドポイントの JSON データを貼り付けて、[保存] をクリックします。
- Gemini Enterprise で、エージェントを追加するアプリの名前をクリックします。
- ナビゲーション メニューで、[エージェント] をクリック > [エージェントを追加] をクリックします。
- [エージェント タイプの選択] ペインで、[Agent Registry のエージェント] を見つけて、[追加] をクリックします。
- [エージェントを追加] ペインで、名前、エージェント レジストリ ID、タイプ、プロデューサー、ユースケースでエージェントを検索するか、リストでエージェント カードを見つけます。
- エージェント カードで [エージェントを追加] をクリックします。
- [エージェントの詳細を確認する] ステップで、エージェントの A2A カードから入力されたエージェント メタデータ(名前、説明、エージェント URL、機能、スキルなど)を確認し、[次へ] をクリックします。
- [エージェントを認証する] ステップで、Gemini Enterprise がエージェント プロバイダに対して認証する方法を選択します。
- Google が管理するデフォルトの認証情報: Google が OAuth 認証情報を自動的に管理します。クライアント認証情報を手動で構成したり入力したりする必要はありません。
- カスタム OAuth: 組織でカスタム OAuth クライアント認証情報が必要な場合にのみ、このオプションを選択し、クライアント ID、クライアント シークレット、認証 URL、トークン URL を入力します。
- [完了] をクリックします。
- エージェントが [エージェント テーブル] に表示され、状態が [有効]、エージェント タイプが [A2A(カスタム)] になります。
- アクセスが必要なユーザーまたはグループとエージェントを共有します。
オプション 2: A2A カードの JSON を使用してインポートする
BigQuery と Gemini Enterprise が異なるプロジェクトにある場合は、次の手順に沿って A2A カード JSON を使用してエージェントをインポートします。
- Gemini Enterprise で、エージェントを追加するアプリの名前をクリックします。
- ナビゲーション メニューで、[エージェント] をクリック > [エージェントを追加] をクリックします。
- [エージェント タイプの選択] ペインで、[A2A によるカスタム エージェント] を見つけて [追加] をクリックします。
- [エージェント カードの JSON] フィールドに、データ アナリストから受け取ったエージェント カードの JSON を入力します。
- [エージェントの詳細をプレビュー] > [次へ] をクリックします。
- [エージェントの認可] ステップで、認証方法を選択します。
- デフォルトの Google 管理の認証情報: Google が OAuth 認証情報を自動的に管理します。クライアント ID とクライアント シークレットを手動で入力または生成する必要はありません。
- カスタム OAuth: A2A エージェントを登録して管理するの手順に沿って、カスタム OAuth 認証情報を手動で指定する場合は、このオプションを選択します。
- [ツールの承認] ステップで、[完了] をクリックします。
- エージェントが [エージェント テーブル] に表示され、状態が [有効]、エージェント タイプが [A2A(カスタム)] になります。
- アクセスが必要なユーザーまたはグループとエージェントを共有します。
エージェントを検出して使用する
Gemini Enterprise でデータ エージェントを検出して使用するには、次のいずれかの方法を使用します。
- 手動検出: Agent Gallery でデータ エージェントを見つけて、次のいずれかの方法で使用します。
- ギャラリーを閲覧する: エージェントを選択して、専用のチャットを開始します。
- 直接リンク: エージェント専用の URL を使用して、特定の BigQuery データ エージェントとのセッションで Gemini Enterprise を直接開きます。
- ダイレクト インテント: Gemini Enterprise のコアチャットで
@mention(例:@sales_pipeline_agent)を使用してエージェントを呼び出します。 - シームレスなオーケストレーション: 一般的な分析に関する質問(「過去 3 か月のセールス パイプラインの傾向はどうなっていますか?」など)をすると、Gemini Enterprise はクエリを関連するデータ エージェントに自動的にルーティングします。
エージェントを検出したら、次の手順でエージェントを操作できます。
- 認証: 1 回限りの OAuth ログインを完了して、BigQuery に対する認証を安全に行います。
- チャット: エージェントに自然言語で質問します。リクエストはエージェントによって処理され、レスポンスはテキスト、マークダウン、グラフ、テーブルとして Gemini Enterprise にストリーミングされます。
- 会話の履歴を表示する: 会話は履歴ペインに自動的に保存されます。
エージェントと会話をモニタリングする
BigQuery で Google Cloud Observability を使用すると、データ エージェントとその会話のパフォーマンス、導入、レイテンシ、費用をモニタリングできます。エージェントのオブザーバビリティを有効にすると、次のような指標を表示できます。
- 会話で使用されたエージェントの数
- 質問したユーザーの数
- 作成された会話の数
- 最も多くの質問に回答したエージェント
- 最もよく使用されるナレッジソース
- ユーザー エンゲージメント
- 予測トークン使用量
- 1 時間あたりの回答レイテンシ
始める前に
Cloud Trace API、Cloud Monitoring API、Cloud Logging API がまだ有効になっていない場合は、有効にします。
API を有効にするために必要なロール
API を有効にするには、serviceusage.services.enable 権限が必要です。プロジェクトを作成した場合は、オーナーロール(roles/owner)を介してこの権限がすでに付与されている可能性があります。それ以外の場合は、Service Usage 管理者ロール(roles/serviceusage.serviceUsageAdmin)を介してこの権限を取得できます。ロールを付与する方法を確認する。
必要なロールと権限
エージェントのオブザーバビリティを有効にするには、プロジェクトに次の権限が必要です。
cloudaicompanion.gibqObservabilitySettings.createcloudaicompanion.gibqObservabilitySettings.listcloudaicompanion.gibqObservabilitySettings.updatecloudaicompanion.settingBindings.gibqObservabilitySettingsCreatecloudaicompanion.settingBindings.gibqObservabilitySettingsListcloudaicompanion.settingBindings.gibqObservabilitySettingsUsegeminidataanalytics.dataAgents.creategeminidataanalytics.operations.getobservability.traceScopes.createresourcemanager.projects.updateserviceusage.services.enableserviceusage.values.test
指標、トレース、ログを使用してエージェントをモニタリングするために必要な権限を取得するには、プロジェクトに対する次の IAM ロールを付与するよう管理者に依頼してください。
-
モニタリング データと構成を表示する: モニタリング閲覧者 (
roles/monitoring.viewer) -
トレースを表示する: Cloud Trace ユーザー (
roles/cloudtrace.user) -
ログを表示する: ログビューア (
roles/logging.viewer) -
データセットとその内容を表示する: BigQuery データ閲覧者 (
roles/bigquery.dataViewer) -
管理者設定を表示する: Gemini for Google Cloud ユーザー (
roles/cloudaicompanion.user)
ロールの付与については、プロジェクト、フォルダ、組織へのアクセス権の管理をご覧ください。
必要な権限は、カスタムロールや他の事前定義ロールから取得することもできます。
オブザーバビリティを有効にする
エージェントのオブザーバビリティはデフォルトで無効になっています。管理者は、プロジェクトまたは組織でこの機能を有効にできます。エージェントのオブザーバビリティを有効にするには、次のいずれかのオプションを選択します。
コンソール
Google Cloud コンソールで、BigQuery の [エージェント] ページに移動します。
[モニタリング] タブを選択します。
オブザーバビリティが無効になっている場合は、プロンプトに沿って有効にします。
Google Cloud CLI
オブザーバビリティ設定を作成します。
gcloud gemini gibq-observability-settings create SETTING_NAME \
  --conversational-analytics-setting-metrics-enabled \
  --conversational-analytics-setting-traces-enabled \
  --project=PROJECT_ID \
  --location=global
次のように置き換えます。
SETTING_NAME: オブザーバビリティ設定の名前。PROJECT_ID: プロジェクト ID。
オブザーバビリティ設定をプロジェクトにバインドします。
gcloud gemini gibq-observability-settings setting-bindings create BINDING_NAME \
  --gibq-observability-setting=SETTING_NAME \
  --target=projects/PROJECT_ID \
  --location=global \
  --project=PROJECT_ID
BINDING_NAMEは、設定バインディングの名前に置き換えます。バインディング名にはbinding-PROJECT_IDを使用することをおすすめします。
API
オブザーバビリティ設定を作成します。
curl -X POST \
    -H "Authorization: Bearer $(gcloud auth print-access-token)" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d '{
          "conversational_analytics_setting": {
            "metrics_enabled": true
          }
        }' \
    "https://cloudaicompanion.googleapis.com/v1/projects/PROJECT_ID/locations/global/gibqObservabilitySettings?gibq_observability_setting_id=SETTING_NAME"
次のように置き換えます。
SETTING_NAME: オブザーバビリティ設定の名前。PROJECT_ID: プロジェクト ID。
オブザーバビリティ設定をプロジェクトにバインドします。
curl -X POST \
    -H "Authorization: Bearer $(gcloud auth print-access-token)" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d '{
          "target": "projects/PROJECT_ID",
          "product": "GEMINI_IN_BIGQUERY"
        }' \
    "https://cloudaicompanion.googleapis.com/v1/projects/PROJECT_ID/locations/global/gibqObservabilitySettings/SETTING_NAME/settingBindings?setting_binding_id=BINDING_NAME"
BINDING_NAMEは、設定バインディングの名前に置き換えます。バインディング名にはbinding-PROJECT_IDを使用することをおすすめします。
指標を表示
指標は、オブザーバビリティを有効にした後に収集されます。データはバックフィルされません。エージェントの指標を表示するには、次のいずれかのオプションを選択します。
BigQuery
Google Cloud コンソールで、BigQuery の [エージェント] ページに移動します。
[モニタリング] タブを選択します。
Cloud Monitoring
Google Cloud コンソールで、Cloud Monitoring の [ダッシュボード] ページに移動します。
[マイ ダッシュボード] ペインで、
BigQuery Conversational Analyticsという名前のダッシュボードを検索します。ダッシュボードを開くには、その名前をクリックします。
省略可: カスタム ダッシュボードを作成します。
省略可: 指標を個別に表示するには、[Metrics Explorer] ページに移動します。
エージェント指標には、エージェントの使用状況、モデル呼び出し、ツールの使用状況、健全性、レイテンシ、トークンの使用状況が含まれます。
モデル呼び出しをデバッグする
モデル呼び出しやツール呼び出しなど、会話ターン内のオペレーションのシーケンスを可視化して、エラーやレイテンシのトラブルシューティングに役立てることができます。
Google Cloud コンソールで、Cloud Monitoring の [Trace エクスプローラ] ページに移動します。
スパンをクリックして調べます。
[詳細] ペインの情報を確認します。
省略可: カスタム トレース ダッシュボードを作成します。
トレースを保持する
Cloud Trace データは、オブザーバビリティ データセットに 30 日間保存されます。トレースデータを長期間保存するには、トレースデータを BigQuery データセットに移動します。
必要なロール
リンクされたデータセットを作成してライブトレースを BigQuery に公開するために必要な権限を取得するには、プロジェクトに対する次の IAM ロールを付与するよう管理者に依頼してください。
- Cloud Trace 管理者 (
roles/cloudtrace.admin) - オブザーバビリティ編集者 (
roles/observability.editor) - BigQuery ユーザー(
roles/bigquery.user)
ロールの付与については、プロジェクト、フォルダ、組織へのアクセス権の管理をご覧ください。
必要な権限は、カスタムロールや他の事前定義ロールから取得することもできます。
トレースデータを BigQuery に移動する
トレースデータを保持するには、次の操作を行います。
Cloud Shell を開きます。
_Traceバケットのロケーションを確認します。gcloud beta observability buckets list --location=-
次のステップで使用するため、
_Traceバケットのロケーションをメモしておきます。_Traceバケットを指すリンクされたデータセットを BigQuery プロジェクトに作成します。gcloud beta observability buckets datasets links create \ projects/PROJECT_ID/locations/LOCATION/buckets/_Trace/datasets/Spans/links/LINK_NAME \ --dataset=Spans \ --bucket=_Trace \ --location=LOCATION \ --project=PROJECT_ID
次のように置き換えます。
PROJECT_ID: プロジェクト IDLOCATION: 前のステップで作成した_TraceバケットのロケーションLINK_NAME: リンクされたデータセットの名前
過去のトレースを保存する標準データセットを作成します。次のコマンドは、デフォルトのパーティションの有効期限を 90 日(7,776,000 秒)に設定します。
bq --location=LOCATION mk \
    --dataset \
    --default_partition_expiration=7776000 \
    --description="Archive storage for historical traces" \
    PROJECT_ID:STORAGE_DATASET
STORAGE_DATASETは、データセットの名前に置き換えます。リンクされたデータセットと同じスキーマを使用して、ストレージ データセットに空のパーティション分割テーブルを作成します。日付でパーティショニングすると、データの保持とクエリの費用を管理できます。テーブルを作成するには、SQL エディタで次のクエリを実行します。
CREATE TABLE `PROJECT_ID.STORAGE_DATASET.TABLE_NAME`
PARTITION BY DATE(start_time)
AS
SELECT *
FROM `PROJECT_ID.LINK_NAME._AllSpans`
WHERE FALSE;
TABLE_NAMEは、テーブルの名前に置き換えます。スケジュールされたクエリを作成して、リンクされたデータセットからアーカイブ テーブルに日次トレースデータをコピーします。次のクエリは、前日のデータをコピーします。
INSERT INTO `PROJECT_ID.STORAGE_DATASET.TABLE_NAME`
SELECT *
FROM `PROJECT_ID.LINK_NAME._AllSpans`
WHERE start_time >=
  TIMESTAMP_SUB(TIMESTAMP_TRUNC(CURRENT_TIMESTAMP(), DAY), INTERVAL 1 DAY)
  AND start_time < TIMESTAMP_TRUNC(CURRENT_TIMESTAMP(), DAY);
詳細については、トレースを検索して調査する方法をご覧ください。
オブザーバビリティをオフにする
データ エージェントのオブザーバビリティをオフにするには、オブザーバビリティ設定を更新します。
gcloud gemini gibq-observability-settings update SETTING_NAME \
    --no-conversational-analytics-setting-metrics-enabled \
    --no-conversational-analytics-setting-traces-enabled \
    --project=PROJECT_ID \
    --location=global
次のように置き換えます。
SETTING_NAME: オブザーバビリティを有効にするために作成したオブザーバビリティ設定の名前。 Google Cloud コンソールを使用してオブザーバビリティを有効にした場合、設定名はdefaultです。PROJECT_ID: プロジェクト ID。
BigQuery で会話ログを分析する
Cloud Monitoring のプロジェクト レベルのオブザーバビリティ指標と Cloud Trace のスパンに加えて、BigQuery Studio でエージェントごとの会話ロギングを有効にすると、ユーザーの質問、エージェントの回答、レイテンシ、モデルトークンの使用状況など、各会話ターンをエージェントのプロジェクトの BigQuery テーブルに書き込むことができます。その後、GoogleSQL、インタラクティブな Colab ノートブック、または BigQuery エージェント分析 Python SDK を使用して、ログに記録されたイベントをクエリして評価できます。詳細については、会話ロギングの概要をご覧ください。
次のステップ
- BigQuery の会話型分析について詳細を確認する。
- Conversational Analytics API について詳細を確認する。
- 会話でデータを分析する。
- Gemini データ分析 Data Agent Viewer(
roles/geminidataanalytics.dataAgentViewer)ロールがデータ エージェントを表示する権限を付与する方法の詳細。