


Connettiti ad Apache Spark
Una connessione Apache Spark in BigQuery consente agli utenti di connettere BigQuery a Managed Service for Apache Spark in modo da poter eseguire stored procedure per Apache Spark. Puoi creare questa connessione, concedere le autorizzazioni richieste al relativo account di servizio e condividere la connessione con gli utenti.
Prima di iniziare
Abilita l'API BigQuery Connection.
-
Per ottenere le autorizzazioni necessarie per creare una connessione Spark, chiedi all'amministratore di concederti il ruolo IAM BigQuery Connection Admin (
roles/bigquery.connectionAdmin) nel progetto. Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.Potresti anche riuscire a ottenere le autorizzazioni richieste tramite i ruoli personalizzati o altri ruoli predefiniti.
- (Facoltativo) Per gestire i metadati utilizzando Dataproc Metastore, assicurati di aver creato un servizio Dataproc Metastore.
- (Facoltativo) Per visualizzare la cronologia dei job utilizzando le interfacce web del server di cronologia Spark, assicurati di aver creato un server di cronologia permanente (PHS) di Managed Service for Apache Spark.
Considerazioni sulla località
Quando scegli una località per i tuoi dati, tieni presente quanto segue:
Multi-regioni
Devi specificare risorse Google Cloud situate nella stessa grande area geografica:
Una connessione nella multiregione BigQuery US può fare riferimento a un Spark History Server o a un Dataproc Metastore in qualsiasi singola regione dell'area geografica degli Stati Uniti, ad esempio
us-central1,us-east4ous-west2.Una connessione nella località multiregionale dell'UE di BigQuery può fare riferimento a un server di cronologia Spark o a un Dataproc Metastore negli stati membri dell'Unione Europea, come
europe-north1oeurope-west3.
Regioni singole
Una connessione in una singola regione può fare riferimento solo alle risorse Google Cloudnella stessa regione. Ad esempio, una connessione nella singola regione us-east4 può fare riferimento solo a un server di cronologia Spark o a un Dataproc Metastore in us-east4.
Crea connessioni
Seleziona una delle seguenti opzioni:
Console
Vai alla pagina BigQuery.
Nel riquadro Explorer, fai clic su Aggiungi dati.
Si apre la finestra di dialogo Aggiungi dati.
Nel riquadro Filtra per, nella sezione Tipo di origine dati, seleziona Applicazioni aziendali.
In alternativa, nel campo Cerca origini dati, puoi inserire
Spark.Nella sezione Origini dati in primo piano, fai clic su Apache Spark.
Fai clic sulla scheda della soluzione Apache Spark: federazione di BigQuery.
Nel riquadro Origine dati esterna, inserisci le seguenti informazioni:
Nell'elenco Tipo di connessione, seleziona Apache Spark.
Nel campo ID connessione, inserisci un nome per la connessione, ad esempio
spark_connection.Nell'elenco Località dei dati, seleziona una regione.
Puoi creare una connessione in regioni e multi-regioni che supportano BigQuery. Per saperne di più, consulta Considerazioni sulla località.
(Facoltativo) Dall'elenco Servizio Metastore, seleziona un Dataproc Metastore.
(Facoltativo) Nel campo Cluster server di cronologia, inserisci un Persistent History Server di Managed Service for Apache Spark.
Fai clic su Crea connessione.
Fai clic su Vai alla connessione.
Nel riquadro Informazioni sulla connessione, copia l'ID account di servizio da utilizzare in un passaggio successivo.
bq
In un ambiente a riga di comando, utilizza il comando
bq mkper creare una connessione:bq mk --connection --connection_type='SPARK' \ --properties=PROPERTIES \ --project_id=PROJECT_ID \ --location=LOCATION CONNECTION_ID
Sostituisci quanto segue:
PROPERTIES: una coppia chiave-valore per fornire parametri specifici della connessione in formato JSONAd esempio:
--properties='{
"metastoreServiceConfig": {"metastoreService": "METASTORE_SERVICE_NAME"},
"sparkHistoryServerConfig": {"dataprocCluster": "MANAGED_SERVICE_FOR_APACHE_SPARK_CLUSTER_NAME"}
}'
Sostituisci quanto segue:
METASTORE_SERVICE_NAME: Dataproc Metastore con una configurazione di rete gRPC, ad esempioprojects/my-project-id/locations/us-central1/services/my-servicePer saperne di più, scopri come accedere ai metadati del metastore Hive archiviati utilizzando un protocollo endpoint.
MANAGED_SERVICE_FOR_APACHE_SPARK_CLUSTER_NAME: la configurazione del server di cronologia Spark, ad esempioprojects/my-project-id/regions/us-central1/clusters/my-clusterPer saperne di più, consulta Crea un cluster di server di cronologia permanente.
PROJECT_ID: il tuo ID progetto Google CloudLOCATION: la località in cui vuoi archiviare la connessione, ad esempioUSCONNECTION_ID: l'ID connessione, ad esempiomyconnectionQuando visualizzi i dettagli della connessione nella console Google Cloud , l'ID connessione è il valore nell'ultima sezione dell'ID connessione completo mostrato in ID connessione, ad esempio
projects/.../locations/.../connections/myconnection
Recupera e copia l'ID del account di servizio, perché ti servirà in un altro passaggio:
bq show --location=LOCATION --connection PROJECT_ID.LOCATION.CONNECTION_ID
L'output è simile al seguente:
Connection myproject.us.myconnection

       name           type                    properties
---------------------- ------- ---------------------------------------------------
myproject.us.myconnection  SPARK   {"serviceAccountId": "bqserver@example.iam.gserviceaccount.com"}
Per informazioni su come gestire le connessioni, consulta Gestisci le connessioni.
Concedi l'accesso al service account
Per consentire a una stored procedure per Apache Spark di accedere alle tue risorse Google Cloud, devi concedere al account di servizio associato alla connessione della stored procedure le autorizzazioni IAM necessarie. In alternativa, puoi utilizzare il tuo service account personalizzato per l'accesso ai dati.
Per leggere e scrivere dati da e verso BigQuery, devi concedere al account di servizio le seguenti autorizzazioni IAM:
bigquery.tables.*sulle tue tabelle BigQuerybigquery.readsessions.*sul tuo progetto
Il ruolo IAM
roles/bigquery.admininclude le autorizzazioni necessarie al account di servizio per leggere e scrivere dati da e verso BigQuery.Per leggere e scrivere dati da e su Cloud Storage, devi concedere al account di servizio l'autorizzazione
storage.objects.*sugli oggetti Cloud Storage.Il ruolo IAM
roles/storage.objectAdmininclude le autorizzazioni necessarie al account di servizio per leggere e scrivere dati da e verso Cloud Storage.Se specifichi Dataproc Metastore quando crei una connessione, affinché BigQuery possa recuperare i dettagli sulla configurazione del metastore, devi concedere all'account di servizio l'autorizzazione
metastore.services.getsu Dataproc Metastore.Il ruolo predefinito
roles/metastore.metadataViewerinclude l'autorizzazione necessaria al account di servizio per recuperare i dettagli sulla configurazione del metastore.Devi anche concedere al account di servizio il ruolo
roles/storage.objectAdminsul bucket Cloud Storage in modo che la stored procedure possa accedere alla directory del warehouse Hive di Dataproc Metastore (hive.metastore.warehouse.dir). Se la stored procedure esegue operazioni sul metastore, potresti dover concedere autorizzazioni aggiuntive. Per saperne di più sui ruoli e sulle autorizzazioni IAM in Dataproc Metastore, consulta Ruoli e autorizzazioni predefiniti di Dataproc Metastore.Se specifichi un server di cronologia permanente di Managed Service for Apache Spark quando crei una connessione, devi concedere al account di servizio i seguenti ruoli:
- Il ruolo
roles/dataproc.viewersul Persistent History Server di Managed Service for Apache Spark che contiene l'autorizzazionedataproc.clusters.get. - Il ruolo
roles/storage.objectAdminsul bucket Cloud Storage che specifichi per la proprietàspark:spark.history.fs.logDirectoryquando crei il Persistent History Server di Managed Service for Apache Spark.
Per saperne di più, consulta Server di cronologia permanente di Managed Service for Apache Spark e Ruoli e autorizzazioni di Managed Service for Apache Spark.
- Il ruolo
Condividi le connessioni con gli utenti
Puoi concedere i seguenti ruoli per consentire agli utenti di eseguire query sui dati e gestire le connessioni:
roles/bigquery.connectionUser: consente agli utenti di utilizzare le connessioni per connettersi a origini dati esterne ed eseguire query su di esse.roles/bigquery.connectionAdmin: consente agli utenti di gestire le connessioni.
Per saperne di più sui ruoli e sulle autorizzazioni IAM in BigQuery, consulta Ruoli e autorizzazioni predefiniti.
Seleziona una delle seguenti opzioni:
Console
Vai alla pagina BigQuery.
Le connessioni sono elencate nel progetto, in un gruppo denominato Connessioni.
Nel riquadro a sinistra, fai clic su Spazio di esplorazione:
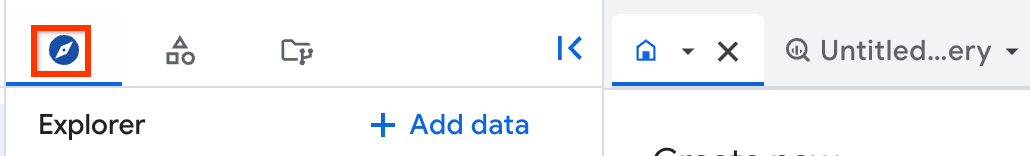
Se non vedi il riquadro a sinistra, fai clic su Espandi riquadro sinistro per aprirlo.
Fai clic sul progetto, poi su Connessioni e seleziona una connessione.
Nel riquadro Dettagli, fai clic su Condividi per condividere una connessione. Quindi:
Nella finestra di dialogo Autorizzazioni di connessione, condividi la connessione con altre entità aggiungendole o modificandole.
Fai clic su Salva.
bq
Non puoi condividere una connessione con lo strumento a riga di comando bq. Per condividere una connessione, utilizza la console Google Cloud o il metodo dell'API BigQuery Connections per condividere una connessione.
API
Utilizza il
metodo projects.locations.connections.setIAM
nella sezione di riferimento dell'API REST BigQuery Connections e
fornisci un'istanza della risorsa policy.
Java
Prima di provare questo esempio, segui le istruzioni di configurazione di Java nella guida rapida di BigQuery per l'utilizzo delle librerie client. Per saperne di più, consulta la documentazione di riferimento dell'API BigQuery Java.
Per eseguire l'autenticazione in BigQuery, configura le Credenziali predefinite dell'applicazione. Per saperne di più, vedi Configura l'autenticazione per le librerie client.
Passaggi successivi
- Scopri i diversi tipi di connessione.
- Scopri di più sulla gestione delle connessioni.
- Scopri come creare una stored procedure per Apache Spark.
- Scopri come gestire le stored procedure.