


Panoramica
Il Persistent History Server (PHS) di Managed Service for Apache Spark fornisce interfacce web per visualizzare la cronologia dei job eseguiti su cluster Managed Service for Apache Spark attivi o eliminati. È disponibile nella versione immagine 1.5 e successive di Managed Service for Apache Spark e viene eseguito su un cluster Managed Service for Apache Spark a nodo singolo. Fornisce interfacce web ai seguenti file e dati:
File di cronologia dei job MapReduce e Spark
File di cronologia dei job Flink (consulta Componente Flink facoltativo di Dataproc per creare un cluster Managed Service for Apache Spark per eseguire job Flink)
File di dati degli Spostamenti delle applicazioni creati dal servizio di cronologia YARN v2 e archiviati in un'istanza Bigtable.
Log di aggregazione YARN
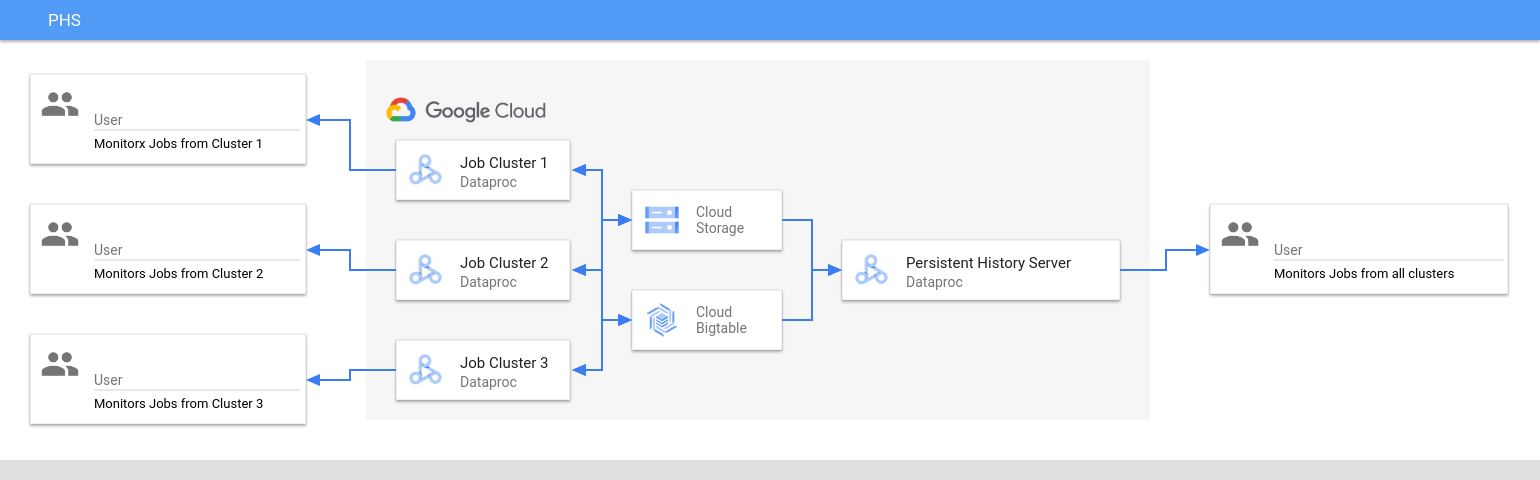
Il Persistent History Server accede e visualizza i file di cronologia dei job Spark e MapReduce, i file di cronologia dei job Flink e i file di log YARN scritti su Cloud Storage durante il ciclo di vita dei cluster di job Managed Service for Apache Spark.
Limitazioni
La versione immagine del cluster PHS e la versione immagine dei cluster di job Managed Service for Apache Spark devono corrispondere. Ad esempio, puoi utilizzare un cluster PHS con versione immagine 2.0 di Managed Service for Apache Spark per visualizzare i file della cronologia dei job eseguiti su cluster di job con versione immagine 2.0 di Managed Service for Apache Spark che si trovavano nel progetto in cui si trova il cluster PHS.
Un cluster PHS non supporta Kerberos e l'autenticazione personale.
Crea un cluster PHS di Managed Service for Apache Spark
Puoi eseguire il seguente comando gcloud dataproc clusters create in un terminale locale o in Cloud Shell con i seguenti flag e proprietà del cluster per creare un cluster a nodo singolo del Persistent History Server di Managed Service for Apache Spark.
gcloud dataproc clusters create CLUSTER_NAME \
    --project=PROJECT \
    --region=REGION \
    --single-node \
    --enable-component-gateway \
    --optional-components=COMPONENT \
    --properties=PROPERTIES
- CLUSTER_NAME: specifica il nome del cluster PHS.
- PROJECT: : specifica il progetto da associare al cluster PHS. Questo progetto deve essere lo stesso associato al cluster che esegue i tuoi job (vedi Crea un cluster di job Dataproc).
- REGION: specifica una regione di Compute Engine in cui si troverà il cluster PHS.
--single-node: un cluster PHS è un cluster a nodo singolo di Dataproc.--enable-component-gateway: questo flag attiva le interfacce web del gateway dei componenti sul cluster PHS.- COMPONENT: utilizza questo flag per installare uno o più componenti facoltativi sul cluster. Devi specificare il componente facoltativo
FLINKper eseguire il servizio web Flink HistoryServer sul cluster PHS per visualizzare i file della cronologia dei job Flink. - PROPERTIES. Specifica una o più proprietà del cluster.
Se vuoi, aggiungi il flag --image-version per specificare la versione dell'immagine del cluster PHS. La versione immagine del PHS deve corrispondere alla versione immagine dei cluster di job Managed Service for Apache Spark. Consulta la sezione Limitazioni.
Note:
- Gli esempi di valori delle proprietà in questa sezione utilizzano un carattere jolly "*" per consentire al PHS di trovare più directory nel bucket specificato in cui scrivono cluster di job diversi (ma consulta Considerazioni sull'efficienza dei caratteri jolly).
- Negli esempi seguenti vengono mostrati flag
--propertiesseparati per facilitare la leggibilità. La pratica consigliata quando utilizzigcloud dataproc clusters createper creare un cluster Managed Service for Apache Spark è utilizzare un flag--propertiesper specificare un elenco di proprietà separate da virgole (consulta la sezione Formattazione delle proprietà del cluster).
Proprietà:
yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/*/yarn-logs: aggiungi questa proprietà per specificare la località di Cloud Storage in cui il PHS accederà ai log YARN scritti dai cluster di job.spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history: aggiungi questa proprietà per abilitare la cronologia dei job Spark permanenti. Questa proprietà specifica la località in cui il PHS accederà ai log della cronologia dei job Spark scritti dai cluster di job.Nei cluster Managed Service for Apache Spark 2.0 e versioni successive, è necessario impostare anche le seguenti due proprietà per abilitare i log della cronologia di Spark PHS (consulta Opzioni di configurazione di Spark History Server). Il valore
spark.history.custom.executor.log.urlè un valore letterale che contiene {{SEGNAPOSTO}} per le variabili che verranno impostate dal server di cronologia permanente. Queste variabili non vengono impostate dagli utenti; passa il valore della proprietà come mostrato.--properties=spark:spark.history.custom.executor.log.url.applyIncompleteApplication=false
--properties=spark:spark.history.custom.executor.log.url={{YARN_LOG_SERVER_URL}}/{{NM_HOST}}:{{NM_PORT}}/{{CONTAINER_ID}}/{{CONTAINER_ID}}/{{USER}}/{{FILE_NAME}}mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done: aggiungi questa proprietà per attivare la cronologia dei job MapReduce permanenti. Questa proprietà specifica la località di Cloud Storage in cui il PHS accederà ai log della cronologia dei job MapReduce scritti dai cluster di job.dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id: dopo aver configurato Yarn Timeline Service v2, aggiungi questa proprietà per utilizzare il cluster PHS per visualizzare i dati degli Spostamenti sulle interfacce web YARN Application Timeline Service V2 e Tez (vedi Interfacce web del gateway dei componenti).flink:historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs: utilizza questa proprietà per configurareHistoryServerdi Flink in modo che monitori un elenco di directory separato da virgole.
Esempi di proprietà:
--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history
--properties=mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done
--properties=flink:flink.historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs
Crea un cluster di job Managed Service for Apache Spark
Puoi eseguire il comando seguente in un terminale locale o in Cloud Shell per creare un cluster di job Managed Service for Apache Spark che esegue i job e scrive i file della cronologia dei job in un Persistent History Server (PHS).
gcloud dataproc clusters create CLUSTER_NAME \ --project=PROJECT \ --region=REGION \ --optional-components=COMPONENT \ --enable-component-gateway \ --properties=PROPERTIES \ other args ...
- CLUSTER_NAME: specifica il nome del cluster di job.
- PROJECT: specifica il progetto associato al cluster di job.
- REGION: specifica la regione di Compute Engine in cui si troverà il cluster del job.
--enable-component-gateway: questo flag attiva le interfacce web del gateway dei componenti sul cluster di job.- COMPONENT: utilizza questo flag per installare uno o più componenti facoltativi sul cluster. Specifica il componente facoltativo
FLINKper eseguire i job Flink sul cluster. PROPERTIES: aggiungi una o più delle seguenti proprietà del cluster per impostare località Cloud Storage non predefinite relative a PHS e altre proprietà del cluster di job.
Note:
- Gli esempi di valori delle proprietà in questa sezione utilizzano un carattere jolly "*" per consentire al PHS di trovare più directory nel bucket specificato in cui scrivono cluster di job diversi (ma consulta Considerazioni sull'efficienza dei caratteri jolly).
- Negli esempi seguenti vengono mostrati flag
--propertiesseparati per facilitare la leggibilità. La pratica consigliata quando utilizzigcloud dataproc clusters createper creare un cluster Managed Service for Apache Spark è utilizzare un flag--propertiesper specificare un elenco di proprietà separate da virgole (consulta la sezione Formattazione delle proprietà del cluster).
Proprietà:
yarn:yarn.nodemanager.remote-app-log-dir: per impostazione predefinita, i log YARN aggregati sono abilitati sui cluster di job Managed Service for Apache Spark e scritti nel bucket temporaneo del cluster. Aggiungi questa proprietà per specificare una località Cloud Storage diversa in cui il cluster scriverà i log di aggregazione per l'accesso da parte del Persistent History Server.--properties=yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/directory-name/yarn-logs
spark:spark.history.fs.logDirectoryespark:spark.eventLog.dir: per impostazione predefinita, i file della cronologia dei job Spark vengono salvati nel clustertemp bucketnella directory/spark-job-history. Puoi aggiungere queste proprietà per specificare percorsi di Cloud Storage diversi per questi file. Se vengono utilizzate entrambe le proprietà, devono puntare a directory nello stesso bucket.--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/directory-name/spark-job-history
--properties=spark:spark.eventLog.dir=gs://bucket-name/directory-name/spark-job-history
mapred:mapreduce.jobhistory.done-diremapred:mapreduce.jobhistory.intermediate-done-dir: per impostazione predefinita, i file della cronologia dei job MapReduce vengono salvati nel clustertemp bucketnelle directory/mapreduce-job-history/donee/mapreduce-job-history/intermediate-done. La posizione intermediamapreduce.jobhistory.intermediate-done-dirè uno spazio di archiviazione temporaneo; i file intermedi vengono spostati nella posizionemapreduce.jobhistory.done-diral termine del job MapReduce. Puoi aggiungere queste proprietà per specificare località Cloud Storage diverse per questi file. Se vengono utilizzate entrambe le proprietà, devono puntare a directory nello stesso bucket.--properties=mapred:mapreduce.jobhistory.done-dir=gs://bucket-name/directory-name/mapreduce-job-history/done
--properties=mapred:mapreduce.jobhistory.intermediate-done-dir=gs://bucket-name/directory-name/mapreduce-job-history/intermediate-done
spark:spark.history.fs.gs.outputstream.type: questa proprietà si applica ai cluster con versioni immagine2.0e2.1che utilizzano la versione2.0.xdel connettore Cloud Storage (la versione predefinita del connettore per i cluster con versioni immagine2.0e2.1). Controlla il modo in cui i job Spark inviano i dati a Cloud Storage. L'impostazione predefinita èBASIC, che invia i dati a Cloud Storage dopo il completamento del job. Se impostato suFLUSHABLE_COMPOSITE, i dati vengono copiati in Cloud Storage a intervalli regolari durante l'esecuzione del job, come impostato daspark:spark.history.fs.gs.outputstream.sync.min.interval.ms.--properties=spark:spark.history.fs.gs.outputstream.type=FLUSHABLE_COMPOSITE
spark:spark.history.fs.gs.outputstream.sync.min.interval.ms: questa proprietà si applica ai cluster con versione immagine2.0e2.1che utilizzano la versione2.0.xdel connettore Cloud Storage (la versione predefinita del connettore per i cluster con versione immagine2.0e2.1). Controlla la frequenza in millisecondi con cui i dati vengono trasferiti a Cloud Storage quandospark:spark.history.fs.gs.outputstream.typeè impostato suFLUSHABLE_COMPOSITE. L'intervallo di tempo predefinito è5000ms. Il valore dell'intervallo di tempo in millisecondi può essere specificato con o senza l'aggiunta del suffissoms.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval.ms=INTERVALms
spark:spark.history.fs.gs.outputstream.sync.min.interval: questa proprietà si applica ai cluster con versione immagine2.2e successive che utilizzano la versione3.0.xdel connettore Cloud Storage (la versione predefinita del connettore per i cluster con versione immagine2.2). Sostituisce la proprietàspark:spark.history.fs.gs.outputstream.sync.min.interval.msprecedente e supporta i valori con suffisso temporale, comems,sem. Controlla la frequenza con cui i dati vengono trasferiti a Cloud Storage quandospark:spark.history.fs.gs.outputstream.typeè impostato suFLUSHABLE_COMPOSITE.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval=INTERVAL
dataproc:yarn.atsv2.bigtable.instance: dopo aver configurato Yarn Timeline Service v2, aggiungi questa proprietà per scrivere i dati degli Spostamenti YARN nell'istanza Bigtable specificata per la visualizzazione sulle interfacce web YARN Application Timeline Service V2 e Tez del cluster PHS. Nota: la creazione del cluster non andrà a buon fine se l'istanza Bigtable non esiste.--properties=dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id
flink:jobhistory.archive.fs.dir: il JobManager di Flink archivia i job Flink completati caricando le informazioni sui job archiviati in una directory del file system. Utilizza questa proprietà per impostare la directory di archiviazione inflink-conf.yaml.--properties=flink:jobmanager.archive.fs.dir=gs://bucket-name/job-cluster-1/flink-job-history/completed-jobs
Utilizza PHS con i workload batch Spark
Per utilizzare il Persistent History Server con Managed Service for Apache Spark Serverless per i workload batch Spark:
Seleziona o specifica il cluster PHS quando invii un workload batch Spark.
Utilizza PHS con Managed Service for Apache Spark su Google Kubernetes Engine
Per utilizzare il Persistent History Server con Managed Service for Apache Spark su GKE:
Seleziona o specifica il cluster PHS quando crei un cluster virtuale Managed Service for Apache Spark su GKE.
Interfacce web del gateway dei componenti
Nella console Google Cloud , dalla pagina Cluster di Managed Service for Apache Spark, fai clic sul nome del cluster PHS per aprire la pagina Dettagli cluster. Nella scheda Interfacce web, seleziona i link del gateway dei componenti per aprire le interfacce web in esecuzione sul cluster PHS.
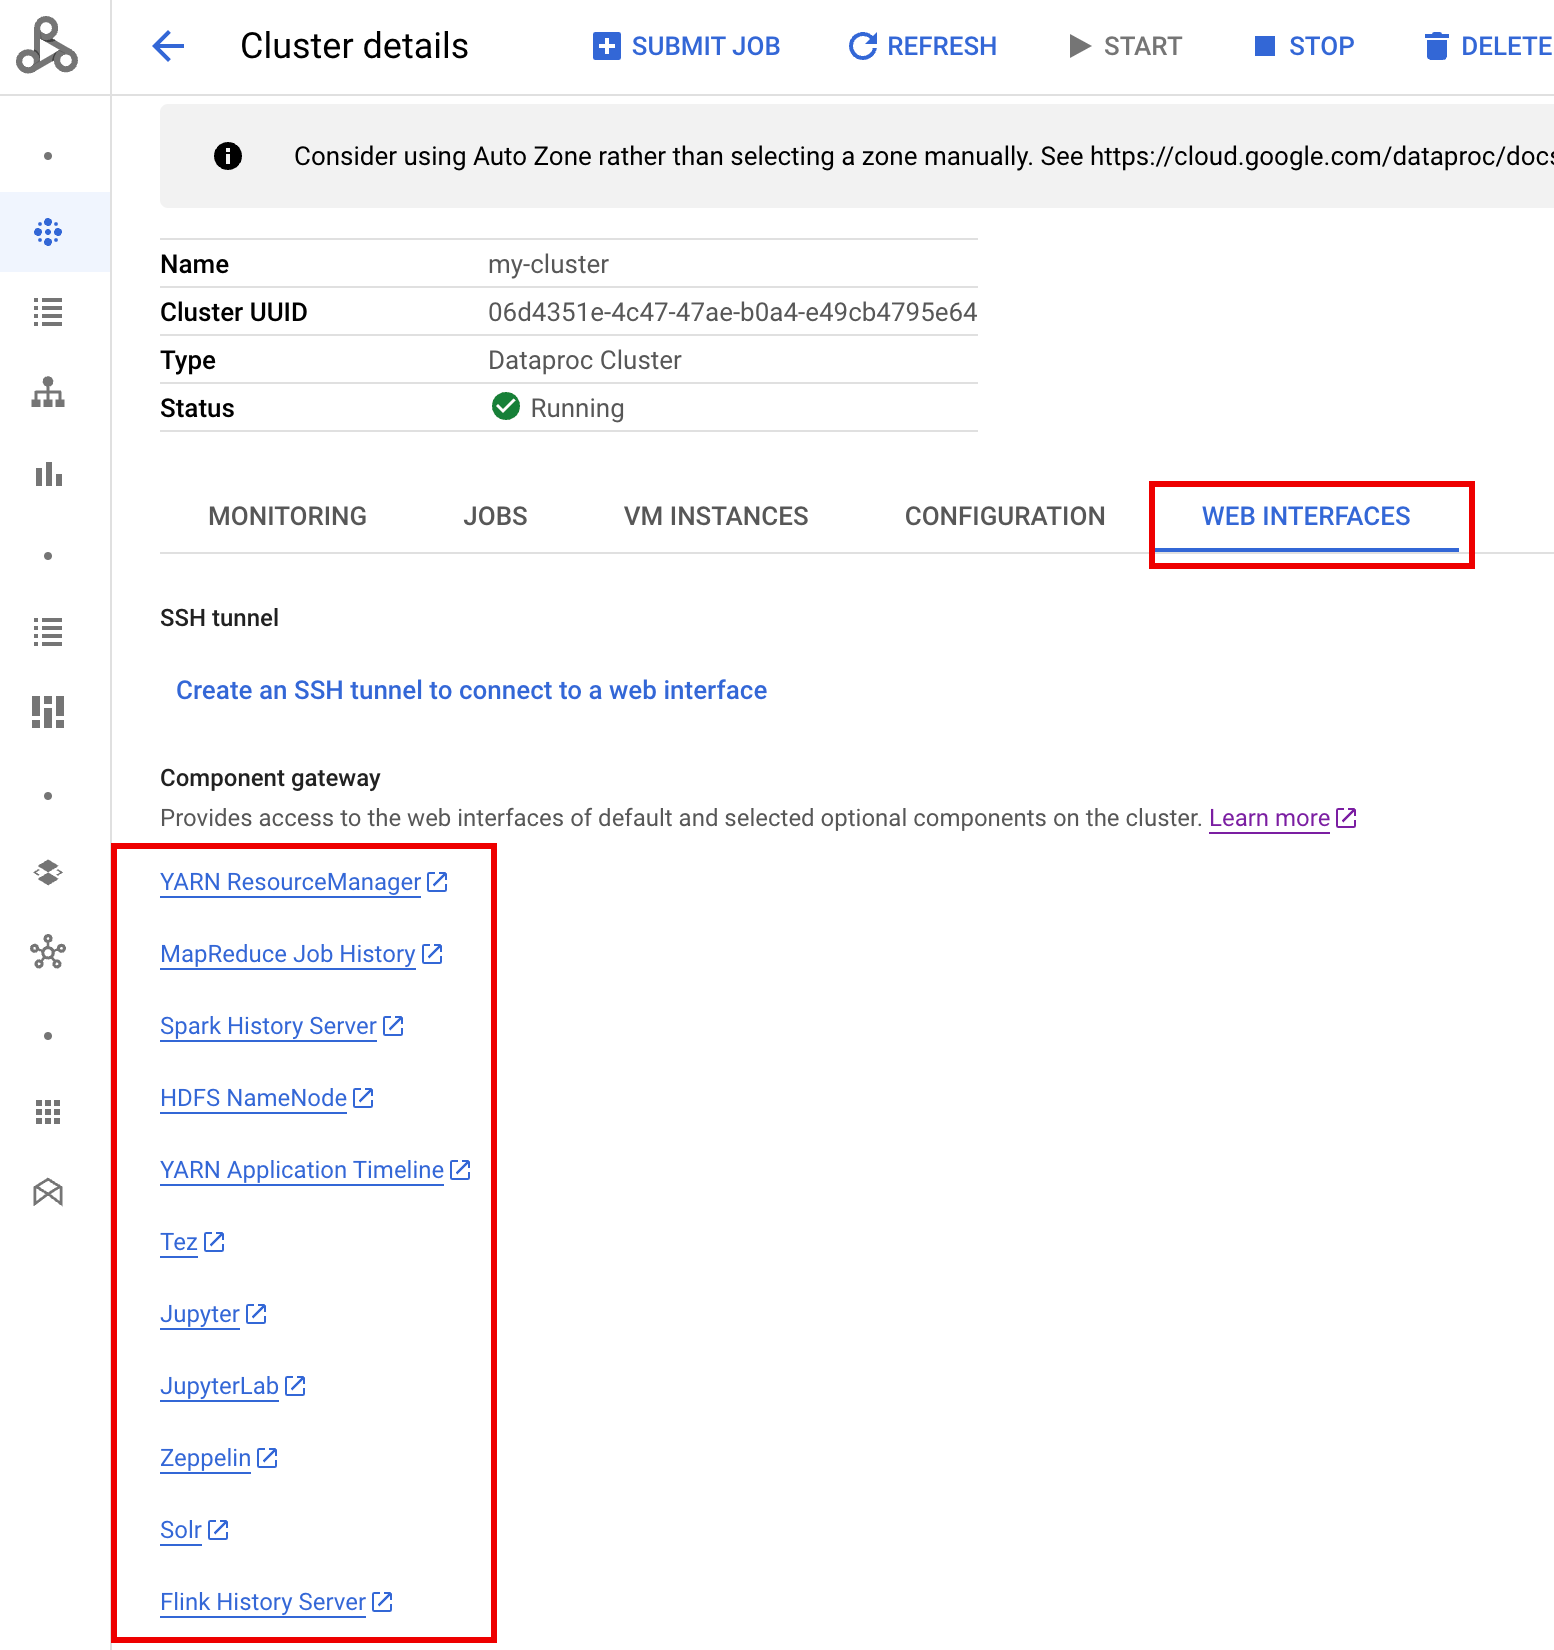
Interfaccia web del server di cronologia Spark
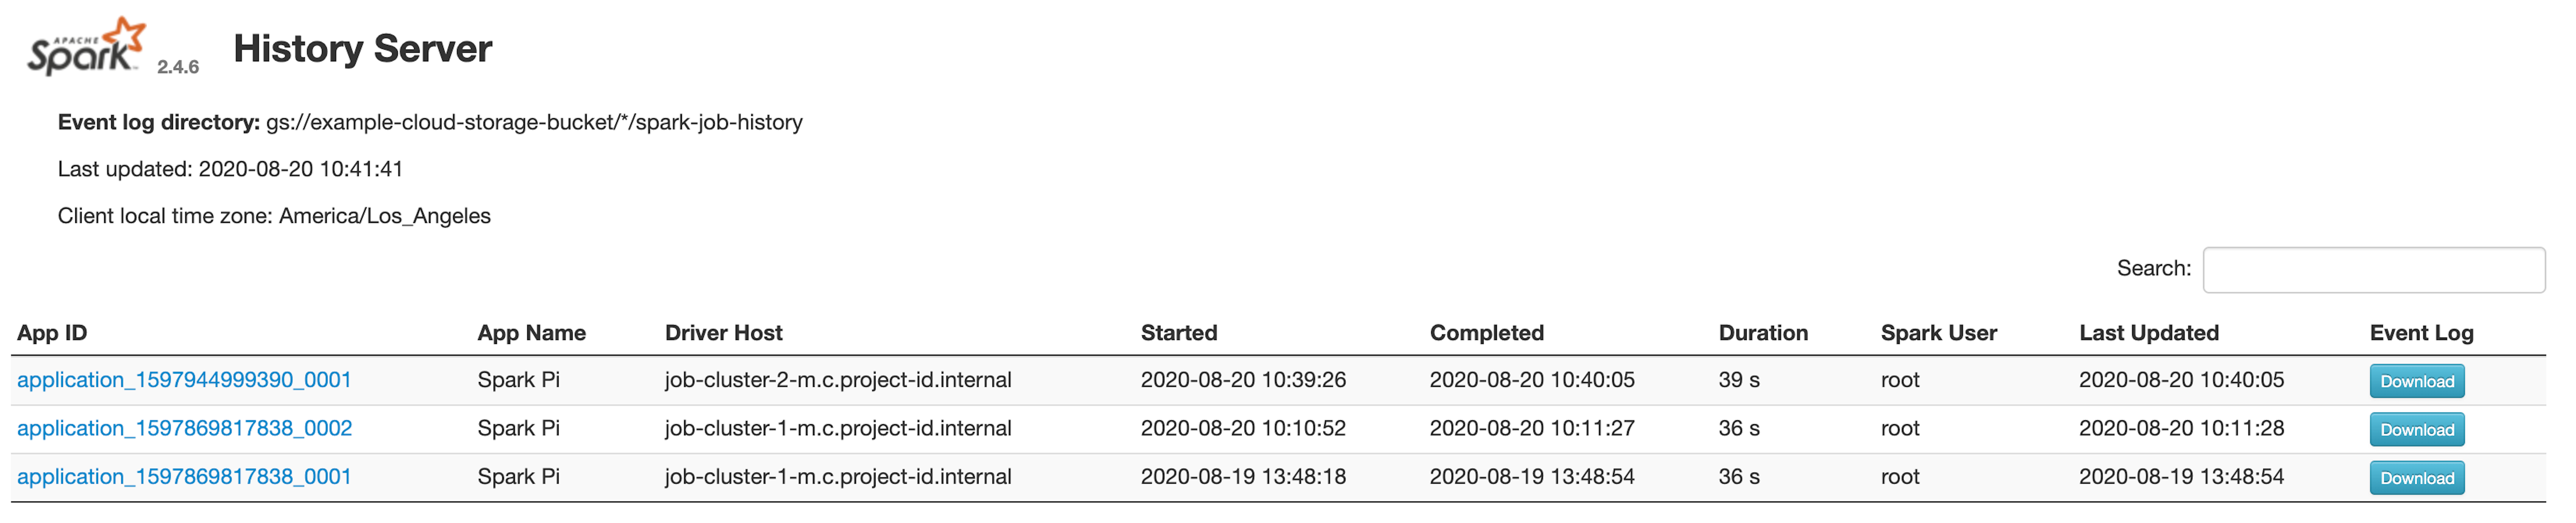
Lo screenshot seguente mostra l'interfaccia web del server della cronologia di Spark che visualizza i link ai job Spark eseguiti su job-cluster-1 e job-cluster-2 dopo aver configurato le posizioni spark.history.fs.logDirectory e spark:spark.eventLog.dir dei cluster di job e la posizione spark.history.fs.logDirectory del cluster PHS come segue:
| job-cluster-1 | gs://example-cloud-storage-bucket/job-cluster-1/spark-job-history |
| job-cluster-2 | gs://example-cloud-storage-bucket/job-cluster-2/spark-job-history |
| phs-cluster | gs://example-cloud-storage-bucket/*/spark-job-history |
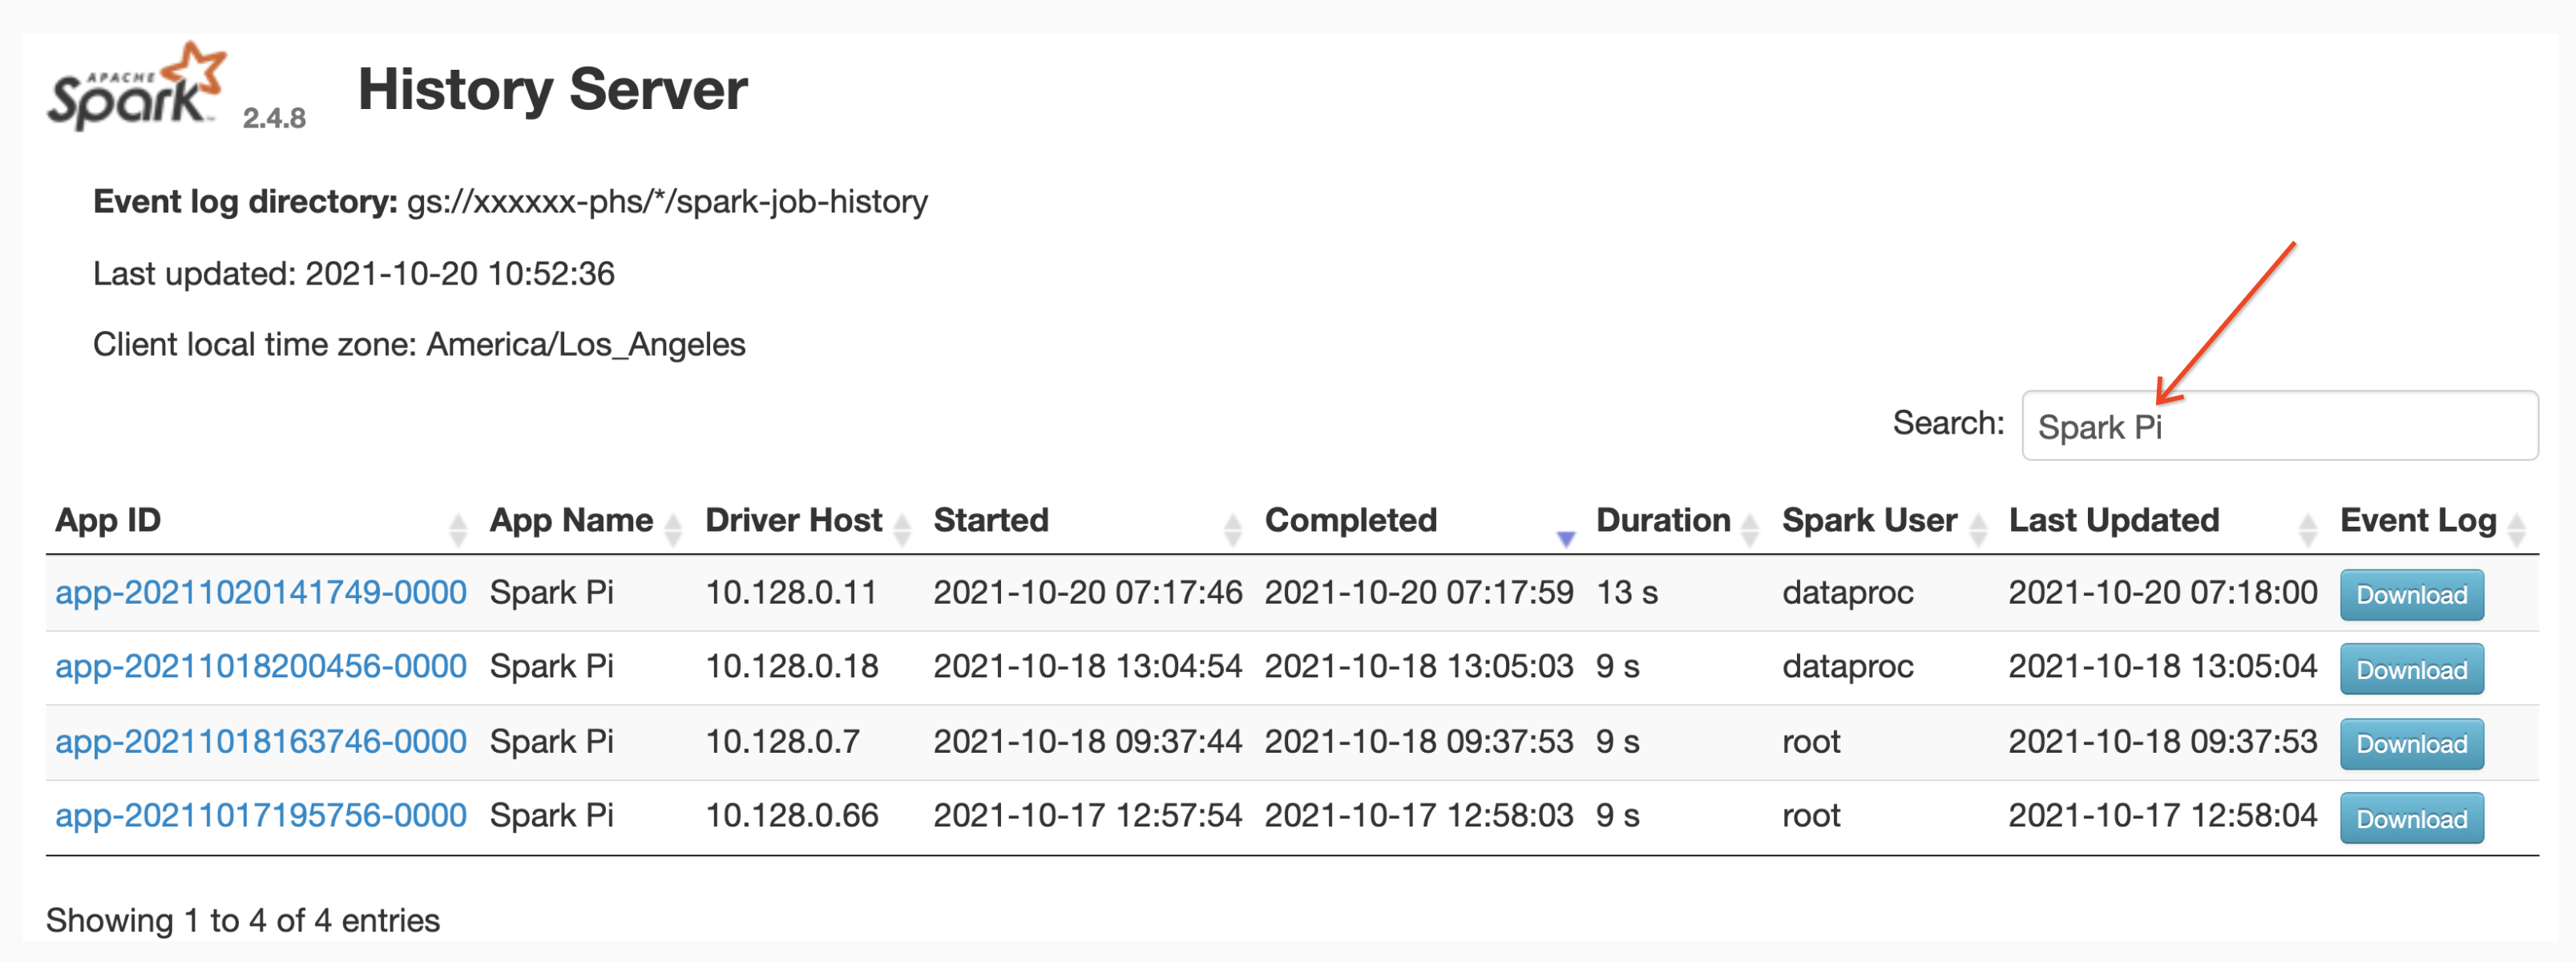
Ricerca per nome dell'app
Puoi elencare i job per nome dell'app nell'interfaccia web del server di cronologia Spark inserendo un nome dell'app nella casella di ricerca. Il nome dell'app può essere impostato in uno dei seguenti modi (elencati in ordine di priorità):
- Impostato all'interno del codice dell'applicazione durante la creazione del contesto Spark
- Impostato dalla proprietà spark.app.name quando il job viene inviato
- Impostato dal servizio gestito per Apache Spark sul nome completo della risorsa REST per il job (
projects/project-id/regions/region/jobs/job-id)
Gli utenti possono inserire il nome di un'app o di una risorsa nella casella Cerca per trovare ed elencare i job.
Log eventi
L'interfaccia web del server di cronologia Spark fornisce un pulsante Log eventi su cui puoi fare clic per scaricare i log eventi Spark. Questi log sono utili per esaminare il ciclo di vita dell'applicazione Spark.
Job Spark
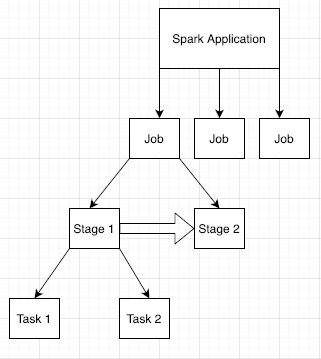
Le applicazioni Spark sono suddivise in più job, che a loro volta sono suddivisi in più fasi. Ogni fase può avere più attività, che vengono eseguite sui nodi esecutori (worker).
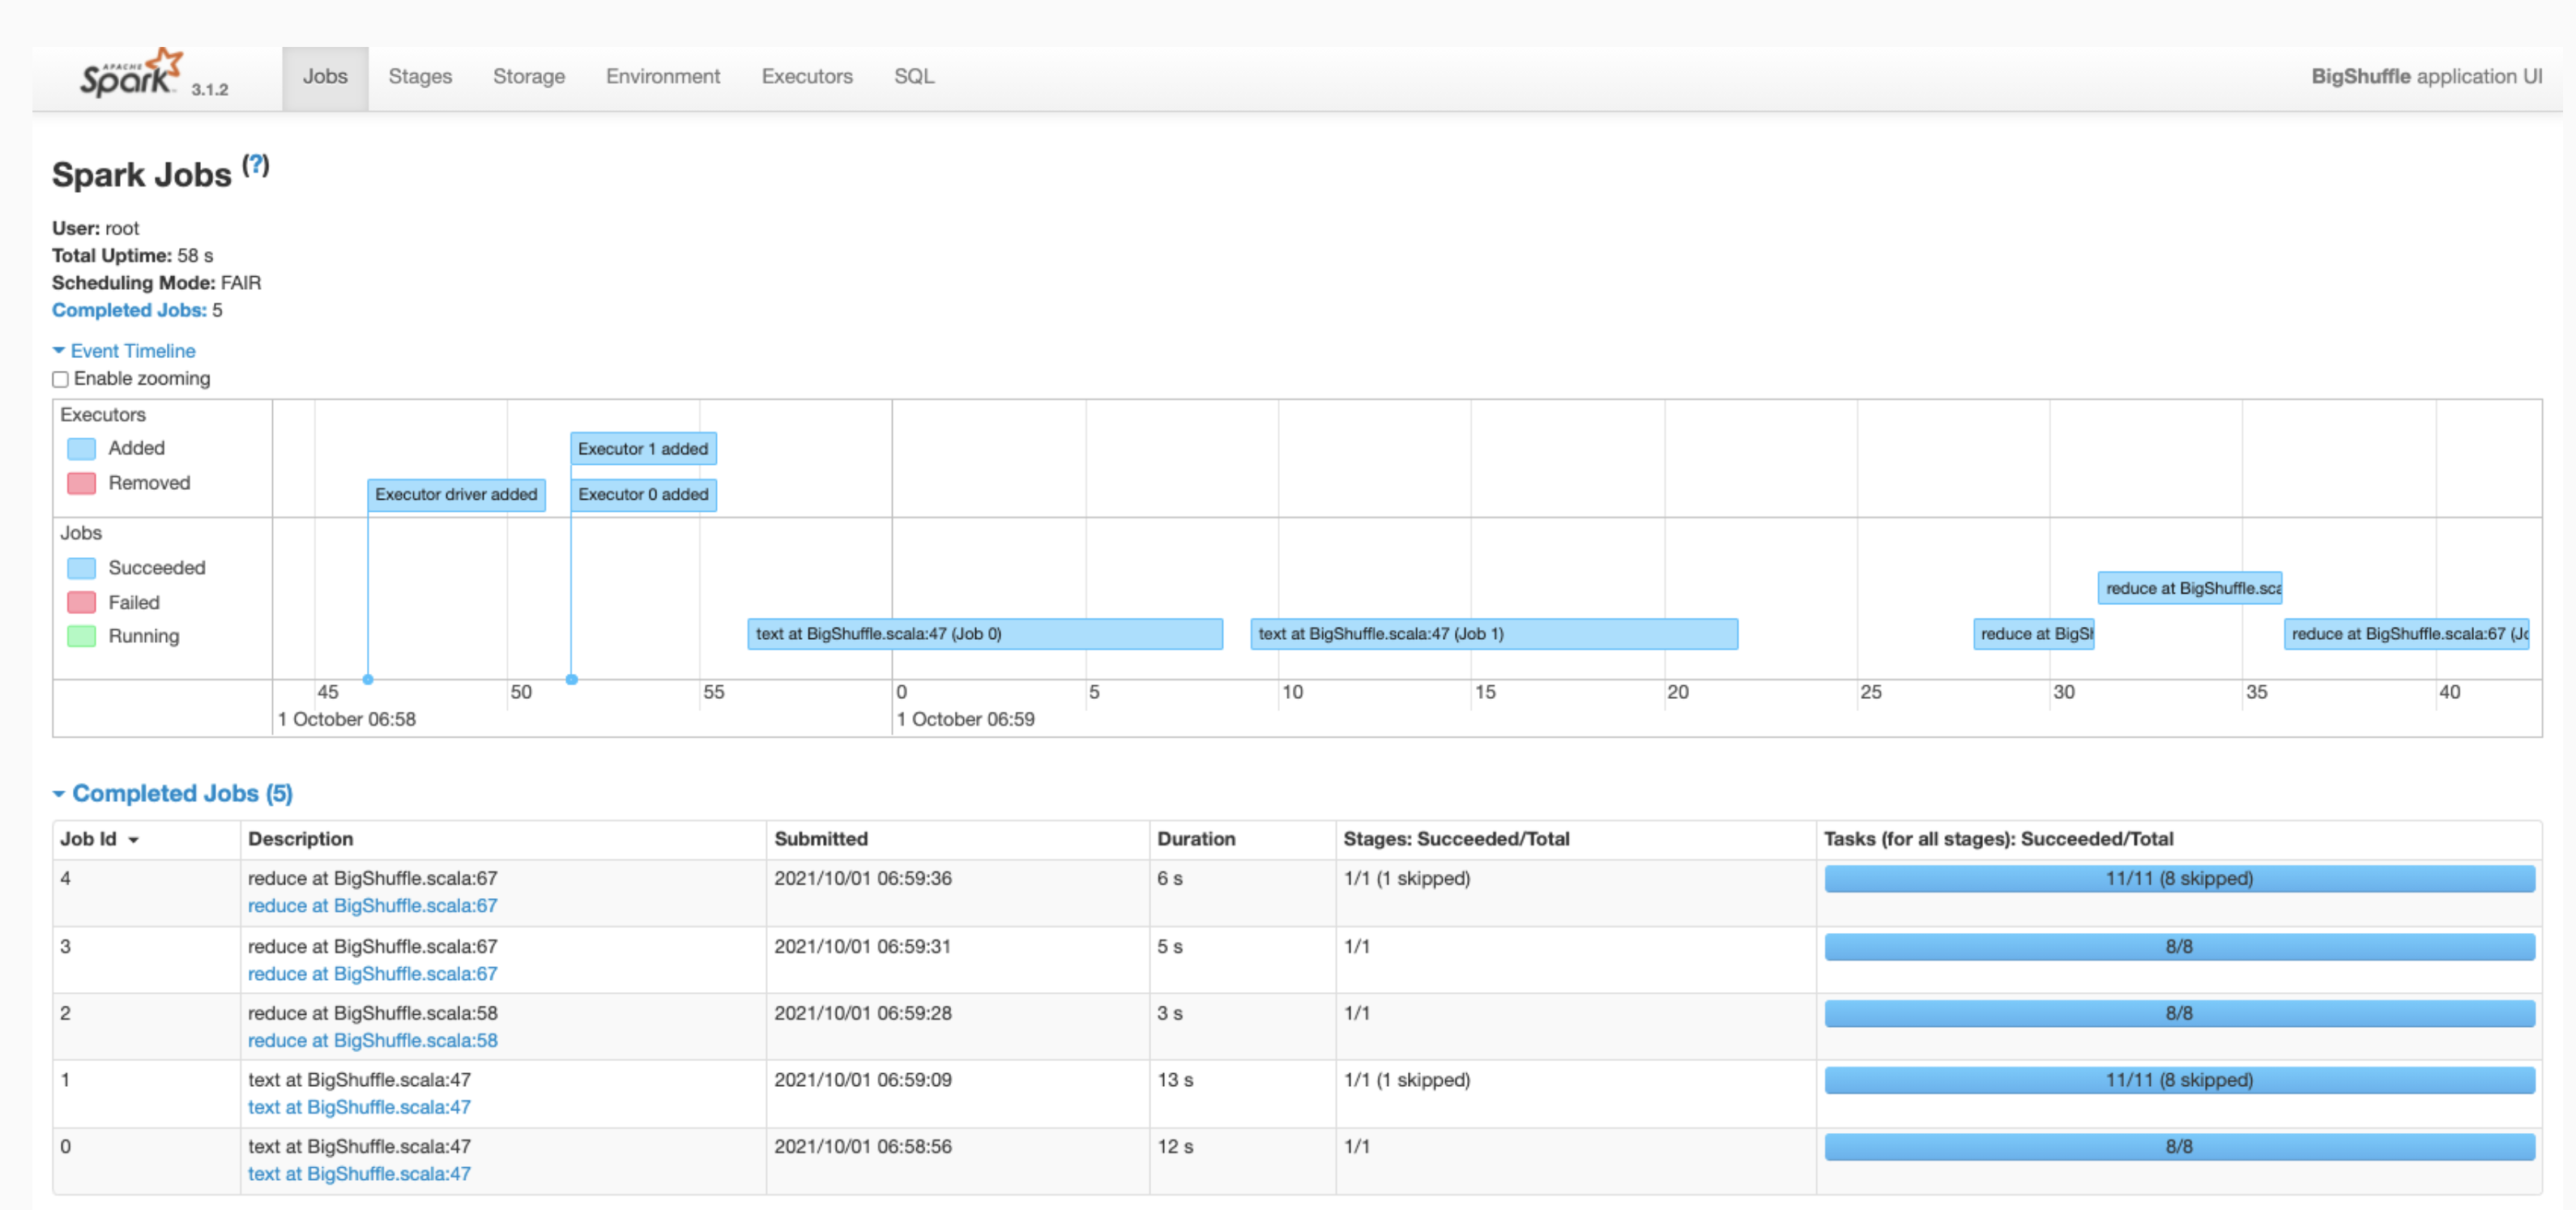
Fai clic su un ID applicazione Spark nell'interfaccia web per aprire la pagina Job Spark, che fornisce una cronologia degli eventi e un riepilogo dei job all'interno dell'applicazione.
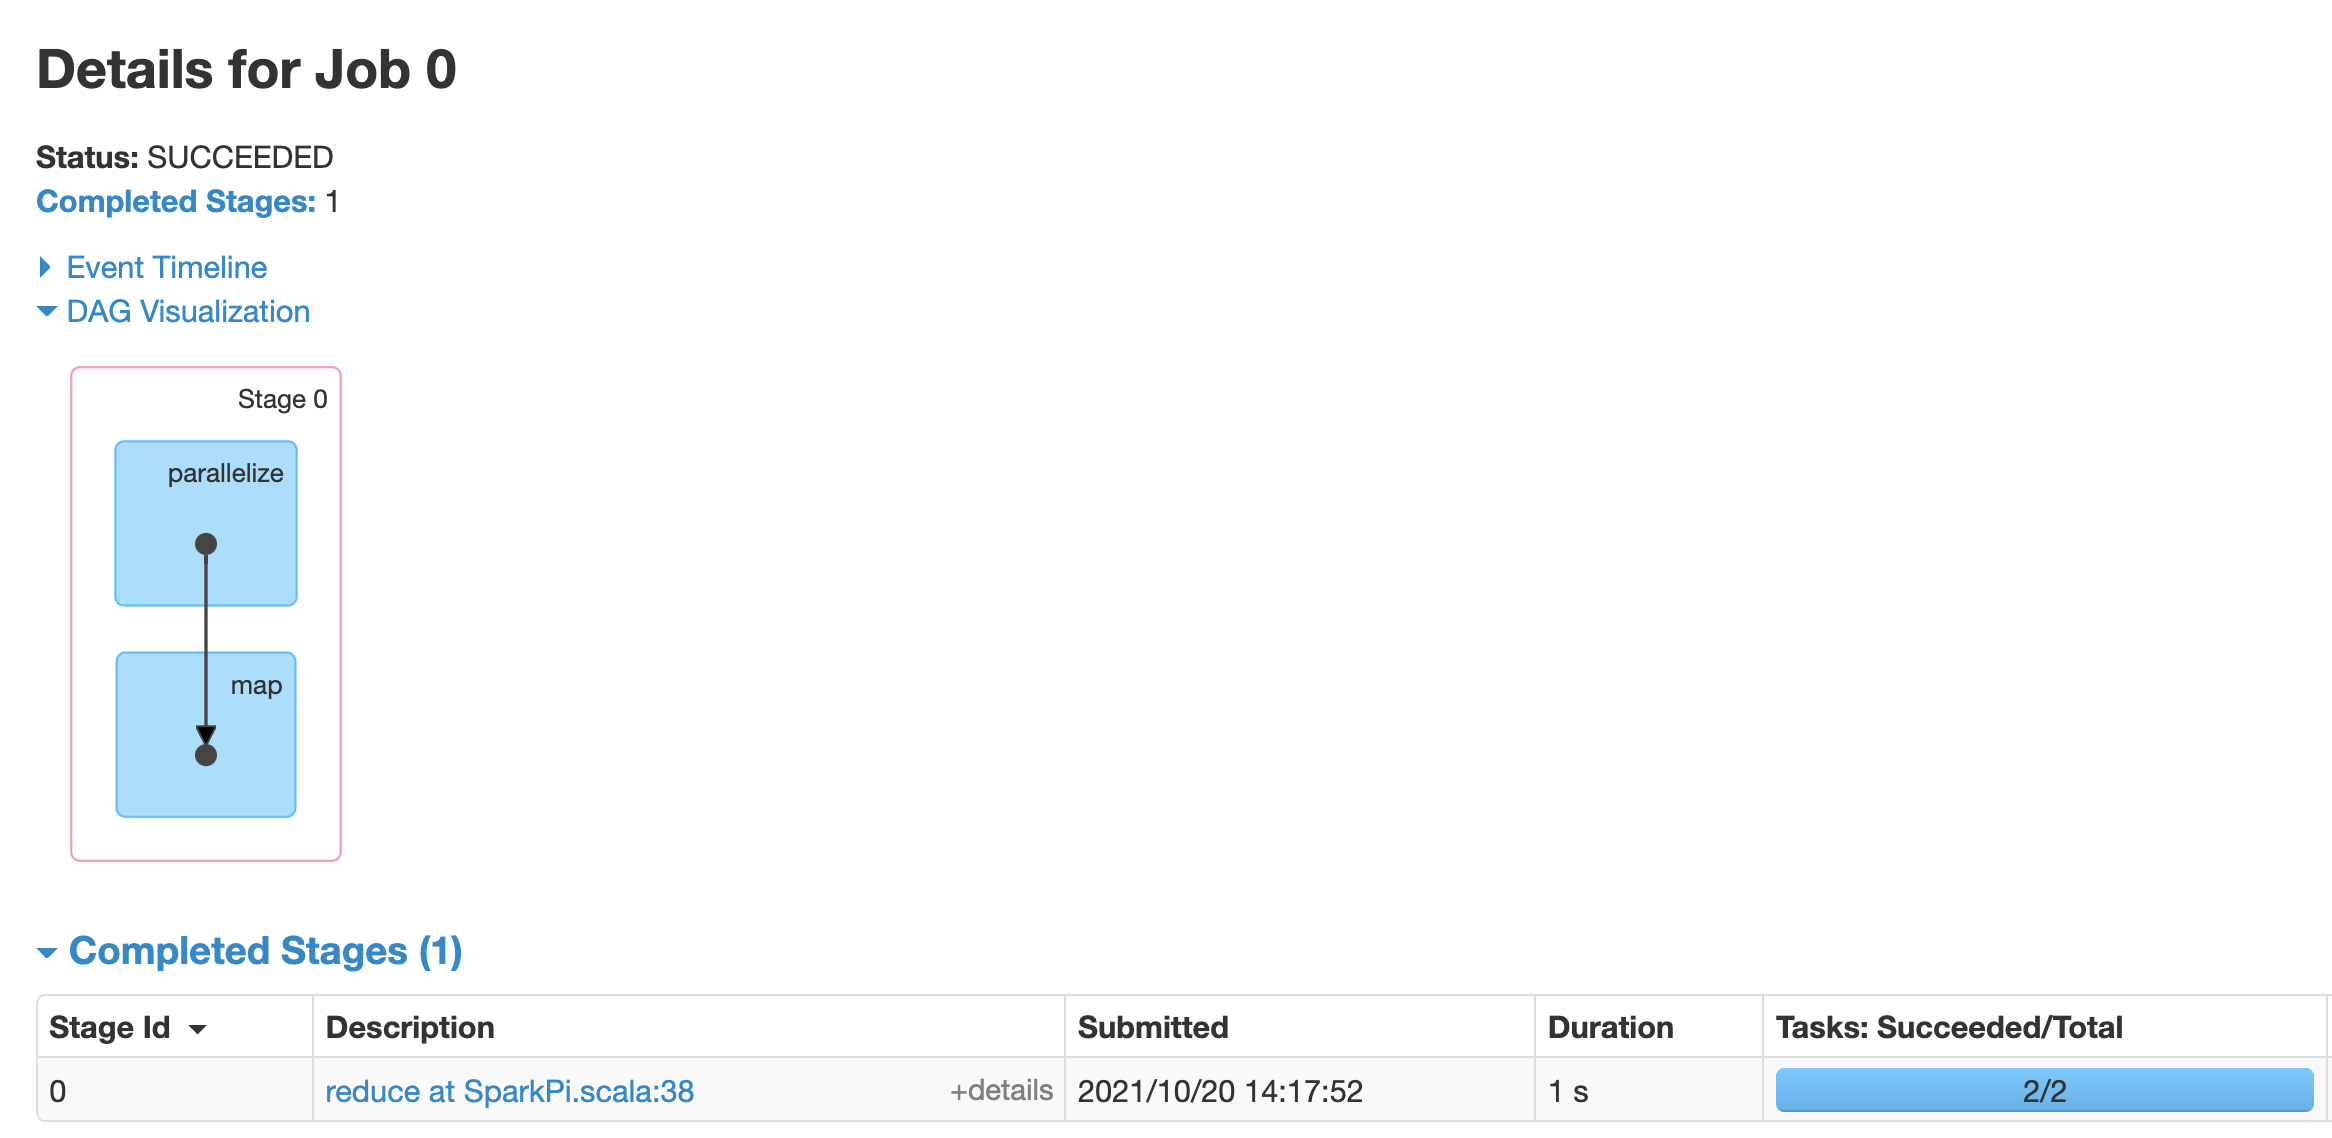
Fai clic su un job per aprire una pagina dei dettagli del job con un grafo diretto aciclico (DAG) e un riepilogo delle fasi del job.
Fai clic su una fase o utilizza la scheda Fasi per selezionare una fase e aprire la pagina dei dettagli della fase.
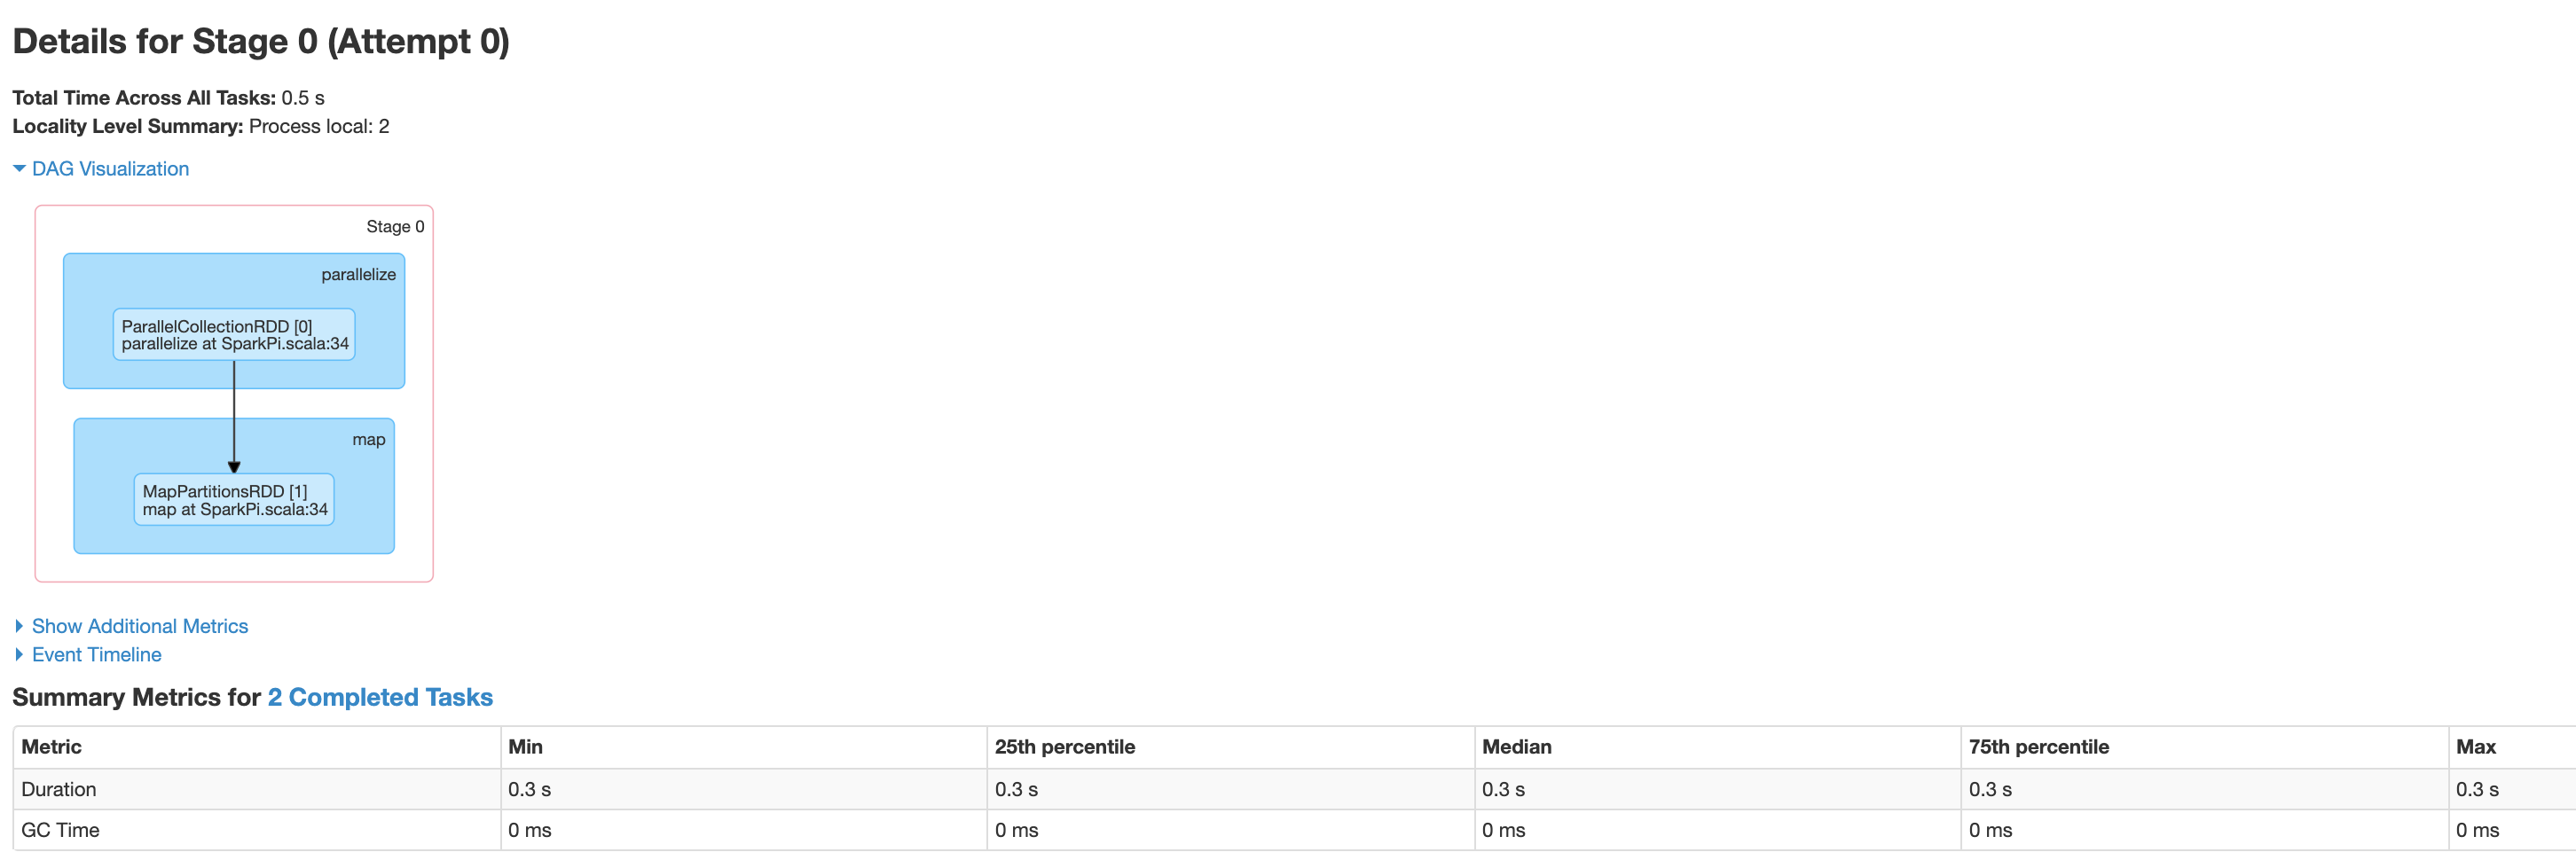
Dettagli fase include una visualizzazione DAG, una cronologia degli eventi e le metriche per le attività all'interno della fase. Puoi utilizzare questa pagina per risolvere i problemi relativi ad attività limitate, ritardi dello scheduler ed errori di memoria esaurita. Il visualizzatore DAG mostra la riga di codice da cui deriva la fase, aiutandoti a risalire ai problemi nel codice.
Fai clic sulla scheda Esecutori per informazioni sui nodi driver ed esecutore dell'applicazione Spark.
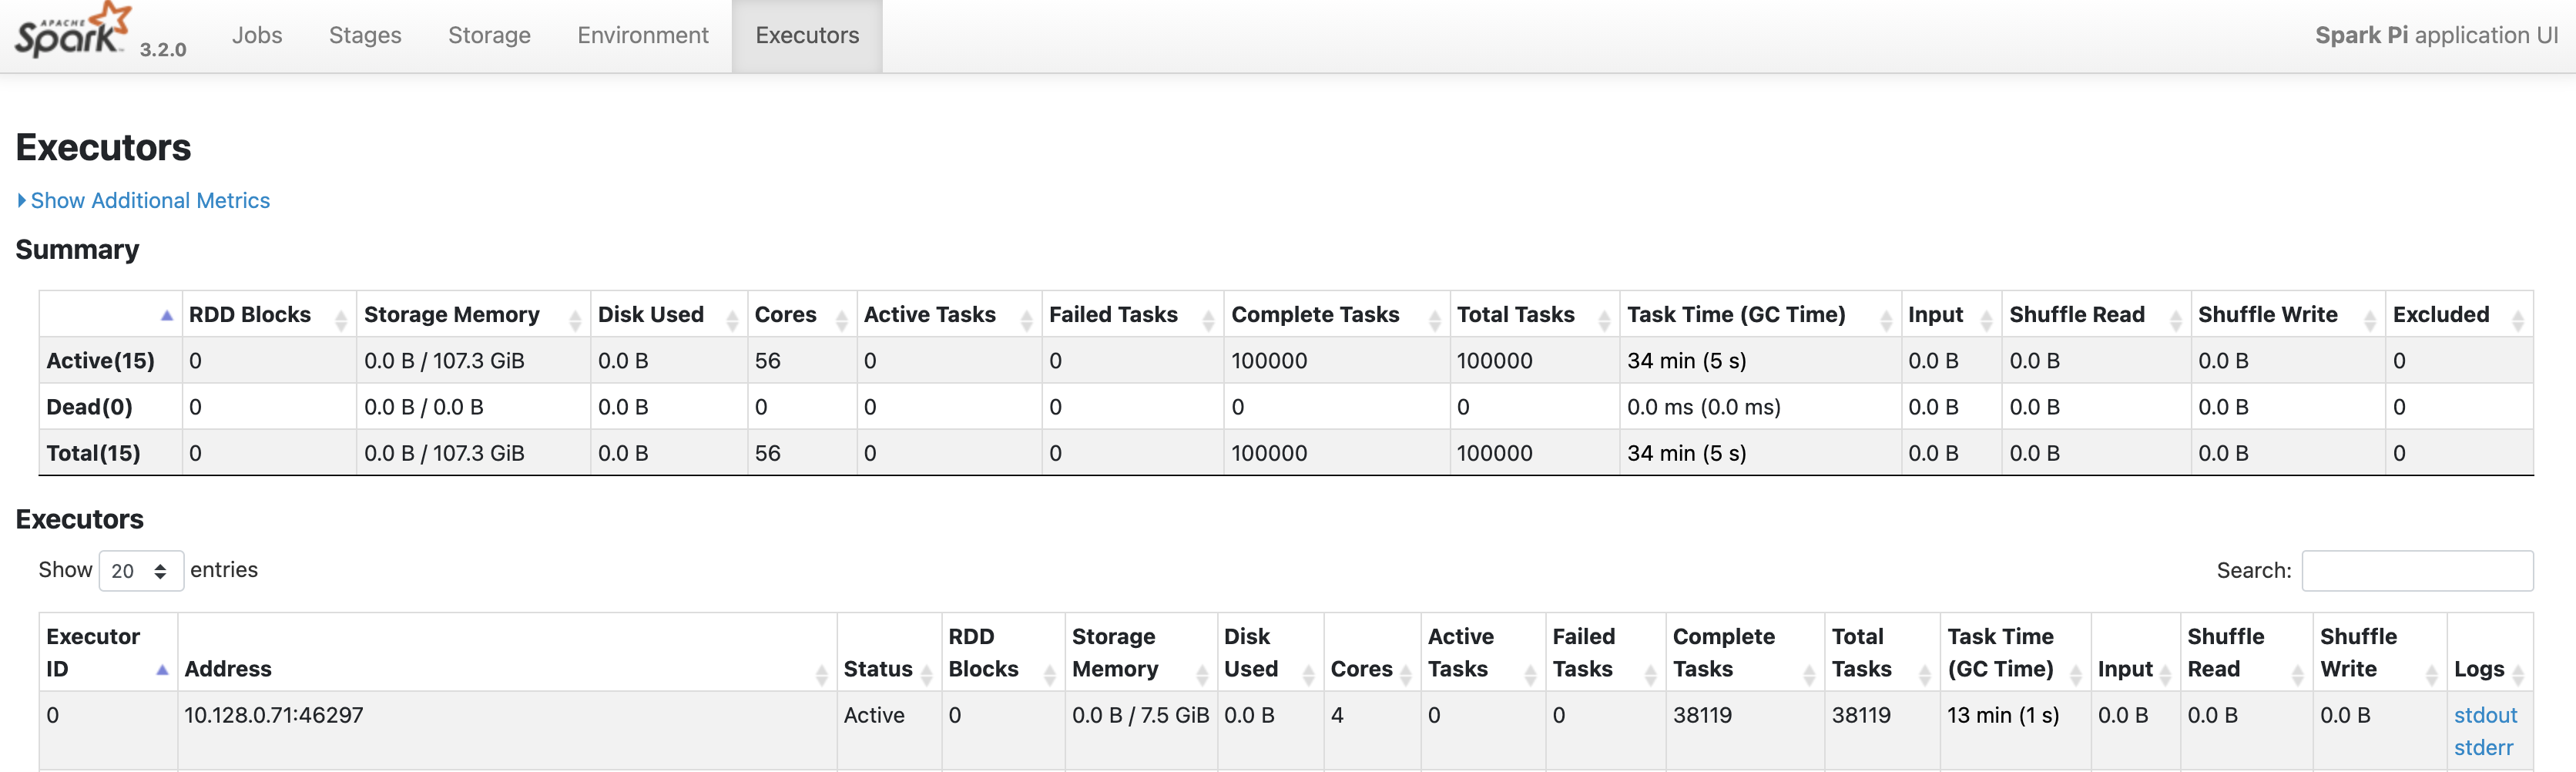
Le informazioni importanti in questa pagina includono il numero di core e il numero di attività eseguite su ciascun esecutore.
Interfaccia web Tez
Tez è il motore di esecuzione predefinito per Hive e Pig su Managed Service for Apache Spark. L'invio di un job Hive su un cluster di job Managed Service for Apache Spark avvia un'applicazione Tez.
Se hai configurato Yarn Timeline Service v2 e impostato la proprietà dataproc:yarn.atsv2.bigtable.instance quando hai creato i cluster di job PHS e Managed Service for Apache Spark, YARN scrive i dati della cronologia dei job Hive e Pig generati nell'istanza Bigtable specificata per il recupero e la visualizzazione nell'interfaccia web Tez in esecuzione sul server PHS.
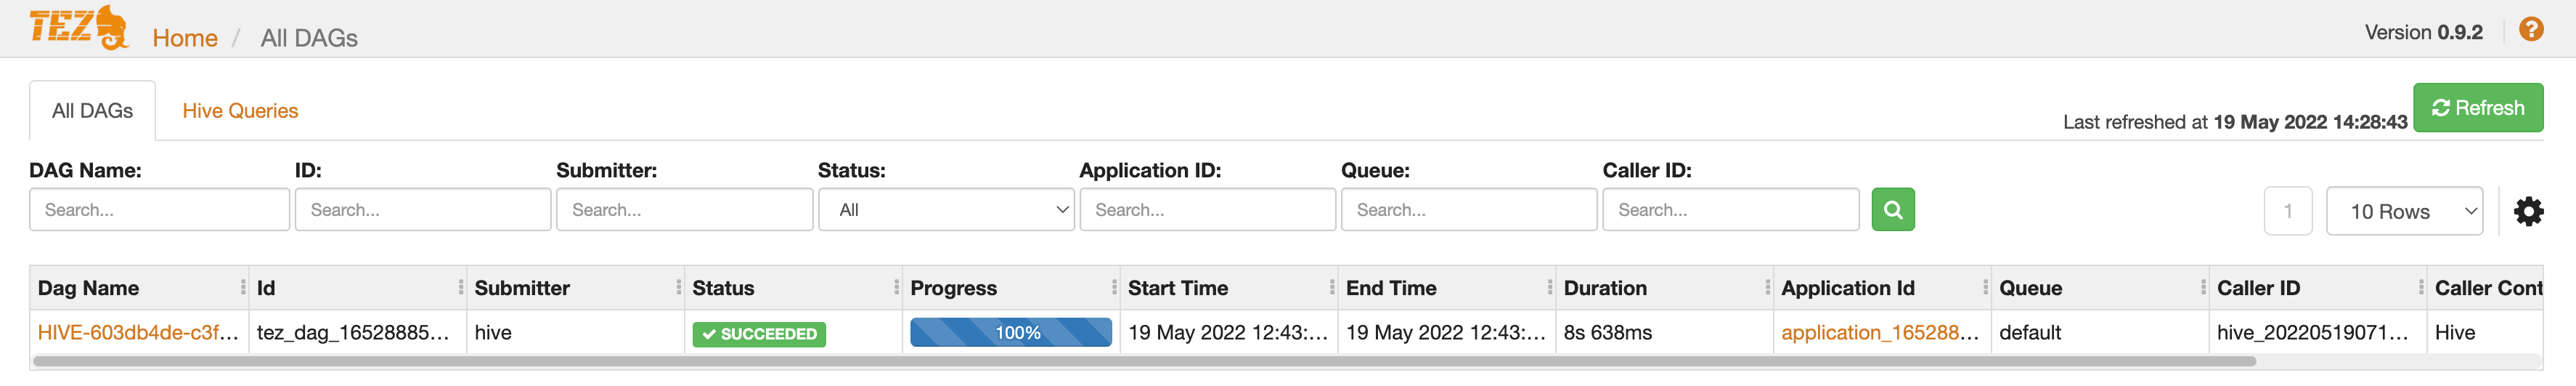
Interfaccia web YARN Application Timeline V2
Se hai configurato Yarn Timeline Service v2 e impostato la proprietà dataproc:yarn.atsv2.bigtable.instance quando hai creato i cluster di job PHS e Managed Service for Apache Spark, YARN scrive i dati della cronologia dei job generati nell'istanza Bigtable specificata per il recupero e la visualizzazione nell'interfaccia web di YARN Application Timeline Service in esecuzione sul server PHS. I job di Managed Service for Apache Spark sono elencati nella scheda Attività flusso nell'interfaccia web.
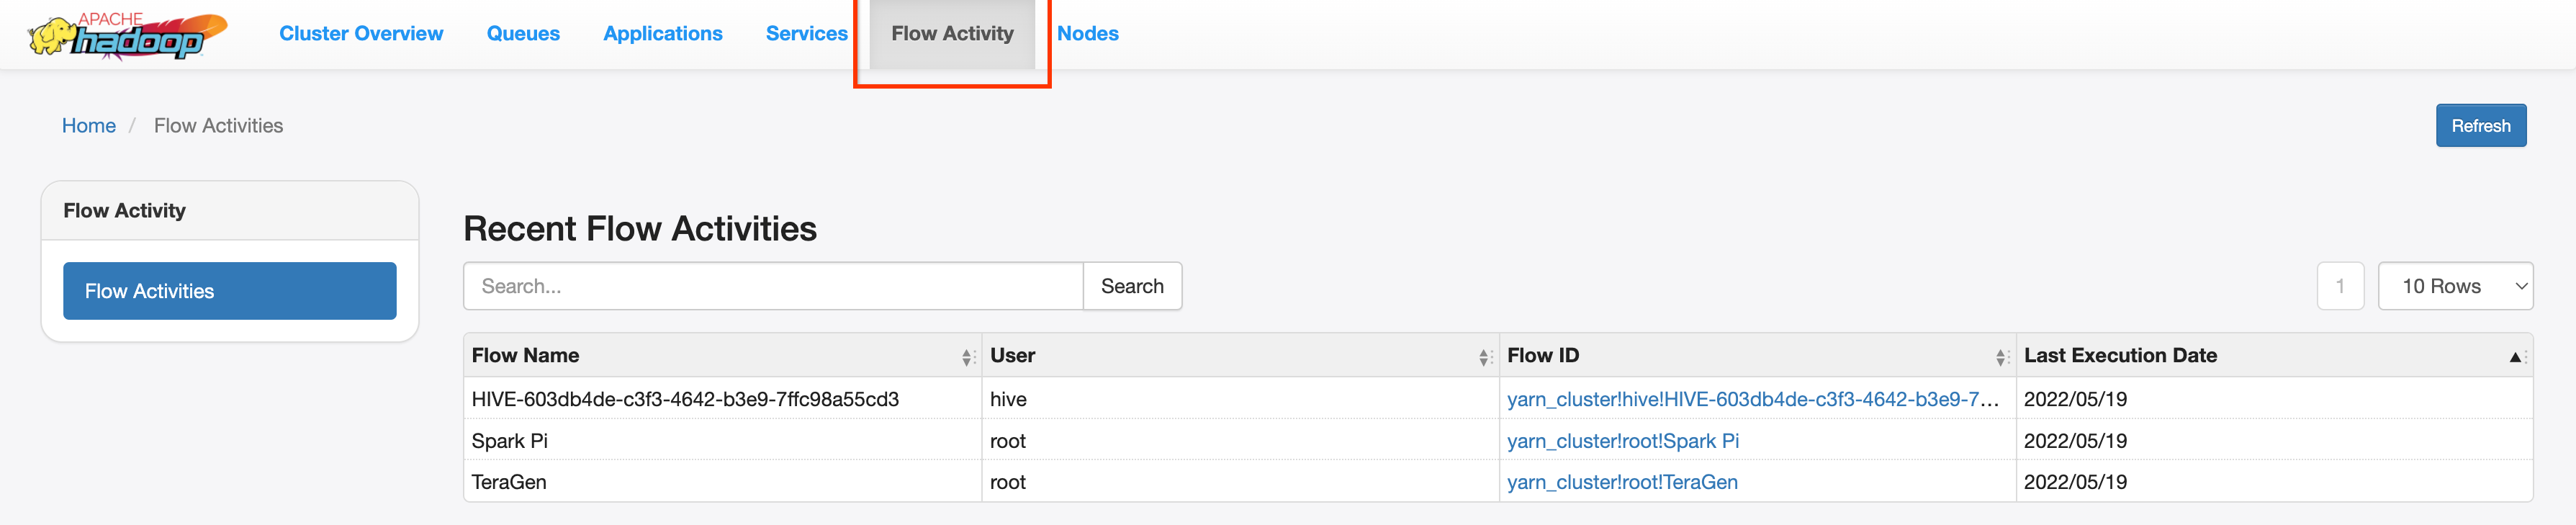
Configura Yarn Timeline Service v2
Per configurare Yarn Timeline Service v2, configura un'istanza Bigtable e, se necessario, controlla i ruoli dei account di servizio come segue:
Se necessario, controlla i ruoli del account di servizio. Il service account VM predefinito utilizzato dalle VM del cluster Dataproc dispone delle autorizzazioni necessarie per creare e configurare l'istanza Bigtable per il servizio di cronologia YARN. Se crei il job o il cluster PHS con un service account VM personalizzato, l'account deve avere il ruolo Bigtable
AdministratoroBigtable User.
Schema della tabella richiesto
Il supporto di Managed Service for Apache Spark PHS per il servizio di cronologia YARN v2 richiede uno schema specifico creato nell'istanza Bigtable. Managed Service for Apache Spark crea lo schema richiesto quando viene creato un cluster di job o un cluster PHS con la proprietà dataproc:yarn.atsv2.bigtable.instance impostata in modo da puntare all'istanza Bigtable.
Di seguito è riportato lo schema dell'istanza Bigtable richiesto:
| Tabelle | Famiglie di colonne |
|---|---|
| prod.timelineservice.application | c,i,m |
| prod.timelineservice.app_flow | m |
| prod.timelineservice.entity | c,i,m |
| prod.timelineservice.flowactivity | i |
| prod.timelineservice.flowrun | i |
| prod.timelineservice.subapplication | c,i,m |
Garbage collection di Bigtable
Puoi configurare la garbage collection di Bigtable in base all'età per le tabelle ATSv2:
Installa cbt, inclusa la creazione di
.cbrtc file.Crea la policy di garbage collection basata sull'età ATSv2:
export NUMBER_OF_DAYS = number \
cbt setgcpolicy prod.timelineservice.application c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.app_flow m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowactivity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowrun i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication m maxage=${NUMBER_OF_DAYS}
Note:
NUMBER_OF_DAYS: il numero massimo di giorni è 30d.