


連線至 Spanner
BigQuery 中的 Spanner 連線可讓使用者即時查詢 Spanner 中的資料,不必將資料複製或移動到 BigQuery。您可以建立 Spanner 連線,並與使用者共用。
事前準備
- 啟用 BigQuery Connection API。
-
如要取得連結 Spanner 所需的權限,請要求管理員授予您專案的 BigQuery 連線管理員 (
roles/bigquery.connectionAdmin) IAM 角色。如要進一步瞭解如何授予角色,請參閱「管理專案、資料夾和組織的存取權」。
建立 Spanner 連線
選取下列選項之一:
控制台
前往「BigQuery」頁面。
在「Explorer」窗格中,點選「 新增資料」。
「新增資料」對話方塊隨即開啟。
在「篩選依據」窗格的「資料來源類型」部分,選取「資料庫」。
或者,您也可以在「Search for data sources」(搜尋資料來源) 欄位中輸入
Spanner。在「精選資料來源」部分,點選「Google Cloud Spanner」。
點選「Google Cloud Spanner:BigQuery 聯盟」解決方案卡片。
在「外部資料來源」窗格,輸入下列資訊:
- 在「連線類型」部分,選取「Cloud Spanner」。
- 在「Connection ID」(連線 ID) 專區中輸入連線資源的 ID。可以使用英文字母、數字和底線。
- 在「Location type」(位置類型) 部分,選取與外部資料來源區域相容的 BigQuery 位置 (或區域)。
- (選用) 在「Friendly name」(好記名稱) 部分,輸入使用者容易使用的連線名稱,例如
My connection resource。這可以是任何值,只要日後需修改時能輕鬆識別即可。 - 選用:在「Description」(說明) 部分,輸入這項連線資源的說明。
- 在「Database name」(資料庫名稱) 部分,按照下列格式輸入 Spanner 資料庫的名稱:
"projects/PROJECT_ID/instances/INSTANCE/databases/DATABASE" - 選用:如要執行並行讀取,請選取「Read data in parallel」(並行讀取資料)。Spanner 可將特定查詢分割成較小的部分或分區,並平行擷取分區。詳情請參閱 Spanner 說明文件的「平行讀取資料」一節。這個選項僅適用於執行計畫中第一個運算子為分散式聯集運算子的查詢。其他查詢則會傳回錯誤。如要查看 Spanner 查詢的查詢執行計畫,請參閱「瞭解 Spanner 如何執行查詢」。
- 選用:在「Database role」(資料庫角色) 中,輸入 Spanner 資料庫角色的名稱。如果不是空白,這項連線預設會使用這個資料庫角色查詢 Spanner。透過這個連線提交查詢的 Spanner 精細的存取控管使用者,必須由系統管理員授予這個角色的存取權,且資料庫角色必須具備外部查詢中指定的所有結構定義物件的
SELECT權限。如要瞭解精細的存取控管機制,請參閱「關於精細的存取控管機制」。 - 選用:如要啟用 Data Boost,請選取「使用 Spanner Data Boost」。Data Boost 可讓您執行數據分析查詢和資料匯出作業,幾乎不會影響佈建的 BigQuery 執行個體上現有的工作負載。如要啟用 Data Boost,請選取「Data Boost」和「平行讀取資料」。
點選「建立連線」。
bq
如要建立連線,請使用 bq mk 指令,並加上 --connection 旗標。
bq mk --connection \
    --connection_type=CLOUD_SPANNER \
    --properties='PROPERTIES' \
    --location=LOCATION \
    --display_name='FRIENDLY_NAME' \
    --description 'DESCRIPTION' \
    CONNECTION_ID
更改下列內容:
PROPERTIES:包含下列欄位的 JSON 物件:"database":連線的 Spanner 資料庫請以字串形式指定,格式如下:
"projects/PROJECT_ID/instances/INSTANCE/databases/DATABASE"。"use_parallelism":(選用) 如果為true,這個連線會執行平行讀取預設值為
false。Spanner 可將特定查詢分成較小的部分或分區,並平行擷取這些分區。詳情請參閱 Spanner 說明文件的「平行讀取資料」一節。這個選項僅適用於執行計畫中第一個運算子為分散式聯集運算子的查詢。其他查詢則會傳回錯誤。如要查看 Spanner 查詢的查詢執行計畫,請參閱「瞭解 Spanner 如何執行查詢」。"database_role":(選用) 如果不是空白,這項連線預設會使用這個資料庫角色查詢 Spanner。透過這個連線提交查詢的 Spanner FGAC 使用者,必須由管理員授予這個角色的存取權,且資料庫角色必須具備外部查詢中指定的所有結構定義物件SELECT權限。如未指定,連線會使用 Spanner 的 IAM 預先定義角色進行驗證,且使用這項連線執行查詢的主體,必須已獲派
roles/spanner.databaseReaderIAM 角色。如要瞭解精細的存取控管,請參閱「關於精細的存取控管」。
"useDataBoost":(選用) 如果是true,使用者可以透過這個連線使用 Data Boost。Data Boost 可讓使用者在獨立的運算資源中執行聯合查詢,與佈建的執行個體分開,避免影響現有的工作負載。如要啟用 Data Boost,請將"useDataBoost"設為true,並將"use_parallelism"設為true。如要使用 Data Boost,透過這個連線執行查詢的主體必須具備
spanner.databases.useDataBoost權限。roles/spanner.admin和roles/spanner.databaseAdmin角色預設具備這項權限。
LOCATION:與外部資料來源區域相容的 BigQuery 位置。CONNECTION_ID:連線資源的 ID連線 ID 只能使用英文字母、數字和底線。如未提供連線 ID,BigQuery 會自動產生專屬 ID。
以下範例會建立名為
my_connection_id的新連線資源。bq mk --connection \ --connection_type='CLOUD_SPANNER' \ --properties='{"database":"projects/my_project/instances/my_instance/databases/database1"}' \ --project_id=federation-test \ --location=us \ my_connection_id
API
在 ConnectionService 服務中呼叫 CreateConnection 方法。
與使用者共用連線
您可以授予下列角色,讓使用者查詢資料及管理連結:
roles/bigquery.connectionUser:可讓使用者透過連線,連至外部資料來源並執行查詢。roles/bigquery.connectionAdmin:可讓使用者管理連線。
如要進一步瞭解 BigQuery 的 IAM 角色和權限,請參閱「預先定義的角色和權限」。
選取下列選項之一:
控制台
前往「BigQuery」頁面。
連線會列在專案的「連線」群組中。
點選左側窗格中的 「Explorer」。
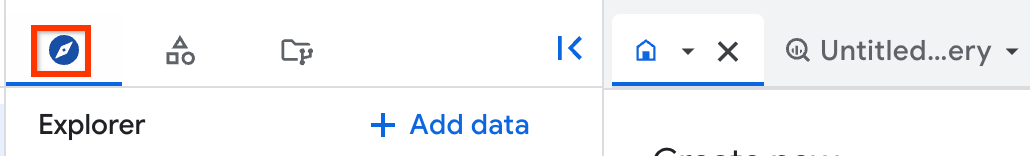
如果沒有看到左側窗格,請按一下 「Expand left pane」(展開左側窗格),開啟窗格。
依序點選專案和「連線」,然後選取連線。
在「詳細資料」窗格中,按一下「共用」即可共用連線。接著,按照下列步驟操作:
在「Connection permissions」(連線權限) 對話方塊中,新增或編輯主體,與其他主體共用連線。
按一下 [儲存]。
bq
您無法使用 bq 指令列工具共用連線。如要共用連線,請使用 Google Cloud 控制台或 BigQuery Connections API 方法。
API
使用 BigQuery Connections REST API 參考資料部分的 projects.locations.connections.setIAM 方法,並提供 policy 資源的執行個體。
Java
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Java 設定操作說明進行操作。詳情請參閱 BigQuery Java API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
後續步驟
- 瞭解不同的連線類型。
- 瞭解如何管理連結。
- 瞭解聯合查詢。
- 瞭解如何查詢 Spanner 資料。