


במדריך הזה תלמדו איך להשתמש במודל של סדרת זמנים עם כמה משתנים כדי לחזות את הערך העתידי של עמודה נתונה, על סמך הערך ההיסטורי של כמה מאפייני קלט.
במדריך הזה נחזה כמה סדרות זמנים. ערכי התחזית מחושבים לכל נקודת זמן, לכל ערך בעמודה אחת או יותר שצוינו. לדוגמה, אם רוצים לחזות את מזג האוויר ומציינים עמודה שמכילה נתונים של מדינה, הנתונים החזויים יכילו תחזיות לכל נקודות הזמן של מדינה א', ואז ערכים חזויים לכל נקודות הזמן של מדינה ב' וכן הלאה. אם אתם רוצים לחזות את מזג האוויר וציינתם עמודות שמכילות נתונים של מדינה ועיר, הנתונים החזויים יכילו תחזיות לכל נקודות הזמן של מדינה א' ועיר א', ואז ערכים חזויים לכל נקודות הזמן של מדינה א' ועיר ב', וכן הלאה.
במדריך הזה משתמשים בנתונים מהטבלאות הציבוריות bigquery-public-data.iowa_liquor_sales.sales ו-bigquery-public-data.covid19_weathersource_com.postal_code_day_history. הטבלה bigquery-public-data.iowa_liquor_sales.sales מכילה נתוני מכירות של משקאות חריפים שנאספו מכמה ערים במדינת איווה. הטבלה bigquery-public-data.covid19_weathersource_com.postal_code_day_history מכילה נתוני מזג אוויר היסטוריים, כמו טמפרטורה ולחות, מרחבי העולם.
לפני שתקראו את המדריך הזה, מומלץ מאוד לקרוא את המאמר חיזוי של סדרת זמנים אחת באמצעות מודל רב-משתני.
מטרות
במדריך הזה מוסבר איך לבצע את הפעולות הבאות:
- יצירת מודל של סדרת זמנים כדי לחזות הזמנות של חנות משקאות באמצעות ההצהרה
CREATE MODEL. - אחזור ערכי ההזמנות החזויים מהמודל באמצעות הפונקציה
ML.FORECAST. - אחזור רכיבים של סדרת הזמן, כמו עונתיות, מגמה ושיוך תכונות, באמצעות הפונקציה
ML.EXPLAIN_FORECAST. אפשר לבדוק את הרכיבים האלה של סדרת הזמן כדי להסביר את הערכים החזויים. - מעריכים את הדיוק של המודל באמצעות הפונקציה
ML.EVALUATE. - מזהים חריגות באמצעות המודל עם הפונקציה
ML.DETECT_ANOMALIES.
עלויות
במדריך הזה משתמשים ברכיבים של Google Cloudשהשימוש בהם כרוך בתשלום, כולל:
- BigQuery
- BigQuery ML
למידע נוסף על העלויות של BigQuery, קראו את הדף תמחור ב-BigQuery.
לפני שמתחילים
- נכנסים לחשבון Google Cloud . אנחנו ממליצים למשתמשים חדשים ב- Google Cloud ליצור חשבון כדי שיוכלו להעריך את הביצועים של המוצרים שלנו בתרחישים מהעולם האמיתי. לקוחות חדשים מקבלים בחינם גם קרדיט בשווי 300$ להרצה, לבדיקה ולפריסה של עומסי העבודה.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
- BigQuery מופעל באופן אוטומטי בפרויקטים חדשים.
כדי להפעיל את BigQuery בפרויקט קיים, עוברים אל
מפעילים את BigQuery API, אם הוא עדיין לא מופעל.
התפקידים שנדרשים כדי להפעיל ממשקי API
כדי להפעיל ממשקי API, צריך את ההרשאה
serviceusage.services.enable. אם אתם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד "בעלים" (roles/owner). אחרת, אתם יכולים לקבל את ההרשאה הזו דרך התפקיד "אדמין בממשק 'שימוש בשירות'" (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידים?
יצירת קבוצת נתונים
כדי ליצור מערך נתונים ב-BigQuery, בוחרים אחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery במסוף Google Cloud .
בחלונית הימנית, לוחצים על Explorer:
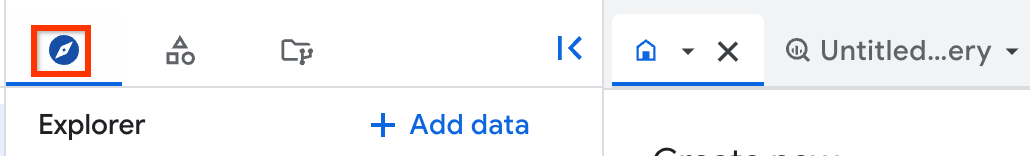
אם החלונית הימנית לא מוצגת, לוחצים על Expand left pane כדי לפתוח אותה.
ב-Explorer, מרחיבים את הפרויקט ולוחצים על Datasets.
בדף Datasets, לוחצים על Create dataset.
בחלונית Create dataset:
בשדה Dataset ID, מזינים
bqml_tutorial.בקטע Data location (מיקום הנתונים), בוחרים באפשרות US (ארה"ב).
משאירים את שאר הגדרות ברירת המחדל כמו שהן.
לוחצים על Create dataset.
BQ
כדי ליצור קבוצת נתונים חדשה, משתמשים בפקודה bq mk --dataset.
יוצרים מערך נתונים בשם
bqml_tutorialומגדירים את מיקום הנתונים ל-US:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
מוודאים שמערך הנתונים נוצר:
bq ls
API
מפעילים את השיטה datasets.insert עם משאב של מערך נתונים מוגדר:
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
יצירת טבלה של נתוני קלט
יוצרים טבלת נתונים שאפשר להשתמש בה כדי לאמן ולהעריך את המודל. הטבלה הזו משלבת עמודות מהטבלאות bigquery-public-data.iowa_liquor_sales.sales ו-bigquery-public-data.covid19_weathersource_com.postal_code_day_history כדי לנתח איך מזג האוויר משפיע על הסוג והמספר של הפריטים שהוזמנו על ידי חנויות משקאות. אתם יוצרים גם את העמודות הנוספות הבאות, שאפשר להשתמש בהן כמשתני קלט למודל:
-
date: תאריך ההזמנה -
store_number: המספר הייחודי של החנות שבה בוצעה ההזמנה -
item_number: המספר הייחודי של הפריט שהוזמן -
bottles_sold: מספר הבקבוקים שהוזמנו מהפריט המשויך -
temperature: הטמפרטורה הממוצעת במיקום החנות בתאריך ההזמנה -
humidity: הלחות הממוצעת במיקום החנות בתאריך ההזמנה
כדי ליצור את טבלת נתוני הקלט:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מדביקים את השאילתה הבאה ולוחצים על Run:
CREATE OR REPLACE TABLE
  `bqml_tutorial.iowa_liquor_sales_with_weather` AS
WITH
  sales AS (
    SELECT
      DATE,
      store_number,
      item_number,
      bottles_sold,
      SAFE_CAST(SAFE_CAST(zip_code AS FLOAT64) AS INT64) AS zip_code
    FROM
      `bigquery-public-data.iowa_liquor_sales.sales` AS sales
    WHERE
      SAFE_CAST(zip_code AS FLOAT64) IS NOT NULL
  ),
  aggregated_sales AS (
    SELECT
      DATE,
      store_number,
      item_number,
      ANY_VALUE(zip_code) AS zip_code,
      SUM(bottles_sold) AS bottles_sold,
    FROM
      sales
    GROUP BY
      DATE,
      store_number,
      item_number
  ),
  weather AS (
    SELECT
      DATE,
      SAFE_CAST(postal_code AS INT64) AS zip_code,
      avg_temperature_air_2m_f AS temperature,
      avg_humidity_specific_2m_gpkg AS humidity,
    FROM
      `bigquery-public-data.covid19_weathersource_com.postal_code_day_history`
    WHERE
      country = 'US' AND
      SAFE_CAST(postal_code AS INT64) IS NOT NULL
  )
SELECT
  aggregated_sales.date,
  aggregated_sales.store_number,
  aggregated_sales.item_number,
  aggregated_sales.bottles_sold,
  weather.temperature AS temperature,
  weather.humidity AS humidity
FROM
  aggregated_sales
  LEFT JOIN weather ON aggregated_sales.zip_code=weather.zip_code
  AND aggregated_sales.DATE=weather.DATE;
יצירת המודל של סדרת הזמנים
צרו מודל של סדרת זמנים כדי לחזות את מספר הבקבוקים שנמכרו לכל שילוב של מזהה חנות ומזהה פריט, לכל תאריך בטבלה bqml_tutorial.iowa_liquor_sales_with_weather לפני 1 בספטמבר 2022. משתמשים בטמפרטורה ובלחות הממוצעות במיקום החנות בכל תאריך כמאפיינים להערכה במהלך החיזוי. בטבלה bqml_tutorial.iowa_liquor_sales_with_weather יש כמיליון שילובים שונים של מספר פריט ומספר חנות, כלומר יש מיליון סדרות זמנים שונות לחיזוי.
כדי ליצור את המודל:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מדביקים את השאילתה הבאה ולוחצים על Run:
CREATE
OR REPLACE MODEL `bqml_tutorial.multi_time_series_arimax_model`
OPTIONS(
  model_type = 'ARIMA_PLUS_XREG',
  time_series_id_col = ['store_number', 'item_number'],
  time_series_data_col = 'bottles_sold',
  time_series_timestamp_col = 'date'
)
AS SELECT
  *
FROM
  `bqml_tutorial.iowa_liquor_sales_with_weather`
WHERE
  DATE < DATE('2022-09-01');
השאילתה מסתיימת תוך כ-38 דקות, ואז אפשר לגשת למודל
multi_time_series_arimax_model. השאילתה משתמשת בהצהרהCREATE MODELכדי ליצור מודל, ולכן לא מוצגות תוצאות שאילתה.
שימוש במודל לחיזוי נתונים
חיזוי ערכים עתידיים של סדרות זמנים באמצעות הפונקציה ML.FORECAST.
בשאילתת GoogleSQL הבאה, המשפט STRUCT(5 AS horizon, 0.8 AS confidence_level) מציין שהשאילתה חוזה 5 נקודות זמן עתידיות, ויוצרת מרווח חיזוי עם רמת סמך של 80%.
חתימת הנתונים של נתוני הקלט של הפונקציה ML.FORECAST זהה לחתימת הנתונים של נתוני האימון ששימשו ליצירת המודל. העמודה bottles_sold לא נכללת בקלט, כי אלה הנתונים שהמודל מנסה לחזות.
כדי לחזות נתונים באמצעות המודל, פועלים לפי השלבים הבאים:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מדביקים את השאילתה הבאה ולוחצים על Run:
SELECT
  *
FROM
  ML.FORECAST (
    model `bqml_tutorial.multi_time_series_arimax_model`,
    STRUCT (5 AS horizon, 0.8 AS confidence_level),
    (
      SELECT
        * EXCEPT (bottles_sold)
      FROM
        `bqml_tutorial.iowa_liquor_sales_with_weather`
      WHERE
        DATE>=DATE('2022-09-01')
    )
  );
התוצאות אמורות להיראות כך:

שורות הפלט מסודרות לפי הערך
store_number, אחר כך לפי הערךitem_ID, ואז בסדר כרונולוגי לפי הערך בעמודהforecast_timestamp. בחיזוי של סדרת זמנים, מרווח החיזוי, שמיוצג על ידי ערכי העמודותprediction_interval_lower_boundו-prediction_interval_upper_bound, חשוב כמו ערך העמודהforecast_value. הערךforecast_valueהוא נקודת האמצע של מרווח החיזוי. מרווח החיזוי תלוי בערכים של העמודותstandard_errorו-confidence_level.למידע נוסף על עמודות הפלט, ראו
ML.FORECAST.
הסבר על תוצאות התחזית
כדי לקבל מדדי הסבר בנוסף לנתוני התחזית, אפשר להשתמש בפונקציה ML.EXPLAIN_FORECAST. הפונקציה ML.EXPLAIN_FORECAST חוזה ערכים עתידיים של סדרות זמנים, וגם מחזירה את כל הרכיבים הנפרדים של סדרות הזמנים.
בדומה לפונקציה ML.FORECAST, הסעיף STRUCT(5 AS horizon, 0.8 AS confidence_level) שמשמש בפונקציה ML.EXPLAIN_FORECAST מציין שהשאילתה חוזה 30 נקודות זמן עתידיות ויוצרת רווח בר-סמך של 80% לחיזוי.
הפונקציה ML.EXPLAIN_FORECAST מספקת גם נתונים היסטוריים וגם נתוני תחזית. כדי לראות רק את נתוני התחזית, מוסיפים את האפשרות time_series_type לשאילתה ומציינים את הערך forecast.
כדי להסביר את תוצאות המודל:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מדביקים את השאילתה הבאה ולוחצים על Run:
SELECT
  *
FROM
  ML.EXPLAIN_FORECAST (
    model `bqml_tutorial.multi_time_series_arimax_model`,
    STRUCT (5 AS horizon, 0.8 AS confidence_level),
    (
      SELECT
        * EXCEPT (bottles_sold)
      FROM
        `bqml_tutorial.iowa_liquor_sales_with_weather`
      WHERE
        DATE >= DATE('2022-09-01')
    )
  );
התוצאות אמורות להיראות כך:


שורות הפלט מסודרות בסדר כרונולוגי לפי הערך בעמודה
time_series_timestamp.למידע נוסף על עמודות הפלט, ראו
ML.EXPLAIN_FORECAST.
הערכת הדיוק של התחזיות
כדי להעריך את דיוק החיזוי של המודל, מריצים אותו על נתונים שהמודל לא אומן עליהם. כדי לעשות את זה, משתמשים בפונקציה ML.EVALUATE. הפונקציה ML.EVALUATE מעריכה כל סדרה עתית בנפרד.
בשאילתת GoogleSQL הבאה, ההצהרה השנייה של SELECT מספקת את הנתונים עם המאפיינים העתידיים, שמשמשים לחיזוי הערכים העתידיים להשוואה עם הנתונים בפועל.
כדי להעריך את רמת הדיוק של המודל:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מדביקים את השאילתה הבאה ולוחצים על Run:
SELECT
  *
FROM
  ML.EVALUATE (
    model `bqml_tutorial.multi_time_series_arimax_model`,
    (
      SELECT
        *
      FROM
       `bqml_tutorial.iowa_liquor_sales_with_weather`
      WHERE
        DATE >= DATE('2022-09-01')
    )
  );
התוצאות אמורות להיראות כך:

למידע נוסף על עמודות הפלט, ראו
ML.EVALUATE.
שימוש במודל לזיהוי אנומליות
מזהים חריגות בנתוני האימון באמצעות הפונקציה ML.DETECT_ANOMALIES.
בשאילתה הבאה, הסעיף STRUCT(0.95 AS anomaly_prob_threshold) גורם לפונקציה ML.DETECT_ANOMALIES לזהות נקודות חריגות על הגרף ברמת סמך של 95%.
כדי לזהות חריגות בנתוני האימון:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מדביקים את השאילתה הבאה ולוחצים על Run:
SELECT
  *
FROM
  ML.DETECT_ANOMALIES (
    model `bqml_tutorial.multi_time_series_arimax_model`,
    STRUCT (0.95 AS anomaly_prob_threshold)
  );
התוצאות אמורות להיראות כך:

בעמודה
anomaly_probabilityבתוצאות מוצגת הסבירות שהערך בעמודהbottles_soldהוא חריג.למידע נוסף על עמודות הפלט, ראו
ML.DETECT_ANOMALIES.
זיהוי חריגות בנתונים חדשים
מזהים חריגות בנתונים החדשים על ידי הזנת נתוני קלט לפונקציה ML.DETECT_ANOMALIES. חתימת הנתונים של הנתונים החדשים צריכה להיות זהה לזו של נתוני האימון.
כדי לזהות חריגות בנתונים חדשים, פועלים לפי השלבים הבאים:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מדביקים את השאילתה הבאה ולוחצים על Run:
SELECT
  *
FROM
  ML.DETECT_ANOMALIES (
    model `bqml_tutorial.multi_time_series_arimax_model`,
    STRUCT (0.95 AS anomaly_prob_threshold),
    (
      SELECT
        *
      FROM
        `bqml_tutorial.iowa_liquor_sales_with_weather`
      WHERE
        DATE >= DATE('2022-09-01')
    )
  );
התוצאות אמורות להיראות כך:

הסרת המשאבים
כדי להימנע מחיובים בחשבון Google Cloud בגלל השימוש במשאבים שנעשה במסגרת המדריך הזה, אפשר למחוק את הפרויקט שמכיל את המשאבים, או להשאיר את הפרויקט ולמחוק את המשאבים הנפרדים.
- אתם יכולים למחוק את הפרויקט שיצרתם.
- אפשר גם להשאיר את הפרויקט ולמחוק את מערך הנתונים.
מחיקת מערך הנתונים
מחיקת הפרויקט תסיר את כל מערכי הנתונים ואת כל הטבלאות בפרויקט. אם אתם מעדיפים להשתמש שוב בפרויקט, אתם יכולים למחוק את קבוצת הנתונים שיצרתם במדריך הזה:
אם צריך, פותחים את הדף של BigQuery במסוףGoogle Cloud .
בניווט, לוחצים על מערך הנתונים bqml_tutorial שיצרתם.
לוחצים על מחיקת מערך הנתונים בצד שמאל של החלון. הפעולה הזו מוחקת את מערך הנתונים, את הטבלה ואת כל הנתונים.
בתיבת הדו-שיח Delete dataset, מאשרים את פקודת המחיקה על ידי הקלדת שם מערך הנתונים (
bqml_tutorial) ולוחצים על Delete.
מחיקת הפרויקט
כדי למחוק את הפרויקט:
- במסוף Google Cloud , נכנסים לדף Manage resources.
- ברשימת הפרויקטים, בוחרים את הפרויקט שרוצים למחוק ולוחצים על Delete.
- כדי למחוק את הפרויקט, כותבים את מזהה הפרויקט בתיבת הדו-שיח ולוחצים על Shut down.
המאמרים הבאים
- איך יוצרים תחזית של סדרת זמנים אחת באמצעות מודל חד-משתני
- איך יוצרים תחזית של כמה סדרות זמנים באמצעות מודל חד-משתני
- איך משנים את קנה המידה של מודל חד-משתני כשיוצרים תחזית של כמה סדרות זמנים על פני שורות רבות
- איך יוצרים תחזית היררכית של כמה סדרות זמנים באמצעות מודל חד-משתני
- לסקירה כללית על BigQuery ML, קראו את המאמר מבוא ל-AI ול-ML ב-BigQuery.