


במסמך הזה מוצגת ארכיטקטורת הפניה ליצירת שירות הסקת מסקנות מרובה-מודלים באמצעות Google Kubernetes Engine (GKE). בארכיטקטורה, מאגרי מסקנות שמתארחים ב-GKE ממוקמים מאחורי GKE Inference Gateway. הארכיטקטורה הזו מספקת את היתרונות הבאים:
- ממשק יחיד לכל בקשות ההסקה.
- ניתוב חכם של כל בקשה למודל ולשרת ההיסק שהכי מתאימים לטפל בה ביעילות.
- הרשאות, אבטחה ושירותים אחרים במקום אחד.
המסמך הזה מיועד לאדריכלי רשת שאחראים על איחוד הפריסה של שרתי הסקה שפועלים ב-GKE. אם כל שרתי ההסקות שלכם לא מאוחסנים ב-GKE, כדאי לעיין במאמר Networking for AI inference model serving on all backends (רשתות להצגת מודלים של הסקת מסקנות מ-AI בכל קצוות העורף). במסמך הזה לא מוסבר איך לתכנן אפליקציה או איך לפרוס מודל ספציפי של AI גנרטיבי. הוראות לפריסת מודל זמינות במאמר יצירה ופריסה של מודלים של AI גנרטיבי ולמידת מכונה בארגון.
הארכיטקטורה הזו פועלת עם ארכיטקטורות של רשתות אפליקציות, כמו Cross-Cloud Network לאפליקציות מבוזרות ועיצובים אחרים.
ארכיטקטורה
בתרשים הבא מוצגת ארכיטקטורה שכוללת Inference Gateway לפני שרתי מסקנות שמתארחים ב-GKE. השער מספק שירותים מאוחדים לכל המודלים המתארחים.
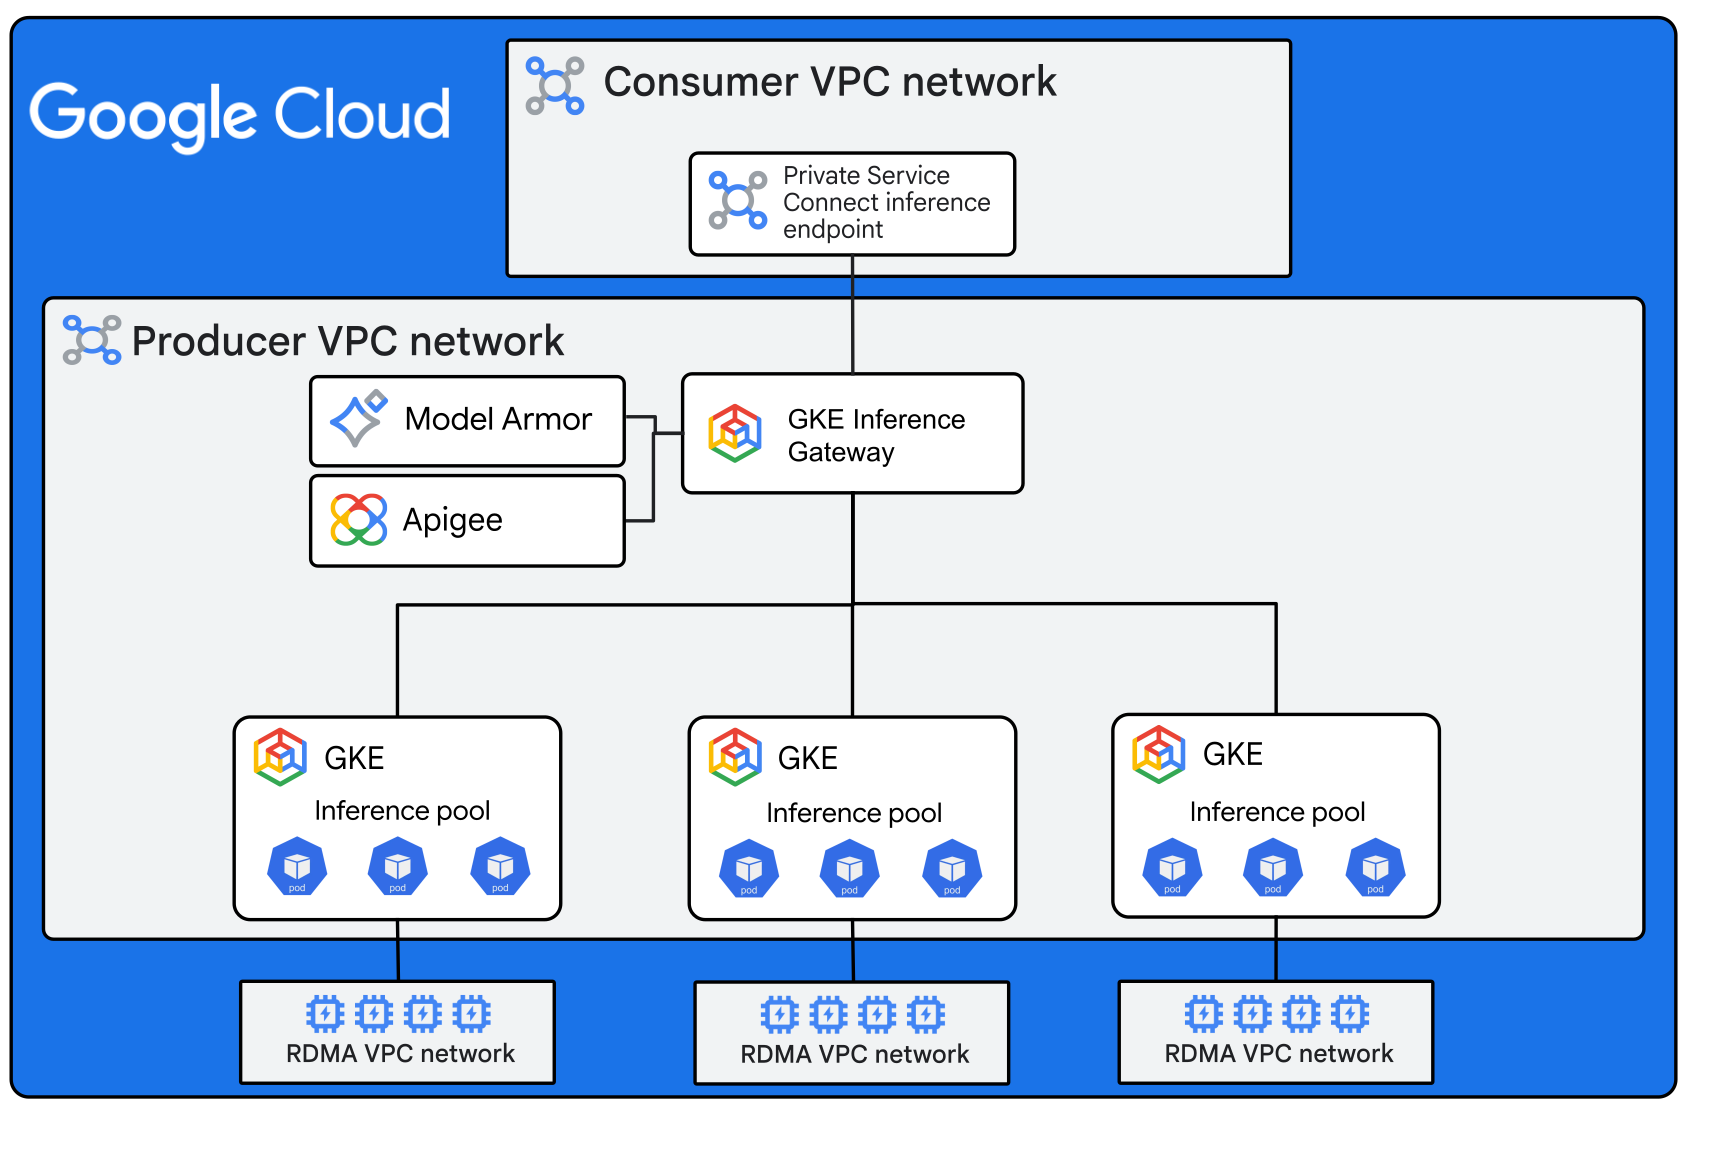
הארכיטקטורה בתרשים כוללת את הרכיבים הבאים:
- נקודת קצה להסקת מסקנות ב-Private Service Connect: נקודת קצה מאוחדת לכל המודלים המתארחים. משתמש הקצה שולח בקשות להסקת מסקנות לכתובת ה-IP של נקודת הקצה. בתרשים מוצגת נקודת קצה של Private Service Connect ברשת יחידה של ענן וירטואלי פרטי (VPC) של צרכן. אפשר לארח נקודות קצה בכמה רשתות VPC או ברשת VPC של שירותים משותפים.
- Inference Gateway: Inference Gateway משפר את GKE Gateway כדי לבצע אופטימיזציה של האופן שבו GKE משרת אפליקציות ועומסי עבודה של AI גנרטיבי. הוא מנתב את התנועה למאגרי מסקנות של העתקי מודלים על סמך שם המודל. השער משתמש בהתאמת קידומות כדי לנתב תנועה במאגר העותקים. אם אין התאמה של קידומת, מעבד ההסקה של Gateway משתמש במדדי Prometheus של GPU או TPU כדי לבחור את העותק המשוכפל עם העומס הכי נמוך במאגר.
מעבד ההסקה מטפל גם בשמירת קידומות במטמון. בארכיטקטורה הזו, האפליקציה שפונה ללקוחות מבצעת קריאות ל-OpenAI API כדי לגשת למודלים דרך השער. השער נפרס על סמך מאזן עומסים של אפליקציות (ALB) פנימי (
gke-l7-rilb) ברמה אזורית, ולכן אי אפשר לגשת אליו ישירות מהאינטרנט.- ניהול API: כלי לניהול API מספק אימות API, אבטחה, הגבלת קצב, מעקב אחר מכסות ושירותים אחרים לניהול API. הארכיטקטורה הזו משתמשת ב-Apigee, אבל היא תומכת באפשרויות אחרות. כדי לשלוח קריאה ל-Apigee ממאזן העומסים, הארכיטקטורה והפריסה של Terraform משתמשות בתוסף תעבורה של Service Extensions כדי לשלוח קריאה למעבד התוספים של Apigee.
- הגנה מוגברת על המודל: מערכת של אמצעי הגנה מבוססי-AI שמבצעת בדיקות בטיחות בהנחיות להיקש לפני שהן מגיעות לשרת להיקש. לאחר מכן, הוא מבצע בדיקות בטיחות בתשובות היוצאות. בארכיטקטורה הזו נעשה שימוש ב-Model Armor כדי להגדיר אמצעי הגנה ל-AI, אבל היא תומכת גם באפשרויות אחרות כמו NVIDIA Nemo Guardrails. פריסת Terraform שמסופקת עם ארכיטקטורת ההפניה הזו כוללת הגדרת Model Armor בסיסית.
- מאגרי הסקה: מאגר הסקה מכיל עותקים של אותו מודל.
כששער הכניסה מקבל הנחיה, הוא משתמש ב
HTTPRouteחיפוש כדי לבחור מאגר הסקה על סמך מזהה המודל. למאגרי השרתים יש גודל התחלתי, אבל אפשר להגדיר אותם כך שהגודל שלהם ישתנה אוטומטית. - קבוצות של רפליקות של מודלים: רפליקה של מודל היא עותק של שרת הסקת מסקנות שנפרס במעבד GPU אחד או יותר או במעבד TPU אחד או יותר. שכפול של מודל יכול להיות עם צומת יחיד או עם כמה צמתים. קבוצת רפליקות היא קבוצה אחידה של רפליקות של מודלים, שמאזן עומסים נמצא בחזית שלה. אם קבוצת הרפליקות היא רב-צמתי, המעבדים הגרפיים מתחברים זה לזה דרך רשת VPC של RDMA בעורף. הרשת מספקת רשתות עם זמן אחזור נמוך ללא אובדן נתונים בין מעבדים גרפיים, שמתאימות לשימוש עם מסילות.
תהליך הבקשה
המערכת מנתבת בקשות להסקת מסקנות באופן הבא:
- משתמש קצה שולח בקשת OpenAI API לנקודת הקצה של Private Service Connect. הבקשה הזו מכילה את הפרטים הבאים:
- הפרומפט.
- שם הדגם, שחייב להיות זהה לשם הדגם של אחד משרתי ההסקה המתארחים.
- נקודת הקצה של Private Service Connect מעבירה את הבקשה לגרסה האזורית הפנימית של מאזן העומסים של האפליקציה של Inference Gateway.
- השער מחלץ את שם המודל מגוף הבקשה ומזריק אותו ל-request header באמצעות ניתוב שמבוסס על גוף הבקשה.
- השער מעביר את הבקשה למערכת לניהול ממשקי API כדי לקבל שירותים לניהול ממשקי API שנדרשים.
- השער שולח את ההנחיה ל-Model Armor לצורך סינון.
- אם ההנחיה מכילה מידע רגיש שלא ניתן לצנזר, ההנחיה נחסמת ו-הגנה מוגברת על המודל מחזיר תשובה שמציינת שנמצאה הפרה של המדיניות.
- אם הפרומפט מכיל מידע רגיש שאפשר לצנזר, או אם אין בו בעיות בכלל, הגנה מוגברת על המודל מצנזר את המידע הרגיש ומעביר את הפרומפט הלאה.
- השער מתייעץ עם
HTTPRouteכדי לקבל רשימה של מאגרי הסקה שתואמים למודל של הבקשה. השער בוחר מתוך הרשימה הזו אחת מההגדרות על סמך עדיפות. - השער מתייעץ עם מטמון התוספות והטעינה הנוכחית של כל העותקים במאגר, ואז משתמש במידע הזה כדי לבחור עותק.
- העותק מעבד את הבקשה ושולח אותה חזרה לשער.
- השער שולח את התשובה ל-Model Armor לאישור או לדחייה.
- השער שולח את התגובה בחזרה לנקודת הקצה של Private Service Connect, ומשם היא מועברת למשתמש הקצה.
בתרשים הבא מוצגת תצוגת ניתוב של פריסה לדוגמה.
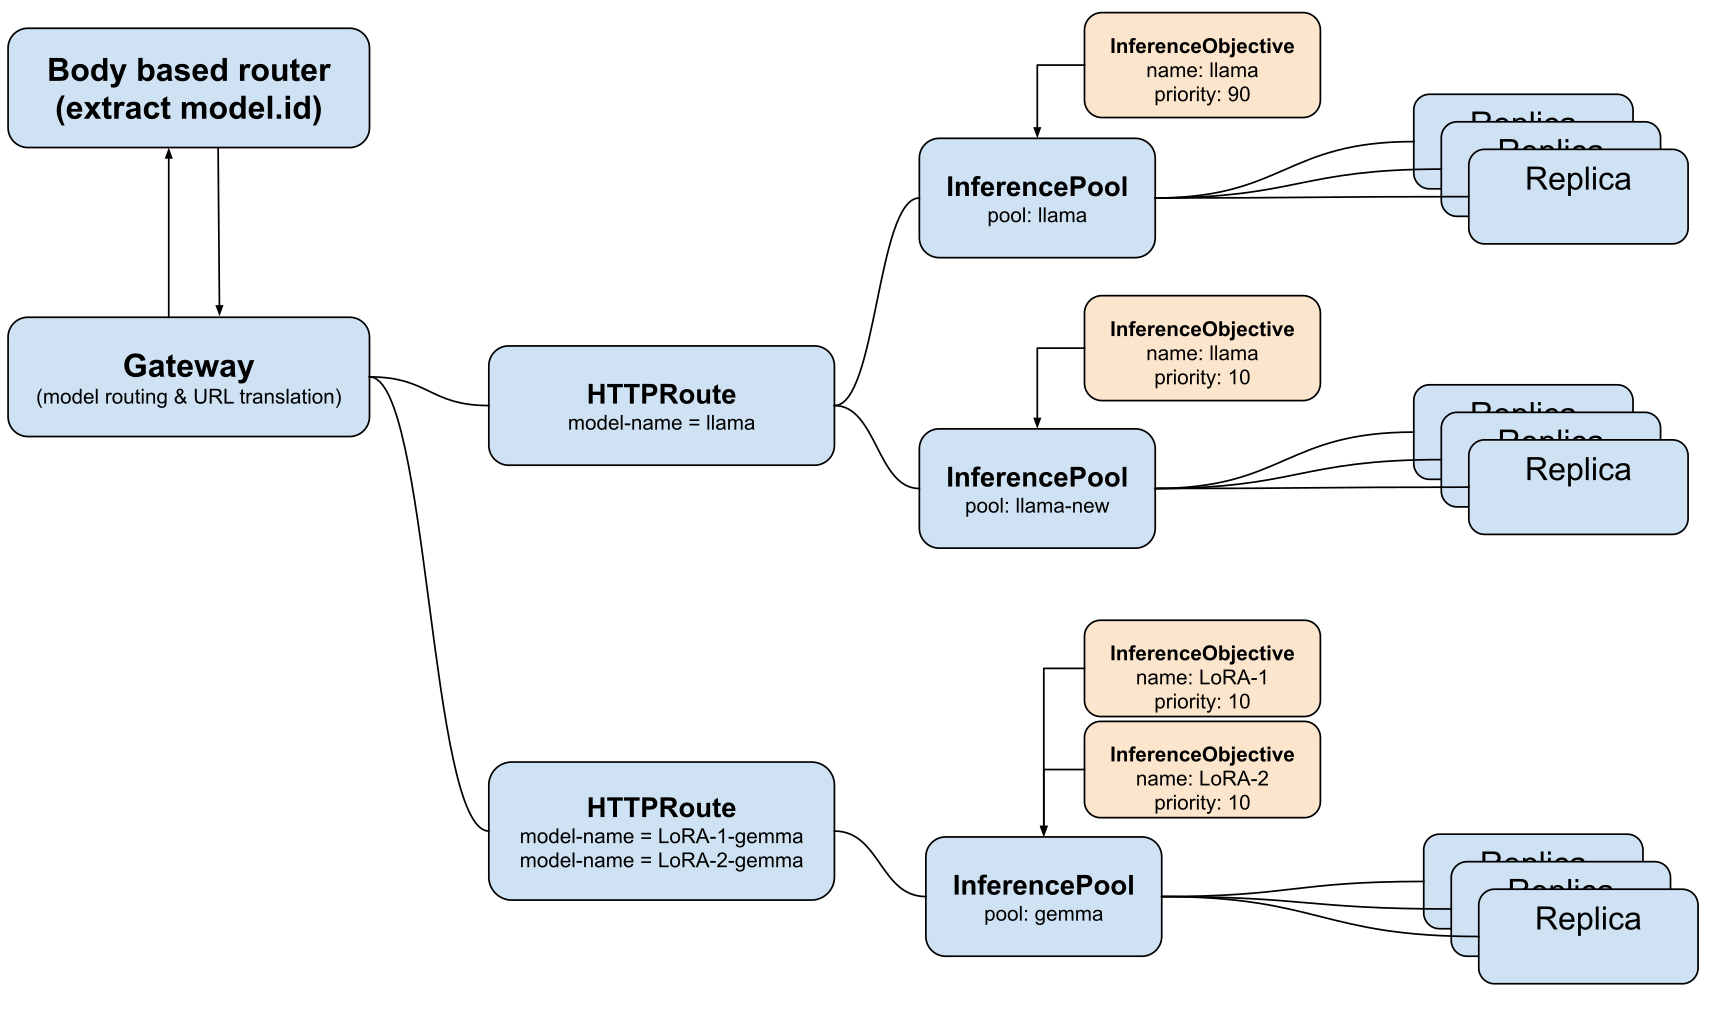
בדוגמה הזו, ההנחיות מטופלות בהתאם למודל שהמשתמש בוחר:
- Llama: המערכת מאזנת את העומס של ההנחיות האלה ביחס של 90/10 בין שתי קבוצות רפליקות שמארחות את מודל Llama. שתי קבוצות הרפליקות האלה לא צריכות להיות מאוחסנות באותו אופן. לדוגמה, אפשר לארח קבוצת שכפול אחת ב-Gemini Enterprise Agent Platform וקבוצת שכפול אחרת ב-GKE.
- LoRA-1-gemma או LoRA-2-gemma: המערכת שולחת את כל ההנחיות לאותה קבוצת רפליקות, שיכולה לטפל בשני המודלים.
בכל המקרים, שער הכניסה משתמש בשילוב של התאמת קידומת וטעינה מינימלית כדי לבחור רפליקה במאגר הרלוונטי.
המוצרים שהשתמשו בהם
ארכיטקטורת העזר הזו כוללת את המוצרים הבאים: Google Cloud
- Google Kubernetes Engine (GKE): שירות Kubernetes שמאפשר לפרוס ולהפעיל אפליקציות בקונטיינרים בהיקף גדול באמצעות התשתית של Google.
- GKE Inference Gateway: תוסף ל-Google Kubernetes Engine Gateway שמספק ניתוב אופטימלי ואיזון עומסים להצגת עומסי עבודה של AI גנרטיבי. הוא מפשט את הפריסה, הניהול והתצפית של עומסי עבודה (workloads) של הסקת מסקנות מ-AI.
- ענן וירטואלי פרטי (VPC): מערכת וירטואלית שמספקת פונקציונליות של רשתות גלובליות וניתנות להרחבה עבור עומסי העבודה שלכם ב- Google Cloud . VPC כולל קישור בין רשתות VPC שכנות (peering), Private Service Connect, גישה לשירותים פרטיים ו-VPC משותף.
- Private Service Connect: תכונה שמאפשרת לצרכנים לגשת לשירותים מנוהלים באופן פרטי מתוך רשת ה-VPC שלהם.
- Cloud Run: פלטפורמת מחשוב ללא שרת שמאפשרת להריץ קונטיינרים ישירות על גבי התשתית הניתנת להרחבה של Google.
- Apigee: כלי לניהול ממשקי API שמאפשר לכם לשלוט באופן מדויק בגישה לממשקי ה-API שלכם ובשימוש בהם. הוא מספק אבטחה, הגבלת קצב, אכיפת מכסות וניתוח נתונים.
- הגנה מוגברת על המודל: שירות שמספק הגנה למשאבי AI גנרטיבי ו-AI אקטיבי מפני החדרת פרומפטים, דליפות של מידע אישי רגיש ותוכן פוגעני.
חלופות עיצוב
בקטע הזה מפורטות חלופות לכמה מההנחות הבסיסיות של הארכיטקטורה הזו.
שכבות הגנה מבוססות-AI
אנחנו ממליצים להשתמש ב-Model Armor כדי להגדיר אמצעי הגנה על AI. כדי לרכז את הניהול, מומלץ להתקשר ישירות ממאזן העומסים, כמו בארכיטקטורה הזו. אפשר גם להטמיע את הגנה מוגברת על המודל בדרכים הבאות:
- משתמשים במדיניות לניהול API כדי לקרוא להגנה מוגברת על המודל.
- פריסת הגנה מוגברת על המודל רק ברפליקה.
אם מטמיעים אמצעי בקרה של AI שלא בנקודת הקצה של המודל, אפשר להשבית את הגנה מוגברת על המודל במאזן העומסים של קצה קדמי אם לא צריך אותו. אם אתם לא רוצים להשתמש ב-הגנה מוגברת על המודל, אתם יכולים להשתמש בתוספים לתעבורת נתונים כדי לפרוס פתרונות אחרים להגנה, כמו NVIDIA NeMo Guardrails.
ניהול API
הארכיטקטורה במסמך הזה משתמשת ב-Apigee לניהול API, שמוטמע באמצעות תוסף שירות של איזון עומסים. אם Apigee לא עונה על הצרכים שלכם, אתם יכולים להשתמש ב-Service Extensions כדי לפרוס שירות אחר לניהול API.
אם פריסת ניהול ה-API באמצעות Service Extensions לא עונה על הצרכים שלכם, יכול להיות שתצטרכו לפרוס רשת שפונה ללקוח ורשת שפונה ל-API. בתרחיש הזה, שירות ניהול ה-API משמש כגשר בין שתי הרשתות. במאמר אפשרויות רשת ב-Apigee מוסבר איך לפרוס את זה ב-Apigee.
התחברות לרשתות אחרות
הארכיטקטורה במסמך הזה משתמשת ברשת VPC אחת של צרכן. עם זאת, אפשר לשתף את נקודת הקצה של Private Service Connect עם רשתות רבות אחרות באמצעות רשת VPC לגישה לשירותים בפריסה של Cross-Cloud Network.
שיקולים בתכנון
כשיוצרים את הארכיטקטורה של עומס העבודה, כדאי לעיין בשיטות המומלצות ובהמלצות שבGoogle Cloud מסגרת Well-Architected.
אבטחה, פרטיות ותאימות
כדי להוסיף הגנה מפני מתקפות מניעת שירות מבוזרות (DDoS), פונקציונליות של חומת אש ליישומי אינטרנט (WAF) ובדיקה של כתובות IP לפריסה, מוסיפים את Google Cloud Armor למאזן העומסים האזורי הפנימי של האפליקציה בחלק הקדמי.
אמינות
כדי להגן על עצמכם מפני כשלים אזוריים, שכפלו את הפריסה לאזור שני באמצעות ארכיטיפ הפריסהGoogle Cloud בכמה אזורים.
הוזלת עלויות
המלצות לאופטימיזציה של עלויות ב-GKE זמינות במאמר שיטות מומלצות להרצה של אפליקציות Kubernetes שעברו אופטימיזציה של עלויות ב-GKE.
יעילות תפעולית
כדי לעקוב אחר הביצועים של בקשות ההסקה של Inference Gateway, אפשר להשתמש במרכז הבקרה של Inference Gateway. בלוח הבקרה מוצגות שגיאות ומדדים כמו קצב הבקשות, זמן האחזור והרוויה. אפשר להשתמש בממצאים בלוח הבקרה כדי לבצע אופטימיזציה של הפריסה.
אופטימיזציה של הביצועים
פועלים לפי ההמלצות במאמר סקירה כללית של שיטות מומלצות להסקת מסקנות ב-GKE.
פריסה
כדי לפרוס יישום לדוגמה של הארכיטקטורה הזו, אפשר להשתמש בדוגמת הקוד Networking for AI Inference Model Serving שזמינה ב-GitHub.
המאמרים הבאים
- מידע על הוספת RAG לפריסה זמין במאמר קישוריות פרטית לאפליקציות של AI גנרטיבי עם יכולות RAG.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחבר: ויקטור מורנו | מנהל מוצר, Cloud Networking
תורמי תוכן אחרים:
- מארק שלגנהוף | כותב טכני, רשתות
- James Duncan | Solutions Product Manager
- אמט וויליאמס | מהנדס קשרי מפתחים