


בדף הזה מוסבר איך להתאים אישית את הפריסה של GKE Inference Gateway.
הדף הזה מיועד למומחי רשתות שאחראים על ניהול התשתית של GKE, ולאדמינים של פלטפורמות שמנהלים עומסי עבודה של AI.
כדי לנהל ולשפר את עומסי העבודה של ההסקה, אתם יכולים להגדיר תכונות מתקדמות של GKE Inference Gateway.
הסבר על התכונות המתקדמות הבאות והגדרתן:
- כדי להשתמש בשילוב של Model Armor, צריך להגדיר בדיקות אבטחה ובטיחות של AI.
- כדי לשפר את GKE Inference Gateway עם תכונות כמו אבטחת API, הגבלת קצב של יצירת בקשות וניתוח נתונים, מגדירים את Apigee לאימות ולניהול ממשקי API.
- כדי לנתב בקשות על סמך שם המודל בגוף הבקשה, מגדירים ניתוב מבוסס-גוף.
- כדי לראות מדדים ומרכזי בקרה של GKE Inference Gateway ושל שרתי מודלים, וכדי להפעיל רישום ביומן של גישה ל-HTTP, צריך להגדיר את הניטור.
- כדי להתאים אוטומטית לעומס את הפריסות של GKE Inference Gateway, מגדירים התאמה אוטומטית לעומס.
הגדרת בדיקות אבטחה ובטיחות של AI
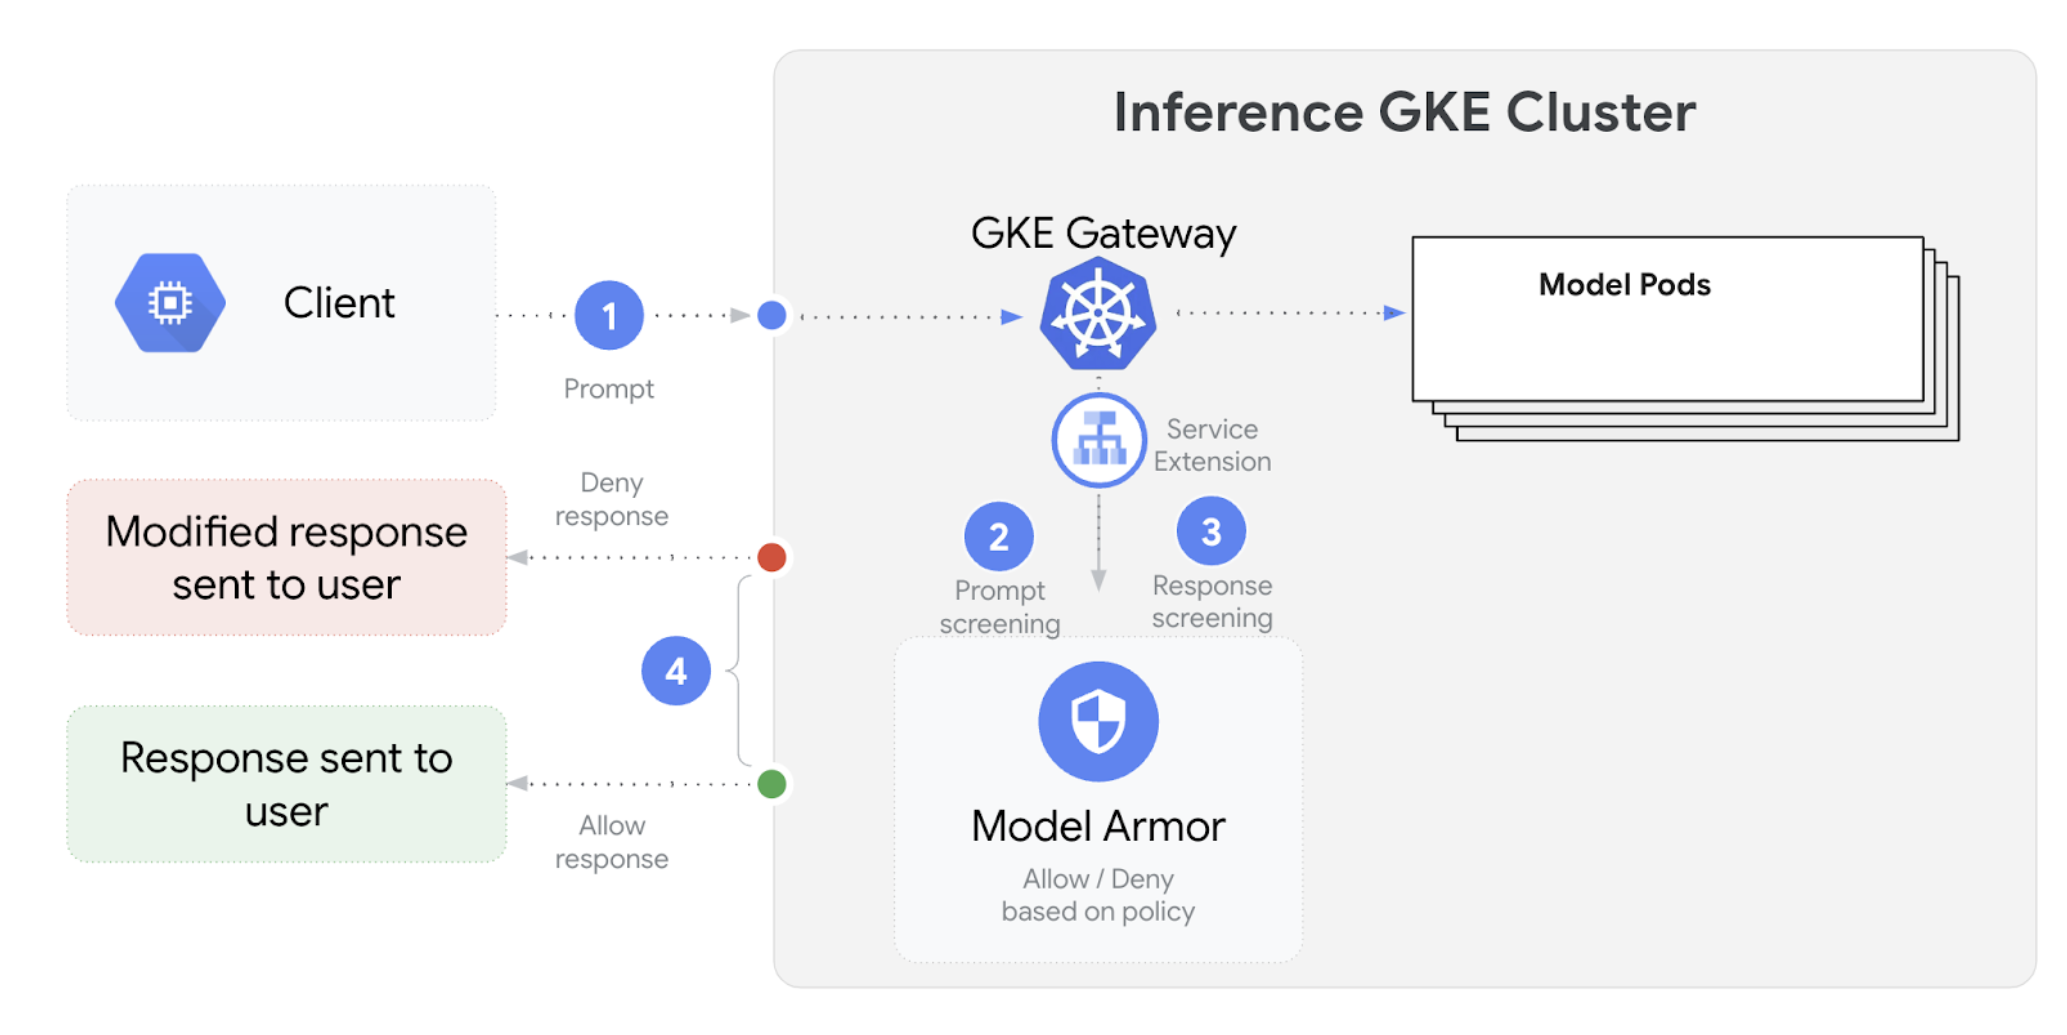
GKE Inference Gateway משתלב עם Model Armor כדי לבצע בדיקות בטיחות של הנחיות ותשובות באפליקציות שמשתמשות במודלים גדולים של שפה (LLM). השילוב הזה מספק שכבה נוספת של אכיפת בטיחות ברמת התשתית, שמשלימה את אמצעי הבטיחות ברמת האפליקציה. כך אפשר להחיל מדיניות ריכוזית על כל התנועה של ה-LLM. אתם יכולים גם להשתמש ב-NVIDIA NeMo Guardrails לבדיקות בטיחות.
הדיאגרמה הבאה ממחישה את השילוב של הגנה מוגברת על המודל עם GKE Inference Gateway באשכול GKE:
כדי להגדיר בדיקות בטיחות של AI:
דרישות מוקדמות
- מפעילים את שירות Model Armor בפרויקט ב- Google Cloud .
יוצרים את התבניות של Model Armor באמצעות מסוף Model Armor, Google Cloud CLI או API. הפקודה הבאה יוצרת תבנית בשם
llmשמתעדת פעולות ומסננת תוכן פוגעני.# Set environment variables PROJECT_ID=$(gcloud config get-value project) # Replace <var>CLUSTER_LOCATION<var> with the location of your GKE cluster. For example, `us-central1`. LOCATION="CLUSTER_LOCATION" MODEL_ARMOR_TEMPLATE_NAME=llm # Set the regional API endpoint gcloud config set api_endpoint_overrides/modelarmor \ "https://modelarmor.$LOCATION.rep.googleapis.com/" # Create the template gcloud model-armor templates create $MODEL_ARMOR_TEMPLATE_NAME \ --location $LOCATION \ --pi-and-jailbreak-filter-settings-enforcement=enabled \ --pi-and-jailbreak-filter-settings-confidence-level=MEDIUM_AND_ABOVE \ --rai-settings-filters='[{ "filterType": "HATE_SPEECH", "confidenceLevel": "MEDIUM_AND_ABOVE" },{ "filterType": "DANGEROUS", "confidenceLevel": "MEDIUM_AND_ABOVE" },{ "filterType": "HARASSMENT", "confidenceLevel": "MEDIUM_AND_ABOVE" },{ "filterType": "SEXUALLY_EXPLICIT", "confidenceLevel": "MEDIUM_AND_ABOVE" }]' \ --template-metadata-log-sanitize-operations \ --template-metadata-log-operations
מתן הרשאות IAM
לחשבון השירות של Service Extensions נדרשות הרשאות כדי לגשת למשאבים הדרושים. מריצים את הפקודות הבאות כדי להקצות את התפקידים הנדרשים:
PROJECT_NUMBER=$(gcloud projects describe $PROJECT_ID --format 'get(projectNumber)')

gcloud projects add-iam-policy-binding $PROJECT_ID \
    --member=serviceAccount:service-$PROJECT_NUMBER@gcp-sa-dep.iam.gserviceaccount.com \
    --role=roles/container.admin

gcloud projects add-iam-policy-binding $PROJECT_ID \
    --member=serviceAccount:service-$PROJECT_NUMBER@gcp-sa-dep.iam.gserviceaccount.com \
    --role=roles/modelarmor.calloutUser

gcloud projects add-iam-policy-binding $PROJECT_ID \
    --member=serviceAccount:service-$PROJECT_NUMBER@gcp-sa-dep.iam.gserviceaccount.com \
    --role=roles/serviceusage.serviceUsageConsumer

gcloud projects add-iam-policy-binding $PROJECT_ID \
    --member=serviceAccount:service-$PROJECT_NUMBER@gcp-sa-dep.iam.gserviceaccount.com \
    --role=roles/modelarmor.user
הגדרת
GCPTrafficExtensionכדי להחיל את כללי המדיניות של Model Armor על השער, יוצרים משאב
GCPTrafficExtensionעם פורמט המטא-נתונים הנכון.שומרים את המניפסט לדוגמה הבא בתור
gcp-traffic-extension.yaml:kind: GCPTrafficExtension apiVersion: networking.gke.io/v1 metadata: name: my-model-armor-extension spec: targetRefs: - group: "gateway.networking.k8s.io" kind: Gateway name: GATEWAY_NAME extensionChains: - name: my-model-armor-chain1 matchCondition: celExpressions: - celMatcher: request.path.startsWith("/") extensions: - name: my-model-armor-service supportedEvents: - RequestHeaders - RequestBody - RequestTrailers - ResponseHeaders - ResponseBody - ResponseTrailers timeout: 1s failOpen: false googleAPIServiceName: "modelarmor.${LOCATION}.rep.googleapis.com" metadata: model_armor_settings: '[{"model": "${MODEL}","model_response_template_id": "projects/${PROJECT_ID}/locations/${LOCATION}/templates/${MODEL_ARMOR_TEMPLATE_NAME}","user_prompt_template_id": "projects/${PROJECT_ID}/locations/${LOCATION}/templates/${MODEL_ARMOR_TEMPLATE_NAME}"}]'מחליפים את מה שכתוב בשדות הבאים:
-
GATEWAY_NAME: שם השער. -
MODEL_ARMOR_TEMPLATE_NAME: השם של התבנית ב-Model Armor.
הקובץ
gcp-traffic-extension.yamlכולל את ההגדרות הבאות:-
targetRefs: מציין את השער שהתוסף הזה חל עליו. -
extensionChains: מגדיר שרשרת של תוספים שיוחלו על התנועה. -
matchCondition: מגדיר את התנאים שבהם התוספים חלים. -
extensions: מגדיר את התוספים שיופעלו. -
supportedEvents: מציין את האירועים שבהם התוסף מופעל. -
timeout: מציין את הזמן הקצוב לתפוגה של התוסף. -
googleAPIServiceName: מציין את שם השירות של התוסף. -
metadata: מציין את המטא-נתונים של התוסף, כוללextensionPolicyוהגדרות הסרת התוכן הזדוני או הרגיש מההנחיה או מהתשובה.
-
מחילים את המניפסט לדוגמה על האשכול:
export GATEWAY_NAME="your-gateway-name"
export MODEL="google/gemma-3-1b-it" # Or your specific model
envsubst < gcp-traffic-extension.yaml | kubectl apply -f -
אחרי שמגדירים את בדיקות הבטיחות של ה-AI ומשלבים אותן ב-Gateway, המערכת של Model Armor מסננת באופן אוטומטי את ההנחיות והתשובות על סמך הכללים שהוגדרו.
הגדרת Apigee לאימות ולניהול ממשקי API
GKE Inference Gateway משתלב עם Apigee כדי לספק אימות, הרשאה וניהול ממשקי API לעומסי העבודה של ההסקה. מה היתרונות העיקריים של השימוש ב-Apigee?
אתם יכולים לשלב את GKE Inference Gateway עם Apigee כדי לשפר את GKE Inference Gateway באמצעות תכונות כמו אבטחת API, הגבלת קצב של יצירת בקשות, מכסות, ניתוח נתונים ומונטיזציה.
דרישות מוקדמות
לפני שמתחילים, חשוב לוודא שהתנאים הבאים מתקיימים:
- אשכול GKE עם גרסה 1.34.* ואילך.
- אשכול GKE עם פריסה של GKE Inference Gateway.
- מכונה של Apigee שנוצרה באותו אזור כמו אשכול GKE.
- Apigee APIM Operator וה-CRD שלו מותקנים באשכול GKE. הוראות מפורטות מופיעות במאמר התקנת האופרטור של Apigee APIM.
-
kubectlמוגדר להתחבר לאשכול GKE. -
Google Cloud CLIהותקן ואומת.
יצירת ApigeeBackendService
קודם צריך ליצור משאב ApigeeBackendService. GKE Inference Gateway משתמש בזה כדי ליצור מעבד של תוסף Apigee.
שומרים את המניפסט הבא בתור
my-apigee-backend-service.yaml:apiVersion: apim.googleapis.com/v1 kind: ApigeeBackendService metadata: name: my-apigee-backend-service spec: apigeeEnv: "APIGEE_ENVIRONMENT_NAME" # optional field defaultSecurityEnabled: true # optional field locations: name: "LOCATION" network: "CLUSTER_NETWORK" subnetwork: "CLUSTER_SUBNETWORK"מחליפים את מה שכתוב בשדות הבאים:
-
APIGEE_ENVIRONMENT_NAME: השם של סביבת Apigee. הערה: לא צריך להגדיר את השדה הזה אםapigee-apim-operatorמותקן עם הדגלgenerateEnv=TRUE. אם לא, יוצרים סביבת Apigee לפי ההוראות במאמר יצירת סביבה. -
LOCATION: המיקום של המכונה של Apigee. -
CLUSTER_NETWORK: הרשת של אשכול GKE. -
CLUSTER_SUBNETWORK: רשת המשנה של אשכול GKE.
-
מחילים את המניפסט על האשכול:
kubectl apply -f my-apigee-backend-service.yamlמוודאים שהסטטוס השתנה ל-
CREATED:kubectl wait --for=jsonpath='{.status.currentState}'="CREATED" -f my-apigee-backend-service.yaml --timeout=5m
הגדרת GKE Inference Gateway
מגדירים את GKE Inference Gateway כדי להפעיל את Apigee Extension Processor כתוסף תנועה של מאזן עומסים.
שומרים את המניפסט הבא בתור
my-apigee-traffic-extension.yaml:kind: GCPTrafficExtension apiVersion: networking.gke.io/v1 metadata: name: my-apigee-traffic-extension spec: targetRefs: - group: "gateway.networking.k8s.io" kind: Gateway name: GATEWAY_NAME extensionChains: - name: my-traffic-extension-chain matchCondition: celExpressions: - celMatcher: request.path.startsWith("/") extensions: - name: my-apigee-extension metadata: # The value for `apigee-extension-processor` must match the name of the `ApigeeBackendService` resource that was applied earlier. apigee-extension-processor: my-apigee-backend-service failOpen: false timeout: 1s supportedEvents: - RequestHeaders - ResponseHeaders - ResponseBody backendRef: group: apim.googleapis.com kind: ApigeeBackendService name: my-apigee-backend-service port: 443מחליפים את
GATEWAY_NAMEבשם של השער.מחילים את המניפסט על האשכול:
kubectl apply -f my-apigee-traffic-extension.yamlמחכים שהסטטוס של
GCPTrafficExtensionישתנה ל-Programmed:kubectl wait --for=jsonpath='{.status.ancestors[0].conditions[?(@.type=="Programmed")].status}'=True -f my-apigee-traffic-extension.yaml --timeout=5m
שליחת בקשות מאומתות באמצעות מפתחות API
כדי למצוא את כתובת ה-IP של GKE Inference Gateway, בודקים את סטטוס השער:
GW_IP=$(kubectl get gateway/GATEWAY_NAME -o jsonpath='{.status.addresses[0].value}')מחליפים את
GATEWAY_NAMEבשם של השער.בודקים בקשה ללא אימות. צריך לדחות את הבקשה הזו:
curl -i ${GW_IP}/v1/completions -H 'Content-Type: application/json' -d '{
"model": "food-review",
"prompt": "Write as if you were a critic: San Francisco",
"max_tokens": 100,
"temperature": 0
}'
תופיע תגובה דומה לזו, שמציינת שתוסף Apigee פועל:
{"fault":{"faultstring":"Raising fault. Fault name : RF-insufficient-request-raise-fault","detail":{"errorcode":"steps.raisefault.RaiseFault"}}}נכנסים לממשק המשתמש של Apigee ויוצרים מפתח API. הוראות מפורטות זמינות במאמר יצירת מפתח API.
שולחים את מפתח ה-API בכותרת של בקשת ה-HTTP:
curl -i ${GW_IP}/v1/completions -H 'Content-Type: application/json' -H 'x-api-key: API_KEY' -d '{
"model": "food-review",
"prompt": "Write as if you were a critic: San Francisco",
"max_tokens": 100,
"temperature": 0
}'
מחליפים את הערך
API_KEYבמפתח ה-API שלכם.
מידע נוסף על הגדרת כללי מדיניות של Apigee זמין במאמר שימוש בכללי מדיניות לניהול ממשקי API עם Apigee APIM Operator ל-Kubernetes.
הגדרת ניראות (observability)
GKE Inference Gateway מספק תובנות לגבי התקינות, הביצועים וההתנהגות של עומסי העבודה של ההסקה. כך תוכלו לזהות ולפתור בעיות, לייעל את ניצול המשאבים ולוודא שהאפליקציות שלכם אמינות.
ב-Google Cloud יש את מרכזי הבקרה הבאים של Cloud Monitoring, שמאפשרים לצפות בהסקת המסקנות של GKE Inference Gateway:
- לוח הבקרה של GKE Inference Gateway: מספק מדדי זהב להצגת LLM, כמו תפוקת בקשות ואסימונים, זמן אחזור, שגיאות וניצול מטמון עבור
InferencePool. לרשימה המלאה של המדדים שזמינים ב-GKE Inference Gateway - לוחות בקרה לניטור AI/ML: לוחות בקרה לשימוש בתשתית, מדדי DCGM ומדדי ביצועים של מודל vLLM.
- Model server dashboard: לוח בקרה לאותות הזהב של שרת המודל. כך אפשר לעקוב אחרי העומס והביצועים של שרתי המודלים, כמו
KVCache Utilizationו-Queue length. - לוח הבקרה של מאזן העומסים: מדווח על מדדים ממאזן העומסים, כמו בקשות לשנייה, זמן אחזור מקצה לקצה של הצגת בקשות וקודי סטטוס של בקשות ותגובות. המדדים האלה עוזרים להבין את הביצועים של מילוי הבקשות מקצה לקצה ולזהות שגיאות.
- מדדי Data Center GPU Manager (DCGM): מספק מדדי DCGM, כמו הביצועים והניצול של מעבדי NVIDIA GPU. אפשר להגדיר מדדי DCGM ב-Cloud Monitoring. מידע נוסף מופיע במאמר איסוף והצגה של מדדי DCGM.
הצגת לוח הבקרה של GKE Inference Gateway
כדי לראות את לוח הבקרה המאוחד llm-d Overview של GKE Inference Gateway:
נכנסים לדף Monitoring במסוף Google Cloud .
בחלונית הניווט, לוחצים על Dashboards.
בקטע Integrations (שילובים), בוחרים באפשרות GMP.
בדף Cloud Monitoring Dashboard Templates, מחפשים את "llm-d".
בוחרים את לוח הבקרה llm-d Overview, שמשמש למעקב אחרי מדדים של מאזן עומסים של אפליקציות (ALB), רשתות GPU, llm-d EPP (
llm_d_epp_*) ו-vLLM במצב עצמאי ובמצב שער.לוחצים על הוספת מרכז בקרה לרשימה וממלאים את שדות החובה. אחר כך לוחצים על הוספה לרשימת מרכזי הבקרה.
צפייה בלוחות בקרה של ניטור מודלים של AI/ML
כדי לראות את המודלים שנפרסו ואת לוחות הבקרה של מדדי התצפיתיות של מודל:
נכנסים לדף Deployed Models במסוף Google Cloud .
כדי לראות פרטים על פריסה ספציפית, כולל המדדים, היומנים ומרכזי הבקרה שלה, לוחצים על שם המודל ברשימה.
בדף הפרטים של המודל, לוחצים על הכרטיסייה Observability כדי לראות את מרכזי הבקרה הבאים. אם מופיעה בקשה, לוחצים על Enable כדי להפעיל את מרכז הבקרה.
- בלוח הבקרה Infrastructure usage מוצגים מדדי ניצול.
- בלוח הבקרה DCGM מוצגים מדדי DCGM.
- אם אתם משתמשים ב-vLLM, לוח הבקרה Model performance זמין ומציג מדדים של ביצועי המודל ב-vLLM.
הגדרת לוח הבקרה של ניראות שרת המודל
כדי לאסוף אותות זהב מכל שרת מודל ולהבין מה משפיע על הביצועים של GKE Inference Gateway, אתם יכולים להגדיר מעקב אוטומטי אחרי שרתי המודלים. זה כולל שרתי מודלים כמו:
כדי לראות את מרכזי הבקרה של השילוב, קודם צריך לוודא שאתם אוספים מדדים משרת המודל. לאחר מכן, מבצעים את השלבים הבאים:
נכנסים לדף Monitoring במסוף Google Cloud .
בחלונית הניווט, לוחצים על Dashboards.
בקטע שילובים, בוחרים באפשרות GMP. מרכזי הבקרה של השילובים המתאימים מוצגים.
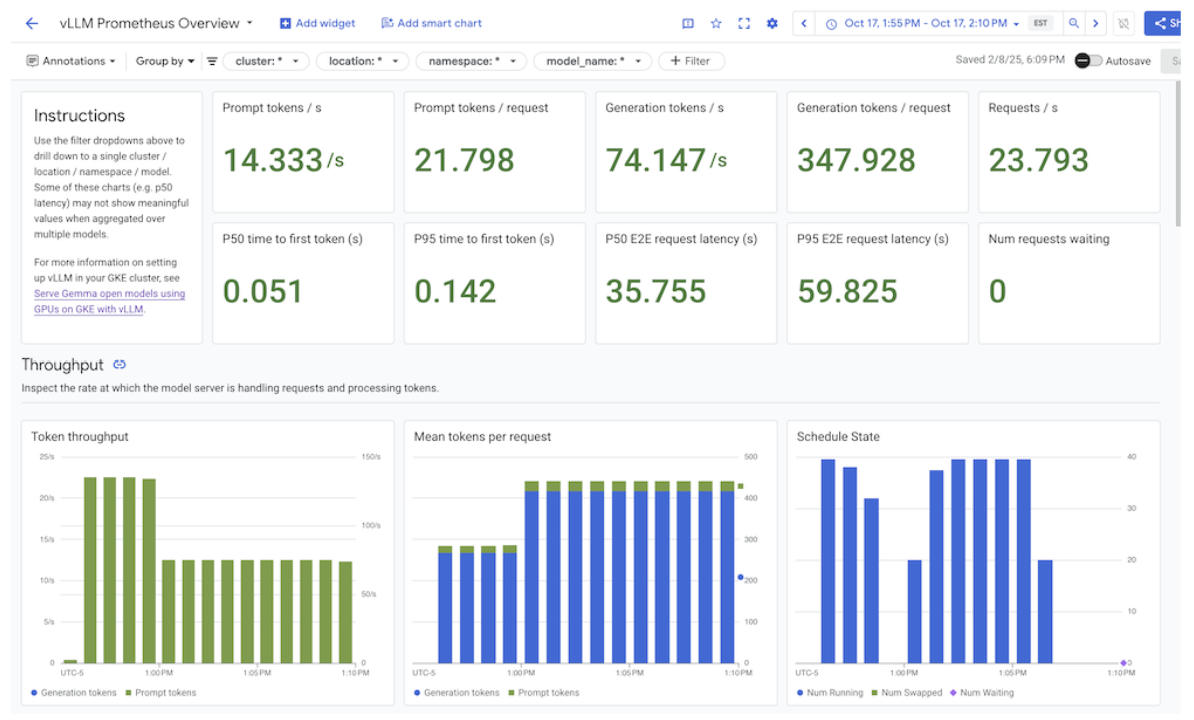
איור: מרכזי בקרה של שילובים
מידע נוסף זמין במאמר התאמה אישית של מעקב אחרי אפליקציות.
הגדרת ההתראות של Cloud Monitoring
כדי להגדיר התראות ב-Cloud Monitoring ל-GKE Inference Gateway:
שומרים את המניפסט לדוגמה הבא בתור
alerts.yamlומשנים את ערכי הסף לפי הצורך:groups: - name: gateway-api-inference-extension rules: - alert: HighInferenceRequestLatencyP99 annotations: title: 'High latency (P99) for model {{ $labels.model_name }}' description: 'The 99th percentile request duration for model {{ $labels.model_name }} and target model {{ $labels.target_model_name }} has been consistently above 10.0 seconds for 5 minutes.' expr: histogram_quantile(0.99, rate(inference_model_request_duration_seconds_bucket[5m])) > 10.0 for: 5m labels: severity: 'warning' - alert: HighInferenceErrorRate annotations: title: 'High error rate for model {{ $labels.model_name }}' description: 'The error rate for model {{ $labels.model_name }} and target model {{ $labels.target_model_name }} has been consistently above 5% for 5 minutes.' expr: sum by (model_name) (rate(inference_model_request_error_total[5m])) / sum by (model_name) (rate(inference_model_request_total[5m])) > 0.05 for: 5m labels: severity: 'critical' impact: 'availability' - alert: HighInferencePoolAvgQueueSize annotations: title: 'High average queue size for inference pool {{ $labels.name }}' description: 'The average number of requests pending in the queue for inference pool {{ $labels.name }} has been consistently above 50 for 5 minutes.' expr: inference_pool_average_queue_size > 50 for: 5m labels: severity: 'critical' impact: 'performance' - alert: HighInferencePoolAvgKVCacheUtilization annotations: title: 'High KV cache utilization for inference pool {{ $labels.name }}' description: 'The average KV cache utilization for inference pool {{ $labels.name }} has been consistently above 90% for 5 minutes, indicating potential resource exhaustion.' expr: inference_pool_average_kv_cache_utilization > 0.9 for: 5m labels: severity: 'critical' impact: 'resource_exhaustion'כדי ליצור מדיניות התראות, מריצים את הפקודה הבאה:
gcloud monitoring policies migrate --policies-from-prometheus-alert-rules-yaml=alerts.yamlבדף Alerting יופיעו כללי מדיניות חדשים להתראות.
שינוי התראות
במאגר kubernetes-sigs/gateway-api-inference-extension ב-GitHub מופיעה רשימה מלאה של המדדים העדכניים, ואתם יכולים להוסיף למניפסט התראות חדשות באמצעות מדדים אחרים.
כדי לשנות את ההתראות לדוגמה, אפשר להשתמש בדוגמה הבאה:
  - alert: HighInferenceRequestLatencyP99
    annotations:
      title: 'High latency (P99) for model {{ $labels.model_name }}'
      description: 'The 99th percentile request duration for model {{ $labels.model_name }} and target model {{ $labels.target_model_name }} has been consistently above 10.0 seconds for 5 minutes.'
    expr: histogram_quantile(0.99, rate(inference_model_request_duration_seconds_bucket[5m])) > 10.0
    for: 5m
    labels:
      severity: 'warning'
ההתראה הזו מופעלת אם האחוזון ה-99 של משך הבקשה במשך 5 דקות חורג מ-10 שניות. אפשר לשנות את הקטע expr בהתראה כדי להתאים את הסף לפי הדרישות שלכם.
הגדרת רישום ביומן ל-GKE Inference Gateway
הגדרת רישום ביומן ל-GKE Inference Gateway מספקת מידע מפורט על בקשות ותגובות, שמועיל לפתרון בעיות, לביקורת ולניתוח ביצועים. ביומני הגישה של HTTP מתועדות כל הבקשות והתגובות, כולל כותרות, קודי סטטוס וחותמות זמן. רמת הפירוט הזו יכולה לעזור לכם לזהות בעיות, למצוא שגיאות ולהבין את ההתנהגות של עומסי העבודה של ההסקה.
כדי להגדיר רישום ביומן ל-GKE Inference Gateway, צריך להפעיל רישום ביומן של גישת HTTP לכל אחד מאובייקטי ה-InferencePool.
שומרים את המניפסט לדוגמה הבא בתור
logging-backend-policy.yaml:apiVersion: networking.gke.io/v1 kind: GCPBackendPolicy metadata: name: logging-backend-policy namespace: NAMESPACE_NAME spec: default: logging: enabled: true sampleRate: 500000 targetRef: group: inference.networking.x-k8s.io kind: InferencePool name: INFERENCE_POOL_NAMEמחליפים את מה שכתוב בשדות הבאים:
-
NAMESPACE_NAME: השם של מרחב השמות שבו פרוסInferencePool. -
INFERENCE_POOL_NAME: השם שלInferencePool.
-
מחילים את המניפסט לדוגמה על האשכול:
kubectl apply -f logging-backend-policy.yaml
אחרי שמחילים את המניפסט הזה, GKE Inference Gateway מפעיל את יומני הגישה ל-HTTP בשביל ה-InferencePool שצוין. אתם יכולים לצפות ביומנים האלה ב-Cloud Logging. היומנים כוללים מידע מפורט על כל בקשה ותגובה, כמו כתובת ה-URL של הבקשה, הכותרות, קוד הסטטוס של התגובה וזמן האחזור.
יצירת מדדים מבוססי-יומנים כדי לראות את פרטי השגיאות
אתם יכולים להשתמש במדדים מבוססי-יומנים כדי לנתח את יומני איזון העומסים ולחלץ את פרטי השגיאות. כל מחלקת GKE Gateway, כמו המחלקות gke-l7-global-external-managed ו-gke-l7-regional-internal-managed, מגובה על ידי מאזן עומסים אחר. מידע נוסף מופיע במאמר יכולות של GatewayClass.
לכל מאזן עומסים יש משאב במעקב שונה, שבו צריך להשתמש כשיוצרים מדד מבוסס-יומנים. למידע נוסף על המשאב במעקב של כל מאזן עומסים:
- למאזני עומסים חיצוניים אזוריים: מדדים מבוססי-יומנים למאזני עומסים חיצוניים מסוג HTTP(S)
- למאזני עומסים פנימיים: מדדים מבוססי-יומנים למאזני עומסים פנימיים מסוג HTTP(S)
כדי ליצור מדד מבוסס-יומנים שבו אפשר לראות את פרטי השגיאה:
יוצרים קובץ JSON בשם
error_detail_metric.jsonעם ההגדרה הבאה שלLogMetric. ההגדרה הזו יוצרת מדד שמחלץ את השדהproxyStatusמהיומנים של מאזן העומסים.{ "description": "Metric to extract error details from load balancer logs.", "filter": "resource.type=\"MONITORED_RESOURCE\"", "metricDescriptor": { "metricKind": "DELTA", "valueType": "INT64", "labels": [ { "key": "error_detail", "valueType": "STRING", "description": "The detailed error string from the load balancer." } ] }, "labelExtractors": { "error_detail": "EXTRACT(jsonPayload.proxyStatus)" } }מחליפים את
MONITORED_RESOURCEבמשאב במעקב של מאזן העומסים.פותחים את Cloud Shell או את הטרמינל המקומי שבו מותקן ה-CLI של gcloud.
כדי ליצור את המדד, מריצים את הפקודה
gcloud logging metrics createעם הדגל--config-from-file:gcloud logging metrics create error_detail_metric \ --config-from-file=error_detail_metric.json
אחרי שיוצרים את המדד, אפשר להשתמש בו ב-Cloud Monitoring כדי לראות את התפלגות השגיאות שדווחו על ידי מאזן העומסים. מידע נוסף זמין במאמר יצירת מדד מבוסס-יומנים.
למידע נוסף על יצירת התראות ממדדים מבוססי-יומנים, ראו יצירת מדיניות התראות במדד מונה.
הגדרת התאמה לעומס (autoscaling)
התאמה אוטומטית לעומס משנה את הקצאת המשאבים בתגובה לשינויים בעומס, ושומרת על הביצועים ועל יעילות המשאבים על ידי הוספה או הסרה של Pods באופן דינמי על סמך הביקוש. ב-GKE Inference Gateway, זה כולל התאמה אופקית לעומס (autoscaling) של Pods בכל InferencePool. Horizontal Pod Autoscaler (HPA) של GKE משנה את קבוצות ה-Pod בהתאם למדדים של שרת המודל, כמו KVCache Utilization. הגישה הזו עוזרת לוודא ששירות ההסקה מטפל בעומסי עבודה ובנפחי שאילתות שונים, תוך ניהול יעיל של השימוש במשאבים.
כדי להגדיר מכונות של InferencePool כך שהן יותאמו אוטומטית לעומס לפי מדדים שנוצרו על ידי GKE Inference Gateway, מבצעים את השלבים הבאים:
פורסים אובייקט
PodMonitoringבאשכול כדי לאסוף מדדים שנוצרו על ידי GKE Inference Gateway. למידע נוסף, קראו את המאמר הגדרת יכולת הצפייה.פורסים את מתאם Stackdriver למדדים מותאמים אישית כדי לתת ל-HPA גישה למדדים:
שומרים את המניפסט לדוגמה הבא בתור
adapter_new_resource_model.yaml:apiVersion: v1 kind: Namespace metadata: name: custom-metrics --- apiVersion: v1 kind: ServiceAccount metadata: name: custom-metrics-stackdriver-adapter namespace: custom-metrics --- apiVersion: rbac.authorization.k8s.io/v1 kind: ClusterRoleBinding metadata: name: custom-metrics:system:auth-delegator roleRef: apiGroup: rbac.authorization.k8s.io kind: ClusterRole name: system:auth-delegator subjects: - kind: ServiceAccount name: custom-metrics-stackdriver-adapter namespace: custom-metrics --- apiVersion: rbac.authorization.k8s.io/v1 kind: RoleBinding metadata: name: custom-metrics-auth-reader namespace: kube-system roleRef: apiGroup: rbac.authorization.k8s.io kind: Role name: extension-apiserver-authentication-reader subjects: - kind: ServiceAccount name: custom-metrics-stackdriver-adapter namespace: custom-metrics --- apiVersion: rbac.authorization.k8s.io/v1 kind: ClusterRole metadata: name: custom-metrics-resource-reader rules: - apiGroups: - "" resources: - pods - nodes - nodes/stats verbs: - get - list - watch --- apiVersion: rbac.authorization.k8s.io/v1 kind: ClusterRoleBinding metadata: name: custom-metrics-resource-reader roleRef: apiGroup: rbac.authorization.k8s.io kind: ClusterRole name: custom-metrics-resource-reader subjects: - kind: ServiceAccount name: custom-metrics-stackdriver-adapter namespace: custom-metrics --- apiVersion: apps/v1 kind: Deployment metadata: name: custom-metrics-stackdriver-adapter labels: run: custom-metrics-stackdriver-adapter k8s-app: custom-metrics-stackdriver-adapter spec: replicas: 1 selector: matchLabels: run: custom-metrics-stackdriver-adapter k8s-app: custom-metrics-stackdriver-adapter template: metadata: labels: run: custom-metrics-stackdriver-adapter k8s-app: custom-metrics-stackdriver-adapter kubernetes.io/cluster-service: "true" spec: serviceAccountName: custom-metrics-stackdriver-adapter containers: - image: gcr.io/gke-release/custom-metrics-stackdriver-adapter:v0.15.2-gke.1 imagePullPolicy: Always name: pod-custom-metrics-stackdriver-adapter command: - /adapter - --use-new-resource-model=true - --fallback-for-container-metrics=true resources: limits: cpu: 250m memory: 200Mi requests: cpu: 250m memory: 200Mi --- apiVersion: v1 kind: Service metadata: labels: run: custom-metrics-stackdriver-adapter k8s-app: custom-metrics-stackdriver-adapter kubernetes.io/cluster-service: 'true' kubernetes.io/name: Adapter name: custom-metrics-stackdriver-adapter namespace: custom-metrics spec: ports: - port: 443 protocol: TCP targetPort: 443 selector: run: custom-metrics-stackdriver-adapter k8s-app: custom-metrics-stackdriver-adapter type: ClusterIP --- apiVersion: apiregistration.k8s.io/v1 kind: APIService metadata: name: v1beta1.custom.metrics.k8s.io spec: insecureSkipTLSVerify: true group: custom.metrics.k8s.io groupPriorityMinimum: 100 versionPriority: 100 service: name: custom-metrics-stackdriver-adapter namespace: custom-metrics version: v1beta1 --- apiVersion: apiregistration.k8s.io/v1 kind: APIService metadata: name: v1beta2.custom.metrics.k8s.io spec: insecureSkipTLSVerify: true group: custom.metrics.k8s.io groupPriorityMinimum: 100 versionPriority: 200 service: name: custom-metrics-stackdriver-adapter namespace: custom-metrics version: v1beta2 --- apiVersion: apiregistration.k8s.io/v1 kind: APIService metadata: name: v1beta1.external.metrics.k8s.io spec: insecureSkipTLSVerify: true group: external.metrics.k8s.io groupPriorityMinimum: 100 versionPriority: 100 service: name: custom-metrics-stackdriver-adapter namespace: custom-metrics version: v1beta1 --- apiVersion: rbac.authorization.k8s.io/v1 kind: ClusterRole metadata: name: external-metrics-reader rules: - apiGroups: - "external.metrics.k8s.io" resources: - "*" verbs: - list - get - watch --- apiVersion: rbac.authorization.k8s.io/v1 kind: ClusterRoleBinding metadata: name: external-metrics-reader roleRef: apiGroup: rbac.authorization.k8s.io kind: ClusterRole name: external-metrics-reader subjects: - kind: ServiceAccount name: horizontal-pod-autoscaler namespace: kube-systemמחילים את המניפסט לדוגמה על האשכול:
kubectl apply -f adapter_new_resource_model.yaml
כדי לתת למתאם הרשאות לקרוא מדדים מהפרויקט, מריצים את הפקודה הבאה:
$ PROJECT_ID=PROJECT_ID
$ PROJECT_NUMBER=$(gcloud projects describe PROJECT_ID --format="value(projectNumber)")
$ gcloud projects add-iam-policy-binding projects/PROJECT_ID \
  --role roles/monitoring.viewer \
  --member=principal://iam.googleapis.com/projects/PROJECT_NUMBER/locations/global/workloadIdentityPools/$PROJECT_ID.svc.id.goog/subject/ns/custom-metrics/sa/custom-metrics-stackdriver-adapter
מחליפים את
PROJECT_IDבמזהה הפרויקט ב- Google Cloud .לכל
InferencePool, פורסים HPA אחד שדומה לזה:apiVersion: autoscaling/v2 kind: HorizontalPodAutoscaler metadata: name: INFERENCE_POOL_NAME namespace: INFERENCE_POOL_NAMESPACE spec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: INFERENCE_POOL_NAME minReplicas: MIN_REPLICAS maxReplicas: MAX_REPLICAS metrics: - type: External external: metric: name: prometheus.googleapis.com|inference_pool_average_kv_cache_utilization|gauge selector: matchLabels: metric.labels.name: INFERENCE_POOL_NAME resource.labels.cluster: CLUSTER_NAME resource.labels.namespace: INFERENCE_POOL_NAMESPACE target: type: AverageValue averageValue: TARGET_VALUEמחליפים את מה שכתוב בשדות הבאים:
-
INFERENCE_POOL_NAME: השם שלInferencePool. -
INFERENCE_POOL_NAMESPACE: מרחב השמות שלInferencePool. -
CLUSTER_NAME: שם האשכול. -
MIN_REPLICAS: הזמינות המינימלית שלInferencePool(קיבולת בסיסית). HPA שומר על מספר הרפליקות הזה כשהשימוש נמוך מסף היעד של HPA. בעומסי עבודה עם זמינות גבוהה, צריך להגדיר ערך גבוה מ-1כדי להבטיח זמינות רציפה בזמן שיבושים ב-Pod. -
MAX_REPLICAS: הערך שמגביל את מספר המאיצים שצריך להקצות לעומסי העבודה שמתארחים ב-InferencePool. HPA לא יגדיל את מספר הרפליקות מעבר לערך הזה. בזמני שיא של תנועה, עוקבים אחרי מספר הרפליקות כדי לוודא שהערך של השדהMAX_REPLICASמספק מספיק מקום פנוי, כך שעומס העבודה יוכל לגדול כדי לשמור על מאפייני הביצועים שנבחרו לעומס העבודה. -
TARGET_VALUE: הערך שמייצג את היעד שנבחר ל-KV-Cache Utilizationלכל שרת מודל. זהו מספר בין 0 ל-100, והוא תלוי מאוד בשרת המודל, במודל, במאיץ ובמאפייני התנועה הנכנסת. אפשר לקבוע את ערך היעד הזה באופן ניסיוני באמצעות בדיקת עומס ושרטוט גרף של תפוקה לעומת זמן אחזור. בוחרים מהתרשים שילוב של קצב העברת נתונים וזמן אחזור, ומשתמשים בערךKV-Cache Utilizationהמתאים כיעד של ה-HPA. כדי להשיג את התוצאות הרצויות של מחיר וביצועים, צריך לשנות את הערך הזה ולעקוב אחריו מקרוב. אתם יכולים להשתמש ב-GKE Inference Quickstart כדי לקבוע את הערך הזה באופן אוטומטי.
-
המאמרים הבאים
- מידע על GKE Inference Gateway
- פריסת GKE Inference Gateway.
- ניהול פעולות ההשקה של GKE Inference Gateway
- הצגה באמצעות GKE Inference Gateway.