


ככל שהשימוש במודלים של AI גנרטיבי ולמידת מכונה (ML) הופך לנפוץ יותר בפעילויות ובתהליכים העסקיים של ארגונים, כך הם זקוקים יותר להנחיות לפיתוח מודלים כדי להבטיח עקביות, יכולת חזרה, אבטחה ובטיחות. כדי לעזור לארגונים גדולים לפתח ולפרוס מודלים של למידת מכונה ו-AI גנרטיבי, יצרנו את התוכנית הארגונית ללמידת מכונה ול-AI גנרטיבי. התוכנית הזו מספקת מדריך מקיף לכל מחזור החיים של פיתוח AI, החל מבדיקת נתונים ראשונית וניסויים ועד לאימון, פריסה ומעקב אחרי מודלים.
לתוכנית ה-AI הגנרטיבי וה-ML לארגונים יש יתרונות רבים, כולל:
- הנחיות מפורטות: הנחיות ברורות ליצירה, להגדרה ולפריסה של סביבת פיתוח ל-AI גנרטיבי ול-ML שמבוססת על Vertex AI. אתם יכולים להשתמש ב-Vertex AI כדי לפתח מודלים משלכם.
- יעילות משופרת: אוטומציה נרחבת שעוזרת לצמצם את העבודה הקשה של פריסת תשתית ופיתוח מודלים של AI גנרטיבי ו-ML. האוטומציה מאפשרת לכם להתמקד במשימות בעלות ערך מוסף, כמו תכנון מודלים וניסויים.
- שיפור הפיקוח והביקורת: התוכנית הזו כוללת יכולת שחזור, יכולת מעקב ופריסה מבוקרת של מודלים. היתרון הזה מאפשר לכם לנהל טוב יותר את מחזור החיים של מודל ה-AI הגנרטיבי וה-ML, ועוזר להבטיח שתוכלו לאמן מחדש ולהעריך מודלים באופן עקבי, עם נתיבי ביקורת ברורים.
- אבטחה: התבנית מותאמת לדרישות של המסגרת של המכון הלאומי לתקנים וטכנולוגיה (NIST) ושל המסגרת של המכון לסיכוני סייבר (CRI).
התוכנית ל-AI גנרטיבי ול-ML בארגונים כוללת את הרכיבים הבאים:
מאגר GitHub שמכיל קבוצה של הגדרות Terraform, Jupyter Notebook, הגדרה של Vertex AI Pipelines, גרף אציקלי מכוון (DAG) של Managed Service for Apache Airflow וסקריפטים נלווים. הרכיבים במאגר מבצעים את הפעולות הבאות:
- התצורה של Terraform מגדירה פלטפורמה לפיתוח מודלים של Vertex AI שיכולה לתמוך בכמה צוותים לפיתוח מודלים.
- ה-notebook של Jupyter מאפשר לפתח מודל באופן אינטראקטיבי.
- Managed Airflow DAG מספק את מסגרת התזמור העיקרית ל-notebook של Jupyter בסביבות ייצור.
- ההגדרה של Vertex AI Pipelines מספקת חלופה לתזמור של משימות למידת מכונה ייעודיות לתהליכי עבודה מבוססי-קונטיינרים ולמשימות אימון שכלולות כולן בסביבה של Vertex AI.
- הסקריפטים הנלווים עוזרים לפרוס את הקוד ואת צינורות עיבוד הנתונים של Terraform.
מדריך לארכיטקטורה, לעיצוב, לאמצעי הבקרה של האבטחה ולתהליכים התפעוליים שאתם מטמיעים באמצעות התוכנית הזו (המסמך הזה).
תוכנית המערך ל-AI גנרטיבי ול-ML בארגונים תואמת לתוכנית המערך ליסודות הארגון. תוכנית האב ליסודות הארגון מספקת כמה שירותים ברמת הבסיס שתוכנית האב הזו מסתמכת עליהם, כמו רשתות VPC. אתם יכולים לפרוס את המערך של ה-AI הגנרטיבי וה-ML לארגונים בלי לפרוס את המערך של יסודות הארגון, אם סביבת Google Cloud מספקת את הפונקציונליות הנדרשת כדי לתמוך במערך של ה-AI הגנרטיבי וה-ML לארגונים.
המסמך הזה מיועד לאדריכלי ענן, למדעני נתונים ולמהנדסי נתונים שיכולים להשתמש בתוכנית כדי ליצור ולפרוס מודלים חדשים של למידת מכונה או של AI גנרטיבי ב- Google Cloud. המסמך הזה מניח שאתם מכירים את פיתוח המודלים של AI גנרטיבי ו-ML ואת פלטפורמת למידת המכונה Vertex AI.
במאמר נקודת המבט של AI ו-ML ב-Well-Architected Framework מפורטים עקרונות והמלצות לארכיטקטורה שספציפיים לעומסי עבודה של AI ו-ML ב- Google Cloud.
סקירה כללית על תוכנית ל-AI גנרטיבי ול-ML בארגונים
התוכנית של AI גנרטיבי ו-ML לארגונים מבוססת על גישה שכבתית, כדי לספק את היכולות שמאפשרות לאמן מודלים של AI גנרטיבי ו-ML. את המערכת לדוגמה פורסים ומנהלים באמצעות תהליך עבודה של תפעול למידת מכונה (MLOps). בתרשים הבא מוצג הקשר בין שכבת ה-MLOps שנפרסה על ידי המערך הזה לבין שכבות אחרות בסביבה שלכם.
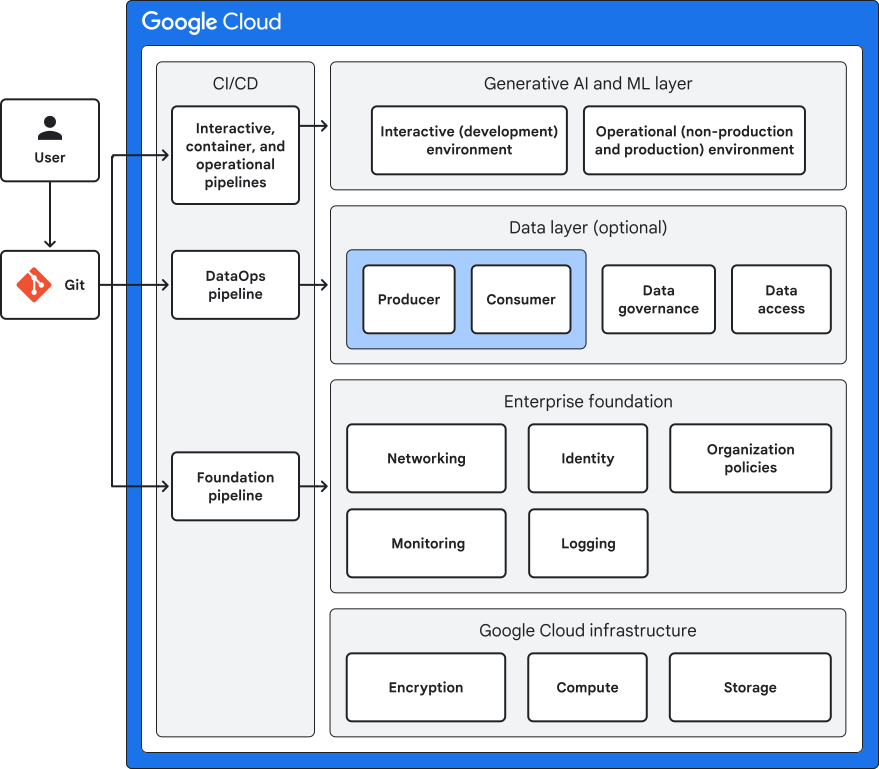
התרשים הזה כולל את הפריטים הבאים:
- Google Cloud התשתית מספקת לכם יכולות אבטחה כמו הצפנה במנוחה והצפנה במעבר, וגם אבני בניין בסיסיות כמו מחשוב ואחסון.
- הבסיס הארגוני מספק לכם משאבים בסיסיים כמו זהות, רשת, רישום ביומן, מעקב ומערכות פריסה שמאפשרים לכם להשתמש ב- Google Cloud לעומסי העבודה שלכם ב-AI.
- שכבת הנתונים היא שכבה אופציונלית בסטאק הפיתוח, שמספקת יכולות שונות כמו הטמעת נתונים, אחסון נתונים, בקרת גישה לנתונים, משילות מידע (data governance), מעקב אחרי נתונים ושיתוף נתונים.
- שכבת ה-AI הגנרטיבי וה-ML (התוכנית הזו) מאפשרת לפתח ולפרוס מודלים. אתם יכולים להשתמש בשכבה הזו כדי לחקור נתונים ראשוניים, לבצע ניסויים, לאמן מודלים, לפרסם מודלים ולעקוב אחריהם.
- CI/CD מספק לכם את הכלים להפוך את ההקצאה, ההגדרה, הניהול והפריסה של התשתית, תהליכי העבודה ורכיבי התוכנה לאוטומטיים. הרכיבים האלה עוזרים לכם לוודא שהפריסות עקביות, אמינות וניתנות לביקורת, לצמצם שגיאות ידניות ולהאיץ את מחזור הפיתוח הכולל.
כדי להראות איך משתמשים בסביבת ה-AI הגנרטיבי וה-ML, התוכנית כוללת פיתוח של מודל ML לדוגמה. בפיתוח המודל לדוגמה תלמדו איך לבנות מודל, ליצור צינורות עיבוד נתונים תפעוליים, לאמן את המודל, לבדוק אותו ולפרוס אותו.
ארכיטקטורה
התוכנית של AI גנרטיבי ו-ML לארגונים מאפשרת לכם לעבוד ישירות עם נתונים. אתם יכולים ליצור מודלים בסביבה אינטראקטיבית (פיתוח) ולקדם את המודלים לסביבה תפעולית (ייצור או לא ייצור).
בסביבה האינטראקטיבית, מפתחים מודלים של ML באמצעות Vertex AI Workbench, שהוא שירות Jupyter Notebook שמנוהל על ידי Google. אתם מפתחים יכולות של חילוץ נתונים, טרנספורמציה של נתונים וכוונון מודלים בסביבה האינטראקטיבית, ומקדמים אותן לסביבה התפעולית.
בסביבה התפעולית (לא סביבת ייצור), משתמשים בצינורות עיבוד נתונים כדי לבנות ולבדוק את המודלים באופן שניתן לחזור עליו ולשלוט בו. אחרי שאתם מרוצים מהביצועים של המודל, אתם יכולים לפרוס אותו בסביבה התפעולית (ייצור). הדיאגרמה הבאה מציגה את הרכיבים השונים של הסביבות האינטראקטיביות וסביבות התפעול.
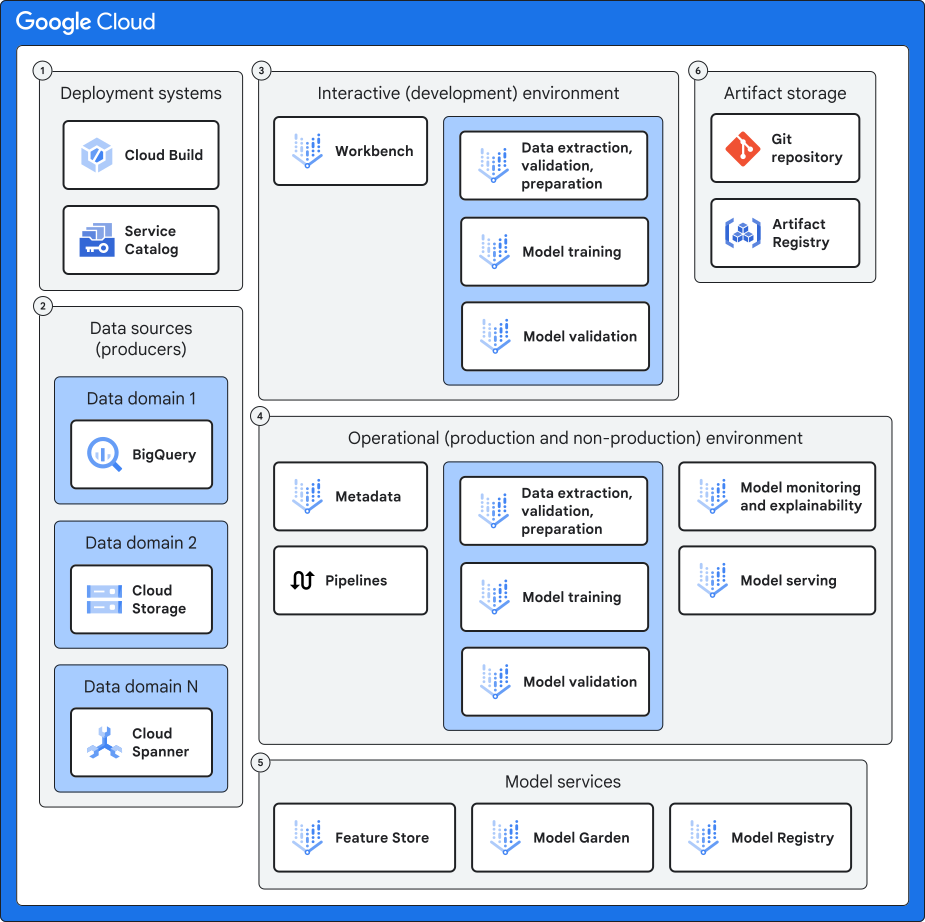
התרשים הזה כולל את הפריטים הבאים:
- מערכות פריסה: שירותים כמו Service Catalog ו-Cloud Build פורסים משאבי Google Cloud בסביבה האינטראקטיבית. בנוסף, Cloud Build פורס משאבי Google Cloud ותהליכי עבודה לבניית מודלים בסביבה התפעולית.
- מקורות נתונים: שירותים כמו BigQuery, Cloud Storage, Spanner ו-AlloyDB ל-PostgreSQL מארחים את הנתונים שלכם. התבנית כוללת נתונים לדוגמה ב-BigQuery וב-Cloud Storage.
- סביבה אינטראקטיבית: סביבה שבה אפשר לבצע אינטראקציה ישירה עם נתונים, לערוך ניסויים במודלים ולבנות צינורות עיבוד נתונים לשימוש בסביבה התפעולית.
- סביבה תפעולית: סביבה שבה אפשר לבנות ולבדוק את המודלים באופן שניתן לחזור עליו, ואז לפרוס את המודלים בסביבת הייצור.
- שירותי מודלים: השירותים הבאים תומכים בפעילויות שונות של MLOps:
- Vertex AI Feature Store מספק נתוני מאפיינים למודל.
- Model Garden כולל ספריית מודלים של למידת מכונה שמאפשרת להשתמש במודלים של Google ובמודלים נבחרים בקוד פתוח.
- מרשם המודלים של Vertex AI מנהל את מחזור החיים של המודלים של למידת המכונה.
- אחסון פריטי מידע שנוצרו בתהליך הפיתוח (Artifact): השירותים האלה מאחסנים את הקוד והקונטיינרים לפיתוח המודלים ולצינורות עיבוד הנתונים. השירותים האלה כוללים:
- ב-Artifact Registry מאוחסנים קונטיינרים שמשמשים צינורות עיבוד נתונים בסביבה התפעולית כדי לשלוט בשלבים השונים של פיתוח המודל.
- מאגר Git שומר את ה-code base של הרכיבים השונים שמשמשים לפיתוח המודל.
פרסונות בפלטפורמה
כשפורסים את ה-blueprint, יוצרים ארבעה סוגים של קבוצות משתמשים: קבוצת מהנדסי MLOps, קבוצת מהנדסי DevOps, קבוצת מדעני נתונים וקבוצת מהנדסי מערכות מידע. תחומי האחריות של הקבוצות:
- הקבוצה מהנדסי MLOps מפתחת את התבניות של Terraform שמשמשות את Service Catalog. הצוות הזה מספק תבניות שמשמשות מודלים רבים.
- קבוצת מהנדסי DevOps מאשרת את התבניות של Terraform שנוצרו על ידי קבוצת מפתחי MLOps.
- קבוצת מדעני הנתונים מפתחת מודלים, צינורות עיבוד נתונים וקונטיינרים שמשמשים את צינורות עיבוד הנתונים. בדרך כלל, צוות אחד מוקדש לבניית מודל אחד.
- הקבוצה Data engineer מאשרת את השימוש ברכיבים שקבוצת מדע הנתונים יוצרת.
המבנה הארגוני
התוכנית הזו משתמשת במבנה הארגוני של התוכנית Enterprise Foundation כבסיס לפריסת עומסי עבודה של AI ו-ML. בתרשים הבא מוצגים הפרויקטים שנוספו ליסודות כדי לאפשר עומסי עבודה של AI ו-ML.
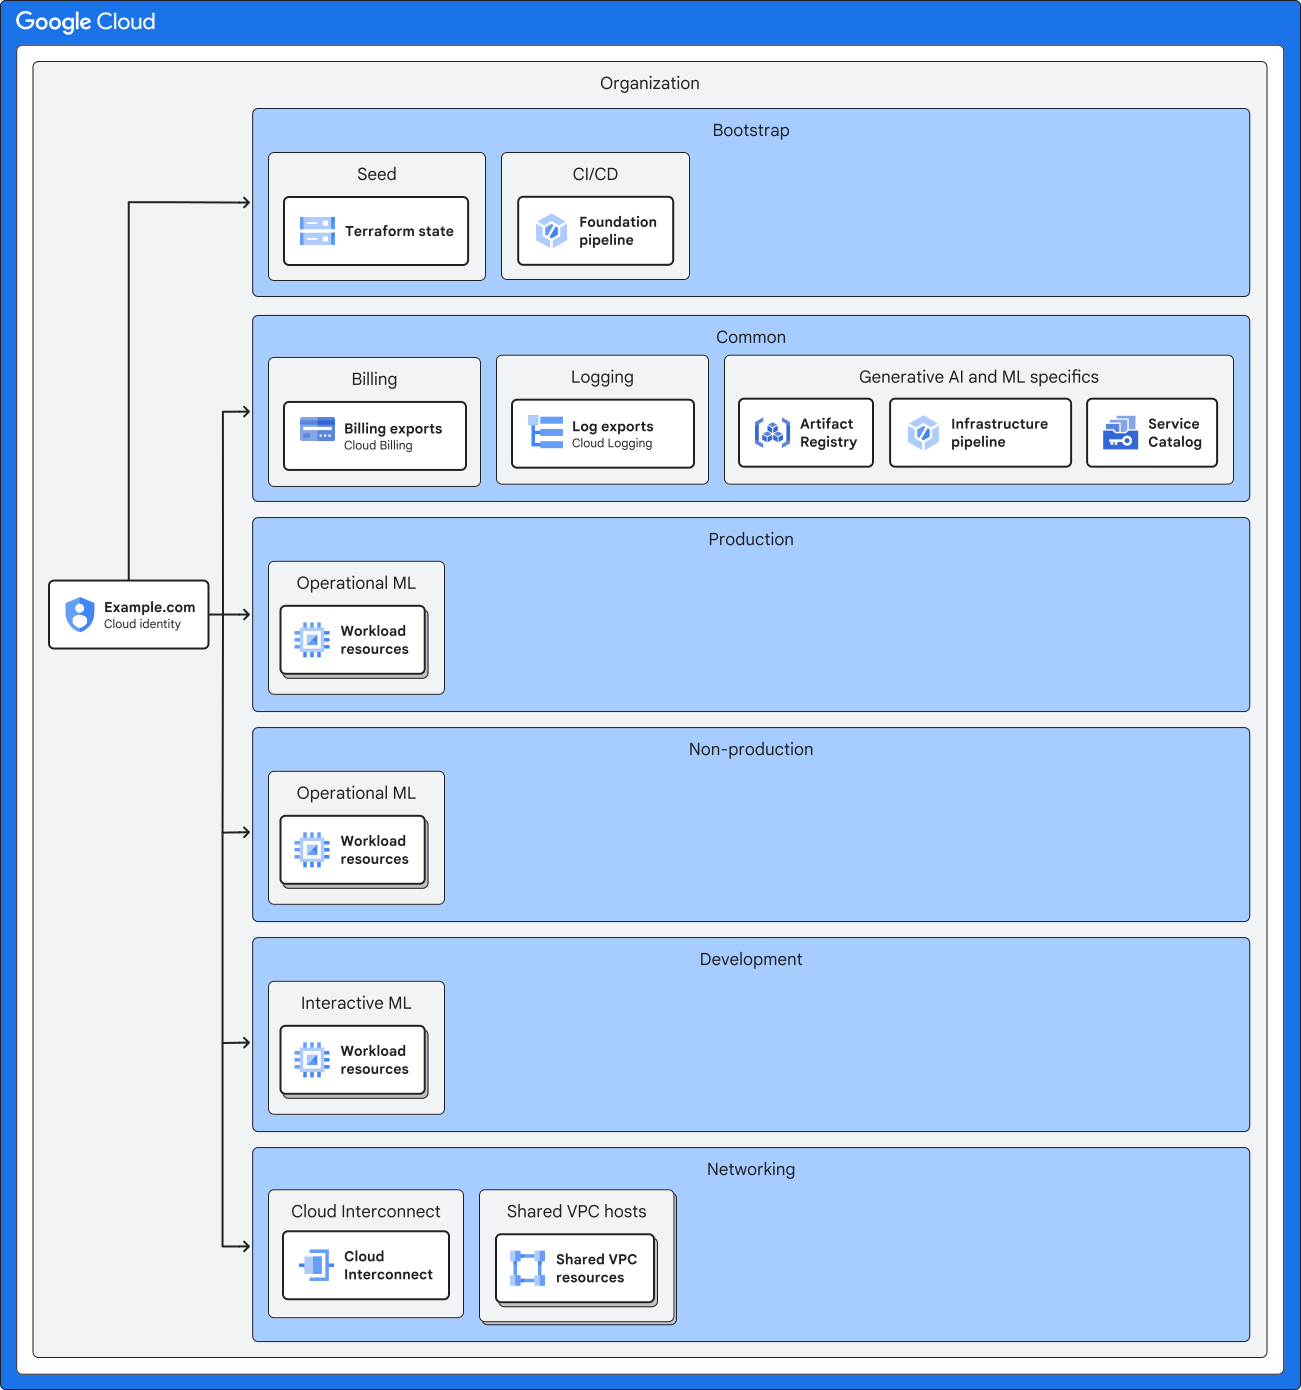
בטבלה הבאה מתוארים הפרויקטים שמשמשים את התוכנית ל-AI גנרטיבי ול-ML.
| תיקייה | פרויקט | תיאור |
|---|---|---|
|
|
מכיל את צינור עיבוד הנתונים לפריסה שמשמש ליצירת רכיבי ה-AI הגנרטיבי וה-ML של התוכנית. מידע נוסף זמין בקטע צינור עיבוד נתונים של תשתית בתוכנית הארגונית הבסיסית. |
|
מכיל את התשתית שמשמשת את Service Catalog לפריסת משאבים בסביבה האינטראקטיבית. | |
|
|
מכיל את הרכיבים לפיתוח תרחיש לדוגמה של AI ו-ML במצב אינטראקטיבי. |
|
|
מכיל את הרכיבים לבדיקה ולהערכה של תרחיש לדוגמה של AI ו-ML שאפשר לפרוס בסביבת הייצור. |
|
|
מכיל את הרכיבים לפריסת תרחיש לדוגמה של AI ו-ML בסביבת ייצור. |
Networking
התוכנית משתמשת ברשת ה-VPC המשותפת שנוצרה בתוכנית הבסיסית לארגונים. בסביבה האינטראקטיבית (פיתוח), ה-notebooks של Vertex AI Workbench נפרסים בפרויקטים של שירותים. משתמשים מקומיים יכולים לגשת לפרויקטים באמצעות מרחב כתובות ה-IP הפרטיות ברשת ה-VPC המשותפת. משתמשים מקומיים יכולים לגשת לממשקי Google Cloud API, כמו Cloud Storage, דרך Private Service Connect. לכל רשת VPC משותפת (פיתוח, סביבה ללא ייצור וסביבת ייצור) יש נקודת קצה נפרדת של Private Service Connect.
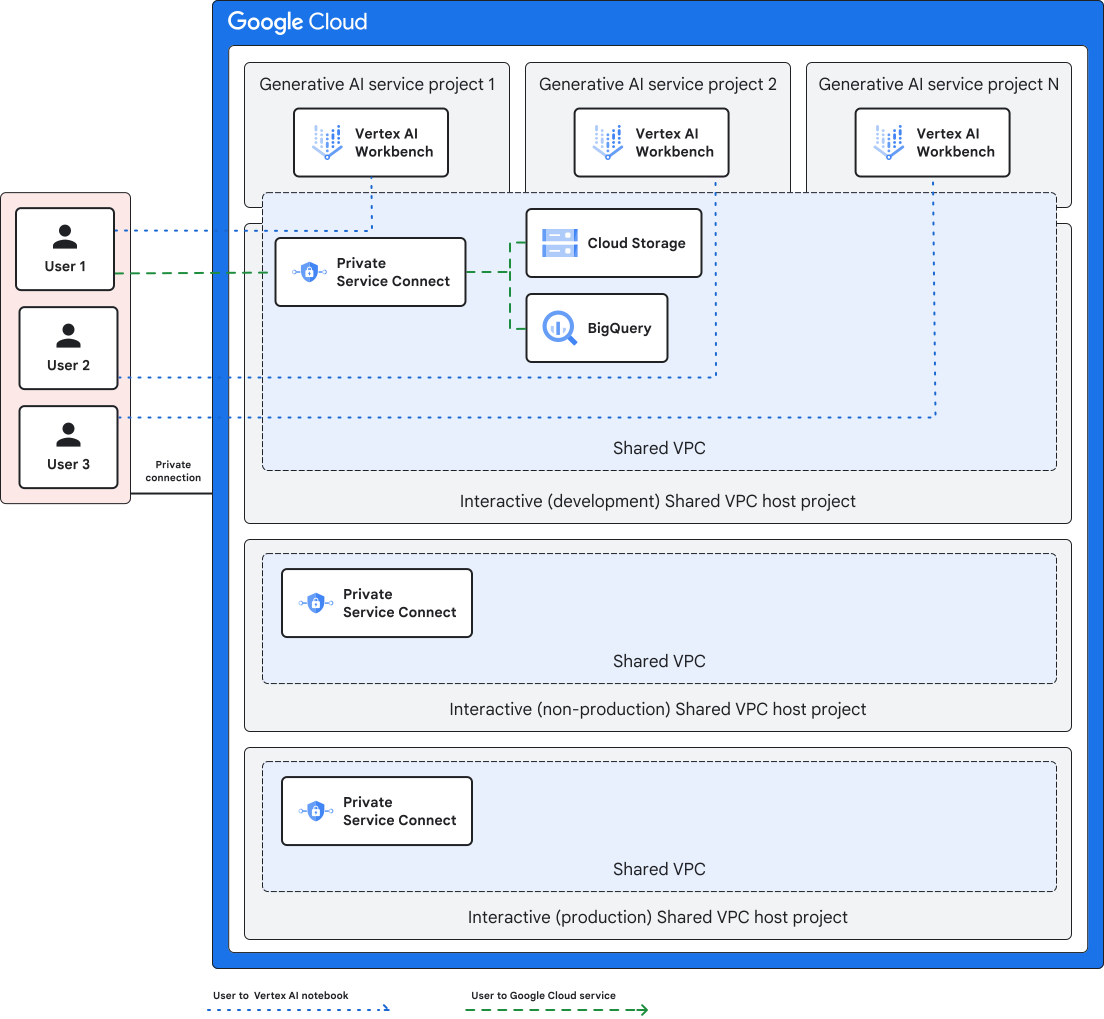
בסביבה התפעולית (ללא ייצור וייצור) יש שתי רשתות VPC משותפות נפרדות, שמשאבים מקומיים יכולים לגשת אליהן באמצעות כתובות IP פרטיות. הסביבות האינטראקטיביות והתפעוליות מוגנות באמצעות VPC Service Controls.
Cloud Logging
התבנית הזו משתמשת ביכולות של Cloud Logging שכלולות בתבנית הבסיסית לארגונים.
Cloud Monitoring
כדי לעקוב אחרי משימות אימון בהתאמה אישית, התוכנית כוללת לוח בקרה שמאפשר לעקוב אחרי המדדים הבאים:
- ניצול המעבד (CPU) של כל צומת אימון
- ניצול הזיכרון של כל צומת אימון
- שימוש ברשת
אם משימת אימון בהתאמה אישית נכשלה, התוכנית משתמשת ב-Cloud Monitoring כדי לספק לכם מנגנון התראות באימייל שיודיע לכם על הכישלון. כדי לעקוב אחרי מודלים שנפרסו ומשתמשים בנקודת הקצה של Vertex AI, התוכנית כוללת מרכז בקרה עם המדדים הבאים:
- מדדים לבדיקת ביצועים:
- חיזויים לשנייה
- זמן האחזור של המודל
- שימוש במשאבים:
- שימוש במעבד (CPU)
- ניצול הזיכרון
הגדרת מדיניות הארגון
בנוסף לכללי המדיניות של הארגון שנוצרו על ידי המערך הבסיסי לארגונים, המערך הזה מוסיף את כללי המדיניות של הארגון שמפורטים בקטע מערך מוגדר מראש לאבטחת AI, מורחב.
תפעול
בקטע הזה מתוארות הסביבות שכלולות בתבנית.
סביבה אינטראקטיבית
כדי לאפשר לכם לחקור נתונים ולפתח מודלים תוך שמירה על מצב האבטחה של הארגון, הסביבה האינטראקטיבית מספקת לכם קבוצה מבוקרת של פעולות שאתם יכולים לבצע. אפשר לפרוס משאבי Google Cloudבאחת מהשיטות הבאות:
- שימוש ב-Service Catalog, שמוגדר מראש באמצעות אוטומציה עם תבניות של משאבים
- יצירת פריטי קוד ושמירה שלהם במאגרי Git באמצעות Vertex AI Workbench notebooks
התרשים הבא מתאר את הסביבה האינטראקטיבית.
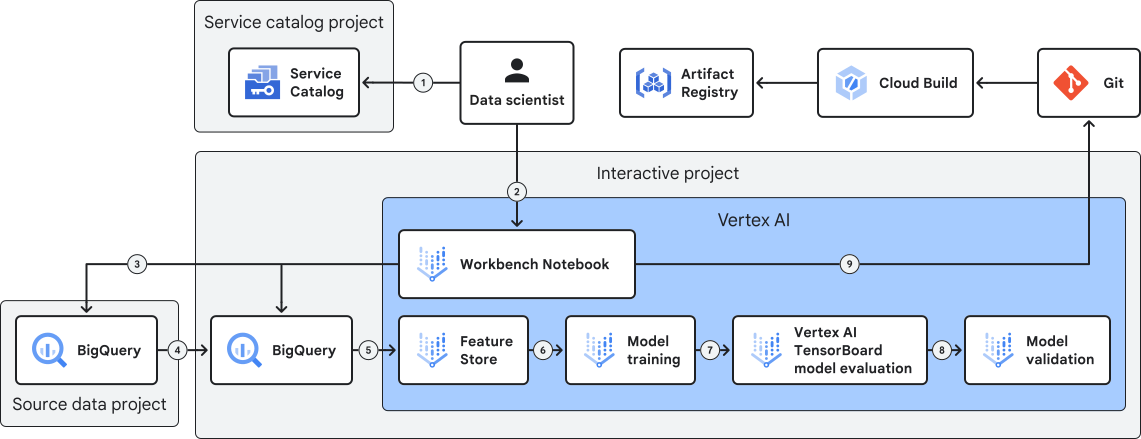
תהליך אינטראקטיבי טיפוסי כולל את השלבים והרכיבים הבאים:
- ב-Service Catalog יש רשימה של משאביGoogle Cloud שמדעני נתונים יכולים לפרוס בסביבה האינטראקטיבית. מדען הנתונים פורס את משאב ה-notebook של Vertex AI Workbench מ-Service Catalog.
- מדעני נתונים משתמשים ב-notebooks של Vertex AI Workbench כממשק הראשי לעבודה עם משאבי Google Cloud שפרוסים בסביבה האינטראקטיבית. ה-notebooks מאפשרים למדעני נתונים לשלוף את הקוד שלהם מ-Git ולעדכן אותו לפי הצורך.
- נתוני המקור מאוחסנים מחוץ לסביבה האינטראקטיבית ומנוהלים בנפרד מהתוכנית הזו. הגישה לנתונים נשלטת על ידי בעלי הנתונים. מדעני נתונים יכולים לבקש גישת קריאה לנתוני המקור, אבל הם לא יכולים לכתוב לנתוני המקור.
- מדעני נתונים יכולים להעביר נתוני מקור לסביבה האינטראקטיבית למשאבים שנוצרו באמצעות Service Catalog. בסביבה האינטראקטיבית, מדעני נתונים יכולים לקרוא, לכתוב ולשנות את הנתונים. עם זאת, מדעני נתונים לא יכולים להעביר נתונים מחוץ לסביבה האינטראקטיבית או לתת גישה למשאבים שנוצרו על ידי Service Catalog. ב-BigQuery מאוחסנים נתונים מובְנים ונתונים מובְנים למחצה, וב-Cloud Storage מאוחסנים נתונים לא מובְנים.
- Feature Store מספק למדעני נתונים גישה בזמן אחזור קצר למאפיינים לאימון מודלים.
מדעני נתונים מאמנים מודלים באמצעות משימות אימון בהתאמה אישית של Vertex AI. התוכנית גם משתמשת ב-Vertex AI לכוונון היפר-פרמטרים.
מדעני נתונים מעריכים מודלים באמצעות Vertex AI Experiments ו-Vertex AI TensorBoard. ב-Vertex AI Experiments אפשר להריץ כמה אימונים של מודל באמצעות פרמטרים, שיטות מידול, ארכיטקטורות וקלט שונים. בעזרת Vertex AI TensorBoard אתם יכולים לעקוב אחרי הניסויים השונים שהרצתם, להציג אותם חזותית ולהשוות ביניהם, ואז לבחור את המודל עם המאפיינים הכי טובים שזיהיתם כדי לאמת אותו.
מדעני נתונים מאמתים את המודלים שלהם באמצעות הערכה של Vertex AI. כדי לאמת את המודלים, מדעני נתונים מפצלים את נתוני המקור לקבוצת נתונים לאימון ולקבוצת נתונים לאימות, ומריצים הערכה של Vertex AI על המודל.
מדעני נתונים יוצרים קונטיינרים באמצעות Cloud Build, מאחסנים אותם ב-Artifact Registry ומשתמשים בהם בצינורות עיבוד נתונים בסביבה התפעולית.
סביבת תפעול
הסביבה התפעולית משתמשת במאגר Git ובצינורות עיבוד נתונים. הסביבה הזו כוללת את סביבת הייצור ואת הסביבה ללא ייצור של תוכנית האב ליסודות הארגון. בסביבה שאינה סביבת ייצור, מדען הנתונים בוחר צינור עיבוד נתונים מבין צינורות עיבוד הנתונים שפותחו בסביבה האינטראקטיבית. מדען הנתונים יכול להריץ את צינור עיבוד הנתונים בסביבה שאינה סביבת ייצור, להעריך את התוצאות ואז לקבוע איזה מודל לקדם לסביבת הייצור.
התוכנית כוללת צינור עיבוד נתונים לדוגמה שנבנה באמצעות Managed Airflow וצינור עיבוד נתונים לדוגמה שנבנה באמצעות Vertex AI Pipelines. בתרשים הבא מוצגת סביבת העבודה.
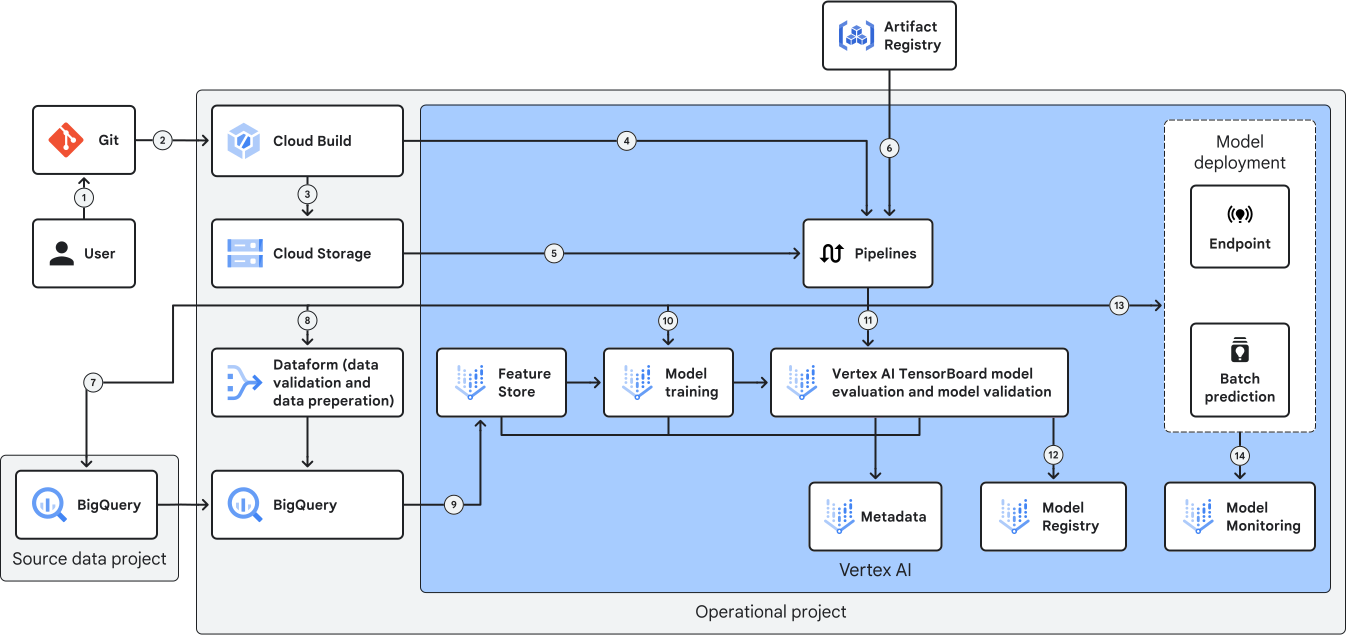
תהליך תפעולי אופייני כולל את השלבים הבאים:
- מדען נתונים ממזג בהצלחה ענף פיתוח לענף פריסה.
- המיזוג להסתעפות הפריסה מפעיל צינור עיבוד נתונים ב-Cloud Build.
- אחד מהמקרים הבאים מתרחש:
- אם מדען נתונים משתמש ב-Managed Airflow בתור כלי התזמור, צינור עיבוד הנתונים של Cloud Build מעביר DAG ל-Cloud Storage.
- אם מדען הנתונים משתמש ב-Vertex AI Pipelines בתור כלי התזמור, הצינור מעביר קובץ Python ל-Cloud Storage.
- צינור עיבוד הנתונים של Cloud Build מפעיל את כלי התזמור (Managed Airflow או Vertex AI Pipelines).
- הכלי לניהול סוכנים שולף את הגדרת צינור עיבוד הנתונים מ-Cloud Storage ומתחיל להריץ את צינור עיבוד הנתונים.
- צינור עיבוד הנתונים שולף קונטיינר מ-Artifact Registry, שמשמש את כל השלבים בצינור עיבוד הנתונים כדי להפעיל את שירותי Vertex AI.
- צינור עיבוד הנתונים, באמצעות הקונטיינר, מפעיל העברת נתונים מפרויקט נתוני המקור לסביבה התפעולית.
- הנתונים עוברים טרנספורמציה, אימות, פיצול והכנה לאימון ולאימות של המודל על ידי צינור עיבוד הנתונים.
- במקרה הצורך, צינור עיבוד הנתונים מעביר את הנתונים אל Vertex AI Feature Store כדי שיהיה קל לגשת אליהם במהלך אימון המודל.
- הצינור משתמש באימון מודלים בהתאמה אישית של Vertex AI כדי לאמן את המודל.
- הצינור משתמש בהערכה של Vertex AI כדי לאמת את המודל.
- הצינור מעביר מודל מאומת אל Model Registry, ומייבא אותו.
- לאחר מכן, המודל המיובא משמש ליצירת חיזויים באמצעות חיזויים אונליין או חיזויים באצווה.
- אחרי שהמודל נפרס בסביבת הייצור, הצינור משתמש ב-Vertex AI Model Monitoring כדי לזהות אם הביצועים של המודל יורדים, על ידי מעקב אחרי training-serving skew וסחף נתוני חיזויים (prediction).
פריסה
התוכנית משתמשת בסדרה של צינורות עיבוד נתונים ב-Cloud Build כדי להקצות את התשתית של התוכנית, את צינור עיבוד הנתונים בסביבה התפעולית ואת הקונטיינרים שמשמשים ליצירת מודלים של AI גנרטיבי ו-ML. אלה הצינורות שבהם משתמשים והמשאבים שמוקצים:
- צינור עיבוד נתונים של תשתית: צינור עיבוד הנתונים הזה הוא חלק מהתוכנית הארגונית הבסיסית. הצינור הזה מקצה את משאבי Google Cloud שמשויכים לסביבה האינטראקטיבית ולסביבה התפעולית.
- צינור עיבוד נתונים אינטראקטיבי: צינור עיבוד הנתונים האינטראקטיבי הוא חלק מהסביבה האינטראקטיבית. הצינור הזה מעתיק תבניות Terraform ממאגר Git לקטגוריה של Cloud Storage ש-Service Catalog יכול לקרוא. הצינור האינטראקטיבי מופעל כשמבוצעת בקשת משיכה (pull request) למיזוג עם ההסתעפות הראשית.
- צינור עיבוד נתונים של קונטיינרים: התוכנית כוללת צינור עיבוד נתונים של Cloud Build כדי ליצור קונטיינרים שמשמשים בצינור עיבוד הנתונים התפעולי. קונטיינרים שנפרסים בסביבות שונות הם קובצי אימג' של קונטיינרים שלא ניתנים לשינוי. קובצי אימג' של קונטיינרים שלא ניתנים לשינוי עוזרים להבטיח שאותו קובץ אימג' ייפרס בכל הסביבות, ושאי אפשר יהיה לשנות אותו בזמן שהוא פועל. אם צריך לשנות את האפליקציה, צריך לבנות מחדש את קובץ האימג' ולפרוס אותו מחדש. קובצי האימג' של הקונטיינרים שמשמשים בתוכנית מאוחסנים ב-Artifact Registry, וקובצי התצורה שמשמשים בצינור עיבוד הנתונים התפעולי מפנים אליהם.
- צינור עיבוד נתונים תפעולי: צינור עיבוד הנתונים התפעולי הוא חלק מסביבת התפעול. הצינור הזה מעתיק קובצי DAG ל-Managed Airflow או ל-Vertex AI Pipelines, שמשמשים לאחר מכן לבנייה, לבדיקה ולפריסה של מודלים.
קטלוג השירותים
בעזרת Service Catalog, מפתחים ואדמינים בענן יכולים להפוך את הפתרונות שלהם לזמינים לשימוש של משתמשים בגרסה הארגונית. המודולים של Terraform ב-Service Catalog נוצרים ומתפרסמים כפריטי מידע שנוצר בקטגוריה של Cloud Storage, באמצעות צינור עיבוד הנתונים של CI/CD ב-Cloud Build. אחרי שהמודולים מועתקים לקטגוריה, המפתחים יכולים להשתמש בהם כדי ליצור פתרונות Terraform בדף הניהול של Service Catalog, להוסיף את הפתרונות ל-Service Catalog ולשתף אותם עם פרויקטים של סביבה אינטראקטיבית כדי שהמשתמשים יוכלו לפרוס את המשאבים.
הסביבה האינטראקטיבית משתמשת ב-Service Catalog כדי לאפשר למדעני נתונים לפרוס משאבי Google Cloud באופן שתואם למצב האבטחה של הארגון. כשמפתחים מודל שדורש משאבים שלGoogle Cloud , כמו קטגוריה של Cloud Storage, מדען הנתונים בוחר את המשאב מ-Service Catalog, מגדיר את המשאב ופורס אותו בסביבה האינטראקטיבית. ב-Service Catalog יש תבניות מוגדרות מראש למשאבים שונים של Google Cloud , שמדען הנתונים יכול לפרוס בסביבה האינטראקטיבית. מדען הנתונים לא יכול לשנות את תבניות המשאבים, אבל הוא יכול להגדיר את המשאבים באמצעות משתני ההגדרות שהתבנית חושפת. בתרשים הבא מוצג המבנה של הקשר בין Service Catalog לבין הסביבה האינטראקטיבית.
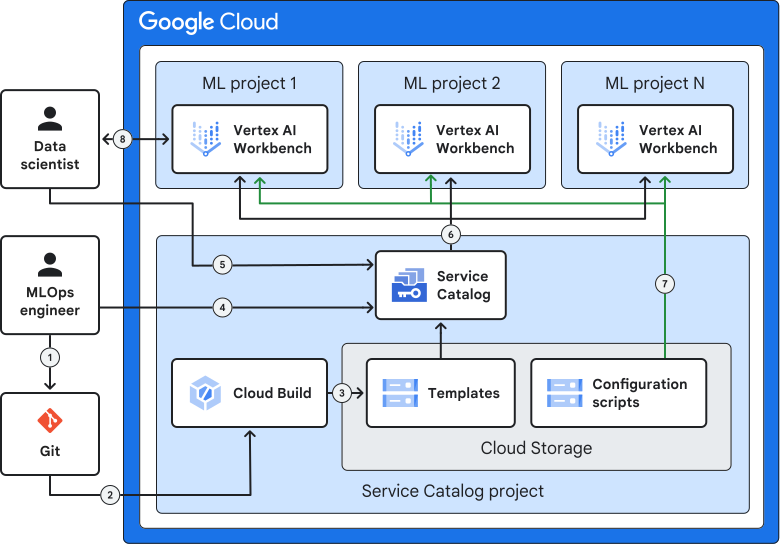
מדעני נתונים פורסים משאבים באמצעות Service Catalog, כפי שמתואר בשלבים הבאים:
- מהנדס ה-MLOps מכניס למאגר Git תבנית משאב של Terraform בשבילGoogle Cloud .
- ה-commit ל-Git מפעיל צינור עיבוד נתונים של Cloud Build.
- Cloud Build מעתיק את התבנית ואת כל קובצי התצורה המשויכים ל-Cloud Storage.
- מהנדס ה-MLOps מגדיר את הפתרונות של Service Catalog ואת Service Catalog באופן ידני. לאחר מכן, המהנדס משתף את Service Catalog עם פרויקט שירות בסביבה האינטראקטיבית.
- מדען הנתונים בוחר משאב מ-Service Catalog.
- קטלוג השירותים פורס את התבנית בסביבה האינטראקטיבית.
- המשאב שולף את כל סקריפטי ההגדרות הנדרשים.
- מדען הנתונים יוצר אינטראקציה עם המשאבים.
מאגרים
התהליכים שמתוארים בקטע פריסה מופעלים על ידי שינויים במאגרים התואמים שלהם. כדי לוודא שאף אחד לא יכול לבצע שינויים עצמאיים בסביבת הייצור, יש הפרדה בין תחומי האחריות של משתמשים שיכולים לשלוח קוד לבין משתמשים שיכולים לאשר שינויים בקוד. בטבלה הבאה מתוארים מאגרי התוכניות, המגישים והמאשרים שלהם.
| מאגר | פייפליין | תיאור | השולח/ת | הגורם המאשר |
|---|---|---|---|---|
|
תשתית |
מכיל את קוד Terraform של תוכנית ה-AI הגנרטיבי וה-ML שיוצרת את הסביבות האינטראקטיביות והתפעוליות. | מהנדס MLOps | מהנדס DevOps |
|
אינטראקטיבי | מכיל את התבניות של המשאבים שאפשר לפרוס באמצעות Service Catalog. | מהנדס MLOps | מהנדס DevOps |
|
מאגר | מכיל את הקונטיינרים שבהם אפשר להשתמש בצינורות עיבוד הנתונים בסביבה התפעולית. | מדעני נתונים | מהנדס מערכות מידע |
|
תפעולי | מכיל את קוד המקור שצינורות עיבוד הנתונים בסביבה התפעולית יכולים להשתמש בו. | מדעני נתונים | מהנדס מערכות מידע |
אסטרטגיית הסתעפות
התוכנית משתמשת בהסתעפות קבועה כדי לפרוס קוד בסביבה המשויכת. התוכנית משתמשת בשלושה ענפים (פיתוח, לא לייצור ולייצור) שמשקפים את הסביבות המתאימות.
אמצעי בקרה לאבטחה
תוכנית ה-AI הגנרטיבי וה-ML לארגונים משתמשת במודל אבטחה שכבתי להגנה לעומק, שמבוסס על יכולות ברירת המחדל של Google Cloud , שירותיGoogle Cloud ויכולות האבטחה שמוגדרות באמצעות תוכנית היסוד לארגונים. בתרשים הבא מוצגות השכבות של אמצעי הבקרה השונים לאבטחה בתבנית.
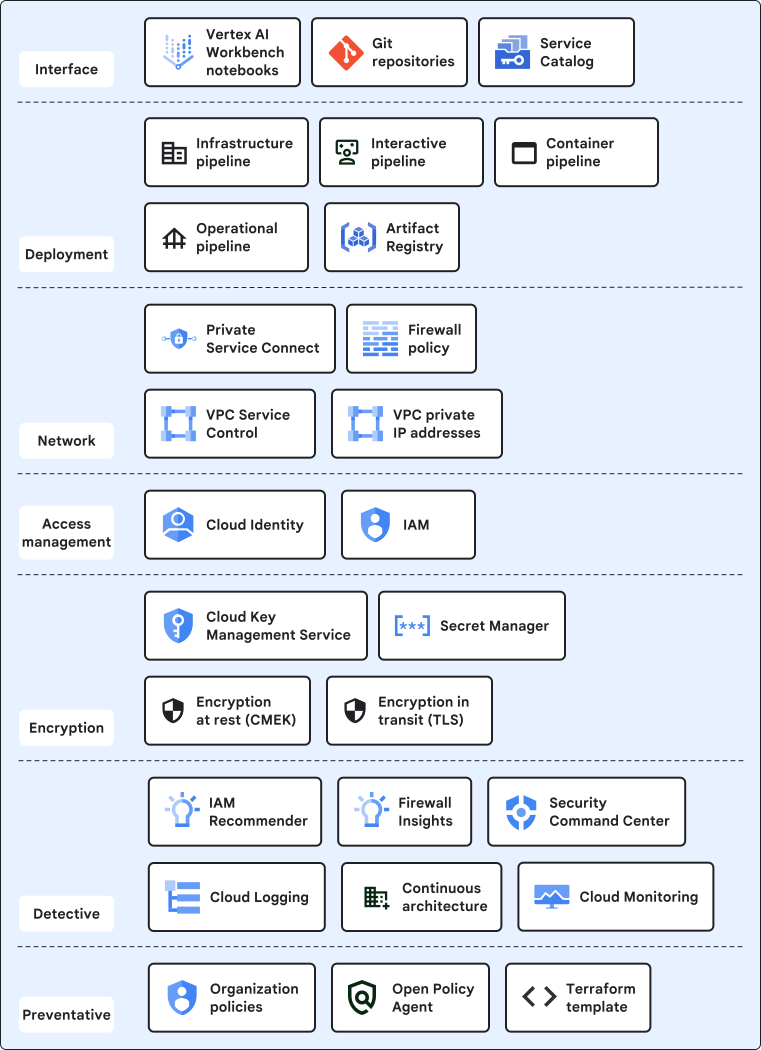
אלה הפונקציות של השכבות:
- ממשק: מספק למדעני נתונים שירותים שמאפשרים להם לקיים אינטראקציה עם התוכנית באופן מבוקר.
- פריסה: מספקת סדרה של צינורות עיבוד נתונים שפורסים תשתית, יוצרים קונטיינרים ויוצרים מודלים. השימוש בצינורות עיבוד נתונים מאפשר לבצע ביקורת, מעקב וחזרה על תהליכים.
- רשת: מספקת הגנה מפני זליגת נתונים סביב המשאבים של תוכנית האב בשכבת ה-API ובשכבת ה-IP.
- ניהול הרשאות גישה: קובע מי יכול לגשת לאילו משאבים, ועוזר למנוע שימוש לא מורשה במשאבים.
- הצפנה: מאפשרת לכם לשלוט במפתחות ההצפנה ובסודות שלכם, ועוזרת להגן על הנתונים באמצעות הצפנה במנוחה והצפנה במעבר כברירת מחדל.
- Detective: עוזר לזהות הגדרות שגויות ופעילות זדונית.
- מניעה: אמצעים לשליטה ולהגבלה של פריסת התשתית.
בטבלה הבאה מתוארים אמצעי הבקרה לאבטחה שמשויכים לכל שכבה.
| שכבה | משאב | אמצעי בקרה לאבטחה |
|---|---|---|
| ממשק | Vertex AI Workbench | מספק חוויית שימוש מנוהלת ב-notebook שכוללת בקרת גישה למשתמשים, בקרת גישה לרשת, בקרת גישה ל-IAM והשבתה של הורדות קבצים. התכונות האלה מאפשרות חוויית משתמש מאובטחת יותר. |
| מאגרים של Git | מספק בקרת גישה למשתמשים כדי להגן על המאגרים שלכם. | |
| קטלוג השירותים | מספק למדעני נתונים רשימה של משאבים שאפשר לפרוס רק בהגדרות שאושרו. | |
| פריסה | צינור עיבוד נתונים לתשתית | מספק תהליך מאובטח לפריסת התשתית של התוכנית באמצעות Terraform. |
| צינור עיבוד נתונים אינטראקטיבי | מספק תהליך מאובטח להעברת תבניות ממאגר Git לקטגוריה בארגון ב- Google Cloud . | |
| צינור עיבוד נתונים של קונטיינר | מספק תהליך מאובטח ליצירת קונטיינרים שמשמשים את צינור עיבוד הנתונים התפעולי. | |
| צינור עיבוד נתונים תפעולי | מספק תהליך מבוקר לאימון, לבדיקה, לאימות ולפריסה של מודלים. | |
| Artifact Registry | אחסון קובצי אימג' של קונטיינרים בצורה מאובטחת באמצעות בקרת גישה למשאבים | |
| רשת | התחברות לשירות פרטי | מאפשרת לכם לתקשר עם ממשקי Google Cloud API באמצעות כתובות IP פרטיות, כדי להימנע מחשיפת התנועה לאינטרנט. |
| VPC עם כתובות IP פרטיות | התוכנית משתמשת ברשתות VPC עם כתובות IP פרטיות כדי להסיר את החשיפה לאיומים באינטרנט. | |
| VPC Service Controls | עוזר להגן על משאבים מוגנים מפני זליגת נתונים. | |
| חומת אש | עוזר להגן על רשת ה-VPC מפני גישה לא מורשית. | |
| ניהול הרשאות גישה | Cloud Identity | ניהול משתמשים מרוכז, שמפחית את הסיכון לגישה לא מורשית. |
| IAM | מאפשרת שליטה פרטנית על מי יכול לעשות מה ובאילו משאבים, וכך מאפשרת ניהול הרשאות גישה עם הרשאות מינימליות. | |
| הצפנה | Cloud KMS | מאפשר לכם לשלוט במפתחות ההצפנה שמשמשים את הארגון שלכם ב-Google Cloud . |
| Secret Manager | מספק מאגר סודי למודלים שלכם, שנשלט על ידי IAM. | |
| הצפנה במנוחה | כברירת מחדל, Google Cloud מצפין נתונים במנוחה. | |
| הצפנה במעבר | כברירת מחדל, Google Cloud מצפינה נתונים במעבר. | |
| בלש/ית | Security Command Center | מספק גלאי איומים שעוזרים להגן על הארגון שלכם ב- Google Cloud. |
| ארכיטקטורה רציפה | בודק באופן קבוע את Google Cloud הארגון שלכם בהתאם לסדרה של כללי מדיניות של Open Policy Agent (OPA) שהגדרתם. | |
| שירות המלצות IAM | מנתח את הרשאות המשתמשים ומציע הצעות לצמצום ההרשאות כדי לעזור באכיפת העיקרון של הרשאות מינימליות. | |
| תובנות לגבי חומת האש | מנתח את הכללים של חומת האש, מזהה כללים מתירניים מדי ומציע כללים מגבילים יותר כדי לשפר את מצב האבטחה הכולל. | |
| Cloud Logging | מספקת תובנות לגבי הפעילות במערכת ועוזרת לזהות חריגות ופעילות זדונית. | |
| Cloud Monitoring | מעקב אחרי אותות ואירועים מרכזיים שיכולים לעזור בזיהוי פעילות חשודה. | |
| מניעה | שירות מדיניות הארגון | מאפשרת להגביל פעולות בארגון ב- Google Cloud. |
המאמרים הבאים
- פורסים את Terraform שמשויך לתוכנית הזו.
- מידע נוסף על תוכנית אב ליסודות של ארגונים
- מידע נוסף על Vertex AI
- מידע נוסף על MLOps ב- Google Cloud:
- MLOps ב-Vertex AI
- מדריך למשתמשים ב-MLOps: מסגרת לפיתוח רציף (continuous delivery) ולאוטומציה של למידת מכונה (PDF)
- MLOps: פיתוח רציף (continuous delivery) וצינורות עיבוד נתונים אוטומטיים בלמידת מכונה
- ארכיטקטורה ל-MLOps באמצעות TensorFlow Extended, Vertex AI Pipelines ו-Cloud Build
- קוד לדוגמה של Vertex AI Pipelines
- קוד לדוגמה של Vertex AI notebook
- במאמר נקודת המבט של AI ו-ML ב-Well-Architected Framework מפורטים עקרונות והמלצות לארכיטקטורה שספציפיים לעומסי עבודה של AI ו-ML ב- Google Cloud.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.