


Este documento apresenta uma arquitetura de alto nível para um sistema de IA agêntica multiagente que consolida dados multimodais fragmentados em um mapa de informações pesquisável. O sistema permite que os usuários façam upload de dados e usem o Mapa de Informações para identificar possíveis problemas ou riscos sistêmicos. A arquitetura permite que os agentes naveguem por redes de dados complexas e mantenham a personalização de longo prazo. Ele garante que os recursos distribuídos correspondam aos requisitos de pesquisa com continuidade.
O GraphRAG é uma abordagem baseada em gráficos para a geração aumentada por recuperação (RAG). A RAG ajuda a embasar as respostas geradas com IA, aumentando os comandos com dados contextualmente relevantes que são recuperados usando a busca vetorial. O GraphRAG combina a pesquisa vetorial com uma consulta de mapa de informações para recuperar dados de contexto que refletem melhor a interconexão de dados de diversas fontes. Os comandos aumentados usando o GraphRAG podem gerar respostas de IA mais detalhadas e relevantes.
O público-alvo deste documento inclui arquitetos, desenvolvedores e administradores que criam e gerenciam infraestrutura e aplicativos de IA na nuvem. Este documento pressupõe que você tenha um entendimento básico sobre agentes e modelos de IA. O documento não fornece orientações específicas para projetar e programar agentes de IA.
A seção de implantação deste documento fornece um exemplo de código que demonstra como definir um esquema do Spanner Graph e vincular entidades multimodais para recuperação agêntica.
Arquitetura
Confira a seguir uma visão geral da arquitetura de um sistema de IA agêntica multiagente que permite a orquestração de recursos do GraphRAG multimodal:
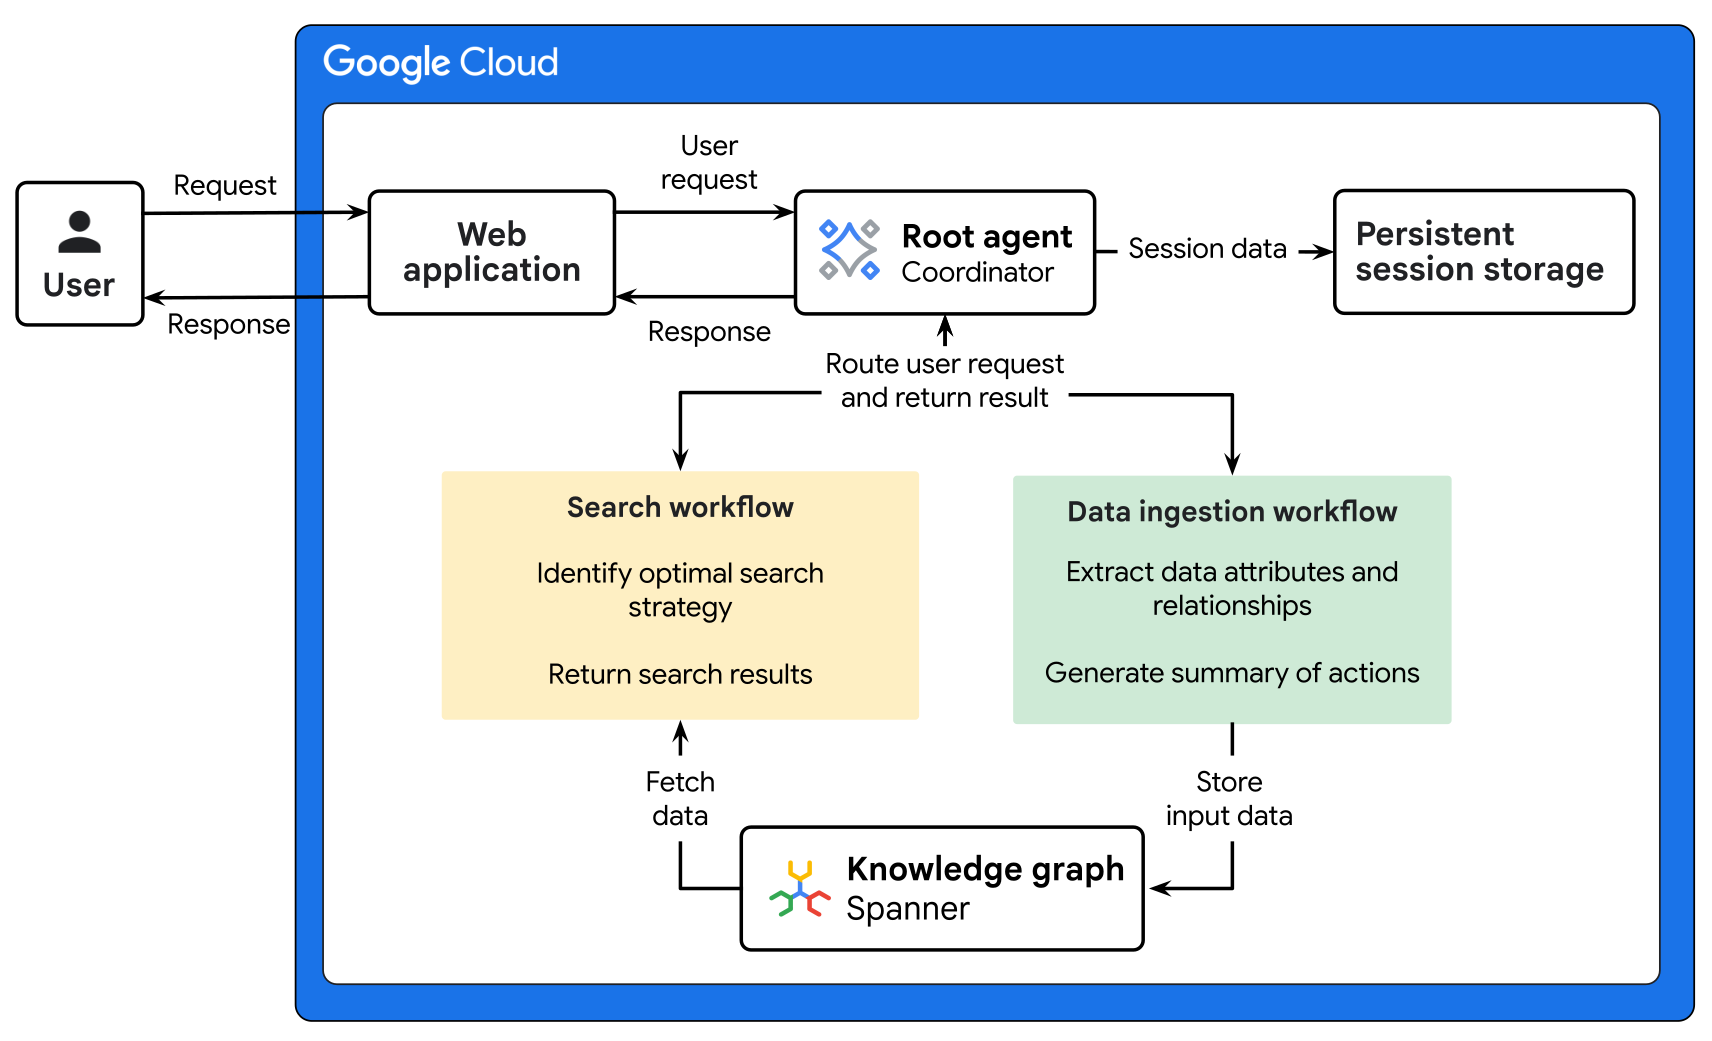
A arquitetura no diagrama anterior tem dois fluxos de trabalho: ingestão de dados e pesquisa.
- O fluxo de trabalho de ingestão de dados consolida registros multimodais fragmentados no mapa de informações unificado. Esse fluxo de trabalho usa um padrão sequencial de vários agentes para fazer upload de dados brutos para o Cloud Storage, extrair relações complexas usando o Gemini e atualizar o mapa de informações do Spanner Graph para garantir que os dados estejam disponíveis para recuperação.
- O fluxo de trabalho de pesquisa permite recuperar insights e embasar respostas por um processo do GraphRAG. Esse fluxo de trabalho usa o Gemini e subagentes especializados para navegar no Mapa de Informações e consolidar as descobertas com base nos dados da sessão anterior.
As guias a seguir mostram diagramas de arquitetura que mostram os fluxos de trabalho de ingestão de dados e pesquisa:
Fluxo de trabalho de ingestão de dados
O diagrama a seguir mostra uma arquitetura detalhada para um fluxo de trabalho de ingestão de dados.
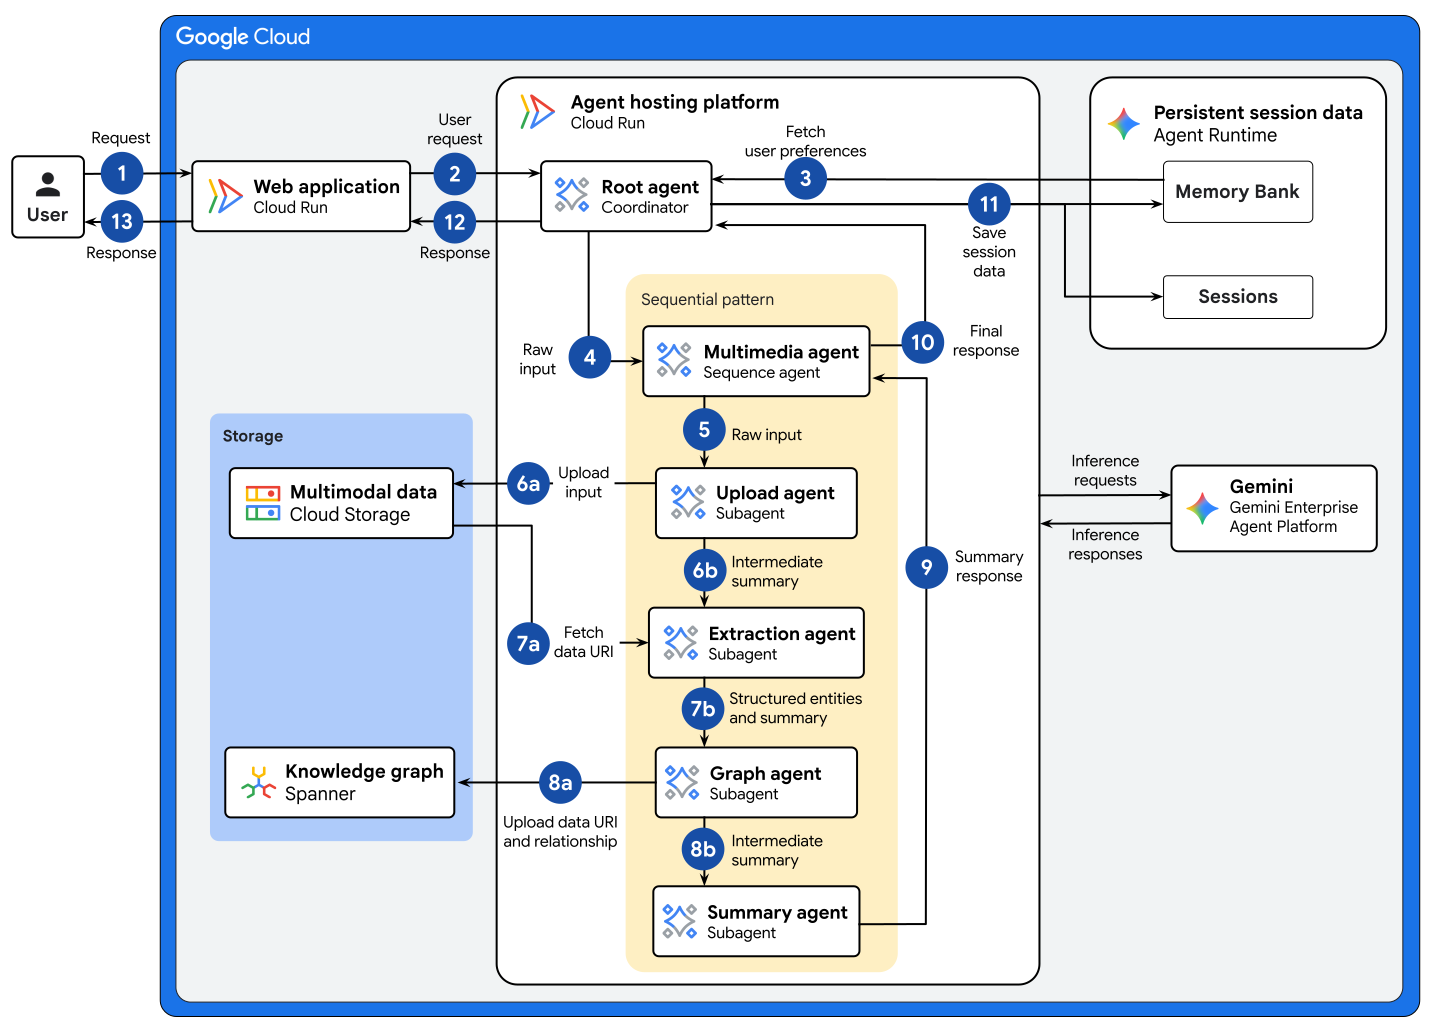
O diagrama anterior mostra o seguinte fluxo de dados:
- O usuário interage com o aplicativo da Web para fazer upload de novos dados. Por exemplo, um analista financeiro pode fazer upload de um PDF de lucros, uma gravação de uma reunião de acionistas ou um gráfico de desempenho do mercado.
- O aplicativo da Web encaminha a solicitação para o agente raiz. O agente raiz é um agente coordenador que recebe solicitações e é implantado em um serviço do Cloud Run.
- O agente raiz recupera dados de sessão persistentes do Memory Bank para personalizar os resultados da pesquisa com base nas preferências do usuário em sessões anteriores.
- O agente raiz usa o Gemini na Gemini Enterprise Agent Platform para interpretar a solicitação e delega a tarefa ao agente multimídia para executar o pipeline de ingestão de dados.
- O agente multimídia inicia o padrão sequencial e encaminha a entrada bruta para o agente de upload.
- O agente de upload executa as seguintes tarefas:
- Armazena o arquivo bruto em um bucket do Cloud Storage e detecta o tipo de mídia.
- Encaminha um resumo intermediário das ações que realizou para o agente de extração.
- O agente de extração realiza as seguintes tarefas:
- Busca o URI de dados do bucket de armazenamento e usa o Gemini para analisar os dados e identificar entidades estruturadas. Por exemplo, as entidades de dados financeiros podem incluir subsidiárias corporativas, trimestres fiscais e sentimento de receita.
- Encaminha as entidades estruturadas e o resumo intermediário das ações que ele realizou para o agente de gráfico.
- O agente de gráfico realiza as seguintes tarefas:
- Recebe as entidades estruturadas e faz upload dos dados para o mapa de informações. O Spanner Graph cria ou vincula nós que representam emissores, partes interessadas e instrumentos de mercado.
- Encaminha um resumo intermediário das ações que realizou para o agente de resumo.
- O agente de resumo produz uma resposta que contém um resumo em texto dos resultados da ingestão e das ações que foram realizadas por todos os subagentes. O agente de resumo envia a resposta ao agente de multimídia.
- O agente de multimídia encaminha a resposta de resumo de volta para o agente raiz.
- O agente raiz aciona uma função de callback para salvar os dados da sessão nas sessões da Gemini Enterprise Agent Platform . O agente raiz extrai tópicos de memória personalizados da sessão para salvar informações sobre áreas de foco importantes. Por exemplo, um analista financeiro pode criar um tópico de memória para acompanhar sinalizações regulatórias ou tendências setoriais.
- O agente raiz encaminha a resposta de resumo para o aplicativo da Web.
- O aplicativo da Web encaminha a resposta de volta ao usuário.
Fluxo de trabalho de pesquisa
O diagrama a seguir mostra uma arquitetura detalhada para um fluxo de trabalho de pesquisa.
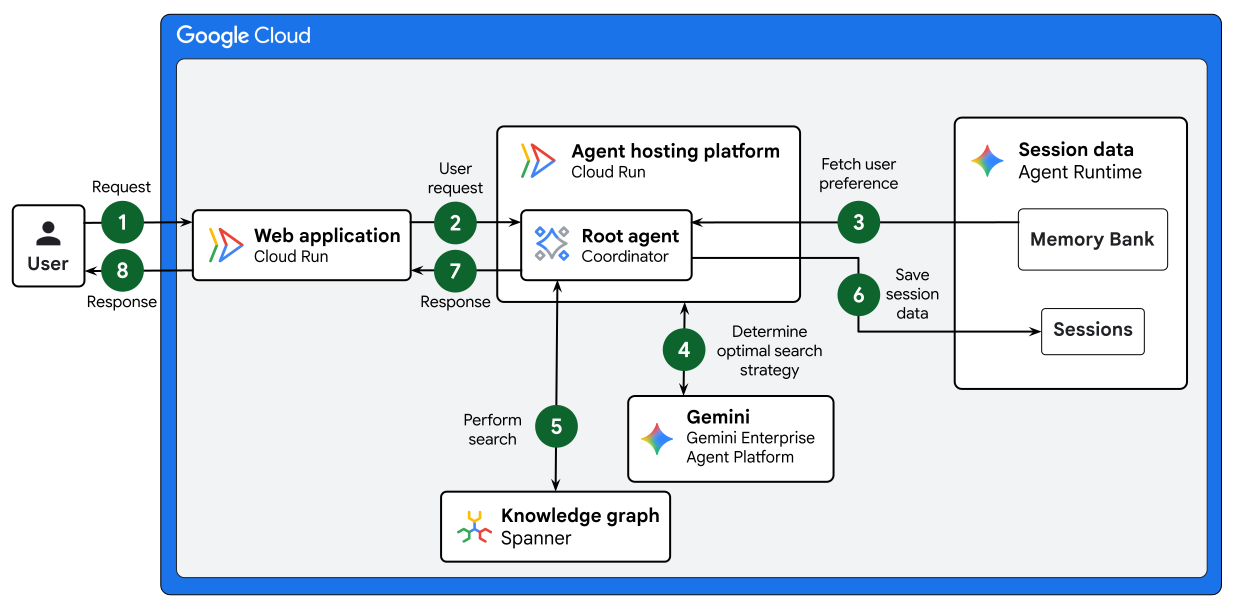
O diagrama anterior mostra o seguinte fluxo de dados:
- Um usuário inicia uma solicitação de pesquisa para o aplicativo da Web. Por exemplo, um gerente de portfólio envia uma solicitação para detectar padrões de transações circulares que envolvem mais de três entidades em que o volume total excede US $1 milhão em um período de 24 horas.
- O aplicativo da Web encaminha a solicitação para o agente raiz. O agente raiz é um agente coordenador que recebe solicitações e é implantado em um serviço do Cloud Run.
- O agente raiz recupera dados de sessão persistentes do Memory Bank para personalizar os resultados da pesquisa com base nas preferências e no contexto históricos do gerente de portfólio.
- O agente raiz usa o Gemini na Agent Platform para
determinar a estratégia de pesquisa ideal:
- Pesquisa por palavra-chave: usa cláusulas SQL
LIKEpara corresponder a categorias ou locais exatos. - Pesquisa semântica de RAG: usa o modelo de embedding e a distância de cosseno para encontrar entradas de dados semanticamente semelhantes.
- Pesquisa híbrida: executa a pesquisa por palavra-chave e a pesquisa semântica de RAG e mescla os resultados usando a Fusão de classificação recíproca (RRF, na sigla em inglês) para garantir alta relevância e cobertura.
- Pesquisa por palavra-chave: usa cláusulas SQL
- O agente raiz executa a estratégia de pesquisa apropriada no mapa de informações, que é armazenado no Spanner Graph, e recupera os resultados da pesquisa.
- O agente raiz aciona uma função de callback para salvar os dados da sessão nas sessões da Agent Platform. O agente raiz extrai tópicos de memória personalizados da sessão. Por exemplo, um gerente de portfólio pode criar um tópico de memória para acompanhar sinalizações regulatórias ou tendências setoriais emergentes.
- O agente raiz encaminha a resposta de resumo para o aplicativo da Web.
- O aplicativo da Web encaminha a resposta de volta ao usuário.
Produtos usados
Esta arquitetura de referência usa os seguintes produtos e recursos do Google Cloud:
- Cloud Run: uma plataforma de computação sem servidor que permite executar contêineres diretamente na infraestrutura escalonável do Google.
- Gemini: uma família de modelos de IA multimodal desenvolvida pelo Google.
- Gemini Enterprise Agent Platform: uma plataforma abrangente que permite criar, escalonar, governar e otimizar agentes de IA de nível empresarial.
- Cloud Storage: um repositório de objetos de baixo custo e sem limite para diversos tipos de dados. Os dados podem ser acessados de dentro e fora do Google Cloude são replicados entre locais para redundância.
- Spanner Graph: um banco de dados de grafos que oferece os recursos de escalonabilidade, disponibilidade e consistência do Spanner.
- Sessões da Gemini Enterprise Agent Platform: um serviço de armazenamento persistente que salva e recupera o histórico de interações entre um usuário e os agentes.
- Memory Bank: um serviço de armazenamento permanente que gera, refina, gerencia e recupera memórias de longo prazo com base nas conversas de um usuário com um agente.
Para informações sobre como selecionar componentes alternativos para seu sistema de IA agêntica, incluindo framework, ambiente de execução do agente, ferramentas, memória e padrões de design, consulte Escolher os componentes da arquitetura de IA agêntica.
Caso de uso
A arquitetura foi projetada para casos de uso que consolidam e analisam dados multimodais fragmentados para otimizar a alocação de recursos e a recuperação de informações. Ao manter subagentes independentes, o sistema oferece suporte a atualizações modulares e garante que os recursos distribuídos sejam correspondidos aos requisitos de pesquisa com alta continuidade. A integração do Spanner Graph como um mapa de informações permite que o sistema de IA agêntica modele dados complexos e interconectados. Essa integração facilita a compreensão contextual avançada e os recursos de consulta sofisticados que podem ser desafiadores ou ineficientes com bancos de dados relacionais ou NoSQL.
Para os casos de uso a seguir, um banco de dados de gráficos é excelente para representar as conexões arbitrárias e em evolução derivadas de dados multimodais. Essas conexões exigiriam um gerenciamento de esquema complexo e rígido em um banco de dados relacional.
Veja a seguir exemplos de casos de uso para a arquitetura descrita neste documento:
- Mobilidade de talentos de RH corporativo: melhore a pesquisa de palavras-chave para recrutamento em grande escala identificando candidatos internos qualificados por meio da expansão semântica. A arquitetura extrai habilidades técnicas e avaliações de habilidades interpessoais de portfólios multimodais e apresentações em vídeo para criar um gráfico de talentos abrangente. O mapa de informações do Spanner rastreia as relações entre funcionários, competências e histórico de projetos. Os resultados do trace identificam especialistas com base na profundidade conceitual e sinalizam projetos com falta de pessoal.
- Análise de conteúdo de redes sociais: identifique memórias ou tendências específicas realizando uma descoberta avançada de conteúdo e uma análise de rede em plataformas de redes sociais. O sistema processa uploads como vídeos, notas de voz e vlogs e extrai entidades, tópicos, sentimentos e menções. O mapa de informações do Spanner rastreia as relações entre os usuários, as conexões deles (amigos e seguidores), postagens, marcações "Gostei", comentários, tópicos compartilhados e tendências.
Considerações sobre o design
As seções a seguir fornecem recomendações gerais para projetar os agentes de IA e implementar essa arquitetura para produção.
As orientações desta seção não são completas. Para mais informações sobre fatores de design e práticas recomendadas, além de recomendações sobre como criar e implantar um sistema de IA multiagente, consulte Sistema de IA multiagente no Google Cloud.
Design de agentes de IA
Para melhorar o custo e o desempenho dos seus agentes, considere as seguintes recomendações:
- Design de sistemas de agentes: divida fluxos de trabalho complexos em vários agentes especializados com responsabilidades bem definidas, em vez de usar um agente monolítico. Essa separação de preocupações simplifica a engenharia de comandos, minimiza o desvio de instruções e permite o escalonamento granular do modelo. A arquitetura encaminha tarefas de alto volume e bem definidas para modelos menores e mais rápidos, reservando o raciocínio complexo para modelos de alta capacidade.
- Design de ferramentas: separe as ferramentas em vários métodos focados em vez de usar um único método monolítico. Essa abordagem garante consistência em toda a base de código, reduz a ramificação lógica e permite caminhos de otimização específicos, como pular a análise de consulta quando um método de pesquisa direta é invocado.
- Contexto do agente: para evitar que os agentes downstream repitam consultas em dados upstream em um pipeline sequencial, transmita contexto suficiente pelo estado do agente. Use estruturas JSON bem definidas para o estado compartilhado, de modo que cada agente possa analisar os dados de maneira confiável.
- Armazenamento do estado da sessão: use o estado da sessão para o histórico imediato da conversa e o Memory Bank para fatos resumidos de várias sessões. Insira o contexto de memória no início de uma sessão para que o agente possa consultar as preferências sem reprocessar históricos de conversas longos.
- Qualidade da memória: permita que os usuários limpem ou atualizem memórias desatualizadas se as preferências ou funções deles mudarem ao longo do tempo.
segurança, privacidade e conformidade
Para ajudar a lidar com os riscos de segurança exclusivos dos agentes de IA, o Google recomenda uma abordagem que combina controles de segurança determinísticos com defesas dinâmicas baseadas em raciocínio:
- Supervisão humana: incorpore um fluxo human-in-the-loop em sistemas essenciais para os negócios, de modo que os supervisores humanos possam analisar as saídas e aprovar, substituir ou pausar as ações do agente.
- Identidade do agente: atribua a cada agente uma identidade vinculada à carga de trabalho para aplicar o controle de acesso com privilégio mínimo e gerenciar centralmente as credenciais de ferramentas externas.
- Gateway de Agente: aplique a governança de tráfego de entrada e saída, políticas de acesso de negação padrão e inspeção de comandos e ferramentas inline com o Model Armor.
Registro de agentes: verifique se os agentes se conectam apenas a subagentes e ferramentas de MCP aprovados.
Implemente o controle de acesso refinado: use o controle de acesso refinado para autorizar o acesso no nível da tabela e da coluna. Restrinja a política do bucket do Cloud Storage para que apenas a conta de serviço do Cloud Run tenha acesso.
Limpar inferências e respostas: use o Model Armor para inspecionar e limpar as solicitações de inferência e as respostas do modelo. Essa limpeza reduz os riscos de injeção de comandos de conteúdo multimodal que os usuários enviam. Ele também ajuda a evitar a exfiltração acidental de informações de identificação pessoal (PII) ou dados sensíveis nas saídas do agente.
Confiabilidade
Para garantir que as configurações do agente atendam aos requisitos de confiabilidade, considere as seguintes recomendações:
- Implementar a lógica de repetição do agente: para lidar com erros temporários, como limites de cota, implemente a lógica de repetição com espera exponencial para chamadas para endpoints da plataforma de agentes e o Spanner.
- Defina limites de arquivos: para evitar tempos limite de API de arquivos grandes, defina limites de tamanho de upload explícitos e separe vídeos grandes em partes antes que as entidades de dados sejam extraídas. Para mais informações, consulte Personalizar o processamento de vídeo.
Eficiência operacional
Para garantir que as configurações do agente atendam aos requisitos de eficiência operacional, considere as seguintes recomendações:
- Usar a geração de registros estruturados: registre todas as invocações de ferramentas de agentes e resultados de pipeline com metadados estruturados. Com os registros estruturados, é possível consultar registros e painéis no Cloud Monitoring.
- Implementar o rastreamento: para diagnosticar pontos de acesso de latência, use o Cloud Trace para capturar rastreamentos de solicitações de ponta a ponta no executor do agente e na execução da ferramenta.
- Avaliar a qualidade do agente: avalie periodicamente a qualidade da saída do agente usando o serviço de avaliação de IA generativa para verificar as trajetórias de seleção de ferramentas e a qualidade da resposta.
Otimização de custos
Para garantir que as configurações do agente atendam aos requisitos de custo, considere as seguintes recomendações:
- Custos de armazenamento: para reduzir os custos de armazenamento, use o Gerenciamento do ciclo de vida de objetos para mover arquivos para as classes de armazenamento Nearline ou Coldline após um período de retenção definido.
- Análise e gerenciamento de custos: para analisar e gerenciar os custos da plataforma de agentes, recomendamos que você crie métricas de referência para consultas por segundo (QPS) e tokens por segundo (TPS). Em seguida, monitore essas métricas após a implantação. O valor de referência que você cria como parte do gerenciamento de custos pode ajudar a determinar o planejamento de capacidade. Por exemplo, o valor de referência ajuda a determinar quando a Capacidade de Processamento Provisionada pode ser necessária.
Otimização de desempenho
Para garantir que as configurações do agente atendam aos requisitos de desempenho, considere as seguintes recomendações:
- Roteamento do agente raiz: para minimizar a latência e evitar invocações desnecessárias de subagentes, defina claramente a lógica de roteamento nas instruções do agente. Verifique se a finalidade, os parâmetros de entrada e as saídas esperadas de cada ferramenta estão documentados em literais de string para ajudar o modelo a selecionar a ferramenta correta.
- Modelos de IA no banco de dados: para reduzir a latência, use a função
ML.PREDICTdo Spanner para chamar modelos inline em consultas SQL. Monitore o uso da cota da Agent Platform, porque as cargas de trabalho de pesquisa híbrida podem acionar várias chamadas de modelo por consulta. - Alocação de recursos: dependendo dos requisitos de desempenho, configure os limites de memória e limites de CPU a serem alocados para o serviço do Cloud Run.
Implantação
Para implantar um exemplo de implementação dessa arquitetura, teste o codelab Way Back Home Level 2.
A seguir
- Saiba como hospedar agentes de IA no Cloud Run.
- Saiba como criar uma infraestrutura de GraphRAG para IA generativa usando a Agent Platform e o Spanner Graph.
- Conheça as práticas recomendadas para projetar o esquema do Spanner Graph.
- Saiba como usar embeddings multimodais.
- Saiba como criar um sistema de IA multiagente no Google Cloud.
- Confira recursos de aprendizado para criar e implantar agentes de nível empresarial com o Gemini Enterprise Agent Ready (GEAR).
- Para uma visão geral dos princípios e recomendações de arquitetura específicos para cargas de trabalho de IA e ML no Google Cloud, consulte a perspectiva de IA e ML no Well-Architected Framework.
- Para mais arquiteturas de referência, diagramas e práticas recomendadas, confira a Central de arquitetura do Cloud.
Colaboradores
Autores:
- Annie Wang | Engenheira de software
- Samantha He | Redatora técnica
Outros colaboradores:
- Christina Lin | Gerente de engenharia de relações com desenvolvedores
- Kumar Dhanagopal | Desenvolvedor de soluções para vários produtos
- Olivier Bourgeois | Engenheiro de relações com desenvolvedores