


Este documento apresenta uma arquitetura de referência para ajudar você a projetar a infraestrutura para aplicativos de IA generativa do GraphRAG no Google Cloud. O público-alvo inclui arquitetos, desenvolvedores e administradores que criam e gerenciam sistemas inteligentes de recuperação de informações. Este documento considera uma compreensão básica dos conceitos de IA, gerenciamento de dados de gráfico e mapa de informações. Este documento não fornece orientações específicas para projetar e desenvolver aplicativos GraphRAG.
O GraphRAG é uma abordagem baseada em gráficos para a geração aumentada por recuperação (RAG). A RAG ajuda a embasar as respostas geradas com IA, aumentando os comandos com dados contextualmente relevantes que são recuperados usando a busca vetorial. O GraphRAG combina a pesquisa vetorial com uma consulta de mapa de informações para recuperar dados de contexto que refletem melhor a interconexão de dados de diversas fontes. Os comandos aumentados usando o GraphRAG podem gerar respostas de IA mais detalhadas e relevantes.
Arquitetura
O diagrama a seguir mostra uma arquitetura para um aplicativo de IA generativa com capacidade de GraphRAG no Google Cloud:
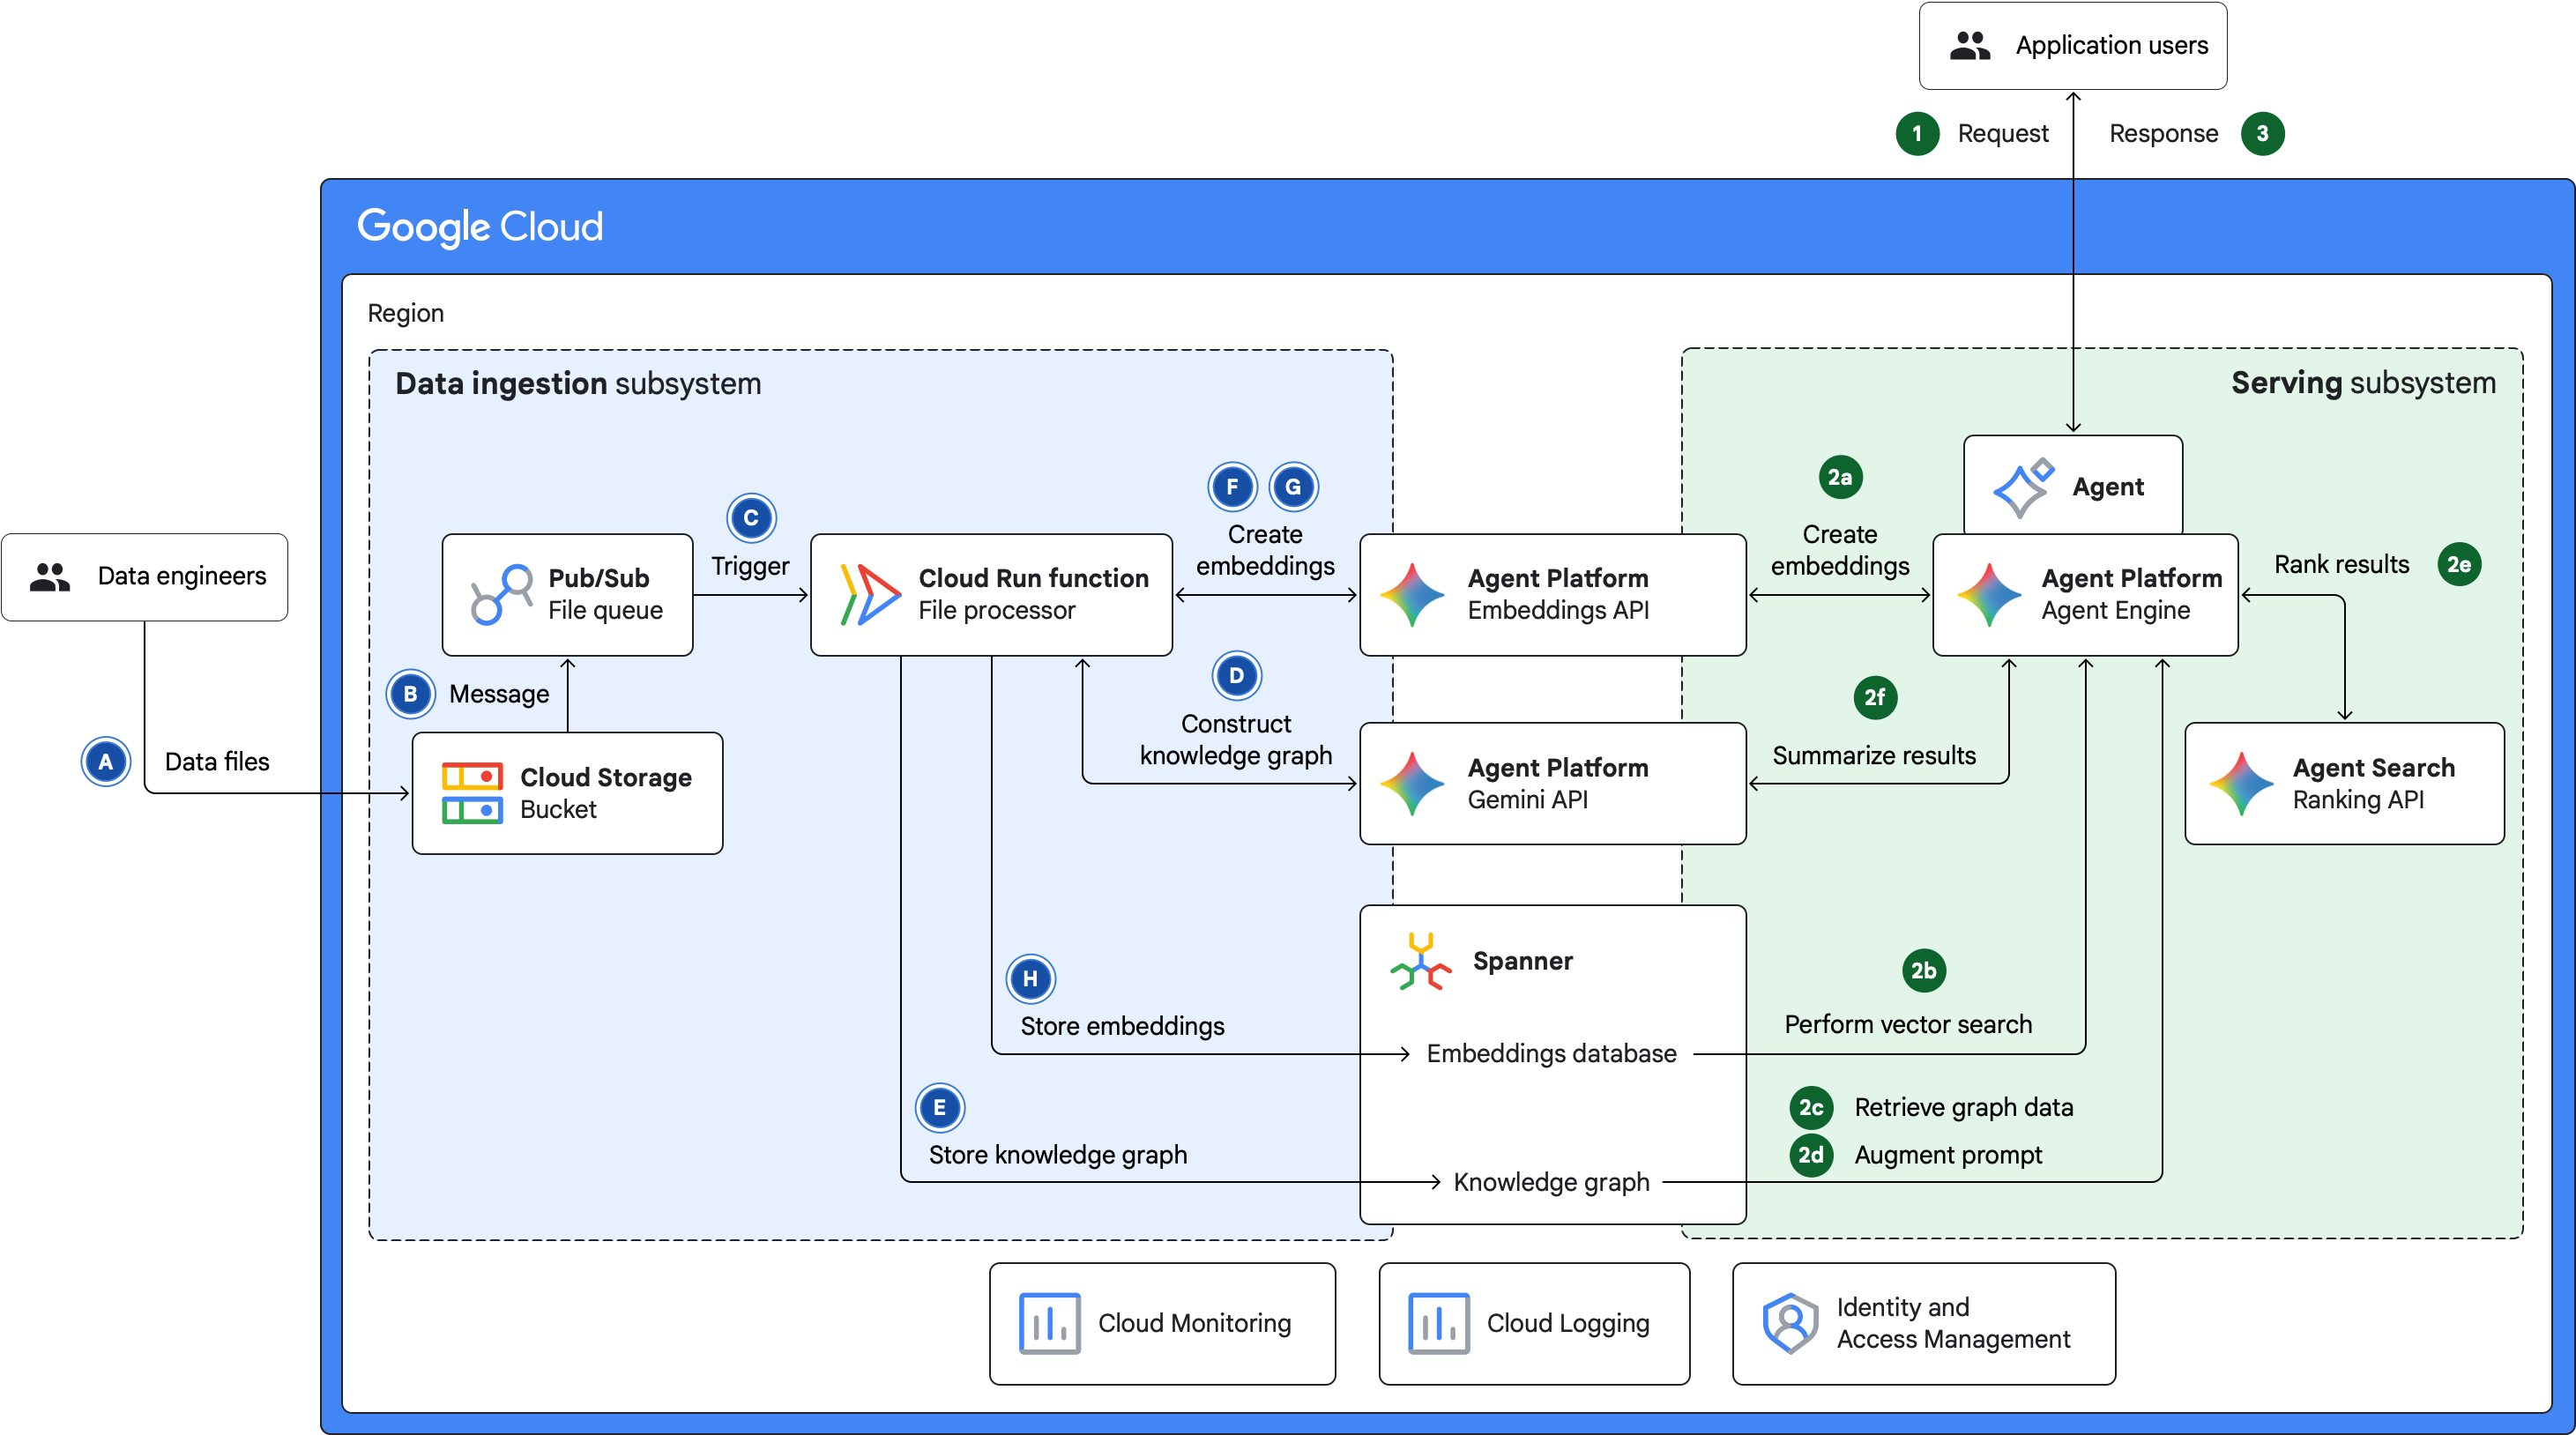
A arquitetura no diagrama anterior consiste em dois subsistemas: ingestão de dados e disponibilização. As seções a seguir descrevem a finalidade dos subsistemas e o fluxo de dados dentro e entre eles.
Subsistema de ingestão de dados
O subsistema de ingestão de dados ingere dados de fontes externas e os prepara para o GraphRAG. O fluxo de ingestão de dados e preparação envolve as seguintes etapas:
- Os dados são ingeridos em um bucket do Cloud Storage. Esses dados podem ser enviados por um analista de dados, ingeridos de um banco de dados ou transmitidos de qualquer fonte.
- Quando os dados são ingeridos, uma mensagem é enviada para um tópico do Pub/Sub.
- O Pub/Sub aciona uma função do Cloud Run para processar os dados enviados.
- A função do Cloud Run cria um mapa de informações com base nos
arquivos de entrada usando a API Gemini e ferramentas como o
LLMGraphTransformerdo LangChain. - A função armazena o mapa de informações em um banco de dados do Spanner Graph.
- A função segmenta o conteúdo textual dos arquivos de dados em
unidades granulares usando ferramentas como o
RecursiveCharacterTextSplitterdo LangChain ou o Analisador de layout da Document AI. - A função cria embeddings de vetor dos segmentos de texto usando as APIs de embeddings da Gemini Enterprise Agent Platform.
- A função armazena os embeddings de vetor e os nós de gráfico associados no Spanner Graph.
Os embeddings de vetor servem como base para a recuperação semântica. Os nós do mapa de informações permitem a travessia e a análise de relações e padrões de dados complexos.
Subsistema de veiculação
O subsistema de disponibilização gerencia o ciclo de vida de consulta-resposta entre o aplicativo de IA generativa e os usuários. O fluxo de veiculação envolve as seguintes etapas:
- Um usuário envia uma consulta em linguagem natural para um agente de IA, que é implantado no Agent Runtime na Gemini Enterprise Agent Platform.
- O agente processa a consulta da seguinte maneira:
- Converte a consulta em embeddings de vetor usando as APIs de embeddings da Agent Platform.
- Recupera nós de gráfico relacionados à consulta realizando uma pesquisa de similaridade vetorial no banco de dados de embeddings.
- Recupera dados relacionados à consulta ao percorrer o Mapa de Informações.
- Aumenta o comando combinando a consulta original com os dados de gráfico recuperados.
- Usa a API de classificação da Pesquisa de Agentes para classificar os resultados, que consistem em nós e arestas recuperados do banco de dados de gráficos. A classificação é baseada na relevância semântica para a consulta.
- Resume os resultados chamando a API Gemini.
- Em seguida, o agente envia o resultado resumido ao usuário.
É possível armazenar e visualizar registros de atividades de consulta-resposta no Cloud Logging e configurar o monitoramento com base em registros usando o Cloud Monitoring.
Produtos usados
Esta arquitetura de referência usa os seguintes produtos e ferramentas do Google:
- Spanner Graph: um banco de dados de grafos que oferece os recursos de escalonabilidade, disponibilidade e consistência do Spanner.
- Gemini Enterprise Agent Platform: uma plataforma abrangente que permite criar, escalonar, governar e otimizar agentes de IA de nível empresarial.
- Cloud Run functions: uma plataforma de computação sem servidor que permite executar funções de finalidade única diretamente no Google Cloud.
- Cloud Storage: um repositório de objetos de baixo custo e sem limite para diversos tipos de dados. Os dados podem ser acessados de dentro e fora do Google Cloude são replicados entre locais para redundância.
- Pub/Sub: um serviço de mensagens assíncrono e escalonável que separa os serviços que produzem mensagens daqueles que processam essas mensagens.
- Cloud Logging: um sistema de gerenciamento de registros em tempo real com armazenamento, pesquisa, análise e alertas.
- Cloud Monitoring: um serviço que fornece visibilidade do desempenho, da disponibilidade e da integridade dos aplicativos e da infraestrutura.
Casos de uso
O GraphRAG facilita a recuperação inteligente de dados para casos de uso em vários setores. Nesta seção, descrevemos alguns casos de uso em saúde, finanças, serviços jurídicos e manufatura.
Saúde e produtos farmacêuticos: suporte à decisão clínica
Em sistemas de apoio à decisão clínica, o GraphRAG integra grandes quantidades de dados da literatura médica, históricos de saúde eletrônicos de pacientes, bancos de dados de interação medicamentosa e resultados de ensaios clínicos em um mapa de informações unificado. Quando médicos e pesquisadores consultam os sintomas e os medicamentos atuais de um paciente, o GraphRAG percorre o mapa de informações para identificar condições relevantes e possíveis interações medicamentosas. Ela também pode gerar recomendações de tratamento personalizadas com base em outros dados, como o perfil genético do paciente. Esse tipo de recuperação de informações fornece respostas mais ricas em contexto e baseadas em evidências do que a correspondência de palavras-chave.
Serviços financeiros: unificação de dados financeiros
As empresas de serviços financeiros usam mapas de informações para oferecer aos analistas uma visão unificada e estruturada de dados de fontes diferentes, como relatórios de analistas, divulgações de resultados e avaliações de risco. Os mapas de informações identificam as principais entidades de dados, como empresas e executivos, e mapeiam as relações cruciais entre as entidades. Essa abordagem fornece uma rede de dados rica e interconectada, que permite uma análise financeira mais profunda e eficiente. Os analistas podem descobrir insights que antes estavam ocultos, como dependências complexas da cadeia de suprimentos, membros do conselho que se sobrepõem entre concorrentes e exposição a riscos geopolíticos complexos.
Serviços jurídicos: pesquisa de casos e análise de precedentes
No setor jurídico, o GraphRAG pode ser usado para gerar recomendações jurídicas personalizadas com base em precedentes, estatutos, jurisprudência, atualizações regulatórias e documentos internos. Quando os advogados se preparam para os casos, eles podem fazer perguntas detalhadas sobre argumentos jurídicos específicos, decisões anteriores em casos semelhantes ou as implicações de uma nova legislação. O GraphRAG usa a interconexão do conhecimento jurídico disponível para identificar precedentes relevantes e explicar a aplicabilidade deles. Ele também pode sugerir contra-argumentos ao traçar as relações entre conceitos jurídicos, estatutos e interpretações judiciais. Com essa abordagem, os profissionais do direito podem ter insights mais completos e precisos do que os métodos convencionais de recuperação de conhecimento.
Manufatura e cadeia de suprimentos: como acessar o conhecimento institucional
As operações de fabricação e cadeia de suprimentos exigem um alto grau de precisão. O conhecimento necessário para manter o nível de precisão exigido geralmente está enterrado em milhares de documentos densos e estáticos de Procedimento Operacional Padrão (SOP, na sigla em inglês). Quando uma linha de produção ou máquina em uma fábrica falha ou se ocorre um problema de logística, engenheiros e técnicos costumam perder tempo crítico pesquisando em documentos PDF desconectados para diagnosticar e resolver o problema. Os mapas de informações e a IA de conversação podem ser combinados para transformar o conhecimento institucional oculto em um parceiro de diagnóstico interativo.
Alternativas de design
A arquitetura descrita neste documento é modular. É possível adaptar determinados componentes da arquitetura para usar produtos, ferramentas e tecnologias alternativos, dependendo dos seus requisitos.
Como criar o Mapa de Informações
Use a ferramenta LLMGraphTransformer do LangChain para criar um mapa de informações
do zero. Ao especificar o esquema do gráfico com parâmetros LLMGraphTransformer, como allowed_nodes, allowed_relationships, node_properties e relationship_properties, é possível melhorar a qualidade do mapa de informações resultante. No entanto, o LLMGraphTransformer pode extrair entidades de
domínios genéricos, portanto, pode não ser adequado para domínios de nicho, como saúde
ou produtos farmacêuticos. Além disso, se a organização já tiver um processo robusto para
criar mapas de informações, o subsistema de ingestão de dados mostrado nesta
arquitetura de referência será opcional.
Armazenamento do mapa de informações e dos embeddings de vetor
A arquitetura neste documento usa o Spanner como o repositório de dados para o mapa de informações e os embeddings de vetor. Se os gráficos de conhecimento empresarial já existirem em outro lugar (como em uma plataforma como o Neo4j), considere usar um banco de dados vetorial para os embeddings. No entanto, essa abordagem exige mais esforço de gerenciamento e pode custar mais. O Spanner oferece um repositório de dados consolidado e globalmente consistente para estruturas de grafos e embeddings de vetor. Esse armazenamento de dados permite o gerenciamento unificado de dados, o que ajuda a otimizar custos, desempenho, governança de segurança e eficiência operacional.
Agent Runtime
Nesta arquitetura de referência, o agente é implantado no Agent Runtime, que fornece um ambiente de execução gerenciado para agentes de IA. Outras opções que você pode considerar incluem o Cloud Run e o Google Kubernetes Engine (GKE). Uma discussão sobre essas opções está fora do escopo deste documento.
Embasamento usando RAG
Como discutido na seção Casos de uso, o GraphRAG permite a recuperação inteligente de dados para embasamento em muitos cenários. No entanto, se os dados de origem usados para aumentar os comandos não tiverem inter-relações complexas, a RAG poderá ser uma escolha apropriada para seu aplicativo de IA generativa.
As arquiteturas de referência a seguir mostram como criar a infraestrutura necessária para RAG no Google Cloud usando bancos de dados gerenciados com vetores ou produtos especializados de pesquisa vetorial:
- Infraestrutura de RAG para IA generativa usando a Agent Platform e a Pesquisa Vetorial
- Infraestrutura de RAG para IA generativa usando a Plataforma de Agentes e o AlloyDB para PostgreSQL
- Infraestrutura de RAG para IA generativa usando o GKE e o Cloud SQL
- Infraestrutura de RAG para IA generativa usando o Gemini Enterprise e a Agent Platform
Considerações sobre o design
Nesta seção, descrevemos fatores de design, práticas recomendadas e recomendações a serem consideradas ao usar essa arquitetura de referência para desenvolver uma topologia que atenda aos seus requisitos específicos de segurança, confiabilidade, custo e desempenho.
As orientações desta seção não são completas. Dependendo dos requisitos da carga de trabalho e dos produtos e recursos do Google Cloud e de terceiros que você usa, pode haver outros fatores de design e compensações que você precisa considerar.
segurança, privacidade e conformidade
Nesta seção, descrevemos as considerações e recomendações de design para criar uma topologia no Google Cloud que atenda aos requisitos de segurança e conformidade da sua carga de trabalho.
Considerações de segurança da Agent Platform
Para garantir que as configurações e o uso da Agent Platform atendam aos seus requisitos de segurança, considere as seguintes recomendações:
Controles de segurança: a Plataforma de Agentes oferece suporte aos controles de segurança do Google Cloud que podem ser usados para atender aos seus requisitos de residência de dados, criptografia de dados, segurança de rede e transparência no acesso. Para mais informações, consulte a seguinte documentação:
Segurança: os modelos de IA generativa podem produzir respostas prejudiciais, especialmente quando são explicitamente solicitados. Para aumentar a segurança e mitigar possíveis usos indevidos, configure filtros de conteúdo para atuar como barreiras contra respostas nocivas. Para mais informações, consulte Filtros de segurança e conteúdo.
Criptografia de dados do Spanner Graph
Por padrão, os dados armazenados no Spanner Graph são criptografados usando Google-owned and Google-managed encryption keys. Se precisar usar chaves de criptografia controladas e gerenciadas por você, use chaves de criptografia gerenciadas pelo cliente (CMEKs). Para mais informações, acesse Sobre CMEK.
Considerações de segurança do Cloud Run functions
Para garantir que a implementação do Cloud Run functions atenda aos requisitos de segurança, considere as seguintes recomendações:
- Criptografia de dados: por padrão, o Cloud Run criptografa dados usando o Google-owned and Google-managed encryption keys. Para proteger os contêineres usando chaves controladas por você, use CMEKs. Para mais informações, consulte Como usar chaves de criptografia gerenciadas pelo cliente.
- Segurança da imagem de contêiner: para garantir que apenas imagens de contêiner autorizadas sejam implantadas no Cloud Run, use a autorização binária.
- Residência de dados: o Cloud Run ajuda você a atender aos requisitos de residência de dados. As funções do Cloud Run são executadas na região selecionada.
Considerações de segurança do Cloud Storage
Para garantir que a configuração do Cloud Storage atenda aos seus requisitos de segurança, considere as seguintes recomendações:
- Criptografia de dados: por padrão, os dados armazenados no Cloud Storage são criptografados usandoGoogle-owned and Google-managed encryption keys. Se necessário, use CMEKs ou suas próprias chaves gerenciadas utilizando um método de gerenciamento externo, como chaves de criptografia fornecidas pelo cliente (CSEKs). Para mais informações, consulte Opções de criptografia de dados.
- Controle de acesso: o Cloud Storage é compatível com dois métodos para conceder aos usuários acesso aos buckets e objetos: Identity and Access Management (IAM) e listas de controle de acesso (ACLs). Na maioria dos casos, recomendamos usar o IAM, que permite conceder permissões no nível do bucket e para envolvidos no projeto. Para mais informações, consulte Visão geral do controle de acesso.
- Proteção de dados: os dados carregados no subsistema de ingestão de dados pelo Cloud Storage podem incluir dados sensíveis. Use a Proteção de Dados Sensíveis para descobrir, classificar e desidentificar dados sensíveis. Para mais informações, acesse Como usar a Proteção de Dados Sensíveis com o Cloud Storage.
- Residência de dados: o Cloud Storage ajuda você a atender aos requisitos de residência de dados. Os dados são armazenados ou replicados na região especificada.
Considerações de segurança do Pub/Sub
Para garantir que a configuração do Pub/Sub atenda aos seus requisitos de segurança, considere as seguintes recomendações:
- Criptografia de dados: por padrão, o Pub/Sub criptografa todas as mensagens, em repouso e em trânsito, usandoGoogle-owned and Google-managed encryption keys. O Pub/Sub pode usar CMEKs para criptografia de mensagens na camada do aplicativo. Para mais informações, consulte Configurar a criptografia de mensagens.
- Residência de dados: se você tiver requisitos de residência de dados, para garantir que os dados das mensagens sejam armazenados em locais específicos, configure políticas de armazenamento de mensagens.
Considerações de segurança do Cloud Logging
Para garantir que a configuração do Cloud Logging atenda aos seus requisitos de segurança, considere os seguintes fatores de design e recomendações:
- Auditoria de atividades administrativas: os registros de auditoria de atividades do administrador são ativados por padrão para todos os serviços do Google Cloud usados nesta arquitetura de referência. Esses registros gravam chamadas de API ou outras ações que modificam a configuração ou os metadados de recursos do Google Cloud .
- Auditoria de acesso a dados: para os serviços do Google Cloud usados nesta arquitetura, é possível ativar os registros de auditoria de acesso a dados. Com esses registros, é possível rastrear chamadas de API que leem a configuração ou os metadados de recursos ou solicitações de usuários para criar, modificar ou ler dados de recursos fornecidos pelo usuário.
- Residência de dados: para ajudar a atender aos requisitos de residência de dados, configure o Cloud Logging para armazenar dados de registro na região especificada. Para mais informações, consulte Regionalizar seus registros.
Para princípios e recomendações de segurança específicos para cargas de trabalho de IA e ML, consulte Perspectiva de IA e ML: segurança no Google Cloud Framework de arquitetura.
Confiabilidade
Nesta seção, descrevemos as considerações e recomendações de design para criar e operar uma infraestrutura confiável para sua implantação no Google Cloud.
Capacidade da Agent Platform e disponibilidade de endpoints
Se o número de solicitações exceder a capacidade alocada, o código do erro 429 será retornado. Para cargas de trabalho essenciais aos negócios e que exigem consistentemente alta capacidade de processamento, é possível reservar capacidade usando a Capacidade de Processamento Provisionada. Se os dados puderem ser compartilhados entre várias regiões ou países, use um endpoint global.
Disponibilidade de dados e recuperação de desastres do Spanner Graph
O Spanner foi projetado para alta disponibilidade de dados e escalonabilidade global. Para garantir a disponibilidade mesmo durante uma interrupção na região, o Spanner oferece configurações multirregionais, que replicam dados em várias zonas em várias regiões. Além desses recursos de resiliência integrados, o Spanner oferece os seguintes recursos para dar suporte a estratégias abrangentes de recuperação de desastres:
- Proteção contra exclusão do banco de dados
- Recursos robustos de backup e restauração, incluindo cópias programadas e entre regiões
- Recuperação pontual (PITR) para proteção contra corrupção lógica de dados, erros de operador ou gravações acidentais por até sete dias
Para mais informações, consulte Visão geral da recuperação de desastres.
Robustez do Cloud Run functions contra interrupções na infraestrutura
O Cloud Run é um serviço regional. Os dados são armazenados de forma síncrona em várias zonas dentro de uma região. É feito o balanceamento de carga automático no tráfego entre as zonas. Em caso de interrupção do serviço na zona, o Cloud Run continua em execução e os dados não são perdidos. Se ocorrer uma interrupção do serviço na região, o serviço deixará de ser executado até que o Google resolva essa interrupção.
Disponibilidade de dados do Cloud Storage
É possível criar buckets do Cloud Storage em um destes três tipos de local: regional, birregional ou multirregional. Os dados armazenados em buckets regionais são replicados de maneira síncrona em várias zonas dentro de uma região. Para maior disponibilidade, use buckets birregionais ou multirregionais, em que os dados são replicados de maneira assíncrona entre regiões.
Considerações sobre a confiabilidade do Pub/Sub
Para garantir que a configuração do Pub/Sub atenda aos seus requisitos de confiabilidade, considere as seguintes recomendações:
- Controle de taxa: para evitar erros durante períodos de picos transitórios no tráfego de mensagens, limite a taxa de solicitações de publicação configurando o controle de fluxo nas configurações do editor.
- Tratamento de falhas: para lidar com tentativas de publicação que falharam, ajuste as variáveis de solicitação de nova tentativa conforme necessário. Para mais informações, consulte Repetir solicitações.
Recomendações de confiabilidade para todos os produtos da arquitetura
Depois de implantar a carga de trabalho no Google Cloud, otimize ainda mais a confiabilidade dos recursos de nuvem aplicando as recomendações relevantes do Active Assist.
Para princípios e recomendações de confiabilidade específicos para cargas de trabalho de IA e ML, consulte Perspectiva de IA e ML: confiabilidade no Well-Architected Framework.
Otimização de custos
Nesta seção, você encontra orientações para otimizar o custo de configuração e operação de uma topologia do Google Cloud criada usando essa arquitetura de referência.
Considerações sobre custos da Agent Platform
Para garantir que as configurações e o uso da Agent Platform atendam aos seus requisitos de custo, considere as seguintes recomendações:
- Análise e gerenciamento de custos: para analisar e gerenciar os custos da Agent Platform, recomendamos que você crie uma referência de consultas por segundo (QPS) e tokens por segundo (TPS) e monitore essas métricas após a implantação. A referência também ajuda no planejamento de capacidade. Por exemplo, o valor de referência ajuda a determinar quando a capacidade de processamento provisionada é necessária.
- Seleção de modelo: selecionar o modelo apropriado para seu aplicativo de IA generativa é uma decisão crítica que afeta diretamente os custos e o desempenho. Para identificar o modelo que oferece um equilíbrio ideal entre desempenho e custo para seu caso de uso específico, teste os modelos de forma iterativa. Recomendamos que você comece com o modelo mais econômico e avance gradualmente para opções mais poderosas.
- Engenharia de comandos: o tamanho dos comandos (entrada) e as respostas geradas (saída) afetam diretamente o desempenho e o custo. Escreva comandos curtos, diretos e com contexto suficiente. Crie comandos para receber respostas concisas do modelo. Por exemplo, inclua frases como "resuma em duas frases" ou "liste três pontos principais". Para mais informações, consulte as práticas recomendadas para design de comandos.
- Armazenamento em cache de contexto: para reduzir o custo das solicitações que contêm conteúdo repetido com altas contagens de tokens de entrada, use o armazenamento em cache de contexto.
- Solicitações em lote: para tarefas de processamento em grande escala que podem ser realizadas de forma assíncrona, como geração de conteúdo e análise off-line, use a inferência em lote. As solicitações em lote são cobradas por um preço menor do que as solicitações padrão.
Considerações sobre o custo do Spanner Graph
Para garantir que a configuração do Spanner Graph atenda aos seus requisitos de custo, considere as seguintes recomendações:
- Escalonamento automático da capacidade de computação: para ajudar a controlar os custos, ajuste dinamicamente a capacidade de computação dos bancos de dados do Spanner Graph com base no uso da CPU e nas necessidades de armazenamento usando o escalonador automático gerenciado. Uma capacidade mínima costuma ser necessária, mesmo para cargas de trabalho pequenas.
- Otimização de taxa: para capacidade de computação previsível, estável ou de referência, compre descontos por compromisso de uso (CUDs). Os CUDs oferecem descontos significativos em troca de um compromisso com um determinado gasto por hora na capacidade de computação.
- Replicação de backup: ao copiar backups para diferentes regiões para recuperação de desastres ou conformidade, considere os custos de saída de rede. Para ajudar a reduzir custos, copie apenas os backups essenciais.
Considerações sobre custos do Cloud Run functions
Para garantir que a implementação das funções do Cloud Run atenda aos seus requisitos de custo, considere as seguintes recomendações:
Alocação de recursos: ao criar funções do Cloud Run, é possível especificar a quantidade de memória e CPU a ser alocada. Para controlar os custos, comece com as alocações padrão (mínimas) de CPU e memória. Para melhorar o desempenho, aumente a alocação configurando o limite de CPU e o limite de memória. Para mais informações, consulte a seguinte documentação:
Otimização de taxa: se você puder prever os requisitos de CPU e memória, poderá economizar dinheiro com CUDs.
Classe de armazenamento do Cloud Storage e gerenciamento do ciclo de vida
Para o bucket do Cloud Storage no subsistema de ingestão de dados, escolha uma classe de armazenamento adequada com base nos requisitos de retenção de dados e frequência de acesso da carga de trabalho. Por exemplo, para controlar os custos de armazenamento, escolha a classe Standard e use o Gerenciamento do ciclo de vida de objetos. Essa abordagem permite o downgrade automático de objetos para uma classe de armazenamento de menor custo ou a exclusão automática de objetos com base em condições especificadas.
Considerações sobre custos do Cloud Logging
Para controlar o custo de armazenamento de registros, considere as seguintes recomendações:
- Reduza o volume de registros excluindo ou filtrando entradas de registro desnecessárias. Para mais informações, consulte Filtros de exclusão.
- Otimize o período de armazenamento de registros. Para mais informações, consulte Configurar retenção personalizada.
Recomendações de otimização de custos para todos os produtos na arquitetura
Para garantir que sua arquitetura atenda aos requisitos de custo, considere as seguintes recomendações gerais:
- Otimização pós-implantação: depois de implantar a carga de trabalho no Google Cloud, otimize ainda mais o custo dos recursos implantados aplicando as recomendações relevantes do Active Assist.
- Estimativa de custo: para estimar o custo dos recursos do Google Cloud, use a calculadora de preços doGoogle Cloud .
Para princípios e recomendações de otimização de custos específicos para cargas de trabalho de IA e ML, consulte Perspectiva de IA e ML: otimização de custos no Well-Architected Framework.
Otimização de desempenho
Nesta seção, descrevemos as considerações e recomendações de design para criar uma topologia no Google Cloud que atenda aos requisitos de desempenho das suas cargas de trabalho.
Considerações sobre o desempenho da Agent Platform
Para garantir que as configurações e o uso da plataforma de agente atendam aos seus requisitos de desempenho, considere as seguintes recomendações:
- Seleção de modelo: selecionar o modelo apropriado para seu aplicativo de IA generativa é uma decisão crítica que afeta diretamente os custos e o desempenho. Para identificar o modelo que oferece um equilíbrio ideal entre desempenho e custo para seu caso de uso específico, teste os modelos de forma iterativa. Recomendamos que você comece com o modelo mais econômico e avance gradualmente para opções mais poderosas.
- Engenharia de comandos: o tamanho dos comandos (entrada) e as respostas geradas (saída) afetam diretamente o desempenho e o custo. Escreva comandos curtos, diretos e com contexto suficiente. Crie comandos para receber respostas concisas do modelo. Por exemplo, inclua frases como "resuma em duas frases" ou "liste três pontos principais". Para mais informações, consulte as práticas recomendadas para design de comandos.
- Otimização de comandos: o otimizador de comandos da plataforma de agentes permite melhorar e otimizar rapidamente o desempenho dos comandos em grande escala e elimina a necessidade de reescrever manualmente. O otimizador ajuda você a adaptar comandos de maneira eficiente em diferentes modelos.
Design de esquema e ajuste de consultas do Spanner Graph
Para recomendações sobre como otimizar o desempenho do Spanner Graph, consulte a seguinte documentação:
- Práticas recomendadas para projetar um esquema do Spanner Graph
- Práticas recomendadas para ajustar consultas do Spanner Graph
Alocação de recursos do Cloud Run functions
Por padrão, cada instância de função do Cloud Run recebe uma CPU e 256 MiB de memória. Dependendo dos requisitos de desempenho, é possível configurar limites de CPU e memória. Para mais informações, consulte a seguinte documentação:
Para mais orientações sobre otimização de desempenho, consulte Dicas gerais de desenvolvimento do Cloud Run.
Uploads compostos paralelos do Cloud Storage
Para fazer upload de arquivos grandes, use uploads compostos paralelos. Com essa estratégia, o arquivo grande é dividido em fragmentos. Esses fragmentos são transferidos para o Cloud Storage em paralelo e, em seguida, os dados são recompostos na nuvem. Quando a largura de banda da rede e a velocidade do disco não estão limitando os fatores, os uploads compostos paralelos podem ser mais rápidos do que as operações de upload normais. No entanto, essa estratégia tem algumas limitações e implicações de custo. Para mais informações, consulte Uploads compostos paralelos.
Recomendações de otimização de desempenho para todos os produtos na arquitetura
Depois de implantar a carga de trabalho no Google Cloud, otimize ainda mais o desempenho dos recursos de nuvem aplicando as recomendações relevantes do Active Assist.
Para princípios e recomendações de otimização de desempenho específicos para cargas de trabalho de IA e ML, consulte Perspectiva de IA e ML: otimização de desempenho no Well-Architected Framework.
Implantação
Para saber como o GraphRAG funciona no Google Cloud, faça o download e execute o seguinte notebook do Jupyter no GitHub: GraphRAG no Google Cloud com o Spanner Graph e o Agent Runtime na Gemini Enterprise Agent Platform.
A seguir
- Criar aplicativos GraphRAG usando o Spanner Graph e o LangChain
- Escolha os componentes da arquitetura de IA agêntica
- Infraestrutura de RAG para IA generativa usando a Agent Platform e a Pesquisa Vetorial
- Infraestrutura de RAG para IA generativa usando a Plataforma de Agentes e o AlloyDB para PostgreSQL
- Infraestrutura de RAG para IA generativa usando o GKE e o Cloud SQL
- Infraestrutura de RAG para IA generativa usando o Gemini Enterprise e a Agent Platform
- Para saber mais sobre princípios e recomendações de arquitetura para cargas de trabalho de IA no Google Cloud, consulte o Framework de arquitetura: perspectiva de IA e ML.
- Para mais arquiteturas de referência, diagramas e práticas recomendadas, confira a Central de arquitetura do Cloud.
Colaboradores
Autores:
- Tristan Li | Arquiteto principal, IA/ML
- Kumar Dhanagopal | Desenvolvedor de soluções para vários produtos
Outros colaboradores:
- Ahsif Sheikh | Engenheiro de clientes de IA
- Ashish Chauhan | Engenheiro de clientes de IA
- Greg Brosman | Gerente de produtos
- Lukas Bruderer | Gerente de produtos, IA do Google Cloud
- Nanditha Embar | Engenheira de clientes de IA
- Piyush Mathur | Gerente de produtos, Spanner
- Smitha Venkat | Engenheira de Clientes de IA