


Mit der Arbeitslastisolation in Google Distributed Cloud (GDC) mit Air Gap können Sie Container- und VM-Anwendungen über Projekte und Kubernetes-Cluster hinweg trennen. Wenn Sie die Grenzen der Umgebung planen, können Sie Zugriffsrichtlinien steuern, die Auswirkungen von Wartungsarbeiten begrenzen und die Knotenkapazität optimieren. Sie können diese Architekturmuster an die spezifischen Anforderungen der einzelnen GDC-Universen anpassen.
Dieses Dokument richtet sich an IT-Mitarbeiter in der Gruppe der Plattformadministratoren, die Organisationsressourcen verwalten, und an Entwickler in der Gruppe der Anwendungsoperatoren, die Dienste verwalten. Weitere Informationen finden Sie unter Zielgruppen für die Dokumentation zu GDC mit Air Gap.
Wo Arbeitslasten bereitgestellt werden sollen
Auf der GDC-Plattform unterscheiden sich die Vorgänge zum Bereitstellen von VM-Arbeitslasten und Containerarbeitslasten. Das folgende Diagramm veranschaulicht die Trennung von Arbeitslasten innerhalb der Datenebene Ihrer Organisation.
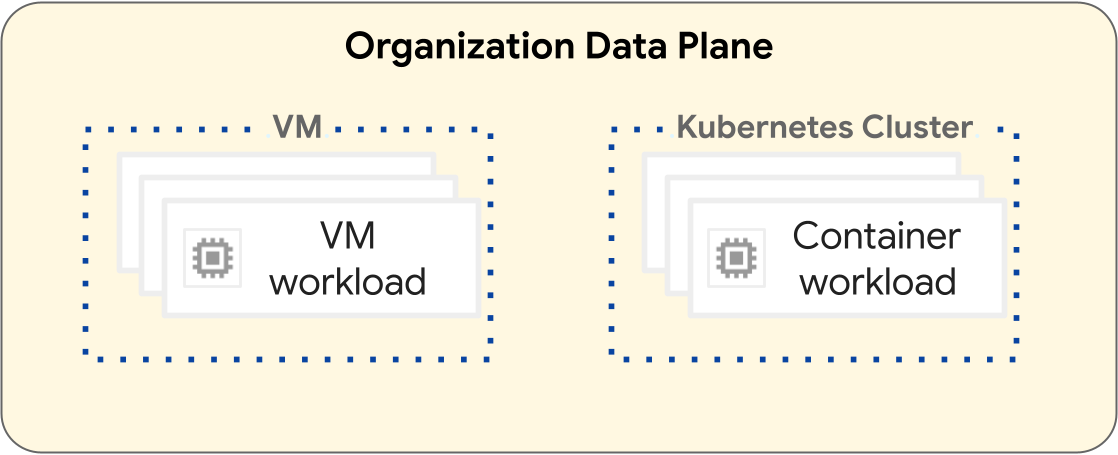
VM-basierte Arbeitslasten werden in einer VM ausgeführt. Containerarbeitslasten werden dagegen in einem Kubernetes-Cluster ausgeführt. Die grundlegende Trennung zwischen VMs und Kubernetes-Clustern sorgt für Isolationsgrenzen zwischen Ihren VM- und Containerarbeitslasten. Weitere Informationen finden Sie unter Ressourcenhierarchie.
In den folgenden Abschnitten werden die Unterschiede zwischen den einzelnen Arbeitslasttypen und ihrem Bereitstellungslebenszyklus vorgestellt.
VM-basierte Arbeitslasten
Sie können VMs erstellen, um Ihre VM-basierten Arbeitslasten zu hosten. Sie haben viele Konfigurationsoptionen für die Form und Größe Ihrer VM, um die Anforderungen Ihrer VM-basierten Arbeitslast optimal zu erfüllen. Sie müssen eine VM in einem Projekt erstellen, das viele VM-Arbeitslasten enthalten kann. VMs sind untergeordnete Ressourcen eines Projekts. Weitere Informationen finden Sie in der VM-Übersicht.
Projekte, die nur VM-basierte Arbeitslasten enthalten, erfordern keinen Kubernetes-Cluster. Daher müssen Sie keine Kubernetes-Cluster für VM-basierte Arbeitslasten bereitstellen.
Containerbasierte Arbeitslasten
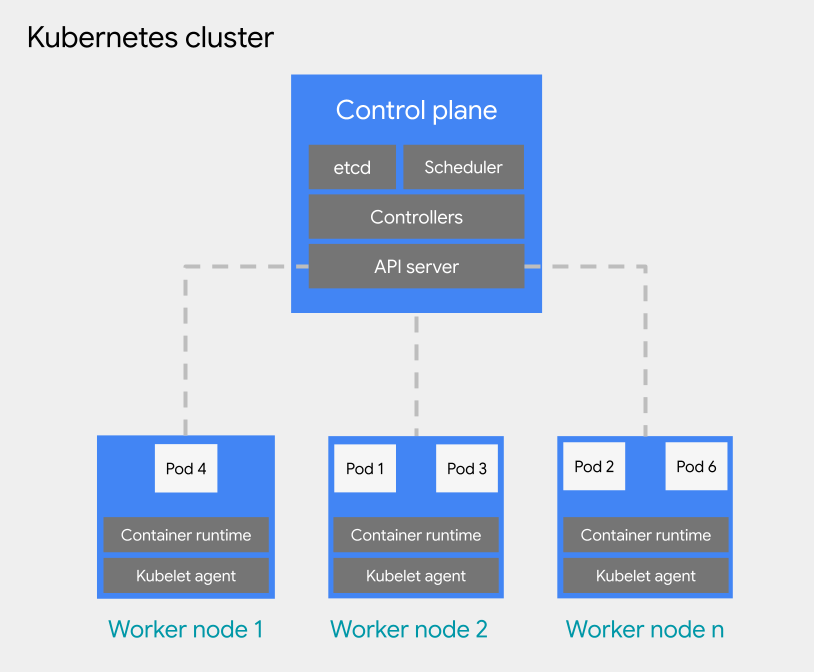
Sie können containerbasierte Arbeitslasten in einem Pod in einem Kubernetes-Cluster bereitstellen. Ein Kubernetes-Cluster besteht aus den folgenden Knotentypen:
Knoten der Steuerungsebene: Führt die Verwaltungsdienste wie Planung, etcd und einen API-Server aus.
Worker-Knoten: Führt Ihre Pods und Containeranwendungen aus.
Es gibt zwei Konfigurationstypen für Kubernetes-Cluster:
- Gemeinsam genutzte Cluster: Ein Kubernetes-Cluster auf Organisationsebene, der sich über mehrere Projekte erstrecken kann und nicht von einem einzelnen Projekt verwaltet wird, sondern mit ihnen verknüpft ist.
- Standardcluster: Ein projektbezogener Kubernetes-Cluster, der Clusterressourcen innerhalb eines Projekts verwaltet und sich nicht über mehrere Projekte erstrecken kann.
Weitere Informationen finden Sie unter Kubernetes-Clusterkonfigurationen.
Kubernetes-Cluster bieten verschiedene Optionen für die Ressourcenhierarchie, da freigegebene Cluster auf Organisationsebene und Standardcluster auf Projektebene gelten. Dies ist ein grundlegender Unterschied zwischen Kubernetes-Clustern und VMs. Eine VM ist eine untergeordnete Ressource eines Projekts und kann nicht so konfiguriert werden, dass sie außerhalb eines Projekts ausgeführt wird. Weitere Informationen zum Entwerfen Ihrer Kubernetes-Clusterinfrastruktur finden Sie unter Best Practices für das Entwerfen von Kubernetes-Clustern.
Für die Pod-Planung innerhalb eines Kubernetes-Clusters verwendet GDC die allgemeinen Kubernetes-Konzepte für Planung, Preemption und Bereinigung. Die Best Practices für die Planung von Pods in einem Cluster hängen von den Anforderungen Ihrer Arbeitslast ab.
Weitere Informationen zu Kubernetes-Clustern finden Sie in der Übersicht über Kubernetes-Cluster. Weitere Informationen zum Verwalten von Containern in einem Kubernetes-Cluster finden Sie unter Containerarbeitslasten in GDC.
Best Practices für das Entwerfen von Kubernetes-Clustern
In diesem Abschnitt werden Best Practices für das Entwerfen von Kubernetes-Clustern vorgestellt:
- Separate Cluster pro Softwareentwicklungsumgebung erstellen
- Weniger, größere Cluster erstellen
- Weniger, größere Knotenpools in einem Cluster erstellen
Berücksichtigen Sie jede Best Practice, um ein robustes Clusterdesign für den Lebenszyklus Ihrer Containerarbeitslast zu entwerfen.
Separate Cluster pro Softwareentwicklungsumgebung erstellen
Zusätzlich zu separaten Projekten pro Softwareentwicklungsumgebung empfehlen wir, separate Kubernetes-Cluster pro Softwareentwicklungsumgebung zu entwerfen. Eine Softwareentwicklungsumgebung ist ein Bereich in Ihrem GDC-Universum, der für alle Vorgänge vorgesehen ist, die einer bestimmten Lebenszyklusphase entsprechen. Wenn Sie beispielsweise drei Softwareentwicklungsumgebungen mit den Namen development, staging und production in Ihrer Organisation haben, können Sie für jede Umgebung einen separaten Satz von Kubernetes-Clustern erstellen und Projekte je nach Bedarf an jeden Cluster anhängen.
Wir empfehlen, Standardcluster in Vorproduktionslebenszyklen zu verwenden, die auf ein einzelnes Projekt beschränkt sind. So können alle destruktiven Prozesse im Zusammenhang mit Tests von Produktionsprojekten isoliert werden. Freigegebene Cluster sind dagegen ideal für Produktionsumgebungen, die sich über mehrere Projekte erstrecken können. Ein freigegebener Cluster, der Produktionsarbeitslasten hostet, die sich über mehrere Projekte erstrecken, bietet einen freigegebenen Bereitstellungsbereich, in dem Standardcluster, die auf ein einzelnes Projekt beschränkt sind, ihre Arbeitslasten direkt in die Produktionsumgebung übertragen können.
Bei definierten Standardclustern für jede Softwareentwicklungsumgebung wird davon ausgegangen, dass Vorproduktionsarbeitslasten innerhalb einer Softwareentwicklungsumgebung auf diesen Cluster beschränkt sind. Ein Kubernetes-Cluster kann weiter in mehrere Knotenpools unterteilt werden oder Markierungen für die Arbeitslastisolation verwenden.
Durch die Trennung von Kubernetes-Clustern nach Softwareentwicklungsumgebung isolieren Sie den Ressourcenverbrauch, die Zugriffsrichtlinien, die Wartungsereignisse und die Konfigurationsänderungen auf Clusterebene zwischen Ihren Produktions- und Nicht-Produktionsarbeitslasten.
Das folgende Diagramm zeigt ein Beispiel für ein Kubernetes-Clusterdesign für mehrere Arbeitslasten, die sich über Projekte, Cluster, Softwareentwicklungsumgebungen und Maschinenklassen erstrecken, die von verschiedenen Knotenpools bereitgestellt werden.
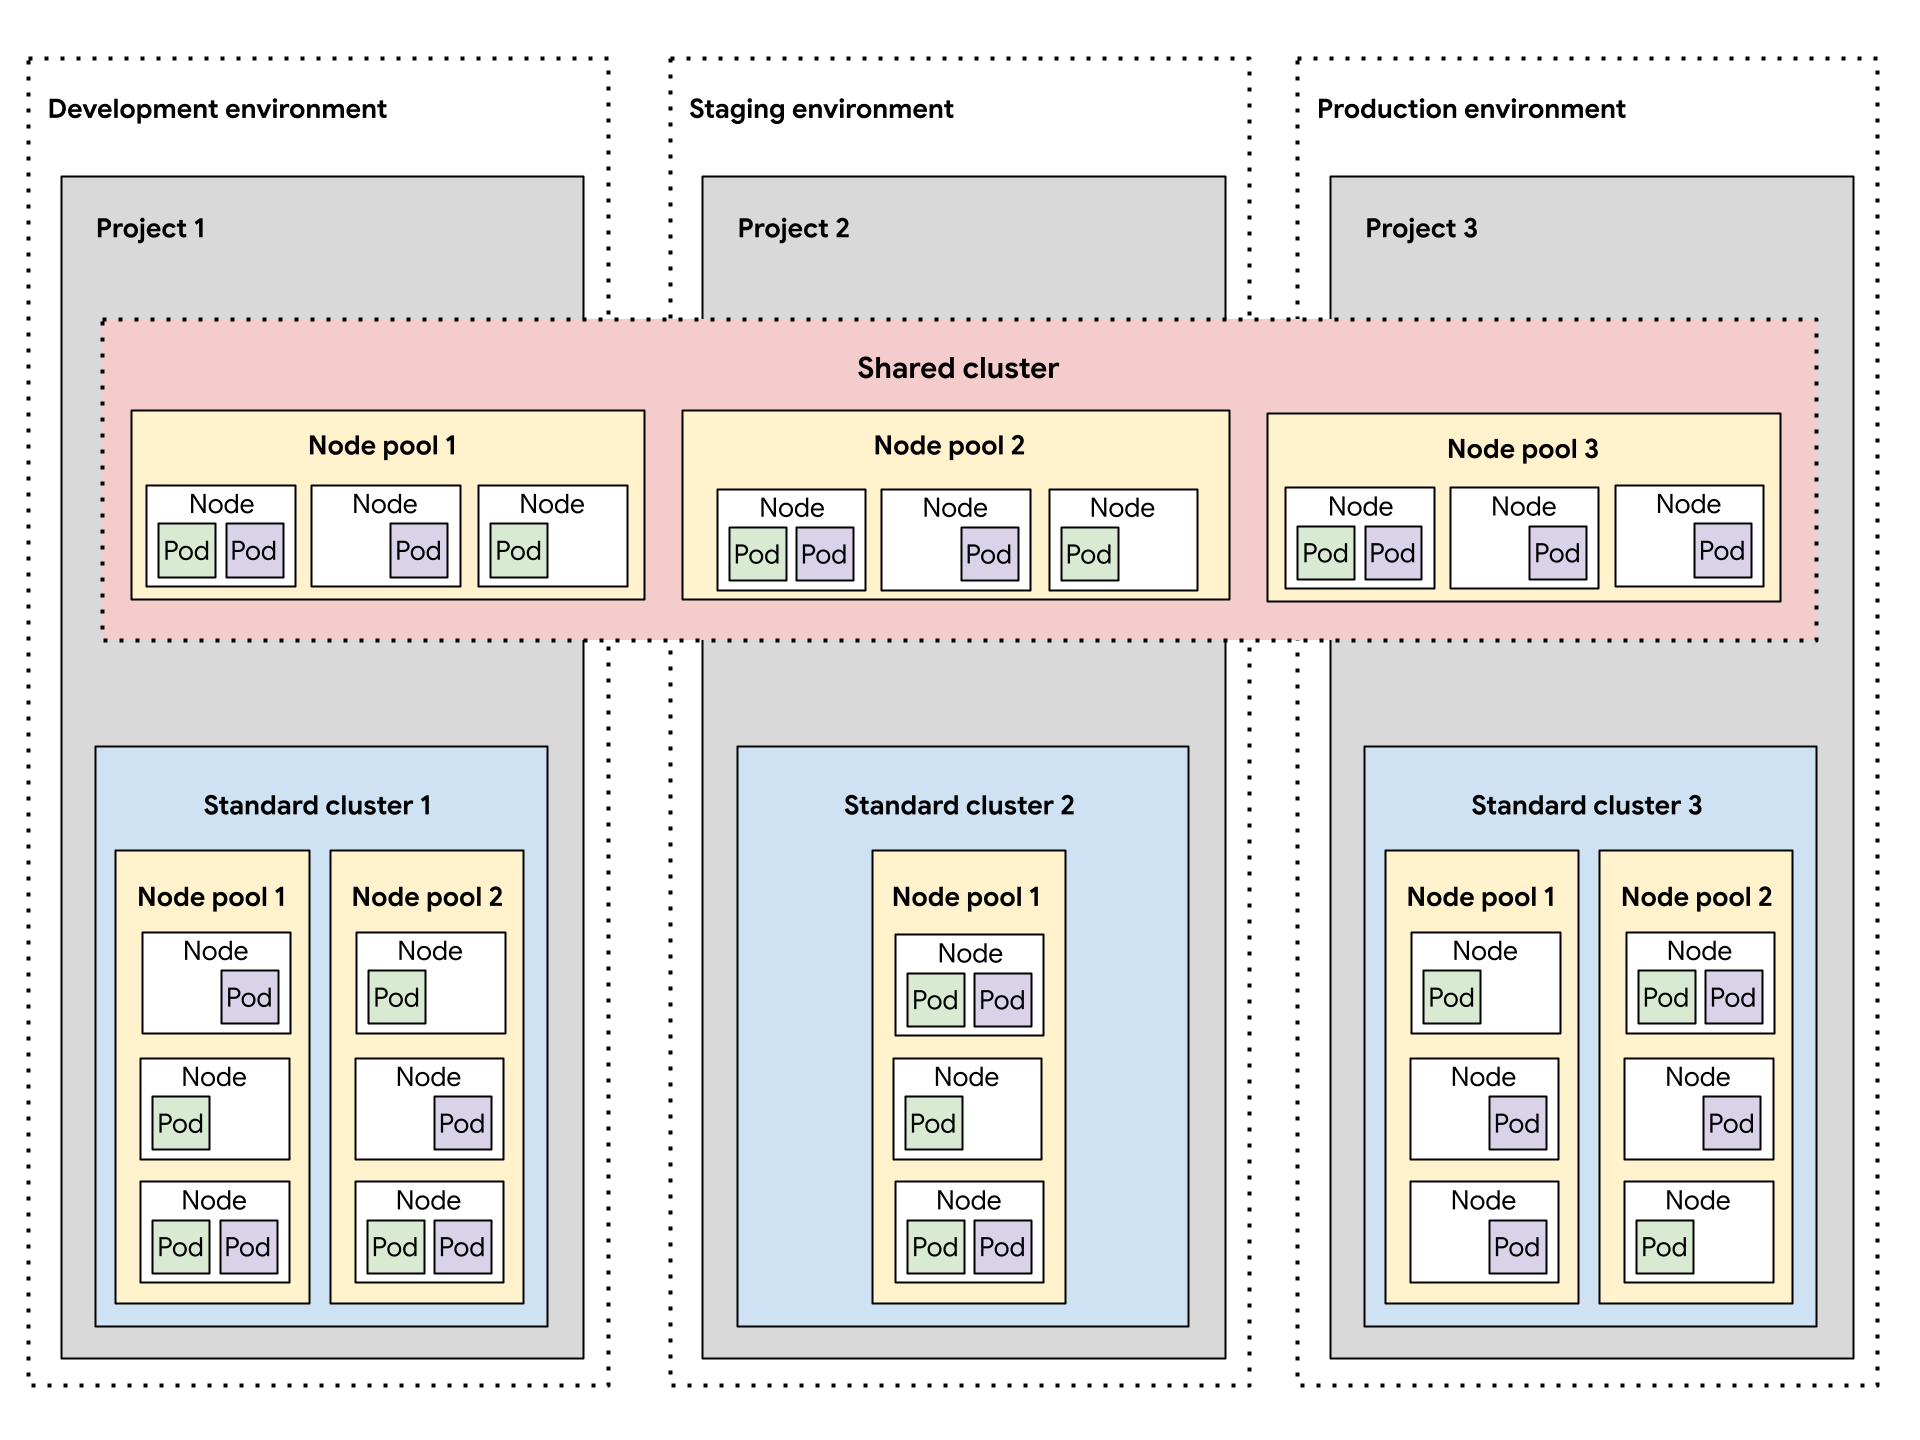
In dieser Beispielarchitektur wird davon ausgegangen, dass Arbeitslasten in den Softwareentwicklungsumgebungen für Entwicklung, Staging und Produktion Cluster gemeinsam nutzen können. Jede Umgebung hat einen separaten Standardcluster, der weiter in mehrere Knotenpools für unterschiedliche Maschinenklassenanforderungen unterteilt ist. Der freigegebene Cluster umfasst alle Softwareentwicklungsumgebungen und bietet einen gemeinsamen Bereitstellungsbereich für alle Umgebungen.
Alternativ ist das Entwerfen mehrerer Standardcluster pro Softwareentwicklungsumgebung für Containervorgänge wie die folgenden Szenarien nützlich:
- Sie haben einige Arbeitslasten an eine bestimmte Kubernetes-Version gebunden, sodass Sie verschiedene Cluster mit unterschiedlichen Versionen verwalten.
- Sie haben einige Arbeitslasten, die unterschiedliche Clusterkonfigurationen erfordern, z. B. die Sicherungsrichtlinie. Daher erstellen Sie mehrere Cluster mit unterschiedlichen Konfigurationen.
- Sie führen Kopien eines Clusters parallel aus, um störende Versionsupgrades oder eine Blau/Grün-Bereitstellungsstrategie zu ermöglichen.
- Sie erstellen eine experimentelle Arbeitslast, bei der die Gefahr besteht, dass der API-Server oder andere Single Points of Failure innerhalb eines Clusters gedrosselt werden. Daher isolieren Sie sie von vorhandenen Arbeitslasten.
Sie müssen Ihre Softwareentwicklungsumgebungen an die Anforderungen Ihrer Container-Vorgänge anpassen.
Weniger Cluster erstellen
Für eine effiziente Ressourcennutzung empfehlen wir, die geringste Anzahl von Kubernetes-Clustern zu entwerfen, die Ihre Anforderungen an die Trennung von Softwareentwicklungsumgebungen und Containervorgängen erfüllen. Jeder zusätzliche Cluster verursacht zusätzlichen Ressourcenverbrauch, z. B. durch zusätzliche Knoten der Steuerungsebene. Daher werden die zugrunde liegenden Rechenressourcen in einem größeren Cluster mit vielen Arbeitslasten effizienter genutzt als in vielen kleinen Clustern.
Wenn es mehrere Cluster mit ähnlichen Konfigurationen gibt, entsteht zusätzlicher Wartungsaufwand, um die Clusterkapazität zu überwachen und clusterübergreifende Abhängigkeiten zu planen.
Wenn ein Cluster seine Kapazitätsgrenze erreicht, sollten Sie dem Cluster zusätzliche Knoten hinzufügen, anstatt einen neuen Cluster zu erstellen.
Weniger Knotenpools in einem Cluster erstellen
Für eine effiziente Ressourcennutzung empfehlen wir, weniger, aber größere Knotenpools in einem Kubernetes-Cluster zu entwerfen.
Die Konfiguration mehrerer Knotenpools ist nützlich, wenn Sie Pods planen müssen, die eine andere Maschinenklasse als andere erfordern. Erstellen Sie für jede Maschinenklasse, die Ihre Arbeitslasten erfordern, einen Knotenpool und legen Sie die Knotenkapazität auf Autoscaling fest, um eine effiziente Nutzung der Rechenressourcen zu ermöglichen.