


Esta arquitectura de referencia proporciona un marco conceptual para implementar y operar bases de datos de PostgreSQL administradas por el cliente en Google Distributed Cloud (GDC) air-gapped. Esta solución permite a las organizaciones mantener cargas de trabajo de bases de datos críticas aprovechando un clúster de alta disponibilidad (HA) y multizona implementado en máquinas virtuales.
La arquitectura se centra en una configuración resistente de 3 nodos que garantiza la disponibilidad de la base de datos incluso en caso de una sola zona o falla de infraestructura. Abarca todo el ciclo de vida, desde el aprovisionamiento y la conexión en red automatizados hasta las operaciones de nivel de producción, como la alta disponibilidad, la copia de seguridad, el restablecimiento y la observabilidad.
Características y funciones
La solución proporciona varios componentes funcionales principales para la administración de bases de datos:
- Alta disponibilidad automatizada: Usa Patroni y etcd para proporcionar la elección y la conmutación por error automáticas del líder, lo que garantiza que la base de datos siga operativa sin intervención manual.
- Resiliencia multizona: Distribuye los nodos de la base de datos en tres zonas de disponibilidad distintas para protegerlos contra interrupciones localizadas de hardware o infraestructura.
- Automatización estandarizada: Aprovisiona toda la pila con libros de jugadas basados en Ansible con Autobase para garantizar implementaciones repetibles y coherentes.
- Agrupación de conexiones: Servicio PgBouncer integrado para administrar recuentos de conexiones altos y estabilizar el consumo de recursos en los nodos de la base de datos.
- Balanceo de cargas global: Usa el balanceador de cargas global de nivel 4 administrado por la plataforma para proporcionar una sola IP virtual (VIP) estable a la que se pueda acceder en todas las zonas.
- Preparación para air-gapped: Flujos de trabajo especializados para empaquetar todas las dependencias y los objetos binarios del sistema operativo necesarios para la implementación en entornos desconectados.
- Protección de datos: Aprovecha las herramientas estándar, como
pg_dumpypg_basebackup, junto con las instantáneas de almacenamiento de GDC para mantener una estrategia sólida de copia de seguridad y recuperación.
Arquitectura
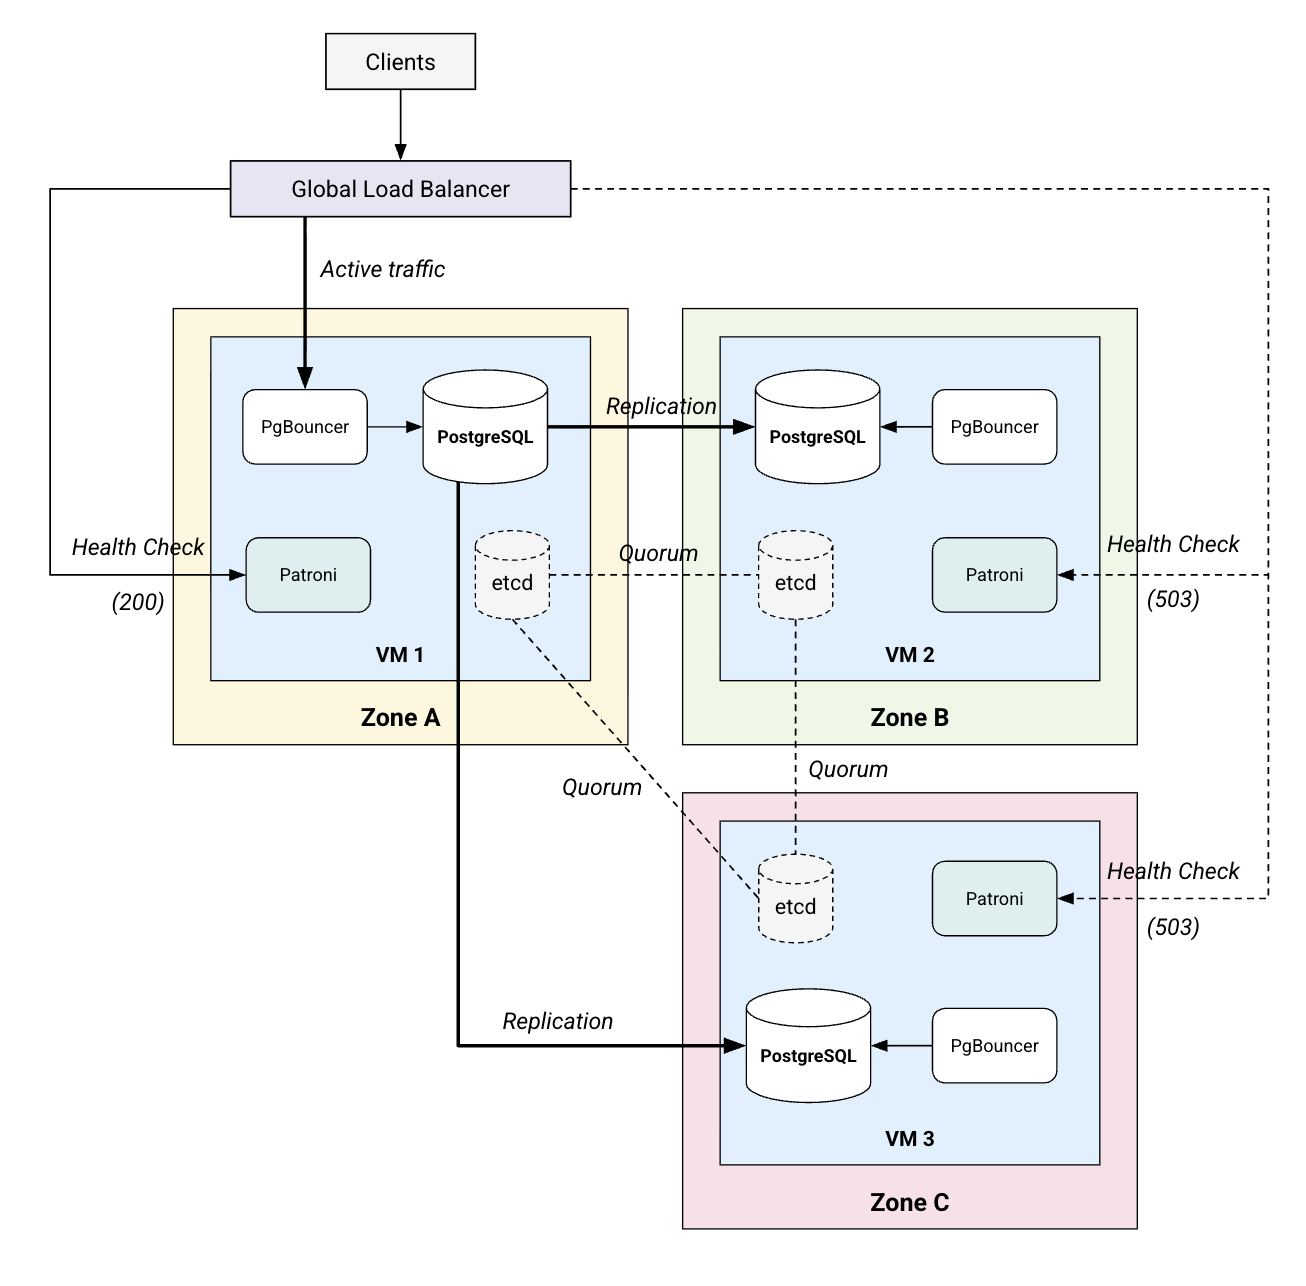
La arquitectura consta de un entorno de tres VM distribuidas en tres zonas de disponibilidad que ejecutan una pila de servicios colocada.
Principios de arquitectura
- Consenso basado en la mayoría: Usa un modelo basado en quórum en el que la mayoría de los nodos (2 de 3) deben estar de acuerdo con el estado del clúster, lo que evita situaciones de "cerebro dividido" y garantiza la integridad de los datos.
- Separación de intereses: Cada VM ejecuta una pila de servicios colocada, pero distinta (base de datos, administrador de HA, consenso y agrupador) para proporcionar un nodo autónomo y resistente.
- Conmutación por error compatible con la base de datos: Prioriza las métricas de estado de la base de datos con la API de REST de Patroni para coordinar el redireccionamiento del tráfico a través del balanceador de cargas de la plataforma.
- Infraestructura como código: Se basa en libros de jugadas automatizados para todas las tareas de configuración, lo que reduce el riesgo de errores humanos durante la implementación y el ajuste de escala.
Conceptos y tecnologías
En esta sección, se detallan los componentes funcionales, sus responsabilidades y cómo se comunican dentro del sistema.
Infraestructura y plataforma
- Máquinas virtuales (VMs): Instancias de procesamiento dedicadas distribuidas en zonas para alojar la pila de la base de datos.
- Balanceador de cargas global de nivel 4: Un servicio administrado por la plataforma que proporciona una IP virtual (VIP) estable que enruta el tráfico al líder del clúster actual.
- Almacenamiento persistente: Se requiere almacenamiento respaldado por SSD de alto rendimiento para cumplir con los estrictos requisitos de latencia de los registros de escritura por adelantado de la capa de consenso.
Servicios y lógica
- PostgreSQL 17: El motor de base de datos relacional principal responsable de la persistencia de los datos y la ejecución de consultas.
- Patroni: El administrador de alta disponibilidad que supervisa el proceso local de PostgreSQL y coordina las elecciones de líder con etcd.
- etcd: El almacén de configuración distribuido que proporciona la capa de consenso y contiene el estado autoritario del clúster.
- PgBouncer: Un agrupador de conexiones liviano que se encuentra frente a PostgreSQL para controlar las conexiones de aplicaciones entrantes de manera eficiente.
Flujo de datos e interfaces
- PgBouncer (puerto 6432): El punto de entrada principal para el tráfico de la base de datos de la aplicación.
- API de Patroni (puerto 8008): Una interfaz HTTPS REST que usa el balanceador de cargas para realizar verificaciones de estado y, también, identificar el líder actual con el extremo
/primary. - etcd (puerto 2379): El canal de comunicación para que el clúster de consenso mantenga el estado y realice elecciones.
Consideraciones
- Escalabilidad y rendimiento:
- Los nodos de la base de datos deben tener un tamaño basado en la carga de trabajo, con un mínimo de 2 vCPUs y 8 GiB de RAM. Por lo general, las cargas de trabajo de producción comienzan con 8 vCPUs y 32 GiB.
- El rendimiento depende del almacenamiento de baja latencia; se requieren SSD para garantizar que etcd pueda procesar las sincronizaciones de datos en menos de 10 ms.
- Replicación síncrona: La sobrecarga de la replicación síncrona depende directamente de la latencia de la red entre zonas. Para garantizar un rendimiento óptimo para las configuraciones sin pérdida de datos, se requiere una latencia baja entre zonas.
- Administración de recursos y licencias:
- Esta solución se basa en componentes de base de datos de código abierto y gratuitos.
- Autobase se usa como la herramienta de automatización de referencia para optimizar la instalación y la configuración de la pila de HA. Sin embargo, la arquitectura no está vinculada exclusivamente a Autobase, y los componentes subyacentes de código abierto se pueden administrar con canalizaciones personalizadas.
- Para las organizaciones que requieren asistencia formal para el paquete de automatización, está disponible la asistencia pagada de terceros.
- La agrupación de conexiones con PgBouncer es esencial para evitar el agotamiento de la CPU y la memoria causado por una gran cantidad de conexiones de usuarios.
- Disponibilidad y confiabilidad:
- La alta disponibilidad se logra a través de un quórum de 3 nodos. La falla de un solo nodo o zona no interrumpe el servicio.
- Estabilidad del clúster: Mantener un quórum confiable requiere una latencia de red baja entre los nodos. Lo ideal es que los tiempos promedio de ida y vuelta (RTT) sean inferiores a 10 ms para evitar los tiempos de espera de elección y la inestabilidad del clúster.
- Administración operativa:
- Las tareas de rutina, como la aplicación de parches de versiones secundarias y las actualizaciones principales, siguen siendo responsabilidad del equipo de operaciones del cliente.
- Los resultados de
stdoutde las VMs se transfieren automáticamente a la plataforma de supervisión de GDC aislado. En el futuro, se publicará una guía sobre cómo integrar una supervisión más detallada para los componentes individuales. - Se debe implementar una estrategia sólida de copia de seguridad con herramientas nativas de la base de datos y instantáneas de la plataforma. Las guías detalladas para estos procedimientos se publicarán por separado.
Decisión de diseño
Las opciones de arquitectura para esta solución proporcionan una ruta resistente para las implementaciones multizona.
Máquinas virtuales en lugar de Kubernetes
Se seleccionó un enfoque basado en VM para proporcionar alta disponibilidad multizona. GDC no admite clústeres de Kubernetes que abarquen varias zonas físicas. Por lo tanto, es necesario implementar VMs dedicadas en zonas separadas para lograr una arquitectura sólida entre zonas. Esta configuración puede sobrevivir a la falla total de una sola zona de infraestructura.
Balanceo de cargas global nativo de la plataforma
La arquitectura aprovecha el balanceador de cargas global de nivel 4 de GDC en lugar de los proxies basados en software en las VMs. Este enfoque proporciona varias ventajas:
- Alcance global: Proporciona una IP virtual estable a la que se puede acceder en todas las zonas.
- Administración de la plataforma: La VIP se administra de forma independiente con el plano de control de la plataforma.
- Conmutación por error simplificada: La conmutación por error se administra a través de sondas de verificación de estado estándar en lugar de configuraciones de software local complejas.
- Alta disponibilidad: Quitar la dependencia de los proxies locales garantiza que el punto de entrada para el tráfico de la base de datos siga siendo resistente.
Suposiciones y limitaciones
Suposiciones
- El entorno tiene un registro o mecanismo local para importar objetos binarios y dependencias del SO empaquetados.
- El acceso SSH basado en claves está disponible para todas las VMs de destino para la automatización basada en Ansible.
- El proyecto tiene una cuota suficiente para el aprovisionamiento de VM y balanceadores de cargas multizona.
Limitaciones
- Mantenimiento manual: La aplicación de parches del sistema operativo y las actualizaciones de la versión de PostgreSQL son tareas manuales y no están automatizadas por la solución.
- Sensibilidad del almacenamiento: La capa de consenso (etcd) es muy sensible a la latencia del disco. La contención alta y sostenida del almacenamiento puede afectar la estabilidad de la capa de consenso.
- Estabilidad de la red: El administrador de alta disponibilidad se basa en una conectividad de red coherente y de baja latencia entre las zonas. Los retrasos o la fluctuación de la red pueden influir en el tiempo de la coordinación del clúster y las transiciones de roles.
Materiales adicionales
- Repositorio de código de automatización de referencia: Código fuente de Autobase en GitHub
- Implementación de referencia de la base de datos de PostgreSQL