


En esta guía, se proporciona un recorrido completo para implementar una pila de PostgreSQL con alta disponibilidad en tres zonas en un entorno aislado de Google Distributed Cloud (GDC). Aprenderás a preparar los artefactos de software necesarios, iniciar las VMs de destino y usar Autobase para automatizar todo el proceso de aprovisionamiento. En esta guía, se usa Patroni como la capa de administración principal para organizar el ciclo de vida de PostgreSQL y controlar las conmutaciones por error automáticas.
Arquitectura
La arquitectura consta de un entorno de tres VM distribuidas en tres zonas de disponibilidad.
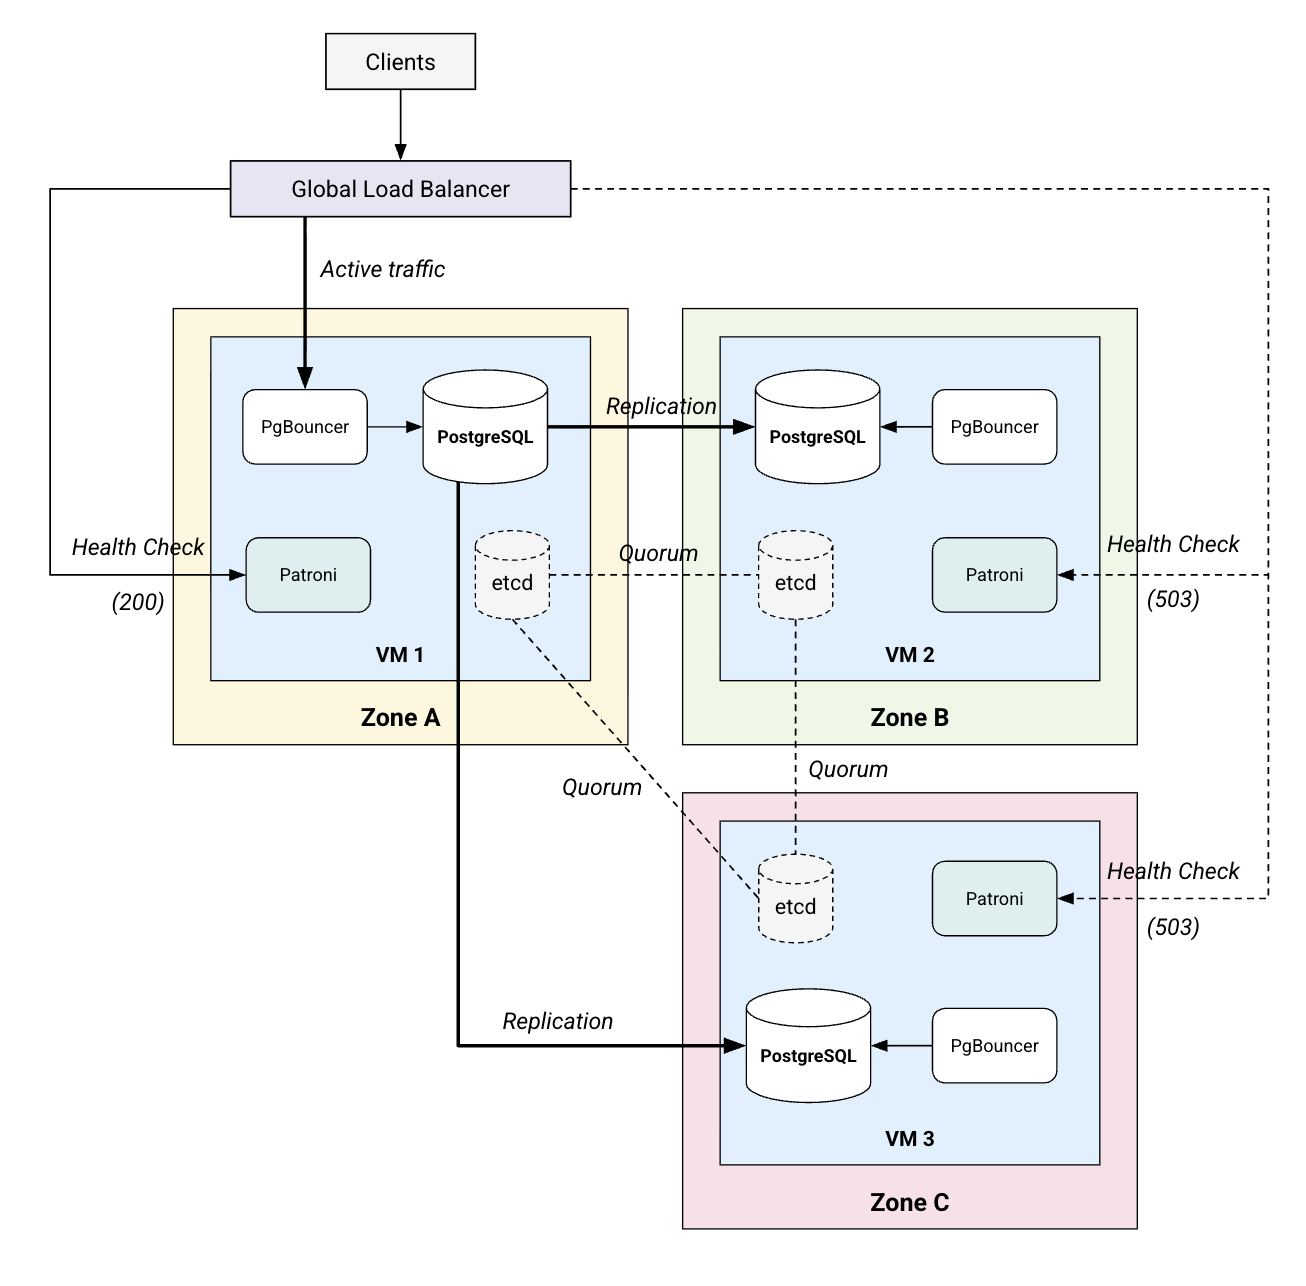
Cada VM es idéntica y ejecuta una pila de servicios colocada:
- PostgreSQL 17: Es el motor de base de datos relacional principal.
- Patroni: Es el administrador de alta disponibilidad. Controla el ciclo de vida del proceso de PostgreSQL y realiza conmutaciones por error automáticas. Expone una API de REST HTTPS en el puerto
8008(extremo/primary) que usa el balanceador de cargas para identificar el líder actual. - etcd: Es el almacén de configuración distribuida (DCS). Proporciona la capa de consenso para la elección del líder y almacena la configuración de Patroni.
- PgBouncer: Es un agrupador de conexiones que se encuentra frente a PostgreSQL para estabilizar la sobrecarga de conexión. Proporciona el punto de entrada recomendado para el tráfico de aplicaciones en el puerto
6432.
La pila también incluye un balanceador de cargas global de capa 4 aislado de GDC, que es un servicio administrado por la plataforma que proporciona una IP virtual (VIP) estable. Las aplicaciones se conectan a la VIP estable en el puerto 6432, que el balanceador de cargas enruta a PgBouncer en la VM del líder actual. Luego, PgBouncer reenvía la solicitud a la instancia local de PostgreSQL. Para administrar el flujo de tráfico, el balanceador de cargas sondea continuamente los extremos HTTPS de Patroni como una verificación de estado.
La verificación de estado en la VM del líder muestra HTTP 200 OK para indicar que la VM está lista para el tráfico, mientras que las verificaciones de estado en las VMs de réplica muestran HTTP 503 Service Unavailable para indicarle al balanceador de cargas que las omita. Si falla el líder, se elige uno nuevo y su instancia de Patroni comienza a mostrar HTTP 200 OK, lo que hace que el balanceador de cargas redireccione automáticamente el tráfico al puerto PgBouncer de la VM nueva.
Para garantizar la alta disponibilidad y evitar la pérdida de datos, la pila se basa en el concepto de un quórum. Con 3 VMs, el sistema requiere que la mayoría de al menos dos miembros estén en buen estado y en comunicación para elegir un líder y seguir funcionando. Este consenso basado en la mayoría, administrado por etcd y Patroni, permite que la pila tolere automáticamente la falla total de cualquier VM o zona.
Consideraciones de rendimiento
Cuando planifiques tu implementación, considera los siguientes factores concretos para optimizar el rendimiento y la confiabilidad:
- Tamaño del hardware: Si bien los requisitos varían según la carga de trabajo, usa estos perfiles estándar como punto de partida para cada VM:
- Desarrollo/prueba de concepto: 2 CPU virtuales, 8 GB de RAM (mínimo para un funcionamiento estable)
- Producción pequeña: 4 CPU virtuales, 16 GB de RAM. Adecuado para herramientas internas con simultaneidad moderada
- Producción estándar: 8 CPU virtuales, 32 GB de RAM. La línea de base recomendada para aplicaciones de misión crítica
- Alto rendimiento: 16 o más CPU virtuales, 64 GB o más de RAM. Para cargas de trabajo que requieren un almacenamiento en caché de datos extenso en la memoria (búferes compartidos de PostgreSQL)
- Rendimiento del almacenamiento: El almacenamiento de alto rendimiento es fundamental. Se recomiendan los discos SSD para la estabilidad de etcd. etcd es extremadamente sensible a la latencia de escritura del disco. Los lineamientos oficiales de hardware de etcd recomiendan una latencia de fdatasync WAL de disco p99 de < 10 ms.
- Latencia de red: La latencia entre las VMs afecta directamente el rendimiento de la replicación:
- Quórum de etcd: El tiempo de ida y vuelta (RTT) promedio debe ser < 50 ms (idealmente < 10 ms) para evitar los tiempos de espera de elección y la inestabilidad del clúster.
- Replicación síncrona: Si está configurada, cada transacción de escritura debe esperar la confirmación de una réplica. La latencia entre zonas en GDC aislado suele ser < 1 ms, lo que es excelente para mantener la sobrecarga de escritura al mínimo (por lo general, entre el 10 y el 30%).
- Función de PgBouncer: PostgreSQL crea un nuevo proceso de SO para cada conexión, que consume aproximadamente 10 MB de RAM y genera costos de cambio de contexto de CPU. PgBouncer reduce esta sobrecarga manteniendo un grupo de conexiones persistentes, lo que permite que la base de datos controle miles de conexiones de aplicaciones con muchos menos procesos de backend.
- Componentes de Sidecar: Patroni y etcd son livianos, pero requieren disponibilidad constante de CPU. En situaciones de carga alta, asegúrate de que las VMs no estén sobreasignadas a nivel del hipervisor para evitar "robar" los ciclos de CPU necesarios para los latidos y el mantenimiento del líder.
- Ajuste del kernel: La automatización de Autobase aplica automáticamente optimizaciones
beneficiosas para PostgreSQL, como configurar
sysctl
de sysctl (p.ej.,
vm.swappiness,net.core.somaxconn) y inhabilitar las páginas enormes transparentes (THP). Estos cambios reducen la sobrecarga de la administración de memoria y mejoran la capacidad de procesamiento de la red para las instancias de bases de datos con mucho tráfico.
Antes de comenzar
Antes de iniciar la implementación, debes asegurarte de que tu entorno cumpla con los siguientes requisitos.
Revisa los requisitos de la VM
Para los fines de este instructivo, debes crear tres VMs en tu proyecto de GDC aislado. Deberás tener en cuenta los siguientes puntos y requisitos para las VMs:
- Distribución de zonas: Para que esta implementación sea realmente resistente a las fallas de zona, debes distribuir las VMs en tres zonas de disponibilidad diferentes. Sin embargo, la implementación sigue siendo idéntica si las VMs se encuentran en dos zonas o incluso en una sola. Lo más importante es que todas las VMs puedan comunicarse entre sí a través de la red con sus direcciones IP internas.
- Sistema operativo: En este instructivo, se supone que usas imágenes de Ubuntu 22.04. Los pasos adicionales de esta guía pueden diferir si usas una distribución diferente.
- Recursos: Debes aprovisionar al menos 2 CPUs y 8 GB de memoria por VM para este instructivo. En producción, debes aprovisionar recursos adecuados para tus cargas de trabajo específicas (consulta Consideraciones de rendimiento).
- IPs de red: Debes tomar nota de las direcciones IP internas y externas de cada VM. En esta guía, usas IPs externas para el control de Ansible porque ejecutas comandos desde una estación de trabajo externa. Las IPs internas se usan para la comunicación y la vinculación entre servicios. Si aprovisionaste una VM de programa de arranque dentro de la red, solo necesitarías las IPs internas.
- Acceso: Se requiere acceso sudo sin contraseña para el usuario de implementación porque la automatización de Ansible necesita realizar tareas administrativas (instalar paquetes, modificar configuraciones del sistema) sin que se bloqueen las solicitudes de contraseña.
- SSH: Se debe habilitar la autenticación basada en claves para permitir que Ansible se conecte a las VMs de destino de forma segura y no interactiva.
Prepara el software de la estación de trabajo local
Para administrar la implementación y preparar los artefactos aislados, necesitarás un conjunto de herramientas de automatización y contenedorización instaladas en tu estación de trabajo local.
- Ansible 2.17.0 o versiones posteriores: Es el motor de automatización que ejecuta los playbooks y las funciones de implementación.
- Docker: Se usa para extraer y empaquetar dependencias del SO en un entorno idéntico a las VMs de destino (Ubuntu 22.04).
- Cliente de PostgreSQL (
psql): Es necesario para ejecutar las consultas de prueba y verificar la replicación de datos desde tu estación de trabajo local. El repositorio de Autobase:
- Clona el repositorio para acceder a los playbooks y las funciones de automatización: https://github.com/vitabaks/autobase
Extrae una versión específica (esta guía usa la versión 2.5.2):
git checkout 2.5.2Los pasos adicionales de esta guía pueden diferir si usas una distribución diferente.
Para ejecutar los playbooks de esta guía, debes instalar el código fuente
autobaselocal como una colección de Ansible para que se puedan resolver los prefijos de función:cd autobase/automation ansible-galaxy collection install . --force
Crea algunas variables de entorno
En esta guía, usarás las siguientes variables de entorno para simplificar los comandos. Estas variables almacenan parámetros críticos, como el ID del proyecto, las zonas de disponibilidad de tus VMs, sus nombres de host y las etiquetas que usa el balanceador de cargas para identificar tu clúster. Configúralas en tu sesión de shell actual con los valores reales de tu entorno (asegúrate de que las zonas estén separadas por espacios).
Ten en cuenta que, aunque puedes establecer los nombres que desees para tus VMs, esta guía usa postgres-vm-1, postgres-vm-2 y postgres-vm-3 como nombres de ejemplo arbitrarios para los nodos del clúster:
export PROJECT_ID="your-project-id"
export ZONES="zone1 zone2 zone3"
export VM1_NAME="postgres-vm-1"
export VM2_NAME="postgres-vm-2"
export VM3_NAME="postgres-vm-3"
export VM_LABEL="app=my-postgres-cluster"
export CLUSTER_NAME="my-postgres-cluster"
Configura Ansible
Define tu entorno de VM en el archivo inventory.ini con la siguiente plantilla:
[master]
postgres-vm-1 ansible_host=XX.XX.XX.XX hostname=postgres-vm-1 bind_address=XX.XX.XX.XX

[replica]
postgres-vm-2 ansible_host=XX.XX.XX.XX hostname=postgres-vm-2 bind_address=XX.XX.XX.XX
postgres-vm-3 ansible_host=XX.XX.XX.XX hostname=postgres-vm-3 bind_address=XX.XX.XX.XX

[postgres_cluster:children]
master
replica

[etcd_cluster]
postgres-vm-1
postgres-vm-2
postgres-vm-3

[all:vars]
ansible_user=...
ansible_ssh_private_key_file=~/.ssh/...
postgresql_version=17
with_haproxy_load_balancing=false
patroni_superuser_password=...
etcd_package_repo="file:///tmp/packages/etcd-v3.5.25-linux-amd64.tar.gz"
installation_method="packages"
install_postgresql_repo=false
install_timescale_repo=false
install_citus_repo=false
apt_repository=[]
yum_repository=[]
install_system_packages=false
patroni_installation_method=deb
Comprende la configuración:
[master]y[replica]: Define las VMs de base de datos principal y secundaria. Asegúrate de usar los nombres reales de las VM que se establecieron en las variables de entornoVM1_NAME,VM2_NAMEyVM3_NAME.[postgres_cluster:children]: Es un grupo que agrega los nodos principal y de réplica, lo que permite que Ansible oriente todo el clúster de base de datos con un solo comando.[etcd_cluster]: Define los nodos que participarán en el clúster de consenso de etcd. Esto incluye los tres nodos de base de datos para garantizar la alta disponibilidad.ansible_host: (Para cada VM) Es la IP de entrada externa de la VM que usa Ansible para conectarse a esa VM. ReemplazaXX.XX.XX.XXpor la IP externa real.bind_address: (Para cada VM) Es la dirección IP interna de la VM. ReemplazaXX.XX.XX.XXpor la IP interna real.ansible_user: Es el usuario remoto que Ansible usa para conectarse a las VMs de destino con SSH. Reemplaza...por el nombre de usuario real.ansible_ssh_private_key_file: Es la ruta de acceso local a la clave SSH privada que se usa para la autenticación en las VMs de destino. Reemplaza~/.ssh/...por la ruta de acceso real.patroni_superuser_password: Es la contraseña del usuariopostgres. Asegúrate de usar una contraseña segura aquí.with_haproxy_load_balancing=false: Inhabilita HAProxy local, ya que usas el balanceador de cargas de capa 4 nativo de la plataforma.etcd_package_repo: Apunta a la ruta de acceso local del objeto binario de etcd dentro del directorio de inicio de la VM.installation_method="packages": Indica a la automatización que instale componentes con paquetes del SO en lugar de compilar desde la fuente o usar pip de Python.install_..._repo=falsey_repository=[]: Estas anulaciones impiden que Ansible intente comunicarse con Internet para agregar repositorios externos o actualizar listas de paquetes.install_system_packages=false: Evita que la automatización intente descargar e instalar paquetes que ya aprovisionaste durante la fase de inicialización o de inicio.patroni_installation_method=deb: Le indica específicamente al rol que use el paquete.debque instalaste.
Inicializa las VMs
La pila de base de datos requiere varios paquetes y bibliotecas del SO que podrían no estar incluidos en tu imagen base de Ubuntu. Como las VMs se encuentran en un entorno aislado sin acceso a Internet, no pueden descargar estas dependencias por sí mismas.
Para resolver este problema, sigue estos pasos:
Usa un contenedor de Docker en tu estación de trabajo local para descargar todos los archivos necesarios. El siguiente comando usa
apt-rdependspara identificar de forma recursiva cada biblioteca compartida y dependencia que requieren las aplicaciones de destino. Configura el repositorio oficial de PostgreSQL dentro del contenedor para recuperar artefactos de la versión 17 y, luego, itera por la lista de dependencias para descargar archivos.debindividuales mientras filtra las bibliotecas principales del sistema (comolibc6ohostname) para evitar conflictos de versión en las VMs de destino. Por último, recupera el objeto binario de etcd independiente directamente desde GitHub.Primero, crea un directorio para contener los paquetes:
mkdir -p ./packagesLuego, ejecuta el comando de Docker para descargar todos los paquetes necesarios y el objeto binario de etcd:
docker run --rm --platform linux/amd64 -v "$(pwd)/packages:/packages" \
  ubuntu:22.04 bash -c "
  set -e
  apt-get update
  apt-get install -y ca-certificates curl gnupg apt-rdepends

  # Add PostgreSQL Repository
  curl -fsSL https://www.postgresql.org/media/keys/ACCC4CF8.asc | \
    gpg --dearmor -o /etc/apt/trusted.gpg.d/postgresql.gpg
  echo 'deb http://apt.postgresql.org/pub/repos/apt jammy-pgdg main' > \
    /etc/apt/sources.list.d/pgdg.list
  apt-get update

  # Define Application Targets + Explicit dependencies needed for air-gap
  TARGETS='unzip tar pgbouncer patroni netdata postgresql-17 \
    postgresql-client-17 postgresql-contrib-17 \
    postgresql-server-dev-17 postgresql-17-dbgsym \
    python3-psycopg2 python3-click python3-yaml python3-prettytable \
    python3-urllib3 python3-tz python3-pip python3-setuptools \
    python3-cryptography moreutils vim jq acl zstd libjq1 \
    libpython3.10-stdlib libexpat1-dev zlib1g-dev libipc-run-perl \
    libtime-duration-perl libjson-perl libpython3-dev \
    libjs-sphinxdoc python3-wheel'

  # Resolve all recursive dependencies
  ALL_DEPS=\$(apt-cache depends --recurse --no-recommends --no-suggests \
    --no-conflicts --no-breaks --no-replaces --no-enhances \$TARGETS | \
    grep '^\w' | sort -u)

  cd /packages
  for pkg in \$ALL_DEPS; do
    if apt-cache show \"\$pkg\" > /dev/null 2>&1; then
      # Filter system core to avoid VM conflicts/breaks
      # We exclude core OS libraries (libc, systemd, etc.) because these
      # often cause version conflicts if the VM's patch level differs
      # from the online container.
      FILTER='base-files|debianutils|coreutils|findutils|diffutils|sed'
      FILTER+='|grep|gzip|hostname|ncurses|perl-base|libc6|binutils'
      FILTER+='|linux-libc|libc-bin|libc-dev-bin|systemd|dpkg|init'
      if [[ ! \"\$pkg\" =~ \$FILTER ]]; then
        apt-get download \"\$pkg\" || echo \"Failed \$pkg\"
      fi
    fi
  done

  # Download etcd binary
  if [ ! -f etcd-v3.5.25-linux-amd64.tar.gz ]; then
    curl -L https://github.com/etcd-io/etcd/releases/download/v3.5.25/\
etcd-v3.5.25-linux-amd64.tar.gz -o etcd-v3.5.25-linux-amd64.tar.gz
  fi
"
Usa Ansible para subir el archivo a las tres VMs de destino de forma simultánea:
ansible all -i inventory.ini -m copy -a "src=packages.tar.gz dest=/tmp/" -bBorra los datos de paquetes existentes en las VMs y extrae el nuevo archivo tar:
ansible all -i inventory.ini -m shell -a "rm -rf /tmp/packages && \
  mkdir -p /tmp/packages && tar -xzf /tmp/packages.tar.gz -C /tmp/packages" -b
Realiza una instalación no interactiva de todos los paquetes
.debdescargados. Para evitar problemas con dependencias previas específicas en un entorno aislado, usa la marca--force-dependsseguida deapt-get install -fypara resolver el árbol de dependencias de forma local:ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a dpkg -i --force-depends /tmp/packages/*.deb" -b ansible all -i inventory.ini -m shell -a "DEBIAN_FRONTEND=noninteractive \ NEEDRESTART_MODE=a apt-get install -fy" -bDetén de inmediato todos los servicios para evitar que se inicien con estados predeterminados y sin configurar antes de que la automatización esté lista:
ansible all -i inventory.ini -m shell -a \
  "systemctl stop patroni etcd pgbouncer postgresql || true" -b
Por último, quita los clústeres predeterminados de PostgreSQL y los datos de etcd existentes para permitir una inicialización limpia:
ansible all -i inventory.ini -m shell -a \
  "pg_dropcluster 17 main --stop || true" -b
ansible all -i inventory.ini -m shell -a \
  "rm -rf /var/lib/postgresql/17/main/* /var/lib/etcd/default.etcd/*" -b
Aprovisiona la infraestructura de la base de datos
Con las VMs iniciadas y el inventario configurado, ahora puedes usar los playbooks de automatización de Autobase con Ansible para implementar la pila de PostgreSQL con alta disponibilidad.
Primero, ejecuta las verificaciones previas para asegurarte de que el entorno esté listo:
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini \
  --tags pre_checks
Si las verificaciones se aprueban, continúa con la implementación completa:
ansible-playbook vitabaks.autobase.deploy_pgcluster -i inventory.ini
Resultado esperado: El playbook debe completarse con un "PLAY RECAP" exitoso que muestre todas las VMs de destino como alcanzadas y actualizadas:
PLAY RECAP ********************************************************************
localhost                  : ok=1    changed=0    unreachable=0    failed=0    skipped=254  rescued=0    ignored=0
postgres-vm-1              : ok=160  changed=53   unreachable=0    failed=0    skipped=514  rescued=0    ignored=2
postgres-vm-2              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
postgres-vm-3              : ok=116  changed=40   unreachable=0    failed=0    skipped=505  rescued=0    ignored=2
Verifica la implementación
Una vez que se complete la implementación, debes realizar varias verificaciones para asegurarte de que todos los componentes funcionen correctamente.
Verifica el estado de la alta disponibilidad
Verifica el estado del administrador de alta disponibilidad para ver las funciones asignadas a cada VM:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Resultado de ejemplo:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Verifica los extremos de verificación de estado
Prueba que Patroni identifique correctamente el líder y las réplicas con su API de REST.
La verificación de estado de la VM del líder debe mostrar 200 OK, mientras que las verificaciones de estado de las VMs de réplica deben mostrar 503 Service Unavailable:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM3_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
Verifica el estado de las VM individuales
Verifica la preparación de todas las instancias de PostgreSQL:
ansible postgres_cluster -i inventory.ini -m shell -a "pg_isready -p 5432" -b
Resultado de ejemplo:
postgres-vm-1 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-2 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections

postgres-vm-3 | CHANGED | rc=0 >>
/var/run/postgresql:5432 - accepting connections
Verifica el estado de etcd
Verifica el estado de la capa de consenso en todas las VMs con localhost como extremo:
ansible all -i inventory.ini -m shell -a "ETCDCTL_API=3 etcdctl \
  --endpoints=https://localhost:2379 \
  --cacert=/etc/etcd/tls/ca.crt \
  --cert=/etc/etcd/tls/server.crt \
  --key=/etc/etcd/tls/server.key \
  endpoint health" -b
Resultado de ejemplo:
postgres-vm-1 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 28.78311ms

postgres-vm-2 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 33.081265ms

postgres-vm-3 | CHANGED | rc=0 >>
https://localhost:2379 is healthy: successfully committed proposal: \
took = 24.414291ms
Configura el balanceador de cargas global
Para proporcionar una IP virtual (VIP) estable para la pila de base de datos, configura el balanceador de cargas global de capa 4 nativo de la plataforma con la CLI de gdcloud.
Requisitos previos:
- Asegúrate de tener la función
load-balancer-adminen tu proyecto. Aplica una etiqueta a tus VMs para que el balanceador de cargas pueda orientar correctamente las instancias que necesita entregar (reemplaza los valores del parámetro
kubeconfigpor los archivoskubeconfigde la API de administración correspondientes para cada zona):kubectl --kubeconfig=ZONE_A_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM1_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_B_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM2_NAME} \ ${VM_LABEL} kubectl --kubeconfig=ZONE_C_MANAGEMENT_API label VirtualMachine \ -n ${PROJECT_ID} \ ${VM3_NAME} \ ${VM_LABEL}
- Asegúrate de tener la función
Define el nivel de acceso al balanceo de cargas. Establece
EXTERNALsi necesitas conectarte desde fuera de la red del proyecto oINTERNALsi solo se requiere acceso desde la VPC. Para este instructivo, usaremos una configuración externa:export LB_SCHEME=EXTERNALCrea una verificación de estado. El balanceador de cargas usa la API de REST de Patroni para identificar el líder:
gdcloud compute health-checks create https ${CLUSTER_NAME}-hc \
  --project=${PROJECT_ID} \
  --port=8008 \
  --request-path="/primary" \
  --check-interval=10 \
  --timeout=5 \
  --healthy-threshold=2 \
  --unhealthy-threshold=3 \
  --global
Crea un backend zonal independiente para cada zona en la que se encuentren tus VMs:
for zone in $(echo $ZONES); do
  gdcloud compute backends create ${CLUSTER_NAME}-backend-${zone} \
    --project=${PROJECT_ID} \
    --zone=${zone} \
    --labels="${VM_LABEL}"
done
Crea un servicio de backend global:
gdcloud compute backend-services create ${CLUSTER_NAME}-bes \
  --project=${PROJECT_ID} \
  --health-check="${CLUSTER_NAME}-hc" \
  --global
Agrega tus backends zonales al servicio global:
for zone in $(echo $ZONES); do
  gdcloud compute backend-services add-backend ${CLUSTER_NAME}-bes \
    --project=${PROJECT_ID} \
    --backend=${CLUSTER_NAME}-backend-${zone} \
    --backend-zone=${zone} \
    --global
done
Crea una regla de reenvío global (la VIP). Esta regla expone la base de datos en el puerto
6432:gdcloud compute forwarding-rules create ${CLUSTER_NAME}-fr \ --project=${PROJECT_ID} \ --load-balancing-scheme=${LB_SCHEME} \ --backend-service=${CLUSTER_NAME}-bes \ --ip-protocol-port="TCP:6432" \ --globalRecupera la dirección VIP:
LB_IP=$(gdcloud compute forwarding-rules describe ${CLUSTER_NAME}-fr \
  --project=${PROJECT_ID} \
  --load-balancing-scheme=${LB_SCHEME} \
  --global \
  --format=json \
  | jq -r '.metadata.annotations["networking.gke.io/forwardingRuleCIDR"]'  \
  | cut -d '/' -f 1)

echo "The load balancer IP is: ${LB_IP}"
Crea una
ProjectNetworkPolicy(PNP) para permitir el tráfico de entrada al puerto PgBouncer (reemplaza el valor del parámetrokubeconfigpor el archivokubeconfigde la API global correspondiente de tu entorno).kubectl --kubeconfig=GLOBAL_API_KUBECONFIG apply -f - <<EOF apiVersion: networking.global.gdc.goog/v1 kind: ProjectNetworkPolicy metadata: name: allow-pgbouncer namespace: ${PROJECT_ID} spec: ingress: - ports: - port: 6432 protocol: TCP policyType: Ingress subject: subjectType: UserWorkload EOF
Verifica la replicación de datos
Para confirmar que la pila de alta disponibilidad funciona como se espera, puedes crear datos de muestra en el líder y verificar su presencia en las réplicas.
Inserta datos de muestra
La automatización genera una contraseña aleatoria para el usuario postgres durante la primera implementación si no se proporciona una en inventory.ini. Puedes recuperarla desde cualquier VM:
export PG_PASSWORD=$(ansible master -i inventory.ini -m shell -a \
  "grep -A10 'authentication:' /etc/patroni/patroni.yml | \
  grep -A3 'superuser' | grep 'password:' | awk '{ print \$2 }'" -b | \
  tail -n 1)
echo $PG_PASSWORD
Conéctate a la VIP del balanceador de cargas en el puerto PgBouncer (6432) y crea una tabla de muestra:
PGPASSWORD="${PG_PASSWORD}" psql -h ${LB_IP} -p 6432 -U postgres -c "
  CREATE TABLE employees (first_name TEXT, last_name TEXT);
  INSERT INTO employees (first_name, last_name) VALUES ('John', 'Doe');
"
Resultado esperado:
INSERT 0 1
Verifica el estado de la replicación
Ejecuta una consulta SELECT en todas las VMs para asegurarte de que los datos se hayan replicado del líder a todas las réplicas:
ansible postgres_cluster -i inventory.ini -m shell -a "psql -U postgres -c \
  'SELECT * FROM employees;'" -b
Resultado de ejemplo:
postgres-vm-1 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-2 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)

postgres-vm-3 | CHANGED | rc=0 >>
 first_name | last_name
------------+-----------
 John       | Doe
(1 row)
Prueba el cambio manual
Un cambio manual te permite mover con elegancia la función de líder a una VM candidata específica. Por lo general, esto se hace para el mantenimiento planificado, las actualizaciones de software o para equilibrar el uso de recursos en las zonas.
Identifica el líder actual
Verifica la función y el estado actuales de las VMs:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Resultado de ejemplo:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  1 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  1 |   0/6000000 |   0 |  0/6000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Realiza el cambio
Activa un cambio del líder actual a otra VM (en este caso, de postgres-vm-1 a postgres-vm-2, respectivamente). El comando usa --force para omitir las solicitudes de confirmación manual:
ansible master -i inventory.ini -m shell -a "patronictl switchover \
  --leader ${VM1_NAME} --candidate ${VM2_NAME} --force" -b
Resultado de ejemplo:
Successfully switched over to "postgres-vm-2"
+ Cluster: postgres-cluster (7607933704953386478) -+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | stopped |    |     unknown |     |    unknown |     |
| postgres-vm-2 | 10.253.1.253 | Leader  | running |  1 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | running |  1 |   0/70000A0 |   0 |  0/70000A0 |   0 |
+---------------+--------------+---------+---------+----+-------------+-----+------------+-----+
Verifica el cambio de verificación de estado
Después del cambio, verifica que el estado de la verificación de estado haya cambiado al nuevo líder:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b

ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
El líder anterior (postgres-vm-1) debe mostrar 503, mientras que el nuevo líder (postgres-vm-2) debe mostrar 200.
Prueba la conmutación por error automática
A diferencia de un cambio manual, una conmutación por error automática ocurre cuando la VM del líder deja de estar disponible. Esta prueba confirma que Patroni elige un nuevo líder y que el balanceador de cargas redirecciona el tráfico sin intervención manual. Supongamos que postgres-vm-2 es el líder actual después del cambio manual realizado anteriormente.
Identifica el líder actual
Verifica la función y el estado actuales de las VMs:
ansible master -i inventory.ini -m shell -a "patronictl list" -b
Resultado de ejemplo:
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
| postgres-vm-2 | 10.253.1.253 | Leader  | running   |  2 |             |     |            |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  2 |   0/8000000 |   0 |  0/8000000 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Simula una falla de VM
Detén el servicio patroni en la VM del líder para simular una falla o una falla grave:
ansible master -i inventory.ini -m shell -a "systemctl stop patroni" -b
Observa la nueva elección
Espera entre 10 y 20 segundos y verifica el estado desde otra VM para ver la promoción de un nuevo líder:
ansible replica -i inventory.ini -m shell -a "patronictl list" -b
Resultado de ejemplo:
postgres-vm-3 | CHANGED | rc=0 >>
+ Cluster: postgres-cluster (7607933704953386478) ---+----+-------------+-----+------------+-----+
| Member        | Host         | Role    | State     | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
| postgres-vm-1 | 10.253.1.254 | Leader  | running   |  3 |             |     |            |     |
| postgres-vm-2 | 10.253.1.253 | Replica | stopped   |    |     unknown |     |    unknown |     |
| postgres-vm-3 | 10.253.1.252 | Replica | streaming |  3 |   0/90003F8 |   0 |  0/90003F8 |   0 |
+---------------+--------------+---------+-----------+----+-------------+-----+------------+-----+
Deberías ver que una de las otras VMs (postgres-vm-1 o postgres-vm-3) se convirtió en el líder y que el líder anterior (postgres-vm-2) está marcado como detenido.
Verifica el cambio de verificación de estado
Confirma que las verificaciones de estado del balanceador de cargas ahora identificarían correctamente al líder recién elegido:
ansible ${VM1_NAME} -i inventory.ini -m shell -a \
  "curl -ks -o /dev/null -w '%{http_code}' https://localhost:8008/primary" -b
El nuevo líder debe mostrar 200 OK.
Recupera la VM con fallas
Vuelve a iniciar el servicio patroni en la VM original para permitir que se vuelva a unir a la pila como una réplica y se ponga al día con los datos perdidos:
ansible ${VM2_NAME} -i inventory.ini -m shell -a \
  "systemctl start patroni" -b