


プロブレム ステートメント
エアギャップ環境で運用している組織は、大規模言語モデルが必要であるものの、厳格なセキュリティ プロトコルにより外部のクラウドベースの API への接続が厳しく禁止されているという大きな課題に直面しています。このギャップを埋めるには、Google Distributed Cloud(GDC)エアギャップ インフラストラクチャでオープン ウェイト モデルを直接ホストして管理できる、堅牢で自己完結型のエコシステムが必要です。このローカライズされたデプロイは、絶対的なデータ主権を維持し、機密情報が物理的な施設から流出しないようにするために不可欠です。安全な実行環境をサービング バックエンドと統合することで、ユーザーはデータ、モデルの重み、内部セキュリティ ポスチャーを完全に管理しながら、高度な AI 機能を使用できます。
GDC の Gemini は、強力なマネージド フロンティア機能を提供しますが、お客様は、より詳細な粒度と制御を実現するために、Gemma 4 や Llama 4 などのオープンウェイト モデルをデプロイすることがよくあります。エアギャップ GDC 環境にオープンウェイト モデルをデプロイすると、マネージド独自のサービスよりも大幅なコスト削減を実現できます。モデルの重みを所有することで、組織はトークンあたりの API 料金の繰り返しを排除できます。これは、大量の自動ワークロードでは法外な料金になる可能性があります。さらに、オープン ウェイト モデルでは量子化(4 ビットや 8 ビットなど)が可能になり、エッジのより小さく、より安価なハードウェア フットプリントで高パフォーマンスの推論を実行できます。この垂直方向の最適化と、追加のライセンス費用なしで複数の内部アプリケーション間でインフラストラクチャを共有できる機能により、継続的な大規模な推論オペレーションの総所有コスト(TCO)が大幅に削減されます。
提案するソリューション
このドキュメントでは、Google Distributed Cloud(GDC)エアギャップ環境にオープンウェイト大規模言語モデル(LLM)をデプロイして管理するためのリファレンス アーキテクチャについて説明します。多くのお客様、特に規制の厳しいセクターのお客様は、データ主権とセキュリティに関する厳格な要件により、クラウドベースの LLM API を使用できません。このアーキテクチャは、独自の安全な GDC インスタンス内で強力な LLM をローカルで実行する必要性に対応しています。
対象範囲: このアーキテクチャでは、vLLM または Ollama サービング バックエンドを使用したオープン ウェイト モデル(Gemma 4、Llama、DeepSeek、Mistral など)のデプロイについて説明します。これには、オーケストレーションに Kubernetes、アーティファクト ストレージに Harbor、モデルの重みに Persistent Volume、ネットワーク セキュリティにネットワーク ポリシー(NetworkPolicy / ProjectNetworkPolicy)、オプションのブラウザ フロントエンドとして Open WebUI を使用することが含まれます。
含まれないもの: このアーキテクチャでは、マネージド AI Gateway サービス、Google の Gemini などの独自モデル、モデルのファインチューニング プロセス、画像生成などの他のモダリティの GenAI モデルは対象外です。
対象者: このドキュメントの主な対象者は、GDC でのサービスのデプロイと管理を担当するプラットフォーム管理者と、エアギャップ環境内で AI ソリューションを設計するテクニカル アーキテクトです。デプロイされたモデルを操作するエンドユーザーとデベロッパーは、基盤となる構造を理解することでメリットを得られる二次的な対象者です。
アーキテクチャ
このソリューションでは、標準クラスタ内にコンテナ化された推論サービング バックエンド(Deployment)として vLLM、Ollama、またはその両方をデプロイします。モデルの重みは、モデルローダー Pod を介してワークステーションから入力される Persistent Volume に保存されます。LoadBalancer タイプの Kubernetes Service はバックエンド API を公開し、NetworkPolicy / ProjectNetworkPolicy オブジェクトはそれらへのアクセスを保護します。Open WebUI は、OpenAI 互換 API のブラウザ フロントエンドとしてデプロイできます。
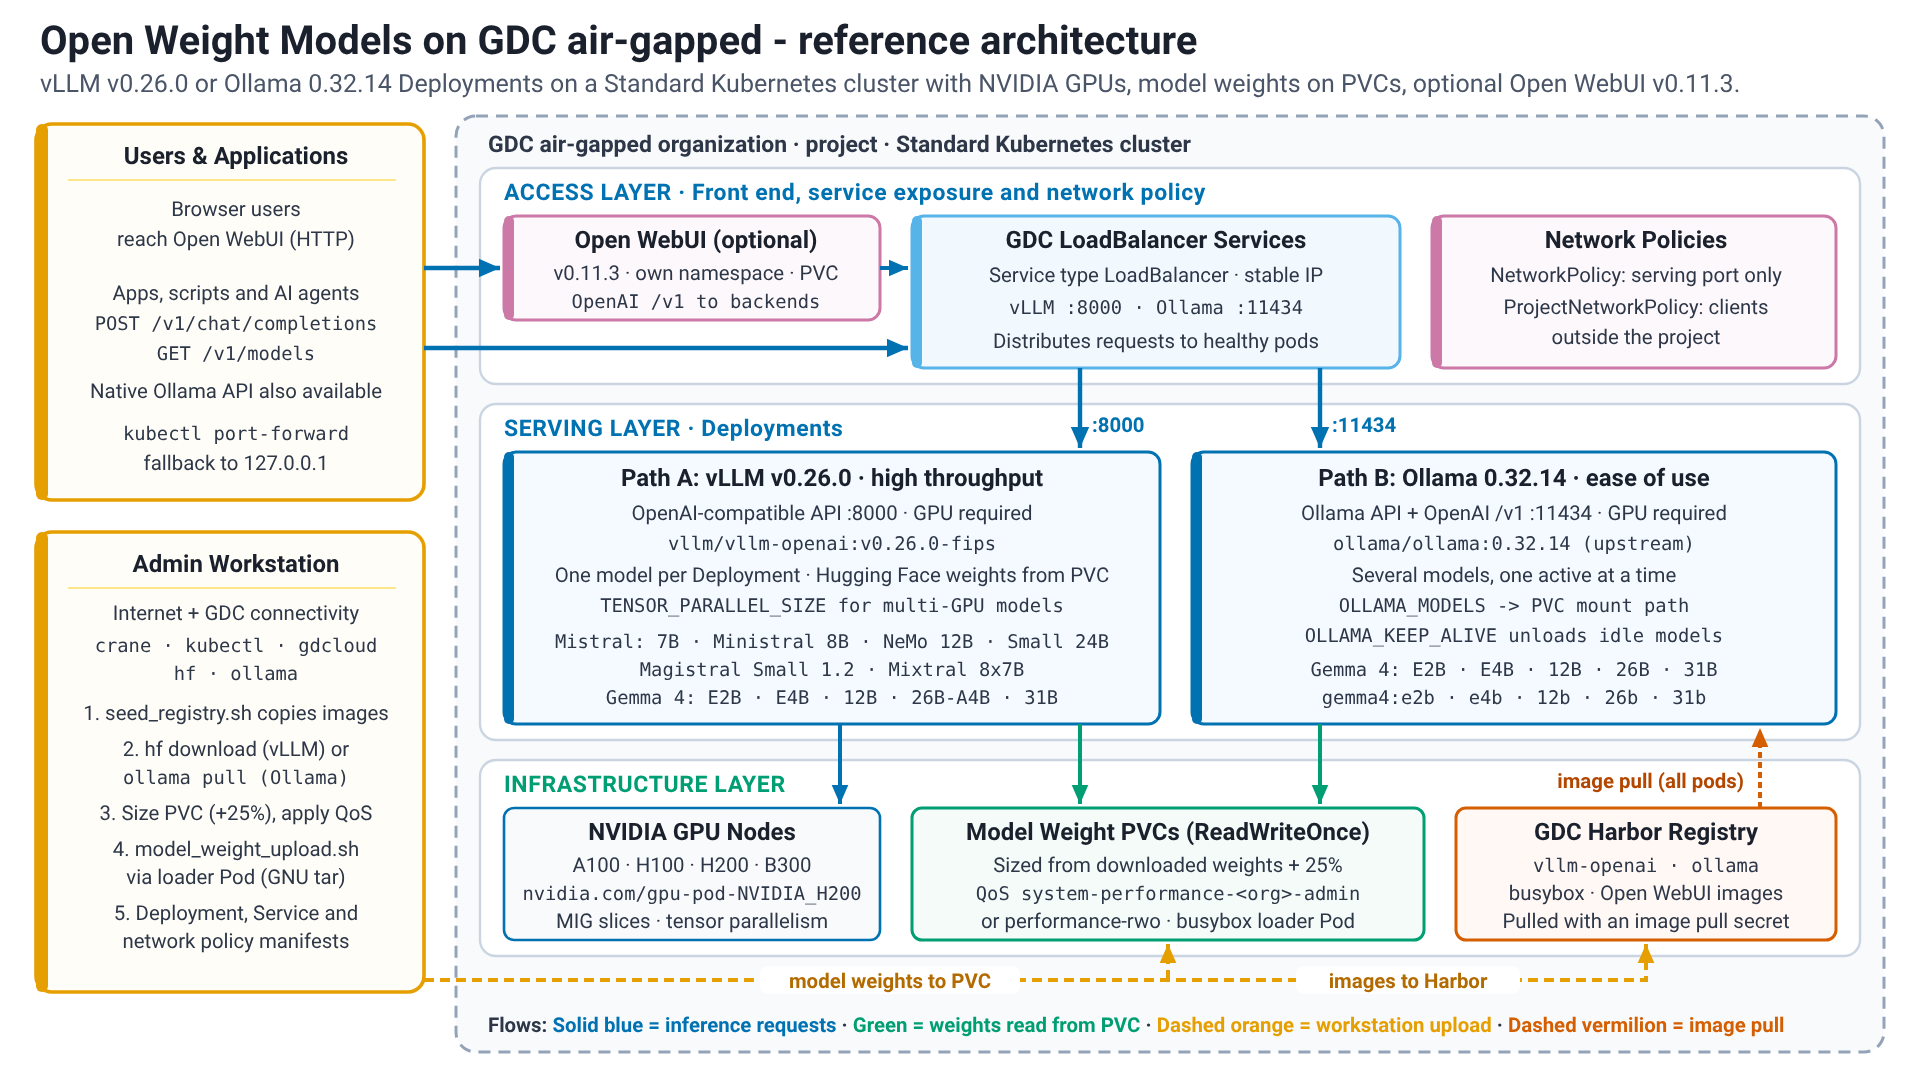
ソリューション コンポーネント
このソリューションでは、次のコンポーネントを使用します。
| ソリューション コンポーネント | 責任 | データフロー | インターフェース |
|---|---|---|---|
| GDC エアギャップのお客様ゾーン | Kubernetes クラスタ、ネットワーキング、ストレージ インフラストラクチャをホストする | 基盤プラットフォーム | IO のインフラストラクチャ管理インターフェース。プラットフォーム管理者とユーザー向けの Kubernetes API |
| ロードバランサ | LLM サービング Pod(vLLM、Ollama)を Kubernetes クラスタ外からのトラフィックに公開し、安定した IP アドレスを提供します。 | 外部クライアント リクエストは、LoadBalancer の外部 IP に送信されます。LoadBalancer は、Service のセレクタに基づいて、正常なバックエンド Pod(vLLM または Ollama)にリクエストを分散します。 | Kubernetes Service API。GDC 環境内にネットワーク ロードバランサを自動的にプロビジョニングします。 |
| vLLM | 高スループットの LLM 推論サービス。PagedAttention などの手法を使用して低レイテンシ向けに最適化されています。通常、インスタンスごとに 1 つのモデルをサービングします。 | クライアントから HTTP 推論リクエストを受信します。マウントされた PVC からモデルの重みを読み込みます。接続された GPU で計算を実行します。生成されたテキストを含む HTTP レスポンスを返します。 | 推論用の OpenAI 互換 RESTful API。JSON リクエストを受け入れる。 |
| Ollama | 使いやすさを重視して設計された LLM 推論サービング。1 つのインスタンスで複数のモデルを処理し、オンデマンドで読み込むことができます。 | HTTP 推論リクエストを受信します。マウントされた PVC(OLLAMA_MODELS)からモデルを読み込みます。接続された GPU で計算を実行します。HTTP レスポンスを返します。モデルは、構成可能な非アクティブ期間(OLLAMA_KEEP_ALIVE)が経過するとアンロードされます。 |
Ollama RESTful API と OpenAI 互換 API(/v1)。JSON リクエストを受け入れます。CLI もあります。 |
| NVIDIA GPU と MIG | LLM 推論にハードウェア アクセラレーションを提供する。 | LLM バックエンド(vLLM、Ollama)は、行列乗算などの負荷の高いモデル計算を GPU にオフロードして、推論を高速化します。MIG を使用すると、単一の GPU を分割して、複数の小規模なモデル インスタンスで使用できます。 | Kubernetes のリソースタイプとして公開されます(例: nvidia.com/gpu-pod-NVIDIA_H200。正確なリソース名は、インストールされている GPU モデルによって異なり、ノードから検出されます)。Pod はこれらのリソースをリクエストする |
| Harbor | vLLM、Ollama、Open WebUI、ヘルパー Pod(busybox など)のコンテナ イメージを安全に保存、管理します。 | コンテナ イメージは、インターネット アクセスが可能なワークステーションから seed_registry.sh(crane)を使用して、公開レジストリから Harbor にコピーされます。Kubernetes ノードは、Harbor からこれらのイメージを pull してコンテナを実行します。 |
Docker Registry API。Kubernetes ノードは Harbor とインターフェースして、Pod の作成中にイメージを pull します。ユーザーは、crane、Docker CLI、または Harbor UI を使用してイメージを push します。 |
| 永続ボリュームの要求 | LLM モデルの重み付けに永続ストレージを提供し、Pod のライフサイクルから切り離します。 | モデルファイルはワークステーションにダウンロードされ、25% のオーバーヘッドで PVC サイズを動的に計算するために使用されます。また、model_weight_upload.sh を使用して一時的なモデルローダー Pod(busybox)を介して Persistent Volume にストリーミングされます。PVC は、高パフォーマンスのブロック ストレージが有効になっている performance-rwo でプロビジョニングされます。それ以外の場合、インフラストラクチャ オペレーターは system-performance-<org>-admin QoS ポリシーをバッキング ボリュームに適用します。どちらのオプションでも、1 GiB あたり 30 IOPS(最小 6,148 IOPS)が提供されます。どちらのバックエンドも、起動時にこのマウントされたボリュームからモデルの重みを読み取ります。vLLM は Hugging Face モデル ディレクトリを読み込み、Ollama は OLLAMA_MODELS をマウントパスに設定します。kubectl cp は使用されず、モデルはコンテナ イメージにバンドルされません。 |
Kubernetes ストレージ API。YAML(ReadWriteOnce)で定義され、ボリュームとして Pod にマウントされます。 |
| ネットワーク ポリシー | ネットワーク分離を適用し、LLM サービスへのトラフィック フローを制御します。名前空間 NetworkPolicy(networking.k8s.io/v1)は、クラスタ内からサービスポートへのトラフィックを許可します。プロジェクト外からアクセスするには、ProjectNetworkPolicy(networking.gdc.goog/v1)も必要です。 |
Namespace 内の Pod との間で送受信されるネットワーク トラフィックが検査されます。ポリシールールは、LLM サービスポート(vLLM の場合は 8000、Ollama の場合は 11434 など)への接続を許可するかどうかを、通常は送信元 IP 範囲またはその他のラベルに基づいて決定します。 | Kubernetes networking.k8s.io/v1 API と networking.gdc.goog/v1 API。YAML で定義されます。 |
| Open WebUI | エンドユーザー向けのオプションのブラウザベースのフロントエンド。vLLM と Ollama の OpenAI 互換 API と通信します。モデルの重みは保持せず、アクセラレータも必要ありません。 | ユーザーは、Kubernetes Service を介して Open WebUI にアクセスします。Open WebUI は、OpenAI 互換の /v1 API を介してチャット リクエストを vLLM サービスと Ollama サービスに転送し、独自の状態(ユーザー、チャット、設定)を永続ボリュームに保持します。 |
ユーザーに対しては HTTP(ブラウザ)、バックエンドに対しては OpenAI 互換の REST API。独自の Namespace にデプロイされたステートフル ワークロード。 |
特長と機能
このリファレンス アーキテクチャは、次のコア機能を提供します。
- オープン ウェイト LLM サービング: さまざまなオープン ウェイト モデル(Gemma 4、Llama、DeepSeek、Mistral など)のホスティングと推論を可能にします。
- コンポーネント: LLM サービング バックエンド(vLLM、Ollama)、Kubernetes Deployment/Pod。
- 責任: モデルの重みの読み込み、推論プロセスの管理、ハードウェア アクセラレーションでのモデルの実行、エンドポイントの公開。
- インターフェース: 推論リクエスト用の REST API(vLLM と Ollama の OpenAI 互換、および Ollama 固有の API)。通常は JSON を使用します。
- Bring Your Own Model(BYOM): ユーザーは、選択したオープンウェイト LLM をインポートして、エアギャップ環境にデプロイできます。
- コンポーネント: Harbor、Persistent Volume Claim、モデルローダー Pod、Kubernetes。
- 責任: コンテナ イメージとモデルの重みの安全なストレージ。モデルを環境に転送し(
model_weight_upload.sh、ローダー Pod を介して)、サービング エンジンからアクセスできるようにするメカニズム。 - インターフェース: Docker Registry API(Harbor 用)、Kubernetes API(PVC とボリューム マウント用)。
- ハードウェア アクセラレーション推論: GDC クラスタ内の NVIDIA GPU を使用して、LLM 推論を効率的に実行します。
- コンポーネント: NVIDIA GPU、Kubernetes、デバイス プラグイン。
- 責任: GPU リソースを持つノードに Pod をスケジュールします。GPU ハードウェアを LLM バックエンド コンテナに公開する。パーティショニング用のマルチインスタンス GPU(MIG)と、Mixtral 8x7B
bf16などの大規模モデル用のマルチ GPU テンソル並列処理(TENSOR_PARALLEL_SIZE)をサポートしています。 - インターフェース: Kubernetes API(
nvidia.com/gpu-pod-NVIDIA_H200やnvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIEなどの GPU リソースをリクエストする場合)。
- ネットワーク制御アクセス: LLM 推論エンドポイントへのアクセスが GDC 環境内で制御され、分離されるようにします。
- コンポーネント: Kubernetes Service(LoadBalancer)、NetworkPolicy、ProjectNetworkPolicy。
- 責任: 安定した IP を使用して推論サービスを公開する。送信元、宛先、ポートに基づいて LLM バックエンドへのトラフィックを許可または拒否するネットワーク ルールを定義して適用する。
- インターフェース: Kubernetes API(Service、NetworkPolicy、ProjectNetworkPolicy 用)。
- スケーラブルなサービング: 需要に応じて容量を調整できます。
- コンポーネント: Kubernetes Deployment。
- 責任: LLM バックエンド Pod のレプリカ数を増やして、水平スケーリングを有効にします。リソース リクエスト/上限を調整して垂直方向にスケーリングする。
- インターフェース: Kubernetes API(Deployment のレプリカとリソースの管理用)。
- ブラウザ フロントエンド(省略可): エンドユーザーは、API 呼び出しを記述することなく、デプロイされたモデルとチャットできます。
- コンポーネント: Open WebUI の Deployment、Service、Persistent Volume Claim。
- 責任: vLLM と Ollama によって提供されるモデルを 1 つのインターフェースで表示する。ユーザー、チャット、設定を永続化する。
- インターフェース: HTTP(ブラウザ)、バックエンドに対する OpenAI 互換の
/v1API。
アーキテクチャの原則
- セキュリティ ファースト: すべてのコンポーネントとデータは GDC エアギャップ境界内に存在するため、最大限のデータ セキュリティと制御が保証されます。ネットワーク アクセスは、
NetworkPolicyオブジェクトとProjectNetworkPolicyオブジェクトを使用して制限されます。 - データ主権: お客様はモデルとデータを完全に制御できます。運用に外部接続は必要ありません。
- オープンかつ柔軟: このアーキテクチャは、オープンソースのサービング バックエンド(vLLM、Ollama)を使用し、さまざまなオープン ウェイト LLM をサポートしているため、お客様は推論エンジンを自由に選択でき、ベンダー ロックインを回避できます。
- コンポーネントの分離: モデル ストレージ(PVC)、イメージ管理(Harbor)、推論サービング(vLLM/Ollama Pod)、ユーザー インターフェース(Open WebUI)などの主要な機能は、独立したコンポーネントであり、個別に管理と更新を行うことができます。
- スケーラビリティとパフォーマンス: Pod レプリカの数を増やすことで水平方向にスケーリングし、CPU/GPU リソース(マルチ GPU テンソル並列処理を含む)を調整することで垂直方向にスケーリングして、パフォーマンス要件を満たすように設計されています。vLLM は、高スループット、低レイテンシのシナリオに選択されます。
- リソースの最適化: NVIDIA マルチインスタンス GPU(MIG)をサポートし、小規模なモデルが GPU リソースを効率的に共有できるようにします。また、動的な PVC サイズ設定(+25% のオーバーヘッド)と高パフォーマンスのストレージ QoS を組み合わせて、モデルの読み込み速度を犠牲にすることなく、ストレージの過剰プロビジョニングを排除します。
- 標準インターフェース: オーケストレーション、デプロイ、サービス公開の Kubernetes 標準に基づいて構築されています。推論エンドポイントは REST API を提供し、vLLM と Ollama の両方が OpenAI 互換性を提供します。
- 復元力: Kubernetes のヘルスチェックとレプリケーションを使用して、サービスの可用性を確保します。
考慮事項
- スケーラビリティとパフォーマンス:
- 水平スケーリングは、vLLM と Ollama の両方の Kubernetes Deployment でレプリカの数を増やすことで実現されます。
ReadOnlyManyStorageClass がないと、モデル Deployment は 1 つのレプリカに制限されます(モデル ボリュームはReadWriteOnce)。追加の容量は、追加の Deployment から取得され、それぞれに独自の PVC があります。 - 垂直スケーリングでは、より多くの CPU/メモリとより大きな GPU スライスを割り当てます。最大で、フル GPU または同じノード上の複数の GPU にわたるマルチ GPU テンソル並列処理(
TENSOR_PARALLEL_SIZE)まで割り当てることができます。 - vLLM はインスタンスごとに 1 つのモデルをサービングするため、追加のモデルには新しい Deployment が必要です。Ollama は 1 つのインスタンスから複数のモデルを提供できます。これらのガイドでは、各 Ollama Deployment が 1 つのモデルを提供します。
- 各モデルの PVC は、ダウンロードされた重みから 25% のオーバーヘッドで動的にサイズ設定され、高性能ストレージ QoS ポリシー(
system-performance-<org>-admin、GiB あたり 30 IOPS、6,148 IOPS の下限、または高性能ブロック ストレージが有効になっているperformance-rwo)で構成されます。これにより、モデルの読み込み時間がデフォルトのstandard-rwoGiB あたり 3 IOPS の上限によってスロットリングされることはありません。
- 水平スケーリングは、vLLM と Ollama の両方の Kubernetes Deployment でレプリカの数を増やすことで実現されます。
- リソース管理:
- GPU リソースの慎重な計画が不可欠です。NVIDIA MIG を使用すると、GPU を分割して小規模なモデルに割り当て、使用率を向上させることができます。一方、大規模なモデル(
bf16の Mixtral 8x7B など)では、テンソル並列処理を使用して複数の GPU に重みをシャーディングできます。 - 推論とモデル管理のオーバーヘッドの両方を処理するために、十分な CPU とメモリを割り当てる必要があります。vLLM と Ollama は、GPU アクセラレーションを使用してモデルを提供します。
- モデルサイズに対応し、パフォーマンスを確保するために、PVC に十分なストレージをプロビジョニングする必要があります。
- GPU リソースの慎重な計画が不可欠です。NVIDIA MIG を使用すると、GPU を分割して小規模なモデルに割り当て、使用率を向上させることができます。一方、大規模なモデル(
- 可用性と信頼性:
- Kubernetes Deployment には、自己修復機能とローリング アップデート機能が用意されています。
- LoadBalancer Service は、正常な Pod 間でトラフィックを分散し、個々の Pod の障害をマスクします。
- モデルの重みを PVC に保存すると、Pod の再起動後も永続性が確保されます。
- 運用の複雑さ:
- Harbor でさまざまなバックエンドとバージョンのコンテナ イメージを管理する。
- モデルの重みをエアギャップ環境に安全に転送する手順。
- 各モデルとバックエンドの Kubernetes マニフェスト(Deployment、Service、PVC、ネットワーク ポリシー)を作成して管理する。
- GPU 使用率、推論レイテンシ、エラー率をモニタリングする。
- セキュリティとコンプライアンス:
- ソリューション全体が GDC エアギャップ セキュリティ境界内で動作します。
- ネットワーク ポリシーは、厳格なネットワーク分離を適用し、LLM エンドポイントへのアクセスを制御するために必須です。クラスタ内アクセス用の Namespace
NetworkPolicyと、プロジェクト外からのアクセス用のProjectNetworkPolicyがあります。 - Harbor ロボット アカウントと Kubernetes イメージ pull シークレットにより、コンテナ イメージへの安全なアクセスが保証されます。
- ネットワーク ポリシーは、エンドポイントにアクセスできるクライアントを制限します。PVC の保存データは、GDC ストレージの暗号化に依存します。
設計上の意思決定
このリファレンス アーキテクチャでは、次の重要な設計上の決定が行われています。
決定 1: 1 つのサービング バックエンドではなく、vLLM と Ollama の両方を提供する
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| 1 つのサービング バックエンド(vLLM または Ollama)または両方を提供します。 | ユーザーとユースケースによって、パフォーマンス、API の互換性、モデル管理の容易さに関する要件が異なるため、両方を提供します。 | vLLM は、高スループット、低レイテンシのサービングと OpenAI API 互換性を提供し、本番環境アプリケーションに適しています。Ollama は、設定が簡単で、複数のモデルの管理が容易で、使いやすいため、開発やテストに適しています。両方をサポートすることで柔軟性が得られます。 |
決定 2: PersistentVolumeClaim のモデルの重み
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| vLLM と Ollama では、実行時にファイル システムにモデルの重みが必要です。エアギャップ環境では、モデルをオンデマンドでダウンロードできません。 | 各モデルの重みを独自の ReadWriteOnce PersistentVolumeClaim に保存します。これは、一時的なモデルローダー Pod を介してワークステーションから入力されます。 |
PersistentVolumeClaim は、推論 Pod のライフサイクルから切り離された、大規模なモデルファイル用の復元力のある永続ストレージ レイヤを提供します。これにより、Pod の起動時にモデルを迅速に読み込むことができます。 |
決定 3: Ollama(ローダー Pod)の PersistentVolume にモデルの重みを配置する(イメージにバンドルしない)
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| Ollama はモデルをダウンロードできますが、これにはインターネット アクセスが必要です。エアギャップ環境ではインターネット アクセスは利用できません。モデルをカスタム Ollama イメージにバンドルする場合は、モデルごとにイメージを再ビルドする必要があり、数 GB のイメージが Harbor に保存されます。 | Ollama は、vLLM と同じローダー Pod ワークフローを使用します。モデルはワークステーション(ollama pull~ollama_model_weight_download.sh)で pull され、model_weight_upload.sh(GNU tar)を使用してモデルローダー Pod を介して PVC にストリーミングされます。OLLAMA_MODELS はマウントパスを指します。 |
両方のバックエンドに 1 つのワークフロー。イメージを再ビルドすることなくモデルを追加または更新可能。変更されていないアップストリームの Ollama イメージは Harbor で小さいまま。 |
決定 4: LoadBalancer Service を使用して vLLM と Ollama を公開するか、ロードバランサを使用しないか
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| LLM API は、GDC 環境内のアプリケーションからアクセスできる必要があります。 | 標準の Kubernetes アプローチである LoadBalancer タイプの Service を介して各バックエンドを公開します。これは、GDC エアギャップ プラットフォームのロードバランサのプロビジョニングに依存します。 |
LoadBalancer タイプの Kubernetes Service は、LLM バックエンドを公開するための標準的で信頼性の高い方法を提供し、安定した IP アドレスを提供して負荷を分散します。 |
決定 5: 必須のネットワーク ポリシー(NetworkPolicy と ProjectNetworkPolicy)を適用する
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| GDC エアギャップ デプロイでは、セキュリティと分離が重要です。 | すべての LLM エンドポイント(サービスポートのみを許可する名前空間 NetworkPolicy。プロジェクト外のクライアントがアクセスする必要がある場合は ProjectNetworkPolicy で補完)にネットワーク ポリシーを適用して、デプロイされた LLM サービスのセキュリティ ポスチャーを強化します。 |
NetworkPolicy オブジェクトは、Namespace レベルでネットワーク分離を適用する Kubernetes ネイティブな方法を提供します。ProjectNetworkPolicy オブジェクトは、これをプロジェクト境界に拡張し、承認されたトラフィックのみが LLM サービスに到達できるようにします。 |
決定 6: 動的な PVC の適正サイズ設定(+25% のオーバーヘッド)とハイ パフォーマンス ストレージ QoS ポリシーの組み合わせ
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
デフォルトの standard-rwo StorageClass は、standard-<org>-admin ONTAP アダプティブ QoS ポリシー(3,072 IOPS per TiB または 3 IOPS per GiB、75 IOPS 最小フロア)を適用します。standard-rwo PVC のサイズをモデルの重みサイズに厳密に合わせると、重みの順次読み取りが 5 ~ 21 MBps に制限されます。また、静的な 300 ~ 500 GiB の PVC をオーバープロビジョニングすると、ストレージが無駄になり、順次読み取りスループットが約 60 MBps に制限されます。 |
まずモデルの重みをダウンロードし、ダウンロードしたディレクトリから GDCS_MODEL_PVC_SIZE を動的に計算します。このとき、25% のオーバーヘッドを次の整数 GiB に切り上げます。高性能ブロック ストレージが有効になっている storageClassName: performance-rwo を使用するか、インフラストラクチャ オペレーターに system-performance-${GDC_ORG}-admin QoS ポリシーをバッキング ボリュームに適用するよう依頼します。 |
system-performance-<org>-admin QoS ポリシーは、最大 204 GiB のボリュームに対して 30,720 IOPS per TiB(30 IOPS per GiB、standard の 10 倍)を提供し、6,148 IOPS の最小フロア(約 393 MBps の ONTAP 上限)を備えています。25% のオーバーヘッドを伴う動的なサイズ設定と system-performance を組み合わせることで、3 ~ 40 倍のストレージ オーバープロビジョニング(100Gi~500Gi ではなく 12Gi~109Gi)を排除しながら、単一 LUN の KubeVirt virtio-scsi のシーケンシャル読み取り速度を約 150 MBps に向上させます(モデルの起動が 2.5 ~ 30 倍高速化)。 |
前提条件と制限事項
- GDC エアギャップ 1.16.2 hotfix 1(
1.16.2-gdch.1353-1)以降の環境が利用可能である(標準クラスタの GPU ノードプールにはこのリリースが必要です。以前のリリースでは、共有クラスタでのみ GPU が提供されます)。 - 標準クラスタに十分なハードウェア リソース(NVIDIA GPU を含む)が存在する。vLLM と Ollama の両方に GPU が必要です。
- Harbor インスタンスが設定され、アクセス可能である。
- インターネット アクセスと GDC 環境(Harbor と Kubernetes API)への接続を備えたワークステーションが、イメージのシーディングとモデルの重みのアップロードに使用できます。
- ユーザーに必要な権限がある: プロジェクト ロール Harbor Instance Viewer と Standard Cluster Admin、および標準クラスタに対する StandardClusterRoleBinding(cluster-admin)。SRI をご覧ください。
- モデルが、選択したサービング バックエンド(vLLM/Ollama)と互換性がある。
- 制限事項: モデルの重み PVC は
ReadWriteOnceです。ReadOnlyManyStorageClass がない場合、各モデルの Deployment は 1 つのレプリカに制限されます。
ユーザーフロー
以下は、Google Distributed Cloud(GDC)エアギャップ環境にオープン ウェイト大規模言語モデル(LLM)をデプロイするための包括的なユーザーフローです。このフローは、共通の設定、2 つのデプロイパス(vLLM と Ollama)、オプションのフロントエンド、最終検証に分かれています。
1. 一般的な設定: イメージ管理
LLM をデプロイする前に、GDC 環境がプライベート Harbor レジストリからコンテナ イメージを pull する方法を構成する必要があります。
- Harbor ロボット アカウントを作成する: Harbor UI でロボット アカウントを生成します。1 つは
crane(イメージ シーディング)の push 権限を持つアカウント、もう 1 つは Kubernetes イメージ pull シークレットの pull 権限を持つアカウントです。 - crane イメージとシードイメージを認証する: ロボット アカウントの認証情報を使用して、インターネット アクセスできるワークステーション(
crane auth login)から Harbor にログインし、必要なコンテナ イメージ(busybox、ollama/ollama、vllm/vllm-openai、必要に応じて Open WebUI)をseed_registry.shで Harbor にコピーします。 - Kubernetes Secret を作成する: kubectl を使用して、ワークロード Namespace に docker-registry Secret を作成し、クラスタで使用する pull ロボット アカウントの認証情報を保存します。
2. デプロイパス A: 高スループットを実現する vLLM
このパスは、GPU で Mistral 7B Instruct などのパフォーマンス重視のモデルをサービングする場合におすすめです。
- イメージを取得する:
seed_registry.shを使用して vLLM イメージ(vllm/vllm-openai:v0.26.0)を Harbor にシードし、SRI の説明に沿ってパッチ適用済みのイメージタグv0.26.0-fipsをビルドして push します。 - モデル ストレージを準備する:
- ワークステーション(
hf download)で Hugging Face から重みをダウンロードします。 - ダウンロードした重み(25% のオーバーヘッドを含む)から必要な PVC サイズを計算し、モデルの重みを保存する
ReadWriteOnce永続ボリューム クレーム(PVC)を作成して、高パフォーマンスの QoS ポリシーを適用します。 - PVC をマウントする一時的なモデルローダー Pod(
busybox)を起動し、model_weight_upload.sh(kubectl exec経由の GNU tar。BusyBox tar は 8 GiB を超えるファイルの PAX ヘッダーを読み取れないため、kubectl cpは使用されません)を使用して重みをストリーミングします。その後、ローダー Pod を削除します。
- ワークステーション(
- バックエンドをデプロイする: vLLM イメージを参照し、ノードから検出されたアクセラレータ リソース(
nvidia.com/gpu-pod-NVIDIA_H200など)をリクエストし、モデルの重み PVC をマウントする Kubernetes Deployment マニフェストを適用します。 - Service を公開する: LoadBalancer Service を作成して、vLLM API に外部 IP を提供します。
- セキュア ネットワーク: Namespace NetworkPolicy を適用して、サービスポート(8000)での上り(内向き)トラフィックを許可します。プロジェクト外のクライアントがアクセスする必要がある場合は、ProjectNetworkPolicy を追加します。
3. デプロイパス B: Ollama(使いやすさ重視)
このパスは、簡素化された設定に重点を置いています。アップストリームの Ollama イメージをそのまま使用し、vLLM と同じモデルローダー ワークフローを使用します。
- シードイメージ:
seed_registry.shを使用して、アップストリームの Ollama イメージ(ollama/ollama:0.32.14)を Harbor にコピーします。 - モデル ストレージを準備する:
ollama_model_weight_download.shを使用してワークステーションでモデル(gemma4:e4bなど)を pull します。これにより、OLLAMA_MODELSがダウンロード ディレクトリを指す一時的なローカルollama serveが実行されます。- ダウンロードした重み(25% のオーバーヘッドを含む)から必要な PVC サイズを計算し、
ReadWriteOncePVC を作成して、高パフォーマンスの QoS ポリシーを適用し、それをマウントする一時的なモデルローダー Pod を起動します。 model_weight_upload.shを使用してダウンロード ディレクトリを PVC にアップロードし、ローダー Pod を削除します。
- デプロイと公開: PVC マウントパス(ノードから検出されたアクセラレータ リソースをリクエストする)を指す
OLLAMA_MODELSと LoadBalancer Service を使用して Ollama Deployment を作成します。 - ネットワークを保護する: Ollama ポート(11434)に Namespace NetworkPolicy を適用します。プロジェクト外のクライアントがアクセスする必要がある場合は、ProjectNetworkPolicy を追加します。
4. 省略可: WebUI を開く
- Open WebUI をデプロイする: Open WebUI イメージを Harbor にシードし、状態の永続ストレージを使用して独自の名前空間にデプロイします。vLLM サービス、Ollama サービス、またはその両方の OpenAI 互換の
/v1エンドポイントを指定します。手順については、オープンウェイト モデルの Open WebUI ユーザーガイドをご覧ください。
5. 検証とテスト
デプロイが完了したら、最後のステップとして、サービスが機能していることを確認します。
- ステータスを確認する: Pod が実行中で、サービスに外部 IP アドレスが割り当てられていることを確認します。
- 推論をテストする:
- vLLM: OpenAI 互換の
/v1/modelsエンドポイントと/v1/chat/completionsエンドポイントを使用して、vLLM LoadBalancer IP に curl リクエストを送信します。 - Ollama: 同じ OpenAI 互換の
/v1/modelsエンドポイントと/v1/chat/completionsエンドポイントを使用して、Ollama LoadBalancer IP に curl リクエストを送信します。
- vLLM: OpenAI 互換の
- ポート転送フォールバック: ワークステーションから LoadBalancer IP に到達できない場合(たとえば、ProjectNetworkPolicy がまだ設定されていない場合)、Service に
kubectl port-forwardを使用し、同じリクエストを127.0.0.1に送信します。
6. 運用とスケーリング
- 垂直スケーリング: GPU スライスを増やすか、大規模なモデルの場合はマルチ GPU 構成に移行します。
- 水平スケーリング: Deployment 内のレプリカ数を増やす(
ReadOnlyManyモデル ボリュームが必要)か、追加のモデル Deployment をデプロイして、より多くの同時ユーザー リクエストを処理します。 - トラブルシューティング:
kubectl logsを使用してログをモニタリングし、FIPS セルフテストの失敗やネットワーク ポリシーの制限などの一般的な問題を確認します。
詳細な手順については、Ollama を使用したオープンウェイト モデルのリファレンス実装、vLLM を使用したオープンウェイト モデルのリファレンス実装、およびそれらのユーザーガイドをご覧ください。
その他の教材
- Ollama リファレンス実装を使用したオープン ウェイト モデル
- vLLM リファレンス実装を使用したオープンウェイト モデル
- Ollama ユーザーガイド付き Gemma 4 E4B
- [SUG] GDC エアギャップで vLLM を使用した Mistral 7B Instruct
- [SUG] GDC エアギャップで vLLM を使用した Mistral NeMo 12B Instruct
- [SUG] GDC エアギャップで vLLM を使用した Mistral Small 3.2 24B Instruct
- [SUG] GDC エアギャップで vLLM を使用した Ministral 8B Instruct
- [SUG] GDC エアギャップで vLLM を使用した Mixtral 8x7B Instruct
- [SUG] GDC エアギャップで vLLM を使用した Magistral Small 1.2 24B
- Open Weight モデルの Open WebUI ユーザーガイド
- vLLM のドキュメント
- Ollama
- Open WebUI
- Google Distributed Cloud エアギャップのドキュメント