


Problembeschreibung
Organisationen, die in Umgebungen mit Air Gap arbeiten, stehen vor einer großen Herausforderung: Sie benötigen Large Language Models, dürfen sich aber aufgrund strenger Sicherheitsprotokolle nicht mit externen cloudbasierten APIs verbinden. Um diese Lücke zu schließen, benötigen diese Kunden ein robustes, eigenständiges Ökosystem, das in der Lage ist, Open-Weight-Modelle direkt auf ihrer Google Distributed Cloud (GDC)-Infrastruktur mit Air Gap zu hosten und zu verwalten. Diese lokalisierte Bereitstellung ist für die Aufrechterhaltung der absoluten Datenhoheit unerlässlich, da so sichergestellt wird, dass sensible Informationen die physischen Räumlichkeiten nie verlassen. Durch die Integration sicherer Ausführungsumgebungen in Bereitstellungs-Backends können Nutzer erweiterte KI-Funktionen verwenden und gleichzeitig die volle administrative Kontrolle über ihre Daten, Modellgewichtungen und den internen Sicherheitsstatus behalten.
Gemini on GDC bietet leistungsstarke, verwaltete Frontier-Funktionen. Kunden stellen jedoch häufig Open-Weight-Modelle wie Gemma 4 oder Llama 4 bereit, um eine höhere Granularität und Kontrolle zu erhalten. Die Bereitstellung von Open-Weight-Modellen in GDC-Umgebungen mit Air Gap bietet erhebliche Kostenvorteile gegenüber verwalteten proprietären Diensten. Durch den Besitz der Modellgewichtungen entfallen wiederkehrende API-Gebühren pro Token, die bei umfangreichen, automatisierten Arbeitslasten unerschwinglich werden können. Darüber hinaus ermöglichen Open-Weight-Modelle die Quantisierung (z. B. 4-Bit oder 8-Bit), sodass leistungsstarke Inferenz auf kleineren, kostengünstigeren Hardware-Footprints am Edge ausgeführt werden kann. Diese vertikale Optimierung, kombiniert mit der Möglichkeit, die Infrastruktur ohne zusätzliche Lizenzkosten für mehrere interne Anwendungen freizugeben, führt zu deutlich niedrigeren Gesamtbetriebskosten für nachhaltige, umfangreiche Inferenzvorgänge.
Vorgeschlagene Lösung
In diesem Dokument wird die Referenzarchitektur für die Bereitstellung und Verwaltung von Large Language Models (LLMs) mit offenen Gewichtungen in GDC-Umgebungen (Google Distributed Cloud) mit Air Gap beschrieben. Viele Kunden, insbesondere in stark regulierten Sektoren, können aufgrund strenger Anforderungen an die Datenhoheit und Sicherheit keine cloudbasierten LLM APIs verwenden. Diese Architektur erfüllt die Anforderung, leistungsstarke LLMs lokal in einer eigenen sicheren GDC-Instanz auszuführen.
Inhalt: Diese Architektur umfasst die Bereitstellung von Open-Weights-Modellen (z. B. Gemma 4, Llama, DeepSeek, Mistral) mit den vLLM- oder Ollama-Serving-Backends. Dazu gehören die Verwendung von Kubernetes für die Orchestrierung, Harbor für die Artefaktspeicherung, nichtflüchtige Volumes für Modellgewichtungen, Netzwerkrichtlinien (NetworkPolicy / ProjectNetworkPolicy) für die Netzwerksicherheit und Open WebUI als optionales Browser-Frontend.
Nicht enthalten: Diese Architektur deckt keine verwalteten AI Gateway-Dienste, proprietären Modelle wie Gemini von Google, Prozesse zur Feinabstimmung von Modellen oder GenAI-Modelle für andere Modalitäten wie die Bildgenerierung ab.
Zielgruppe: Die Hauptzielgruppe für dieses Dokument sind Plattformadministratoren, die für die Bereitstellung und Verwaltung von Diensten in GDC verantwortlich sind, sowie technische Architekten, die KI-Lösungen in der Air-Gap-Umgebung entwerfen. Endnutzer und Entwickler, die mit den bereitgestellten Modellen interagieren, sind sekundäre Zielgruppen, die von einem Verständnis der zugrunde liegenden Struktur profitieren.
Architektur
Die Lösung stellt vLLM, Ollama oder beide als containerisierte Inferenzbereitstellungs-Backends (Deployments) in einem Standardcluster bereit. Modellgewichtungen werden auf nichtflüchtigen Volumes gespeichert, die von der Workstation über einen Modell-Loader (Pod) befüllt werden. Kubernetes-Services vom Typ LoadBalancer stellen die Backend-APIs bereit, NetworkPolicy- / ProjectNetworkPolicy-Objekte sichern den Zugriff darauf und Open WebUI kann optional als Browser-Frontend für die OpenAI-kompatiblen APIs bereitgestellt werden.
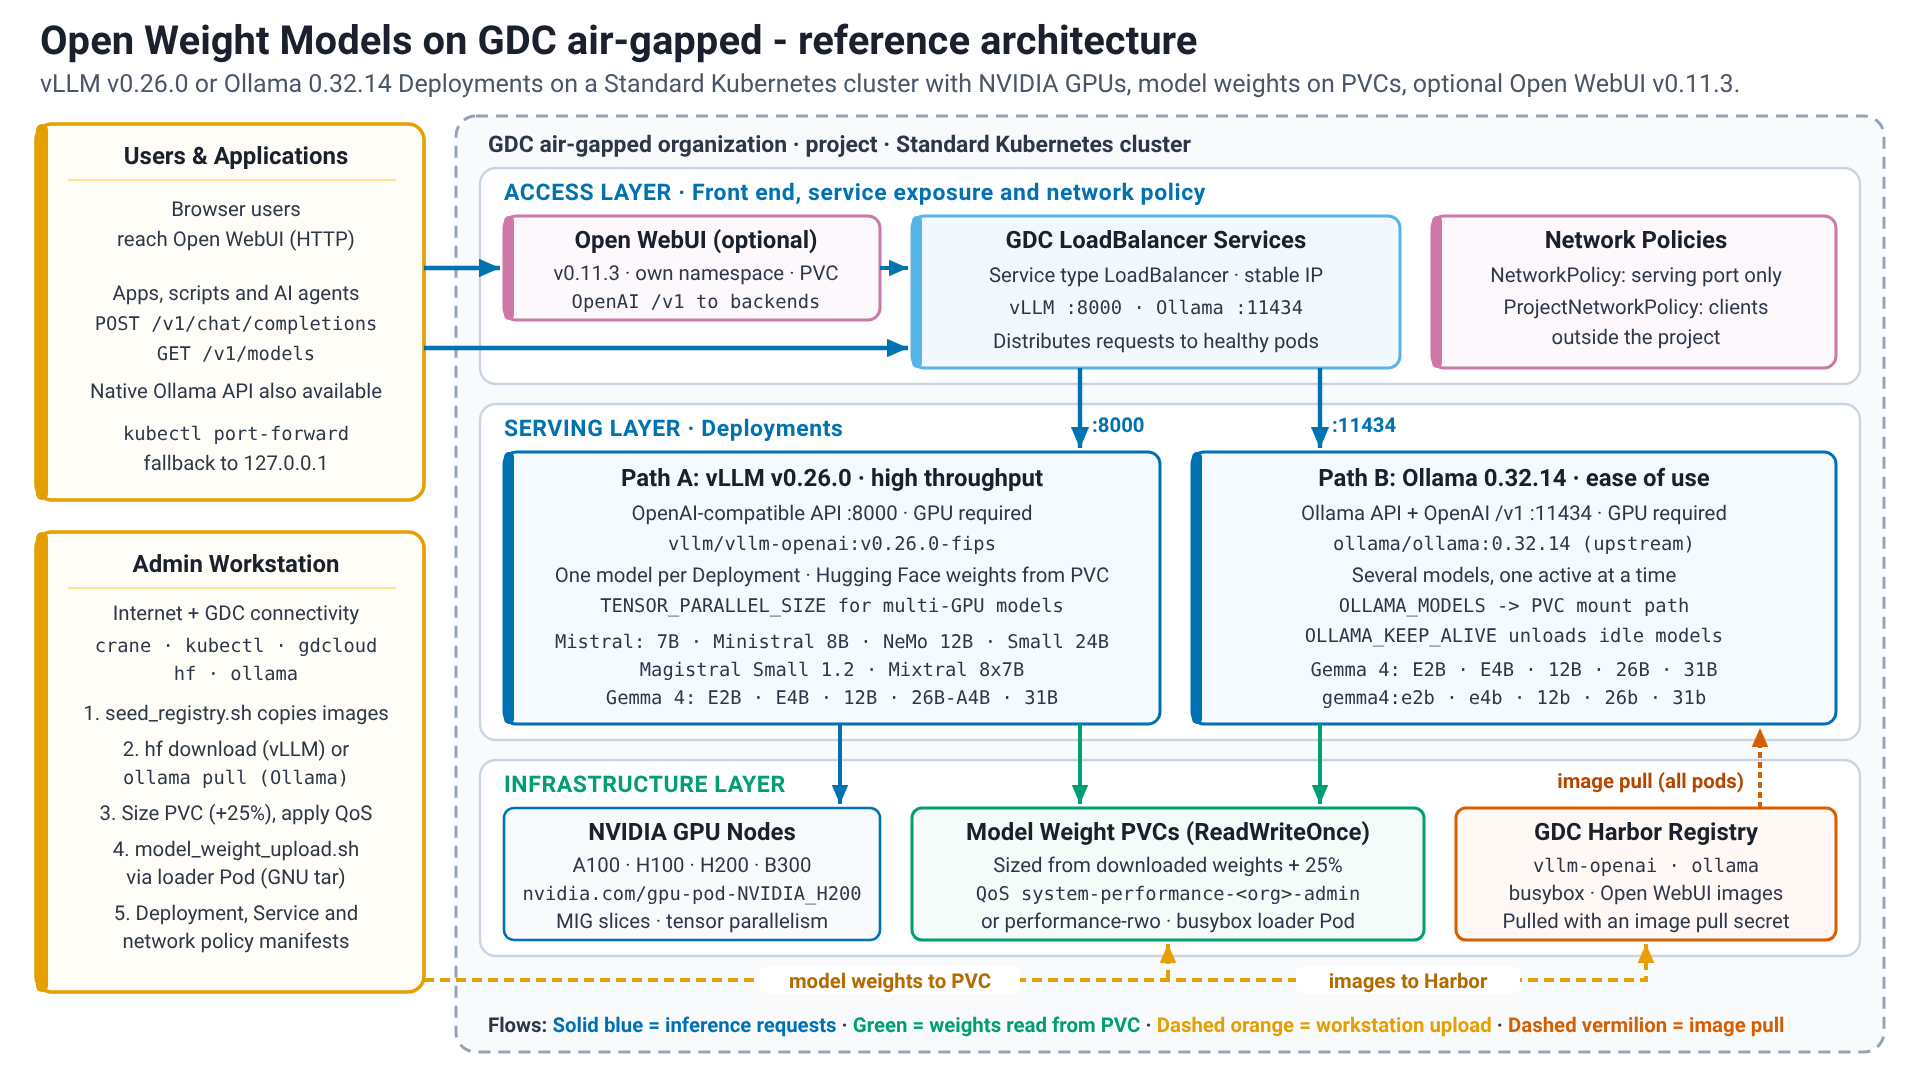
Lösungskomponenten
Die Lösung verwendet die folgenden Komponenten:
| Lösungskomponente | Verantwortlichkeiten | Datenfluss | Schnittstellen |
|---|---|---|---|
| GDC mit Air Gap – Kundenzone | Hostet die Kubernetes-Cluster, das Netzwerk und die Speicherinfrastruktur | Grundlegende Plattform | Infrastrukturverwaltungsoberflächen für den IO. Kubernetes API für Plattformadministratoren und Nutzer |
| Load Balancer | Macht die LLM-Bereitstellungs-Pods (vLLM, Ollama) für Traffic von außerhalb des Kubernetes-Clusters verfügbar und stellt eine stabile IP-Adresse bereit. | Externe Clientanfragen werden an die externe IP-Adresse des Load Balancers gesendet. Der LoadBalancer verteilt die Anfragen basierend auf dem Selektor des Dienstes auf die fehlerfreien Backend-Pods (vLLM oder Ollama). | Kubernetes Service API. Stellt automatisch einen Netzwerk-Load-Balancer in der GDC-Umgebung bereit. |
| vLLM | LLM-Inferenzbereitstellung mit hohem Durchsatz. Optimiert für niedrige Latenz mit Techniken wie PagedAttention. Stellt in der Regel ein Modell pro Instanz bereit. | Empfängt HTTP-Inferenzanfragen von Clients. Lädt Modellgewichtungen aus dem bereitgestellten PVC. Führt Berechnungen auf angehängten GPUs aus. Gibt HTTP-Antworten mit generiertem Text zurück. | OpenAI-kompatible RESTful API für die Inferenz. Akzeptiert JSON-Anfragen. |
| Ollama | LLM-Inferenzbereitstellung, die auf einfache Bedienung ausgelegt ist. Eine Instanz kann mehrere Modelle bereitstellen und lädt sie bei Bedarf. | Empfängt HTTP-Inferenzanfragen. Lädt Modelle aus dem bereitgestellten PVC (OLLAMA_MODELS). Führt Berechnungen auf angehängten GPUs aus. Gibt HTTP-Antworten zurück. Modelle werden nach einem konfigurierbaren Zeitraum der Inaktivität (OLLAMA_KEEP_ALIVE) entladen. |
Ollama RESTful API und OpenAI-kompatible API (/v1). Akzeptiert JSON-Anfragen. Außerdem ist eine Befehlszeile vorhanden. |
| NVIDIA-GPUs und MIG | Hardwarebeschleunigung für LLM-Inferenz bereitstellen | Die LLM-Backends (vLLM, Ollama) lagern die rechenintensiven Modellberechnungen (z. B. Matrixmultiplikationen) auf die GPUs aus, um die Inferenz zu beschleunigen. Mit MIG kann eine einzelne GPU partitioniert werden, um sie für mehrere kleinere Modellinstanzen zu verwenden. | Wird in Kubernetes als Ressourcentyp bereitgestellt (z. B. nvidia.com/gpu-pod-NVIDIA_H200; der genaue Ressourcenname hängt vom installierten GPU-Modell ab und wird von den Knoten ermittelt). Pods fordern diese Ressourcen an |
| Harbor | Speichert und verwaltet Container-Images für vLLM, Ollama, Open WebUI und alle Hilfs-Pods (wie BusyBox) sicher. | Container-Images werden mit seed_registry.sh (crane) von einer Workstation mit Internetzugriff aus öffentlichen Registries in Harbor kopiert. Kubernetes-Knoten rufen diese Images aus Harbor ab, um Container auszuführen. |
Docker Registry API. Kubernetes-Knoten interagieren mit Harbor, um Images während der Pod-Erstellung abzurufen. Nutzer verwenden die crane, die Docker-Befehlszeile oder die Harbor-Benutzeroberfläche, um Images per Push zu übertragen. |
| Anforderungen nichtflüchtiger Volumes | Bietet nichtflüchtigen Speicher für LLM-Modellgewichtungen, entkoppelt von Pod-Lebenszyklen. | Modell-Dateien werden auf die Workstation heruntergeladen, verwendet, um die PVC-Größe mit 25% Overhead dynamisch zu berechnen, und über einen temporären Modell-Loader-Pod (busybox) mit model_weight_upload.sh in das nichtflüchtige Volume gestreamt. Der PVC wird mit performance-rwo bereitgestellt, wobei leistungsstarker Blockspeicher aktiviert ist. Andernfalls wendet ein Infrastrukturoperator die QoS-Richtlinie system-performance-<org>-admin auf das zugrunde liegende Volume an. Beide Optionen bieten 30 IOPS pro GiB (mindestens 6.148 IOPS). Beide Backends lesen ihre Modellgewichtungen beim Start aus diesem bereitgestellten Volume: vLLM lädt das Hugging Face-Modellverzeichnis, Ollama verweist mit OLLAMA_MODELS auf den Bereitstellungspfad. Es wird kein kubectl cp verwendet und es werden keine Modelle in Container-Images gebündelt. |
Kubernetes Storage API. In YAML (ReadWriteOnce) definiert und als Volumes in Pods bereitgestellt. |
| Netzwerkrichtlinien | Netzwerkisolation erzwingen und Trafficfluss zu den LLM-Diensten steuern Ein Namespace NetworkPolicy (networking.k8s.io/v1) lässt Traffic zum Bereitstellungsport von innerhalb des Clusters zu. Für den Zugriff von außerhalb des Projekts ist zusätzlich ein ProjectNetworkPolicy (networking.gdc.goog/v1) erforderlich. |
Der Netzwerkverkehr zu und von Pods im Namespace wird geprüft. Die Richtlinienregeln legen fest, ob Verbindungen zu den LLM-Dienstports (z. B. 8000 für vLLM, 11434 für Ollama) zulässig sind, in der Regel basierend auf Quell-IP-Bereichen oder anderen Labels. | Kubernetes-APIs networking.k8s.io/v1 und networking.gdc.goog/v1. In YAML definiert. |
| Open WebUI | Optionales browserbasiertes Frontend für Endnutzer. Kommuniziert mit den OpenAI-kompatiblen APIs von vLLM und Ollama. Es enthält keine Modellgewichtungen und benötigt keinen Beschleuniger. | Nutzer greifen über den Kubernetes-Dienst auf Open WebUI zu. Open WebUI leitet Chatanfragen über die OpenAI-kompatible /v1 API an die vLLM- und Ollama-Dienste weiter und speichert den eigenen Status (Nutzer, Chats, Einstellungen) auf einem nichtflüchtigen Volume. |
HTTP (Browser) für Nutzer, OpenAI-kompatible REST API für die Backends. Zustandsorientierte Arbeitslast, die in einem eigenen Namespace bereitgestellt wird. |
Funktionen
Diese Referenzarchitektur bietet die folgenden Kernfunktionen:
- Bereitstellung von Open-Weight-LLMs: Ermöglicht das Hosting und die Inferenz verschiedener Open-Weight-Modelle (z. B. Gemma 4, Llama, DeepSeek, Mistral).
- Komponenten: LLM-Bereitstellungs-Backends (vLLM, Ollama), Kubernetes-Deployments/-Pods.
- Aufgaben: Modellgewichtungen laden, Inferenzprozess verwalten, Modelle auf Hardwarebeschleunigern ausführen und Endpunkte bereitstellen.
- Schnittstellen: REST APIs (OpenAI-kompatibel für vLLM und Ollama sowie die Ollama-spezifische API) für Inferenzanfragen, in der Regel mit JSON.
- Bring Your Own Model (BYOM): Nutzer können ihre ausgewählten Open-Weight-LLMs in die Air-Gap-Umgebung importieren und dort bereitstellen.
- Komponenten: Harbor, Persistent Volume Claims, Modell-Loader-Pod, Kubernetes.
- Aufgaben: Sichere Speicherung von Container-Images und Modellgewichtungen. Mechanismus zum Übertragen von Modellen in die Umgebung (
model_weight_upload.shüber den Loader-Pod) und zum Bereitstellen für die Bereitstellungs-Engines. - Schnittstellen: Docker Registry API (für Harbor), Kubernetes API (für PVCs und Volume-Bereitstellungen).
- Hardwarebeschleunigte Inferenz: Verwendet NVIDIA-GPUs im GDC-Cluster, um LLM-Inferenzen effizient auszuführen.
- Komponenten: NVIDIA-GPUs, Kubernetes, Geräte-Plug-ins.
- Aufgaben: Pods auf Knoten mit GPU-Ressourcen planen.
GPU-Hardware für die LLM-Backend-Container verfügbar machen. Unterstützt Multi-Instanz-GPU (MIG) für die Partitionierung und Multi-GPU-Tensor-Parallelität (
TENSOR_PARALLEL_SIZE) für große Modelle wie Mixtral 8x7Bbf16. - Schnittstellen: Kubernetes API (zum Anfordern von GPU-Ressourcen wie
nvidia.com/gpu-pod-NVIDIA_H200odernvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE).
- Netzwerkgesteuerter Zugriff: Sorgt dafür, dass der Zugriff auf die LLM-Inferenzendpunkte innerhalb der GDC-Umgebung gesteuert und isoliert wird.
- Komponenten: Kubernetes-Dienste (LoadBalancer), NetworkPolicy, ProjectNetworkPolicy.
- Aufgaben: Inferenzdienste über eine stabile IP-Adresse bereitstellen. Netzwerkregeln definieren und erzwingen, um Traffic zu den LLM-Back-Ends basierend auf Quelle, Ziel und Ports zuzulassen oder abzulehnen.
- Schnittstellen: Kubernetes API (für Services, NetworkPolicy und ProjectNetworkPolicy).
- Skalierbare Bereitstellung: Ermöglicht die Anpassung der Kapazität je nach Bedarf.
- Komponenten: Kubernetes-Deployments.
- Aufgaben: Horizontale Skalierung durch Erhöhen der Anzahl der Replikate für die LLM-Backend-Pods ermöglichen. Vertikale Skalierung durch Anpassen von Ressourcenanfragen/-limits.
- Schnittstellen: Kubernetes API (zum Verwalten von Deployment-Replikaten und -Ressourcen).
- Browser-Frontend (optional): Ermöglicht Endnutzern, mit den bereitgestellten Modellen zu chatten, ohne API-Aufrufe schreiben zu müssen.
- Komponenten: Open WebUI-Bereitstellung, Dienst und Persistent Volume Claim.
- Aufgaben: Die von vLLM und Ollama bereitgestellten Modelle in einer Oberfläche präsentieren; Nutzer, Chats und Einstellungen beibehalten.
- Schnittstellen: HTTP (Browser); OpenAI-kompatible
/v1API für die Backends.
Architekturprinzipien
- Sicherheit an erster Stelle: Alle Komponenten und Daten befinden sich innerhalb der GDC mit Air Gap-Grenze, was für maximale Datensicherheit und Kontrolle sorgt. Der Netzwerkzugriff wird mithilfe von
NetworkPolicy- undProjectNetworkPolicy-Objekten eingeschränkt. - Datenhoheit: Kunden behalten die volle Kontrolle über ihre Modelle und Daten. Für den Betrieb ist keine externe Verbindung erforderlich.
- Offen und flexibel: Die Architektur verwendet Open-Source-Bereitstellungs-Backends (vLLM, Ollama) und unterstützt eine Vielzahl von LLMs mit offenen Gewichtungen. So haben Kunden die Wahl und vermeiden eine Anbieterabhängigkeit für die Inferenz-Engine.
- Entkopplung von Komponenten: Wichtige Funktionen wie Modellspeicherung (PVCs), Image-Verwaltung (Harbor), Inferenzbereitstellung (vLLM/Ollama-Pods) und die Benutzeroberfläche (Open WebUI) sind separate Komponenten, die unabhängig voneinander verwaltet und aktualisiert werden können.
- Skalierbarkeit und Leistung: Entwickelt, um sowohl horizontal durch Erhöhung der Anzahl der Pod-Replikate als auch vertikal durch Anpassung der CPU-/GPU-Ressourcen (einschließlich Multi-GPU-Tensor-Parallelität) zu skalieren, um die Leistungsanforderungen zu erfüllen. vLLM wird für Szenarien mit hohem Durchsatz und niedriger Latenz ausgewählt.
- Ressourcenoptimierung: Unterstützt NVIDIA Multi-Instance GPU (MIG), damit kleinere Modelle GPU-Ressourcen effizient gemeinsam nutzen können, und dynamische PVC-Größenanpassung (+25% Overhead) in Kombination mit leistungsstarker Speicher-QoS, um eine Überdimensionierung des Speichers zu vermeiden, ohne die Ladegeschwindigkeit des Modells zu beeinträchtigen.
- Standardschnittstellen: Basiert auf Kubernetes-Standards für Orchestrierung, Bereitstellung und Dienstbereitstellung. Inferenzendpunkte bieten REST APIs, wobei sowohl vLLM als auch Ollama OpenAI-Kompatibilität bieten.
- Ausfallsicherheit: Verwendet Kubernetes-Systemdiagnosen und Replikation, um die Dienstverfügbarkeit zu gewährleisten.
Hinweise
- Skalierbarkeit und Leistung:
- Die horizontale Skalierung wird durch Erhöhen der Anzahl der Replikate im Kubernetes-Deployment für vLLM und Ollama erreicht. Ohne eine
ReadOnlyMany-StorageClass ist ein Modell-Deployment auf ein Replikat beschränkt (das Modell-Volume istReadWriteOnce). Zusätzliche Kapazität wird dann durch zusätzliche Deployments bereitgestellt, die jeweils einen eigenen PVC haben. - Bei der vertikalen Skalierung werden mehr CPU/Arbeitsspeicher und größere GPU-Slices zugewiesen, bis hin zu vollständigen GPUs oder Tensor-Parallelität mit mehreren GPUs (
TENSOR_PARALLEL_SIZE) über mehrere GPUs auf demselben Knoten. - vLLM stellt ein Modell pro Instanz bereit. Für zusätzliche Modelle sind neue Deployments erforderlich. Ollama kann mehrere Modelle von einer Instanz aus bereitstellen. In diesen Anleitungen stellt jede Ollama-Bereitstellung ein Modell bereit.
- Der PVC jedes Modells wird dynamisch anhand der heruntergeladenen Gewichtungen mit 25% Overhead dimensioniert und mit der QoS-Richtlinie für Hochleistungsspeicher (
system-performance-<org>-admin, 30 IOPS pro GiB mit einer Untergrenze von 6.148 IOPS oderperformance-rwo,wenn Hochleistungs-Blockspeicher aktiviert ist) konfiguriert, damit die Ladezeiten des Modells nicht durch die Standardbegrenzung von 3 IOPS pro GiB vonstandard-rwogedrosselt werden.
- Die horizontale Skalierung wird durch Erhöhen der Anzahl der Replikate im Kubernetes-Deployment für vLLM und Ollama erreicht. Ohne eine
- Ressourcenverwaltung:
- Eine sorgfältige Planung der GPU-Ressourcen ist unerlässlich. Mit NVIDIA MIG können GPUs für kleinere Modelle partitioniert werden, um die Auslastung zu verbessern. Bei größeren Modellen (z. B. Mixtral 8x7B in
bf16) können die Gewichtungen mithilfe von Tensorparallelität auf mehrere GPUs verteilt werden. - Es müssen ausreichend CPU und Arbeitsspeicher zugewiesen werden, um sowohl die Inferenz als auch den Overhead für die Modellverwaltung zu bewältigen. vLLM und Ollama stellen Modelle mit GPU-Beschleunigung bereit.
- Für PVCs muss ausreichend Speicherplatz bereitgestellt werden, um die Modellgrößen zu berücksichtigen und die Leistung zu gewährleisten.
- Eine sorgfältige Planung der GPU-Ressourcen ist unerlässlich. Mit NVIDIA MIG können GPUs für kleinere Modelle partitioniert werden, um die Auslastung zu verbessern. Bei größeren Modellen (z. B. Mixtral 8x7B in
- Verfügbarkeit und Zuverlässigkeit:
- Kubernetes-Deployments bieten Funktionen für die Selbstheilung und Rolling Updates.
- LoadBalancer-Dienste verteilen den Traffic auf fehlerfreie Pods und maskieren einzelne Pod-Ausfälle.
- Durch das Speichern von Modellgewichtungen auf PVCs wird die Persistenz über Pod-Neustarts hinweg sichergestellt.
- Operative Komplexität:
- Verwalten von Container-Images für verschiedene Backends und Versionen in Harbor.
- Verfahren für die sichere Übertragung von Modellgewichtungen in die Air-Gap-Umgebung.
- Erstellen und Verwalten von Kubernetes-Manifesten (Deployments, Services, PVCs, Netzwerkrichtlinien) für jedes Modell und Backend.
- Überwachung der GPU-Auslastung, Inferenzlatenz und Fehlerraten.
- Sicherheit und Compliance:
- Die gesamte Lösung wird innerhalb des GDC-Sicherheitsperimeters mit Air Gap ausgeführt.
- Netzwerkrichtlinien sind obligatorisch, um eine strikte Netzwerkisolation zu erzwingen und den Zugriff auf die LLM-Endpunkte zu steuern: ein Namespace
NetworkPolicyfür den Zugriff innerhalb des Clusters und einProjectNetworkPolicyfür den Zugriff von außerhalb des Projekts. - Harbor-Roboterkonten und Kubernetes-Image-Pull-Secrets sorgen für sicheren Zugriff auf Container-Images.
- Netzwerkrichtlinien schränken ein, welche Clients die Endpunkte erreichen können. Inaktive Daten auf PVCs basieren auf der GDC-Speicherverschlüsselung.
Designentscheidungen
Für diese Referenzarchitektur wurden die folgenden wichtigen Designentscheidungen getroffen:
Entscheidung 1: Sowohl vLLM als auch Ollama anstelle eines einzelnen Bereitstellungs-Backends anbieten
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Ein oder beide Bereitstellungs-Backends (vLLM oder Ollama) anbieten. | Beide anbieten, da Nutzer und Anwendungsfälle unterschiedliche Anforderungen an Leistung, API-Kompatibilität und einfache Modellverwaltung haben. | vLLM bietet eine Bereitstellung mit hohem Durchsatz und niedriger Latenz sowie Kompatibilität mit der OpenAI API, was es für Produktionsanwendungen geeignet macht. Ollama bietet eine einfachere Einrichtung, eine einfachere Verwaltung mehrerer Modelle und eine höhere Nutzerfreundlichkeit, was für die Entwicklung und das Experimentieren besser ist. Die Unterstützung beider Optionen bietet Flexibilität. |
Entscheidung 2: Modellgewichtungen für PersistentVolumeClaims
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| vLLM und Ollama erfordern zur Laufzeit Modellgewichtungen im Dateisystem. In einer Air-Gap-Umgebung können Modelle nicht bei Bedarf heruntergeladen werden. | Speichern Sie die Gewichtungen jedes Modells in einem eigenen ReadWriteOnce-PersistentVolumeClaim, der von der Workstation über einen temporären Modell-Loader-Pod befüllt wird. |
PersistentVolumeClaims bieten eine robuste und nichtflüchtige Speicherebene für große Modelldateien, die vom Lebenszyklus des Inferenz-Pods entkoppelt ist. So können Modelle beim Pod-Start schnell geladen werden. |
Entscheidung 3: Modellgewichtungen auf PersistentVolumes für Ollama (Loader-Pod) statt im Image bündeln
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Ollama kann Modelle herunterladen, aber dafür ist ein Internetzugriff erforderlich, der in Umgebungen mit Air Gap nicht verfügbar ist. Wenn Sie die Modelle in einem benutzerdefinierten Ollama-Image bündeln, müssen Sie für jedes Modell ein neues Image erstellen und mehrere Gigabyte große Images in Harbor speichern. | Ollama verwendet denselben Loader-Pod-Workflow wie vLLM: Das Modell wird auf der Workstation (ollama pull bis ollama_model_weight_download.sh) abgerufen, über den Modell-Loader-Pod mit model_weight_upload.sh (GNU tar) in den PVC gestreamt und OLLAMA_MODELS wird auf den Bereitstellungspfad verwiesen. |
Ein Workflow für beide Backends; Modelle können hinzugefügt oder aktualisiert werden, ohne Images neu zu erstellen; das unveränderte Upstream-Ollama-Image bleibt in Harbor klein. |
Entscheidung 4: vLLM und Ollama mit LoadBalancer-Diensten oder ohne Load Balancer bereitstellen
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| LLM APIs müssen für Anwendungen in der GDC-Umgebung zugänglich sein. | Stellen Sie jedes Backend über einen Dienst vom Typ LoadBalancer bereit, dem Standard-Kubernetes-Ansatz. Dazu wird die Load-Balancer-Bereitstellung der GDC-Plattform mit Air Gap verwendet. |
Kubernetes-Dienste vom Typ „LoadBalancer“ bieten eine standardmäßige, zuverlässige Methode, um die LLM-Backends bereitzustellen, eine stabile IP-Adresse bereitzustellen und die Last zu verteilen. |
Entscheidung 5: Obligatorische Netzwerkrichtlinien erzwingen (NetworkPolicy und ProjectNetworkPolicy)
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Sicherheit und Isolation sind bei GDC-Deployments mit Air Gap von entscheidender Bedeutung. | Erzwingen Sie Netzwerkrichtlinien für jeden LLM-Endpunkt (ein Namespace NetworkPolicy, der nur den Bereitstellungsport zulässt, ergänzt durch eine ProjectNetworkPolicy, wenn Clients außerhalb des Projekts Zugriff benötigen), um den Sicherheitsstatus der bereitgestellten LLM-Dienste zu verbessern. |
NetworkPolicy-Objekte bieten eine Kubernetes-native Möglichkeit, die Netzwerkisolation auf Namespace-Ebene zu erzwingen, und ProjectNetworkPolicy-Objekte erweitern diese auf die Projektgrenze, sodass nur autorisierter Traffic die LLM-Dienste erreichen kann. |
Entscheidung 6: Dynamische PVC-Anpassung (+25% Overhead) in Kombination mit einer leistungsstarken Speicher-QoS-Richtlinie
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
Die Standard-StorageClass standard-rwo erzwingt die ONTAP-Richtlinie für adaptive Dienstqualität standard-<org>-admin (3,072 IOPS per TiB oder 3 IOPS per GiB mit einem Mindestwert von 75 IOPS). Wenn Sie die Größe eines standard-rwo-PVCs strikt auf die Größe der Modellgewichtungen beschränken, werden sequenzielle Lesevorgänge für Gewichtungen auf 5 bis 21 MB/s gedrosselt. Wenn Sie statische PVCs mit 300 bis 500 GiB überdimensionieren, wird Speicherplatz verschwendet, während der sequenzielle Lesedurchsatz immer noch auf etwa 60 MB/s begrenzt ist. |
Laden Sie zuerst die Modellgewichtungen herunter, berechnen Sie GDCS_MODEL_PVC_SIZE dynamisch aus dem heruntergeladenen Verzeichnis mit 25% Overhead, aufgerundet auf das nächste ganze GiB, und verwenden Sie storageClassName: performance-rwo, wenn Hochleistungs-Blockspeicher aktiviert ist, oder bitten Sie einen Infrastrukturbetreiber, die QoS-Richtlinie system-performance-${GDC_ORG}-admin auf das zugrunde liegende Volume anzuwenden. |
Die QoS-Richtlinie system-performance-<org>-admin bietet 30,720 IOPS per TiB (30 IOPS per GiB, 10-mal höher als standard) mit einem Mindestwert von 6,148 IOPS (~393 MB/s ONTAP-Obergrenze) für jedes Volume bis zu 204 GiB. Durch die Kombination der dynamischen Größenanpassung mit 25 % Overhead mit system-performance wird eine 3- bis 40-fache Überdimensionierung des Speichers (12Gi bis 109Gi statt 100Gi bis 500Gi) vermieden, während die sequenzielle Lesegeschwindigkeit von KubeVirt-virtio-scsi mit einer einzelnen LUN auf ca.150 MB/s erhöht wird (2,5- bis 30-mal schnellerer Modellstart). |
Annahmen und Einschränkungen
- GDC mit Air Gap 1.16.2 Hotfix 1 (
1.16.2-gdch.1353-1) oder höher ist verfügbar (GPU-Knotenpools in Standardclustern erfordern dieses Release; frühere Releases bieten GPUs nur in freigegebenen Clustern). - Im Standardcluster sind ausreichende Hardwareressourcen (einschließlich NVIDIA-GPUs) vorhanden. Sowohl vLLM als auch Ollama erfordern eine GPU.
- Die Harbor-Instanz ist eingerichtet und zugänglich.
- Eine Workstation mit Internetzugriff und Verbindung zur GDC-Umgebung (Harbor und Kubernetes API) ist für das Seeding von Images und das Hochladen von Modellgewichtungen verfügbar.
- Nutzer haben die erforderlichen Berechtigungen: die Projektrollen „Harbor Instance Viewer“ und „Standard Cluster Admin“ sowie ein StandardClusterRoleBinding (cluster-admin) für den Standardcluster. Weitere Informationen finden Sie in den SRIs.
- Die Modelle sind mit den ausgewählten Bereitstellungs-Backends (vLLM/Ollama) kompatibel.
- Einschränkung: Der PVC für die Modellgewichtung ist
ReadWriteOnce. Ohne eineReadOnlyMany-StorageClass ist jede Modellbereitstellung auf ein Replikat beschränkt.
User-Flow
Im Folgenden finden Sie einen umfassenden User-Flow für die Bereitstellung von Large Language Models (LLMs) mit offenen Gewichtungen in GDC-Umgebungen (Google Distributed Cloud) mit Air Gap. Der Ablauf ist in eine allgemeine Einrichtung, zwei Bereitstellungspfade (vLLM und Ollama), ein optionales Frontend und eine abschließende Validierung unterteilt.
1. Allgemeine Einrichtung: Image-Verwaltung
Bevor Sie ein LLM bereitstellen, müssen Sie konfigurieren, wie die GDC-Umgebung Container-Images aus Ihrer privaten Harbor-Registry abruft.
- Harbor-Robot-Konten erstellen: Generieren Sie Robot-Konten in der Harbor-Benutzeroberfläche: eines mit Push-Berechtigungen für
crane(Image-Seeding) und eines mit Pull-Berechtigungen für das Kubernetes-Image-Pull-Secret. - Crane- und Seed-Images authentifizieren: Verwenden Sie die Anmeldedaten des Roboterkontos, um sich von einer Workstation mit Internetzugriff (
crane auth login) bei Harbor anzumelden, und kopieren Sie die erforderlichen Container-Images (busybox,ollama/ollama,vllm/vllm-openai, optional Open WebUI) mitseed_registry.shin Harbor. - Kubernetes-Secret erstellen: Erstellen Sie mit kubectl ein Docker-Registry-Secret im Workload-Namespace, um die Anmeldedaten des Pull-Robot-Kontos für den Cluster zu speichern.
2. Bereitstellungspfad A: vLLM für hohen Durchsatz
Dieser Pfad wird für die Bereitstellung leistungsorientierter Modelle wie Mistral 7B Instruct auf GPUs empfohlen.
- Image abrufen: Fügen Sie das vLLM-Image (
vllm/vllm-openai:v0.26.0) mitseed_registry.shin Harbor ein. Erstellen Sie dann das gepatchte Image-Tagv0.26.0-fipsund übertragen Sie es per Push, wie im SRI beschrieben. - Modellspeicher vorbereiten:
- Laden Sie die Gewichtungen von Hugging Face auf die Workstation (
hf download) herunter. - Berechnen Sie die erforderliche PVC-Größe aus den heruntergeladenen Gewichtungen (mit 25 % Overhead), erstellen Sie einen
ReadWriteOnce-PersistentVolumeClaim (PVC) zum Speichern der Modellgewichtungen und wenden Sie die Hochleistungs-QoS-Richtlinie an. - Starten Sie einen temporären Pod zum Laden des Modells (
busybox), der den PVC bereitstellt, und streamen Sie die Gewichtungen mitmodel_weight_upload.sh(GNU tar überkubectl exec;kubectl cpwird nicht verwendet, da BusyBox tar die PAX-Header für Dateien, die größer als 8 GiB sind, nicht lesen kann) in den Pod. Löschen Sie dann den Pod zum Laden des Modells.
- Laden Sie die Gewichtungen von Hugging Face auf die Workstation (
- Backend bereitstellen: Wenden Sie ein Kubernetes-Deployment-Manifest an, das auf das vLLM-Image verweist, die von den Knoten erkannte Beschleunigerressource (z. B.
nvidia.com/gpu-pod-NVIDIA_H200) anfordert und den PVC für die Modellgewichtungen bereitstellt. - Dienst freigeben: Erstellen Sie einen LoadBalancer-Dienst, um eine externe IP-Adresse für die vLLM API bereitzustellen.
- Sicheres Netzwerk: Wenden Sie eine Namespace-NetworkPolicy an, um eingehenden Traffic auf dem Dienstport (8000) zuzulassen. Fügen Sie eine ProjectNetworkPolicy hinzu, wenn Clients außerhalb des Projekts Zugriff benötigen.
3. Bereitstellungspfad B: Ollama für einfache Nutzung
Dieser Pfad konzentriert sich auf eine vereinfachte Einrichtung. Es verwendet das Upstream-Ollama-Image unverändert und denselben Modell-Loader-Workflow wie vLLM.
- Seed-Image: Kopieren Sie das Upstream-Ollama-Image (
ollama/ollama:0.32.14) mitseed_registry.shin Harbor. - Modellspeicher vorbereiten:
- Rufen Sie das Modell (z. B.
gemma4:e4b) auf der Workstation mitollama_model_weight_download.shab. Dadurch wird ein temporärer lokalerollama servemitOLLAMA_MODELSausgeführt, der auf das Downloadverzeichnis verweist. - Berechnen Sie die erforderliche PVC-Größe aus den heruntergeladenen Gewichtungen (mit 25 % Overhead), erstellen Sie einen
ReadWriteOnce-PVC, wenden Sie die Hochleistungs-QoS-Richtlinie an und starten Sie einen temporären Pod zum Laden des Modells, der ihn bereitstellt. - Laden Sie das Downloadverzeichnis mit
model_weight_upload.shin den PVC hoch und löschen Sie dann den Loader-Pod.
- Rufen Sie das Modell (z. B.
- Bereitstellen und freigeben: Erstellen Sie ein Ollama-Deployment mit
OLLAMA_MODELS, das auf den PVC-Bereitstellungspfad verweist (und die von den Knoten erkannte Beschleunigerressource anfordert), und einen LoadBalancer-Dienst. - Sicheres Netzwerk: Wenden Sie eine Namespace-NetworkPolicy für den Ollama-Port (11434) an. Fügen Sie eine ProjectNetworkPolicy hinzu, wenn Clients außerhalb des Projekts Zugriff benötigen.
4. Optional: WebUI öffnen
- Open WebUI bereitstellen: Übertragen Sie das Open WebUI-Image in Harbor und stellen Sie es in einem eigenen Namespace mit nichtflüchtigem Speicher für den Status bereit. Verweisen Sie auf die OpenAI-kompatiblen
/v1-Endpunkte des vLLM-Dienstes, des Ollama-Dienstes oder beider Dienste. Die Schritte finden Sie im Nutzerhandbuch zu Open WebUI für Open-Weight-Modelle.
5. Validierung und Tests
Nach der Bereitstellung müssen Sie im letzten Schritt prüfen, ob die Dienste funktionieren.
- Status prüfen: Prüfen Sie, ob die Pods ausgeführt werden und den Diensten externe IP-Adressen zugewiesen wurden.
- Inferenz testen:
- vLLM: Senden Sie eine curl-Anfrage an die vLLM-LoadBalancer-IP-Adresse. Verwenden Sie dazu die OpenAI-kompatiblen Endpunkte
/v1/modelsund/v1/chat/completions. - Ollama: Senden Sie eine curl-Anfrage an die Ollama-LoadBalancer-IP-Adresse und verwenden Sie dabei dieselben OpenAI-kompatiblen
/v1/models- und/v1/chat/completions-Endpunkte.
- vLLM: Senden Sie eine curl-Anfrage an die vLLM-LoadBalancer-IP-Adresse. Verwenden Sie dazu die OpenAI-kompatiblen Endpunkte
- Portweiterleitungs-Fallback: Wenn die LoadBalancer-IP-Adresse von der Workstation aus nicht erreichbar ist (z. B. weil noch keine ProjectNetworkPolicy vorhanden ist), verwenden Sie
kubectl port-forwardfür den Dienst und senden Sie dieselben Anfragen an127.0.0.1.
6. Betrieb und Skalierung
- Vertikale Skalierung: Erhöhen Sie die Anzahl der GPU-Slices oder wechseln Sie für größere Modelle zu Multi-GPU-Konfigurationen.
- Horizontale Skalierung: Erhöhen Sie die Anzahl der Replikate in der Bereitstellung (erfordert ein
ReadOnlyMany-Modellvolumen) oder stellen Sie zusätzliche Modellbereitstellungen bereit, um mehr gleichzeitige Nutzeranfragen zu verarbeiten. - Fehlerbehebung: Überwachen Sie Logs mit
kubectl logsund prüfen Sie auf häufige Probleme wie Fehler bei FIPS-Selbsttests oder Einschränkungen durch Netzwerkrichtlinien.
Die detaillierten Schritte finden Sie in der Referenzimplementierung für Open-Weight-Modelle mit Ollama, der Referenzimplementierung für Open-Weight-Modelle mit vLLM und den entsprechenden Nutzerhandbüchern.
Zusätzliche Materialien
- Offene Gewichtungsmodelle mit Ollama-Referenzimplementierung
- Referenzimplementierung für offene Gewichtungsmodelle mit vLLM
- Nutzerhandbuch für Gemma 4 E4B mit Ollama
- [SUG] Mistral 7B Instruct mit vLLM in GDC mit Air Gap
- [SUG] Mistral NeMo 12B Instruct mit vLLM in GDC mit Air Gap
- [SUG] Mistral Small 3.2 24B Instruct mit vLLM in GDC mit Air Gap
- [SUG] Ministral 8B Instruct mit vLLM in GDC mit Air Gap
- [SUG] Mixtral 8x7B Instruct mit vLLM auf GDC mit Air Gap
- [SUG] Magistral Small 1.2 24B mit vLLM in GDC mit Air Gap
- Nutzerhandbuch für Open WebUI für Open-Weight-Modelle
- vLLM-Dokumentation
- Ollama
- Open WebUI
- Dokumentation zu Google Distributed Cloud mit Air Gap