


问题陈述
在隔网环境中运行大语言模型 (LLM) 的组织会快速积累模型端点:在 Google Distributed Cloud (GDC) 隔网环境中部署的每个开放权重模型(请参阅配套指南“在 GDC 隔网环境中部署开放权重模型”)都会公开自己的 Kubernetes Service、自己的地址、自己的凭据和自己的运营生命周期。应用和代理开发者最终会陷入架构孤岛,为每个模型硬编码一个端点,并在每次模型迭代时重写集成。这种碎片化会产生技术债务,并减缓关键的多步骤智能体工作负载的部署速度。
标准网络层也是“AI 盲”:传统负载均衡器将推理流量视为通用 HTTP,无法读取请求的 model 字段,无法优先处理对延迟时间敏感的工作负载,无法考虑令牌而非请求,也无法将请求引导至已持有相关 KV 缓存的模型服务器副本。在高成本的隔离 GPU 集群中,这会导致硬件利用率不足,投资回报率较低。虽然 GDC 上的 Gemini 提供代管式前沿模型,但将这些模型与自托管开放权重模型相结合的客户需要一个推理层,该推理层可提供类似云的敏捷性,同时不会损害数据主权:任何请求、提示或模型权重都不得离开 GDC 边界。
建议的解决方案
本文档概述了 GDC 网闸隔离配置环境中的自管理 AI 网关的参考架构:一个安全、集中的推理层,可为应用提供一个与 OpenAI 兼容的端点,用于访问所有模型,并将每个请求路由到正确的后端。参考实现基于 Kubernetes Gateway API 构建:Envoy Gateway 是 Gateway API 实现(控制平面和 Envoy 代理数据平面),Envoy Agent Router(以前称为 Envoy AI Gateway)通过 AI 特定的请求处理来扩展它:从请求正文中提取模型、请求和响应翻译、上游身份验证、令牌记账,以及可选的基于令牌的速率限制。Gateway API 推理扩展程序添加了可感知模型服务器的端点选择功能(InferencePool 和端点选择器),以便高效使用 GPU 容量。所有制品都暂存在 GDC 组织的 Harbor 注册表中,整个堆栈在没有任何外部连接的标准集群中运行。
包含的内容:此架构涵盖了在标准集群中部署 Envoy Gateway 和 Envoy 代理路由器、公开统一的 OpenAI 兼容端点的 Gateway API 资源(GatewayClass、Gateway)和 Envoy 代理路由器资源(AIGatewayRoute、AIServiceBackend、BackendSecurityPolicy、GatewayConfig)、基于 model 字段的基于正文的路由、用于实现模型感知型负载均衡的 Gateway API 推理扩展(InferencePool、InferenceObjective、端点选择器)、使用 Redis 实现的可选的基于令牌的速率限制、网关处的 TLS 终结、网络政策(NetworkPolicy/ProjectNetworkPolicy)以及 Harbor 中的经过网闸隔离制品管理。网关 (Ollama、vLLM) 后面的模型服务后端是按照配套指南“在 GDC 上部署开放式权重模型(气隙)”进行部署的。
不包含的内容:此架构不涵盖受管理的 AI 网关产品、模型本身的部署和调优(配套指南集)、模型微调、非 LLM GenAI 模态、智能体到工具的流量 (MCPRoute) 或商业支持的网关分发。GDC 上的 Gemini 是一项受管理的产品功能;其配置不在本指南集的范围内,本指南集版本使用自托管的开放权重模型验证网关。
受众群体:本文档的主要受众群体包括负责在标准集群中部署和运行网关的平台管理员,以及在气隙环境中设计 AI 平台的技术架构师。使用统一端点的应用开发者是次要受众群体,了解请求的路由方式对他们有益。
架构
该解决方案完全在 GDC 网闸隔离配置组织的标准集群中运行。在服务层中,Kubernetes Gateway API 标准化了配置模型;AI 网关控制平面(Envoy Gateway 控制器和 Envoy Agent Router 控制器)读取 Gateway API 和 Envoy Agent Router 资源,并配置数据平面:Envoy 代理 Deployment(作为请求入口点,通过类型为 LoadBalancer 的 Service 公开)和 Envoy Agent Router 外部处理器(作为 Sidecar 在代理 Pod 中运行并执行 AI 特定的逻辑)。在应用层,客户工作负载(应用和代理)向代理发送 AI 请求 (1),代理将请求交给外部处理器,后者提取模型名称、翻译请求并记录令牌使用情况 (2),代理将平衡的流量转发到所选模型的推理 Pod (3),模型在基础设施层的 GPU 节点上运行 (4)。模型部署后端以 AIServiceBackend(任何与 OpenAI 兼容的 Service)或 InferencePool 的形式附加到网关,后者通过端点选择器为每个请求选择最佳副本。容器映像和 Helm 图表是从 Harbor 中拉取的。
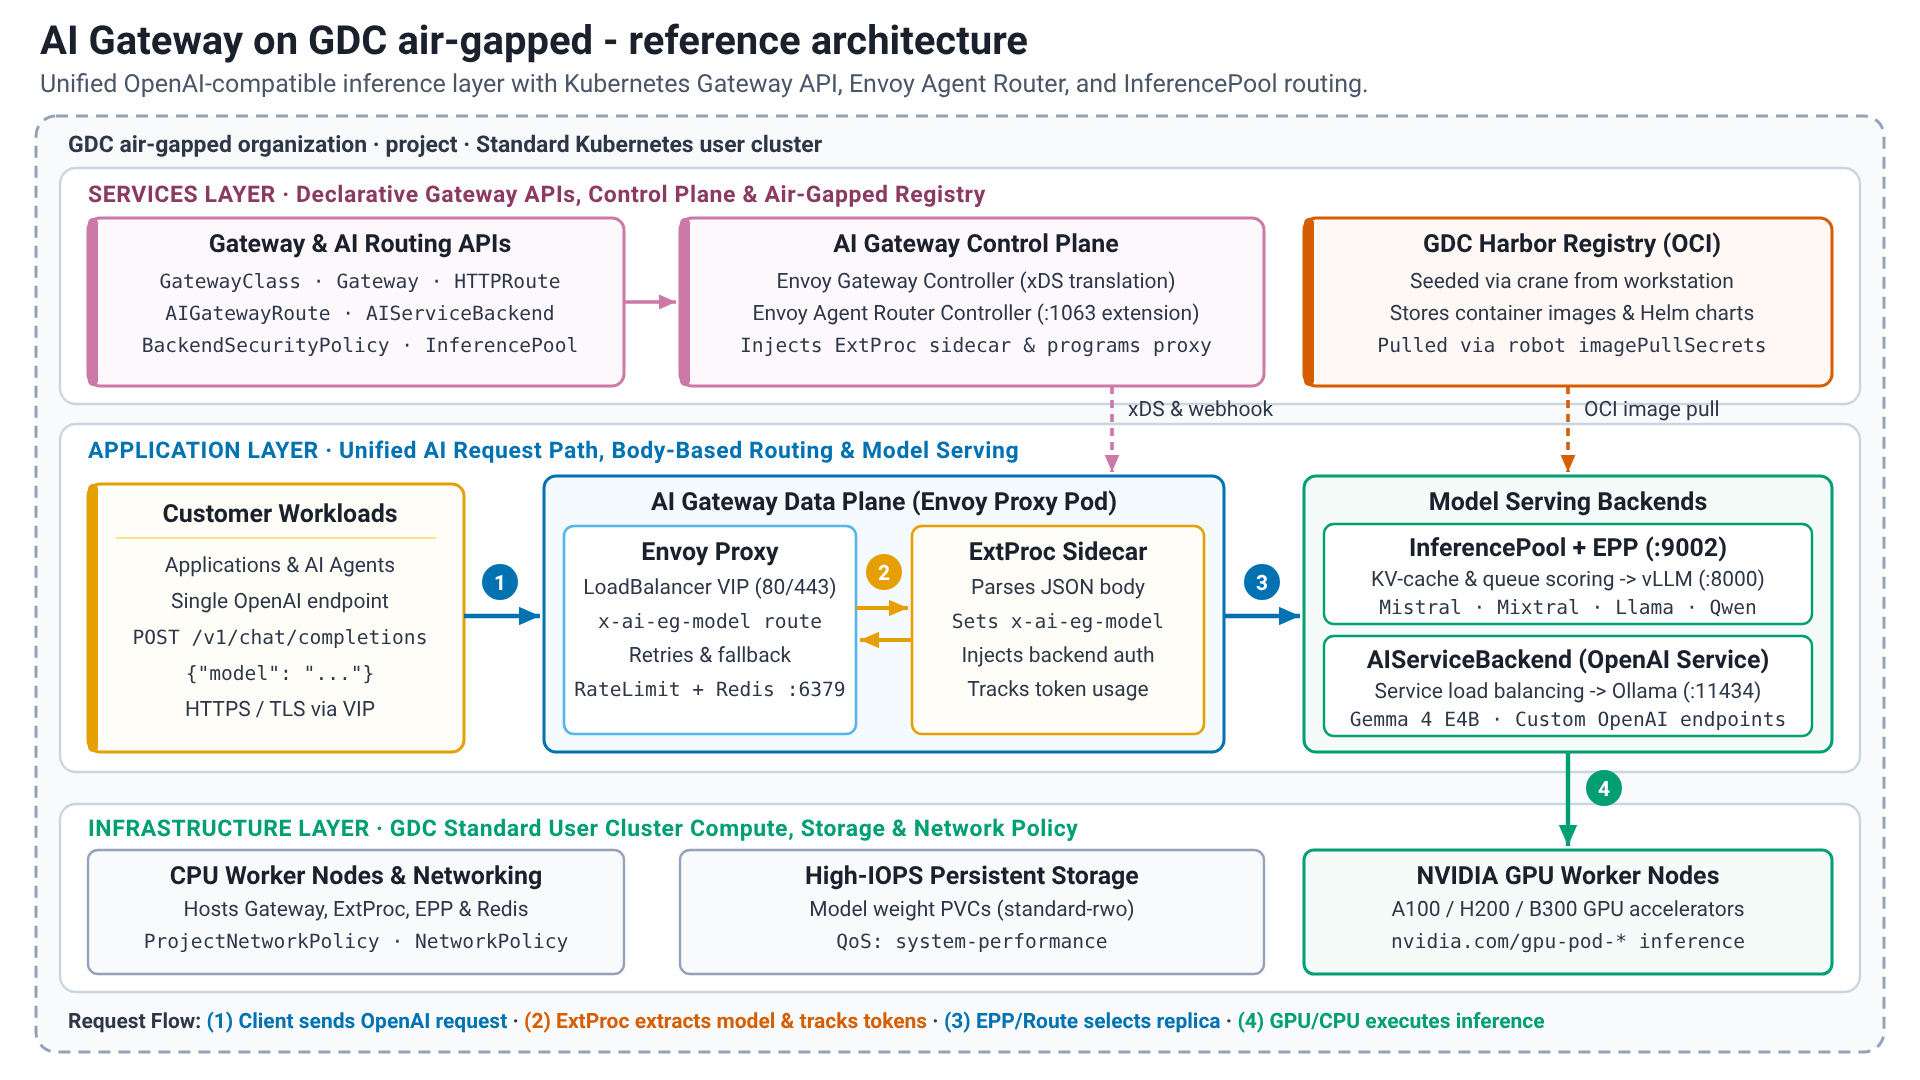
解决方案组件
此解决方案使用以下组件:
| 解决方案组件 | 需求管理代表的职责 | 数据流 | 接口 |
|---|---|---|---|
| Kubernetes Gateway API | 面向 Ingress 和路由的标准、基于角色的资源模型:GatewayClass(由平台所有)、Gateway(监听器、TLS)和路由资源(由应用团队所有)。不含特定于供应商的注释的 Ingress API 的后继版本。 |
仅限声明式配置;资源由控制器监控,不承载任何请求流量。 | Kubernetes API (gateway.networking.k8s.io/v1);CRD 是从 Envoy Gateway CRD 图表中安装的。 |
| Envoy Gateway 控制器(控制平面) | 实现 Gateway API:为每个 Gateway 提供一个 Envoy 代理 Deployment 和 LoadBalancer Service,将路由和政策(BackendTrafficPolicy、SecurityPolicy、EnvoyExtensionPolicy、Backend、EnvoyProxy)转换为 xDS 配置,在配置时运行全局速率限制服务,并通过其扩展管理器调用 Envoy 代理路由器扩展服务器,以便将 InferencePool 后端添加到转换中。 |
监控 Kubernetes API 并将 xDS 配置推送到代理;没有请求流量。 | Kubernetes API(监听)、面向代理的 xDS gRPC、面向扩展服务器的 gRPC(端口 1063)。 |
| Envoy 代理路由器控制器(控制平面) | 将 aigateway.envoyproxy.io/v1beta1 资源、AIGatewayRoute(提取的模型名称的路由规则)、AIServiceBackend(具有 API 架构的后端)、BackendSecurityPolicy(上游凭据)和 GatewayConfig(每个 Gateway 的外部处理器设置)协调到 Envoy Gateway 资源中,将外部处理器边车注入到 Envoy 代理 Pod 中,并提供 Envoy Gateway 使用的扩展服务器。 |
仅限配置。 | Kubernetes API、gRPC 扩展服务器(端口 1063)、用于 Sidecar 注入的变异准入 Webhook。 |
| Envoy 代理(数据平面) | 请求入口点:终止 TLS、匹配监听器和路由、在后端端点之间进行负载均衡、强制执行速率限制和超时、重试并回退到替代后端,以及发出访问日志和指标。 | 在 LoadBalancer VIP (80/443) 上接收客户端请求,针对每个 AI 请求咨询外部处理器,将请求转发到所选的后端端点(由端点选择器选择的 Service 或 Pod),并将响应流式传输回客户端。 |
面向客户端的 HTTP/HTTPS(与 OpenAI 兼容的 API)、面向边车和端点选择器的 ext_proc gRPC、面向后端的 HTTP、面向速率限制服务的 gRPC。 |
| Envoy 代理路由器外部处理器 (ExtProc) | 解析 OpenAI 兼容的请求正文,将 model 字段提取到路由标头 x-ai-eg-model 中,应用模型名称替换,在客户端 API schema 和后端 API schema 之间转换请求和响应载荷,注入由 BackendSecurityPolicy 定义的上游凭据,并从响应中提取令牌使用情况(输入、输出、总计)到用于基于令牌的速率限制和指标的动态元数据中。 |
Envoy 代理中的边车容器 Pod;处理请求和响应正文,包括流式响应。 |
Envoy ext_proc gRPC;Prometheus 指标端点。 |
| Gateway API 推理扩展程序(InferencePool + 端点选择器) | InferencePool (inference.networking.k8s.io/v1) 将一个模型服务器部署的 Pod(标签选择器、目标端口,例如 8000)分组,并引用其端点选择器 (EPP)。InferenceObjective (v1alpha2) 可为每个模型或目标分配优先级。EPP 会抓取模型服务器指标(请求队列深度、KV 缓存利用率、已加载的 LoRA 适配器),并为每个请求选择端点。 |
代理使用请求标头调用 EPP(ext_proc,端口 9002);EPP 使用要使用的端点进行回答;代理将请求转发到该 Pod。 |
Kubernetes API (CRD)、gRPC ext_proc (9002)、模型服务器的 Prometheus 抓取。 |
| Redis(可选) | Envoy 速率限制服务的后备存储区:所有代理副本中基于请求和基于令牌的限制的共享计数器。仅在配置了全局速率限制时需要。 | 速率限制服务会读取并递增端口 6379 上的计数器,以记录每个受限请求。 | Redis 协议 (6379)。部署在集群中的 Redis 8.10 或现有 Redis 实例。 |
| 模型部署后端 (Ollama / vLLM) | 在网关后部署开放权重模型;使用配套指南“在 GDC 空气隔离环境中部署开放权重模型”进行部署。以 AIServiceBackend(任何兼容 OpenAI 的 Service,例如 Ollama)或 InferencePool(模型服务器,例如 vLLM,可公开端点选择器评分所依据的指标)的形式附加。 |
从代理接收路由的请求,在 GPU 节点上运行推理(或在 CPU 上运行推理以使用小型模型进行功能评估),并返回与 OpenAI 兼容的响应。 | 与 OpenAI 兼容的 REST API:端口 8000 上的 vLLM、端口 11434 上的 Ollama;端点选择器的 Prometheus 指标 (vLLM)。 |
| Harbor | 存储解决方案的容器映像(Envoy 代理、Envoy 网关、Envoy 代理路由器控制器和外部处理器、速率限制服务、端点选择器、Redis)和 Helm 图表 (OCI 工件)。 | 制品通过 seed_registry.sh (crane) 从具有互联网访问权限的工作站复制到 Harbor 中;集群通过映像拉取密钥和机器人账号拉取映像,并通过 helm template 从 Harbor 渲染图表。 |
OCI Distribution API;Harbor 界面和机器人账号。 |
| Standard 集群和 GPU 节点 | 托管所有网关组件(CPU 节点就足够了)和推理 Pod(从节点发现加速器资源的 GPU 节点)。提供 LoadBalancer VIP、模型权重的永久性存储空间和网络政策执行。 |
基础平台;请求通过 Gateway 的 LoadBalancer VIP 进入,并保留在集群网络内。 |
Kubernetes API、GDC 网络 API(networking.gdc.goog/v1 ProjectNetworkPolicy)、GDC 控制台和 gdcloud(适用于平台管理员)。 |
特性和功能
此参考架构提供以下核心功能:
- 统一的 OpenAI 兼容端点:应用针对网关后端的每个模型调用一个地址(
/v1/chat/completions、/v1/models等)。- 组件:
Gateway、AIGatewayRoute、Envoy 代理、外部处理器。 - 职责:公开稳定的虚拟 IP、终止 TLS、接受 OpenAI 兼容的请求格式,并在需要时将其转换为后端架构。
- 接口:HTTPS REST(JSON,包括用于流式传输的服务器发送事件)。
- 组件:
- 基于正文(模型感知)的路由:网关读取请求正文的
model字段,并将请求路由到匹配的后端,而无需任何客户端端点逻辑。- 组件:外部处理器,
AIGatewayRoute规则匹配(基于x-ai-eg-model、AIServiceBackend、InferencePool)。 - 职责:提取模型名称、匹配路由规则、重命名模型 (
modelNameOverride)、按权重拆分流量以及按优先级回退到替代后端。 - 接口:Kubernetes API (
aigateway.envoyproxy.io/v1beta1)。
- 组件:外部处理器,
- 模型服务器感知负载均衡:系统会将对
InferencePool的请求发送到队列最短且 KV 缓存最有用的副本,而不是以轮循方式发送。- 组件:Gateway API 推理扩展程序(
InferencePool、InferenceObjective、端点选择器)。 - 职责:抓取模型服务器指标、对端点(队列深度、KV 缓存利用率、前缀缓存亲和性、LoRA 适配器)进行评分、在负载下遵守每个目标的优先级。
- 接口:Kubernetes API(
inference.networking.k8s.io/v1、inference.networking.x-k8s.io/v1alpha2)、ext_proc gRPC (9002)。
- 组件:Gateway API 推理扩展程序(
- 上游身份验证和安全政策:需要凭据的后端的凭据由网关注入,绝不会分发给应用。
- 组件:
BackendSecurityPolicy、Envoy GatewaySecurityPolicy、TLS 监听器。 - 职责:向后端注入 API 密钥,在
Gateway处终止客户端 TLS,并在需要时强制执行客户端身份验证和授权政策。 - 接口:政策引用的 Kubernetes
Secret。
- 组件:
- 基于令牌的速率限制(可选):使用量以令牌数衡量,而不仅仅是请求数。
- 组件:外部处理器 (
llmRequestCosts)、Envoy GatewayBackendTrafficPolicy(全局速率限制)、速率限制服务、Redis。 - 职责:从每个响应中提取输入、输出和总 token 数,将其作为请求费用附加,并在所有代理副本中强制执行每个消费者或每个模型的预算。
- 接口:Kubernetes API、Redis (6379)。
- 组件:外部处理器 (
- 流量管理:标准 Gateway API 功能适用于 AI 流量。
- 组件:
Gateway、HTTPRoute、AIGatewayRoute、BackendTrafficPolicy。 - 职责:基于主机、路径和标头的匹配、适合长时间生成的超时、重试、加权流量拆分以及基于优先级的后端回退。
- 接口:Kubernetes API。
- 组件:
- 可观测性:所有模型均提供请求、延迟时间和令牌指标。
- 组件:Envoy 代理访问日志和统计信息、外部处理器指标(令牌使用情况、请求时长、首次获取令牌的时间)、Endpoint Picker 指标。
- 职责:公开 GDC 可观测性堆栈或客户管理的 Prometheus 可以抓取的 Prometheus 格式的指标和结构化访问日志。
- 接口:Prometheus 指标端点、标准输出日志。
- 气隙制品管理:所有映像和图表在安装前都会在 Harbor 中暂存。
- 组件:Harbor、
seed_registry.sh、机器人账号、映像拉取密钥、EnvoyProxy资源(代理映像和拉取密钥)。 - 职责:从已连接的工作站播种映像和 OCI Helm 图表,固定版本,使用
helm template离线呈现图表。 - 接口:OCI Distribution API、Kubernetes API。
- 组件:Harbor、
架构原则
- 标准优先:网关通过 Kubernetes Gateway API 及其推理扩展程序进行配置,并向应用发出与 OpenAI 兼容的 API,因此应用、路由和后端在不同网关实现方案之间保持可移植性。
- 安全至上:所有组件和数据都位于 GDC 网闸隔离配置边界内。TLS 在
Gateway处终止,后端凭据由网关注入,并且网络访问权限受到NetworkPolicy和ProjectNetworkPolicy对象的限制。 - 数据主权:提示、回答、模型权重和使用情况数据绝不会离开客户的 GDC 组织;运行无需外部连接。
- 关注点分离:面向角色的 Gateway API 可让平台管理员拥有
GatewayClass、Gateway、TLS 和网络政策,而应用团队则可在自己的命名空间中拥有AIGatewayRoute、AIServiceBackend和InferencePool资源。 - 解耦的控制平面和数据平面:控制器仅转换配置;请求路径由 Envoy 代理、其外部处理器边车和端点选择器组成,即使控制器重新启动,它们也会继续提供流量。
- 开放且灵活:该架构在整个过程中使用开源软件(Envoy Gateway、Envoy Agent Router、Gateway API 推理扩展程序、Ollama、vLLM),并且相同的 Gateway API 资源可由替代实现方案提供。
- 可伸缩性和性能:数据平面通过添加代理副本进行横向扩缩,并通过调整 CPU 和内存进行纵向扩缩;感知模型服务器的负载均衡可使 GPU 保持饱和状态,而不会使单个副本过载。
- 简化的最终用户体验:每个模型都使用一个端点、一种 API 格式和一个凭据,缩短了从模型部署到使用的时间。
- 弹性:Kubernetes 健康检查和复制、Envoy 重试以及后端之间基于优先级的回退,可在单个模型副本失败时保持端点可用。
注意事项
- 可伸缩性和性能:
- 网关组件是仅使用 CPU 的工作负载;
Gateway的 Envoy 代理Deployment通过增加其副本数量(EnvoyProxy资源)进行横向扩缩,并通过提高 CPU 和内存请求进行纵向扩缩。外部处理器执行正文检查时,所消耗的 CPU 与请求和响应的大小成正比;系统会以增量方式处理流式响应。 - 模型服务器感知型负载均衡仅适用于作为
InferencePool附加的后端;作为AIServiceBackend附加的后端由代理在其Service的各个端点之间进行负载均衡。 - 网关不会增加 GPU 容量:吞吐量和延迟时间受模型服务器的限制。使用配套指南集(vLLM 用于高吞吐量,Ollama 用于易用性和仅限 CPU 的评估)调整模型部署的大小。
- 与典型的 HTTP API 相比,长时间生成需要更长的请求和空闲超时时间;请在路由和政策上配置这些超时时间,而不是在客户端上配置。
- 网关组件是仅使用 CPU 的工作负载;
- 资源管理:
- 所有网关组件都在 CPU 节点上运行,不需要加速器;下表给出了功能部署的指示性大小。参考实现设置了确切的请求和限制;生产值取决于请求速率和载荷大小。
- 下表列出了网络政策必须允许的所有端口。
- GPU 规划属于模型部署:加速器资源名称是从节点中发现的,如配套指南集中所述。
网关组件的指示性大小调整(仅限 CPU)
| 组件 | 副本 | CPU(请求) | 内存(请求) | 备注 |
|---|---|---|---|---|
| Envoy Gateway 控制器 | 1 | 100 米到 500 米 | 256Mi–1Gi | 控制平面;不在请求路径中 |
| Envoy 代理路由器控制器 | 1 | 100 米到 500 米 | 256Mi–512Mi | 控制平面和扩展服务器 |
Envoy 代理 Pod(代理 + 外部处理器边车) |
每Gateway 1-2 次 |
500 米 - 2 | 512Mi–2Gi | 根据请求速率和载荷大小进行扩缩 |
| 端点选择器 | 每 InferencePool 1 次 |
100 米到 500 米 | 256Mi–512Mi | 抓取模型服务器指标 |
| 速率限制服务(可选) | 1 | 100 米到 500 米 | 256Mi–512Mi | 仅限使用全局速率限制 |
| Redis(可选) | 1 | 100 米到 500 米 | 256Mi–1Gi | 仅限使用全局速率限制 |
网络端口
| 端口 | 组件 | 用途 |
|---|---|---|
| 80 / 443 | Envoy 代理(Gateway 监听器) |
LoadBalancer VIP 上的 HTTP / HTTPS 入口点 |
| 1063 | Envoy 代理路由器控制器(扩展服务器) | 来自 Envoy Gateway 扩展程序管理器的 gRPC 调用 |
| 9002 | 端点选择器 | 来自 Envoy 代理的 ext_proc gRPC 调用 |
| 6379 | Redis | 速率限制计数器 |
| 8000 | vLLM | 模型服务器的 OpenAI 兼容 API 和指标 |
| 11434 | Ollama | 模型服务器的 Ollama 和 OpenAI 兼容型 API |
- 可用性和可靠性:
- 代理和外部处理器在同一
Pod中运行;LoadBalancerService后面的多个副本可屏蔽单个Pod故障,并且控制器可以重新启动,而不会中断流量。 AIGatewayRoute规则可以列出多个具有优先级的后端,以便在某个后端不健康时,网关可以回退到另一个副本集或模型服务器。- 端点选择器是每个池的
Deployment;如果它不可用,则对相应InferencePool的请求会失败,直到它恢复正常为止。使用资源请求和就绪状态探测高效运转,并像数据平面组件一样对其进行监控。 - Redis 仅保存速率限制计数器;Redis 服务中断会影响速率限制,但不会影响路由。
- 代理和外部处理器在同一
- 运营复杂性:
- Envoy Gateway、Envoy Agent Router 和 Gateway API 推理扩展程序之间的版本对齐:将这三者一起升级到经过测试的组合版本(Envoy Gateway 1.8.4、Envoy Agent Router 1.1.0、Gateway API 推理扩展程序 1.5.0)。
- 隔网生命周期:每次升级时,所有映像和图表都会重新植入到 Harbor 中;
EnvoyProxy资源和图表值会固定注册表和拉取密钥。 - 两个配置层:平台拥有的
GatewayClass/Gateway/EnvoyProxy和团队拥有的AIGatewayRoute/AIServiceBackend/InferencePool;添加新模型意味着添加路由规则和后端,而不是新网关。 - 监控:请求速率、延迟时间(包括首次令牌生成时间)、每个模型和每个消费者的令牌使用情况、Endpoint Picker 得分以及模型服务器的 GPU 利用率。
InferenceObjective仍为 Alpha 版 API (v1alpha2);预计推理扩展程序在不同版本之间会发生架构变更。
- 安全与合规性:
- 整个解决方案在 GDC 的气隙安全边界内运行。
- 网络政策是强制性的:命名空间
NetworkPolicy允许从代理到模型服务器端口(8000、11434)和端点选择器 (9002) 的流量,而ProjectNetworkPolicy允许客户端流量到达LoadBalancerVIP(当消费者位于项目外部时)。 - TLS 在
Gateway处终止,并使用存储在 KubernetesSecret中的证书;客户端始终只能看到网关端点。 - 上游凭据(例如模型服务器所需的 API 密钥)存储在
Secret中,由BackendSecurityPolicy引用并由网关注入,因此应用永远不会持有后端凭据。 - 基于令牌的速率限制可限制每个消费者或每个模型对昂贵 GPU 容量的消耗。
- Harbor 机器人账号和 Kubernetes 映像拉取 Secret 可确保对容器映像的安全访问;面向角色的 Gateway API RBAC 可分离平台和应用责任。
设计决策
此参考架构做出了以下关键设计决策:
决策 1:AI 网关实现:基于 Envoy 网关的开源 Envoy 代理路由器与替代分发版
| 上下文 | 关键决策 | 理由 |
|---|---|---|
| AI 网关是主要架构选择,还有一些可行的替代方案,从自行管理的开源选项到商业支持的产品:(a) Envoy Gateway 上的 Envoy 代理路由器(开源);(b) kgateway 和 agentgateway(开源 Gateway API 实现,还可以在一个数据平面中处理 LLM 提供商流量、MCP 工具和智能体到智能体的通信,可选择从 solo.io 获得供应商支持);(c) Solo Enterprise for agentgateway,作为商业支持的优质选项。 | 参考实现使用 Envoy Gateway 上的开源 Envoy 代理路由器。替代方案仍然是有效的选择,它们位于同一 Gateway API 资源后面;对于需要专属供应商支持的生产环境,建议使用商业支持的发行版。 | 开源优势:轻量级且符合标准、高性能 L7 路由、无许可费用,非常适合在承诺购买付费产品之前评估解决方案;Envoy 代理路由器是本指南集中验证的选项。开源缺点:支持由解决方案团队尽最大努力提供,并由社区驱动,可能无法满足核心生产环境的需求。高级优势:网关生命周期的企业支持协议,以及通常提供的高级智能体功能。Premium 版的缺点:需要付费许可或支持协议,以及额外的供应商关系。 |
决策 2:Kubernetes Gateway API(含推理扩展程序)与 Ingress 或专有网关 API
| 上下文 | 关键决策 | 理由 |
|---|---|---|
| 推理端点可以通过旧版 Ingress API、特定于网关的配置格式或 Kubernetes Gateway API 公开。模型感知型负载均衡还需要一种方法来描述模型服务器池及其优先级。 | 该解决方案基于 Envoy Gateway 实现的 Kubernetes Gateway API(GatewayClass、Gateway、路由)和用于实现模型感知路由的 Gateway API 推断扩展程序(InferencePool、InferenceObjective、端点选择器)进行标准化。 |
Gateway API 是 Kubernetes 标准,可取代 Ingress,以角色为导向(平台团队与应用团队),并且可在不同实现方案之间移植。推理扩展是模型服务器感知路由(队列深度、KV 缓存、优先级)的社区标准,Envoy 代理路由器开箱即支持该扩展;替代网关分发版本实现了相同的 API,这使得决策 1 可逆。 |
决策 3:将基于正文的路由应用于 OpenAI 兼容请求的 model 字段,作为统一端点
| 上下文 | 关键决策 | 理由 |
|---|---|---|
应用可以通过以下方式寻址模型:每个模型一个端点(基于主机或路径)、由客户端设置的自定义标头,或者每个 OpenAI 兼容请求已携带的 model 字段。 |
网关公开一个与 OpenAI 兼容的端点,并在 model 字段上进行路由:外部处理器将其提取到 x-ai-eg-model 标头中,AIGatewayRoute 规则与该标头匹配。 |
现有的 OpenAI 兼容客户端和 SDK 可正常运行,只需更改一个字符串即可切换模型;端点、凭据和模型放置位置可以更改,而无需修改应用;同一规则可以将模型名称映射到多个后端,以实现流量拆分、回退或模型名称替换。 |
决策 4:将经过网闸隔离的制品植入到 Harbor 中与按需拉取制品
| 上下文 | 关键决策 | 理由 |
|---|---|---|
| 上游安装会根据需要从公共注册表和 Helm 图表中拉取容器映像作为 OCI 制品,这在气隙环境中是不可能的。 | 所有容器映像(Envoy 代理、Envoy Gateway、Envoy 代理路由器控制器和外部处理器、速率限制服务、端点选择器、Redis)以及 Envoy Gateway 和 Envoy 代理路由器 Helm 图表都植入到具有 seed_registry.sh (crane) 的 Harbor 项目中,图表通过 helm template 从 Harbor 离线呈现,并且 EnvoyProxy 资源和图表值会固定 Harbor 注册表和拉取密钥。 |
每个版本都有一个可重复且可审核的初始配置步骤;集群永远不需要外部连接;版本固定使升级变得明确且可逆。 |
决策 5:使用 Redis 实现基于令牌的可选速率限制与仅使用基于请求的限制
| 上下文 | 关键决策 | 理由 |
|---|---|---|
| GPU 容量是按令牌消耗的,而不是按请求消耗的;请求数限制无法保护共享模型免受少量超大提示或长时间生成内容的消耗。Envoy Gateway 中的全局速率限制需要共享计数器存储区。 | 基于令牌的速率限制是架构的一项可选功能:外部处理器记录每个请求的输入、输出和总令牌数 (llmRequestCosts),BackendTrafficPolicy 强制执行预算,Redis 实例(部署在集群中或现有实例中的 Redis 8.10)存储计数器。未进行速率限制的部署不需要 Redis。 |
使用量以反映费用的单位来衡量,预算在所有代理副本中保持一致,并且只有需要配额的客户才需要支付依赖项的费用。 |
决策 6:拓扑:网关控制和数据平面位于标准集群的专用命名空间中,模型位于应用命名空间中
| 上下文 | 关键决策 | 理由 |
|---|---|---|
| 网关可以在专用集群中运行,也可以在每个应用命名空间中运行,还可以在每个标准集群中运行一次,紧邻其所代理的模型。GDC 气隙环境中的开放权重模型部署在标准集群中(配套指南集)。 | Envoy Gateway 和 Envoy 代理路由器控制平面以及 Envoy 代理数据平面在托管模型的标准集群的专用命名空间中运行;AIGatewayRoute、AIServiceBackend、InferencePool 和模型部署位于应用命名空间中,并在命名空间之间引用。 |
请求在代理和模型 Pod 之间保持在集群网络内(延迟时间最短,无需额外的负载均衡器),平台管理员拥有网关命名空间,而应用团队拥有其路由和模型,并且端点选择器可以直接抓取模型服务器。每个项目的客户端网关(转发到中央服务器网关)仍然是此拓扑的扩展,可用于多项目使用。 |
假设和限制
- GDC 网闸隔离配置 1.16.2-hf1 或更高版本环境适用于运行 Kubernetes v1.32.13-gke.400 或更高版本的标准集群。
- 模型服务后端具有足够的硬件资源(尤其是 GPU);网关组件本身在 CPU 节点上运行。真实模型需要 GPU;Ollama 上的小型模型只能在 CPU 上运行,以进行功能评估。
- Harbor 实例已设置并可访问,并且工作站可访问互联网并连接到 GDC 环境(Harbor 和 Kubernetes API),可用于播种映像和图表。
- 用户拥有必要的权限:项目角色“Harbor 实例查看者”和“标准集群管理员”,以及标准集群上集群范围安装(CRD、
GatewayClass、命名空间)的cluster-admin角色,请参阅参考实现。StandardClusterRoleBinding - 模型部署后端会公开与 OpenAI 兼容的 API;作为
InferencePool附加的后端还会公开端点选择器所依赖的与 vLLM 兼容的指标。 - 限制:解决方案团队会尽最大努力提供对开源组件(Envoy Gateway、Envoy Agent Router、Gateway API Inference Extension)的支持;如需获得专门的供应商支持,则需要使用商业支持的发行版(决策 1)。
- 限制:
InferenceObjective是 Alpha 版 API (inference.networking.x-k8s.io/v1alpha2),可能会在推理扩展程序的各个版本之间发生变化。 - 限制:对于项目外部的使用方,需要为
Gateway和ProjectNetworkPolicy提供LoadBalancerVIP;对于项目内部的使用方,集群内客户端或kubectl port-forward可以直接访问网关Service。 - 限制:在此版本的解决方案中,GDC 上的 Gemini、模型微调、非 LLM 生成式 AI 模型和多节点模型部署不在支持范围内。
用户流
以下是 GDC 网闸隔离配置中 AI 网关的完整用户流程:首先是应用开发者依赖的请求路径,然后是平台管理员遵循的设置路径。
1. 开发者请求路径
应用或代理只需要网关端点、客户端凭据(如果网关强制要求)和模型名称。
- 发送请求:应用使用 OpenAI 兼容的 JSON 正文(其中包含模型名称,例如
"model": "gemma")在网关端点上调用POST /v1/chat/completions,就像调用任何 OpenAI 兼容的服务一样。 - 进入网关:请求到达
Gateway的LoadBalancerVIP;Envoy 代理终止 TLS 并匹配监听器和路由。 - 处理正文:代理将请求交给 Envoy 代理路由器外部处理器,该处理器会解析正文,将模型名称提取到
x-ai-eg-model标头中,并在有效载荷与后端架构不同时将其转换为后端架构。 - 选择后端:与模型名称匹配的
AIGatewayRoute规则会选择AIServiceBackend(例如 OllamaService)或InferencePool(例如 vLLM 副本集);对于InferencePool,端点选择器会选择队列最短且 KV 缓存匹配度最高的副本。 - 转发和响应:当
BackendSecurityPolicy应用时,代理会注入上游凭据,将请求转发到所选的Pod,将响应流式传输回来,并允许外部处理器记录令牌使用情况,从而提供指标,并在配置时提供基于令牌的速率限制。 - 切换模型:如需使用其他模型,开发者只需更改
model字符串,无需使用新的端点、凭据或客户端库。
2. 平台管理员设置路径
- 将制品植入 Harbor:创建 Harbor 机器人账号,然后使用
seed_registry.sh从具有互联网访问权限的工作站将容器映像以及 Envoy Gateway 和 Envoy 代理路由器 Helm 图表复制到 Harbor。 - 安装 Envoy Gateway:使用
helm template从 Harbor 渲染 CRD 和控制器图表,并在网关命名空间中应用它们;创建用于固定代理映像和拉取密钥的EnvoyProxy资源,并通过基本的GatewayClass、Gateway和HTTPRoute验证控制器。 - 安装 Envoy 代理路由器:安装 Envoy 代理路由器 CRD 和 Gateway API 推理扩展 CRD,部署 Envoy 代理路由器控制器,并重新配置 Envoy 网关以调用其扩展服务器(端口 1063)并接受
InferencePool后端;可以选择部署 Redis 并启用全局速率限制服务。 - 公开网关:创建具有 HTTP 和 HTTPS 监听器 (TLS 证书
Secret) 的GatewayClass和Gateway,等待LoadBalancerVIP,并为项目外部的消费者应用ProjectNetworkPolicy。 - 附加模型:使用配套指南集部署模型服务后端,然后为兼容 OpenAI 的
Service和InferencePool创建AIServiceBackend资源,并为兼容 vLLM 的副本集创建端点选择器资源,同时创建命名空间NetworkPolicy对象。 - 发布路由:创建
AIGatewayRoute,其中包含每个模型名称(基于正文的路由)的一条规则,以及上游凭据和令牌预算所需的BackendSecurityPolicy和BackendTrafficPolicy对象。 - 验证和运行:通过 VIP(或
kubectl port-forward后备)调用/v1/models和/v1/chat/completions,检查代理、外部处理器和端点选择器指标,并将端点和模型名称交给应用团队。独立扩缩代理副本和模型部署;同时升级 Envoy Gateway、Envoy Agent Router 和推理扩展程序。
详细步骤请参阅 Envoy 代理路由器参考实现和基于正文的路由(使用 Envoy 代理路由器)用户指南。
其他资料
- Envoy 代理路由器参考实现
- Envoy 代理路由器用户指南中的基于正文的路由
- 开放权重 LLM 参考架构
- Envoy Agent Router 文档
- Envoy Gateway
- Kubernetes Gateway API
- Gateway API Inference Extension
- Google Distributed Cloud 网闸隔离配置文档