


טעינת נתונים מ-Amazon S3 ל-BigQuery
אתם יכולים לטעון נתונים מ-Amazon S3 ל-BigQuery באמצעות המחבר של שירות העברת הנתונים ל-BigQuery ב-Amazon S3. בעזרת שירות העברת הנתונים ל-BigQuery, אתם יכולים לתזמן משימות העברה חוזרות שמוסיפות את הנתונים העדכניים מ-Amazon S3 ל-BigQuery.
מידע על אופן הפעולה של העברה מ-Amazon S3 זמין במאמר מבוא להעברת נתונים מ-Amazon S3.
מגבלות
העברות נתונים מ-Amazon S3 כפופות למגבלות הבאות:
- אי אפשר להגדיר פרמטרים לחלק של ה-URI שמתייחס לדלי ב-Amazon S3.
- בהעברות נתונים מ-Amazon S3, אם הפרמטר Write disposition מוגדר לערך
WRITE_TRUNCATE, כל הקבצים התואמים יועברו אל Google Cloudבכל הפעלה. יכול להיות שזה יגרום לעלויות נוספות של העברת נתונים יוצאים ב-Amazon S3. למידע נוסף על הקבצים שמועברים במהלך הפעלה, ראו ההשפעה של התאמת תחילית לעומת התאמת תו כללי לחיפוש. - העברות נתונים מאזורי AWS GovCloud (
us-gov) לא נתמכות. - אי אפשר להעביר נתונים למיקומים של BigQuery Omni.
יכול להיות שיהיו מגבלות נוספות, בהתאם לפורמט של נתוני המקור ב-Amazon S3. מידע נוסף זמין במקורות המידע הבאים:
מרווח הזמן המינימלי בין העברות נתונים חוזרות הוא שעה אחת. מרווח הזמן שמוגדר כברירת מחדל להעברת נתונים חוזרת הוא 24 שעות.
העברות הנתונים מ-Amazon S3 נתמכות באותן מגבלות אזוריות של Amazon S3 כמו Storage Transfer Service. מידע נוסף זמין במאמר בנושא אזורים נתמכים.
לפני שמתחילים
לפני שיוצרים העברת נתונים מ-Amazon S3:
- מוודאים שביצעתם את כל הפעולות שנדרשות כדי להפעיל את שירות העברת נתונים ל-BigQuery.
- יוצרים מערך נתונים ב-BigQuery כדי לאחסן את הנתונים.
- יוצרים את טבלת היעד להעברת הנתונים ומציינים את הגדרת הסכימה. טבלת היעד צריכה לעמוד בכללים למתן שמות לטבלאות. אפשר להשתמש בפרמטרים גם בשמות של טבלאות היעד. אתם יכולים ליצור טבלה ב-BigQuery או ליצור טבלה מנוהלת ב-Iceberg.
- מאחזרים את ה-URI של Amazon S3, את המזהה של מפתח הגישה ואת מפתח הגישה הסודי. מידע על ניהול מפתחות הגישה זמין במסמכי AWS.
- אם אתם מתכוונים להגדיר התראות על הפעלת העברות ב-Pub/Sub, אתם צריכים את ההרשאות של
pubsub.topics.setIamPolicy. אם אתם מגדירים רק התראות באימייל, אתם לא צריכים הרשאות Pub/Sub. למידע נוסף, קראו את המאמר התראות על הפעלות של שירות העברת הנתונים ל-BigQuery. - אם אתם מתכננים לציין מפתח הצפנה בניהול הלקוח (CMEK), ודאו שלחשבון השירות שלכם יש הרשאות להצפנה ולפענוח, ושיש לכם את מזהה משאב המפתח של Cloud KMS שנדרש לשימוש ב-CMEK. במאמר ציון מפתח הצפנה בהעברות מוסבר איך CMEK פועל עם שירות העברת הנתונים ל-BigQuery.
ההרשאות הנדרשות
צריך לוודא שהענקתם את ההרשאות הבאות.
התפקידים הנדרשים ב-BigQuery
כדי לקבל את ההרשאות שדרושות ליצירת העברת נתונים באמצעות שירות העברת הנתונים ל-BigQuery, בקשו מהאדמין להקצות לכם את התפקיד אדמין ב-BigQuery (roles/bigquery.admin) ב-IAM בפרויקט.
כדי לקרוא הסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
התפקיד המוגדר מראש הזה כולל את ההרשאות שנדרשות כדי ליצור העברת נתונים בשירות העברת הנתונים ל-BigQuery. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי ליצור העברת נתונים באמצעות שירות העברת הנתונים ל-BigQuery, נדרשות ההרשאות הבאות:
-
הרשאות של שירות העברת נתונים ל-BigQuery:
-
bigquery.transfers.update -
bigquery.transfers.get
-
-
הרשאות ב-BigQuery:
-
bigquery.datasets.get -
bigquery.datasets.getIamPolicy -
bigquery.datasets.update -
bigquery.datasets.setIamPolicy -
bigquery.jobs.create
-
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
מידע נוסף מופיע במאמר בנושא מתן גישה ל-bigquery.admin.
התפקידים הנדרשים ב-Amazon S3
כדי לוודא שהגדרתם את כל ההרשאות שנדרשות להעברת הנתונים, עיינו במסמכי התיעוד של Amazon S3. לכל הפחות, צריך להחיל על נתוני המקור של Amazon S3 את המדיניות המנוהלת של AWS, AmazonS3ReadOnlyAccess.
הגדרת העברת נתונים מ-Amazon S3
כדי ליצור העברת נתונים מ-Amazon S3:
המסוף
נכנסים לדף Data transfers במסוף Google Cloud .
לוחצים על Create transfer.
בדף Create Transfer:
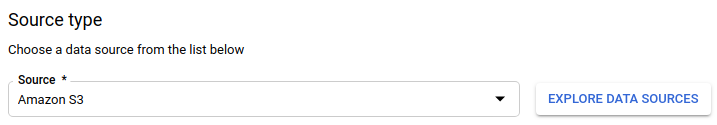
בקטע סוג המקור, בוחרים באפשרות Amazon S3 בשדה מקור.
בקטע Transfer config name, בשדה השם המוצג מזינים שם להעברה, למשל
My Transfer. השם של ההעברה יכול להיות כל ערך שיעזור לכם לזהות את ההעברה אם תצטרכו לשנות אותה בהמשך.
בקטע אפשרויות תזמון:
בוחרים תדירות חזרה. אם בוחרים באפשרות שעות, ימים, שבועות או חודשים, צריך לציין גם תדירות. אפשר גם לבחור באפשרות בהתאמה אישית כדי ליצור תדירות חזרה ספציפית יותר. אם בוחרים באפשרות על פי דרישה, העברת הנתונים הזו מתבצעת רק כשמפעילים את ההעברה באופן ידני.
אם רלוונטי, בוחרים באפשרות Start now או באפשרות Start at set time, ומציינים תאריך התחלה וזמן ריצה.
בקטע הגדרות היעד:
- בקטע Dataset, בוחרים את מערך הנתונים שיצרתם כדי לאחסן את הנתונים.
- בוחרים באפשרות Native table (טבלה מקורית) אם רוצים להעביר לטבלה ב-BigQuery.
- בוחרים באפשרות Iceberg Managed (טבלה מנוהלת בפורמט Iceberg) אם רוצים להעביר לטבלה מנוהלת בפורמט Iceberg.
- בקטע Dataset, בוחרים את מערך הנתונים שיצרתם כדי לאחסן את הנתונים.
בקטע פרטי מקור הנתונים:
- בשדה טבלת יעד, מזינים את שם הטבלה שיצרתם כדי לאחסן את הנתונים ב-BigQuery. שמות של טבלאות ביעד תומכים בפרמטרים.
- בשדה Amazon S3 URI, מזינים את ה-URI בפורמט
s3://mybucket/myfolder/.... מזהי URI תומכים גם בפרמטרים. - בשדה Access key ID (מזהה מפתח הגישה), מזינים את מזהה מפתח הגישה.
- בשדה Secret access key, מזינים את מפתח הגישה הסודי.
- בקטע פורמט קובץ בוחרים את פורמט הנתונים (JSON עם תווי שורה, CSV, Avro, Parquet או ORC).
- בקטע Write Disposition (הגדרת סילוק), בוחרים באחת מהאפשרויות הבאות:
-
WRITE_APPENDכדי להוסיף נתונים חדשים לטבלת היעד הקיימת. WRITE_APPENDהוא ערך ברירת המחדל של העדפת הכתיבה. -
WRITE_TRUNCATEכדי להחליף את הנתונים בטבלת היעד בכל הפעלה של העברת נתונים.
-
במאמר הטמעת נתונים להעברות מ-Amazon S3 תוכלו לקרוא איך שירות העברת הנתונים ל-BigQuery מטמיע נתונים באמצעות
WRITE_APPENDאוWRITE_TRUNCATE. מידע נוסף על השדהwriteDispositionזמין במאמרJobConfigurationLoad.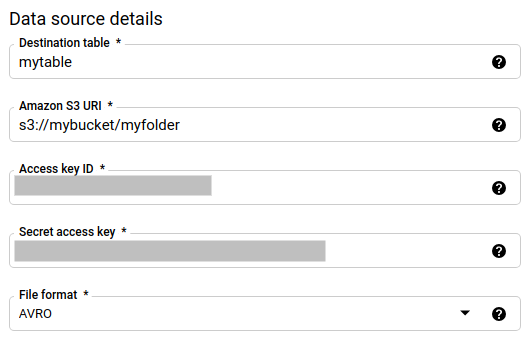
בקטע אפשרויות העברה – כל הפורמטים:
- בקטע מספר השגיאות המותר, מזינים ערך של מספר שלם למספר המקסימלי של רשומות פגומות שאפשר להתעלם מהן.
- (אופציונלי) בשביל סוגי יעדים עשרוניים, מזינים רשימה מופרדת בפסיקים של סוגי נתונים אפשריים של SQL שאפשר להמיר אליהם את הערכים העשרוניים של המקור. סוג הנתונים של ה-SQL שנבחר להמרה תלוי בתנאים הבאים:
- סוג הנתונים שנבחר להמרה יהיה סוג הנתונים הראשון ברשימה הבאה שתומך בדיוק ובקנה המידה של נתוני המקור, לפי הסדר הזה: NUMERIC, BIGNUMERIC ו-STRING.
- אם אף אחד מסוגי הנתונים שברשימה לא תומך בדיוק ובקנה המידה, נבחר סוג הנתונים שתומך בטווח הרחב ביותר ברשימה שצוינה. אם ערך חורג מהטווח הנתמך במהלך קריאת נתוני המקור, תוצג שגיאה.
- סוג הנתונים STRING תומך בכל ערכי הדיוק והקנה מידה.
- אם השדה הזה נשאר ריק, סוג הנתונים יהיה כברירת מחדל "NUMERIC,STRING" ל-ORC, ו-"NUMERIC" לפורמטים האחרים של הקבצים.
- השדה הזה לא יכול להכיל סוגי נתונים כפולים.
- המערכת מתעלמת מהסדר של סוגי הנתונים שאתם מפרטים בשדה הזה.
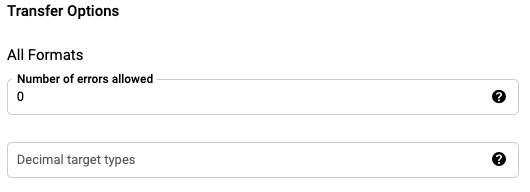
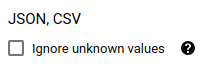
אם בחרתם בפורמט קובץ CSV או JSON, בקטע JSON,CSV מסמנים את האפשרות Ignore unknown values כדי לקבל שורות שמכילות ערכים שלא תואמים לסכימה. המערכת מתעלמת מערכים לא ידועים. בקובצי CSV, האפשרות הזו מתעלמת מערכים נוספים בסוף השורה.
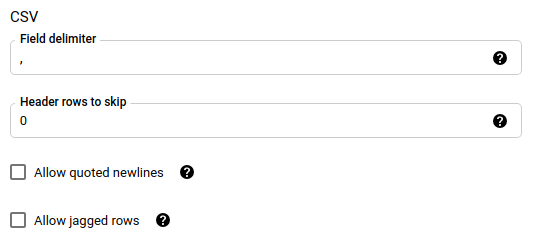
אם בחרתם בפורמט קובץ CSV, בקטע CSV מזינים אפשרויות CSV נוספות לטעינת נתונים.
בתפריט Service Account, בוחרים חשבון שירות מבין חשבונות השירות שמשויכים לפרויקט ב-Google Cloud . אתם יכולים לשייך חשבון שירות להעברת הנתונים במקום להשתמש בפרטי הכניסה של המשתמש. מידע נוסף על שימוש בחשבונות שירות בהעברות נתונים זמין במאמר שימוש בחשבונות שירות.
- אם נכנסתם באמצעות זהות מאוחדת, תצטרכו חשבון שירות כדי ליצור העברת נתונים. אם נכנסתם באמצעות חשבון Google, אתם לא חייבים להשתמש בחשבון שירות כדי לבצע העברת נתונים.
- לחשבון השירות צריכות להיות ההרשאות הנדרשות.
אם אתם משתמשים בCMEK, בקטע Advanced options (אפשרויות מתקדמות) בוחרים באפשרות Customer-managed key (מפתח בניהול הלקוח). תוצג רשימה של מפתחות CMEK זמינים לבחירה.
(אופציונלי) בקטע Notification options:
לוחצים על Save.
BQ
מזינים את הפקודה bq mk ומציינים את הדגל ליצירת העברה – --transfer_config.
bq mk \
--transfer_config \
--project_id=project_id \
--data_source=data_source \
--display_name=name \
--target_dataset=dataset \
--service_account_name=service_account \
--destination_kms_key=destination_key \
--params='parameters'
כאשר:
- project_id: אופציונלי. מזהה הפרויקט ב- Google Cloud .
אם לא מציינים את
--project_idכדי לציין פרויקט מסוים, המערכת משתמשת בפרויקט ברירת המחדל. - data_source: שדה חובה. מקור הנתונים –
amazon_s3. - display_name: שדה חובה. השם המוצג של הגדרת העברת הנתונים. שם ההעברה יכול להיות כל ערך שמאפשר לכם לזהות את ההעברה אם תצטרכו לשנות אותה בהמשך.
- dataset: שדה חובה. מערך הנתונים של היעד להגדרת העברת הנתונים.
- service_account: השם של חשבון השירות שמשמש לאימות של העברת הנתונים. חשבון השירות צריך להיות בבעלות אותו
project_idששימש ליצירת העברת הנתונים, וצריכות להיות לו כל ההרשאות הנדרשות. - destination_key: אופציונלי. מזהה המשאב של מפתח Cloud KMS – לדוגמה,
projects/project_name/locations/us/keyRings/key_ring_name/cryptoKeys/key_name. parameters: שדה חובה. הפרמטרים של הגדרת ההעברה שנוצרה בפורמט JSON. לדוגמה:
--params='{"param":"param_value"}'. אלה הפרמטרים להעברה מ-Amazon S3:- destination_table_name_template: שדה חובה. השם של טבלת היעד.
data_path: שדה חובה. ה-URI של Amazon S3, בפורמט הבא:
s3://mybucket/myfolder/...מזהי URI תומכים גם בפרמטרים.
access_key_id: שדה חובה. מזהה מפתח הגישה.
secret_access_key: שדה חובה. מפתח הגישה הסודי שלכם.
file_format: אופציונלי. מציין את סוג הקבצים שרוצים להעביר:
CSV,JSON,AVRO,PARQUETאוORC. ערך ברירת המחדל הואCSV.write_disposition: אופציונלי.
WRITE_APPENDיעביר רק את הקבצים ששונו מאז ההפעלה הקודמת המוצלחת.WRITE_TRUNCATEתעביר את כל הקבצים התואמים, כולל קבצים שהועברו בהפעלה קודמת. ערך ברירת המחדל הואWRITE_APPEND.max_bad_records: אופציונלי. מספר הרשומות הפגומות המותר. ערך ברירת המחדל הוא
0.decimal_target_types: אופציונלי. רשימה מופרדת בפסיקים של סוגי נתונים אפשריים ב-SQL שאליהם אפשר להמיר את הערכים העשרוניים של המקור. אם לא מציינים את השדה הזה, סוג הנתונים שמוגדר כברירת מחדל הוא NUMERIC,STRING ל-ORC, ו-NUMERIC לפורמטים האחרים של הקבצים.
ignore_unknown_values: אופציונלי, ומתעלמים ממנו אם file_format הוא לא
JSONאוCSV. אם להתעלם מערכים לא ידועים בנתונים.field_delimiter: אופציונלי, ורלוונטי רק כשהערך של
file_formatהואCSV. התו שמפריד בין השדות. ערך ברירת המחדל הוא פסיק.skip_leading_rows: אופציונלי, ורלוונטי רק כשהערך של file_format הוא
CSV. מציין את מספר שורות הכותרת שאתם לא רוצים לייבא. ערך ברירת המחדל הוא0.allow_quoted_newlines (לא חובה): חל רק אם הערך של file_format הוא
CSV. מציין אם לאפשר שורות חדשות בשדות במירכאות.allow_jagged_rows: אופציונלי, ורלוונטי רק כשהערך של file_format הוא
CSV. מציין אם לקבל שורות שחסרות בהן עמודות אופציונליות בסוף. הערכים החסרים ימולאו בערכי NULL.
לדוגמה, הפקודה הבאה יוצרת העברת נתונים של Amazon S3 בשם My Transfer באמצעות ערך data_path של s3://mybucket/myfile/*.csv, קבוצת נתונים של יעד mydataset ו-file_format
CSV. הדוגמה הזו כוללת ערכים שאינם ברירת מחדל לפרמטרים האופציונליים שמשויכים לפורמט הקובץ CSV.
העברת הנתונים נוצרת בפרויקט ברירת המחדל:
bq mk --transfer_config \
--target_dataset=mydataset \
--display_name='My Transfer' \
--params='{"data_path":"s3://mybucket/myfile/*.csv",
"destination_table_name_template":"MyTable",
"file_format":"CSV",
"write_disposition":"WRITE_APPEND",
"max_bad_records":"1",
"ignore_unknown_values":"true",
"field_delimiter":"|",
"skip_leading_rows":"1",
"allow_quoted_newlines":"true",
"allow_jagged_rows":"false"}' \
--data_source=amazon_s3
אחרי הרצת הפקודה, תתקבל הודעה כמו זו:
[URL omitted] Please copy and paste the above URL into your web browser and
follow the instructions to retrieve an authentication code.
פועלים לפי ההוראות ומדביקים את קוד האימות בשורת הפקודה.
API
משתמשים ב-method projects.locations.transferConfigs.create ומספקים מופע של המשאב TransferConfig.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
ההשפעה של התאמת תחילית לעומת התאמה של תווים כלליים לחיפוש
Amazon S3 API תומך בהתאמה של קידומות, אבל לא בהתאמה של תווים כלליים לחיפוש. כל הקבצים ב-Amazon S3 שתואמים לקידומת יועברו אל Google Cloud. עם זאת, רק נתונים שתואמים ל-URI של Amazon S3 בהגדרת ההעברה ייטענו בפועל ל-BigQuery. התוצאה יכולה להיות עלויות גבוהות מדי של העברת נתונים יוצאים מ-Amazon S3 עבור קבצים שמועברים אבל לא נטענים ל-BigQuery.
לדוגמה, נניח שיש לנו את נתיב הנתונים הבא:
s3://bucket/folder/*/subfolder/*.csv
בנוסף לקבצים האלה במיקום המקור:
s3://bucket/folder/any/subfolder/file1.csv
s3://bucket/folder/file2.csv
כתוצאה מכך, כל הקבצים ב-Amazon S3 עם הקידומת s3://bucket/folder/ יועברו אל Google Cloud. בדוגמה הזו, גם file1.csv וגם file2.csv יועברו.
עם זאת, רק קבצים שתואמים ל-s3://bucket/folder/*/subfolder/*.csv ייטענו בפועל ב-BigQuery. בדוגמה הזו, רק file1.csv ייטען ל-BigQuery.
ציון מפתח הצפנה בהעברות
אתם יכולים לציין מפתחות הצפנה בניהול הלקוח (CMEK) כדי להצפין נתונים להרצת העברה. אתם יכולים להשתמש ב-CMEK כדי לתמוך בהעברות מ-Amazon Simple Storage Service (Amazon S3).כשמציינים CMEK בהעברה, שירות העברת הנתונים ל-BigQuery מחיל את ה-CMEK על כל מטמון ביניים בדיסק של נתונים שהועברו, כך שכל תהליך העבודה של העברת הנתונים תואם ל-CMEK.
אי אפשר לעדכן העברה קיימת כדי להוסיף CMEK אם ההעברה לא נוצרה במקור עם CMEK. לדוגמה, אי אפשר לשנות טבלת יעד שהייתה מוצפנת כברירת מחדל כך שהיא תוצפן עכשיו באמצעות CMEK. באופן דומה, אי אפשר לשנות את סוג ההצפנה של טבלת יעד שמוצפנת באמצעות CMEK.
אפשר לעדכן את ה-CMEK של העברה אם הגדרות ההעברה נוצרו במקור עם הצפנת CMEK. כשמעדכנים את ה-CMEK בהגדרות של העברה, שירות העברת הנתונים ל-BigQuery מעביר את ה-CMEK לטבלאות היעד בהפעלה הבאה של ההעברה. במהלך ההפעלה, שירות העברת הנתונים ל-BigQuery מחליף את כל ה-CMEK שהתיישנו ב-CMEK החדש. מידע נוסף זמין במאמר בנושא עדכון העברה.
אפשר גם להשתמש במפתחות ברירת המחדל של הפרויקט. כשמציינים מפתח ברירת מחדל לפרויקט בהעברה, שירות העברת הנתונים ל-BigQuery משתמש במפתח ברירת המחדל של הפרויקט כמפתח ברירת המחדל לכל הגדרות ההעברה החדשות.
פתרון בעיות בהגדרת ההעברה
אם נתקלתם בבעיות בהגדרת העברת הנתונים, כדאי לעיין במאמר בעיות בהעברה מ-Amazon S3.
המאמרים הבאים
- סקירה כללית של שירות העברת נתונים ל-BigQuery זמינה במאמר מבוא לשירות העברת נתונים ל-BigQuery.
- במאמר עבודה עם העברות מוסבר איך משתמשים בהעברות נתונים, כולל איך מקבלים מידע על הגדרות העברה, איך מציגים רשימה של הגדרות העברה ואיך מציגים את היסטוריית ההרצה של העברה.
- איך טוענים נתונים באמצעות פעולות של BigQuery Omni