


טעינת נתוני CSV מ-Cloud Storage
ב-BigQuery אפשר לטעון נתוני CSV מ-Cloud Storage לטבלה או למחיצה חדשה, או להוסיף אותם לטבלה או למחיצה קיימת או להחליף אותה. במהלך הטמעת הנתונים, BigQuery ממיר את הנתונים לפורמט עמודות של Capacitor (פורמט האחסון של BigQuery) לצורך שאילתות וניתוח.
למידע על טעינת נתוני CSV מקובץ מקומי, ראו טעינת נתונים ל-BigQuery ממקור נתונים מקומי.
נסו בעצמכם
אנחנו ממליצים למשתמשים חדשים ב-Google Cloud ליצור חשבון כדי שיוכלו להעריך את הביצועים של BigQuery בתרחישים מהעולם האמיתי. לקוחות חדשים מקבלים בחינם גם קרדיט בשווי 300 $להרצה, לבדיקה ולפריסה של עומסי העבודה.
לניסיון חינם של BigQueryמגבלות
כשאתם טוענים נתונים ל-BigQuery מקטגוריה של Cloud Storage, אתם כפופים למגבלות הבאות:
- ב-BigQuery אין הבטחה לעקביות של נתונים ממקורות חיצוניים. שינויים בנתוני הבסיס בזמן ששאילתה פועלת עלולים לגרום להתנהגות לא צפויה.
- ב-BigQuery אין תמיכה בניהול גרסאות של אובייקטים ב-Cloud Storage. אם תכללו מספר דור ב-URI של Cloud Storage, משימת הטעינה תיכשל.
כשאתם טוענים קובצי CSV ל-BigQuery, שימו לב לנקודות הבאות:
- קובצי CSV לא תומכים בנתונים בתצוגת עץ או בנתונים חוזרים.
- מסירים תווים של סימון סדר בתים (BOM). הם עלולים לגרום לבעיות לא צפויות.
- אם אתם משתמשים בדחיסת gzip, BigQuery לא יכול לקרוא את הנתונים במקביל. טעינת נתוני CSV דחוסים ל-BigQuery איטית יותר מטעינת נתונים לא דחוסים. מידע נוסף זמין במאמר טעינת נתונים דחוסים ולא דחוסים.
- אי אפשר לכלול קבצים דחוסים וקבצים לא דחוסים באותה משימת טעינה.
- הגודל המקסימלי של קובץ gzip הוא 4GB.
- כשאתם טוענים נתוני CSV באמצעות זיהוי אוטומטי של סכימה, המערכת לא מזהה כותרות באופן אוטומטי אם כל העמודות הן מסוג מחרוזת. במקרה כזה, צריך להוסיף עמודה מספרית לקלט או להצהיר על הסכימה באופן מפורש.
- כשאתם טוענים נתוני CSV או JSON, הערכים בעמודות
DATEחייבים להשתמש במקף (-) כמפריד, והתאריך חייב להיות בפורמט הבא:YYYY-MM-DD(שנה-חודש-יום). - כשאתם טוענים נתוני JSON או CSV, הערכים בעמודות
TIMESTAMPחייבים להשתמש במקף (-) או בלוכסן (/) כמפריד בחלק של התאריך בחותמת הזמן, והתאריך חייב להיות באחד מהפורמטים הבאים:YYYY-MM-DD(שנה-חודש-יום) אוYYYY/MM/DD(שנה/חודש/יום). בחלק שלhh:mm:ss(שעה-דקה-שנייה) בחותמת הזמן צריך להשתמש בנקודתיים (:) כמפריד. - הקבצים צריכים לעמוד במגבלות הגודל של קובצי CSV, כפי שמתואר במגבלות על משימות טעינה.
לפני שמתחילים
מקצים תפקידים של ניהול זהויות והרשאות גישה (IAM) שנותנים למשתמשים את ההרשאות שדרושות כדי לבצע כל משימה במסמך הזה, ויוצרים מערך נתונים לאחסון הנתונים.
ההרשאות הנדרשות
כדי לטעון נתונים ל-BigQuery, אתם צריכים הרשאות IAM להרצת משימת טעינה ולטעינת נתונים לטבלאות ב-BigQuery ולמחיצות. אם אתם טוענים נתונים מ-Cloud Storage, אתם צריכים גם הרשאות IAM כדי לגשת לקטגוריה שמכילה את הנתונים.
הרשאות לטעינת נתונים ל-BigQuery
כדי לטעון נתונים לטבלה או למחיצה חדשה ב-BigQuery, או כדי להוסיף או להחליף טבלה או מחיצה קיימת, צריך את הרשאות ה-IAM הבאות:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
כל אחד מהתפקידים הבאים שמוגדרים מראש ב-IAM כולל את ההרשאות שצריך כדי לטעון נתונים לטבלה או למחיצה ב-BigQuery:
roles/bigquery.dataEditorroles/bigquery.dataOwner-
roles/bigquery.admin(כולל את ההרשאהbigquery.jobs.create) -
bigquery.user(כולל את ההרשאהbigquery.jobs.create) -
bigquery.jobUser(כולל את ההרשאהbigquery.jobs.create)
בנוסף, אם יש לכם את ההרשאה bigquery.datasets.create, אתם יכולים ליצור ולעדכן טבלאות באמצעות משימת טעינה בקבוצות הנתונים שאתם יוצרים.
למידע נוסף על תפקידים והרשאות של IAM ב-BigQuery, קראו את המאמר תפקידים והרשאות מוגדרים מראש.
הרשאות לטעינת נתונים מ-Cloud Storage
כדי לקבל את ההרשאות שנדרשות לטעינת נתונים מקטגוריה של Cloud Storage, בקשו מהאדמין לתת לכם את התפקיד אדמין של אחסון (roles/storage.admin) ב-IAM בקטגוריה.
כדי לקרוא הסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
זהו תפקיד שמוגדר מראש וכולל את ההרשאות שנדרשות לטעינת נתונים מקטגוריה של Cloud Storage. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי לטעון נתונים מקטגוריה של Cloud Storage, נדרשות ההרשאות הבאות:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
יצירת קבוצת נתונים
יוצרים מערך נתונים ב-BigQuery כדי לאחסן את הנתונים.
דחיסת CSV
אפשר להשתמש בכלי gzip כדי לדחוס קובצי CSV. שימו לב ש-gzip מבצע דחיסת קבצים מלאה, בניגוד לדחיסת תוכן הקובץ שמבוצעת על ידי רכיבי codec של דחיסה לפורמטים אחרים של קבצים, כמו Avro. אם תשתמשו ב-gzip כדי לדחוס את קובצי ה-CSV, יכול להיות שתהיה לכך השפעה על הביצועים. למידע נוסף על היתרונות והחסרונות, קראו את המאמר טעינת נתונים דחוסים ולא דחוסים.
טעינת נתוני CSV לטבלה
כדי לטעון נתוני CSV מ-Cloud Storage לטבלה חדשה ב-BigQuery, בוחרים אחת מהאפשרויות הבאות:
המסוף
כדי לקבל הדרכה מפורטת לביצוע המשימה הזו ישירות ב-Cloud Shell Editor, לחצו על תראו לי איך:
נכנסים לדף BigQuery במסוף Google Cloud .
- בחלונית הימנית, לוחצים על Explorer.
- בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים מערך נתונים.
- בקטע Dataset info, לוחצים על Create table.
- בחלונית Create table, מציינים את הפרטים הבאים:
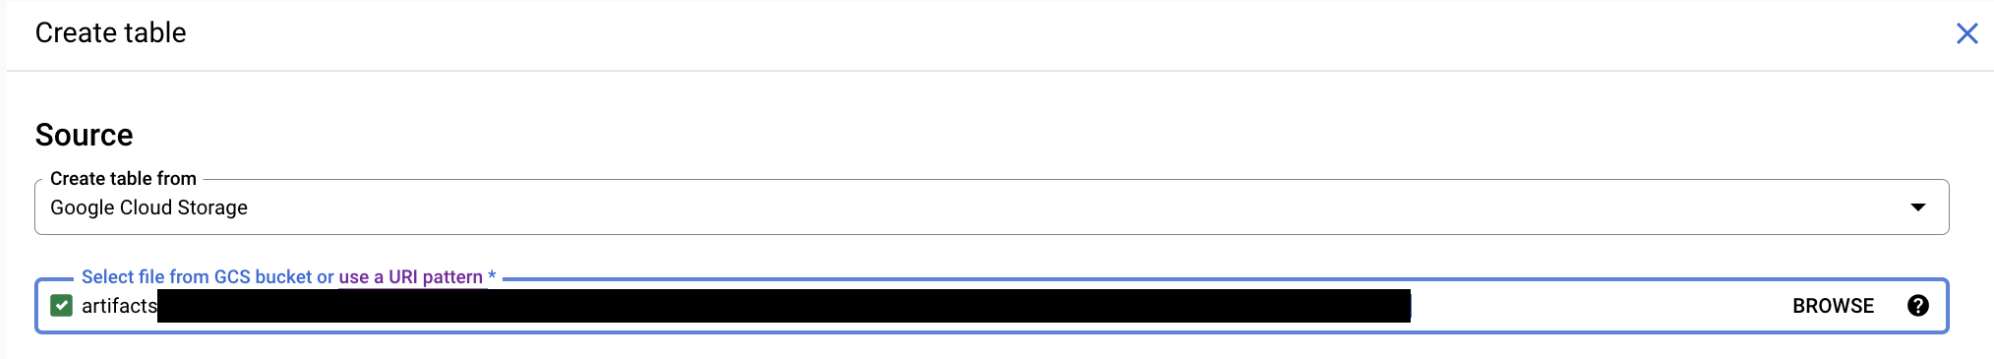
- בקטע Source, בוחרים באפשרות Google Cloud Storage ברשימה Create table from.
לאחר מכן, מבצעים את הפעולות הבאות:
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בשדה פורמט קובץ, בוחרים באפשרות CSV.
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בקטע Destination, מציינים את הפרטים הבאים:
- בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table, מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהשדה Table type מוגדר ל-Native table.
- בקטע Schema, מזינים את הגדרת הסכימה.
כדי להפעיל זיהוי אוטומטי של סכימה, בוחרים באפשרות Auto detect.
אפשר להזין את פרטי הסכימה באופן ידני באחת מהשיטות הבאות:
- אפשרות 1: לוחצים על Edit as text ומדביקים את הסכימה בצורה של מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שמשמש ליצירת קובץ סכימה של JSON.
כדי להציג את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
bq show --format=prettyjson dataset.table
- אפשרות 2: לוחצים על Add field ומזינים את סכימת הטבלה. מציינים את הערכים של השדות Name, Type ו-Mode.
- אפשרות 1: לוחצים על Edit as text ומדביקים את הסכימה בצורה של מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שמשמש ליצירת קובץ סכימה של JSON.
כדי להציג את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
- אופציונלי: מציינים את הגדרות המחיצה והאשכול. מידע נוסף זמין במאמרים יצירת טבלאות מחולקות למחיצות ויצירה של טבלאות מסודרות באשכולות ושימוש בהן.
- לוחצים על אפשרויות מתקדמות ומבצעים את הפעולות הבאות:
- בשדה Write preference, משאירים את האפשרות Write if empty מסומנת. This option creates a new table and loads your data into it.
- בשדה Number of errors allowed, מאשרים את ערך ברירת המחדל
0או מזינים את המספר המקסימלי של שורות עם שגיאות שאפשר להתעלם מהן. אם מספר השורות עם השגיאות חורג מהערך הזה, המשימה תיכשל ותוצג הודעתinvalid. האפשרות הזו רלוונטית רק לקובצי CSV ו-JSON. - בשדה Time zone, מזינים את אזור הזמן שיוגדר כברירת מחדל לניתוח ערכים של חותמות זמן שלא צוין בהם אזור זמן ספציפי. כאן אפשר למצוא שמות תקינים נוספים של אזורי זמן. אם הערך הזה לא קיים, ערכי חותמת הזמן בלי אזור זמן ספציפי מנותחים באמצעות אזור הזמן שמוגדר כברירת מחדל, UTC.
- בשדה Date Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי DATE בקובצי הקלט. השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY). אם הערך הזה קיים, הפורמט הזה הוא הפורמט היחיד שתואם ל-DATE. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATE על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATE מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. - בשדה Datetime Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי DATETIME בקובצי הקלט.
השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של DATETIME. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATETIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATETIME מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - בשדה Time Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי TIME בקובצי הקלט. השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא פורמט TIME התואם היחיד. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIME מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. - בשדה Timestamp Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי TIMESTAMP בקובצי הקלט.
השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של TIMESTAMP. הזיהוי האוטומטי של הסכימה יקבע גם את סוג העמודה TIMESTAMP על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIMESTAMP מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - אם רוצים להתעלם מערכים בשורה שלא קיימים בסכימה של הטבלה, בוחרים באפשרות Unknown values.
- בשדה Field delimiter, בוחרים את התו שמפריד בין התאים בקובץ ה-CSV: Comma, Tab, Pipe או Custom. אם בוחרים באפשרות בהתאמה אישית, מזינים את התו המפריד בתיבה תו מפריד מותאם אישית. ערך ברירת המחדל הוא פסיק.
- בקטע Source column match, בוחרים באחת מהאסטרטגיות הבאות להתאמת העמודות שנטענו לסכימה.
-
Default: פעולת ברירת המחדל נבחרת בהתאם לאופן שבו הסכימה מסופקת. אם הזיהוי האוטומטי מופעל, פעולת ברירת המחדל היא להתאים עמודות לפי שם. אחרת, ברירת המחדל היא להתאים עמודות לפי מיקום. ההגדרה הזו נועדה לשמור על תאימות לדורות קודמים. Position: התאמת עמודות לפי מיקום, בהנחה שהעמודות מסודרות באותו אופן כמו הסכימה.-
Name: התאמה לפי שם על ידי קריאת שורת הכותרת כשמות העמודות ושינוי סדר העמודות כך שיתאימו לשמות השדות בסכימה. שמות העמודות נקראים מהשורה האחרונה שדילגו עליה, בהתאם להגדרה שורות כותרת שצריך לדלג עליהן. - בשדה Header rows to skip, מזינים את מספר שורות הכותרת שרוצים לדלג עליהן בחלק העליון של קובץ ה-CSV. ערך ברירת המחדל הוא
0. - בשדה Quoted newlines, מסמנים את האפשרות Allow quoted newlines כדי לאפשר קטעי נתונים במירכאות שמכילים תווי שורה חדשה בקובץ CSV. ערך ברירת המחדל הוא
false. - בקטע Jagged rows, מסמנים את האפשרות Allow jagged rows כדי לאשר שורות בקובצי CSV שחסרות בהן עמודות אופציונליות בסוף. הערכים החסרים נחשבים לערכי null. אם לא מסמנים את האפשרות הזו, רשומות שחסרות בהן עמודות בסוף נחשבות לרשומות לא תקינות. אם יש יותר מדי רשומות לא תקינות, מוחזרת שגיאה לא חוקית בתוצאת המשימה. ערך ברירת המחדל הוא
false. - בשדה Null markers, מזינים רשימה של מחרוזות בהתאמה אישית שמייצגות ערך NULL בנתוני CSV.
- בקטע Encryption, לוחצים על Customer-managed key כדי להשתמש במפתח של Cloud Key Management Service. אם משאירים את ההגדרה Google-managed key, הנתונים מוצפנים במצב מנוחה ב-BigQuery.
- לוחצים על Create table.
SQL
משתמשים בהצהרת ה-DDL LOAD DATA.
בדוגמה הבאה נטען קובץ CSV לטבלה החדשה mytable:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
LOAD DATA OVERWRITE mydataset.mytable
(x INT64,y STRING)
FROM FILES (
  format = 'CSV',
  uris = ['gs://bucket/path/file.csv']);
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
משתמשים בפקודה bq load, מציינים את CSV באמצעות הדגל --source_format וכוללים URI של Cloud Storage.
אפשר לכלול URI יחיד, רשימה מופרדת בפסיקים של מזהי URI, או URI שמכיל תו כללי לחיפוש.
מציינים את הסכימה בתוך השורה, בקובץ הגדרת סכימה, או משתמשים בזיהוי אוטומטי של סכימה. אם לא מציינים סכימה, הערך של --autodetect הוא false וטבלת היעד קיימת, המערכת משתמשת בסכימה של טבלת היעד.
(אופציונלי) מציינים את הדגל --location ומגדירים את הערך למיקום שלכם.
דגלים אופציונליים נוספים:
-
--allow_jagged_rows: אם מציינים את האפשרות הזו, המערכת מקבלת שורות בקובצי CSV שחסרות בהן עמודות אופציונליות בסוף. הערכים החסרים נחשבים כערכים ריקים. אם לא מסמנים את האפשרות הזו, רשומות שחסרות בהן עמודות נגררות נחשבות לרשומות פגומות. אם יש יותר מדי רשומות פגומות, מוחזרת שגיאה לא חוקית בתוצאת המשימה. ערך ברירת המחדל הואfalse. -
--allow_quoted_newlines: כשמציינים את האפשרות הזו, אפשר להשתמש בקטעי נתונים במירכאות שמכילים תווים של שורה חדשה בקובץ CSV. ערך ברירת המחדל הואfalse. -
--field_delimiter: התו שמציין את הגבול בין העמודות בנתונים. אפשר להשתמש גם ב-\tוגם ב-tabבתור תווי הפרדה של טאבים. ערך ברירת המחדל הוא,. -
--null_marker: מחרוזת אופציונלית בהתאמה אישית שמייצגת ערך NULL בנתוני CSV. -
--null_markers: רשימה אופציונלית מופרדת בפסיקים של מחרוזות בהתאמה אישית שמייצגות ערכי NULL בנתוני CSV. אי אפשר להשתמש באפשרות הזו עם הדגל--null_marker. --source_column_match: מציין את האסטרטגיה שמשמשת להתאמת העמודות שנטענו לסכימה. אפשר לצייןPOSITIONכדי להתאים את העמודות שנטענו לפי מיקום, בהנחה שהעמודות מסודרות באותו אופן כמו הסכימה. אפשר גם לצייןNAMEכדי להתאים לפי שם, על ידי קריאת שורת הכותרת כשמות העמודות ושינוי סדר העמודות כך שיתאימו לשמות השדות בסכימה. אם לא מציינים ערך, ברירת המחדל מבוססת על האופן שבו הסכימה מסופקת. אם מפעילים את--autodetect, פעולת ברירת המחדל היא להתאים עמודות לפי שם. אחרת, ברירת המחדל היא להתאים עמודות לפי מיקום.-
--skip_leading_rows: מציין את מספר שורות הכותרת שצריך לדלג עליהן בחלק העליון של קובץ ה-CSV. ערך ברירת המחדל הוא0. -
--quote: תו המירכאות שבו משתמשים כדי לתחום רשומות. ערך ברירת המחדל הוא". כדי לציין שאין תו מירכאות, משתמשים במחרוזת ריקה. -
--max_bad_records: מספר שלם שמציין את המספר המקסימלי של רשומות לא תקינות שמותרות לפני שהמשימה כולה נכשלת. ערך ברירת המחדל הוא0. מוחזרות לכל היותר חמש שגיאות מכל סוג, בלי קשר לערך של--max_bad_records. -
--ignore_unknown_values: כשמציינים את הפרמטר הזה, המערכת מאפשרת ערכים נוספים לא מזוהים בנתוני CSV או JSON ומתעלמת מהם. -
--time_zone: אזור זמן אופציונלי שמוגדר כברירת מחדל, שיחול כשמנתחים ערכי חותמות זמן שאין להם אזור זמן ספציפי בנתוני CSV או JSON. -
--date_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי DATE בנתוני CSV או JSON. -
--datetime_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי DATETIME בנתוני CSV או JSON. -
--time_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי TIME בנתוני CSV או JSON. -
--timestamp_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי TIMESTAMP בנתוני CSV או JSON. -
--autodetect: כשמציינים את האפשרות הזו, מפעילים זיהוי אוטומטי של סכימה לנתוני CSV ו-JSON. -
--time_partitioning_type: הפעלת חלוקה למחיצות לפי זמן בטבלה והגדרת סוג המחיצה. הערכים האפשריים הםHOUR,DAY,MONTHו-YEAR. הדגל הזה הוא אופציונלי כשיוצרים טבלה שמחולקת למחיצות לפי עמודה מסוגDATE,DATETIMEאוTIMESTAMP. סוג המחיצה שמוגדר כברירת מחדל לחלוקה למחיצות לפי זמן הואDAY. אי אפשר לשנות את מפרט החלוקה למחיצות בטבלה קיימת. -
--time_partitioning_expiration: מספר שלם שמציין (בשניות) מתי צריך למחוק מחיצה שמבוססת על זמן. זמן התפוגה מחושב לפי תאריך ה-UTC של המחיצה בתוספת ערך המספר השלם. -
--time_partitioning_field: העמודהDATEאוTIMESTAMPשמשמשת ליצירת טבלה מחולקת למחיצות. אם מפעילים חלוקה למחיצות לפי זמן בלי הערך הזה, נוצרת טבלה מחולקת למחיצות לפי זמני כתיבת הנתונים. -
--require_partition_filter: כשהאפשרות הזו מופעלת, המשתמשים צריכים לכלול משפטWHEREשמציין את המחיצות שרוצים לשלוח אליהן שאילתות. דרישה למסנן מחיצות יכולה להפחית את העלות ולשפר את הביצועים. מידע נוסף זמין במאמר שליחת שאילתות לטבלאות מחולקות למחיצות. -
--clustering_fields: רשימה מופרדת בפסיקים של עד ארבעה שמות עמודות שמשמשים ליצירת טבלה מסודרת באשכולות. -
--destination_kms_key: המפתח של Cloud KMS להצפנת נתוני הטבלה.
--column_name_character_map: מגדיר את ההיקף והטיפול בתווים בשמות של עמודות, עם אפשרות להפעיל שמות גמישים של עמודות. צריך להשתמש באפשרות--autodetectבקובצי CSV. מידע נוסף זמין במאמרload_option_list.למידע נוסף על הפקודה
bq load:למידע נוסף על טבלאות מחולקות למחיצות:
מידע נוסף על טבלאות מסודרות באשכולות:
מידע נוסף על הצפנת טבלאות זמין במאמרים הבאים:
כדי לטעון נתוני CSV ל-BigQuery, מזינים את הפקודה הבאה:
bq --location=location load \
--source_format=format \
dataset.table \
path_to_source \
schema
כאשר:
- location הוא המיקום שלך. הדגל
--locationהוא אופציונלי. לדוגמה, אם אתם משתמשים ב-BigQuery באזור טוקיו, אתם יכולים להגדיר את הערך של הדגל ל-asia-northeast1. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ bigqueryrc.. - format הוא
CSV. - dataset הוא מערך נתונים קיים.
- table הוא שם הטבלה שאליה טוענים את הנתונים.
- path_to_source הוא URI של Cloud Storage מלא או רשימה מופרדת בפסיקים של מזהי URI. יש גם תמיכה בתווים כלליים לחיפוש.
- schema היא סכימה תקינה. הסכימה יכולה להיות קובץ JSON מקומי, או שאפשר להקליד אותה כחלק מהפקודה. אפשר גם להשתמש בדגל
--autodetectבמקום לספק הגדרת סכימה.
דוגמאות:
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלה בשם mytable ב-mydataset. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.json.
    bq load \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    ./myschema.json
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלה בשם mytable ב-mydataset. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.json. קובץ ה-CSV כולל שתי שורות כותרת.
אם לא מציינים את --skip_leading_rows, פעולת ברירת המחדל היא להניח שהקובץ לא מכיל כותרות.
    bq load \
    --source_format=CSV \
    --skip_leading_rows=2
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    ./myschema.json
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלה מחולקת למחיצות (Partitions) לפי זמני כתיבת הנתונים בשם mytable ב-mydataset. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.json.
    bq load \
    --source_format=CSV \
    --time_partitioning_type=DAY \
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    ./myschema.json
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלה חדשה מחולקת למחיצות בשם mytable ב-mydataset. הטבלה מחולקת למחיצות לפי העמודה mytimestamp. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.json.
    bq load \
    --source_format=CSV \
    --time_partitioning_field mytimestamp \
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    ./myschema.json
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלה בשם mytable ב-mydataset. הסכימה מזוהה באופן אוטומטי.
    bq load \
    --autodetect \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata.csv
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv לטבלה בשם mytable ב-mydataset. הסכימה מוגדרת בתוך השורה בפורמט field:data_type,field:data_type.
    bq load \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    qtr:STRING,sales:FLOAT,year:STRING
הפקודה הבאה טוענת נתונים מכמה קבצים ב-gs://mybucket/ לטבלה בשם mytable ב-mydataset. ה-URI של Cloud Storage כולל תו כללי לחיפוש. הסכימה מזוהה באופן אוטומטי.
    bq load \
    --autodetect \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata*.csv
הפקודה הבאה טוענת נתונים מכמה קבצים ב-gs://mybucket/ לטבלה בשם mytable ב-mydataset. הפקודה כוללת רשימה מופרדת בפסיקים של מזהי URI של Cloud Storage עם תווים כלליים לחיפוש. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.json.
    bq load \
    --source_format=CSV \
    mydataset.mytable \
    "gs://mybucket/00/*.csv","gs://mybucket/01/*.csv" \
    ./myschema.json
API
יוצרים משימת
loadשמפנה לנתוני המקור ב-Cloud Storage.(אופציונלי) מציינים את המיקום במאפיין
locationבקטעjobReferenceשל משאב המשימה.המאפיין
source URIsחייב להיות מלא, בפורמטgs://bucket/object. כל URI יכול להכיל תו כללי לחיפוש אחד, "*".מציינים את פורמט הנתונים של ה-CSV על ידי הגדרת המאפיין
sourceFormatלערךCSV.כדי לבדוק את סטטוס המשימה, מפעילים את
jobs.get(job_id*), כאשר job_id הוא מזהה המשימה שהוחזר בבקשה הראשונית.- אם הערך הוא
status.state = DONE, המשימה הושלמה בהצלחה. - אם המאפיין
status.errorResultקיים, הבקשה נכשלה והאובייקט הזה יכלול מידע שמתאר מה השתבש. אם הבקשה נכשלת, לא נוצרת טבלה ולא נטענים נתונים. - אם
status.errorResultלא מופיע, המשימה הסתיימה בהצלחה, אבל יכול להיות שהיו כמה שגיאות לא קריטיות, כמו בעיות בייבוא של כמה שורות. שגיאות לא קריטיות מופיעות במאפייןstatus.errorsשל אובייקט המשימה שמוחזר.
- אם הערך הוא
הערות לגבי ה-API:
משימות טעינה הן אטומיות ועקביות. אם משימת טעינה נכשלת, אף אחד מהנתונים לא זמין. אם משימת טעינה מצליחה, כל הנתונים זמינים.
מומלץ ליצור מזהה ייחודי ולהעביר אותו בתור
jobReference.jobIdכשקוראים ל-jobs.insertכדי ליצור משימת טעינה. הגישה הזו עמידה יותר בפני כשלים ברשת, כי הלקוח יכול לבצע דגימה או לנסות שוב באמצעות מזהה המשימה הידוע.הקריאה ל-
jobs.insertבמזהה משימה נתון היא אידמפוטנטית. אפשר לנסות שוב כמה פעמים שרוצים עם אותו מזהה משימה, ורק אחת מהפעולות האלה תצליח.
C#
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של C# במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery C# API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
משתמשים ב-method Client.load_table_from_uri() כדי לטעון נתונים מקובץ CSV ב-Cloud Storage. כדי לספק הגדרת סכימה מפורשת, מגדירים את המאפיין LoadJobConfig.schema לרשימה של אובייקטים מסוג SchemaField.
Ruby
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Ruby במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Ruby API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
טעינת נתוני CSV לטבלה שמשתמשת בחלוקה למחיצות לפי זמן על בסיס עמודות
כדי לטעון נתוני CSV מ-Cloud Storage לטבלה ב-BigQuery שמשתמשת בחלוקה לזמן לפי עמודות:
Go
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
הוספה לטבלה או החלפה של טבלה באמצעות נתוני CSV
אפשר לטעון נתונים נוספים לטבלה מקובצי מקור או על ידי הוספת תוצאות של שאילתות.
במסוף Google Cloud , משתמשים באפשרות Write preference כדי לציין איזו פעולה לבצע כשאתם טוענים נתונים מקובץ מקור או מתוצאת שאילתה.
כשאתם טוענים נתונים נוספים לטבלה, יש לכם את האפשרויות הבאות:
| אפשרות המסוף | דגל של הכלי bq | נכס BigQuery API | תיאור |
|---|---|---|---|
| כתיבה אם ריק | לא נתמך | WRITE_EMPTY |
הנתונים נכתבים רק אם הטבלה ריקה. |
| הוספה לטבלה | --noreplace או --replace=false; אם לא צוין --[no]replace, ברירת המחדל היא append |
WRITE_APPEND |
(ברירת המחדל) הוספת הנתונים לסוף הטבלה. |
| החלפת הטבלה | --replace או --replace=true |
WRITE_TRUNCATE |
מוחק את כל הנתונים הקיימים בטבלה לפני כתיבת הנתונים החדשים. הפעולה הזו גם מוחקת את סכימת הטבלה, את האבטחה ברמת השורה ואת כל מפתחות Cloud KMS. |
אם אתם טוענים נתונים לטבלה קיימת, משימת הטעינה יכולה להוסיף את הנתונים או להחליף את הטבלה.
המסוף
נכנסים לדף BigQuery במסוף Google Cloud .
- בחלונית הימנית, לוחצים על Explorer.
- בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים מערך נתונים.
- בקטע Dataset info, לוחצים על Create table.
- בחלונית Create table, מציינים את הפרטים הבאים:
- בקטע Source, בוחרים באפשרות Google Cloud Storage ברשימה Create table from.
לאחר מכן, מבצעים את הפעולות הבאות:
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בשדה פורמט קובץ, בוחרים באפשרות CSV.
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בקטע Destination, מציינים את הפרטים הבאים:
- בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table, מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהשדה Table type מוגדר ל-Native table.
- בקטע Schema, מזינים את הגדרת הסכימה.
כדי להפעיל זיהוי אוטומטי של סכימה, בוחרים באפשרות Auto detect.
אפשר להזין את פרטי הסכימה באופן ידני באחת מהשיטות הבאות:
- אפשרות 1: לוחצים על Edit as text ומדביקים את הסכימה בצורה של מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שמשמש ליצירת קובץ סכימה של JSON.
כדי להציג את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
bq show --format=prettyjson dataset.table
- אפשרות 2: לוחצים על Add field ומזינים את סכימת הטבלה. מציינים את הערכים של השדות Name, Type ו-Mode.
- אפשרות 1: לוחצים על Edit as text ומדביקים את הסכימה בצורה של מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שמשמש ליצירת קובץ סכימה של JSON.
כדי להציג את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
- אופציונלי: מציינים את הגדרות המחיצה והאשכול. מידע נוסף זמין במאמרים יצירת טבלאות מחולקות למחיצות ויצירה של טבלאות מסודרות באשכולות ושימוש בהן. אי אפשר להמיר טבלה לטבלה מחולקת למחיצות או לטבלה מסודרת באשכולות על ידי הוספה או החלפה שלה. במסוף Google Cloud אי אפשר להוסיף נתונים לטבלאות מחולקות למחיצות או לטבלאות מסודרות באשכולות, או להחליף אותן, במסגרת משימת טעינה.
- לוחצים על אפשרויות מתקדמות ומבצעים את הפעולות הבאות:
- בקטע Write preference, בוחרים באפשרות Append to table או Overwrite table.
- בשדה Number of errors allowed, מאשרים את ערך ברירת המחדל
0או מזינים את המספר המקסימלי של שורות עם שגיאות שאפשר להתעלם מהן. אם מספר השורות עם השגיאות חורג מהערך הזה, המשימה תיכשל ותוצג הודעתinvalid. האפשרות הזו רלוונטית רק לקובצי CSV ו-JSON. - בשדה Time zone, מזינים את אזור הזמן שיוגדר כברירת מחדל לניתוח ערכים של חותמות זמן שלא צוין בהם אזור זמן ספציפי. כאן אפשר למצוא שמות תקינים נוספים של אזורי זמן. אם הערך הזה לא קיים, ערכי חותמת הזמן בלי אזור זמן ספציפי מנותחים באמצעות אזור הזמן שמוגדר כברירת מחדל, UTC.
- בשדה Date Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי DATE בקובצי הקלט. השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY). אם הערך הזה קיים, הפורמט הזה הוא הפורמט היחיד שתואם ל-DATE. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATE על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATE מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. - בשדה Datetime Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי DATETIME בקובצי הקלט.
השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של DATETIME. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATETIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATETIME מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - בשדה Time Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי TIME בקובצי הקלט. השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא פורמט TIME התואם היחיד. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIME מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. - בשדה Timestamp Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי TIMESTAMP בקובצי הקלט.
השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של TIMESTAMP. הזיהוי האוטומטי של הסכימה יקבע גם את סוג העמודה TIMESTAMP על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIMESTAMP מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - אם רוצים להתעלם מערכים בשורה שלא קיימים בסכימה של הטבלה, בוחרים באפשרות Unknown values.
- בשדה Field delimiter, בוחרים את התו שמפריד בין התאים בקובץ ה-CSV: Comma, Tab, Pipe או Custom. אם בוחרים באפשרות בהתאמה אישית, מזינים את התו המפריד בתיבה תו מפריד מותאם אישית. ערך ברירת המחדל הוא פסיק.
- בקטע Source column match, בוחרים באחת מהאסטרטגיות הבאות להתאמת העמודות שנטענו לסכימה.
-
Default: פעולת ברירת המחדל נבחרת בהתאם לאופן שבו הסכימה מסופקת. אם הזיהוי האוטומטי מופעל, פעולת ברירת המחדל היא להתאים עמודות לפי שם. אחרת, ברירת המחדל היא להתאים עמודות לפי מיקום. ההגדרה הזו נועדה לשמור על תאימות לדורות קודמים. Position: התאמת עמודות לפי מיקום, בהנחה שהעמודות מסודרות באותו אופן כמו הסכימה.-
Name: התאמה לפי שם על ידי קריאת שורת הכותרת כשמות העמודות ושינוי סדר העמודות כך שיתאימו לשמות השדות בסכימה. שמות העמודות נקראים מהשורה האחרונה שדילגו עליה, בהתאם להגדרה שורות כותרת שצריך לדלג עליהן. - בשדה Header rows to skip, מזינים את מספר שורות הכותרת שרוצים לדלג עליהן בחלק העליון של קובץ ה-CSV. ערך ברירת המחדל הוא
0. - בשדה Quoted newlines, מסמנים את האפשרות Allow quoted newlines כדי לאפשר קטעי נתונים במירכאות שמכילים תווי שורה חדשה בקובץ CSV. ערך ברירת המחדל הוא
false. - בקטע Jagged rows, מסמנים את האפשרות Allow jagged rows כדי לאשר שורות בקובצי CSV שחסרות בהן עמודות אופציונליות בסוף. הערכים החסרים נחשבים לערכי null. אם לא מסמנים את האפשרות הזו, רשומות שחסרות בהן עמודות בסוף נחשבות לרשומות לא תקינות. אם יש יותר מדי רשומות לא תקינות, מוחזרת שגיאה לא חוקית בתוצאת המשימה. ערך ברירת המחדל הוא
false. - בשדה Null markers, מזינים רשימה של מחרוזות בהתאמה אישית שמייצגות ערך NULL בנתוני CSV.
- בקטע Encryption, לוחצים על Customer-managed key כדי להשתמש במפתח של Cloud Key Management Service. אם משאירים את ההגדרה Google-managed key, הנתונים מוצפנים במצב מנוחה ב-BigQuery.
- לוחצים על Create table.
SQL
משתמשים בהצהרת ה-DDL LOAD DATA.
בדוגמה הבאה, קובץ CSV מצורף לטבלה mytable:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
LOAD DATA INTO mydataset.mytable
FROM FILES (
  format = 'CSV',
  uris = ['gs://bucket/path/file.csv']);
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
משתמשים בפקודה bq load, מציינים את CSV באמצעות הדגל --source_format וכוללים URI של Cloud Storage.
אפשר לכלול URI יחיד, רשימה מופרדת בפסיקים של מזהי URI, או URI שמכיל תו כללי לחיפוש.
מציינים את הסכימה בתוך השורה, בקובץ הגדרת סכימה, או משתמשים בזיהוי אוטומטי של סכימה. אם לא מציינים סכימה, הערך של --autodetect הוא false וטבלת היעד קיימת, המערכת משתמשת בסכימה של טבלת היעד.
מציינים את הדגל --replace כדי להחליף את הטבלה. משתמשים בדגל --noreplace כדי להוסיף נתונים לטבלה. אם לא מציינים דגל, ברירת המחדל היא להוסיף נתונים.
אפשר לשנות את הסכימה של הטבלה כשמוסיפים לה נתונים או מחליפים אותם. למידע נוסף על שינויים נתמכים בסכימה במהלך פעולת טעינה, קראו את המאמר שינוי סכימות של טבלאות.
(אופציונלי) מציינים את הדגל --location ומגדירים את הערך למיקום שלכם.
דגלים אופציונליים נוספים:
-
--allow_jagged_rows: אם מציינים את האפשרות הזו, המערכת מקבלת שורות בקובצי CSV שחסרות בהן עמודות אופציונליות בסוף. הערכים החסרים נחשבים כערכים ריקים. אם לא מסמנים את האפשרות הזו, רשומות שחסרות בהן עמודות נגררות נחשבות לרשומות פגומות. אם יש יותר מדי רשומות פגומות, מוחזרת שגיאה לא חוקית בתוצאת המשימה. ערך ברירת המחדל הואfalse. -
--allow_quoted_newlines: כשמציינים את האפשרות הזו, אפשר להשתמש בקטעי נתונים במירכאות שמכילים תווים של שורה חדשה בקובץ CSV. ערך ברירת המחדל הואfalse. -
--field_delimiter: התו שמציין את הגבול בין העמודות בנתונים. אפשר להשתמש גם ב-\tוגם ב-tabבתור תווי הפרדה של טאבים. ערך ברירת המחדל הוא,. -
--null_marker: מחרוזת אופציונלית בהתאמה אישית שמייצגת ערך NULL בנתוני CSV. -
--null_markers: רשימה אופציונלית מופרדת בפסיקים של מחרוזות בהתאמה אישית שמייצגות ערכי NULL בנתוני CSV. אי אפשר להשתמש באפשרות הזו עם הדגל--null_marker. --source_column_match: מציין את האסטרטגיה שמשמשת להתאמת העמודות שנטענו לסכימה. אפשר לציין את הערךPOSITIONכדי להתאים את העמודות שנטענו לפי המיקום, בהנחה שהעמודות מסודרות באותו אופן כמו הסכימה. אפשר גם לציין את הערךNAMEכדי להתאים לפי שם, על ידי קריאת שורת הכותרת כשמות העמודות ושינוי סדר העמודות כך שיתאימו לשמות השדות בסכימה. אם לא מציינים ערך, ברירת המחדל מבוססת על האופן שבו הסכימה מסופקת. אם המדיניות--autodetectמופעלת, פעולת ברירת המחדל היא להתאים עמודות לפי שם. אחרת, ברירת המחדל היא להתאים עמודות לפי מיקום.-
--skip_leading_rows: מציין את מספר שורות הכותרת שצריך לדלג עליהן בחלק העליון של קובץ ה-CSV. ערך ברירת המחדל הוא0. -
--quote: תו המירכאות שבו משתמשים כדי לתחום רשומות. ערך ברירת המחדל הוא". כדי לציין שאין תו מירכאות, משתמשים במחרוזת ריקה. -
--max_bad_records: מספר שלם שמציין את המספר המקסימלי של רשומות לא תקינות שמותרות לפני שהמשימה כולה נכשלת. ערך ברירת המחדל הוא0. מוחזרות לכל היותר חמש שגיאות מכל סוג, בלי קשר לערך של--max_bad_records. -
--ignore_unknown_values: כשמציינים את הפרמטר הזה, המערכת מאפשרת ערכים נוספים לא מזוהים בנתוני CSV או JSON ומתעלמת מהם. -
--time_zone: אזור זמן אופציונלי שמוגדר כברירת מחדל, שיחול כשמנתחים ערכי חותמות זמן שאין להם אזור זמן ספציפי בנתוני CSV או JSON. -
--date_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי DATE בנתוני CSV או JSON. -
--datetime_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי DATETIME בנתוני CSV או JSON. -
--time_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי TIME בנתוני CSV או JSON. -
--timestamp_format: מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי TIMESTAMP בנתוני CSV או JSON. -
--autodetect: כשמציינים את האפשרות הזו, מפעילים זיהוי אוטומטי של סכימה לנתוני CSV ו-JSON. -
--destination_kms_key: המפתח של Cloud KMS להצפנת נתוני הטבלה.
bq --location=location load \
--[no]replace \
--source_format=format \
dataset.table \
path_to_source \
schema
כאשר:
- location הוא המיקום שלך.
הדגל
--locationהוא אופציונלי. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ bigqueryrc.. - format הוא
CSV. - dataset הוא מערך נתונים קיים.
- table הוא שם הטבלה שאליה טוענים את הנתונים.
- path_to_source הוא URI של Cloud Storage מלא או רשימה מופרדת בפסיקים של מזהי URI. יש גם תמיכה בתווים כלליים לחיפוש.
- schema היא סכימה תקינה. הסכימה יכולה להיות קובץ JSON מקומי, או שאפשר להקליד אותה כחלק מהפקודה. אפשר גם להשתמש בדגל
--autodetectבמקום לספק הגדרת סכימה.
דוגמאות:
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv ומחליפה טבלה בשם mytable ב-mydataset. הסכימה מוגדרת באמצעות זיהוי אוטומטי של סכימה.
    bq load \
    --autodetect \
    --replace \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata.csv
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.csv ומוסיפה נתונים לטבלה בשם mytable ב-mydataset. הסכימה מוגדרת באמצעות קובץ סכימת JSON – myschema.json.
    bq load \
    --noreplace \
    --source_format=CSV \
    mydataset.mytable \
    gs://mybucket/mydata.csv \
    ./myschema.json
API
יוצרים משימת
loadשמפנה לנתוני המקור ב-Cloud Storage.(אופציונלי) מציינים את המיקום במאפיין
locationבקטעjobReferenceשל משאב המשימה.המאפיין
source URIsצריך להיות מלא, בפורמטgs://bucket/object. אפשר לכלול כמה מזהי URI ברשימה מופרדת בפסיקים. שימו לב שאפשר להשתמש גם בתווים כלליים לחיפוש.מציינים את פורמט הנתונים על ידי הגדרת המאפיין
configuration.load.sourceFormatלערךCSV.מציינים את העדפת הכתיבה על ידי הגדרת המאפיין
configuration.load.writeDispositionלערךWRITE_TRUNCATEאוWRITE_APPEND.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להחליף את השורות בטבלה קיימת, מגדירים את הערך writeDisposition בפרמטר metadata ל-'WRITE_TRUNCATE'.
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להחליף את השורות בטבלה קיימת, מגדירים את המאפיין LoadJobConfig.write_disposition לקבוע WRITE_TRUNCATE של SourceFormat.
טעינת נתוני CSV שמחולקים למחיצות ב-Apache Hive
ב-BigQuery אפשר לטעון נתוני CSV שעברו חלוקה למחיצות ב-Apache Hive ומאוחסנים ב-Cloud Storage, ולאכלס את עמודות החלוקה למחיצות של Apache Hive כעמודות בטבלה המנוהלת של BigQuery. מידע נוסף זמין במאמר טעינה של נתונים שחולקו למחיצות באופן חיצוני.
פרטים על טעינת נתונים בפורמט CSV
בקטע הזה מוסבר איך BigQuery מטפל באפשרויות שונות של פורמט CSV.
קידוד
ב-BigQuery, נתוני CSV צריכים להיות מקודדים לפי UTF-8. אם יש לכם קובצי CSV עם סוגי קידוד נתמכים אחרים, צריך לציין במפורש את הקידוד כדי ש-BigQuery יוכל להמיר את הנתונים ל-UTF-8 בצורה תקינה.
BigQuery תומך בסוגי הקידוד הבאים של קובצי CSV:
- UTF-8
- ISO-8859-1
- UTF-16BE (UTF-16 Big Endian)
- UTF-16LE (UTF-16 Little Endian)
- UTF-32BE (UTF-32 Big Endian)
- UTF-32LE (UTF-32 Little Endian)
אם לא תציינו קידוד, או אם תציינו קידוד UTF-8 כשקובץ ה-CSV לא מקודד ב-UTF-8, BigQuery ינסה להמיר את הנתונים ל-UTF-8. באופן כללי, אם קובץ ה-CSV מקודד ב-ISO-8859-1, הנתונים ייטענו בהצלחה, אבל יכול להיות שהם לא יהיו בדיוק מה שציפיתם. אם קובץ ה-CSV מקודד ב-UTF-16BE, ב-UTF-16LE, ב-UTF-32BE או ב-UTF-32LE, יכול להיות שהטעינה תיכשל.
כדי למנוע כשלים לא צפויים, צריך לציין את הקידוד הנכון באמצעות הדגל --encoding.
אם BigQuery לא יכול להמיר תו שאינו תו ASCII 0, הוא ממיר את התו לתו החלופי הסטנדרטי של Unicode: .
תווי הפרדה בין שדות
התווים המפרידים בקובצי CSV יכולים להיות כל תו של בייט אחד. אם קובץ המקור מקודד ב-ISO-8859-1, כל תו יכול לשמש כמפריד. אם קובץ המקור מקודד ב-UTF-8, אפשר להשתמש בכל תו בטווח העשרוני 1-127 (U+0001-U+007F) בלי לשנות אותו. אפשר להוסיף תו ISO-8859-1 מחוץ לטווח הזה כתו מפריד, ו-BigQuery יפרש אותו בצורה נכונה. עם זאת, אם משתמשים בתו של כמה בייטים כמפריד, חלק מהבייטים יפורשו באופן שגוי כחלק מערך השדה.
באופן כללי, מומלץ להשתמש בתו הפרדה סטנדרטי, כמו טאב, קו אנכי או פסיק. ברירת המחדל היא פסיק.
סוגי הנתונים
בוליאני. BigQuery יכול לנתח כל אחד מהזוגות הבאים של נתונים בוליאניים: 1 או 0, true או false, t או f, yes או no, או y או n (כולם לא תלויי-רישיות). הזיהוי האוטומטי של הסכימה מזהה באופן אוטומטי כל אחד מהערכים האלה, חוץ מ-0 ו-1.בייטים. עמודות עם סוגי BYTES חייבות להיות מקודדות כ-Base64.
תאריך. עמודות עם סוגי DATE חייבות להיות בפורמט YYYY-MM-DD.
Datetime. עמודות עם סוגי DATETIME חייבות להיות בפורמט YYYY-MM-DD
HH:MM:SS[.SSSSSS].
מיקום גיאוגרפי. עמודות עם סוגי GEOGRAPHY חייבות להכיל מחרוזות באחד מהפורמטים הבאים:
- טקסט מוכר (WKT)
- Well-known binary (WKB)
- GeoJSON
אם משתמשים ב-WKB, הערך צריך להיות מקודד בפורמט הקסדצימלי.
ברשימה הבאה מוצגות דוגמאות לנתונים תקינים:
- WKT:
POINT(1 2) - GeoJSON:
{ "type": "Point", "coordinates": [1, 2] } - WKB בקידוד הקסדצימלי:
0101000000feffffffffffef3f0000000000000040
לפני שאתם טוענים נתוני GEOGRAPHY, קראו גם את המאמר טעינת נתונים גיאו-מרחביים.
אינטרוול. עמודות עם סוגי INTERVAL חייבות להיות בפורמט Y-M D H:M:S[.F], כאשר:
- Y = שנה. הטווח הנתמך הוא 0-10,000.
- M = חודש. הטווח הנתמך הוא 1-12.
- D = יום. הטווח הנתמך הוא 1 עד [היום האחרון בחודש שצוין].
- H = שעה.
- M = דקה.
- S = שנייה.
- [.F] = חלקי שנייה עד שש ספרות, ברמת דיוק של מיקרו-שנייה.
כדי לציין ערך שלילי, מוסיפים מקף (-) לפני הערך.
ברשימה הבאה מוצגות דוגמאות לנתונים תקינים:
10-6 0 0:0:00-0 -5 0:0:00-0 0 0:0:1.25
כדי לטעון נתוני INTERVAL, צריך להשתמש בפקודה bq load ובדגל --schema כדי לציין סכימה. אי אפשר להעלות נתוני INTERVAL באמצעות המסוף.
JSON. כדי לסמן בתו בריחה (escape) את המירכאות, משתמשים ברצף של שני התווים "". למידע נוסף, ראו דוגמה לטעינת נתוני JSON מקובץ CSV.
זמן. עמודות עם סוגי TIME צריכות להיות בפורמט HH:MM:SS[.SSSSSS].
חותמת זמן. ב-BigQuery יש תמיכה בפורמטים שונים של חותמות זמן. חותמת הזמן חייבת לכלול חלק של תאריך וחלק של שעה.
הפורמט של החלק של התאריך יכול להיות
YYYY-MM-DDאוYYYY/MM/DD.הפורמט של חותמת הזמן צריך להיות
HH:MM[:SS[.SSSSSS]](השניות והחלקים של השניות הם אופציונליים).התאריך והשעה צריכים להיות מופרדים באמצעות רווח או האות "T".
אפשר להוסיף לתאריך ולשעה סטייה משעון UTC או את המזהה של אזור הזמן UTC (
Z). מידע נוסף זמין בקטע אזורי זמן.
לדוגמה, כל אחד מהערכים הבאים הוא ערך תקין של חותמת זמן:
2018-08-19T12:112018-08-19T12:11:352018-08-19T12:11:35.222018/08/19T12:112018-07-05T12:54:00 UTC2018-08-19T07:11:35.220 -05:002018-08-19T12:11:35.220Z
אם אתם מספקים סכימה, BigQuery מקבל גם את ראשית זמן יוניקס (Unix epoch) כערכים של חותמות זמן. עם זאת, הזיהוי האוטומטי של הסכימה לא מזהה את המקרה הזה, ומתייחס לערך כסוג מספרי או כמחרוזת.
דוגמאות לערכים של חותמות זמן לפי ראשית זמן יוניקס (Unix epoch):
- 1534680695
- 1.534680695e12
RANGE. מיוצג בקובצי CSV בפורמט [LOWER_BOUND, UPPER_BOUND), כאשר LOWER_BOUND ו-UPPER_BOUND הם מחרוזות חוקיות של DATE, DATETIME או TIMESTAMP. הערכים NULL ו-UNBOUNDED מייצגים ערכי התחלה או סיום לא מוגבלים.
הנה דוגמאות לערכי CSV של RANGE<DATE>:
"[2020-01-01, 2021-01-01)""[UNBOUNDED, 2021-01-01)""[2020-03-01, NULL)""[UNBOUNDED, UNBOUNDED)"
זיהוי אוטומטי של סכימה
בקטע הזה מתוארת ההתנהגות של זיהוי סכימה אוטומטי בזמן טעינת קובצי CSV.
תו מפריד בקובץ CSV
BigQuery מזהה את התווים המפרידים הבאים:
- פסיק ( , )
- קו ניצב ( | )
- טאב ( \t )
כותרת CSV
BigQuery מסיק מהן הכותרות על ידי השוואה בין השורה הראשונה בקובץ לשורות אחרות בקובץ. אם השורה הראשונה מכילה רק מחרוזות, והשורות האחרות מכילות סוגי נתונים אחרים, BigQuery מניח שהשורה הראשונה היא שורת כותרת. BigQuery מקצה שמות לעמודות על סמך שמות השדות בשורת הכותרת. יכול להיות שהשמות ישתנו כדי לעמוד בכללי מתן השמות לעמודות ב-BigQuery. לדוגמה, רווחים מוחלפים בקווים תחתונים.
אחרת, המערכת של BigQuery מניחה שהשורה הראשונה היא שורת נתונים, ומקצה שמות עמודות כלליים כמו string_field_1. שימו לב שאחרי שיוצרים טבלה, אי אפשר לעדכן את שמות העמודות בסכימה, אבל אפשר לשנות את השמות באופן ידני אחרי שיוצרים את הטבלה. אפשרות אחרת היא לספק סכימה מפורשת במקום להשתמש בזיהוי אוטומטי.
יכול להיות שיש לכם קובץ CSV עם שורת כותרת, שבו כל שדות הנתונים הם מחרוזות. במקרה כזה, BigQuery לא יזהה באופן אוטומטי שהשורה הראשונה היא כותרת. משתמשים באפשרות --skip_leading_rows כדי לדלג על שורת הכותרת. אחרת, הכותרת מיובאת כנתונים. במקרה כזה, כדאי גם לספק סכימה מפורשת כדי שתוכלו להקצות שמות לעמודות.
שורות חדשות במירכאות בקובץ CSV
BigQuery מזהה תווי שורה חדשה במירכאות בתוך שדה CSV, ולא מפרש את תו השורה החדשה במירכאות כגבול של שורה.
פתרון בעיות
כשמזהים באופן אוטומטי סכימה של קובצי CSV, יכול להיות שתופיע השגיאה הבאה:
שגיאה: Error while reading data, error message: CSV processing encountered
too many errors, giving up.
השגיאה הזו יכולה להתרחש כשבקובץ ה-CSV יש שורת כותרת עם ערכי מחרוזת, ו-BigQuery לא זיהה אותה ככותרת. אפשר להשתמש באפשרות --skip_leading_rows כדי לדלג על שורת הכותרת.
פתרון בעיות בטעינת נתונים מקובץ CSV
בקטעים הבאים מוסבר איך לפתור שגיאות נפוצות בניתוח ובמכסות כשאתם טוענים קובצי CSV ל-BigQuery.
פתרון שגיאות ניתוח
אם יש בעיה בניתוח של קובצי ה-CSV, המשאב errors של משימת הטעינה יאוכלס בפרטי השגיאה.
בדרך כלל, השגיאות האלה מזהות את תחילת השורה הבעייתית באמצעות היסט בייטים. בקבצים לא דחוסים, אפשר להשתמש ב-gcloud storage עם הארגומנט --recursive כדי לגשת לשורה הרלוונטית.
לדוגמה, אתם מריצים את הפקודה bq load ומתקבלת השגיאה הבאה:
bq load
    --skip_leading_rows=1 \
    --source_format=CSV \
    mydataset.mytable \
    gs://my-bucket/mytable.csv \
    'Number:INTEGER,Name:STRING,TookOffice:STRING,LeftOffice:STRING,Party:STRING'
השגיאה בפלט אמורה להיראות כך:
Waiting on bqjob_r5268069f5f49c9bf_0000018632e903d7_1 ... (0s)
Current status: DONE
BigQuery error in load operation: Error processing job
'myproject:bqjob_r5268069f5f49c9bf_0000018632e903d7_1': Error while reading
data, error message: Error detected while parsing row starting at position: 1405.
Error: Data between close quote character (") and field separator.
File: gs://my-bucket/mytable.csv
Failure details:
- gs://my-bucket/mytable.csv: Error while reading data,
error message: Error detected while parsing row starting at
position: 1405. Error: Data between close quote character (") and
field separator. File: gs://my-bucket/mytable.csv
- Error while reading data, error message: CSV processing encountered
too many errors, giving up. Rows: 22; errors: 1; max bad: 0; error
percent: 0
בהתאם לשגיאה הקודמת, יש שגיאה בפורמט של הקובץ.
כדי לראות את תוכן הקובץ, מריצים את הפקודה gcloud storage cat:
gcloud storage cat 1405-1505 gs://my-bucket/mytable.csv --recursive
הפלט אמור להיראות כך:
16,Abraham Lincoln,"March 4, 1861","April 15, "1865,Republican
18,Ulysses S. Grant,"March 4, 1869",
...
לפי הפלט של הקובץ, הבעיה היא מירכאות במקום הלא נכון ב-"April 15, "1865.
קובצי CSV דחוסים
ניפוי באגים של שגיאות ניתוח בקובצי CSV דחוסים הוא מאתגר יותר, כי היסט הבייטים המדווח מתייחס למיקום בקובץ הלא דחוס.
הפקודה הבאה של gcloud storage cat מעבירה בסטרימינג את הקובץ מ-Cloud Storage, מחלצת את הקובץ, מזהה את היסט הבייטים המתאים ומדפיסה את השורה עם שגיאת הפורמט:
gcloud storage cat gs://my-bucket/mytable.csv.gz | gunzip - | tail -c +1406 | head -n 1
הפלט אמור להיראות כך:
16,Abraham Lincoln,"March 4, 1861","April 15, "1865,Republican
פתרון בעיות שקשורות לשגיאות במכסות
בקטע הזה מוסבר איך לפתור שגיאות שקשורות למכסות או למגבלות בטעינת קובצי CSV ל-BigQuery.
אם טוענים קובץ CSV גדול באמצעות הפקודה bq load עם הדגל --allow_quoted_newlines, יכול להיות שתופיע השגיאה הזו.
הודעת שגיאה
Input CSV files are not splittable and at least one of the files is larger than
the maximum allowed size. Size is: ...
רזולוציה
כדי לפתור את שגיאת המכסה:
- מגדירים את הדגל
--allow_quoted_newlinesלערךfalse. - מפצלים את קובץ ה-CSV לחלקים קטנים יותר, שכל אחד מהם קטן מ-4GB.
מידע נוסף על המגבלות שחלות כשאתם טוענים נתונים ל-BigQuery זמין במאמר משימות טעינה.
אפשרויות CSV
כדי לשנות את האופן שבו BigQuery מנתח נתוני CSV, צריך לציין אפשרויות נוספות במסוף Google Cloud , בכלי שורת הפקודה של BigQuery או ב-API.
מידע נוסף על פורמט CSV זמין ב-RFC 4180.
| אפשרות CSV | אפשרות המסוף | דגל של הכלי bq | נכס BigQuery API | תיאור |
|---|---|---|---|---|
| תו מפריד בין שדות | תו מפריד בין שדות: פסיק, טאב, קו אנכי, בהתאמה אישית | -F או --field_delimiter |
fieldDelimiter
(Java,
Python)
|
(אופציונלי) התו שמפריד בין השדות בקובץ CSV. התו המפריד יכול להיות כל תו ISO-8859-1 של בייט אחד. BigQuery ממיר את המחרוזת לקידוד ISO-8859-1, ומשתמש בבייט הראשון של המחרוזת המקודדת כדי לפצל את הנתונים במצב הגולמי והבינארי שלהם. ב-BigQuery אפשר גם להשתמש ברצף המילוט "\t" כדי לציין מפריד טאב. ערך ברירת המחדל הוא פסיק (`,`). |
| שורות כותרת | שורות כותרת שצריך לדלג עליהן | --skip_leading_rows |
skipLeadingRows
(Java,
Python)
|
(אופציונלי) מספר שלם שמציין את מספר שורות הכותרת בנתוני המקור. |
| התאמה לעמודת המקור | התאמה של עמודת המקור: ברירת מחדל, מיקום, שם | --source_column_match |
sourceColumnMatch
(Java,
Python) |
(אופציונלי) האפשרות הזו קובעת את האסטרטגיה שבה משתמשים כדי להתאים את העמודות שנטענו לסכימה.
הערכים הנתמכים כוללים:
|
| מספר הרשומות הלא תקינות שמותרות | מספר השגיאות המותר | --max_bad_records |
maxBadRecords
(Java,
Python)
|
(אופציונלי) המספר המקסימלי של רשומות פגומות ש-BigQuery יכול להתעלם מהן בזמן הרצת המשימה. אם מספר הרשומות הלא תקינות חורג מהערך הזה, תוחזר שגיאה לא חוקית בתוצאת המשימה. ערך ברירת המחדל הוא 0, כלומר כל הרשומות צריכות להיות תקינות. |
| תווים של שורה חדשה | אישור שורות חדשות במירכאות | --allow_quoted_newlines |
allowQuotedNewlines
(Java,
Python)
|
(אופציונלי) מציין אם לאפשר קטעי נתונים במירכאות שמכילים תווים של שורה חדשה בקובץ CSV. ערך ברירת המחדל הוא False. |
| ערכי null מותאמים אישית | ללא | --null_marker |
nullMarker
(Java,
Python)
|
(אופציונלי) מציין מחרוזת שמייצגת ערך null בקובץ CSV. לדוגמה, אם מציינים "\N", BigQuery מפרש את "\N" כערך null כשנטען קובץ CSV. ערך ברירת המחדל הוא מחרוזת ריקה. אם מגדירים את המאפיין הזה לערך מותאם אישית, BigQuery מחזיר שגיאה אם יש מחרוזת ריקה לכל סוגי הנתונים, חוץ מ-STRING ו-BYTE. בעמודות STRING ו-BYTE, BigQuery מפרש את המחרוזת הריקה כערך ריק. |
| עמודות אופציונליות בסוף | מותרות שורות משוננות | --allow_jagged_rows |
allowJaggedRows
(Java,
Python)
|
(אופציונלי) קבלת שורות שחסרות בהן עמודות אופציונליות בסוף. הערכים החסרים מטופלים כערכי null. אם הערך הוא false, רשומות שחסרות בהן עמודות בסוף נחשבות לרשומות לא תקינות. אם יש יותר מדי רשומות לא תקינות, מוחזרת שגיאה לא חוקית בתוצאת המשימה. ערך ברירת המחדל הוא False. רלוונטי רק ל-CSV, המערכת מתעלמת מהשדה הזה בפורמטים אחרים. |
| ערכים לא ידועים | התעלמות מערכים לא ידועים | --ignore_unknown_values |
ignoreUnknownValues
(Java,
Python)
|
(אופציונלי) מציין אם BigQuery צריך לאפשר ערכים נוספים שלא מיוצגים בסכימת הטבלה. אם הערך הוא True, המערכת מתעלמת מהערכים הנוספים. אם הערך הוא false, רשומות עם עמודות נוספות נחשבות לרשומות לא תקינות. אם יש יותר מדי רשומות לא תקינות, מוחזרת שגיאה לא חוקית בתוצאת המשימה. ערך ברירת המחדל הוא False. המאפיין sourceFormat קובע מה נחשב ב-BigQuery כערך נוסף:
|
| ציטוט | תו מירכאות: מירכאות כפולות, מירכה בודדת, ללא, בהתאמה אישית | --quote |
quote
(Java,
Python)
|
(אופציונלי) הערך שמשמש לציטוט קטעי נתונים בקובץ CSV.
BigQuery ממיר את המחרוזת לקידוד ISO-8859-1, ואז משתמש בבייט הראשון של המחרוזת המקודדת כדי לפצל את הנתונים במצב הבינארי הגולמי שלהם. ערך ברירת המחדל הוא מירכאות כפולות ("). אם הנתונים לא מכילים קטעים במירכאות, צריך להגדיר את ערך המאפיין כמחרוזת ריקה. אם הנתונים מכילים תווי שורה חדשה במירכאות, צריך גם להגדיר את המאפיין allowQuotedNewlines לערך true. כדי לכלול את תו המירכאות הספציפי בתוך ערך במירכאות, צריך להוסיף לפניו תו מירכאות תואם נוסף. לדוגמה, אם רוצים לסמן בתו בריחה את תו ברירת המחדל ' " ', משתמשים ב-' "" '. |
| קידוד | ללא | -E או --encoding |
encoding
(Java,
Python) |
(אופציונלי) קידוד התווים של הנתונים. הערכים הנתמכים הם:
UTF-8, ISO-8859-1, UTF-16BE, UTF-16LE, UTF-32BE או UTF-32LE.
ערך ברירת המחדל הוא UTF-8. BigQuery מפענח את הנתונים אחרי שהנתונים הבינאריים הגולמיים פוצלו באמצעות הערכים של המאפיינים quote ו-fieldDelimiter. |
| תו בקרה של ASCII | ללא | --preserve_ascii_control_characters |
ללא | (אופציונלי) אם רוצים לאפשר תווי בקרה של ASCII 0 ותווי בקרה אחרים של ASCII, מגדירים את --preserve_ascii_control_characters לערך true במשימות הטעינה. |
| סמנים ריקים | סמנים ריקים | --null_markers |
nullMarkers
(Java,
Python) |
(אופציונלי)
רשימה של מחרוזות בהתאמה אישית שמייצגות ערך NULL בנתוני
CSV. אי אפשר להשתמש באפשרות הזו עם האפשרות --null_marker. |
| אזור זמן | אזור זמן | --time_zone |
timeZone
(Java,
Python) |
(אופציונלי) אזור הזמן שמוגדר כברירת מחדל, שיחול כשמנתחים ערכים של חותמות זמן שאין להם אזור זמן ספציפי. שמות תקינים של אזורי זמן אם הערך הזה לא קיים, ערכי חותמת הזמן ללא אזור זמן ספציפי מנותחים באמצעות אזור הזמן שמוגדר כברירת מחדל, UTC. |
| פורמט התאריך | פורמט התאריך | --date_format |
dateFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי DATE בקובצי הקלט (לדוגמה, MM/DD/YYYY). אם הערך הזה קיים, הפורמט הזה הוא פורמט ה-DATE התואם היחיד.
זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATE על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATE מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. |
| פורמט תאריך ושעה | פורמט תאריך ושעה | --datetime_format |
datetimeFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי DATETIME בקובצי הקלט (לדוגמה, MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של DATETIME.
זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATETIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATETIME מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. |
| פורמט השעה | פורמט השעה | --time_format |
timeFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי TIME בקובצי הקלט (לדוגמה, HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא פורמט TIME התואם היחיד.
זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIME על סמך הפורמט הזה, במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIME מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. |
| פורמט חותמת הזמן | פורמט חותמת הזמן | --timestamp_format |
timestampFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי TIMESTAMP בקובצי הקלט (לדוגמה, MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא פורמט TIMESTAMP התואם היחיד.
זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIMESTAMP על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIMESTAMP מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. |