


טעינת נתוני JSON מ-Cloud Storage
ב-BigQuery אפשר לטעון נתוני JSON מופרדים בשורה חדשה (ndJSON) מ-Cloud Storage לטבלה או למחיצה חדשה, או להוסיף אותם לטבלה או למחיצה קיימת או להחליף אותה. במהלך ההטמעה, BigQuery ממיר את הנתונים לפורמט עמודות של Capacitor (פורמט האחסון של BigQuery) לצורך שאילתות וניתוח. פורמט ndJSON זהה לפורמט JSON Lines.
מגבלות
כשאתם טוענים נתונים ל-BigQuery מקטגוריה של Cloud Storage, אתם כפופים למגבלות הבאות:
- ב-BigQuery אין הבטחה לעקביות של נתונים ממקורות חיצוניים. שינויים בנתוני הבסיס בזמן ששאילתה פועלת עלולים לגרום להתנהגות לא צפויה.
- ב-BigQuery אין תמיכה בניהול גרסאות של אובייקטים ב-Cloud Storage. אם תכללו מספר דור ב-URI של Cloud Storage, משימת הטעינה תיכשל.
כשאתם טוענים קובצי JSON ל-BigQuery, שימו לב לנקודות הבאות:
- נתוני JSON חייבים להיות מופרדים בשורה חדשה, או ndJSON. כל אובייקט JSON צריך להיות בשורה נפרדת בקובץ.
- אם אתם משתמשים בדחיסת gzip, BigQuery לא יכול לקרוא את הנתונים במקביל. טעינת נתוני JSON דחוסים ל-BigQuery איטית יותר מטעינת נתונים לא דחוסים.
- אי אפשר לכלול קבצים דחוסים וקבצים לא דחוסים באותה משימת טעינה.
- הגודל המקסימלי של קובץ gzip הוא 4GB.
ב-BigQuery יש תמיכה בסוג
JSONגם אם פרטי הסכימה לא ידועים בזמן הטמעת הנתונים. שדה שמוגדר כסוגJSONנטען עם ערכי ה-JSON הגולמיים.אם אתם משתמשים ב-BigQuery API כדי לטעון מספר שלם מחוץ לטווח של [-253+1, 253-1] (בדרך כלל זה אומר מספר שגדול מ-9,007,199,254,740,991) לעמודה של מספר שלם (INT64), צריך להעביר אותו כמחרוזת כדי למנוע פגיעה בנתונים. הבעיה הזו נגרמת בגלל מגבלה על גודל המספר השלם ב-JSON או ב-ECMAScript. מידע נוסף זמין בקטע Numbers ב-RFC 7159.
- כשאתם טוענים נתוני CSV או JSON, הערכים בעמודות
DATEחייבים להשתמש במקף (-) כמפריד, והתאריך חייב להיות בפורמט הבא:YYYY-MM-DD(שנה-חודש-יום). - כשאתם טוענים נתוני JSON או CSV, הערכים בעמודות
TIMESTAMPחייבים להשתמש במקף (-) או בלוכסן (/) כמפריד בחלק של התאריך בחותמת הזמן, והתאריך חייב להיות באחד מהפורמטים הבאים:YYYY-MM-DD(שנה-חודש-יום) אוYYYY/MM/DD(שנה/חודש/יום). בחלק שלhh:mm:ss(שעה-דקה-שנייה) בחותמת הזמן צריך להשתמש בנקודתיים (:) כמפריד. הקבצים צריכים לעמוד במגבלות הגודל של קובצי JSON, כפי שמתואר במגבלות של משימות טעינה.
לפני שמתחילים
מקצים תפקידים של ניהול זהויות והרשאות גישה (IAM) שנותנים למשתמשים את ההרשאות שדרושות כדי לבצע כל משימה במסמך הזה, ויוצרים מערך נתונים לאחסון הנתונים.
ההרשאות הנדרשות
כדי לטעון נתונים ל-BigQuery, אתם צריכים הרשאות IAM להרצת משימת טעינה ולטעינת נתונים לטבלאות ב-BigQuery ולמחיצות. אם אתם טוענים נתונים מ-Cloud Storage, אתם צריכים גם הרשאות IAM כדי לגשת לקטגוריה שמכילה את הנתונים.
הרשאות לטעינת נתונים ל-BigQuery
כדי לטעון נתונים לטבלה או למחיצה חדשה ב-BigQuery, או כדי להוסיף או להחליף טבלה או מחיצה קיימת, צריך את הרשאות ה-IAM הבאות:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
כל אחד מהתפקידים הבאים שמוגדרים מראש ב-IAM כולל את ההרשאות שצריך כדי לטעון נתונים לטבלה או למחיצה ב-BigQuery:
roles/bigquery.dataEditorroles/bigquery.dataOwner-
roles/bigquery.admin(כולל את ההרשאהbigquery.jobs.create) -
bigquery.user(כולל את ההרשאהbigquery.jobs.create) -
bigquery.jobUser(כולל את ההרשאהbigquery.jobs.create)
בנוסף, אם יש לכם את ההרשאה bigquery.datasets.create, אתם יכולים ליצור ולעדכן טבלאות באמצעות משימת טעינה בקבוצות הנתונים שאתם יוצרים.
למידע נוסף על תפקידים והרשאות של IAM ב-BigQuery, קראו את המאמר תפקידים והרשאות מוגדרים מראש.
הרשאות לטעינת נתונים מ-Cloud Storage
כדי לקבל את ההרשאות שנדרשות לטעינת נתונים מקטגוריה של Cloud Storage, בקשו מהאדמין לתת לכם את התפקיד אדמין של אחסון (roles/storage.admin) ב-IAM בקטגוריה.
כדי לקרוא הסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
זהו תפקיד שמוגדר מראש וכולל את ההרשאות שנדרשות לטעינת נתונים מקטגוריה של Cloud Storage. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי לטעון נתונים מקטגוריה של Cloud Storage, נדרשות ההרשאות הבאות:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
יצירת קבוצת נתונים
יוצרים מערך נתונים ב-BigQuery כדי לאחסן את הנתונים.
דחיסת JSON
אפשר להשתמש בכלי gzip כדי לדחוס קובצי JSON. שימו לב ש-gzip מבצע דחיסת קבצים מלאה, בניגוד לדחיסת תוכן הקובץ שמבוצעת על ידי רכיבי codec של דחיסה לפורמטים אחרים של קבצים, כמו Avro. אם משתמשים ב-gzip כדי לדחוס קובצי JSON, יכולה להיות לכך השפעה על הביצועים. מידע נוסף על היתרונות והחסרונות מופיע במאמר טעינת נתונים דחוסים ולא דחוסים.
טעינת נתוני JSON לטבלה חדשה
כדי לטעון נתוני JSON מ-Cloud Storage לטבלה חדשה ב-BigQuery:
המסוף
נכנסים לדף BigQuery במסוף Google Cloud .
- בחלונית הימנית, לוחצים על Explorer.
- בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים מערך נתונים.
- בקטע Dataset info, לוחצים על Create table.
- בחלונית Create table, מציינים את הפרטים הבאים:
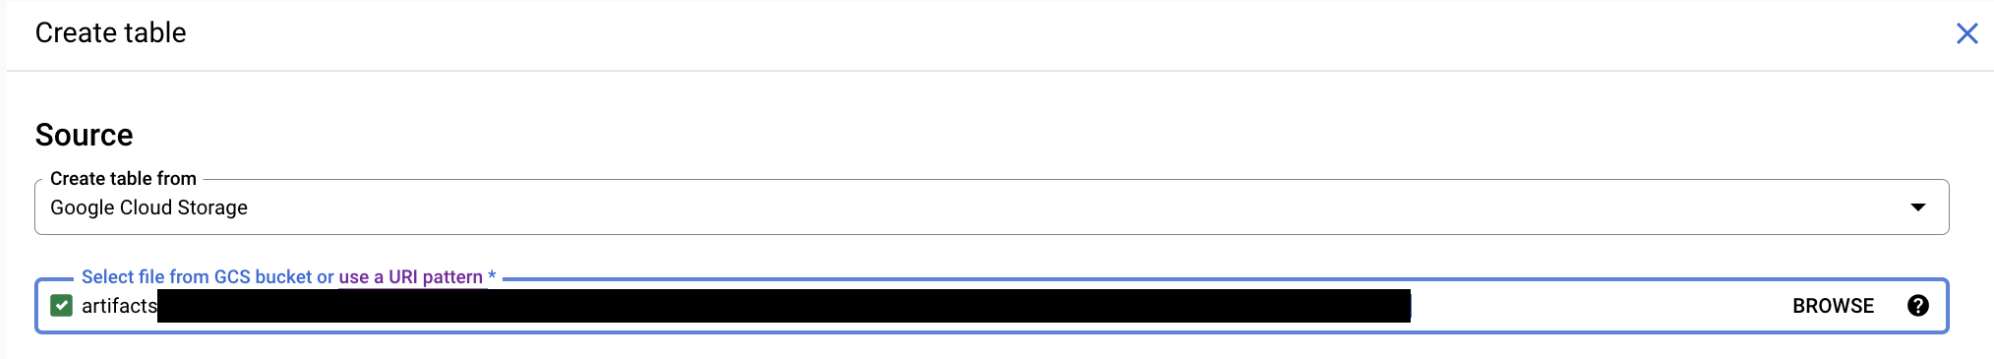
- בקטע Source, בוחרים באפשרות Google Cloud Storage ברשימה Create table from.
לאחר מכן, מבצעים את הפעולות הבאות:
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בשדה פורמט קובץ, בוחרים באפשרות JSONL (JSON מופרד בשורות חדשות).
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בקטע Destination, מציינים את הפרטים הבאים:
- בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table, מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהשדה Table type מוגדר ל-Native table.
- בקטע Schema, מזינים את הגדרת הסכימה.
כדי להפעיל זיהוי אוטומטי של סכימה, בוחרים באפשרות Auto detect.
אפשר להזין את פרטי הסכימה באופן ידני באחת מהשיטות הבאות:
- אפשרות 1: לוחצים על Edit as text ומדביקים את הסכימה בצורה של מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שמשמש ליצירת קובץ סכימה של JSON.
כדי להציג את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
bq show --format=prettyjson dataset.table
- אפשרות 2: לוחצים על Add field ומזינים את סכימת הטבלה. מציינים את הערכים של השדות Name, Type ו-Mode.
- אפשרות 1: לוחצים על Edit as text ומדביקים את הסכימה בצורה של מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שמשמש ליצירת קובץ סכימה של JSON.
כדי להציג את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
- אופציונלי: מציינים את הגדרות המחיצה והאשכול. מידע נוסף זמין במאמרים יצירת טבלאות מחולקות למחיצות ויצירה של טבלאות מסודרות באשכולות ושימוש בהן.
- לוחצים על אפשרויות מתקדמות ומבצעים את הפעולות הבאות:
- בשדה Write preference, משאירים את האפשרות Write if empty מסומנת. This option creates a new table and loads your data into it.
- בשדה Number of errors allowed, מאשרים את ערך ברירת המחדל
0או מזינים את המספר המקסימלי של שורות עם שגיאות שאפשר להתעלם מהן. אם מספר השורות עם השגיאות חורג מהערך הזה, המשימה תיכשל ותוצג הודעתinvalid. האפשרות הזו רלוונטית רק לקובצי CSV ו-JSON. - בשדה Time zone, מזינים את אזור הזמן שיוגדר כברירת מחדל לניתוח ערכים של חותמות זמן שלא צוין בהם אזור זמן ספציפי. כאן אפשר למצוא שמות תקינים נוספים של אזורי זמן. אם הערך הזה לא קיים, ערכי חותמת הזמן בלי אזור זמן ספציפי מנותחים באמצעות אזור הזמן שמוגדר כברירת מחדל, UTC.
- בשדה Date Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי DATE בקובצי הקלט. השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY). אם הערך הזה קיים, הפורמט הזה הוא הפורמט היחיד שתואם ל-DATE. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATE על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATE מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. - בשדה Datetime Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי DATETIME בקובצי הקלט.
השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של DATETIME. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATETIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATETIME מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - בשדה Time Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי TIME בקובצי הקלט. השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא פורמט TIME התואם היחיד. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIME מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. - בשדה Timestamp Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי TIMESTAMP בקובצי הקלט.
השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של TIMESTAMP. הזיהוי האוטומטי של הסכימה יקבע גם את סוג העמודה TIMESTAMP על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIMESTAMP מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - אם רוצים להתעלם מערכים בשורה שלא קיימים בסכימה של הטבלה, בוחרים באפשרות Unknown values.
- בקטע Encryption, לוחצים על Customer-managed key כדי להשתמש במפתח של Cloud Key Management Service. אם משאירים את ההגדרה Google-managed key, הנתונים מוצפנים במצב מנוחה ב-BigQuery.
- לוחצים על Create table.
SQL
משתמשים בהצהרת ה-DDL LOAD DATA.
בדוגמה הבאה נטען קובץ JSON לטבלה החדשה mytable:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
LOAD DATA OVERWRITE mydataset.mytable
(x INT64,y STRING)
FROM FILES (
  format = 'JSON',
  uris = ['gs://bucket/path/file.json']);
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
משתמשים בפקודה bq load, מציינים את NEWLINE_DELIMITED_JSON באמצעות הדגל --source_format וכוללים URI של Cloud Storage.
אפשר לכלול URI יחיד, רשימה מופרדת בפסיקים של מזהי URI, או URI שמכיל תו כללי לחיפוש.
מציינים את הסכימה בתוך השורה, בקובץ הגדרת סכימה, או משתמשים בזיהוי אוטומטי של סכימה.
(אופציונלי) מציינים את הדגל --location ומגדירים את הערך למיקום שלכם.
דגלים אופציונליים נוספים:
-
--max_bad_records: מספר שלם שמציין את המספר המקסימלי של רשומות לא תקינות שמותרות לפני שהמשימה כולה נכשלת. ערך ברירת המחדל הוא0. מוחזרות לכל היותר חמש שגיאות מכל סוג, בלי קשר לערך של--max_bad_records. -
--ignore_unknown_values: כשמציינים את הפרמטר הזה, המערכת מאפשרת ערכים נוספים לא מזוהים בנתוני CSV או JSON ומתעלמת מהם. -
--time_zone: (תצוגה מקדימה) אזור זמן אופציונלי שמוגדר כברירת מחדל, שיחול כשמנתחים ערכים של חותמות זמן שאין להם אזור זמן ספציפי בנתוני CSV או JSON. -
--date_format: (תצוגה מקדימה) מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי DATE בנתוני CSV או JSON. -
--datetime_format: (תצוגה מקדימה) מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי DATETIME בנתוני CSV או JSON. --time_format: (תצוגה מקדימה) מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי TIME בנתוני CSV או JSON.-
--timestamp_format: (תצוגה מקדימה) מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי TIMESTAMP בנתוני CSV או JSON. -
--autodetect: כשמציינים את האפשרות הזו, מפעילים זיהוי אוטומטי של סכימה לנתוני CSV ו-JSON. -
--time_partitioning_type: הפעלת חלוקה למחיצות לפי זמן בטבלה והגדרת סוג המחיצה. הערכים האפשריים הםHOUR,DAY,MONTHו-YEAR. הדגל הזה הוא אופציונלי כשיוצרים טבלה שמחולקת למחיצות לפי עמודה מסוגDATE,DATETIMEאוTIMESTAMP. סוג המחיצה שמוגדר כברירת מחדל לחלוקה למחיצות לפי זמן הואDAY. אי אפשר לשנות את מפרט החלוקה למחיצות בטבלה קיימת. -
--time_partitioning_expiration: מספר שלם שמציין (בשניות) מתי צריך למחוק מחיצה שמבוססת על זמן. זמן התפוגה מחושב לפי תאריך ה-UTC של המחיצה בתוספת ערך המספר השלם. -
--time_partitioning_field: העמודהDATEאוTIMESTAMPשמשמשת ליצירת טבלה מחולקת למחיצות. אם מפעילים חלוקה למחיצות לפי זמן בלי הערך הזה, נוצרת טבלה מחולקת למחיצות לפי זמני כתיבת הנתונים. -
--require_partition_filter: כשהאפשרות הזו מופעלת, המשתמשים צריכים לכלול משפטWHEREשמציין את המחיצות שרוצים לשלוח אליהן שאילתות. דרישה למסנן מחיצות יכולה להפחית את העלות ולשפר את הביצועים. מידע נוסף זמין במאמר דרישה למסנן מחיצות בשאילתות. -
--clustering_fields: רשימה מופרדת בפסיקים של עד ארבעה שמות עמודות שמשמשים ליצירת טבלה מסודרת באשכולות.
--destination_kms_key: המפתח של Cloud KMS להצפנת נתוני הטבלה.למידע נוסף על טבלאות מחולקות למחיצות:
מידע נוסף על טבלאות מסודרות באשכולות:
מידע נוסף על הצפנת טבלאות זמין במאמרים הבאים:
כדי לטעון נתוני JSON ל-BigQuery, מזינים את הפקודה הבאה:
bq --location=LOCATION load \
--source_format=FORMAT \
DATASET.TABLE \
PATH_TO_SOURCE \
SCHEMA
מחליפים את מה שכתוב בשדות הבאים:
-
LOCATION: המיקום שלכם. הדגל--locationהוא אופציונלי. לדוגמה, אם אתם משתמשים ב-BigQuery באזור טוקיו, אתם יכולים להגדיר את הערך של הדגל ל-asia-northeast1. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ bigqueryrc.. FORMAT:NEWLINE_DELIMITED_JSON.-
DATASET: מערך נתונים קיים. -
TABLE: שם הטבלה שאליה טוענים את הנתונים. -
PATH_TO_SOURCE: URI מלא של Cloud Storage או רשימה של מזהי URI שמופרדים בפסיקים. יש גם תמיכה בתווים כלליים לחיפוש. -
SCHEMA: סכימה תקינה. הסכימה יכולה להיות קובץ JSON מקומי, או שאפשר להקליד אותה כחלק מהפקודה. אם משתמשים בקובץ סכימה, לא נותנים לו סיומת. אפשר גם להשתמש בדגל--autodetectבמקום לספק הגדרת סכימה.
דוגמאות:
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.json לטבלה בשם mytable ב-mydataset. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata.json \
    ./myschema
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.json לטבלה חדשה מחולקת למחיצות (Partitions) לפי זמני כתיבת הנתונים בשם mytable ב-mydataset. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    --time_partitioning_type=DAY \
    mydataset.mytable \
    gs://mybucket/mydata.json \
    ./myschema
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.json לטבלה מחולקת למחיצות בשם mytable ב-mydataset. הטבלה מחולקת למחיצות לפי העמודה mytimestamp. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    --time_partitioning_field mytimestamp \
    mydataset.mytable \
    gs://mybucket/mydata.json \
    ./myschema
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.json לטבלה בשם mytable ב-mydataset. הסכימה מזוהה באופן אוטומטי.
    bq load \
    --autodetect \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata.json
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.json לטבלה בשם mytable ב-mydataset. הסכימה מוגדרת בתוך השורה בפורמט FIELD:DATA_TYPE, FIELD:DATA_TYPE.
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata.json \
    qtr:STRING,sales:FLOAT,year:STRING
הפקודה הבאה טוענת נתונים מכמה קבצים ב-gs://mybucket/ לטבלה בשם mytable ב-mydataset. ה-URI של Cloud Storage כולל תו כללי לחיפוש. הסכימה מזוהה באופן אוטומטי.
    bq load \
    --autodetect \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata*.json
הפקודה הבאה טוענת נתונים מכמה קבצים ב-gs://mybucket/ לטבלה בשם mytable ב-mydataset. הפקודה כוללת רשימה מופרדת בפסיקים של מזהי URI של Cloud Storage עם תווים כלליים לחיפוש. הסכימה מוגדרת בקובץ סכימה מקומי בשם myschema.
    bq load \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    "gs://mybucket/00/*.json","gs://mybucket/01/*.json" \
    ./myschema
API
יוצרים משימת
loadשמפנה לנתוני המקור ב-Cloud Storage.(אופציונלי) מציינים את המיקום במאפיין
locationבקטעjobReferenceשל משאב המשימה.המאפיין
source URIsחייב להיות מוגדר במלואו, בפורמטgs://BUCKET/OBJECT. כל URI יכול להכיל תו כללי לחיפוש אחד מסוג "*".מציינים את פורמט הנתונים
JSONעל ידי הגדרת המאפייןsourceFormatלערךNEWLINE_DELIMITED_JSON.כדי לבדוק את סטטוס המשימה, מפעילים את
jobs.get(JOB_ID*)ומחליפים אתJOB_IDבמזהה המשימה שהוחזר בבקשה הראשונית.- אם הערך הוא
status.state = DONE, המשימה הושלמה בהצלחה. - אם המאפיין
status.errorResultקיים, הבקשה נכשלה והאובייקט הזה כולל מידע שמתאר מה השתבש. אם הבקשה נכשלת, לא נוצרת טבלה ולא נטענים נתונים. - אם
status.errorResultלא מופיע, המשימה הסתיימה בהצלחה, אבל יכול להיות שהיו כמה שגיאות לא קריטיות, כמו בעיות בייבוא של כמה שורות. שגיאות לא קריטיות מופיעות במאפייןstatus.errorsשל אובייקט המשימה שמוחזר.
- אם הערך הוא
הערות לגבי ה-API:
משימות טעינה הן אטומיות ועקביות. אם משימת טעינה נכשלת, אף אחד מהנתונים לא זמין. אם משימת טעינה מצליחה, כל הנתונים זמינים.
מומלץ ליצור מזהה ייחודי ולהעביר אותו בתור
jobReference.jobIdכשקוראים ל-jobs.insertכדי ליצור משימת טעינה. הגישה הזו עמידה יותר בפני כשלים ברשת, כי הלקוח יכול לבצע דגימה או לנסות שוב באמצעות מזהה המשימה הידוע.הקריאה ל-
jobs.insertבמזהה משימה נתון היא אידמפוטנטית. אפשר לנסות שוב כמה פעמים שרוצים עם אותו מזהה משימה, ורק אחת מהפעולות האלה תצליח.
C#
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של C# במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery C# API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להתחיל משימת טעינה מ-Cloud Storage, משתמשים ב-methodBigQueryClient.CreateLoadJob(). כדי להשתמש ב-JSONL, יוצרים אובייקט CreateLoadJobOptions ומגדירים את המאפיין SourceFormat שלו לערך FileFormat.NewlineDelimitedJson.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להתחיל משימת טעינה מ-Cloud Storage, משתמשים ב-method LoadJobConfiguration.builder(tableId, sourceUri). כדי להשתמש ב-JSON שמופרד בתו שורה חדשה, משתמשים ב-LoadJobConfiguration.setFormatOptions(FormatOptions.json()).
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להתחיל משימת טעינה מ-Cloud Storage, משתמשים ב-method Client.load_table_from_uri(). כדי להשתמש ב-JSONL, מגדירים את המאפיין LoadJobConfig.source_format למחרוזתNEWLINE_DELIMITED_JSON ומעבירים את הגדרת המשימה כארגומנט job_config ל-method load_table_from_uri().
Ruby
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Ruby במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Ruby API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
משתמשים ב-method Dataset.load_job() כדי להתחיל משימת טעינה מ-Cloud Storage. כדי להשתמש ב-JSONL, מגדירים את הפרמטרformat ל-"json".
טעינת נתוני JSON חוזרים ומקוננים
ב-BigQuery אפשר לטעון נתונים חוזרים ונתונים בתצוגת עץ מפורמטים של מקורות שתומכים בסכימות מבוססות-אובייקטים, כמו JSON, Avro, ORC, Parquet, Firestore ו-Datastore.
בכל שורה צריך להופיע אובייקט JSON אחד, כולל שדות חוזרים או שדות בתצוגת עץ.
בדוגמה הבאה מוצגים נתונים לדוגמה בתצוגת עץ או נתונים חוזרים. הטבלה הזו מכילה מידע על אנשים. הוא מורכב מהשדות הבאים:
idfirst_namelast_namedob(תאריך לידה)addresses(שדה חוזר בתוך שדה)-
addresses.status(הנוכחי או הקודם) addresses.addressaddresses.cityaddresses.stateaddresses.zipaddresses.numberOfYears(מספר השנים בכתובת)
-
קובץ הנתונים בפורמט JSON ייראה כך: שימו לב ששדה הכתובת מכיל מערך של ערכים (שמצוין באמצעות [ ]).
{"id":"1","first_name":"John","last_name":"Doe","dob":"1968-01-22","addresses":[{"status":"current","address":"123 First Avenue","city":"Seattle","state":"WA","zip":"11111","numberOfYears":"1"},{"status":"previous","address":"456 Main Street","city":"Portland","state":"OR","zip":"22222","numberOfYears":"5"}]}
{"id":"2","first_name":"Jane","last_name":"Doe","dob":"1980-10-16","addresses":[{"status":"current","address":"789 Any Avenue","city":"New York","state":"NY","zip":"33333","numberOfYears":"2"},{"status":"previous","address":"321 Main Street","city":"Hoboken","state":"NJ","zip":"44444","numberOfYears":"3"}]}
הסכימה של הטבלה הזו תיראה כך:
[
    {
        "name": "id",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "first_name",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "last_name",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "dob",
        "type": "DATE",
        "mode": "NULLABLE"
    },
    {
        "name": "addresses",
        "type": "RECORD",
        "mode": "REPEATED",
        "fields": [
            {
                "name": "status",
                "type": "STRING",
                "mode": "NULLABLE"
            },
            {
                "name": "address",
                "type": "STRING",
                "mode": "NULLABLE"
            },
            {
                "name": "city",
                "type": "STRING",
                "mode": "NULLABLE"
            },
            {
                "name": "state",
                "type": "STRING",
                "mode": "NULLABLE"
            },
            {
                "name": "zip",
                "type": "STRING",
                "mode": "NULLABLE"
            },
            {
                "name": "numberOfYears",
                "type": "STRING",
                "mode": "NULLABLE"
            }
        ]
    }
]
למידע על ציון סכימה של שדות בתוך שדות ושדות חוזרים, קראו את המאמר ציון שדות בתוך שדות ושדות חוזרים.
טעינת נתוני JSON מובנים למחצה
ב-BigQuery אפשר לטעון נתונים חצי-מובְנים, שבהם שדה יכול להכיל ערכים מסוגים שונים. בדוגמה הבאה מוצגים נתונים שדומים לדוגמה הקודמת של נתוני JSON חוזרים ומקוננים, אבל השדה address יכול להיות STRING, STRUCT או ARRAY:
{"id":"1","first_name":"John","last_name":"Doe","dob":"1968-01-22","address":"123 First Avenue, Seattle WA 11111"}

{"id":"2","first_name":"Jane","last_name":"Doe","dob":"1980-10-16","address":{"status":"current","address":"789 Any Avenue","city":"New York","state":"NY","zip":"33333","numberOfYears":"2"}}

{"id":"3","first_name":"Bob","last_name":"Doe","dob":"1982-01-10","address":[{"status":"current","address":"789 Any Avenue","city":"New York","state":"NY","zip":"33333","numberOfYears":"2"}, "321 Main Street Hoboken NJ 44444"]}
כדי לטעון את הנתונים האלה ל-BigQuery, אפשר להשתמש בסכימה הבאה:
[
    {
        "name": "id",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "first_name",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "last_name",
        "type": "STRING",
        "mode": "NULLABLE"
    },
    {
        "name": "dob",
        "type": "DATE",
        "mode": "NULLABLE"
    },
    {
        "name": "address",
        "type": "JSON",
        "mode": "NULLABLE"
    }
]
השדה address נטען לעמודה מסוג JSON, שמאפשרת להכיל את הסוגים המעורבים שבדוגמה. אפשר להטמיע נתונים כ-JSON גם אם הם מכילים סוגים מעורבים וגם אם לא. לדוגמה, אפשר לציין את הסוג JSON במקום STRING בשדה first_name. מידע נוסף מופיע במאמר עבודה עם נתוני JSON ב-GoogleSQL.
הוספה לטבלה או החלפה של טבלה עם נתוני JSON
אפשר לטעון נתונים נוספים לטבלה מקובצי מקור או על ידי הוספת תוצאות של שאילתות.
במסוף Google Cloud , משתמשים באפשרות Write preference כדי לציין איזו פעולה לבצע כשאתם טוענים נתונים מקובץ מקור או מתוצאת שאילתה.
כשאתם טוענים נתונים נוספים לטבלה, יש לכם את האפשרויות הבאות:
| אפשרות המסוף | דגל של הכלי bq | נכס BigQuery API | תיאור |
|---|---|---|---|
| כתיבה אם ריק | לא נתמך | WRITE_EMPTY |
הנתונים נכתבים רק אם הטבלה ריקה. |
| הוספה לטבלה | --noreplace או --replace=false; אם לא צוין --[no]replace, ברירת המחדל היא append |
WRITE_APPEND |
(ברירת המחדל) הוספת הנתונים לסוף הטבלה. |
| החלפת הטבלה | --replace או --replace=true |
WRITE_TRUNCATE |
מוחק את כל הנתונים הקיימים בטבלה לפני כתיבת הנתונים החדשים. הפעולה הזו גם מוחקת את סכימת הטבלה, את האבטחה ברמת השורה ואת כל מפתחות Cloud KMS. |
אם אתם טוענים נתונים לטבלה קיימת, משימת הטעינה יכולה להוסיף את הנתונים או להחליף את הטבלה.
אפשר להוסיף נתונים לטבלה או להחליף אותה באחת מהדרכים הבאות:
- מסוף Google Cloud
- הפקודה
bq loadשל כלי שורת הפקודה של BigQuery - ה-method של ה-API של
jobs.insertוהגדרת משימה ב-load - ספריות הלקוח
המסוף
נכנסים לדף BigQuery במסוף Google Cloud .
- בחלונית הימנית, לוחצים על Explorer.
- בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים מערך נתונים.
- בקטע Dataset info, לוחצים על Create table.
- בחלונית Create table, מציינים את הפרטים הבאים:
- בקטע Source, בוחרים באפשרות Google Cloud Storage ברשימה Create table from.
לאחר מכן, מבצעים את הפעולות הבאות:
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בשדה פורמט קובץ, בוחרים באפשרות JSONL (JSON מופרד בשורות חדשות).
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בקטע Destination, מציינים את הפרטים הבאים:
- בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table, מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהשדה Table type מוגדר ל-Native table.
- בקטע Schema, מזינים את הגדרת הסכימה.
כדי להפעיל זיהוי אוטומטי של סכימה, בוחרים באפשרות Auto detect.
אפשר להזין את פרטי הסכימה באופן ידני באחת מהשיטות הבאות:
- אפשרות 1: לוחצים על Edit as text ומדביקים את הסכימה בצורה של מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שמשמש ליצירת קובץ סכימה של JSON.
כדי להציג את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
bq show --format=prettyjson dataset.table
- אפשרות 2: לוחצים על Add field ומזינים את סכימת הטבלה. מציינים את הערכים של השדות Name, Type ו-Mode.
- אפשרות 1: לוחצים על Edit as text ומדביקים את הסכימה בצורה של מערך JSON. כשמשתמשים במערך JSON, יוצרים את הסכימה באותו תהליך שמשמש ליצירת קובץ סכימה של JSON.
כדי להציג את הסכימה של טבלה קיימת בפורמט JSON, מזינים את הפקודה הבאה:
- אופציונלי: מציינים את הגדרות המחיצה והאשכול. מידע נוסף זמין במאמרים יצירת טבלאות מחולקות למחיצות ויצירה של טבלאות מסודרות באשכולות ושימוש בהן. אי אפשר להמיר טבלה לטבלה מחולקת למחיצות או לטבלה מסודרת באשכולות על ידי הוספה או החלפה שלה. במסוף Google Cloud אי אפשר להוסיף נתונים לטבלאות מחולקות למחיצות או לטבלאות מסודרות באשכולות, או להחליף אותן, במסגרת משימת טעינה.
- לוחצים על אפשרויות מתקדמות ומבצעים את הפעולות הבאות:
- בקטע Write preference, בוחרים באפשרות Append to table או Overwrite table.
- בשדה Number of errors allowed, מאשרים את ערך ברירת המחדל
0או מזינים את המספר המקסימלי של שורות עם שגיאות שאפשר להתעלם מהן. אם מספר השורות עם השגיאות חורג מהערך הזה, המשימה תיכשל ותוצג הודעתinvalid. האפשרות הזו רלוונטית רק לקובצי CSV ו-JSON. - בשדה Time zone, מזינים את אזור הזמן שיוגדר כברירת מחדל לניתוח ערכים של חותמות זמן שלא צוין בהם אזור זמן ספציפי. כאן אפשר למצוא שמות תקינים נוספים של אזורי זמן. אם הערך הזה לא קיים, ערכי חותמת הזמן בלי אזור זמן ספציפי מנותחים באמצעות אזור הזמן שמוגדר כברירת מחדל, UTC.
- בשדה Date Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי DATE בקובצי הקלט. השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY). אם הערך הזה קיים, הפורמט הזה הוא הפורמט היחיד שתואם ל-DATE. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATE על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATE מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. - בשדה Datetime Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי DATETIME בקובצי הקלט.
השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של DATETIME. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATETIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATETIME מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - בשדה Time Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי TIME בקובצי הקלט. השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא פורמט TIME התואם היחיד. זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIME מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. - בשדה Timestamp Format, מזינים את
רכיבי הפורמט שמגדירים את הפורמט של ערכי TIMESTAMP בקובצי הקלט.
השדה הזה מצפה לפורמט של סגנונות SQL (לדוגמה,
MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של TIMESTAMP. הזיהוי האוטומטי של הסכימה יקבע גם את סוג העמודה TIMESTAMP על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIMESTAMP מנותח באמצעות פורמטים שמוגדרים כברירת מחדל. - אם רוצים להתעלם מערכים בשורה שלא קיימים בסכימה של הטבלה, בוחרים באפשרות Unknown values.
- בקטע Encryption, לוחצים על Customer-managed key כדי להשתמש במפתח של Cloud Key Management Service. אם משאירים את ההגדרה Google-managed key, הנתונים מוצפנים במצב מנוחה ב-BigQuery.
- לוחצים על Create table.
SQL
משתמשים בהצהרת ה-DDL LOAD DATA.
בדוגמה הבאה, קובץ JSON נוסף לטבלה mytable:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
LOAD DATA INTO mydataset.mytable
FROM FILES (
  format = 'JSON',
  uris = ['gs://bucket/path/file.json']);
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
משתמשים בפקודה bq load, מציינים את NEWLINE_DELIMITED_JSON באמצעות הדגל --source_format וכוללים URI של Cloud Storage.
אפשר לכלול URI יחיד, רשימה מופרדת בפסיקים של מזהי URI, או URI שמכיל תו כללי לחיפוש.
מציינים את הסכימה בתוך השורה, בקובץ הגדרת סכימה, או משתמשים בזיהוי אוטומטי של סכימה.
מציינים את הדגל --replace כדי להחליף את הטבלה. משתמשים בדגל --noreplace כדי להוסיף נתונים לטבלה. אם לא מציינים דגל, ברירת המחדל היא להוסיף נתונים.
אפשר לשנות את הסכימה של הטבלה כשמוסיפים לה נתונים או מחליפים אותם. למידע נוסף על שינויים נתמכים בסכימה במהלך פעולת טעינה, קראו את המאמר שינוי סכימות של טבלאות.
(אופציונלי) מציינים את הדגל --location ומגדירים את הערך למיקום שלכם.
דגלים אופציונליים נוספים:
-
--max_bad_records: מספר שלם שמציין את המספר המקסימלי של רשומות לא תקינות שמותרות לפני שהמשימה כולה נכשלת. ערך ברירת המחדל הוא0. מוחזרות לכל היותר חמש שגיאות מכל סוג, בלי קשר לערך של--max_bad_records. -
--ignore_unknown_values: כשמציינים את הפרמטר הזה, המערכת מאפשרת ערכים נוספים לא מזוהים בנתוני CSV או JSON ומתעלמת מהם. -
--time_zone: (תצוגה מקדימה) אזור זמן אופציונלי שמוגדר כברירת מחדל, שיחול כשמנתחים ערכים של חותמות זמן שאין להם אזור זמן ספציפי בנתוני CSV או JSON. -
--date_format: (תצוגה מקדימה) מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי DATE בנתוני CSV או JSON. -
--datetime_format: (תצוגה מקדימה) מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי DATETIME בנתוני CSV או JSON. --time_format: (תצוגה מקדימה) מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי TIME בנתוני CSV או JSON.-
--timestamp_format: (תצוגה מקדימה) מחרוזת אופציונלית בהתאמה אישית שמגדירה את הפורמט של ערכי TIMESTAMP בנתוני CSV או JSON. -
--autodetect: כשמציינים את האפשרות הזו, מפעילים זיהוי אוטומטי של סכימה לנתוני CSV ו-JSON. -
--destination_kms_key: המפתח של Cloud KMS להצפנת נתוני הטבלה.
bq --location=LOCATION load \
--[no]replace \
--source_format=FORMAT \
DATASET.TABLE \
PATH_TO_SOURCE \
SCHEMA
מחליפים את מה שכתוב בשדות הבאים:
-
LOCATION: המיקום שלכם. הדגל--locationהוא אופציונלי. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ bigqueryrc.. FORMAT:NEWLINE_DELIMITED_JSON.-
DATASET: מערך נתונים קיים. -
TABLE: שם הטבלה שאליה טוענים את הנתונים. -
PATH_TO_SOURCE: URI מלא של Cloud Storage או רשימה של מזהי URI שמופרדים בפסיקים. יש גם תמיכה בתווים כלליים לחיפוש. -
SCHEMA: סכימה תקינה. הסכימה יכולה להיות קובץ JSON מקומי, או שאפשר להקליד אותה כחלק מהפקודה. אפשר גם להשתמש בדגל--autodetectבמקום לספק הגדרת סכימה.
דוגמאות:
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.json ומחליפה טבלה בשם mytable ב-mydataset. הסכימה מוגדרת באמצעות זיהוי אוטומטי של סכימה.
    bq load \
    --autodetect \
    --replace \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata.json
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.json ומוסיפה נתונים לטבלה בשם mytable ב-mydataset. הסכימה מוגדרת באמצעות קובץ סכימת JSON – myschema.
    bq load \
    --noreplace \
    --source_format=NEWLINE_DELIMITED_JSON \
    mydataset.mytable \
    gs://mybucket/mydata.json \
    ./myschema
API
יוצרים משימת
loadשמפנה לנתוני המקור ב-Cloud Storage.(אופציונלי) מציינים את המיקום במאפיין
locationבקטעjobReferenceשל משאב המשימה.המאפיין
source URIsחייב להיות מוגדר באופן מלא, בפורמטgs://BUCKET/OBJECT. אפשר לכלול כמה מזהי URI ברשימה מופרדת בפסיקים. יש גם תמיכה בתווים כלליים לחיפוש.מציינים את פורמט הנתונים על ידי הגדרת המאפיין
configuration.load.sourceFormatלערךNEWLINE_DELIMITED_JSON.מציינים את העדפת הכתיבה על ידי הגדרת המאפיין
configuration.load.writeDispositionלערךWRITE_TRUNCATEאוWRITE_APPEND.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
כדי להחליף את השורות בטבלה קיימת, מגדירים את המאפיין LoadJobConfig.write_disposition למחרוזת WRITE_TRUNCATE.
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Ruby
כדי להחליף את השורות בטבלה קיימת, מגדירים את הפרמטר write של Table.load_job() לערך "WRITE_TRUNCATE".
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Ruby במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Ruby API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
טעינת נתוני JSON שמחולקים למחיצות ב-Hive
ב-BigQuery אפשר לטעון נתוני JSON עם חלוקה למחיצות ב-Hive שמאוחסנים ב-Cloud Storage, ולאכלס את העמודות של החלוקה למחיצות ב-Hive כעמודות בטבלה המנוהלת של היעד ב-BigQuery. מידע נוסף זמין במאמר טעינה של נתונים שחולקו למחיצות באופן חיצוני.
פרטים על טעינת נתוני JSON
בקטע הזה מוסבר איך BigQuery מנתח סוגי נתונים שונים כשטוענים נתוני JSON.
סוגי הנתונים
בוליאני. BigQuery יכול לנתח כל אחד מהזוגות הבאים של נתונים בוליאניים: 1 או 0, true או false, t או f, yes או no, או y או n (כולם לא תלויי-רישיות). הזיהוי האוטומטי של הסכימה מזהה באופן אוטומטי כל אחד מהערכים האלה, חוץ מ-0 ו-1.בייטים. עמודות עם סוגי BYTES חייבות להיות מקודדות כ-Base64.
תאריך. עמודות עם סוגי DATE חייבות להיות בפורמט YYYY-MM-DD.
Datetime. עמודות עם סוגי DATETIME חייבות להיות בפורמט YYYY-MM-DD
HH:MM:SS[.SSSSSS].
מיקום גיאוגרפי. עמודות עם סוגי GEOGRAPHY חייבות להכיל מחרוזות באחד מהפורמטים הבאים:
- טקסט מוכר (WKT)
- Well-known binary (WKB)
- GeoJSON
אם משתמשים ב-WKB, הערך צריך להיות מקודד בפורמט הקסדצימלי.
ברשימה הבאה מוצגות דוגמאות לנתונים תקינים:
- WKT:
POINT(1 2) - GeoJSON:
{ "type": "Point", "coordinates": [1, 2] } - WKB בקידוד הקסדצימלי:
0101000000feffffffffffef3f0000000000000040
לפני שאתם טוענים נתוני GEOGRAPHY, קראו גם את המאמר טעינת נתונים גיאו-מרחביים.
אינטרוול. עמודות עם סוגי INTERVAL צריכות להיות בפורמט ISO 8601 PYMDTHMS, כאשר:
- P = מציין שהערך מייצג משך זמן. חובה לכלול את זה תמיד.
- Y = שנה
- M = חודש
- D = יום
- T = מציין את החלק של הזמן במשך. חובה לכלול את זה תמיד.
- H = שעה
- M = דקה
- S = שנייה. אפשר לציין שניות כערך שלם או כערך חלקי של עד שש ספרות, ברמת דיוק של מיקרו-שנייה.
כדי לציין ערך שלילי, מוסיפים מקף (-) לפני הערך.
ברשימה הבאה מוצגות דוגמאות לנתונים תקינים:
P-10000Y0M-3660000DT-87840000H0M0SP0Y0M0DT0H0M0.000001SP10000Y0M3660000DT87840000H0M0S
כדי לטעון נתוני INTERVAL, צריך להשתמש בפקודה bq load ובדגל --schema כדי לציין סכימה. אי אפשר להעלות נתוני INTERVAL באמצעות המסוף.
זמן. עמודות עם סוגי TIME צריכות להיות בפורמט HH:MM:SS[.SSSSSS].
חותמת זמן. ב-BigQuery יש תמיכה בפורמטים שונים של חותמות זמן. חותמת הזמן חייבת לכלול חלק של תאריך וחלק של שעה.
הפורמט של החלק של התאריך יכול להיות
YYYY-MM-DDאוYYYY/MM/DD.הפורמט של חותמת הזמן צריך להיות
HH:MM[:SS[.SSSSSS]](השניות והחלקים של השניות הם אופציונליים).התאריך והשעה צריכים להיות מופרדים באמצעות רווח או האות "T".
אפשר להוסיף לתאריך ולשעה סטייה משעון UTC או את המזהה של אזור הזמן UTC (
Z). מידע נוסף זמין בקטע אזורי זמן.
לדוגמה, כל אחד מהערכים הבאים הוא ערך תקין של חותמת זמן:
2018-08-19T12:112018-08-19T12:11:352018-08-19T12:11:35.222018/08/19T12:112018-07-05T12:54:00 UTC2018-08-19T07:11:35.220 -05:002018-08-19T12:11:35.220Z
אם אתם מספקים סכימה, BigQuery מקבל גם את ראשית זמן יוניקס (Unix epoch) כערכים של חותמות זמן. עם זאת, הזיהוי האוטומטי של הסכימה לא מזהה את המקרה הזה, ומתייחס לערך כסוג מספרי או כמחרוזת.
דוגמאות לערכים של חותמות זמן לפי ראשית זמן יוניקס (Unix epoch):
- 1534680695
- 1.534680695e12
מערך (שדה חוזר). הערך חייב להיות מערך JSON או null. null ב-JSON מומר ל-NULL ב-SQL. המערך עצמו לא יכול להכיל ערכי null.
זיהוי אוטומטי של סכימה
בקטע הזה מתוארת ההתנהגות של הזיהוי האוטומטי של הסכימה בזמן טעינת קובצי JSON.
שדות בתוך שדות ושדות חוזרים ב-JSON
BigQuery מסיק שדות חוזרים ושדות בתוך שדות בקובצי JSON. אם ערך השדה הוא אובייקט JSON, BigQuery טוען את העמודה כסוג RECORD. אם ערך השדה הוא מערך, BigQuery טוען את העמודה כעמודה חוזרת. דוגמה לנתוני JSON עם נתונים בתצוגת עץ ונתונים חוזרים מופיעה במאמר טעינת נתוני JSON בתצוגת עץ ונתונים חוזרים.
המרת מחרוזת
אם מפעילים זיהוי אוטומטי של סכימה, BigQuery ממיר מחרוזות לסוגים בוליאניים, מספריים או של תאריך/שעה, כשאפשר. לדוגמה, אם משתמשים בנתוני ה-JSON הבאים, הזיהוי האוטומטי של הסכימה ממיר את השדה id לעמודה INTEGER:
{ "name":"Alice","id":"12"}
{ "name":"Bob","id":"34"}
{ "name":"Charles","id":"45"}
סוגי קידוד
ב-BigQuery, נתוני JSON צריכים להיות בקידוד UTF-8. אם יש לכם קובצי JSON עם סוגי קידוד נתמכים אחרים, צריך לציין במפורש את הקידוד באמצעות הדגל --encoding כדי ש-BigQuery ימיר את הנתונים ל-UTF-8.
ב-BigQuery יש תמיכה בסוגי הקידוד הבאים של קובצי JSON:
- UTF-8
- ISO-8859-1
- UTF-16BE (UTF-16 Big Endian)
- UTF-16LE (UTF-16 Little Endian)
- UTF-32BE (UTF-32 Big Endian)
- UTF-32LE (UTF-32 Little Endian)
אפשרויות JSON
כדי לשנות את האופן שבו BigQuery מנתח נתוני JSON, צריך לציין אפשרויות נוספות במסוף Google Cloud , בכלי שורת הפקודה של BigQuery, ב-API או בספריות הלקוח.
| אפשרות JSON | אפשרות המסוף | דגל של הכלי bq | נכס BigQuery API | תיאור |
|---|---|---|---|---|
| מספר הרשומות הלא תקינות שמותרות | מספר השגיאות המותר | --max_bad_records |
maxBadRecords
(Java,
Python)
|
(אופציונלי) המספר המקסימלי של רשומות פגומות ש-BigQuery יכול להתעלם מהן בזמן הרצת המשימה. אם מספר הרשומות הלא תקינות חורג מהערך הזה, תוחזר שגיאה לא חוקית בתוצאת המשימה. ערך ברירת המחדל הוא `0`, כלומר כל הרשומות צריכות להיות תקינות. |
| ערכים לא ידועים | התעלמות מערכים לא ידועים | --ignore_unknown_values |
ignoreUnknownValues
(Java,
Python)
|
(אופציונלי) מציין אם BigQuery צריך לאפשר ערכים נוספים שלא מיוצגים בסכימת הטבלה. אם הערך הוא True, המערכת מתעלמת מהערכים הנוספים. אם הערך הוא false, רשומות עם עמודות נוספות נחשבות לרשומות לא תקינות. אם יש יותר מדי רשומות לא תקינות, מוחזרת שגיאה לא חוקית בתוצאת המשימה. ערך ברירת המחדל הוא False. המאפיין `sourceFormat` קובע מה נחשב ב-BigQuery כערך נוסף: CSV: עמודות נגררות, JSON: ערכים בעלי שם שלא תואמים לאף שם של עמודה. |
| קידוד | ללא | -E או --encoding |
encoding
(Python) |
(אופציונלי) קידוד התווים של הנתונים. הערכים הנתמכים הם: UTF-8, ISO-8859-1, UTF-16BE, UTF-16LE, UTF-32BE או UTF-32LE. ערך ברירת המחדל הוא UTF-8. |
| אזור זמן | אזור זמן | --time_zone |
timeZone
(Java,
Python) |
(אופציונלי) אזור הזמן שמוגדר כברירת מחדל ומוחל כשמנתחים ערכים של חותמות זמן שאין להן אזור זמן ספציפי. שמות תקינים של אזורי זמן אם הערך הזה לא קיים, ערכי חותמת הזמן ללא אזור זמן ספציפי מנותחים באמצעות אזור הזמן שמוגדר כברירת מחדל, UTC. |
| פורמט התאריך | פורמט התאריך | --date_format |
dateFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי DATE בקובצי הקלט (לדוגמה, MM/DD/YYYY). אם הערך הזה קיים, הפורמט הזה הוא פורמט ה-DATE התואם היחיד.
זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATE על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATE מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. |
| פורמט תאריך ושעה | פורמט תאריך ושעה | --datetime_format |
datetimeFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי DATETIME בקובצי הקלט (לדוגמה, MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא הפורמט התואם היחיד של DATETIME.
זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה DATETIME על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה DATETIME מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. |
| פורמט השעה | פורמט השעה | --time_format |
timeFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי TIME בקובצי הקלט (לדוגמה, HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא פורמט TIME התואם היחיד.
זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIME על סמך הפורמט הזה, במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIME מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. |
| פורמט חותמת הזמן | פורמט חותמת הזמן | --timestamp_format |
timestampFormat
(Java,
Python) |
(אופציונלי)
רכיבי פורמט
שמגדירים את הפורמט של ערכי TIMESTAMP בקובצי הקלט (לדוגמה, MM/DD/YYYY HH24:MI:SS.FF3). אם הערך הזה קיים, הפורמט הזה הוא פורמט TIMESTAMP התואם היחיד.
זיהוי אוטומטי של סכימה יקבע גם את סוג העמודה TIMESTAMP על סמך הפורמט הזה במקום הפורמט הקיים. אם הערך הזה לא קיים, השדה TIMESTAMP מנותח באמצעות הפורמטים שמוגדרים כברירת מחדל. |
המאמרים הבאים
- למידע על טעינת נתוני JSON מקובץ מקומי, ראו טעינת נתונים מקבצים מקומיים.
- מידע נוסף על יצירה, הטמעה ושאילתות של נתוני JSON זמין במאמר עבודה עם נתוני JSON ב-GoogleSQL.