


將 Amazon S3 資料載入 BigQuery
您可以使用 Amazon S3 專用的 BigQuery 資料移轉服務連接器,將資料從 Amazon S3 載入 BigQuery。透過 BigQuery 資料移轉服務,您可以安排週期性移轉工作,將 Amazon S3 的最新資料新增至 BigQuery。
如要瞭解 Amazon S3 移轉作業的運作方式,請參閱「Amazon S3 資料移轉簡介」。
限制
Amazon S3 資料移轉作業有下列限制:
- Amazon S3 URI 的 bucket 部分無法參數化。
- 如果將 Write disposition 參數設為
WRITE_TRUNCATE,每次執行作業時,系統都會將所有相符的檔案轉移至 Google Cloud。這可能會產生額外的 Amazon S3 傳出資料移轉費用。如要進一步瞭解執行期間會移轉哪些檔案,請參閱「前置字元比對與萬用字元比對的影響」。 - 不支援從 AWS GovCloud (
us-gov) 區域移轉資料。 - 系統不支援將資料移轉至 BigQuery Omni 位置。
視 Amazon S3 來源資料的格式而定,可能還有其他的限制。詳情請參閱下列資源:
週期性資料移轉作業之間的最短間隔時間為 1 小時。週期性資料移轉作業的預設間隔為 24 小時。
Amazon S3 資料移轉作業支援的 Amazon S3 區域限制,與 Storage 移轉服務相同。詳情請參閱「支援的地區」。
事前準備
建立 Amazon S3 資料移轉作業前:
- 確認您已完成啟用 BigQuery 資料移轉服務的所有必要動作。
- 請建立 BigQuery 資料集來儲存您的資料。
- 建立資料移轉的目的地資料表,並指定結構定義。目的地資料表的名稱必須符合資料表命名規則,目的地資料表名稱也支援參數。您可以建立 BigQuery 資料表或建立 Iceberg 代管資料表。
- 擷取 Amazon S3 URI、存取金鑰 ID 和私密存取金鑰。如要瞭解如何管理存取金鑰,請參閱 AWS 說明文件。
- 如要設定 Pub/Sub 的移轉作業執行通知,您必須具備
pubsub.topics.setIamPolicy權限。如果您只想設定電子郵件通知,則不需要擁有 Pub/Sub 權限。詳情請參閱 BigQuery 資料移轉服務執行通知一文。 - 如果您打算指定客戶自行管理的加密金鑰 (CMEK),請確認服務帳戶具備加密和解密權限,且您擁有使用 CMEK 所需的 Cloud KMS 金鑰資源 ID。如要瞭解 CMEK 如何與 BigQuery 資料移轉服務搭配運作,請參閱「指定移轉作業加密金鑰」。
所需權限
請確認您已授予下列權限。
必要的 BigQuery 角色
如要取得建立 BigQuery 資料移轉服務資料移轉作業所需的權限,請要求管理員授予您專案的 BigQuery 管理員 (roles/bigquery.admin) IAM 角色。如要進一步瞭解如何授予角色,請參閱「管理專案、資料夾和組織的存取權」。
這個預先定義的角色具備建立 BigQuery 資料移轉服務資料移轉作業所需的權限。如要查看確切的必要權限,請展開「Required permissions」(必要權限) 部分:
所需權限
如要建立 BigQuery 資料移轉服務資料移轉作業,您必須具備下列權限:
-
BigQuery 資料移轉服務權限:
-
bigquery.transfers.update -
bigquery.transfers.get
-
-
BigQuery 權限:
-
bigquery.datasets.get -
bigquery.datasets.getIamPolicy -
bigquery.datasets.update -
bigquery.datasets.setIamPolicy -
bigquery.jobs.create
-
詳情請參閱「授予 bigquery.admin 存取權」。
必要的 Amazon S3 角色
請參閱 Amazon S3 的文件,確認您已設定啟用資料移轉所需的任何權限。Amazon S3 來源資料至少必須套用 AWS 代管政策 AmazonS3ReadOnlyAccess。
設定 Amazon S3 資料移轉作業
如何建立 Amazon S3 資料移轉作業:
控制台
前往 Google Cloud 控制台的「Data transfers」(資料移轉) 頁面。
按一下「建立轉移作業」。
在「Create Transfer」(建立轉移作業) 頁面:
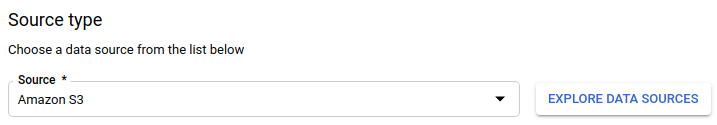
在「Source type」(來源類型) 部分,「Source」(來源) 請選取「Amazon S3」。
在「Transfer config name」(轉移設定名稱) 部分,「Display name」(顯示名稱) 請輸入移轉作業的名稱,例如
My Transfer。移轉作業名稱可以是任意值,日後需要修改移轉作業時能夠據此識別。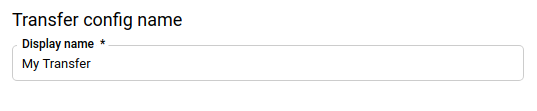
在「Schedule options」(排程選項) 專區:
選取重複頻率。如果選取「Hours」(小時)、「Days」(天)、「Weeks」(週)或「Months」(月),必須一併指定頻率。您也可以選取「Custom」(自訂),建立專屬的重複頻率。如果選取「On-demand」(隨選),這項資料移轉作業會在您手動觸發後執行。
視情況選取「Start now」(立即開始) 或「Start at set time」(在所設時間開始執行),並提供開始日期和執行時間。
在「Destination settings」(目的地設定) 部分:
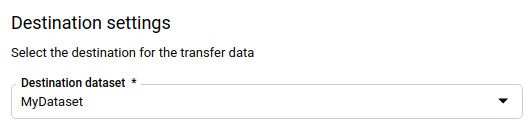
- 在「Dataset」(資料集) 部分,選取您為了儲存資料而建立的資料集。
- 如要移轉至 BigQuery 資料表,請選取「Native table」(原生資料表)。
- 如要移轉至 Iceberg 代管資料表,請選取「Iceberg Managed」。
- 在「Dataset」(資料集) 部分,選取您為了儲存資料而建立的資料集。
在「Data source details」(資料來源詳細資料) 區段:
- 在「Destination table」(目的地資料表),輸入您為了在 BigQuery 儲存資料而建立的資料表名稱。目的地資料表的名稱支援參數。
- 在「Amazon S3 URI」以
s3://mybucket/myfolder/...的格式輸入 URI (支援參數)。 - 在「Access key ID」(存取金鑰 ID) 輸入您的存取金鑰 ID。
- 在「Secret access key」(私密存取金鑰) 輸入您的私密存取金鑰。
- 在「File format」(檔案格式) 選取資料格式:JSON (以換行符號分隔)、CSV、Avro、Parquet 或 ORC。
- 在「Write Disposition」(寫入配置) 選取下列其中一個選項:
- 「
WRITE_APPEND」:逐步將新的資料附加至現有目的地資料表。「Write preference」(寫入偏好設定) 的預設值為WRITE_APPEND。 WRITE_TRUNCATE:在每次執行資料移轉作業時,覆寫目的地資料表中的資料。
- 「
如要進一步瞭解 BigQuery 資料移轉服務如何使用
WRITE_APPEND或WRITE_TRUNCATE擷取資料,請參閱 Amazon S3 移轉作業資料擷取的相關說明。如要進一步瞭解writeDisposition欄位,請參閱JobConfigurationLoad。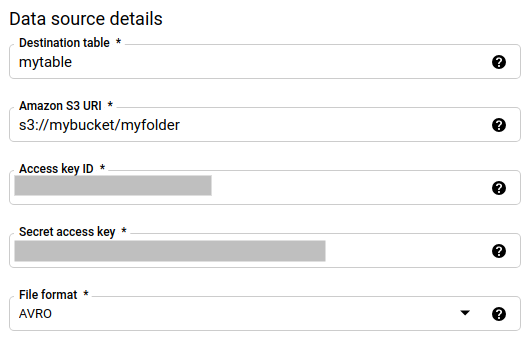
在「Transfer Options - All Formats」(移轉選項 - 所有格式) 部分執行下列操作:
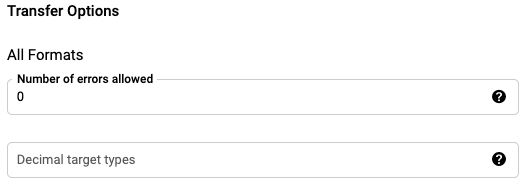
- 在「Number of errors allowed」(允許的錯誤數量) 部分,輸入可以忽略的損壞記錄數量上限 (整數值)。
- (選用步驟) 在「Decimal target types」(小數目標類型) 部分,輸入以半形逗號分隔的清單,內含來源小數值可能轉換成的 SQL 資料類型。系統會依據下列條件,選取要轉換的 SQL 資料類型:
- 系統會按照 NUMERIC、BIGNUMERIC 和 STRING 的順序,選取下列清單中第一個支援來源資料有效位數和小數位數的資料類型,做為要轉換的資料類型。
- 如果清單中的資料類型都不支援有效位數和小數位數,則會選取指定清單中支援範圍最廣的資料類型。如果讀取來源資料時,值超過支援的範圍,就會擲回錯誤。
- 資料類型 STRING 支援所有有效位數和小數位數值。
- 如果將這個欄位留空,ORC 的預設資料類型為「NUMERIC, STRING」(NUMERIC、STRING),其他檔案格式則為「NUMERIC」。
- 這個欄位不得含有重複的資料類型。
- 您在這個欄位提供資料類型時採用的順序不會有影響。
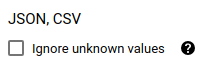
如果您選取的檔案格式為 CSV 或 JSON,請在「JSON, CSV」(JSON、CSV) 部分勾選「Ignore unknown values」(略過不明的值),接受所含值不符合結構定義的資料列。系統會忽略不明的值。對於 CSV 檔案,此選項會忽略每行結尾處額外的值。
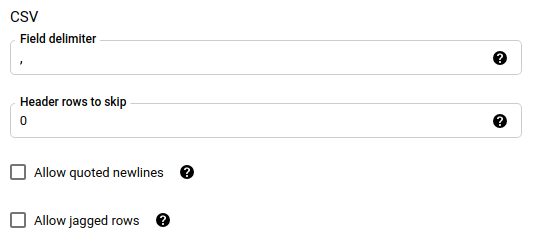
如果您選取的檔案格式為 CSV,請在「CSV」部分針對要載入的資料輸入額外的 CSV 選項。
在「Service Account」(服務帳戶) 選單,選取與您的Google Cloud 專案相關聯的服務帳戶。您可以將服務帳戶與資料移轉作業建立關聯,這樣就不需要使用者憑證。如要進一步瞭解如何搭配使用服務帳戶與資料移轉作業,請參閱使用服務帳戶的相關說明。
如果使用 CMEK,請在「Advanced options」(進階選項) 部分選取「Customer-managed key」(客戶管理的金鑰)。畫面隨即會列出可用的 CMEK 供您選擇。
(選用) 在「Notification options」(通知選項) 區段中:
按一下 [儲存]。
bq
輸入 bq mk 指令,並提供轉移建立旗標 --transfer_config。
bq mk \
--transfer_config \
--project_id=project_id \
--data_source=data_source \
--display_name=name \
--target_dataset=dataset \
--service_account_name=service_account \
--destination_kms_key=destination_key \
--params='parameters'
其中:
- project_id:選用。您的 Google Cloud 專案 ID。如未提供
--project_id來指定特定專案,系統會使用預設專案。 - data_source:必填,資料來源:
amazon_s3。 - display_name:必填,資料移轉設定的顯示名稱。移轉作業名稱可以是任意值,日後需要修改移轉作業時,能夠據此識別即可。
- dataset:必填,資料移轉設定的目標資料集。
- service_account:用於驗證資料移轉作業的服務帳戶名稱。服務帳戶應由用於建立資料移轉作業的
project_id所擁有,且應具備所有必要權限。 - destination_key:選用。Cloud KMS 金鑰資源 ID,例如
projects/project_name/locations/us/keyRings/key_ring_name/cryptoKeys/key_name。 parameters:必填,已建立移轉設定的參數,採用 JSON 格式。例如:
--params='{"param":"param_value"}'。以下是 Amazon S3 移轉作業的參數:- destination_table_name_template:必填,目的地資料表的名稱。
data_path:必填,Amazon S3 URI,格式如下:
s3://mybucket/myfolder/...URI 也支援參數。
access_key_id:必填,存取金鑰 ID。
secret_access_key:必填,您的存取密鑰。
file_format:選用。指出要轉移的檔案類型:
CSV、JSON、AVRO、PARQUET或ORC。預設值為CSV。write_disposition:選用。
WRITE_APPEND只會轉移上次成功執行後修改的檔案。WRITE_TRUNCATE會移轉所有相符檔案,包括先前執行時已移轉的檔案。預設值為WRITE_APPEND。max_bad_records:選用。允許的不良記錄數量。預設值為
0。decimal_target_types:選用。以半形逗號分隔的清單,列出來源小數值可能轉換成的 SQL 資料類型。如果未提供這個欄位,ORC 的預設資料類型為「NUMERIC, STRING」(NUMERIC、STRING),其他檔案格式則為「NUMERIC」。
ignore_unknown_values:選用,如果 file_format 不是
JSON或CSV,則會忽略。是否忽略資料中的不明值。field_delimiter:選用,僅適用於
file_format為CSV的情況。分隔欄位的字元。預設值為半形逗號。skip_leading_rows:選用,且僅在 file_format 為
CSV時適用。指出您不想匯入的標題列數。預設值為0。allow_quoted_newlines:選用,僅適用於 file_format 為
CSV的情況。指出是否允許在引用的欄位中使用換行符號。allow_jagged_rows:選用,且僅在 file_format 為
CSV時適用。指出是否接受缺少結尾選用欄的資料列。遺漏的值會填入 NULL。
舉例來說,下列指令會使用 s3://mybucket/myfile/*.csv 的 data_path 值、目標資料集 mydataset 和 file_format
CSV,建立名為 My Transfer 的 Amazon S3 資料移轉作業。這個範例包含與 CSV 檔案格式 相關聯的選用參數非預設值。
資料移轉作業會在預設專案中建立:
bq mk --transfer_config \
--target_dataset=mydataset \
--display_name='My Transfer' \
--params='{"data_path":"s3://mybucket/myfile/*.csv",
"destination_table_name_template":"MyTable",
"file_format":"CSV",
"write_disposition":"WRITE_APPEND",
"max_bad_records":"1",
"ignore_unknown_values":"true",
"field_delimiter":"|",
"skip_leading_rows":"1",
"allow_quoted_newlines":"true",
"allow_jagged_rows":"false"}' \
--data_source=amazon_s3
執行指令後,您會收到如下的訊息:
[URL omitted] Please copy and paste the above URL into your web browser and
follow the instructions to retrieve an authentication code.
請按照指示進行操作,並在指令列中貼上驗證碼。
API
請使用 projects.locations.transferConfigs.create 方法,並提供 TransferConfig 資源的執行個體。
Java
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Java 設定說明操作。詳情請參閱 BigQuery Java API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
前置比對與萬用字元比對的影響
Amazon S3 API 支援前置字元比對,但不支援萬用字元比對。所有符合前置字元的 Amazon S3 檔案都會移轉至 Google Cloud。不過,只有與移轉設定中的 Amazon S3 URI 相符的檔案,才會實際載入 BigQuery。這可能會導致已移轉但未載入 BigQuery 的檔案產生過多的 Amazon S3 傳出資料移轉費用。
舉例來說,假設資料路徑如下:
s3://bucket/folder/*/subfolder/*.csv
來源位置中的這些檔案:
s3://bucket/folder/any/subfolder/file1.csv
s3://bucket/folder/file2.csv
這樣一來,所有前置字元為 s3://bucket/folder/ 的 Amazon S3 檔案都會移轉至 Google Cloud。在本範例中,file1.csv 和 file2.csv 都會轉移。
不過,只有符合 s3://bucket/folder/*/subfolder/*.csv 的檔案才會實際載入 BigQuery。在這個範例中,只有 file1.csv 會載入 BigQuery。
在轉移作業中指定加密金鑰
您可以指定客戶自行管理的加密金鑰 (CMEK),為移轉作業執行的資料加密。您可以使用 CMEK 支援從 Amazon Simple Storage Service (Amazon S3) 移轉資料。使用移轉作業指定 CMEK 時,BigQuery 資料移轉服務會將 CMEK 套用至任何擷取資料的中繼磁碟快取,確保整個資料移轉工作流程符合 CMEK 規範。
如果轉移作業最初並未以 CMEK 建立,您就無法更新現有轉移作業來新增 CMEK。舉例來說,您無法將原本預設加密的目的地資料表變更為使用 CMEK 加密。反之,您也無法變更以 CMEK 加密的目的地資料表,改用其他類型的加密。
如果移轉設定最初是使用 CMEK 加密建立,您可以更新移轉的 CMEK。更新移轉設定的 CMEK 時,BigQuery 資料移轉服務會在下次執行移轉作業時,將 CMEK 傳播至目的地資料表,並在移轉作業執行期間,以新的 CMEK 取代任何過時的 CMEK。詳情請參閱「更新移轉作業」。
您也可以使用專案預設金鑰。 指定移轉作業的專案預設金鑰時,BigQuery 資料移轉服務會將專案預設金鑰,設為任何新移轉設定的預設金鑰。
排解轉移設定問題
如果無法順利設定資料移轉作業,請參閱「Amazon S3 移轉問題」。
後續步驟
- 如要瞭解 BigQuery 資料移轉服務,請參閱「BigQuery 資料移轉服務簡介」。
- 如要瞭解如何使用資料移轉作業,包括取得移轉設定資訊、列出移轉設定,以及查看移轉作業的執行記錄,請參閱「使用移轉作業」。
- 瞭解如何透過 BigQuery Omni 作業載入資料。