


העברה מ-Oracle ל-BigQuery
במאמר הזה מוסבר באופן כללי איך עוברים מ-Oracle ל-BigQuery. הוא מתאר את ההבדלים הבסיסיים בארכיטקטורה ומציע דרכים להעברת מחסני נתונים (data warehouses) ו-data marts שפועלים ב-Oracle RDBMS (כולל Exadata) ל-BigQuery. הפרטים במסמך הזה רלוונטיים גם ל-Exadata, ל-ExaCC ול-Oracle Autonomous Data Warehouse, כי הם משתמשים בתוכנה תואמת של Oracle.
המסמך הזה מיועד לאדריכלי מערכות ארגוניות, למנהלי מסדי נתונים, למפתחי אפליקציות ולמומחי אבטחת מידע שרוצים לעבור מ-Oracle ל-BigQuery ולפתור אתגרים טכניים בתהליך ההעברה.
אפשר גם להשתמש בתרגום SQL באצווה כדי להעביר את הסקריפטים של SQL בכמות גדולה, או בתרגום SQL אינטראקטיבי כדי לתרגם שאילתות אד-הוק. שני הכלים תומכים ב-Oracle SQL, ב-PL/SQL וב-Exadata בגרסת טרום-השקה (Preview).
לפני ההעברה
כדי להבטיח שההעברה של מחסן הנתונים תתבצע בהצלחה, כדאי להתחיל לתכנן את אסטרטגיית ההעברה בשלב מוקדם בציר הזמן של הפרויקט. במאמר מה להעביר ואיך: מסגרת ההעברה מוסבר איך לתכנן את תהליך ההעברה באופן שיטתי.
תכנון קיבולת ב-BigQuery
מאחורי הקלעים, קצב הניתוח ב-BigQuery נמדד במשבצות. יחידת קיבולת של BigQuery היא יחידה קניינית של Google לקיבולת חישובית שנדרשת כדי להריץ שאילתות SQL.
מערכת BigQuery מחשבת באופן רציף כמה יחידות קיבולת נדרשות לשאילתות בזמן שהן פועלות, אבל מקצה יחידות קיבולת לשאילתות על סמך מתזמן הוגן.
כשמתכננים את הקיבולת של יחידות ה-SQL ב-BigQuery, אפשר לבחור בין המודלים הבאים לתמחור:
תמחור על פי דרישה: בתמחור על פי דרישה, BigQuery מחייב על מספר הבייטים שעובדו (גודל הנתונים), כך שאתם משלמים רק על השאילתות שאתם מריצים. איך BigQuery מחשב את גודל הנתונים? מכיוון שה-slots קובעים את קיבולת החישוב הבסיסית, אתם יכולים לשלם על השימוש ב-BigQuery בהתאם למספר ה-slots שאתם צריכים (במקום לפי מספר הבייטים שעובדו). כברירת מחדל,פרויקטים ב- Google Cloud מוגבלים ל-2,000 משבצות לכל היותר.
תמחור מבוסס-קיבולת: בתמחור מבוסס-קיבולת, אתם רוכשים מערכים שמורים של יחידות קיבולת ב-BigQuery (מינימום 100) במקום לשלם על הבייטים שעובדו על ידי שאילתות שהרצתם. אנחנו ממליצים על תמחור מבוסס-קיבולת לעומסי עבודה של מחסני נתונים ארגוניים, שבהם בדרך כלל יש הרבה שאילתות דיווח ושאילתות ELT (חילוץ, טעינה וטרנספורמציה) בו-זמניות, עם צריכה צפויה.
כדי להעריך את מספר ה-slots, מומלץ להגדיר מעקב אחרי BigQuery באמצעות Cloud Monitoring ולנתח את יומני הביקורת באמצעות BigQuery. לקוחות רבים משתמשים ב-Data Studio (לדוגמה, ראו דוגמה בקוד פתוח של לוח בקרה ב-Data Studio), ב-Looker או ב-Tableau כממשקי משתמש להצגה חזותית של נתוני יומן הביקורת של BigQuery, במיוחד לשימוש ב-slots בשאילתות ובפרויקטים. אתם יכולים גם להשתמש בנתונים מטבלאות המערכת של BigQuery כדי לעקוב אחרי השימוש ב-slots במשימות ובהזמנות. כאן תוכלו לראות דוגמה בקוד פתוח ללוח בקרה ב-Data Studio.
מעקב וניתוח קבועים של ניצול ה-slots עוזרים לכם להעריך כמה slots בסך הכול הארגון שלכם צריך ככל שהוא גדל ב- Google Cloud.
לדוגמה, נניח שבהתחלה אתם שומרים 4,000 יחידות קיבולת של BigQuery כדי להריץ בו-זמנית 100 שאילתות ברמת מורכבות בינונית. אם אתם מבחינים בזמני המתנה ארוכים בתוכניות הרצה של השאילתות, ובלוחות הבקרה מוצג ניצול גבוה של יחידות קיבולת של BigQuery, יכול להיות שאתם צריכים עוד יחידות קיבולת של BigQuery כדי לתמוך בעומסי העבודה. אם אתם רוצים לרכוש משבצות בעצמכם באמצעות התחייבויות לשנה או לשלוש שנים, אתם יכולים להתחיל להשתמש בהזמנות ב-BigQuery באמצעות מסוף Google Cloud או כלי שורת הפקודה של bq.
אם יש לכם שאלות לגבי התוכנית הנוכחית והאפשרויות שצוינו, פנו לנציג המכירות.
אבטחה ב- Google Cloud
בקטעים הבאים מתוארים אמצעי האבטחה הנפוצים של Oracle, ואיך אתם יכולים לוודא שמחסן הנתונים שלכם מוגן בסביבת Google Cloud.
ניהול זהויות והרשאות גישה (IAM)
ב-Oracle יש משתמשים, הרשאות, תפקידים ופרופילים לניהול הגישה למשאבים.
ב-BigQuery משתמשים ב-IAM כדי לנהל את הגישה למשאבים, ולקבל ניהול הרשאות גישה מרכזי למשאבים ולפעולות. סוגי המשאבים שזמינים ב-BigQuery כוללים ארגונים, פרויקטים, מערכי נתונים, טבלאות ותצוגות. בהיררכיית המדיניות של IAM, מערכי הנתונים הם משאבי צאצא של פרויקטים. טבלה מקבלת בירושה את ההרשאות של מערך הנתונים שמכיל אותה.
כדי לתת גישה למשאב, מקצים תפקיד אחד או יותר למשתמש, לקבוצה או לחשבון שירות. תפקידים ברמת הארגון והפרויקט משפיעים על היכולת להריץ משימות או לנהל את הפרויקט, ואילו תפקידים ברמת מערך הנתונים משפיעים על היכולת לגשת לנתונים שבתוך הפרויקט או לשנות אותם.
אלה סוגי התפקידים ב-IAM:
- תפקידים מוגדרים מראש נועדו לתמוך בתרחישים נפוצים לדוגמה ובדפוסי בקרת גישה. תפקידים מוגדרים מראש מאפשרים גישה פרטנית לשירותים ספציפיים ומנוהלים ב- Google Cloud.
תפקידים בסיסיים כוללים את התפקידים "בעלים", "עריכה" ו"צפייה".
תפקידים בהתאמה אישית מאפשרים גישה פרטנית בהתאם לרשימת ההרשאות שנבחרו.
כשמקצים למשתמש גם תפקידים מוגדרים מראש וגם תפקידים בסיסיים, ההרשאות שניתנות הן איחוד של ההרשאות של כל תפקיד בנפרד.
אבטחה ברמת השורה
Oracle Label Security (OLS) מאפשר להגביל את הגישה לנתונים ברמת השורה. תרחיש לדוגמה של אבטחה ברמת השורה הוא הגבלת הגישה של איש מכירות לחשבונות שהוא מנהל. הטמעה של אבטחה ברמת השורה מאפשרת לכם להשתמש בבקרת גישה מפורטת.
כדי להשיג אבטחה ברמת השורה ב-BigQuery, אתם יכולים להשתמש בתצוגות מורשות ובכללי מדיניות גישה ברמת השורה. במאמר מבוא לאבטחה ברמת השורה ב-BigQuery מוסבר איך לתכנן ולהטמיע את כללי המדיניות האלה.
הצפנת דיסק שלם (FDE)
ב-Oracle יש הצפנת נתונים שקופה (TDE) והצפנת רשת להצפנת נתונים במנוחה ובמעבר. כדי להשתמש ב-TDE צריך את האפשרות Advanced Security, שניתנת ברישיון נפרד.
כברירת מחדל, BigQuery מצפין את כל הנתונים במצב מנוחה ובמעבר, בלי קשר למקור או לכל תנאי אחר, ואי אפשר להשבית את ההצפנה הזו. BigQuery תומך גם במפתחות הצפנה בניהול הלקוח (CMEK) למשתמשים שרוצים לשלוט במפתחות להצפנת מפתחות ולנהל אותם ב-Cloud Key Management Service. למידע נוסף על הצפנה ב- Google Cloud, קראו את המאמרים ברירת המחדל של הצפנה במנוחה והצפנה במעבר.
אנונימיזציה והשמטה של נתונים
ב-Oracle משתמשים בהסתרת נתונים ב-Real Application Testing ובהשמטת נתונים, שמאפשרת להסתיר (להשמיט) נתונים שמוחזרים משאילתות שהונפקו על ידי אפליקציות.
ב-BigQuery יש תמיכה בהסתרת מידע דינמית ברמת העמודה. אתם יכולים להשתמש בהסתרת נתונים כדי להסתיר באופן סלקטיבי נתונים בעמודות מקבוצות של משתמשים, ועדיין לאפשר גישה לעמודה.
אתם יכולים להשתמש ב-Sensitive Data Protection כדי לזהות ולצנזר פרטים אישיים מזהים (PII) רגישים ב-BigQuery.
השוואה בין BigQuery ל-Oracle
בקטע הזה מתוארים ההבדלים העיקריים בין BigQuery לבין Oracle. הדגשים האלה עוזרים לזהות מכשולים בהעברה ולתכנן את השינויים הנדרשים.
ארכיטקטורת המערכת
אחד ההבדלים העיקריים בין Oracle ל-BigQuery הוא ש-BigQuery הוא מחסן נתונים ארגוני (EDW) בענן ללא שרת, עם שכבות אחסון ומחשוב נפרדות שאפשר לשנות את הגודל שלהן בהתאם לצורכי השאילתה. בגלל אופי ההצעה של BigQuery ללא שרת, אתם לא מוגבלים על ידי החלטות שקשורות לחומרה. במקום זאת, אתם יכולים לבקש יותר משאבים לשאילתות ולמשתמשים שלכם באמצעות הזמנות. בנוסף, ב-BigQuery אין צורך להגדיר את התוכנה והתשתית הבסיסיות, כמו מערכת ההפעלה (OS), מערכות הרשת ומערכות האחסון, כולל התאמה לעומס וזמינות גבוהה. ב-BigQuery, פעולות הניהול, האדמינסטרציה וההתאמה לעומס (scaling) מתבצעות באופן אוטומטי. התרשים הבא ממחיש את היררכיית האחסון ב-BigQuery.
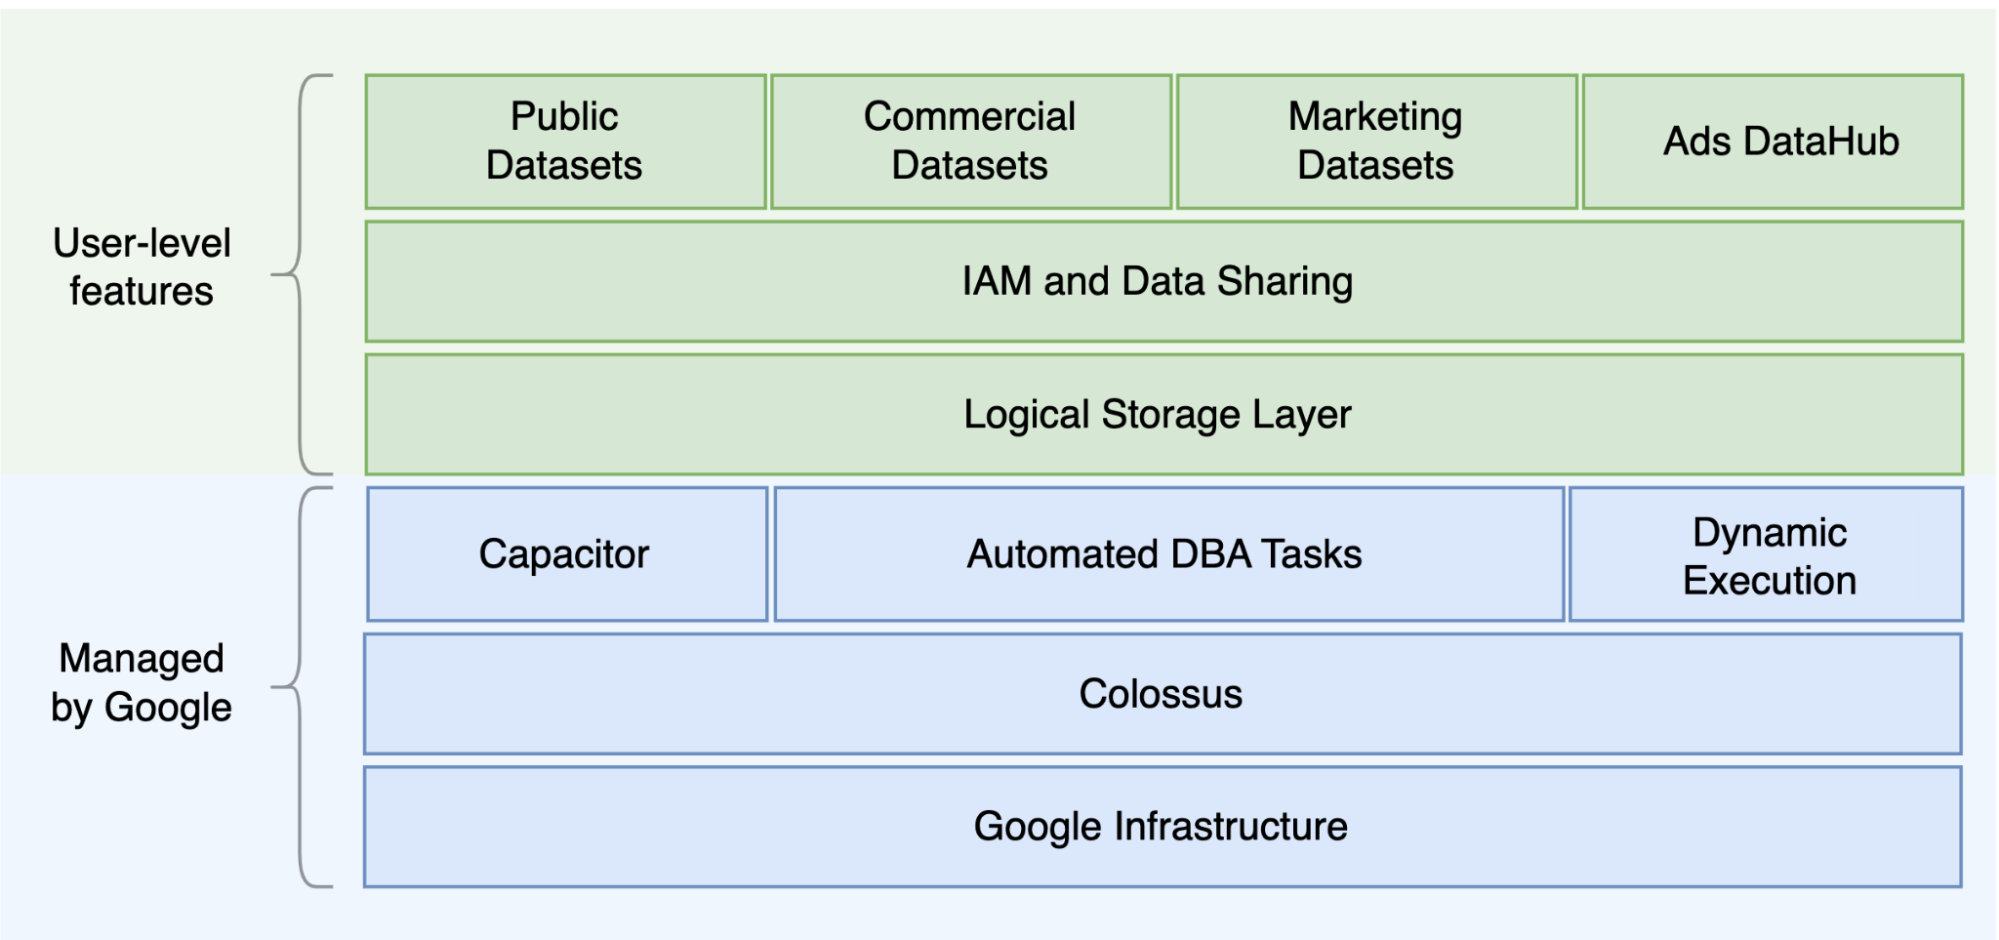
כדי להבין את ההבדלים בהתנהגות ולשפר את ביצועי השאילתות ואת היעילות הכלכלית, כדאי להכיר את הארכיטקטורה הבסיסית של האחסון ושל עיבוד השאילתות, כמו ההפרדה בין האחסון (Colossus) לבין הרצת השאילתות (Dremel), ואיך מוקצים המשאבים ב-Google Cloud (Borg). לפרטים, ראו את ארכיטקטורות המערכת של BigQuery, Oracle ו-Exadata.
ארכיטקטורת נתונים ואחסון
מבנה הנתונים והאחסון הוא חלק חשוב בכל מערכת לניתוח נתונים, כי הוא משפיע על ביצועי השאילתות, העלות, יכולת ההתאמה לעומס והיעילות.
ב-BigQuery יש הפרדה בין אחסון הנתונים לבין העיבוד שלהם. הנתונים נדחסים ומאוחסנים ב-Colossus בפורמט עמודות שנקרא Capacitor.
ב-BigQuery, הנתונים הדחוסים מעובדים ישירות באמצעות Capacitor, בלי לפרוס אותם. כפי שמוצג בתרשים שלמעלה, BigQuery מספק מערכי נתונים בתור ההפשטה ברמה הגבוהה ביותר לארגון הגישה לטבלאות. אפשר להשתמש בסכימות ובתוויות כדי לארגן את הטבלאות בצורה טובה יותר. ב-BigQuery אפשר להשתמש בחלוקה למחיצות כדי לשפר את הביצועים של השאילתות, להוזיל את העלויות ולנהל את מחזור החיים של המידע. משאבי האחסון מוקצים כשאתם משתמשים בהם, ומוסרים כשאתם מסירים נתונים או מוחקים טבלאות.
ב-Oracle, הנתונים נשמרים בפורמט של שורות באמצעות פורמט הבלוקים של Oracle, שמסודר בפלחים. סכימות (בבעלות המשתמשים) משמשות לארגון טבלאות ואובייקטים אחרים של מסד הנתונים. החל מגרסה 12c של Oracle, משתמשים בריבוי דיירים (multitenancy) כדי ליצור מסדי נתונים שאפשר לחבר למכונה אחת של מסד נתונים, לצורך בידוד נוסף. אפשר להשתמש בחלוקה למחיצות כדי לשפר את ביצועי השאילתות ואת פעולות מחזור החיים של המידע. Oracle מציעה כמה אפשרויות אחסון למסדי נתונים עצמאיים ולמסדי נתונים של Real Application Clusters (RAC), כמו ASM, מערכת קבצים של מערכת הפעלה ומערכת קבצים של אשכול.
ב-Exadata יש תשתית אחסון אופטימלית בשרתי תאי אחסון, שמאפשרת לשרתי Oracle לגשת לנתונים האלה באופן שקוף באמצעות ASM. ב-Exadata יש אפשרויות של Hybrid Columnar Compression (HCC), כדי שהמשתמשים יוכלו לדחוס טבלאות ומחיצות.
ב-Oracle צריך להקצות מראש נפח אחסון, להגדיר בקפידה את הגודל ולהגדיר הגדלה אוטומטית של פלחים, קובצי נתונים ומרחבי טבלאות.
ביצוע וביצועים של שאילתות
BigQuery מנהל את הביצועים ומשתנה בהתאם לעומס ברמת השאילתה, כדי למקסם את הביצועים ביחס לעלות. ב-BigQuery יש הרבה אופטימיזציות, למשל:
- הרצת שאילתות בזיכרון
- ארכיטקטורת עץ בכמה רמות שמבוססת על מנוע ההפעלה Dremel
- אופטימיזציה אוטומטית של האחסון ב-Capacitor
- רוחב פס כולל של פטה-ביט אחד לשנייה עם Jupiter
- ניהול משאבים בהתאמה אוטומטית לעומס (automatic scaling) כדי לספק שאילתות מהירות בקנה מידה של פטה-בייט
בזמן טעינת הנתונים, BigQuery אוסף נתונים סטטיסטיים על העמודות וכולל מידע לאבחון תוכנית לביצוע שאילתה והתזמון. המשאבים של השאילתות מוקצים בהתאם לסוג השאילתה ולמורכבות שלה. כל שאילתה משתמשת במספר מסוים של משבצות, שהן יחידות חישוב שכוללות כמות מסוימת של מעבד (CPU) ו-RAM.
ב-Oracle יש משימות לאיסוף נתונים סטטיסטיים. האופטימיזציה של מסד הנתונים משתמשת בנתונים סטטיסטיים כדי לספק תוכניות ביצוע אופטימליות. יכול להיות שיהיה צורך באינדקסים לחיפושי שורות מהירים ולפעולות איחוד (join). בנוסף, Oracle מספקת מאגר עמודות בזיכרון לניתוח נתונים בזיכרון. ב-Exadata יש כמה שיפורים בביצועים, כמו סריקה חכמה של תאים, אינדקסים של אחסון, מטמון Flash וחיבורי InfiniBand בין שרתי אחסון לשרתי מסדי נתונים. אפשר להשתמש ב-Real Application Clusters (RAC) כדי להשיג זמינות גבוהה של השרת ולהתאים את קנה המידה של אפליקציות מסד נתונים שדורשות שימוש אינטנסיבי במעבד (CPU), באמצעות אותו אחסון בסיסי.
כדי לשפר את ביצועי השאילתות ב-Oracle, צריך לבחון בקפידה את האפשרויות האלה ואת הפרמטרים של מסד הנתונים. Oracle מספקת כמה כלים לכוונון הביצועים, כמו Active Session History (ASH), Automatic Database Diagnostic Monitor (ADDM), דוחות Automatic Workload Repository (AWR), SQL monitoring, Tuning Advisor ו-Undo and Memory Tuning Advisors.
ניתוח נתונים גמיש
ב-BigQuery אתם יכולים לאפשר לפרויקטים, למשתמשים ולקבוצות שונים לשלוח שאילתות למערכי נתונים בפרויקטים שונים. הפרדת הרצת השאילתות מאפשרת לצוותים אוטונומיים לעבוד בתוך הפרויקטים שלהם בלי להשפיע על משתמשים ופרויקטים אחרים, על ידי הפרדת מכסות המשבצות והחיוב על שאילתות מפרויקטים אחרים ומהפרויקטים שמארחים את מערכי הנתונים.
זמינות גבוהה, גיבויים ותוכנית התאוששות מאסון (DR)
Oracle מספקת את Data Guard כפתרון לתוכנית התאוששות מאסון (DR) ולרפליקה של מסדי נתונים. אפשר להגדיר Real Application Clusters (RAC) לזמינות של השרת. אפשר להגדיר גיבויים של Recovery Manager (RMAN) למסד הנתונים ול-archivelog, ולהשתמש בהם גם לפעולות שחזור. אפשר להשתמש בתכונה Flashback database כדי להחזיר את מסד הנתונים לנקודת זמן ספציפית. מרחב הטבלאות לביטול מכיל תמונות מצב של טבלאות. אפשר לשלוח שאילתות לתמונות מצב ישנות באמצעות שאילתת פלאשבק וסעיפי השאילתה as of, בהתאם לפעולות DML/DDL שבוצעו קודם לכן ולהגדרות undo retention. ב-Oracle, צריך לנהל את כל התקינות של מסד הנתונים במרחבי טבלאות שתלויים במטא-נתונים של המערכת, בביטול ובמרחבי הטבלאות התואמים, כי עקביות חזקה חשובה לגיבוי של Oracle, והליכי השחזור צריכים לכלול נתונים ראשיים מלאים. אם לא צריך שחזור מערכת מנקודה מסוימת בזמן (PITR) ב-Oracle, אפשר לתזמן ייצוא ברמת הסכימה של הטבלה.
BigQuery הוא מחסן נתונים מנוהל, והוא שונה ממערכות מסורתיות של מסדי נתונים בפונקציונליות הגיבוי המלאה שלו. אתם לא צריכים לדאוג לגבי תקלות בשרתים ובאחסון, באגים במערכת ופגיעה פיזית בנתונים. כדי למקסם את האמינות והזמינות, מערכת BigQuery משכפלת נתונים במרכזי נתונים שונים בהתאם למיקום של מערך הנתונים. הפונקציונליות של BigQuery במספר אזורים יוצרת רפליקה של נתונים באזורים שונים, ומגינה מפני חוסר זמינות של אזור אחד בתוך האזור. הפונקציונליות של BigQuery באזור יחיד משכפלת נתונים בין אזורים שונים באותו אזור.
בעזרת המסע בזמן, ב-BigQuery אתם יכולים להריץ שאילתות על תמונות מצב היסטוריות של טבלאות עד שבעה ימים, ולשחזר טבלאות שנמחקו תוך יומיים.
אפשר להעתיק טבלה שנמחקה (כדי לשחזר אותה) באמצעות תחביר של קובץ snapshot (dataset.table@timestamp). אפשר לייצא נתונים מטבלאות ב-BigQuery לצורכי גיבוי נוספים, כמו שחזור מפעולות משתמש מקריות. אפשר להשתמש באסטרטגיית גיבוי ובלוחות זמנים מוכחים שמשמשים למערכות קיימות של מחסני נתונים (DWH).
פעולות באצווה וטכניקת ה-snapshotting מאפשרות אסטרטגיות גיבוי שונות ל-BigQuery, כך שלא צריך לייצא טבלאות ומחיצות ללא שינוי לעיתים קרובות. מספיק גיבוי ייצוא אחד של המחיצה או הטבלה אחרי סיום פעולת הטעינה או ה-ETL. כדי להוזיל את עלות הגיבוי, אתם יכולים לאחסן קובצי ייצוא ב-Nearline Storage או ב-Coldline Storage ב-Cloud Storage, ולהגדיר מדיניות מחזור חיים למחיקת קבצים אחרי פרק זמן מסוים, בהתאם לדרישות של שמירת הנתונים.
שמירה במטמון
ב-BigQuery יש מטמון לכל משתמש, ואם הנתונים לא משתנים, תוצאות השאילתות נשמרות במטמון למשך כ-24 שעות. אם התוצאות מאוחזרות מהמטמון, השאילתה לא עולה כלום.
ב-Oracle יש כמה מטמונים לנתונים ולתוצאות של שאילתות, כמו מטמון מאגר נתונים, מטמון תוצאות, מטמון Exadata Flash ומאגר עמודות בזיכרון.
חיבורים
BigQuery מטפל בניהול החיבורים, ואין צורך לבצע הגדרות בצד השרת. ב-BigQuery יש מנהלי התקנים של JDBC ו-ODBC. אפשר להשתמש במסוףGoogle Cloud או ב-bq command-line tool כדי לשלוח שאילתות באופן אינטראקטיבי. אתם יכולים להשתמש בממשקי API בארכיטקטורת REST ובספריות לקוח כדי לקיים אינטראקציה עם BigQuery באופן פרוגרמטי. אתם יכולים לקשר את Google Sheets ישירות ל-BigQuery ולהשתמש במנהלי התקנים של ODBC ו-JDBC כדי להתחבר ל-Excel. אם אתם מחפשים לקוח למחשב, יש כלים חינמיים כמו DBeaver.
Oracle מספקת מאזינים, שירותים, רכיבי טיפול בשירותים, כמה פרמטרים של הגדרה וכוונון, ושרתים משותפים וייעודיים לטיפול בחיבורים של מסדי נתונים. Oracle מספקת מנהלי התקנים של JDBC, JDBC Thin ו-ODBC, וחיבורים של Oracle Client ו-TNS. כדי להגדיר RAC צריך מאזיני SCAN, כתובות IP של SCAN ושם SCAN.
תמחור ורישוי
Oracle דורשת עמלות רישיון ותמיכה על סמך מספר הליבות של מהדורות מסד הנתונים ואפשרויות מסד הנתונים, כמו RAC, ריבוי דיירים (multitenant), Active Data Guard, חלוקה למחיצות, בזיכרון, Real Application Testing, GoldenGate, Spatial ו-Graph.
ב-BigQuery יש אפשרויות תמחור גמישות שמבוססות על השימוש באחסון, בשאילתות ובהזנת זרם נתונים. ב-BigQuery יש תמחור מבוסס-קיבולת ללקוחות שצריכים עלות צפויה וקיבולת משבצות באזורים ספציפיים. ה-slots שמשמשים להזנת זרם נתונים ולטעינות לא נספרים בקיבולת ה-slots של הפרויקט. כדי להחליט כמה חריצים לרכוש למחסן הנתונים, קראו את המאמר תכנון קיבולת ב-BigQuery.
בנוסף, ב-BigQuery עלויות האחסון של נתונים שלא השתנו במשך יותר מ-90 יום נחתכות אוטומטית בחצי.
תוויות
אפשר להוסיף תוויות למערכי נתונים, לטבלאות ולתצוגות ב-BigQuery באמצעות צמדים של מפתח/ערך. אפשר להשתמש בתוויות כדי להבדיל בין עלויות האחסון לבין החזרים כספיים פנימיים.
מעקב ורישום ביומן הביקורת
Oracle מספקת רמות וסוגים שונים של אפשרויות לביקורת מסדי נתונים, וגם תכונות של כספת ביקורת וחומת אש של מסד נתונים, שהרישיון שלהן נפרד. אורקל מספקת את Enterprise Manager למעקב אחרי מסדי נתונים.
ב-BigQuery, יומני הביקורת של Cloud משמשים גם ליומני גישה לנתונים וגם ליומני ביקורת, שמופעלים כברירת מחדל. יומני הגישה לנתונים זמינים למשך 30 ימים, ויומני הפעילות של האדמינים ואירועי המערכת האחרים זמינים למשך 400 ימים. אם אתם צריכים לשמור את היומנים לפרק זמן ארוך יותר, אתם יכולים לייצא אותם ל-BigQuery, ל-Cloud Storage או ל-Pub/Sub, כמו שמתואר במאמר ניתוח של יומני אבטחה ב- Google Cloud. אם צריך לשלב עם כלי קיים למעקב אחרי אירועים, אפשר להשתמש ב-Pub/Sub לייצוא, ולפתח בכלי הקיים פיתוח בהתאמה אישית כדי לקרוא יומנים מ-Pub/Sub.
יומני הביקורת כוללים את כל הקריאות ל-API, הצהרות השאילתות והסטטוסים של המשימות. אתם יכולים להשתמש ב-Cloud Monitoring כדי לעקוב אחרי הקצאת ה-slots, הבייטים שנסרקו בשאילתות ונשמרו, ומדדים אחרים של BigQuery. אפשר להשתמש בתוכנית השאילתות ובציר הזמן של BigQuery כדי לנתח את שלבי השאילתות ואת הביצועים שלהן.
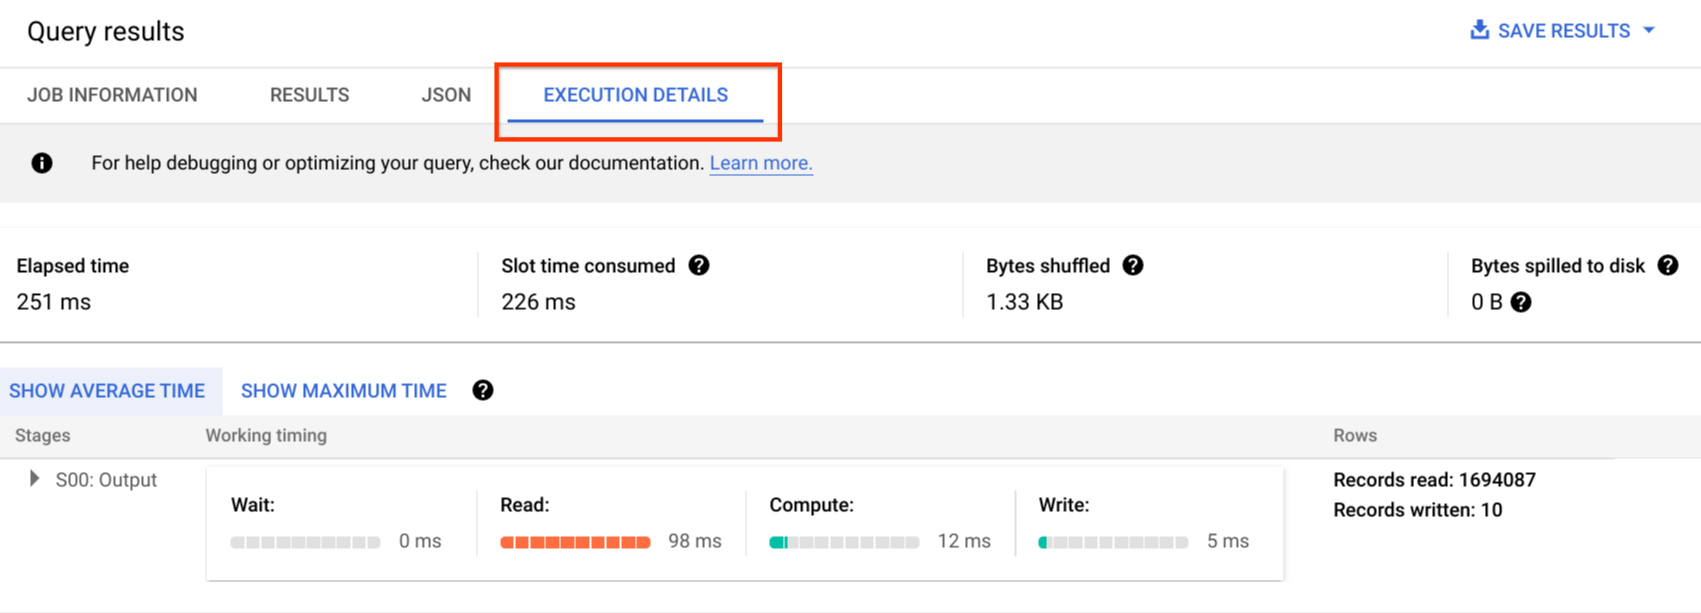
אפשר להשתמש בטבלת הודעות השגיאה כדי לפתור בעיות במשימות של שאילתות ובשגיאות API. כדי להבחין בין הקצאות של משבצות לכל שאילתה או משימה, אתם יכולים להשתמש בכלי הזה, שמועיל ללקוחות שמשתמשים בתמחור מבוסס-קיבולת ויש להם פרויקטים רבים שמופצים בין כמה צוותים.
תחזוקה, שדרוגים וגרסאות
BigQuery הוא שירות שמנוהל במלואו, ולא צריך לבצע בו תחזוקה או שדרוגים. ל-BigQuery אין גרסאות שונות. השדרוגים מתבצעים באופן רציף, לא דורשים זמן השבתה ולא פוגעים בביצועי המערכת. מידע נוסף זמין בנתוני הגרסה.
ב-Oracle וב-Exadata צריך לבצע תיקונים, שדרוגים ותחזוקה ברמת מסד הנתונים וברמת התשתית הבסיסית. יש הרבה גרסאות של Oracle, וגרסה ראשית חדשה מתוכננת לצאת מדי שנה. למרות שהגרסאות החדשות תואמות לדורות קודמים, יכולים להיות שינויים בביצועי השאילתות, בהקשר ובתכונות.
יכולות להיות אפליקציות שדורשות גרסאות ספציפיות כמו 10g, 11g או 12c. כשמשדרגים מסד נתונים גדול, צריך לתכנן ולבדוק את התהליך בקפידה. העברה מגרסאות שונות עשויה לכלול צורכי המרה טכניים שונים בסעיפי שאילתות ובאובייקטים של מסדי נתונים.
עומסי עבודה
Oracle Exadata תומך בעומסי עבודה מעורבים, כולל עומסי עבודה של OLTP. BigQuery מיועד לניתוח נתונים ולא לעומסי עבודה של OLTP. עומסי עבודה של OLTP שמשתמשים באותו Oracle צריכים לעבור ל-Cloud SQL, ל-Spanner או ל-Firestore ב-Google Cloud. Oracle מציעה אפשרויות נוספות כמו Advanced Analytics ו-Spatial and Graph. יכול להיות שתצטרכו לשכתב את עומסי העבודה האלה כדי להעביר אותם ל-BigQuery. מידע נוסף זמין במאמר העברת אפשרויות של Oracle.
פרמטרים והגדרות
ב-Oracle יש הרבה פרמטרים שצריך להגדיר ולכוונן ברמות של מערכת ההפעלה, מסד הנתונים, RAC, ASM והמאזין, בהתאם לעומסי העבודה ולאפליקציות השונות. BigQuery הוא שירות שמנוהל במלואו, ולא צריך להגדיר בו פרמטרים של אתחול.
מגבלות ומכסות
ל-Oracle יש מגבלות קשיחות וגמישות שמבוססות על תשתית, קיבולת חומרה, פרמטרים, גרסאות תוכנה ורישוי. ב-BigQuery יש מכסות ומגבלות על פעולות ואובייקטים ספציפיים.
הקצאת BigQuery
BigQuery הוא פלטפורמה כשירות (PaaS) ומחסן נתונים בענן לעיבוד מקבילי בקנה מידה גדול. הקיבולת שלו גדלה וקטנה בלי התערבות של המשתמש, כי Google מנהלת את הקצה העורפי. לכן, בניגוד למערכות RDBMS רבות, ב-BigQuery אין צורך להקצות משאבים לפני השימוש. BigQuery מקצה משאבי אחסון ושאילתות באופן דינמי, על סמך דפוסי השימוש שלכם. משאבי האחסון מוקצים כשאתם משתמשים בהם, ומוסרים כשאתם מסירים נתונים או מוחקים טבלאות. המשאבים של השאילתות מוקצים בהתאם לסוג השאילתה ולמורכבות שלה. כל שאילתה משתמשת במשבצות. התזמון מבוסס על הוגנות, כך שיכול להיות שבפרקי זמן קצרים שאילתות מסוימות יקבלו נתח גדול יותר של משבצות, אבל בסופו של דבר התזמון יתקן את זה.
במונחים של מכונות וירטואליות מסורתיות, BigQuery נותן לכם את המקבילה של:
- חיוב לפי שנייה
- שינוי קנה מידה לשנייה
כדי לבצע את המשימה הזו, BigQuery מבצע את הפעולות הבאות:
- הקצאת משאבים רבים כדי להימנע מהצורך בהרחבה מהירה.
- משתמש במשאבים של ריבוי דיירים (multitenant) כדי להקצות באופן מיידי נתחים גדולים למשך שניות בכל פעם.
- הקצאת משאבים יעילה בין המשתמשים, עם יתרונות לגודל.
- החיוב הוא רק על המשימות שאתם מריצים, ולא על המשאבים שפרסתם, כך שאתם משלמים על המשאבים שבהם אתם משתמשים.
מידע נוסף על התמחור ב-BigQuery
העברת סכימות
כדי להעביר נתונים מ-Oracle ל-BigQuery, אתם צריכים להכיר את סוגי הנתונים של Oracle ואת המיפויים של BigQuery.
סוגי נתונים ב-Oracle ומיפויים ב-BigQuery
סוגי הנתונים ב-Oracle שונים מסוגי הנתונים ב-BigQuery. למידע נוסף על סוגי הנתונים ב-BigQuery, אפשר לעיין במסמכי התיעוד הרשמיים.
להשוואה מפורטת בין סוגי הנתונים של Oracle ו-BigQuery, קראו את המדריך לתרגום Oracle SQL.
אינדקסים
בעומסי עבודה רבים של ניתוח נתונים, משתמשים בטבלאות עמודות במקום במאגרי שורות. כך אפשר להגדיל משמעותית את הפעולות שמבוססות על עמודות, ולבטל את השימוש באינדקסים לניתוח נתונים באצווה. בנוסף, הנתונים ב-BigQuery מאוחסנים בפורמט של עמודות, ולכן אין צורך באינדקסים ב-BigQuery. אם עומס העבודה של הניתוח דורש קבוצה אחת קטנה של גישה מבוססת-שורות, Bigtable יכול להיות חלופה טובה יותר. אם עומס העבודה דורש עיבוד טרנזקציות עם עקביות רלציונית חזקה, Spanner או Cloud SQL יכולים להיות חלופות טובות יותר.
לסיכום, ב-BigQuery לא צריך אינדקסים לניתוח נתונים באצווה, והם גם לא מוצעים. אפשר להשתמש בחלוקה למחיצות או באשכולות. במאמר מבוא לאופטימיזציה של ביצועי שאילתות מוסבר איך לשפר את ביצועי השאילתות ב-BigQuery.
תצוגות
בדומה ל-Oracle, גם ב-BigQuery אפשר ליצור תצוגות מותאמות אישית. עם זאת, תצוגות ב-BigQuery לא תומכות בפקודות DML.
תצוגות מהותיות
תצוגות מהותיות משמשות בדרך כלל לשיפור זמן הרינדור של דוחות, בסוגים של דוחות ועומסי עבודה שבהם כותבים פעם אחת וקוראים הרבה פעמים.
תצוגות מהותיות מוצעות ב-Oracle כדי לשפר את ביצועי התצוגה, פשוט על ידי יצירה ותחזוקה של טבלה שתכיל את מערך הנתונים של תוצאות השאילתה. יש שתי דרכים לרענן תצוגות מהותיות ב-Oracle: on-commit ועל פי דרישה.
הפונקציונליות של תצוגה מהותית זמינה גם ב-BigQuery. BigQuery משתמש בתוצאות שחושבו מראש מתצוגות מהותיות, ובכל פעם שאפשר, קורא רק את השינויים בדלתא מטבלת הבסיס כדי לחשב תוצאות עדכניות.
פונקציות של שמירה במטמון ב-Data Studio או בכלים מודרניים אחרים של BI יכולות גם לשפר את הביצועים ולחסוך בעלויות, כי לא צריך להריץ מחדש את אותה שאילתה.
חלוקת טבלאות למחיצות (Partitions)
חלוקה למחיצות של טבלאות נמצאת בשימוש נרחב במחסני נתונים של Oracle. בניגוד ל-Oracle, BigQuery לא תומך בחלוקה היררכית למחיצות.
ב-BigQuery יש שלושה סוגים של חלוקה למחיצות בטבלאות, שמאפשרים לשאילתות לציין מסנני פרדיקטים על סמך עמודת החלוקה למחיצות כדי לצמצם את כמות הנתונים שנסרקים.
- טבלאות שמחולקות למחיצות לפי זמן הטמעת הנתונים: הטבלאות מחולקות למחיצות לפי זמן הטמעת הנתונים.
- טבלאות שמחולקות לפי עמודה: הטבלאות מחולקות לפי עמודה מסוג
TIMESTAMPאוDATE. - טבלאות שמחולקות לפי טווח של מספרים שלמים: הטבלאות מחולקות על סמך עמודה של מספרים שלמים.
מידע נוסף על המגבלות והמכסות שחלות על טבלאות מחולקות למחיצות ב-BigQuery זמין במאמר מבוא לטבלאות מחולקות למחיצות.
אם המגבלות של BigQuery משפיעות על הפונקציונליות של מסד הנתונים שהועבר, כדאי להשתמש בפיצול אופקי (sharding) במקום בחלוקה למחיצות.
בנוסף, ב-BigQuery אי אפשר להשתמש ב-EXCHANGE PARTITION, ב-SPLIT PARTITION או להמיר טבלה שלא חולקה למחיצות לטבלה שחולקה למחיצות.
סידור באשכולות
אשכולות עוזרים לארגן ולאחזר ביעילות נתונים שמאוחסנים בכמה עמודות, שלרוב ניגשים אליהם ביחד. עם זאת, ב-Oracle וב-BigQuery יש נסיבות שונות שבהן אשכולות פועלים בצורה הטובה ביותר. ב-BigQuery, אם בדרך כלל מסננים טבלה וצוברים אותה לפי עמודות ספציפיות, משתמשים באשכולות. אפשר להשתמש באשכולות כשמעבירים טבלאות list-partitioned או index-organized מ-Oracle.
טבלאות זמניות
בדרך כלל משתמשים בטבלאות זמניות בצינורות עיבוד נתונים של Oracle ETL. טבלה זמנית מכילה נתונים במהלך סשן של משתמש. הנתונים האלה נמחקים באופן אוטומטי בסוף הסשן.
ב-BigQuery, טבלאות זמניות משמשות לשמירה במטמון של תוצאות שאילתות שלא נכתבות בטבלה קבועה. אחרי שהשאילתה מסתיימת, הטבלאות הזמניות קיימות למשך עד 24 שעות. הטבלאות נוצרות במערך נתונים מיוחד, והשמות שלהן נבחרים באופן אקראי. אתם יכולים גם ליצור טבלאות זמניות לשימושכם. מידע נוסף מופיע במאמר טבלאות זמניות.
טבלאות חיצוניות
בדומה ל-Oracle, ב-BigQuery אפשר לשלוח שאילתות למקורות נתונים חיצוניים. ב-BigQuery אפשר להריץ שאילתות על נתונים ישירות ממקורות הנתונים החיצוניים, כולל:
- Amazon Simple Storage Service (Amazon S3)
- Azure Blob Storage
- Bigtable
- Spanner
- Cloud SQL
- Cloud Storage
- Google Drive
מודלים של נתונים
מודלים של נתונים מסוג כוכב או פתית שלג יכולים להיות יעילים לאחסון של ניתוח נתונים, והם משמשים בדרך כלל למחסני נתונים ב-Oracle Exadata.
טבלאות שעברו דה-נורמליזציה מבטלות פעולות צירוף יקרות, וברוב המקרים מספקות ביצועים טובים יותר לניתוח נתונים ב-BigQuery. ב-BigQuery יש גם תמיכה במודלים של נתונים מסוג כוכב ופתית שלג. לפרטים נוספים על תכנון מחסן נתונים ב-BigQuery, קראו את המאמר תכנון סכימה.
פורמט שורה לעומת פורמט עמודה, ומגבלות שרת לעומת ללא שרת (serverless)
ב-Oracle נעשה שימוש בפורמט של שורות שבו שורת הטבלה מאוחסנת בבלוקים של נתונים, כך שעמודות לא נחוצות נשלפות בתוך הבלוק בשביל שאילתות הניתוח, על סמך סינון וצבירה של עמודות ספציפיות.
ל-Oracle יש ארכיטקטורה של שיתוף מלא, עם תלות קבועה במשאבי חומרה, כמו זיכרון ואחסון, שמוקצים לשרת. אלה שני הכוחות העיקריים שעומדים בבסיסן של הרבה שיטות ליצירת מודלים של נתונים, שהתפתחו כדי לשפר את יעילות האחסון ואת הביצועים של שאילתות ניתוח. סכמות כוכב ופתית שלג ומודלים של מאגרי נתונים הם חלק מהם.
ב-BigQuery, הנתונים נשמרים בפורמט של עמודות ואין מגבלות קבועות על האחסון והזיכרון. הארכיטקטורה הזו מאפשרת לכם לבצע דה-נורמליזציה נוספת ולתכנן סכימות על סמך קריאות וצרכים עסקיים, וכך להפחית את המורכבות ולשפר את הגמישות, את יכולת ההתאמה לעומס ואת הביצועים.
דה-נורמליזציה
אחת מהמטרות העיקריות של נורמליזציה של מסד נתונים רלציוני היא להפחית את יתירות הנתונים. המודל הזה מתאים במיוחד למסד נתונים רלציוני שמשתמש בפורמט של שורות, אבל ביטול הנרמול של נתונים עדיף למסדי נתונים של עמודות. במאמר דה-נורמליזציה תוכלו לקרוא מידע נוסף על היתרונות של דה-נורמליזציה של נתונים ועל אסטרטגיות אחרות לאופטימיזציה של שאילתות ב-BigQuery.
שיטות להשטחת הסכימה הקיימת
הטכנולוגיה של BigQuery משלבת גישה לנתונים ועיבוד שלהם בעמודות, אחסון בזיכרון ועיבוד מבוזר, כדי לספק ביצועי שאילתות איכותיים.
כשמתכננים סכימת DWH ב-BigQuery, כדי לנצל את האחסון בצורה טובה יותר, עדיף ליצור טבלת עובדות במבנה של טבלה שטוחה (איחוד של כל טבלאות המאפיינים לרשומה אחת בטבלת העובדות) מאשר להשתמש בכמה טבלאות מאפיינים של DWH. בנוסף לניצול מופחת של נפח האחסון, טבלה שטוחה ב-BigQuery מובילה לשימוש מופחת ב-JOIN. התרשים הבא ממחיש דוגמה של סכימה שעברה שיטוח.
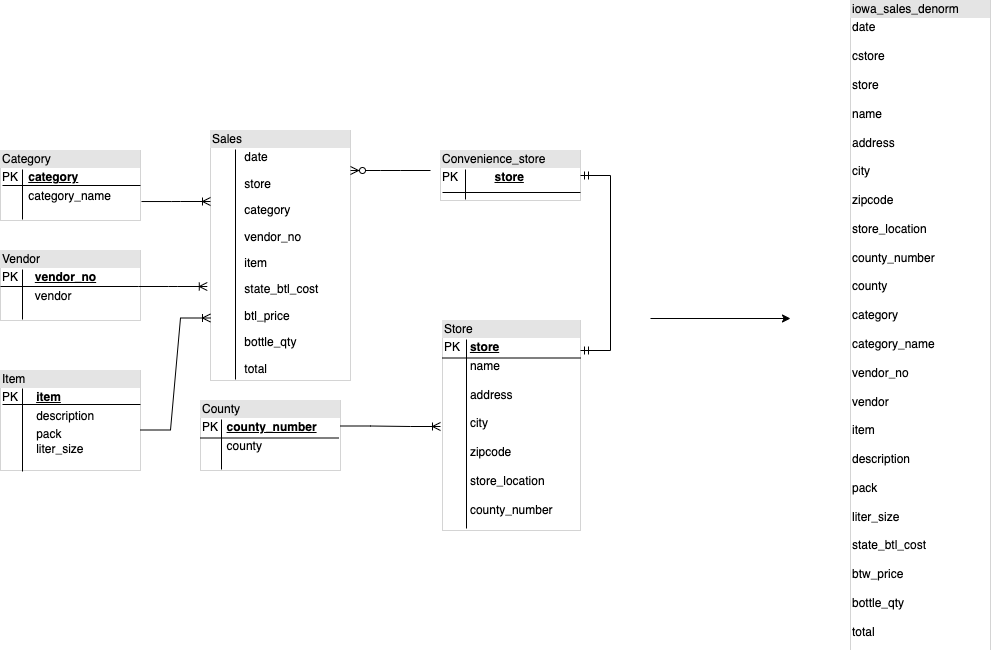
דוגמה להשטחה של סכימת כוכב
באיור 1 מוצג מסד נתונים פיקטיבי לניהול מכירות, שכולל ארבע טבלאות:
- טבלת הזמנות/מכירות (טבלת עובדות)
- טבלת העובדים
- טבלת המיקומים
- טבלת לקוחות
המפתח הראשי של טבלת המכירות הוא OrderNum, והוא מכיל גם מפתחות זרים לשלוש הטבלאות האחרות.
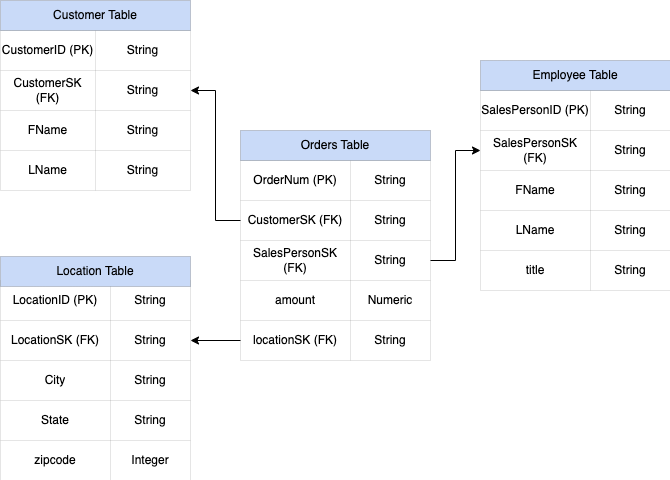
איור 1: נתוני מכירות לדוגמה בסכימת כוכב
נתונים לדוגמה
תוכן טבלת ההזמנות/העובדות
| OrderNum | CustomerID | SalesPersonID | סכום | מיקום |
|---|---|---|---|---|
| O-1 | 1234 | 12 | 234.22 | 18 |
| O-2 | 4567 | 1 | 192.10 | 27 |
| O-3 | 12 | 14.66 | 18 | |
| O-4 | 4567 | 4 | 182.00 | 26 |
תוכן הטבלה של העובדים
| SalesPersonID | FName | LName | כותרת |
|---|---|---|---|
| 1 | Alex | Smith | שותף מכירות |
| 4 | ליסה | כהן | שותף מכירות |
| 12 | יונתן | כהן | שותף מכירות |
תוכן טבלת הלקוחות
| CustomerID | FName | LName |
|---|---|---|
| 1234 | אמנדה | Lee |
| 4567 | מאט | Ryan |
תוכן טבלת המיקומים
| מיקום | עיר | הסמוי הסופי | מיקוד |
|---|---|---|---|
| 18 | ברונקס | ניו יורק | 10452 |
| 26 | מאונטיין ויו | CA | 90210 |
| 27 | אמריקה/שיקגו | IL | 60613 |
שאילתה להשטחת הנתונים באמצעות LEFT OUTER JOIN
#standardSQL
INSERT INTO flattened
SELECT
  orders.ordernum,
  orders.customerID,
  customer.fname,
  customer.lname,
  orders.salespersonID,
  employee.fname,
  employee.lname,
  employee.title,
  orders.amount,
  orders.location,
  location.city,
  location.state,
  location.zipcode
FROM orders
LEFT OUTER JOIN customer
  ON customer.customerID = orders.customerID
LEFT OUTER JOIN employee
  ON employee.salespersonID = orders.salespersonID
LEFT OUTER JOIN location
  ON location.locationID = orders.locationID
פלט של הנתונים השטוחים
| OrderNum | CustomerID | FName | LName | SalesPersonID | FName | LName | סכום | מיקום | עיר | הסמוי הסופי | מיקוד |
|---|---|---|---|---|---|---|---|---|---|---|---|
| O-1 | 1234 | אמנדה | Lee | 12 | יונתן | כהן | 234.22 | 18 | ברונקס | ניו יורק | 10452 |
| O-2 | 4567 | מאט | Ryan | 1 | Alex | Smith | 192.10 | 27 | אמריקה/שיקגו | IL | 60613 |
| O-3 | 12 | יונתן | כהן | 14.66 | 18 | ברונקס | ניו יורק | 10452 | |||
| O-4 | 4567 | מאט | Ryan | 4 | ליסה | כהן | 182.00 | 26 | הר
הצגה |
CA | 90210 |
שדות בתוך שדות ושדות חוזרים
כדי לתכנן וליצור סכימת DWH מסכימה יחסית (לדוגמה, סכימות כוכב ופתית שלג שמכילות טבלאות של מאפיינים ועובדות), BigQuery מציג את הפונקציונליות של שדות בתוך שדות ושדות חוזרים. לכן, אפשר לשמר את הקשרים באופן דומה לסכימת DWH מנורמלת (או מנורמלת חלקית) בלי להשפיע על הביצועים. מידע נוסף זמין במאמר שיטות מומלצות לשיפור הביצועים.
כדי להבין טוב יותר את ההטמעה של שדות בתוך שדות ושדות חוזרים, נסתכל על סכימה יחסית פשוטה של טבלת CUSTOMERS וטבלת ORDER/SALES. אלה שתי טבלאות שונות, אחת לכל ישות, והקשרים מוגדרים באמצעות מפתח כמו מפתח ראשי ומפתח זר כקישור בין הטבלאות בזמן שליחת שאילתות באמצעות JOIN. שדות חוזרים ומקוננים ב-BigQuery מאפשרים לשמור על אותו קשר בין הישויות בטבלה אחת. כדי להטמיע את זה, צריך שכל נתוני הלקוחות יהיו זמינים, ונתוני ההזמנות יהיו מקוננים לכל אחד מהלקוחות. מידע נוסף זמין במאמר הגדרת עמודות חוזרות (repeated) ועמודות בתצוגת עץ (nested).
כדי להמיר את המבנה השטוח לסכימה עם שדות בתוך שדות או שדות חוזרים, צריך להגדיר את השדות בתוך שדות באופן הבא:
-
CustomerID, FName, LNameמקוננים בשדה חדש בשםCustomer. -
SalesPersonID, FName, LNameמקוננים בשדה חדש בשםSalesperson. -
LocationID,city,state,zip codeמוטמעים בשדה חדש בשםLocation.
השדות OrderNum ו-amount לא מוטמעים, כי הם מייצגים רכיבים ייחודיים.
אתם רוצים שהסכימה תהיה גמישה מספיק כדי שלכל הזמנה יהיה יותר מלקוח אחד: לקוח ראשי ולקוח משני. השדה customer מסומן כחוזר. הסכימה שנוצרה מוצגת באיור 2, שממחיש שדות בתוך שדות ושדות חוזרים.
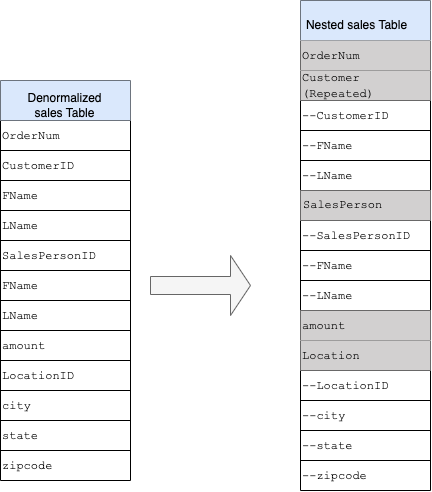
איור 2: ייצוג לוגי של מבנה בתצוגת עץ
במקרים מסוימים, דה-נורמליזציה באמצעות שדות בתוך שדות ושדות חוזרים לא מובילה לשיפורים בביצועים. למידע נוסף על מגבלות והגבלות, ראו ציון עמודות בתצוגת עץ ועמודות חוזרות בסכימות של טבלאות.
מפתחות פונדקאיים (surrogate keys)
בדרך כלל מזהים שורות באמצעות מפתחות ייחודיים בתוך הטבלאות. ב-Oracle, בדרך כלל משתמשים ברצפים כדי ליצור את המפתחות האלה. ב-BigQuery אפשר ליצור מפתחות חלופיים באמצעות הפונקציות row_number ו-partition by. למידע נוסף, קראו את המאמר BigQuery and surrogate keys: a practical approach.
מעקב אחרי שינויים והיסטוריה
כשמתכננים העברה של מחסן נתונים ל-BigQuery, כדאי להביא בחשבון את הקונספט של מאפיינים שמשתנים לאט (SCD). באופן כללי, המונח SCD מתאר את תהליך ביצוע השינויים (פעולות DML) בטבלאות המאפיינים.
מכמה סיבות, במחסני נתונים מסורתיים משתמשים בסוגים שונים כדי לטפל בשינויים בנתונים ולשמור נתונים היסטוריים במאפיינים שמשתנים לאט. השימושים האלה בסוגים נדרשים בגלל מגבלות החומרה ודרישות היעילות שצוינו קודם. מכיוון שהאחסון זול בהרבה מהמחשוב וניתן להרחבה באופן אינסופי, מומלץ להשתמש ביתירות נתונים ובשכפול נתונים אם הם מובילים לשאילתות מהירות יותר ב-BigQuery. אתם יכולים להשתמש בשיטות ליצירת תמונת מצב של נתונים, שבהן כל הנתונים נטענים למחיצות יומיות חדשות.
תצוגות ספציפיות לתפקיד ולמשתמש
השתמשו בתצוגות ספציפיות לתפקיד ולמשתמש כשמשתמשים שייכים לצוותים שונים וצריכים לראות רק את הרשומות והתוצאות שהם צריכים.
ב-BigQuery יש תמיכה בcolumn- וברמת השורה. אבטחה ברמת העמודה מספקת גישה מדויקת לעמודות עם נתונים רגישים באמצעות תגי מדיניות, או סיווג מבוסס-נתונים. אבטחה ברמת השורה, שמאפשרת לסנן נתונים ולגשת לשורות ספציפיות בטבלה על סמך תנאי המשתמשים המתאימים.
העברת נתונים
בקטע הזה מוסבר איך להעביר נתונים מ-Oracle ל-BigQuery, כולל טעינה ראשונית, סימון נתונים שהשתנו (CDC) וגישות וכלים של ETL/ELT.
פעילויות העברה
מומלץ לבצע את ההעברה בשלבים, על ידי זיהוי תרחישים לדוגמה שמתאימים להעברה. יש כמה כלים ושירותים שאפשר להשתמש בהם כדי להעביר נתונים מ-Oracle ל- Google Cloud. הרשימה הזו חלקית, אבל היא נותנת מושג לגבי הגודל וההיקף של מאמץ ההעברה.
ייצוא נתונים מ-Oracle: מידע נוסף זמין במאמרים טעינה ראשונית וCDC והטמעת עדכונים בזמן אמת מ-Oracle ל-BigQuery. אפשר להשתמש בכלי ETL לטעינה הראשונית.
הכנת נתונים (ב-Cloud Storage): מומלץ להשתמש ב-Cloud Storage כסביבת Staging לנתונים שמיוצאים מ-Oracle. Cloud Storage מיועד להטמעה מהירה וגמישה של נתונים מובְנים או לא מובְנים.
תהליך ETL: מידע נוסף זמין במאמר העברת ETL/ELT.
טעינת נתונים ישירות ל-BigQuery: אפשר לטעון נתונים ל-BigQuery ישירות מ-Cloud Storage, דרך Dataflow או באמצעות סטרימינג בזמן אמת. משתמשים ב-Dataflow כשצריך לבצע טרנספורמציה של נתונים.
טעינה ראשונית
העברת הנתונים הראשוניים ממחסן הנתונים הקיים של Oracle ל-BigQuery עשויה להיות שונה מצינורות עיבוד הנתונים המצטברים של ETL/ELT, בהתאם לגודל הנתונים ולרוחב הפס של הרשת. אפשר להשתמש באותם צינורות עיבוד נתונים של ETL/ELT אם גודל הנתונים הוא כמה טרה-בייטים.
אם הנתונים הם עד כמה טרה-בייטים, העברת הנתונים באמצעות dump ו-gcloud storage יכולה להיות הרבה יותר יעילה מאשר שימוש במתודולוגיה פרוגרמטית לחילוץ מסד נתונים כמו JdbcIO, כי גישות פרוגרמטיות עשויות לדרוש כוונון ביצועים הרבה יותר פרטני. אם גודל הנתונים הוא יותר מכמה טרה-בייט והנתונים מאוחסנים בענן או באחסון אונליין (כמו Amazon Simple Storage Service (Amazon S3)), כדאי להשתמש בשירות העברת הנתונים ל-BigQuery. להעברות בקנה מידה גדול (במיוחד העברות עם רוחב פס מוגבל ברשת), Transfer Appliance הוא אפשרות שימושית.
מגבלות על הטעינה הראשונית
כשמתכננים העברת נתונים, כדאי להביא בחשבון את הנקודות הבאות:
- גודל הנתונים של Oracle DWH: לגודל המקור של הסכימה יש משקל משמעותי בשיטה שנבחרה להעברת הנתונים, במיוחד כשגודל הנתונים גדול (טרה-בייט ומעלה). כשהנתונים קטנים יחסית, אפשר להשלים את תהליך העברת הנתונים בפחות שלבים. הטיפול בנתונים בהיקף גדול הופך את התהליך הכולל למורכב יותר.
זמן השבתה: חשוב להחליט אם זמן השבתה הוא אופציה בהעברה ל-BigQuery. כדי לצמצם את זמן ההשבתה, אפשר לטעון בכמות גדולה את הנתונים ההיסטוריים הקבועים ולהשתמש בפתרון CDC כדי להתעדכן בשינויים שמתרחשים במהלך תהליך ההעברה.
תמחור: בתרחישים מסוימים, יכול להיות שתצטרכו כלי שילוב עם צד שלישי (לדוגמה, כלי ETL או כלי שכפול) שדורשים רישיונות נוספים.
העברת נתונים ראשונית (אצווה)
העברת נתונים באמצעות שיטת אצווה מציינת שהנתונים ייצאו באופן עקבי בתהליך יחיד (לדוגמה, ייצוא נתוני הסכימה של Oracle DWH לקובצי CSV, Avro או Parquet, או ייבוא ל-Cloud Storage כדי ליצור מערכי נתונים ב-BigQuery. אפשר להשתמש בכל הכלים והמושגים של ETL שמוסברים במאמר העברת ETL/ELT לטעינה הראשונית.
אם אתם לא רוצים להשתמש בכלי ETL/ELT לטעינה הראשונית, אתם יכולים לכתוב סקריפטים בהתאמה אישית כדי לייצא נתונים לקבצים (CSV, Avro או Parquet) ולהעלות את הנתונים האלה ל-Cloud Storage באמצעות gcloud storage, שירות העברת הנתונים ל-BigQuery או Transfer Appliance. למידע נוסף על כוונון ביצועים של העברות נתונים גדולות ואפשרויות העברה, ראו העברת מערכי נתונים גדולים. ואז טוענים את הנתונים מ-Cloud Storage ל-BigQuery.
Cloud Storage הוא אידיאלי לטיפול בנחיתה הראשונית של הנתונים. Cloud Storage הוא שירות אחסון אובייקטים עמיד וזמין מאוד, ללא הגבלה על מספר הקבצים, שבו משלמים רק על נפח האחסון שמשתמשים בו. השירות מותאם לעבודה עם שירותים אחרים של Google Cloud , כמו BigQuery ו-Dataflow.
CDC והטמעת עדכונים בזמן אמת מ-Oracle ל-BigQuery
יש כמה דרכים לתעד את הנתונים שהשתנו מ-Oracle. לכל אפשרות יש יתרונות וחסרונות, בעיקר בהשפעה על הביצועים במערכת המקור, בדרישות הפיתוח וההגדרה, ובתמחור וברישוי.
CDC מבוסס-יומן
Oracle GoldenGate הוא הכלי המומלץ של Oracle לחילוץ יומני Redo, ואפשר להשתמש ב-GoldenGate for Big Data כדי להעביר יומנים בסטרימינג ל-BigQuery. ל-GoldenGate נדרש רישוי לכל מעבד (CPU). למידע על המחיר, ראו Oracle Technology Global Price List. אם Oracle GoldenGate for Big Data זמין (במקרה שכבר נרכשו רישיונות), השימוש ב-GoldenGate יכול להיות בחירה טובה ליצירת פייפליינים להעברת נתונים (טעינה ראשונית) ולאחר מכן לסנכרון כל שינויי הנתונים.
Oracle XStream
Oracle שומרת כל commit בקובצי יומן Redo, ואפשר להשתמש בקובצי ה-Redo האלה ל-CDC. Oracle XStream Out מבוסס על LogMiner ומסופק על ידי כלים של צד שלישי כמו Debezium (החל מגרסה 0.8) או באופן מסחרי באמצעות כלים כמו Striim. כדי להשתמש בממשקי ה-API של XStream, צריך לרכוש רישיון ל-Oracle GoldenGate, גם אם לא מתקינים את GoldenGate ולא משתמשים בו. XStream מאפשר להפיץ הודעות Streams בין Oracle לבין תוכנות אחרות בצורה יעילה.
Oracle LogMiner
לא נדרש רישיון מיוחד ל-LogMiner. אתם יכולים להשתמש באפשרות LogMiner במחבר הקהילה של Debezium. הוא זמין גם באופן מסחרי באמצעות כלים כמו Attunity, Striim או StreamSets. LogMiner עשוי להשפיע על הביצועים של מסד נתונים פעיל מאוד, וצריך להשתמש בו בזהירות במקרים שבהם נפח השינויים (גודל הביצוע מחדש) הוא יותר מ-10GB לשעה, בהתאם למעבד (CPU), לזיכרון, לקיבולת הקלט/פלט ולניצול של השרת.
CDC שמבוסס על SQL
זוהי גישת ה-ETL המצטברת, שבה שאילתות SQL דוגמות באופן רציף את טבלאות המקור לכל שינוי, בהתאם למפתח שגדל באופן מונוטוני ולעמודת חותמת זמן שמכילה את התאריך האחרון של השינוי או ההוספה. אם אין מפתח שגדל באופן מונוטוני, שימוש בעמודת חותמת הזמן (תאריך השינוי) עם דיוק קטן (שניות) יכול לגרום לרשומות כפולות או לנתונים חסרים, בהתאם לנפח ולאופרטור ההשוואה, כמו > או >=.
כדי להתגבר על בעיות כאלה, אפשר להשתמש ברמת דיוק גבוהה יותר בעמודות של חותמות זמן, כמו שש ספרות אחרי הנקודה העשרונית (מיקרו-שניות, שהיא רמת הדיוק המקסימלית שנתמכת ב-BigQuery), או להוסיף משימות של ביטול כפילויות בצינור עיבוד הנתונים של ETL/ELT, בהתאם למפתחות העסקיים ולמאפייני הנתונים.
כדי לשפר את ביצועי החילוץ ולהפחית את ההשפעה על מסד הנתונים של המקור, צריך להיות אינדקס בעמודת המפתח או חותמת הזמן. פעולות מחיקה הן אתגר בשיטה הזו, כי צריך לטפל בהן באפליקציית המקור בשיטה של מחיקה זמנית, כמו הוספת דגל מחיקה ועדכון של last_modified_date. פתרון חלופי יכול להיות רישום הפעולות האלה בטבלה אחרת באמצעות טריגר.
טריגרים
אפשר ליצור טריגרים של מסד נתונים בטבלאות המקור כדי לתעד שינויים בטבלאות יומן נסתרות. טבלאות יומן יכולות להכיל שורות שלמות כדי לעקוב אחרי כל שינוי בעמודה, או שהן יכולות לשמור רק את המפתח הראשי עם סוג הפעולה (הוספה, עדכון או מחיקה). לאחר מכן, אפשר לתעד את הנתונים שהשתנו באמצעות גישה מבוססת-SQL, שמתוארת בקטע CDC מבוסס-SQL. שימוש בטריגרים יכול להשפיע על ביצועי העסקאות ולהכפיל את זמן האחזור של פעולת DML בשורה אחת אם מאחסנים שורה שלמה. אחסון של המפתח הראשי בלבד יכול להפחית את התקורה הזו, אבל במקרה כזה נדרשת פעולת JOIN עם הטבלה המקורית בחילוץ שמבוסס על SQL, שמפספס את השינוי שבוצע באמצע.
העברת ETL או ELT
יש הרבה אפשרויות לטיפול ב-ETL/ELT ב- Google Cloud. הנחיות טכניות לגבי המרות ספציפיות של עומסי עבודה ב-ETL לא נכללות במסמך הזה. אתם יכולים לשקול גישה של העברה ללא שינוי (lift and shift) או לתכנן מחדש את פלטפורמת שילוב הנתונים, בהתאם לאילוצים כמו עלות וזמן. במאמר העברת צינורות עיבוד נתונים תוכלו לקרוא מידע נוסף על העברת צינורות עיבוד הנתונים ל- Google Cloud ועל מושגים רבים אחרים שקשורים להעברה.
גישת "חותכים ולוקחים"
אם הפלטפורמה הקיימת תומכת ב-BigQuery ואתם רוצים להמשיך להשתמש בכלי הקיים לשילוב נתונים:
- אתם יכולים להשאיר את פלטפורמת ה-ETL/ELT כמו שהיא, ולשנות את שלבי האחסון הנדרשים באמצעות BigQuery במשימות ה-ETL/ELT.
- אם אתם רוצים להעביר גם את פלטפורמת ה-ETL/ELT ל- Google Cloud , אתם יכולים לשאול את הספק אם הכלי שלו ברישיון ב- Google Cloud. אם כן, אתם יכולים להתקין אותו ב-Compute Engine או לבדוק ב-Google Cloud Marketplace.
למידע על ספקי פתרונות לשילוב נתונים, ראו שותפי BigQuery.
תכנון מחדש של פלטפורמת ETL/ELT
אם אתם רוצים לשנות את הארכיטקטורה של פייפליינים, מומלץ מאוד להשתמש בשירותי Google Cloud .
Cloud Data Fusion
Cloud Data Fusion הוא CDAP מנוהל ב- Google Cloud , שמציע ממשק חזותי עם הרבה פלאגינים למשימות כמו גרירה ושחרור ופיתוחים של צינורות עיבוד נתונים. אפשר להשתמש ב-Cloud Data Fusion כדי לתעד נתונים מהרבה סוגים שונים של מערכות מקור, והוא מציע יכולות של רפליקציה באצווה ובסטרימינג. אפשר להשתמש בפלאגינים של Cloud Data Fusion או של Oracle כדי לתעד נתונים מ-Oracle. אפשר להשתמש בפלאגין של BigQuery כדי לטעון את הנתונים ל-BigQuery ולטפל בעדכוני הסכימה.
לא מוגדרת סכימת פלט בפלאגינים של המקור והכיור, ומשתמשים ב-select * from בפלאגין של המקור כדי לשכפל גם עמודות חדשות.
אתם יכולים להשתמש בתכונה Wrangle של Cloud Data Fusion כדי לבצע טיוב נתונים ולהכין אותם.
Dataflow
Dataflow היא פלטפורמה לעיבוד נתונים ללא שרת (serverless) שיכולה להתאים את עצמה לעומס (autoscaling) ולעבד נתונים באצווה ובסטרימינג. Dataflow יכול להיות בחירה טובה למפתחי Python ו-Java שרוצים לתכנת את פייפליינים שלהם ולהשתמש באותו קוד גם לעומסי עבודה בסטרימינג וגם לעומסי עבודה באצווה. משתמשים בתבנית JDBC to BigQuery כדי לחלץ נתונים מ-Oracle או ממסדי נתונים רלציוניים אחרים, ולטעון אותם ל-BigQuery.
Managed Service for Apache Airflow
Managed Airflow הוא שירות מנוהל לתזמור תהליכי עבודה שמבוסס על Apache Airflow. Google Cloud הוא מאפשר ליצור, לתזמן ולנטר צינורות עיבוד נתונים שפועלים בסביבות ענן ובמרכזי נתונים מקומיים. ב-Managed Airflow יש אופרטורים ותרומות שיכולים להריץ טכנולוגיות בכמה עננים לתרחישים לדוגמה, כולל חילוץ וטעינה, טרנספורמציות של ELT וקריאות ל-API בארכיטקטורת REST.
ב-Managed Airflow משתמשים בגרפים אציקליים מכוונים (DAG) כדי לתזמן ולתזמר תהליכי עבודה. כדי להבין את המושגים הכלליים של Airflow, קראו את המאמר מושגים של Apache Airflow. למידע נוסף על DAG, קראו את המאמר כתיבת DAG (תהליכי עבודה). באתר התיעוד של Airflow תוכלו לקרוא על השיטות המומלצות ל-ETL באמצעות Apache Airflow. אפשר להחליף את האופרטור של Hive בדוגמה הזו באופרטור של BigQuery, ואותם מושגים יהיו רלוונטיים.
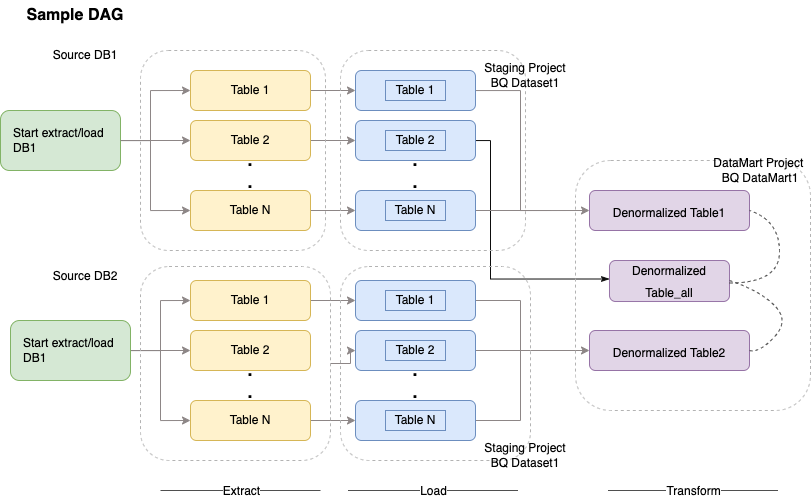
הקוד לדוגמה הבא הוא חלק ברמה גבוהה של DAG לדוגמה לתרשים הקודם:
    default_args = {
      'owner': 'airflow',
      'depends_on_past': False,
     'start_date': airflow.utils.dates.days_ago(2),
     'email': ['airflow@example.com'],
     'email_on_failure': False,
     'email_on_retry': False,
     'retries': 2,
     'retry_delay': timedelta(minutes=10),
    }
    schedule_interval = "00 01 * * *"
    dag = DAG('load_db1_db2',catchup=False, default_args=default_args,
    schedule_interval=schedule_interval)
    tables = {
      'DB1_TABLE1': {'database':'DB1', 'table_name':'TABLE1'},
      'DB1_TABLE2': {'database':'DB1', 'table_name':'TABLE2'},
      'DB1_TABLEN': {'database':'DB1', 'table_name':'TABLEN'},
      'DB2_TABLE1': {'database':'DB2', 'table_name':'TABLE1'},
      'DB2_TABLE2': {'database':'DB2', 'table_name':'TABLE2'},
      'DB2_TABLEN': {'database':'DB2', 'table_name':'TABLEN'},
    }
    start_db1_daily_incremental_load = DummyOperator(
       task_id='start_db1_daily_incremental_load', dag=dag)
    start_db2_daily_incremental_load = DummyOperator(
       task_id='start_db2_daily_incremental_load', dag=dag)

    load_denormalized_table1 = BigQueryOperator(
       task_id='load_denormalized_table1',
       use_legacy_sql=False,
       write_disposition='WRITE_TRUNCATE',
       allow_large_results=True,
       trigger_rule='all_done',
       bql='''
       #standardSQL
       select
           t1.*,tN.* except (ID)
           from `ingest-project.ingest_db1.TABLE1` as t1
           left join `ingest-project.ingest_db1.TABLEN` as tN on t1.ID = tN.ID
        ''',    destination_dataset_table='datamart-project.dm1.dt1', dag=dag)

        load_denormalized_table2 = BigQueryOperator(
           task_id='load_denormalized_table2',
           use_legacy_sql=False,
           write_disposition='WRITE_TRUNCATE',
           allow_large_results=True,
           trigger_rule='all_done',
        bql='''
        #standardSQL
        select
           t1.*,t2.* except (ID),tN.* except (ID)
           from `ingest-project.ingest_db1.TABLE1` as t1
           left join `ingest-project.ingest_db2.TABLE2` as t2 on t1.ID = t2.ID
           left join `ingest-project.ingest_db2.TABLEN` as tN on t2.ID = tN.ID
        ''',    destination_dataset_table='datamart-project.dm1.dt2', dag=dag)

        load_denormalized_table_all = BigQueryOperator(
           task_id='load_denormalized_table_all',
           use_legacy_sql=False,
           write_disposition='WRITE_TRUNCATE',
           allow_large_results=True,
          trigger_rule='all_done',
        bql='''
        #standardSQL
        select
           t1.*,t2.* except (ID),t3.* except (ID)
           from `datamart-project.dm1.dt1` as t1
           left join `ingest-project.ingest_db1.TABLE2` as t2 on t1.ID = t2.ID
           left join `datamart-project.dm1.dt2` as t3 on t2.ID = t3.ID
        ''',    destination_dataset_table='datamart-project.dm1.dt_all', dag=dag)

        def start_pipeline(database,table,...):
        #start initial or incremental load job here
        #you can write your custom operator to integrate ingestion tool
        #or you can use operators available in composer instead

        for table,table_attr in tables.items():
        tbl=table_attr['table_name']
        db=table_attr['database'])
        load_start = PythonOperator(
        task_id='start_load_{db}_{tbl}'.format(tbl=tbl,db=db),
        python_callable=start_pipeline,
        op_kwargs={'database': db,
        'table':tbl},
        dag=dag
        )

        load_monitor = HttpSensor(
          task_id='load_monitor_{db}_{tbl}'.format(tbl=tbl,db=db),
          http_conn_id='ingestion-tool',
          endpoint='restapi-endpoint/',
          request_params={},
          response_check=lambda response: """{"status":"STOPPED"}""" in
          response.text,
          poke_interval=1,
          dag=dag,
        )

        load_start.set_downstream(load_monitor)

        if table_attr['database']=='db1':
          load_start.set_upstream(start_db1_daily_incremental_load)
        else:
          load_start.set_upstream(start_db2_daily_incremental_load)

        if table_attr['database']=='db1':
          load_monitor.set_downstream(load_denormalized_table1)
        else:
          load_monitor.set_downstream(load_denormalized_table2)
          load_denormalized_table1.set_downstream(load_denormalized_table_all)
          load_denormalized_table2.set_downstream(load_denormalized_table_all)
הקוד שלמעלה מיועד להדגמה בלבד ואי אפשר להשתמש בו כמו שהוא.
Dataprep by Trifacta
Dataprep הוא שירות נתונים שמאפשר לבדוק בצורה חזותית, לנקות ולהכין נתונים מובְנים ולא מובְנים לצורכי ניתוח, דיווח ולמידת מכונה. אתם מייצאים את נתוני המקור לקובצי JSON או CSV, משנים את הנתונים באמצעות Dataprep וטוענים אותם באמצעות Dataflow. לדוגמה, ראו נתוני Oracle (ETL) ל-BigQuery באמצעות Dataflow ו-Dataprep.
Managed Service for Apache Spark
Managed Service for Apache Spark הוא שירות Hadoop שמנוהל על ידי Google. אתם יכולים להשתמש ב-Sqoop כדי לייצא נתונים מ-Oracle וממסדי נתונים רלציוניים רבים ל-Cloud Storage כקובצי Avro, ואז לטעון את קובצי ה-Avro ל-BigQuery באמצעות bq tool. בדרך כלל מתקינים כלי ETL כמו CDAP ב-Hadoop, שמשתמשים ב-JDBC כדי לחלץ נתונים וב-Apache Spark או ב-MapReduce כדי לבצע טרנספורמציות של הנתונים.
כלים של שותפים להעברת נתונים
יש כמה ספקים בתחום החילוץ, הטרנספורמציה והטעינה (ETL). מובילי שוק בתחום ה-ETL, כמו Informatica, Talend, Matillion, Infoworks, Stitch, Fivetran ו-Striim, משולבים באופן עמוק גם ב-BigQuery וגם ב-Oracle, ויכולים לעזור לחלץ, להמיר ולטעון נתונים ולנהל תהליכי עיבוד.
כלי ETL קיימים כבר הרבה שנים. בארגונים מסוימים, יכול להיות שיהיה נוח למנף השקעה קיימת בסקריפטים מהימנים של ETL. חלק מהפתרונות המרכזיים של השותפים שלנו מופיעים באתר השותפים של BigQuery. ההחלטה מתי לבחור בכלים של שותפים על פני כלי השירות המובנים שלGoogle Cloud תלויה בתשתית הנוכחית שלכם, ובמידת הנוחות של צוות ה-IT שלכם בפיתוח פייפליינים בקוד Java או Python.
העברת כלי בינה עסקית (BI)
ב-BigQuery יש חבילה גמישה של פתרונות בינה עסקית (BI) לדיווח ולניתוח נתונים. למידע נוסף על העברת כלי BI ושילוב עם BigQuery, קראו את המאמר סקירה כללית על ניתוח הנתונים ב-BigQuery.
תרגום שאילתות (SQL)
GoogleSQL של BigQuery תומך בתאימות לתקן SQL 2011, ויש לו תוספים שתומכים בשאילתות של נתונים חוזרים ומקוננים. אפשר להשתמש בכל הפונקציות והאופרטורים של SQL שתואמים ל-ANSI, עם שינויים מינימליים. להשוואה מפורטת בין התחביר והפונקציות של Oracle SQL ו-BigQuery SQL, קראו את המדריך לתרגום SQL מ-Oracle ל-BigQuery.
אתם יכולים להשתמש בתרגום SQL באצווה כדי להעביר את קוד ה-SQL בכמות גדולה, או בתרגום SQL אינטראקטיבי כדי לתרגם שאילתות אד-הוק.
אפשרויות להעברת Oracle
בקטע הזה מוצגות המלצות ודוגמאות לארכיטקטורה להמרת אפליקציות שמשתמשות בפונקציונליות של Oracle Data Mining, R, Spatial ו-Graph.
Oracle Advanced Analytics option
אורקל מציעה אפשרויות מתקדמות לניתוח נתונים לצורך כריית מידע, אלגוריתמים בסיסיים של למידת מכונה (ML) ושימוש ב-R. כדי להשתמש באפשרות "ניתוחים מתקדמים" צריך רישיון. אתם יכולים לבחור מתוך רשימה מקיפה של מוצרי Google AI ו-ML, בהתאם לצרכים שלכם – מפיתוח ועד לייצור בקנה מידה נרחב.
Oracle R Enterprise
Oracle R Enterprise (ORE), רכיב של Oracle Advanced Analytics, מאפשר לשלב את שפת התכנות הסטטיסטית R בקוד פתוח עם Oracle Database. בפריסות ORE רגילות, R מותקן בשרת Oracle.
כשמדובר בכמויות גדולות מאוד של נתונים או בגישות שונות לאחסון נתונים, שילוב של R עם BigQuery הוא בחירה אידיאלית. אפשר להשתמש בספריית R בקוד פתוח bigrquery כדי לשלב את R עם BigQuery.
Google משתפת פעולה עם RStudio כדי להעמיד לרשות המשתמשים את הכלים המתקדמים ביותר בתחום. אפשר להשתמש ב-RStudio כדי לגשת לטרה-בייטים של נתונים ב-BigQuery, להתאים מודלים ב-TensorFlow, ולהריץ מודלים של למידת מכונה בקנה מידה נרחב באמצעות פלטפורמת AI. ב- Google Cloud, אפשר להתקין את R ב- Compute Engine בקנה מידה נרחב.
Oracle Data Mining
Oracle Data Mining (ODM), רכיב של Oracle Advanced Analytics, מאפשר למפתחים לבנות מודלים של למידת מכונה באמצעות Oracle PL/SQL Developer ב-Oracle.
בעזרת BigQuery ML, מפתחים יכולים להריץ סוגים רבים ושונים של מודלים, כמו רגרסיה לינארית, רגרסיה לוגיסטית בינארית, רגרסיה לוגיסטית מרובת-מחלקות, אשכולות k-means וייבוא של מודלים של TensorFlow. למידע נוסף, קראו את המאמר מבוא ל-BigQuery ML.
כדי להמיר משימות ODM, יכול להיות שתצטרכו לשכתב את הקוד. אתם יכולים לבחור מתוך מגוון מוצרי Google AI, כמו BigQuery ML, ממשקי AI API (כמו Speech-to-Text, Text-to-Speech, Dialogflow, Cloud Translation, Cloud Natural Language API, Cloud Vision ועוד) או Gemini Enterprise Agent Platform.
אפשר להשתמש ב-Vertex AI Workbench כסביבת פיתוח למדעני נתונים, וב-Vertex AI Training כדי להריץ עומסי עבודה של אימון וניקוד בקנה מידה נרחב.
האפשרות Spatial and Graph
ב-Oracle יש אפשרות Spatial and Graph לשאילתות של גיאומטריה וגרפים, וצריך רישיון כדי להשתמש בה. אתם יכולים להשתמש בפונקציות הגיאומטריות ב-BigQuery בלי עלויות או רישיונות נוספים, ולהשתמש במסדי נתונים אחרים של תרשימים ב- Google Cloud.
מרחבי
ב-BigQuery יש פונקציות וסוגי נתונים של ניתוח נתונים גיאו-מרחביים. מידע נוסף מופיע במאמר עבודה עם נתוני ניתוח גיאו-מרחבי. אפשר להמיר פונקציות וסוגי נתונים של Oracle Spatial לפונקציות geography ב-SQL סטנדרטי של BigQuery. פונקציות גיאוגרפיות לא מוסיפות עלות מעבר לתמחור הרגיל של BigQuery.
תרשים
JanusGraph הוא פתרון למסד נתונים של גרפים בקוד פתוח, שיכול להשתמש ב-Bigtable כ-backend לאחסון. מידע נוסף זמין במאמר הרצת JanusGraph ב-GKE עם Bigtable.
Neo4j הוא פתרון נוסף למסד נתונים של גרפים, שמוצע כשירות Google Cloud שפועל ב-Google Kubernetes Engine (GKE).
Oracle Application Express
אפליקציות Oracle Application Express (APEX) הן ייחודיות ל-Oracle וצריך לשכתב אותן. אפשר לפתח פונקציות של דיווח והצגת נתונים באמצעות Data Studio או BI Engine, ואפשר לפתח פונקציות ברמת האפליקציה, כמו יצירה ועריכה של שורות, בלי לכתוב קוד ב-AppSheet באמצעות Cloud SQL.
המאמרים הבאים
- אופטימיזציה של עומסי עבודה (workloads) לשיפור הביצועים הכוללים ולהפחתת העלויות.
- איך מבצעים אופטימיזציה של האחסון ב-BigQuery
- לעדכונים של BigQuery, קראו את נתוני הגרסה.
- מדריך התרגום של Oracle SQL