


데이터 웨어하우스 마이그레이션 검증
BigQuery Migration Service 검증 서비스를 사용하면 소스 데이터 웨어하우스에서 마이그레이션된 테이블이 BigQuery의 대상 테이블과 일치하는지 확인할 수 있습니다. 스키마와 테이블 데이터를 비교하여 마이그레이션 중에 불일치를 식별할 수 있습니다.
검증 서비스 클라이언트는 소스 데이터베이스에 연결하고 소스 스키마 및 행 데이터를 사용자가 제어하는 Cloud Storage 버킷으로 추출합니다. 추출이 완료되면 검증 서비스는 Cloud Storage 버킷에서 추출된 스키마와 데이터를 마이그레이션된 BigQuery 테이블과 비교합니다.
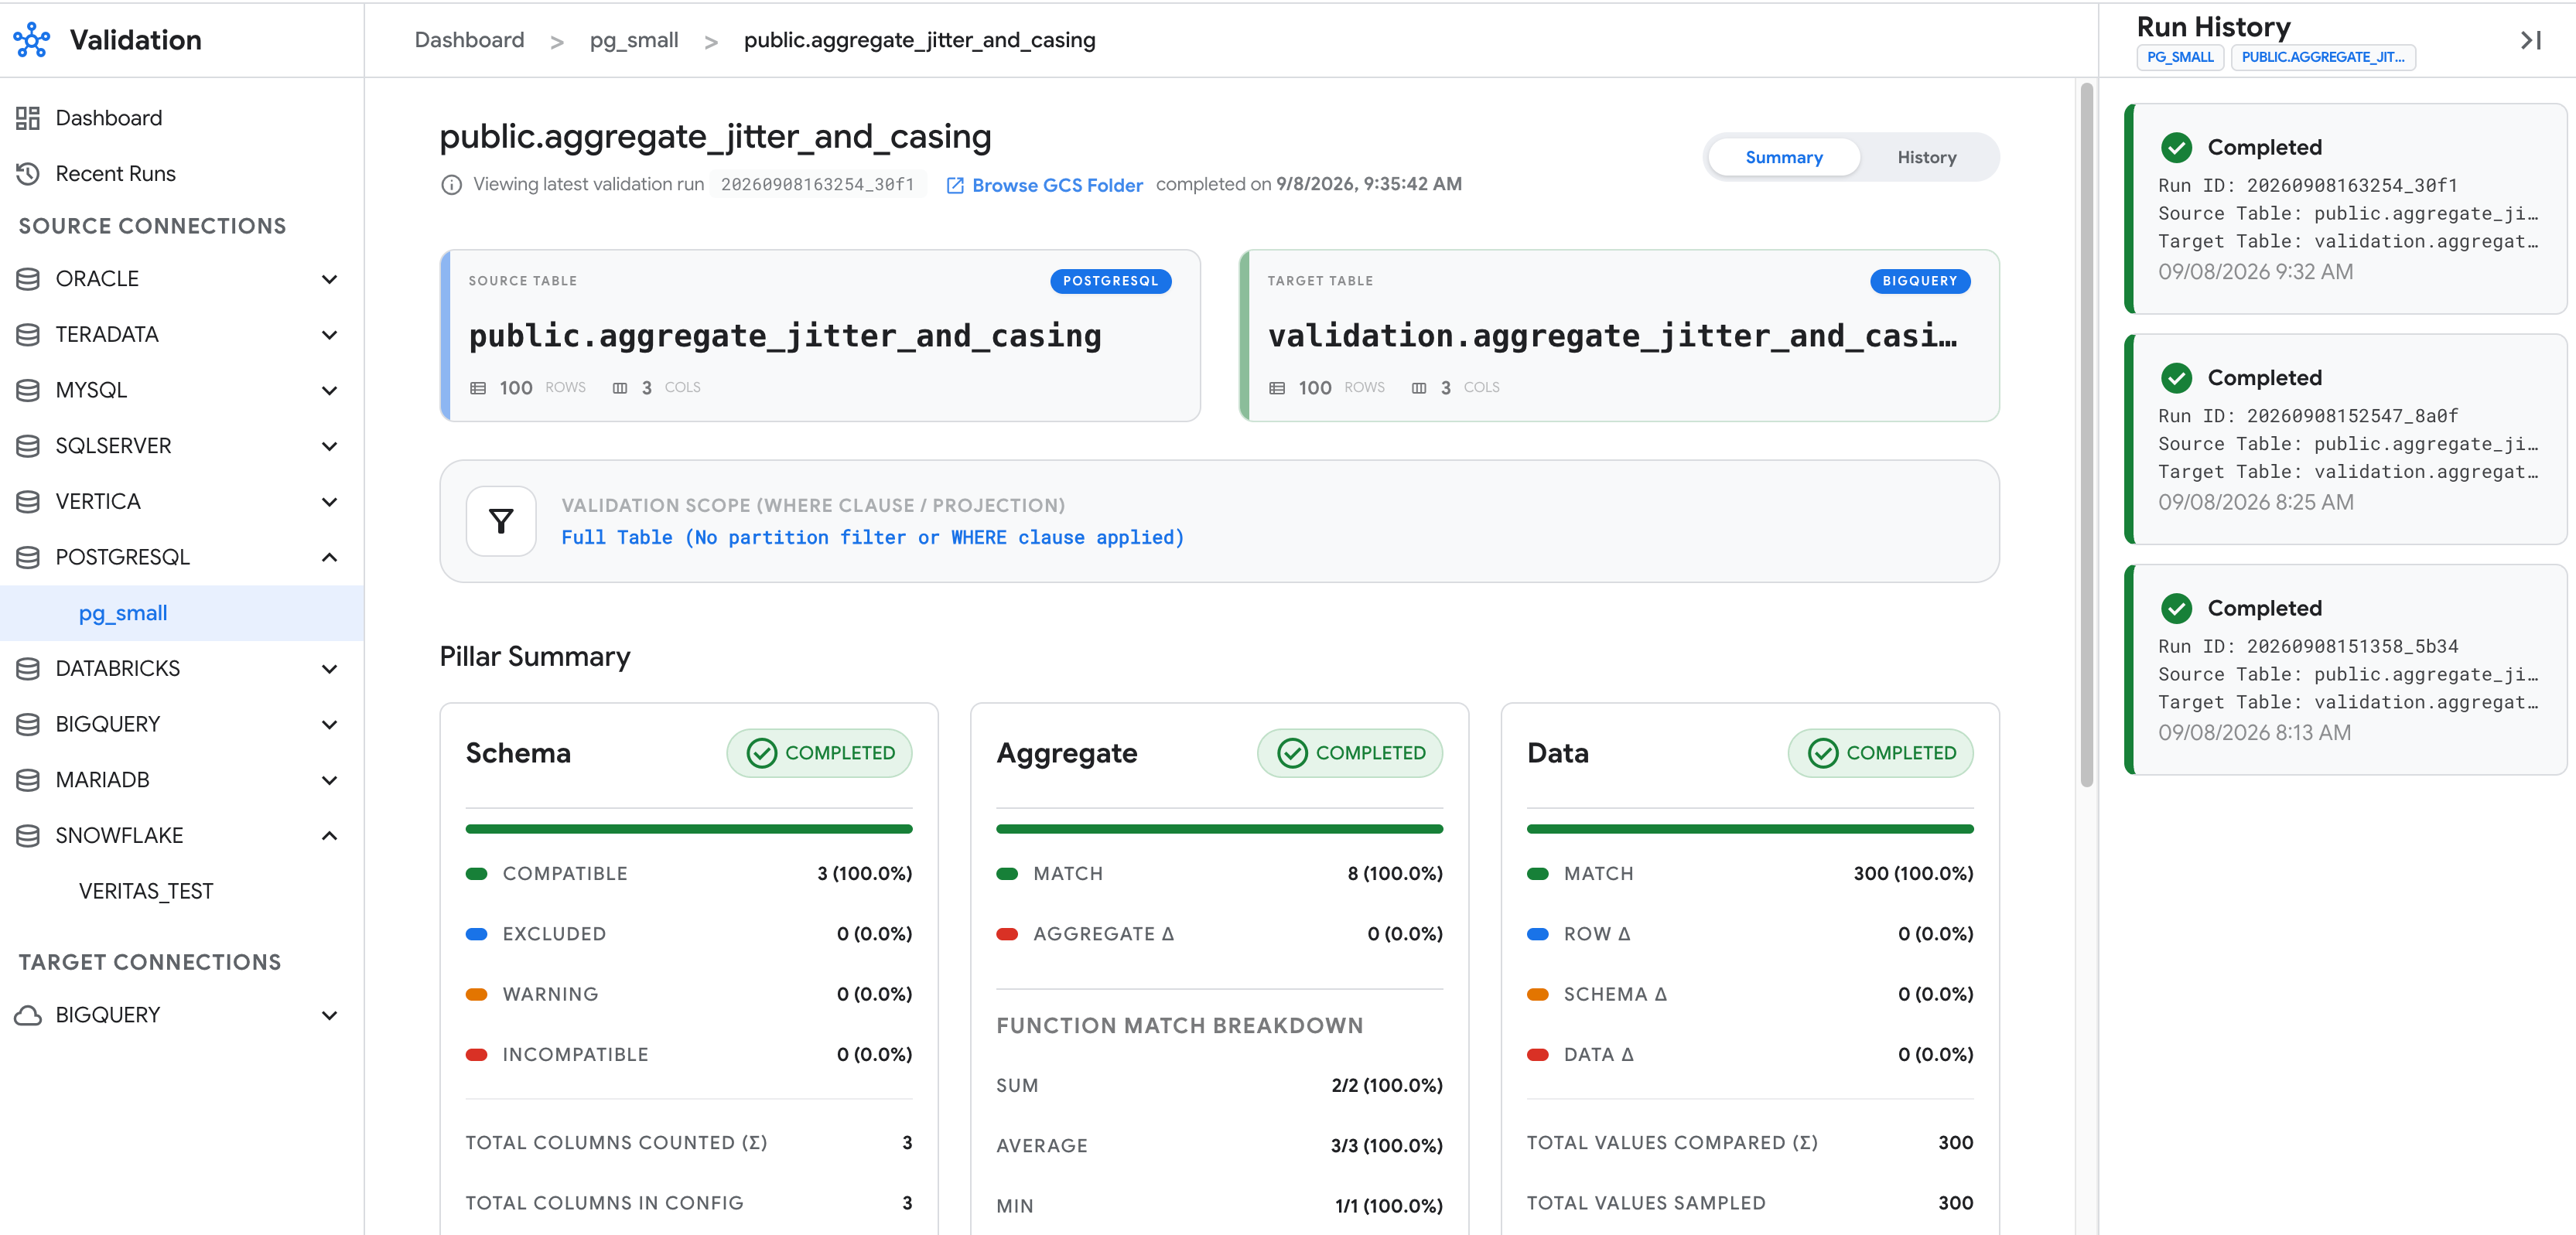
검증 워크플로는 세 가지 검증 핵심 요소를 기준으로 소스 테이블과 대상 BigQuery 테이블을 비교합니다.
- 스키마 검증(
--schema): 소스 테이블과 대상 BigQuery 테이블 간의 열 이름, 데이터 유형, 유형 호환성을 비교합니다. - 집계 검증(
--aggregate): 전체 테이블에서 행 수,SUM,AVG,MIN,MAX, 불리언 분포, 문자열 길이와 같은 테이블 수준 및 열 수준 집계 측정항목을 계산하고 비교합니다. - 데이터 검증(
--data): 전체 테이블 스캔(BRUTE_FORCE) 또는 무작위 키 기반 샘플링(SAMPLE)을 사용하여 행별 비교를 수행하여 누락된 행과 셀 수준 값 드리프트를 감지합니다.
지원되는 위치
검증 서비스는 일부 지역에서만 사용할 수 있습니다. 자세한 내용은 BigQuery 마이그레이션 서비스 위치를 참조하세요.
데이터 처리 및 보안 고려사항
검증 서비스는 실행하는 검증 핵심 요소에 따라 다양한 데이터를 추출하고 스테이징합니다.
- 스키마 검증(
--schema): 셀 값을 추출하지 않고 열 이름, 데이터 유형, 테이블 통계만source_query_result.json파일에 업로드합니다. - 집계 검증(
--aggregate): 포함된 열의 실제MIN및MAX셀 값을 포함하여 계산된 집계 측정항목을source_aggregates.parquet파일에 업로드합니다. - 데이터 검증(
--data): 샘플링된 행에서 또는BRUTE_FORCE전략을 사용할 때 모든 행에서 마스킹되지 않은 원시 셀 값을 추출합니다. 이러한 값을 Apache Parquet 또는 CSV 형식으로 Cloud Storage 스테이징 버킷에 업로드하고 BigQuery의validation_results데이터 세트에 로드합니다.
데이터를 보호하고 검증 환경을 보호하려면 다음 설정을 구성합니다.
- 민감한 열 제외: 민감한 열을
columnSettings.exclude필드에 추가하여 소스 추출 쿼리, 대상 비교, 검증 보고서에서 생략합니다. - 로컬 데이터 스토리지 최소화:
settings.yaml파일의googleCloudStorage.gcsPath필드를 설정하여 샘플링된 행을 로컬 디스크에 쓰지 않고 Cloud Storage로 직접 스트리밍합니다. 공유 호스트에서 실행할 때마다 로컬--output-dir작업 디렉터리를 삭제하여 로컬 메타데이터, 집계, 로그 파일을 삭제합니다. - 스테이징된 데이터 및 결과 암호화: 검증을 실행하기 전에 Cloud Storage 스테이징 버킷 및 BigQuery 결과 데이터 세트(기본적으로
validation_results또는results.dataset필드에 지정된 데이터 세트)에서 Cloud Key Management Service를 사용하여 고객 관리 암호화 키(CMEK)를 구성합니다. - 구성 액세스 제한: 코드 검토가 필요한 버전 제어 저장소 또는 신뢰할 수 있는 사용자만
storage.objects.create권한을 갖는 Cloud Storage 버킷에 검증 구성 파일을 저장합니다. - 최소 권한 액세스 적용: 워크플로 생성자에게 프로젝트가 아닌 검증 중인 대상 데이터 세트 또는 테이블에만
roles/bigquery.dataViewer역할을 부여합니다. 소스 데이터베이스 권한 구성에 설명된 대로 읽기 전용 소스 데이터베이스 사용자를 사용합니다.
시작하기 전에
Google Cloud 콘솔의 프로젝트 선택기 페이지에서 대상 BigQuery 데이터 세트가 포함된 Google Cloud 프로젝트를 선택하거나 만듭니다.
Google Cloud 프로젝트에 결제가 사용 설정되었는지 확인합니다.
BigQuery, BigQuery Migration Service, Cloud Storage, (데이터베이스 비밀번호를 Secret Manager에 저장하는 경우) Secret Manager API를 사용 설정합니다.
추출된 메타데이터 및 데이터 샘플을 스테이징할 대상 BigQuery 데이터 세트와 동일한 위치에 Cloud Storage 버킷을 만들거나 선택합니다. 자세한 내용은 버킷 만들기를 참조하세요.
필수 역할 및 권한
검증 실행은 세 부분으로 구성되며 각 부분은 서로 다른 주 구성원이 수행할 수 있습니다.
- 데이터 수집: 검증 클라이언트가 소스 데이터베이스를 읽고 메타데이터, 집계, 샘플링된 행을 Cloud Storage 스테이징 버킷에 업로드합니다. BigQuery를 호출하지 않습니다.
- 검증: BigQuery Migration Service 검증 워크플로는 스테이징된 데이터를 대상 테이블과 비교합니다. 워크플로는 검증 클라이언트,
gcloud또는 Google Cloud 콘솔 등 워크플로를 만든 주 구성원의 사용자 인증 정보로 실행됩니다. - 결과 보기: 결과 데이터 세트 및 Cloud Storage 보고서를 읽습니다.
generate-config에는 권한이 Google Cloud 필요하지 않습니다.
데이터 수집
소스 데이터를 수집하는 데 필요한 권한을 얻으려면 관리자에게 다음 IAM 역할을 부여해 달라고 요청하세요.
- 스테이징 버킷의 스토리지 객체 생성자(
roles/storage.objectCreator) - 스테이징 버킷의 스토리지 객체 뷰어(
roles/storage.objectViewer) -
Cloud Storage에서 구성 파일 읽기: 구성 버킷의 스토리지 객체 뷰어(
roles/storage.objectViewer) -
Secret Manager에서 데이터베이스 비밀번호 읽기: 보안 비밀에 대한 Secret Manager 보안 비밀 접근자(
roles/secretmanager.secretAccessor)
역할 부여에 대한 자세한 내용은 프로젝트, 폴더, 조직에 대한 액세스 관리를 참조하세요.
이러한 사전 정의된 역할에는 소스 데이터를 수집하는 데 필요한 권한이 포함되어 있습니다. 필요한 정확한 권한을 보려면 필수 권한 섹션을 펼치세요.
필수 권한
소스 데이터를 수집하려면 다음 권한이 필요합니다.
-
스테이징 버킷에 대한
storage.objects.create -
스테이징 버킷에 대한
storage.objects.get -
Cloud Storage에서 구성 파일 읽기:
-
구성 버킷에 대한
storage.objects.get -
구성 버킷에 대한
storage.objects.list
-
구성 버킷에 대한
-
Secret Manager에서 데이터베이스 비밀번호 읽기: 보안 비밀에 대한
secretmanager.versions.access
커스텀 역할이나 다른 사전 정의된 역할을 사용하여 이 권한을 부여받을 수도 있습니다.
--extract-only를 사용하면 데이터 수집에 BigQuery 또는 BigQuery Migration Service 권한이 필요하지 않습니다. 이 플래그가 없으면 클라이언트가 검증 워크플로도 만들고 검증 역할이 필요합니다.
유효성 검사
검증 워크플로를 만들고 실행하는 데 필요한 권한을 얻으려면 관리자에게 다음 IAM 역할을 부여해 달라고 요청하세요.
- 프로젝트에 대한 MigrationWorkflow 편집자(
roles/bigquerymigration.editor) - 프로젝트에 대한 BigQuery 작업 사용자(
roles/bigquery.jobUser) - 각 대상 데이터 세트에 대한 BigQuery 데이터 뷰어(
roles/bigquery.dataViewer) - 결과 데이터 세트에 대한 BigQuery 데이터 편집자(
roles/bigquery.dataEditor) - 스테이징 버킷에 대한 스토리지 객체 사용자(
roles/storage.objectUser) -
결과 데이터 세트가 없는 경우: 프로젝트의 BigQuery 사용자(
roles/bigquery.user)
이러한 사전 정의된 역할에는 검증 워크플로를 만들고 실행하는 데 필요한 권한이 포함되어 있습니다. 필요한 정확한 권한을 보려면 필수 권한 섹션을 펼치세요.
필수 권한
검증 워크플로를 만들고 실행하려면 다음 권한이 필요합니다.
- 프로젝트에 대한
bigquerymigration.workflows.create권한 - 프로젝트에 대한
bigquerymigration.workflows.get권한 - 프로젝트에 대한
bigquery.jobs.create권한 -
각 대상 데이터 세트에 대한
bigquery.tables.get권한 -
각 대상 데이터 세트에 대한
bigquery.tables.getData권한 -
결과 데이터 세트에 대한
bigquery.datasets.get권한 -
결과 데이터 세트에 대한
bigquery.tables.get권한 -
결과 데이터 세트에 대한
bigquery.tables.create권한 -
결과 데이터 세트에 대한
bigquery.tables.update권한 -
결과 데이터 세트에 대한
bigquery.tables.updateData권한 -
결과 데이터 세트에 대한
bigquery.tables.getData권한 -
스테이징 버킷에 대한
storage.objects.get -
스테이징 버킷에 대한
storage.objects.create -
스테이징 버킷에 대한
storage.objects.delete -
결과 데이터 세트가 없는 경우: 프로젝트에 대한
bigquery.datasets.create
roles/bigquerymigration.editor에는 검증에서 사용하지 않는 많은 권한이 포함되어 있습니다. 최소 권한을 위해 bigquerymigration.workflows.create 및 bigquerymigration.workflows.get만 있는 맞춤 역할을 부여합니다.
검증은 대상 테이블만 읽고 결과 데이터 세트에만 씁니다. 프로젝트에서 데이터 세트를 만들 권한이 주 구성원에게 필요하지 않도록 결과 데이터 세트를 미리 만드는 것이 좋습니다.
결과 보기
검증 결과를 보는 데 필요한 권한을 얻으려면 관리자에게 다음 IAM 역할을 부여해 달라고 요청하세요.
- 결과 데이터 세트가 포함된 프로젝트에 대한 BigQuery 작업 사용자(
roles/bigquery.jobUser) - 결과 데이터 세트에 대한 BigQuery 데이터 뷰어(
roles/bigquery.dataViewer) -
Cloud Storage에서 보고서 읽기: 스테이징 버킷의 스토리지 객체 뷰어(
roles/storage.objectViewer) -
Google Cloud 콘솔에서 검증 워크플로 나열 및 보기: 프로젝트에 대한 MigrationWorkflow 뷰어(
roles/bigquerymigration.viewer)
이러한 사전 정의된 역할에는 검증 결과를 보는 데 필요한 권한이 포함되어 있습니다. 필요한 정확한 권한을 보려면 필수 권한 섹션을 펼치세요.
필수 권한
검증 결과를 보려면 다음 권한이 필요합니다.
- 프로젝트에 대한
bigquery.jobs.create권한 -
결과 데이터 세트에 대한
bigquery.tables.get권한 -
결과 데이터 세트에 대한
bigquery.tables.getData권한 -
Cloud Storage에서 보고서 읽기:
-
스테이징 버킷에 대한
storage.objects.get권한 -
스테이징 버킷에 대한
storage.objects.list권한
-
스테이징 버킷에 대한
-
Google Cloud 콘솔에서 검증 워크플로를 나열하고 확인합니다.
- 프로젝트에 대한
bigquerymigration.workflows.list권한 - 프로젝트에 대한
bigquerymigration.workflows.get권한
- 프로젝트에 대한
소스 데이터베이스 권한 구성
다음 권한을 사용하여 소스 데이터베이스 사용자에 대한 읽기 전용 액세스를 구성해야 합니다.
- 검증 중인 모든 소스 테이블에 대한
SELECT권한 - 스키마 및 기본 키 검색에 사용되는 시스템 카탈로그 뷰에 대한 읽기 액세스 권한(예: Oracle의
information_schema테이블,ALL_CONSTRAINTS,ALL_TAB_COLUMNS또는 Amazon Redshift의SVV_COLUMNS및pg_attribute)
이 사용자에게 쓰기, DDL 또는 관리 권한을 부여하지 마세요. 검증 클라이언트는 이 사용자로 검증 구성에서 SQL을 실행합니다. 자세한 내용은 데이터 처리 및 보안 고려사항을 참조하세요.
제한사항
검증 서비스에는 다음과 같은 제한사항이 적용됩니다.
- BigQuery는 지원되는 유일한 대상 데이터베이스입니다. BigQuery가 아닌 두 데이터베이스 간의 검증 또는 BigQuery를 검증 소스로 사용하는 것은 지원되지 않습니다.
- 대상 BigQuery 데이터 세트, 결과 데이터 세트(기본적으로
validation_results또는settings.yaml의results에서 구성된 커스텀 데이터 세트), Cloud Storage 스테이징 버킷, 검증 워크플로 위치(BQMS_VALIDATION_LOCATION)가 동일한 위치에 있어야 합니다. 검증 서비스가 결과 데이터 세트를 만들 때 데이터 세트 위치를 Cloud Storage 스테이징 버킷 및 대상 BigQuery 데이터 세트에서 사용하는 리전으로 기본 설정하거나 명시적으로 설정된 경우results.location로 기본 설정합니다. - 데이터 유형 지원은 소스에 따라 다릅니다. 지원되지 않는 유형의 열은 검증에서 제외됩니다. 자세한 내용은 지원되는 데이터 웨어하우스를 참조하세요.
- BigQuery에서 생성된 실행별 비교 테이블은
settings.yaml의resultTtlHours에 따라 자동으로 만료되며, 기본값은168.0시간 또는 7일입니다.validation_results데이터 세트에서 데이터 세트 수준의 기본 테이블 만료 시간을 구성하지 마세요. 이렇게 하면run_history,run_metrics,column_history와 같은 장기 감사 테이블도 만료됩니다. - BigQuery 테이블 이름은 대소문자를 구분합니다.
generate-config가 변환tables.yaml매핑 없이dwh-migration-dumper도구 메타데이터 보관 파일에서 구성을 만들면 대상 테이블 이름은 소스 식별자 대소문자를 유지합니다. 예를 들어 Oracle 또는 Snowflake의 대문자 테이블 이름입니다.targetTable.name가 BigQuery의 테이블과 정확히 일치하는지 확인합니다.
지원되는 데이터 웨어하우스
검증 서비스는 다음 소스 데이터베이스를 지원합니다. 각 섹션에는 설치에 번들로 제공되는 JDBC 드라이버, dwh-migration-dumper 도구 메타데이터 보관 파일에서 테이블 구성을 자동으로 생성할 수 있는지 여부, 이 데이터베이스의 대형 테이블에 지원되는 파티셔닝 유형, 검증에 지원되는 데이터 유형이 포함됩니다.
- Teradata
- Snowflake
- Amazon Redshift
- Databricks
- Apache Hive
- SQL Server
- MariaDB
- MySQL
- Oracle
- PostgreSQL
VARCHAR(255) 또는 DECIMAL(10,2)과 같이 지원되는 데이터 유형의 매개변수화된 변형도 지원됩니다.
검증 서비스는 자동으로 다운로드된 드라이버보다 먼저 drivers/ 디렉터리의 JAR 파일을 로드하므로 drivers/를 사용하여 번들 드라이버 버전을 재정의할 수도 있습니다.
검증 구성 파일을 자동으로 생성하면 지원되지 않는 데이터 유형이 있는 열이 columnSettings.exclude에 자동으로 추가됩니다. 수동 구성의 경우 columnSettings.exclude에서 명시적으로 제외해야 합니다.
지원되는 대부분의 소스 데이터베이스의 경우 검증 도구는 처음 사용할 때 Maven Central에서 필요한 JDBC 드라이버를 자동으로 다운로드하고, SHA-256 체크섬을 확인하고, ~/.cache/google-cloud-bqms/drivers/(또는 $XDG_CACHE_HOME/google-cloud-bqms/drivers/)에 로컬로 캐시합니다. Teradata와 같이 독점 드라이버를 사용하는 데이터 웨어하우스의 경우 또는 오프라인 또는 에어 갭 환경에서 실행하는 경우 다음을 수행합니다.
- 필수 드라이버 JAR 파일을
./drivers/,<sdk_root>/platform/bqms/drivers/또는BQMS_DRIVER_DIR환경 변수로 지정된 디렉터리에 배치합니다. 이러한 로컬 디렉터리에 배치된 드라이버 JAR은 자동 Maven Central 다운로드보다 우선 적용됩니다. - 에어 갭 환경에서 자동 네트워크 다운로드를 완전히 사용 중지하려면
BQMS_AUTO_DOWNLOAD_DRIVERS=false를 설정하거나 내부 Maven 저장소 미러를 가리키도록BQMS_MAVEN_MIRROR를 설정합니다.
검증 서비스에서 지원하는 각 데이터 소스에 대해 알아보려면 다음 옵션 중 하나를 선택하세요.
Teradata
Teradata 마이그레이션의 검증은 다음과 같이 지원됩니다.
dialect값:teradata- JDBC 드라이버: 사용자 제공. Teradata에서 Teradata JDBC 드라이버 JAR(예:
terajdbc4.jar또는terajdbc.jar)을 다운로드하고drivers/디렉터리 또는BQMS_DRIVER_DIR로 지정된 디렉터리에 복사합니다. - 자동 구성 생성:
dwh-migration-dumper도구 메타데이터 보관 파일(--connector teradata)에서 지원됩니다. - 파티션을 나눈 추출:
INTEGER_RANGE,PHYSICAL
| 카테고리 | 데이터 유형 |
|---|---|
| 숫자 | BYTEINT, SMALLINT, INTEGER, INT, BIGINT, DECIMAL, DEC, NUMERIC, NUMBER, FLOAT, REAL, DOUBLE PRECISION |
| 문자열 | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, LONG VARCHAR |
| 날짜 및 시간 | DATE, TIME, TIME WITH TIME ZONE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
Teradata에서 마이그레이션을 검증할 때는 다음을 고려하세요.
- 테이블에 명시적인 기본 키가 없으면 고유 기본 색인(
UPI) 또는 고유 보조 색인(USI)에서 비교 키가 검색됩니다. 고유하지 않은 기본 색인(NUPI)은 비교 키로 사용되지 않습니다. - 고정 정밀도
NUMBER(P,S)는 지원되지만 제약이 없는NUMBER(정밀도 없음)는 지원되지 않습니다. 제약 조건이 없는NUMBER,CLOB,BLOB,BYTE,VARBYTE,INTERVAL,PERIOD,JSON,XML열은generate-config에 의해 자동으로 제외됩니다(또는 수동 구성의 경우columnSettings.exclude에 나열되어야 함). - 고정 너비
CHAR열은 자동으로 잘립니다.LATIN및UNICODE문자 집합과CASESPECIFIC/NOT CASESPECIFIC속성이 모두 지원됩니다. TIME WITH TIME ZONE및TIMESTAMP WITH TIME ZONE값은 비교 전에 UTC(AT 0)로 정규화됩니다.
Snowflake
Snowflake 마이그레이션의 검증은 다음과 같이 지원됩니다.
dialect값:snowflake- JDBC 드라이버: 처음 사용할 때 자동으로 다운로드되거나(
net.snowflake:snowflake-jdbc) 오프라인 환경의 경우drivers/디렉터리에 사용자가 제공합니다. - 자동 구성 생성:
dwh-migration-dumper도구 메타데이터 보관 파일(--connector snowflake)에서 지원됩니다. - 파티션을 나눈 추출:
INTEGER_RANGE,DATE_RANGE
검증 서비스는 Snowflake 마이그레이션에 대해 다음 데이터 유형을 지원합니다.
| 카테고리 | 데이터 유형 |
|---|---|
| 숫자 | NUMBER, DECIMAL, NUMERIC, FLOAT, REAL, DOUBLE |
| 문자열 | CHAR, VARCHAR, STRING, TEXT |
| 날짜 및 시간 | DATE, TIME, TIMESTAMP_NTZ, TIMESTAMP_LTZ, TIMESTAMP_TZ |
| 불리언 | BOOLEAN |
Snowflake에서 마이그레이션을 검증할 때는 다음 사항을 고려하세요.
- 고정 너비
CHAR열은 자동으로 잘립니다. - BigQuery Data Transfer Service로 데이터를 복제한 경우
tolerances.timestamp: 0.001을 설정하여 밀리초 미만의 반올림을 흡수합니다.
Amazon Redshift
Amazon Redshift 마이그레이션의 유효성 검사는 다음과 같이 지원됩니다.
dialect값:redshift- JDBC 드라이버: 처음 사용할 때 자동으로 다운로드되거나(
com.amazon.redshift:redshift-jdbc42) 오프라인 환경의 경우drivers/디렉터리에 사용자가 제공합니다. - 자동 구성 생성:
dwh-migration-dumper도구 메타데이터 보관 파일(--connector redshift)에서 지원됩니다. - 파티션을 나눈 추출:
INTEGER_RANGE,PHYSICAL
검증 서비스는 Amazon Redshift 마이그레이션에 대해 다음 데이터 유형을 지원합니다.
| 카테고리 | 데이터 유형 |
|---|---|
| 숫자 | SMALLINT, INTEGER, BIGINT, DECIMAL, NUMERIC, REAL, DOUBLE PRECISION |
| 문자열 | CHAR, VARCHAR, TEXT |
| 날짜 및 시간 | DATE, TIME, TIMETZ, TIMESTAMP, TIMESTAMPTZ |
| 불리언 | BOOLEAN |
| 반구조화 | SUPER |
Amazon Redshift에서 마이그레이션을 검증할 때는 다음 사항을 고려하세요.
- 스키마 검사는
SVV_COLUMNS를 사용하므로 지연 결합 뷰가 지원됩니다. - 테이블에 기본 키가 없으면 비교 키가 단일 열
DISTKEY또는SORTKEY로 자동 대체됩니다. GEOMETRY열은 지원되지 않습니다.
Databricks
Databricks 마이그레이션 검증은 다음과 같이 지원됩니다.
dialect값:databricks- JDBC 드라이버: 처음 사용할 때 자동으로 다운로드되거나(
com.databricks:databricks-jdbc) 오프라인 환경의 경우drivers/디렉터리에 사용자가 제공합니다. - 자동 구성 생성: 지원되지 않습니다. 수동 테이블 구성 파일을 만듭니다.
- 파티션을 나눈 추출:
INTEGER_RANGE
검증 서비스는 Databricks 마이그레이션에 대해 다음 데이터 유형을 지원합니다.
| 카테고리 | 데이터 유형 |
|---|---|
| 숫자 | BYTE, TINYINT, SHORT, SMALLINT, INT, INTEGER, LONG, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| 문자열 | CHAR, VARCHAR, STRING |
| 날짜 및 시간 | DATE, TIMESTAMP |
| 불리언 | BOOLEAN |
| 바이너리 | BINARY |
| 복잡 | ARRAY, MAP, STRUCT |
Databricks에서 마이그레이션을 검증할 때는 다음 사항을 고려하세요.
- 개인 액세스 토큰으로 인증:
user: token를 설정하고passwordSecret를 통해 토큰을 제공합니다. - 스키마 검사는 쿼리 기반(
SELECT * ... WHERE 1=0)이므로 Unity Catalog 및 Hive metastore 작업공간이 모두 지원됩니다.
Apache Hive
Apache Hive 마이그레이션 검증은 다음과 같이 지원됩니다.
dialect값:hive- JDBC 드라이버: 처음 사용할 때 자동으로 다운로드되거나(
org.apache.hive:hive-jdbc독립형 JAR) 오프라인 환경의drivers/디렉터리에 사용자가 제공합니다. - 자동 구성 생성:
dwh-migration-dumper도구 메타데이터 보관 파일(--connector hiveql)에서 지원됩니다. - 파티션을 나눈 추출:
INTEGER_RANGE
검증 서비스는 Hive 마이그레이션에 다음 데이터 유형을 지원합니다.
| 카테고리 | 데이터 유형 |
|---|---|
| 숫자 | TINYINT, SMALLINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| 문자열 | CHAR, VARCHAR, STRING |
| 날짜 및 시간 | DATE, TIMESTAMP |
| 불리언 | BOOLEAN |
| 바이너리 | BINARY |
| 복잡 | ARRAY, MAP, STRUCT |
Hive에서 마이그레이션을 검증할 때는 다음을 고려하세요.
- 스키마 검사는 쿼리 기반입니다(
SELECT * ... WHERE 1=0). - Hive 테이블은 기본 키를 정의하는 경우가 거의 없습니다. 비교 키가 없는 테이블은 데이터 열에 전체 행 해시 집계를 자동으로 사용합니다.
SQL Server
SQL Server 마이그레이션 검증은 다음과 같이 지원됩니다.
dialect값:sqlserver- JDBC 드라이버: 처음 사용할 때 자동으로 다운로드되거나(
com.microsoft.sqlserver:mssql-jdbc) 오프라인 환경의 경우drivers/디렉터리에 사용자가 제공합니다. - 자동 구성 생성:
dwh-migration-dumper도구 메타데이터 보관 파일(--connector sqlserver)에서 지원됩니다. - 파티션을 나눈 추출:
INTEGER_RANGE
검증 서비스는 SQL Server 마이그레이션에 다음 데이터 유형을 지원합니다.
| 카테고리 | 데이터 유형 |
|---|---|
| 숫자 | INT, BIGINT, DECIMAL, NUMERIC, FLOAT, REAL |
| 문자열 | CHAR, VARCHAR, TEXT |
| 날짜 및 시간 | DATE, DATETIME, TIMESTAMP |
| 불리언 | BIT |
SQL Server에서 마이그레이션을 검증할 때는 다음을 고려하세요.
- 기본 JDBC URL은
encrypt=true;trustServerCertificate=true;를 설정합니다. 엄격한 TLS 인증서 검증이 필요한 경우url연결 키로 재정의합니다.
MariaDB
MariaDB 마이그레이션의 검증은 다음과 같이 지원됩니다.
dialect값:mariadb- JDBC 드라이버: 처음 사용할 때 자동으로 다운로드되거나(
org.mariadb.jdbc:mariadb-java-client) 오프라인 환경의 경우drivers/디렉터리에 사용자가 제공합니다. - 자동 구성 생성: 수동 테이블 구성 파일을 만듭니다.
- 파티션을 나눈 추출:
INTEGER_RANGE
검증 서비스는 MariaDB 마이그레이션에 대해 다음 데이터 유형을 지원합니다.
| 카테고리 | 데이터 유형 |
|---|---|
| 숫자 | TINYINT, SMALLINT, MEDIUMINT, INT, INTEGER, BIGINT, FLOAT, DOUBLE, DECIMAL, NUMERIC |
| 문자열 | CHAR, VARCHAR, TINYTEXT, TEXT, MEDIUMTEXT, LONGTEXT, ENUM, SET |
| 날짜 및 시간 | DATE, TIME, DATETIME, TIMESTAMP, YEAR |
| 바이너리 및 대형 객체 | BINARY, VARBINARY, TINYBLOB, BLOB, MEDIUMBLOB, LONGBLOB |
MySQL
MySQL 마이그레이션의 검증은 다음과 같이 지원됩니다.
dialect값:mysql- JDBC 드라이버: 처음 사용할 때 자동으로 다운로드되거나(
com.mysql:mysql-connector-j) 오프라인 환경의 경우drivers/디렉터리에 사용자가 제공합니다. - 자동 구성 생성: 수동 테이블 구성 파일을 만듭니다.
- 파티션을 나눈 추출:
INTEGER_RANGE
검증 서비스는 MySQL 마이그레이션에 다음 데이터 유형을 지원합니다.
| 카테고리 | 데이터 유형 |
|---|---|
| 숫자 | INT, BIGINT, DECIMAL, FLOAT, DOUBLE |
| 문자열 | CHAR, VARCHAR, TEXT |
| 날짜 및 시간 | DATE, TIME, DATETIME, TIMESTAMP |
| 불리언 | BOOLEAN |
Oracle
Oracle 마이그레이션의 검증은 다음과 같이 지원됩니다.
dialect값:oracle- JDBC 드라이버: 처음 사용할 때 자동으로 다운로드되거나(
com.oracle.database.jdbc:ojdbc11) 오프라인 환경의 경우drivers/디렉터리에 사용자가 제공합니다. - 자동 구성 생성:
dwh-migration-dumper도구 메타데이터 보관 파일(--connector oracle)에서 지원됩니다. - 파티션을 나눈 추출:
INTEGER_RANGE,PHYSICAL
검증 서비스는 Oracle 마이그레이션에 대해 다음 데이터 유형을 지원합니다.
| 카테고리 | 데이터 유형 |
|---|---|
| 숫자 | NUMBER, NUMERIC, INTEGER, FLOAT, DOUBLE |
| 문자열 | CHAR, NCHAR, VARCHAR, VARCHAR2, NVARCHAR2 |
| 날짜 및 시간 | DATE, TIMESTAMP, TIMESTAMP WITH TIME ZONE |
| 바이너리 및 대형 객체 | RAW, BINARY, BLOB, CLOB, NCLOB |
Oracle에서 마이그레이션을 검증할 때는 다음을 고려하세요.
DATE열에는 Oracle의 시간 구성요소가 포함됩니다. 검증 도구는 일 단위 정밀도(YYYY-MM-DD)로 OracleDATE열을 추출하므로 시간 차이는 잘립니다.
PostgreSQL
PostgreSQL 마이그레이션의 유효성 검사는 다음과 같이 지원됩니다.
dialect값:postgresql- JDBC 드라이버: 처음 사용할 때 자동으로 다운로드되거나(
org.postgresql:postgresql) 오프라인 환경의 경우drivers/디렉터리에 사용자가 제공합니다. - 자동 구성 생성:
dwh-migration-dumper도구 메타데이터 보관 파일(--connector postgres)에서 지원됩니다. - 파티션을 나눈 추출:
INTEGER_RANGE,DATE_RANGE,PHYSICAL
검증 서비스는 PostgreSQL 마이그레이션에 다음 데이터 유형을 지원합니다.
| 카테고리 | 데이터 유형 |
|---|---|
| 숫자 | SMALLINT, INTEGER, BIGINT, NUMERIC, DOUBLE PRECISION |
| 문자열 | CHAR, CHARACTER, VARCHAR, CHARACTER VARYING, TEXT |
| 날짜 및 시간 | DATE, TIME, TIMESTAMP, TIMESTAMP WITHOUT TIME ZONE, TIMESTAMP WITH TIME ZONE, TIMESTAMPTZ |
| 불리언 | BOOLEAN |
| 기타 | UUID |
PostgreSQL에서 마이그레이션을 검증할 때는 다음 사항을 고려하세요.
BIGINT값이 253보다 크면AVG()에서 약간의 정밀도 차이가 표시될 수 있습니다.SUM및COUNT는 정확하게 유지됩니다.
검증 구성 디렉터리 및 파일 설정
검증 서비스는 다음 파일이 포함된 validation_config/이라는 모듈식 구성 디렉터리에서 읽습니다.
- 데이터베이스 연결 파일:
source데이터 웨어하우스 연결 프로필과targetBigQuery 연결 프로필을 정의합니다. - 스테이징 및 결과 설정 파일: Cloud Storage 스테이징 경로(
googleCloudStorage), BigQuery 결과 데이터 세트 구성(results), 실행별 비교 테이블 만료(resultTtlHours), 선택적 전역 기본값(tolerances,aggregate,labels)을 정의합니다. - 테이블 검증 구성 파일: 테이블별 매핑(
sourceTable및targetTable), 비교 키(comparisonKeys), 검증 전략(strategy), 파티션을 나눈 추출 설정(partitioning), 열 설정(columnSettings)이 포함됩니다.
다음 섹션에서는 검증 구성 디렉터리를 설정하는 단계와 마이그레이션 검증에 필요한 구성 파일을 만드는 단계를 설명합니다.
검증 구성 디렉터리 만들기
검증 구성 파일을 저장할 validation_config/이라는 검증 구성 디렉터리를 만듭니다. 이 디렉터리를 검증 서비스를 실행하는 머신에 저장하거나 Cloud Storage 버킷에 저장하여 팀이 실행 간에 하나의 구성을 공유할 수 있습니다.
데이터베이스 연결 파일 만들기
검증 구성 디렉터리에서 connections.yaml라는 파일을 만들고 소스 데이터베이스와 대상 BigQuery 데이터베이스에 연결할 정보로 구성합니다.
각 데이터 웨어하우스 소스에는 데이터베이스 연결 파일을 만들 때 고려해야 할 특정 기능과 요구사항이 있습니다. 각 데이터 소스에 대한 자세한 내용은 지원되는 데이터 웨어하우스를 참조하세요.
연결 프로필에 passwordSecret를 지정하면 검증 서비스가 로컬 애플리케이션 기본 사용자 인증 정보(ADC)를 사용하여 클라이언트 머신의 Secret Manager에서 보안 비밀 버전을 가져오고 확인된 비밀번호를 로컬 JDBC 드라이버에 직접 전달합니다. 소스 데이터베이스에는 Google Cloud에 대한 네트워크 액세스 또는 IAM 액세스가 필요하지 않으므로 passwordSecret는 온프레미스 데이터베이스와 Amazon Redshift 또는 Snowflake와 같은 다른 클라우드에서 호스팅되는 데이터베이스에서 작동합니다. 또는 passwordSecret를 생략하고 검증 서비스를 실행하는 머신에서 BQMS_VALIDATION_SOURCE_PASSWORD 환경 변수를 설정할 수 있습니다.
데이터 웨어하우스의 데이터베이스 연결 파일을 만들려면 다음 옵션 중 하나를 선택합니다.
Teradata
Teradata 마이그레이션 검증의 경우 다음 정보로 데이터베이스 연결 파일을 구성합니다.
connections:
source:
  dialect: teradata
  host: SOURCE_HOST
  port: 1025
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
다음을 바꿉니다.
SOURCE_HOST: Teradata 시스템의 호스트 이름 또는 IP 주소입니다.SOURCE_DATABASE: 필수 Teradata 데이터베이스 이름입니다.SOURCE_USER: Teradata 사용자 이름입니다.SECRET_PROJECT_ID및SECRET_ID: 비밀번호가 포함된 Secret Manager의 프로젝트 ID 및 보안 비밀 ID 또는BQMS_VALIDATION_SOURCE_PASSWORD설정TARGET_PROJECT_ID: 대상 Google Cloud프로젝트 ID입니다.TARGET_DATASET: 대상 BigQuery 데이터 세트 이름입니다.
Snowflake
Snowflake 마이그레이션 검증의 경우 다음 정보로 데이터베이스 연결 파일을 구성합니다.
connections:
source:
  dialect: snowflake
  account: SNOWFLAKE_ACCOUNT
  warehouse: SNOWFLAKE_WAREHOUSE
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  role: SNOWFLAKE_ROLE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
다음을 바꿉니다.
SNOWFLAKE_ACCOUNT: Snowflake 계정 식별자(예:myorg-myaccount)SNOWFLAKE_WAREHOUSE: 추출 쿼리를 실행하는 데 사용되는 가상 웨어하우스입니다.SOURCE_DATABASE: 필수 Snowflake 데이터베이스 이름입니다.SOURCE_SCHEMA: 필수 Snowflake 스키마 이름입니다.SNOWFLAKE_ROLE: 선택적 Snowflake 역할입니다.SOURCE_USER: Snowflake 사용자 이름입니다.SECRET_PROJECT_ID및SECRET_ID: 비밀번호가 포함된 Secret Manager의 프로젝트 ID 및 보안 비밀 ID 또는BQMS_VALIDATION_SOURCE_PASSWORD설정TARGET_PROJECT_ID: 대상 Google Cloud프로젝트 ID입니다.TARGET_DATASET: 대상 BigQuery 데이터 세트 이름입니다.
Amazon Redshift
Amazon Redshift 마이그레이션 검증의 경우 다음 정보로 데이터베이스 연결 파일을 구성합니다.
connections:
source:
  dialect: redshift
  host: SOURCE_HOST
  port: 5439
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
다음을 바꿉니다.
SOURCE_HOST: Amazon Redshift 클러스터 엔드포인트 호스트 이름입니다.SOURCE_DATABASE: 필수 Amazon Redshift 데이터베이스 이름입니다.SOURCE_SCHEMA: 기본 스키마 이름입니다(생략된 경우 기본값은public).SOURCE_USER: 데이터베이스 사용자 이름입니다.SECRET_PROJECT_ID및SECRET_ID: 비밀번호가 포함된 Secret Manager의 프로젝트 ID 및 보안 비밀 ID 또는BQMS_VALIDATION_SOURCE_PASSWORD설정TARGET_PROJECT_ID: 대상 Google Cloud프로젝트 ID입니다.TARGET_DATASET: 대상 BigQuery 데이터 세트 이름입니다.
Databricks
Databricks 마이그레이션 검증의 경우 다음 정보로 데이터베이스 연결 파일을 구성합니다.
connections:
source:
  dialect: databricks
  host: DATABRICKS_HOST
  port: 443
  httpPath: HTTP_PATH
  catalog: CATALOG_NAME
  schema: SCHEMA_NAME
  user: token
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
다음을 바꿉니다.
DATABRICKS_HOST: Databricks SQL 웨어하우스 또는 클러스터의 서버 호스트 이름입니다.HTTP_PATH: Databricks SQL 웨어하우스의 HTTP 경로(예:sql/protocolv1/o/1234567890/0123-456789-abcdef)CATALOG_NAME: 필수 Unity 카탈로그 이름(또는hive_metastore)SCHEMA_NAME: 필수 스키마 이름입니다.SECRET_PROJECT_ID및SECRET_ID: Databricks 개인 액세스 토큰(PAT)이 포함된 Secret Manager의 프로젝트 ID 및 보안 비밀 ID. 또는passwordSecret를 생략하고BQMS_VALIDATION_SOURCE_PASSWORD를 설정합니다.passwordSecret와 함께user: token를 사용하면 토큰이 스테이징 메타데이터 파일에 기록되지 않습니다.TARGET_PROJECT_ID: 대상 Google Cloud프로젝트 ID입니다.TARGET_DATASET: 대상 BigQuery 데이터 세트 이름입니다.
Apache Hive
Apache Hive 마이그레이션 검증의 경우 다음 정보로 데이터베이스 연결 파일을 구성합니다.
connections:
source:
  dialect: hive
  host: SOURCE_HOST
  port: 10000
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
다음을 바꿉니다.
SOURCE_HOST: HiveServer2 호스트 이름 또는 IP 주소입니다.SOURCE_DATABASE: 필수 Hive 데이터베이스 이름(예:default)SOURCE_USER: Hive 사용자 이름입니다.SECRET_PROJECT_ID및SECRET_ID: 비밀번호가 포함된 Secret Manager의 프로젝트 ID 및 보안 비밀 ID 또는BQMS_VALIDATION_SOURCE_PASSWORD설정TARGET_PROJECT_ID: 대상 Google Cloud프로젝트 ID입니다.TARGET_DATASET: 대상 BigQuery 데이터 세트 이름입니다.
SQL Server
SQL Server 마이그레이션 검증의 경우 다음 정보로 데이터베이스 연결 파일을 구성합니다.
connections:
source:
  dialect: sqlserver
  host: SOURCE_HOST
  port: 1433
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
다음을 바꿉니다.
SOURCE_HOST: SQL Server 인스턴스의 호스트 이름 또는 IP 주소입니다(선택적으로 이름이 지정된 인스턴스에 대해instanceName지정).SOURCE_DATABASE: 필수 데이터베이스 이름입니다.SOURCE_SCHEMA: 기본 스키마 이름입니다(생략된 경우 기본값은dbo).SOURCE_USER: 데이터베이스 사용자 이름입니다.SECRET_PROJECT_ID및SECRET_ID: 비밀번호가 포함된 Secret Manager의 프로젝트 ID 및 보안 비밀 ID 또는BQMS_VALIDATION_SOURCE_PASSWORD설정TARGET_PROJECT_ID: 대상 Google Cloud프로젝트 ID입니다.TARGET_DATASET: 대상 BigQuery 데이터 세트 이름입니다.
MariaDB
MariaDB 마이그레이션 검증의 경우 다음 정보로 데이터베이스 연결 파일을 구성합니다.
connections:
source:
  dialect: mariadb
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
다음을 바꿉니다.
SOURCE_HOST: MariaDB 서버의 호스트 이름 또는 IP 주소입니다.SOURCE_DATABASE: 필수 MariaDB 데이터베이스 이름입니다.SOURCE_USER: MariaDB 사용자 이름입니다.SECRET_PROJECT_ID및SECRET_ID: 비밀번호가 포함된 Secret Manager의 프로젝트 ID 및 보안 비밀 ID 또는BQMS_VALIDATION_SOURCE_PASSWORD설정TARGET_PROJECT_ID: 대상 Google Cloud프로젝트 ID입니다.TARGET_DATASET: 대상 BigQuery 데이터 세트 이름입니다.
MySQL
MySQL 마이그레이션 검증의 경우 다음 정보로 데이터베이스 연결 파일을 구성합니다.
connections:
source:
  dialect: mysql
  host: SOURCE_HOST
  port: 3306
  database: SOURCE_DATABASE
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
다음을 바꿉니다.
SOURCE_HOST: MySQL 서버의 호스트 이름 또는 IP 주소입니다.SOURCE_DATABASE: 필수 MySQL 데이터베이스 이름입니다.SOURCE_USER: MySQL 사용자 이름입니다.SECRET_PROJECT_ID및SECRET_ID: 비밀번호가 포함된 Secret Manager의 프로젝트 ID 및 보안 비밀 ID 또는BQMS_VALIDATION_SOURCE_PASSWORD설정TARGET_PROJECT_ID: 대상 Google Cloud프로젝트 ID입니다.TARGET_DATASET: 대상 BigQuery 데이터 세트 이름입니다.
Oracle
Oracle 마이그레이션 검증의 경우 다음 정보로 데이터베이스 연결 파일을 구성합니다.
connections:
source:
  dialect: oracle
  host: SOURCE_HOST
  port: 1521
  database: SERVICE_NAME
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
다음을 바꿉니다.
SOURCE_HOST: Oracle 서버의 호스트 이름 또는 IP 주소입니다.SERVICE_NAME: Oracle 서비스 이름(jdbc:oracle:thin:@//HOST:PORT/SERVICE_NAME구성에 사용됨)입니다. 커스텀 TNS 또는 SID 연결의 경우 대신 전체 JDBC URL과 함께url를 지정합니다.SOURCE_SCHEMA: 선택사항인 기본 스키마 이름입니다.SOURCE_USER: 필수 Oracle 사용자 이름입니다.SECRET_PROJECT_ID및SECRET_ID: 데이터베이스 비밀번호가 포함된 Secret Manager의 프로젝트 ID 및 보안 비밀 ID 또는BQMS_VALIDATION_SOURCE_PASSWORD설정.TARGET_PROJECT_ID: 대상 Google Cloud프로젝트 ID입니다.TARGET_DATASET: 대상 BigQuery 데이터 세트 이름입니다.
PostgreSQL
PostgreSQL 마이그레이션 검증의 경우 다음 정보로 데이터베이스 연결 파일을 구성합니다.
connections:
source:
  dialect: postgresql
  host: SOURCE_HOST
  port: 5432
  database: SOURCE_DATABASE
  schema: SOURCE_SCHEMA
  user: SOURCE_USER
  passwordSecret: projects/SECRET_PROJECT_ID/secrets/SECRET_ID/versions/latest
target:
  dialect: bigquery
  projectId: TARGET_PROJECT_ID
  dataset: TARGET_DATASET
다음을 바꿉니다.
SOURCE_HOST: PostgreSQL 서버의 호스트 이름 또는 IP 주소입니다.SOURCE_DATABASE: 필수 PostgreSQL 데이터베이스 이름SOURCE_SCHEMA: 기본 스키마 이름입니다(생략된 경우 기본값은public).SOURCE_USER: 데이터베이스 사용자 이름입니다.SECRET_PROJECT_ID및SECRET_ID: 데이터베이스 비밀번호가 포함된 Secret Manager의 프로젝트 ID 및 보안 비밀 ID입니다. 또는passwordSecret를 생략하고BQMS_VALIDATION_SOURCE_PASSWORD환경 변수를 설정합니다.TARGET_PROJECT_ID: 마이그레이션된 BigQuery 테이블이 포함되고validation_results데이터 세트가 생성되는 Google Cloud 프로젝트 ID입니다.TARGET_DATASET: 대상 BigQuery 데이터 세트 이름입니다.
설정 파일 만들기
검증 구성 디렉터리에 settings.yaml라는 스테이징 및 결과 설정 파일을 만들어 Cloud Storage 스테이징 경로, BigQuery 결과 데이터 세트, 실행별 테이블 만료, 선택적 전역 기본값을 구성합니다.
다음과 같이 스테이징 및 결과 설정 파일을 구성합니다.
googleCloudStorage:
  gcsPath: gs://BUCKET_NAME/PATH_PREFIX
  format: FORMAT

results:
  projectId: RESULTS_PROJECT_ID
  dataset: RESULTS_DATASET
  location: RESULTS_LOCATION

resultTtlHours: RESULT_TTL_HOURS
results: RESULTS_CONFIG
다음을 바꿉니다.
BUCKET_NAME: Cloud Storage 스테이징 버킷의 이름입니다.PATH_PREFIX: 추출된 스키마 메타데이터, 집계 측정항목, 샘플링된 행, 요약 보고서를 스테이징하는 데 사용되는 버킷의 Cloud Storage URI 프리픽스입니다.FORMAT: 스테이징된 데이터 샘플의 파일 형식입니다. 지원되는 값은parquet(기본값) 및csv입니다.RESULTS_PROJECT_ID: 검증 결과 및 실행 기록 테이블이 작성되는 Google Cloud 프로젝트 ID입니다. 생략하면 기본값은connections.yaml의target.projectId입니다.RESULTS_DATASET: 검증 결과 및 실행 기록 테이블(run_history,run_metrics,column_history)이 작성되는 BigQuery 데이터 세트 이름입니다. 생략하면 기본값은validation_results입니다. 데이터 세트가 없으면 검증 서비스에서 자동으로 만듭니다.RESULTS_LOCATION: 결과 데이터 세트의 BigQuery 위치입니다. 생략하면 자동으로 생성된 결과 데이터 세트가 기본적으로 Cloud Storage 스테이징 버킷 및 대상 BigQuery 데이터 세트의 리전으로 설정됩니다.RESULT_TTL_HOURS: 결과 데이터 세트에 생성된 실행별 비교 및 불일치 테이블의 TTL(수명)(시간)입니다. 기본값은168.0시간(7일)입니다. 장기 모니터링 가능성 테이블(run_history,run_metrics,column_history)은resultTtlHours의 영향을 받지 않습니다.RESULTS_CONFIG: 비교 결과 및 감사 기록을 위한 대상 BigQuery 데이터 세트를 구성합니다. 지원되는 값은projectId,dataset,location입니다. 생략하면 검증 서비스가TARGET_PROJECT_ID.validation_results` 에 쓰고, 대상 데이터 세트 및 Cloud Storage 스테이징 버킷과 동일한 리전에 데이터 세트가 아직 없으면 자동으로 만듭니다.
settings.yaml 또는 validation-config.yaml의 최상위 수준에서 tolerances, aggregate 또는 labels를 지정하여 전역 테이블 기본값을 지정할 수도 있습니다. 이러한 기본값은 개별 테이블 구성에서 재정의되지 않는 한 모든 테이블에 적용됩니다.
테이블 검증 구성 생성
연결 및 설정 파일을 구성한 후 테이블 검증 구성을 정의합니다. generate-config 명령어는 최상위 table: 키를 사용하여 validation_config/databases/DATABASE/SCHEMA/TABLE.yaml에서 테이블당 하나의 YAML 파일을 작성하거나 수동 validation_config/tables.yaml 파일을 만들 수 있습니다.
소스 데이터베이스의 테이블 검증 구성을 생성하는 방법에 대한 자세한 내용은 다음 옵션 중 하나를 선택하세요.
Teradata
Teradata 마이그레이션 검증의 경우 다음을 수행하여 소스 스키마의 dwh-migration-dumper 도구 메타데이터 보관 파일을 생성합니다.
dwh-migration-dumper도구를 설치합니다.- 소스 데이터베이스에 대해
dwh-migration-dumper를 실행하여dwh-migration-dumper도구 메타데이터 보관 파일을 생성합니다.
메타데이터 보관 파일을 사용하여 generate-config를 실행하여 테이블별 구성 파일을 생성합니다. --update 플래그를 사용하여 validation_config/에서 만든 기존 connections.yaml 및 settings.yaml 파일을 보존할 수 있습니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
일괄 SQL 변환기의 tables.yaml 스키마 매핑 파일도 있는 경우 --tables-yaml 플래그를 단독으로 또는 --metadata와 함께 포함하여 변환된 테이블 매핑을 메타데이터 보관 파일의 소스 파티션 메타데이터 및 데이터 유형 제외로 보완합니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 명령어는 다음 플래그를 지원합니다.
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper도구 메타데이터 보관 파일(ZIP 파일) 또는 메타데이터 보관 파일이 포함된 디렉터리의 경로입니다.--tables-yaml PATH_TO_TABLES_YAML: 하나 이상의 번역tables.yaml파일 또는 디렉터리의 경로입니다(쉼표로 구분).--target-dataset TARGET_DATASET: 생성된targetTable.name항목에 프리픽스로 추가할 대상 BigQuery 데이터 세트 이름입니다.-o, --output-dir DIRECTORY: 모듈식 구성 파일의 출력 디렉터리입니다. 기본값은validation_config입니다.--schemas SCHEMA_LIST: 포함할 소스 스키마 또는 데이터베이스의 쉼표로 구분된 목록입니다(대소문자 구분,*와일드 카드 지원).--tables TABLE_LIST: 포함할 쉼표로 구분된 테이블 이름(TABLE,SCHEMA.TABLE,DB.SCHEMA.TABLE) 목록입니다(대소문자 구분,*와일드 카드 지원).--filter-file PATH: 포함할 테이블 이름의 줄바꿈으로 구분된 파일의 경로입니다(#로 시작하는 줄은 무시됨).--update: 검색된 테이블을 기존validation_config/디렉터리에 병합하면서 기존connections.yaml,settings.yaml, 커스텀 테이블별 재정의를 유지합니다.--force: 기존 테이블 구성 파일을 유지하면서 새로 검색된 테이블 파일을 비어 있지 않은 출력 디렉터리에 쓸 수 있습니다.--clean: 새로 검색된 파일을 작성하기 전에 출력 디렉터리의 모든 기존 파일을 삭제합니다.
Snowflake
Snowflake 마이그레이션 검증의 경우 다음을 수행하여 소스 스키마의 dwh-migration-dumper 도구 메타데이터 보관 파일을 생성합니다.
dwh-migration-dumper도구를 설치합니다.- 소스 데이터베이스에 대해
dwh-migration-dumper를 실행하여dwh-migration-dumper도구 메타데이터 보관 파일을 생성합니다.
메타데이터 보관 파일을 사용하여 generate-config를 실행하여 테이블별 구성 파일을 생성합니다. --update 플래그를 사용하여 validation_config/에서 만든 기존 connections.yaml 및 settings.yaml 파일을 보존할 수 있습니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
일괄 SQL 변환기의 tables.yaml 스키마 매핑 파일도 있는 경우 --tables-yaml 플래그를 단독으로 또는 --metadata와 함께 포함하여 소스 클러스터링 키(기본 키가 없는 파티션을 나눈 테이블의 경우), 물리적 파티션 메타데이터, 메타데이터 보관 파일의 데이터 유형 제외를 사용하여 변환된 테이블 매핑을 보완합니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 명령어는 다음 플래그를 지원합니다.
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper도구 메타데이터 보관 파일(ZIP 파일) 또는 메타데이터 보관 파일이 포함된 디렉터리의 경로입니다.--tables-yaml PATH_TO_TABLES_YAML: 하나 이상의 번역tables.yaml파일 또는 디렉터리의 경로입니다(쉼표로 구분).--target-dataset TARGET_DATASET: 생성된targetTable.name항목에 프리픽스로 추가할 대상 BigQuery 데이터 세트 이름입니다.-o, --output-dir DIRECTORY: 모듈식 구성 파일의 출력 디렉터리입니다. 기본값은validation_config입니다.--schemas SCHEMA_LIST: 포함할 소스 스키마 또는 데이터베이스의 쉼표로 구분된 목록입니다(대소문자 구분,*와일드 카드 지원).--tables TABLE_LIST: 포함할 쉼표로 구분된 테이블 이름(TABLE,SCHEMA.TABLE,DB.SCHEMA.TABLE) 목록입니다(대소문자 구분,*와일드 카드 지원).--filter-file PATH: 포함할 테이블 이름의 줄바꿈으로 구분된 파일의 경로입니다(#로 시작하는 줄은 무시됨).--update: 검색된 테이블을 기존validation_config/디렉터리에 병합하면서 기존connections.yaml,settings.yaml, 커스텀 테이블별 재정의를 유지합니다.--force: 기존 테이블 구성 파일을 유지하면서 새로 검색된 테이블 파일을 비어 있지 않은 출력 디렉터리에 쓸 수 있습니다.--clean: 새로 검색된 파일을 작성하기 전에 출력 디렉터리의 모든 기존 파일을 삭제합니다.
Amazon Redshift
Amazon Redshift 마이그레이션 검증의 경우 다음을 수행하여 소스 스키마의 메타데이터 ZIP 파일을 생성합니다.
dwh-migration-dumper도구를 설치합니다.- 소스 데이터베이스에 대해
dwh-migration-dumper를 실행하여dwh-migration-dumper도구 메타데이터 보관 파일을 생성합니다.
메타데이터 보관 파일을 사용하여 generate-config를 실행하여 테이블별 구성 파일을 생성합니다. --update 플래그를 사용하여 validation_config/에서 만든 기존 connections.yaml 및 settings.yaml 파일을 보존할 수 있습니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
일괄 SQL 변환기의 tables.yaml 스키마 매핑 파일도 있는 경우 --tables-yaml 플래그를 단독으로 또는 --metadata와 함께 포함하여 변환된 테이블 매핑을 소스 파티션 메타데이터 및 메타데이터 보관 파일의 데이터 유형 제외로 보완합니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 명령어는 다음 플래그를 지원합니다.
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper도구 메타데이터 보관 파일(ZIP 파일) 또는 메타데이터 보관 파일이 포함된 디렉터리의 경로입니다.--tables-yaml PATH_TO_TABLES_YAML: 하나 이상의 번역tables.yaml파일 또는 디렉터리의 경로입니다(쉼표로 구분).--target-dataset TARGET_DATASET: 생성된targetTable.name항목에 프리픽스로 추가할 대상 BigQuery 데이터 세트 이름입니다.-o, --output-dir DIRECTORY: 모듈식 구성 파일의 출력 디렉터리입니다. 기본값은validation_config입니다.--schemas SCHEMA_LIST: 포함할 소스 스키마 또는 데이터베이스의 쉼표로 구분된 목록입니다(대소문자 구분,*와일드 카드 지원).--tables TABLE_LIST: 포함할 쉼표로 구분된 테이블 이름(TABLE,SCHEMA.TABLE,DB.SCHEMA.TABLE) 목록입니다(대소문자 구분,*와일드 카드 지원).--filter-file PATH: 포함할 테이블 이름의 줄바꿈으로 구분된 파일의 경로입니다(#로 시작하는 줄은 무시됨).--update: 검색된 테이블을 기존validation_config/디렉터리에 병합하면서 기존connections.yaml,settings.yaml, 커스텀 테이블별 재정의를 유지합니다.--force: 기존 테이블 구성 파일을 유지하면서 새로 검색된 테이블 파일을 비어 있지 않은 출력 디렉터리에 쓸 수 있습니다.--clean: 새로 검색된 파일을 작성하기 전에 출력 디렉터리의 모든 기존 파일을 삭제합니다.
Databricks
Databricks에서는 자동 구성 생성이 지원되지 않습니다. 다음 구성으로 validation_config/ 디렉터리에 tables.yaml 파일을 수동으로 만듭니다.
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Apache Hive
Apache Hive 마이그레이션 검증의 경우 다음을 수행하여 소스 스키마의 메타데이터 ZIP 파일을 생성합니다.
dwh-migration-dumper도구를 설치합니다.- 소스 데이터베이스에 대해
dwh-migration-dumper를 실행하여dwh-migration-dumper도구 메타데이터 보관 파일을 생성합니다.
메타데이터 보관 파일을 사용하여 generate-config를 실행하여 테이블별 구성 파일을 생성합니다. --update 플래그를 사용하여 validation_config/에서 만든 기존 connections.yaml 및 settings.yaml 파일을 보존할 수 있습니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
일괄 SQL 변환기의 tables.yaml 스키마 매핑 파일도 있는 경우 --tables-yaml 플래그를 단독으로 또는 --metadata와 함께 포함하여 변환된 테이블 매핑을 메타데이터 보관 파일의 소스 파티션 메타데이터 및 데이터 유형 제외로 보완합니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 명령어는 다음 플래그를 지원합니다.
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper도구 메타데이터 보관 파일(ZIP 파일) 또는 메타데이터 보관 파일이 포함된 디렉터리의 경로입니다.--tables-yaml PATH_TO_TABLES_YAML: 하나 이상의 번역tables.yaml파일 또는 디렉터리의 경로입니다(쉼표로 구분).--target-dataset TARGET_DATASET: 생성된targetTable.name항목에 프리픽스로 추가할 대상 BigQuery 데이터 세트 이름입니다.-o, --output-dir DIRECTORY: 모듈식 구성 파일의 출력 디렉터리입니다. 기본값은validation_config입니다.--schemas SCHEMA_LIST: 포함할 소스 스키마 또는 데이터베이스의 쉼표로 구분된 목록입니다(대소문자 구분,*와일드 카드 지원).--tables TABLE_LIST: 포함할 쉼표로 구분된 테이블 이름(TABLE,SCHEMA.TABLE,DB.SCHEMA.TABLE) 목록입니다(대소문자 구분,*와일드 카드 지원).--filter-file PATH: 포함할 테이블 이름의 줄바꿈으로 구분된 파일의 경로입니다(#로 시작하는 줄은 무시됨).--update: 검색된 테이블을 기존validation_config/디렉터리에 병합하면서 기존connections.yaml,settings.yaml, 커스텀 테이블별 재정의를 유지합니다.--force: 기존 테이블 구성 파일을 유지하면서 새로 검색된 테이블 파일을 비어 있지 않은 출력 디렉터리에 쓸 수 있습니다.--clean: 새로 검색된 파일을 작성하기 전에 출력 디렉터리의 모든 기존 파일을 삭제합니다.
SQL Server
SQL Server 마이그레이션 검증의 경우 다음을 수행하여 소스 스키마의 dwh-migration-dumper 도구 메타데이터 보관 파일을 생성합니다.
dwh-migration-dumper도구를 설치합니다.- 소스 데이터베이스에 대해
dwh-migration-dumper를 실행하여dwh-migration-dumper도구 메타데이터 보관 파일을 생성합니다.
메타데이터 보관 파일을 사용하여 generate-config를 실행하여 테이블별 구성 파일을 생성합니다. --update 플래그를 사용하여 validation_config/에서 만든 기존 connections.yaml 및 settings.yaml 파일을 보존할 수 있습니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
일괄 SQL 변환기의 tables.yaml 스키마 매핑 파일도 있는 경우 --tables-yaml 플래그를 단독으로 또는 --metadata와 함께 포함하여 변환된 테이블 매핑을 메타데이터 보관 파일의 소스 파티션 메타데이터 및 데이터 유형 제외로 보완합니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 명령어는 다음 플래그를 지원합니다.
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper도구 메타데이터 보관 파일(ZIP 파일) 또는 메타데이터 보관 파일이 포함된 디렉터리의 경로입니다.--tables-yaml PATH_TO_TABLES_YAML: 하나 이상의 번역tables.yaml파일 또는 디렉터리의 경로입니다(쉼표로 구분).--target-dataset TARGET_DATASET: 생성된targetTable.name항목에 프리픽스로 추가할 대상 BigQuery 데이터 세트 이름입니다.-o, --output-dir DIRECTORY: 모듈식 구성 파일의 출력 디렉터리입니다. 기본값은validation_config입니다.--schemas SCHEMA_LIST: 포함할 소스 스키마 또는 데이터베이스의 쉼표로 구분된 목록입니다(대소문자 구분,*와일드 카드 지원).--tables TABLE_LIST: 포함할 쉼표로 구분된 테이블 이름(TABLE,SCHEMA.TABLE,DB.SCHEMA.TABLE) 목록입니다(대소문자 구분,*와일드 카드 지원).--filter-file PATH: 포함할 테이블 이름의 줄바꿈으로 구분된 파일의 경로입니다(#로 시작하는 줄은 무시됨).--update: 검색된 테이블을 기존validation_config/디렉터리에 병합하면서 기존connections.yaml,settings.yaml, 커스텀 테이블별 재정의를 유지합니다.--force: 기존 테이블 구성 파일을 유지하면서 새로 검색된 테이블 파일을 비어 있지 않은 출력 디렉터리에 쓸 수 있습니다.--clean: 새로 검색된 파일을 작성하기 전에 출력 디렉터리의 모든 기존 파일을 삭제합니다.
MariaDB
MariaDB에서는 자동 구성 생성이 지원되지 않습니다. 다음 구성으로 validation_config/ 디렉터리에 tables.yaml 파일을 수동으로 만듭니다.
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
MySQL
MySQL에서는 자동 구성 생성이 지원되지 않습니다. 다음 구성을 사용하여 validation_config/ 디렉터리에 tables.yaml 파일을 수동으로 만듭니다.
tables:
- sourceTable: name: SOURCE_SCHEMA.SOURCE_TABLE comparisonKeys: - PRIMARY_KEY_COLUMN targetTable: name: TARGET_DATASET.TARGET_TABLE
Oracle
Oracle 마이그레이션 검증의 경우 다음을 수행하여 소스 스키마의 dwh-migration-dumper 도구 메타데이터 보관 파일을 생성합니다.
dwh-migration-dumper도구를 설치합니다.- 소스 데이터베이스에 대해
dwh-migration-dumper를 실행하여dwh-migration-dumper도구 메타데이터 보관 파일을 생성합니다.
메타데이터 보관 파일을 사용하여 generate-config를 실행하여 테이블별 구성 파일을 생성합니다. --update 플래그를 사용하여 validation_config/에서 만든 기존 connections.yaml 및 settings.yaml 파일을 보존할 수 있습니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
일괄 SQL 변환기의 tables.yaml 스키마 매핑 파일도 있는 경우 --tables-yaml 플래그를 단독으로 또는 --metadata와 함께 포함하여 변환된 테이블 매핑을 메타데이터 보관 파일의 소스 파티션 메타데이터 및 데이터 유형 제외로 보완합니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 명령어는 다음 플래그를 지원합니다.
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper도구 메타데이터 보관 파일(ZIP 파일) 또는 메타데이터 보관 파일이 포함된 디렉터리의 경로입니다.--tables-yaml PATH_TO_TABLES_YAML: 하나 이상의 번역tables.yaml파일 또는 디렉터리의 경로입니다(쉼표로 구분).--target-dataset TARGET_DATASET: 생성된targetTable.name항목에 프리픽스로 추가할 대상 BigQuery 데이터 세트 이름입니다.-o, --output-dir DIRECTORY: 모듈식 구성 파일의 출력 디렉터리입니다. 기본값은validation_config입니다.--schemas SCHEMA_LIST: 포함할 소스 스키마 또는 데이터베이스의 쉼표로 구분된 목록입니다(대소문자 구분,*와일드 카드 지원).--tables TABLE_LIST: 포함할 쉼표로 구분된 테이블 이름(TABLE,SCHEMA.TABLE,DB.SCHEMA.TABLE) 목록입니다(대소문자 구분,*와일드 카드 지원).--filter-file PATH: 포함할 테이블 이름의 줄바꿈으로 구분된 파일의 경로입니다(#로 시작하는 줄은 무시됨).--update: 검색된 테이블을 기존validation_config/디렉터리에 병합하면서 기존connections.yaml,settings.yaml, 커스텀 테이블별 재정의를 유지합니다.--force: 기존 테이블 구성 파일을 유지하면서 새로 검색된 테이블 파일을 비어 있지 않은 출력 디렉터리에 쓸 수 있습니다.--clean: 새로 검색된 파일을 작성하기 전에 출력 디렉터리의 모든 기존 파일을 삭제합니다.
PostgreSQL
PostgreSQL 마이그레이션 검증의 경우 다음을 수행하여 소스 스키마의 dwh-migration-dumper 도구 메타데이터 보관 파일을 생성합니다.
dwh-migration-dumper도구를 설치합니다.- 소스 데이터베이스에 대해
dwh-migration-dumper를 실행하여dwh-migration-dumper도구 메타데이터 보관 파일을 생성합니다.
메타데이터 보관 파일을 사용하여 generate-config를 실행하여 테이블별 구성 파일을 생성합니다. --update 플래그를 사용하여 validation_config/에서 만든 기존 connections.yaml 및 settings.yaml 파일을 보존할 수 있습니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
  --metadata PATH_TO_METADATA_ZIP \
  --target-dataset TARGET_DATASET \
  --update
일괄 SQL 변환기의 tables.yaml 스키마 매핑 파일도 있는 경우 --tables-yaml 플래그를 단독으로 또는 --metadata와 함께 포함하여 변환된 테이블 매핑을 메타데이터 보관 파일의 소스 파티션 메타데이터 및 데이터 유형 제외로 보완합니다. 예를 들면 다음과 같습니다.
gcloud bq migration validate generate-config \
--metadata PATH_TO_METADATA_ZIP \
--tables-yaml PATH_TO_TABLES_YAML \
--target-dataset TARGET_DATASET \
--update
generate-config 명령어는 다음 플래그를 지원합니다.
--metadata PATH_TO_METADATA_ZIP:dwh-migration-dumper도구 메타데이터 보관 파일(ZIP 파일) 또는 메타데이터 보관 파일이 포함된 디렉터리의 경로입니다.--tables-yaml PATH_TO_TABLES_YAML: 하나 이상의 번역tables.yaml파일 또는 디렉터리의 경로입니다(쉼표로 구분).--target-dataset TARGET_DATASET: 생성된targetTable.name항목에 프리픽스로 추가할 대상 BigQuery 데이터 세트 이름입니다.-o, --output-dir DIRECTORY: 모듈식 구성 파일의 출력 디렉터리입니다. 기본값은validation_config입니다.--schemas SCHEMA_LIST: 포함할 소스 스키마 또는 데이터베이스의 쉼표로 구분된 목록입니다(대소문자 구분,*와일드 카드 지원).--tables TABLE_LIST: 포함할 쉼표로 구분된 테이블 이름(TABLE,SCHEMA.TABLE,DB.SCHEMA.TABLE) 목록입니다(대소문자 구분,*와일드 카드 지원).--filter-file PATH: 포함할 테이블 이름의 줄바꿈으로 구분된 파일의 경로입니다(#로 시작하는 줄은 무시됨).--update: 검색된 테이블을 기존validation_config/디렉터리에 병합하면서 기존connections.yaml,settings.yaml, 커스텀 테이블별 재정의를 유지합니다.--force: 기존 테이블 구성 파일을 유지하면서 새로 검색된 테이블 파일을 비어 있지 않은 출력 디렉터리에 쓸 수 있습니다.--clean: 새로 검색된 파일을 작성하기 전에 출력 디렉터리의 모든 기존 파일을 삭제합니다.
표 설정 맞춤설정하기
generate-config에서 생성된 각 테이블 파일에는 검증을 실행하기 전에 맞춤설정할 수 있는 table: 섹션이 포함되어 있습니다. 다음 표에는 각 테이블 항목에서 지원되는 모든 선택적 키가 나와 있습니다.
| 선택적 YAML 키 | 기본값 | 설명 |
|---|---|---|
runSchema, runAggregate, runData |
true |
필러 명령줄 플래그가 전달되지 않을 때 개별 검증 필러를 사용 설정 또는 중지하는 테이블별 불리언입니다. |
maxColumnsPerTile |
100 |
넓은 테이블에서 단일 비교 타일로 그룹화되는 최대 열 수입니다. |
strategy |
SMART |
데이터 검증 실행 전략: SMART(행이 100,000개 미만인 경우 BRUTE_FORCE, 그렇지 않으면 SAMPLE), SAMPLE 또는 BRUTE_FORCE. |
sampleSize |
70000 |
해결된 전략이 SAMPLE일 때 추출할 행 수(파티션을 나눈 경우 슬라이스당)입니다. 기본값인 70,000개 행은 결함률이 0.01%(10,000개 행 중 1개) 이상일 때 일치하지 않는 행을 하나 이상 감지할 확률이 99.9% 이상입니다. |
whereClause |
없음 | 소스 추출 및 타겟 비교 쿼리 모두에 적용되는 SQL 조건자(WHERE 키워드 제외)입니다. sourceTable.whereClause 및 targetTable.whereClause에서 별도로 설정할 수도 있습니다. |
skipRandomization |
false |
true인 경우 무작위 함수로 정렬하는 대신 자연 테이블 순서로 최대 sampleSize개의 행을 읽어 큰 테이블의 쿼리 비용을 줄입니다. |
maxConcurrency |
1 |
파티션을 나눈 테이블의 최대 동시 슬라이스 추출 스레드 수입니다. |
maxSlices |
0(무제한) |
파티션을 나눈 테이블에 허용되는 최대 파티션 슬라이스 수입니다. 계산된 슬라이스 수가 maxSlices를 초과하면(0보다 큰 경우) 파티션 계획이 오류와 함께 실패합니다. |
disablePartitioning |
false |
true인 경우 partitioning 블록이 구성되거나 행 수가 1000000를 초과하더라도 테이블의 파티션을 나눈 슬라이싱을 사용 중지합니다. |
labels |
빈 지도 | validation_results의 검증 실행 측정항목에 연결된 키-값 문자열 라벨입니다. |
다음 섹션에서는 이러한 YAML 키를 사용하여 검증 실행을 맞춤설정하는 방법을 설명합니다.
검증 전략 선택
테이블 항목에서 strategy 키를 사용하여 --data 필러가 행을 추출하고 비교하는 방법을 제어하는 검증 전략을 선택합니다. 다음과 같은 값이 지원됩니다.
SMART(기본값): 먼저 소스 테이블의 행을 계산합니다. 테이블에 행이 100,000개 미만인 경우BRUTE_FORCE를 실행하고 테이블에 행이 100,000개 이상인 경우SAMPLE를 실행합니다.SAMPLE:sampleSize값(기본값은70,000)을 기준으로 무작위 행 샘플을 추출하고comparisonKeys를 사용하여 대상 테이블에 조인합니다. 70,000개 행의 샘플은 행의 0.01% 이상(10,000개 중 1개)에 불일치가 포함된 경우 결함이 있는 행을 하나 이상 포착할 확률이 99.9% 이상입니다.BRUTE_FORCE: 파티션을 나누지 않은 단일 쿼리 패스에서 모든 행을 추출하고 비교합니다.BRUTE_FORCE를 사용하면 파티셔닝 설정이 무시됩니다.
비교 키 구성
비교 키는 소스 시스템과 대상 시스템 간에 행을 고유하게 식별하고 조인하는 데 사용되는 열입니다. 비교 키는 안정적인 조인을 위해 충분한 고유성을 제공하는 속성을 설명합니다.
행 수준 데이터 비교를 실행할 때 다음과 같은 방법으로 비교 키를 구성할 수 있습니다.
- 자동 검색:
sourceTable섹션에서comparisonKeys를 생략하여 검증 도구가 프리플라이트 중에 소스 데이터베이스에서 기본 키를 자동으로 감지하도록 합니다(Oracle 및 Snowflake의NOT NULL고유 제약 조건, Teradata의 고유 색인 또는 Amazon Redshift의 단일 열DISTKEY또는SORTKEY로 대체). 수동 복합 또는 커스텀 키:
sourceTable의comparisonKeys에 소스 키 열 이름을 나열하여 복합 또는 커스텀 비교 키를 수동으로 지정합니다. 소스와 타겟 키 열 이름 간의 대소문자 차이는 자동으로 일치합니다. BigQuery에서 비교 키 열의 이름이 변경된 경우columnSettings.columns.SOURCE_COLUMN.targetColumn아래에 매핑합니다. 다음 예시에서는 복합 비교 키를 구성합니다.table: sourceTable: name: sales_db.public.order_items comparisonKeys: - order_id - line_number targetTable: name: migrated_sales.order_items
고유 키가 없는 테이블의 해시 비교: 테이블에 기본 키가 없는 경우
sourceTable에서useAllColumnsAsKey: true를 설정합니다. 이는 프리플라이트 메타데이터 검사에서 기본 키를 찾지 못할 때도 자동으로 선택됩니다.
대형 테이블에 파티션을 나눈 추출 구성
테이블의 전략이 SAMPLE로 확인되고 테이블 구성에 partitioning 블록이 있거나(기본적으로 generate-config 쓰기) 테이블의 행 수가 1,000,000를 초과하는 경우 검증 도구는 테이블을 슬라이스로 분할하여 샘플링 쿼리가 전체 테이블을 한 번에 정렬하는 대신 제한된 범위를 스캔하도록 합니다. 파티션을 나눈 경우 슬라이스당 최대 sampleSize개의 행이 추출됩니다. 검증을 행 하위 집합으로 제한하려면 대신 whereClause를 사용합니다.
파티션을 나눈 추출을 구성하려면 table: 섹션에서 partitioning 블록을 사용합니다. 예를 들면 다음과 같습니다.
table:
  sourceTable:
    name: sales_db.public.orders
    comparisonKeys:
      - order_id
  targetTable:
    name: migrated_sales.orders
  strategy: SAMPLE
  maxConcurrency: 4
  maxSlices: 100
  partitioning:
    type: INTEGER_RANGE
    column: order_id
    partitionSize: 1000000
partitioning 블록은 다음 필드를 지원합니다.
type:INTEGER_RANGE: 테이블을 숫자 키-값 간격(COLUMN BETWEEN START AND END)으로 슬라이스합니다. 기본값입니다.DATE_RANGE: 테이블을 날짜 또는 타임스탬프 간격으로 슬라이스합니다. PostgreSQL 및 Snowflake에서 지원됩니다.PHYSICAL: 물리적 파티션 메타데이터가 있는 경우 Oracle 및 Amazon Redshift 테이블에 데이터베이스 파티션을 사용합니다.
column: 슬라이스 경계를 계산하는 데 사용되는 소스 테이블의 색인이 생성된 숫자, 날짜 또는 타임스탬프 열을 지정합니다. 파티셔닝 열에NULL값이 있는 행은 범위 기반 슬라이스(INTEGER_RANGE및DATE_RANGE)에서 제외됩니다.partitionSize:INTEGER_RANGE유형의 경우 이 값은 슬라이스당 숫자 키-값 범위 너비를 지정합니다. 기본값은1000000입니다.DATE_RANGE유형의 경우 이 값은 슬라이스당 일수를 지정하며 기본값은30입니다.maxSlices: 테이블에 허용되는 최대 총 슬라이스 수를 지정합니다(table:에서 설정). 테이블에maxSlices보다 많은 슬라이스가 필요한 경우 파티션 계획이 실패하고 더 큰partitionSize또는maxSlices가 필요하다는 오류가 발생합니다.maxConcurrency: 슬라이스를 추출하는 데 사용되는 병렬 작업자 스레드 수를 지정합니다. 기본값은1입니다.table:에서 설정합니다.
집계 검사 맞춤설정
집계 분석은 기본적으로 사용 설정되어 있으며 매크로 수준 집계 검사를 통해 행 수준 샘플링을 보완합니다. 이 구성은 무작위 샘플링으로 미묘한 데이터 비대칭을 놓칠 수 있는 대규모 테이블을 검증하는 데 유용합니다.
맞춤 열 구성이 없으면 검증 도구는 열 유형에 따라 표준 집계 검사를 자동으로 적용합니다.
- 정확한 숫자(
INTEGER,NUMERIC,BIGNUMERIC):COUNT,SUM,AVG,MIN,MAX - 부동 소수점(
FLOAT,DOUBLE,REAL):COUNT,MIN,MAX - 불리언(
BOOLEAN):COUNT,COUNT_TRUE,COUNT_FALSE,COUNT_NULL - 문자열(
STRING,VARCHAR,CHAR,TEXT):COUNT,SUM_LENGTH - 날짜, 시간, 타임스탬프:
COUNT,MIN,MAX
columnSettings 섹션을 사용하여 집계 검사를 맞춤설정하거나 사용 중지할 수 있습니다. 다음 예시에서는 집계 허용 오차를 구성하고 특정 열 검사를 재정의하는 방법을 보여줍니다.
table:
  sourceTable:
    name: sales_db.public.orders
  targetTable:
    name: migrated_sales.orders
  # Set aggregate: false here to disable aggregate checks for the entire table
  columnSettings:
    aggregate:
      tolerance: 0.01
    columns:
      amount:
        aggregate:
          functions:
            - COUNT
            - SUM
            - AVG
          tolerance: 0.05
      internal_notes:
        aggregate: false
다음 집계 구성 규칙이 적용됩니다.
columnSettings.columns의 열 키는 소스 열 이름과 대소문자를 구분하여 일치해야 합니다.- 집계
tolerance는 절대 차이 임곗값(ABS(target - source) <= tolerance)입니다. 집계tolerance가 설정되지 않고(열 수준 또는columnSettings.aggregate.tolerance) 열에 행 수준tolerances.numeric설정이 있는 경우AVG,MIN,MAX는tolerances.numeric를 직접 상속하고SUM는 상속된 행 수준 허용 오차에COUNT를 곱합니다. columnSettings.columns.SOURCE_COLUMN.aggregate.functions에서 열당functions만 재정의할 수 있습니다.
열 제외, 열 이름 매핑, SQL 비교 표현식 적용
columnSettings를 사용하여 열을 제외하거나, 숫자 또는 시간 허용 오차를 설정하거나, 이름이 바뀐 대상 열을 매핑하거나, 비교 전에 SQL 변환을 적용할 수 있습니다. columnSettings.columns의 각 키는 소스 열 이름입니다. 열의 이름이 BigQuery에서 다른 경우 해당 항목 내의 targetColumn 속성을 사용합니다. 예를 들면 다음과 같습니다.
table:
  sourceTable:
    name: sales_db.public.customers
    comparisonKeys:
      - customer_id
  targetTable:
    name: migrated_sales.customers
  columnSettings:
    exclude:
      - etl_loaded_at
      - "temp_*"
    tolerances:
      numeric: 0.0001
      timestamp: 0.001
      date: 1
    columns:
      SOURCE_COLUMN_1:
        targetColumn: customer_full_name
        transform: TRIM
      SOURCE_COLUMN_2:
        transformExpression: "ROUND(SOURCE_COLUMN_2, 4)"
columnSettings는 다음 필드를 지원합니다.
exclude: 모든 검증 필러에서 제외할 대소문자를 구분하지 않는 열 이름 또는 glob 패턴(*) 목록을 지정합니다.tolerances:numeric: 숫자 열의 허용 오차(키 기반 비교의 경우ABS(target - source) <= tolerance,useAllColumnsAsKey: true의 경우 소수점 이하ceil(-log10(tolerance))자리로 반올림)timestamp: 타임스탬프 열의 허용 오차(초)입니다. 예를 들어 1밀리초의 경우0.001입니다.date: 날짜 열의 허용 오차(일)입니다.
columns: 소스 열 이름(SOURCE_COLUMN)으로 키가 지정된 열별 설정의 맵:targetColumn: 소스 열을 BigQuery에서 다른 이름의 대상 열에 매핑합니다.transform: 비교 전에 적용되는 기본 제공 변환:TRIM,UPPER,LOWER: 모든 언어에서 지원됩니다.EMPTY_TO_NULL,NULL_TO_EMPTY,CAST_TO_STRING: PostgreSQL, Amazon Redshift, Oracle, Teradata 소스의 소스 쿼리에서 지원됩니다.
transformExpression: 리터럴 소스 열 이름을 참조하는 커스텀 SQL 표현식입니다. 예를 들면"ROUND(SOURCE_COLUMN, 4)"입니다. 표현식은 소스 쿼리와 BigQuery 비교 쿼리 모두에서 평가되므로 소스 언어와 GoogleSQL 모두에서 유효한 SQL 함수를 사용합니다.
값 정규화
행 수준 비교(--data) 중에 검증 서비스는 소스 엔진과 BigQuery 간의 표현 차이로 인해 불일치가 발생하지 않도록 값을 정규화합니다. 검증 서비스는 다음과 같은 방법으로 값을 정규화합니다.
- 정확한 숫자 유형(
INTEGER,NUMERIC,DECIMAL,BIGNUMERIC): 키 기반 비교에서 값은 전체 규모(NUMERIC의 경우 소수점 이하 최대 9자리,BIGNUMERIC의 경우 소수점 이하 최대 38자리)로 비교되며,tolerances.numeric가 설정된 경우ABS(target - source) <= tolerance일 때 값이 일치합니다. 전체 행 해시 비교(useAllColumnsAsKey: true)에서 값은 기본적으로 소수점 이하 9자리로 반올림되거나 숫자 허용 오차가 설정된 경우 소수점 이하ceil(-log10(tolerance))자리로 반올림됩니다. - 부동 소수점 유형(
FLOAT,DOUBLE,REAL): 기본적으로 소수점 이하 6자리(1e-6)로 정규화됩니다. - 타임스탬프: 마이크로초 정밀도로 UTC로 정규화됩니다.
- 고정 너비 문자 유형(
CHAR,NCHAR,CHARACTER): BigQuerySTRING시맨틱스에 맞게 선행 및 후행 공백이 자동으로 잘립니다.
검증 서비스 실행
검증 구성을 설정한 후 validate 명령어를 실행하여 마이그레이션 검증 도구를 시작합니다. 로컬 경로 또는 validation_config/ 디렉터리를 가리키는 Cloud Storage gs:// URI를 전달할 수 있습니다.
다음 예시에서는 로컬에 저장된 검증 구성 파일에서 검증 서비스를 실행합니다.
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG
PATH_TO_VALIDATION_CONFIG를 모듈식 validation_config/ 디렉터리의 경로로 바꿉니다.
검증 구성이 Cloud Storage에 저장된 경우 구성 디렉터리의 gs:// URI를 전달합니다.
gcloud bq migration validate gs://BUCKET_NAME/validation_config
BUCKET_NAME을 Cloud Storage 버킷 이름으로 바꿉니다.
기본적으로 검증 서비스는 다음 세 가지 검증 요소 모두에서 검증 서비스를 실행합니다.
--schema: 스키마만 검증--aggregate: 집계만 검증--data: 행 수준 데이터만 검증
핵심 요소 플래그를 사용하여 특정 검증 핵심 요소에서 검증 서비스를 실행할 수 있습니다. 다음 예시에서는 커스텀 WHERE 필터를 사용하여 두 개의 특정 테이블에서 스키마 및 집계 검증을 실행합니다.
gcloud bq migration validate PATH_TO_VALIDATION_CONFIG \
  --schema \
  --aggregate \
  --tables orders,customers \
  --where "order_date >= '2026-01-01'"
validate 명령어는 다음 선택적 플래그를 지원합니다.
--table또는--tables: 검증할 테이블 이름의 쉼표로 구분된 목록입니다.--tables일치는 대소문자를 구분하며sourceTable.name또는targetTable.name에 사용된 대소문자와 일치해야 합니다.--where SQL_PREDICATE: 이 실행 중에 소스 및 대상 테이블 모두에 대해whereClause를 재정의합니다.--source-where SQL_PREDICATE: 소스 테이블에 대해서만whereClause를 재정의합니다.--target-where SQL_PREDICATE: 대상 테이블에만whereClause를 재정의합니다.--gcs-path:googleCloudStorage.gcsPath를 재정의합니다. 예를 들면--gcs-path gs://my-bucket/validation입니다.--max-concurrency,--concurrency또는--threads: 병렬 슬라이스 추출을 위해maxConcurrency를 재정의합니다.--no-partition또는--disable-partitioning: 실행의 모든 테이블에 대해 파티션을 나눈 슬라이스 추출을 사용 중지합니다.--labels KEY=VALUE[,KEY=VALUE...]: 커스텀 키-값 라벨을 실행 결과에 연결합니다.--output-dir: 임시 실행 메타데이터 및 상태 파일의 로컬 디렉터리입니다. 기본값은/tmp/validation_outputs입니다.-v,--verbose,-d또는--debug: 상세 또는 디버그 로깅을 사용 설정합니다.
비동기 워크플로 핸드오프
validate는 소스 추출을 동기식으로 수행한 후 각 테이블에 대해 비동기 BigQuery Migration Service 워크플로를 트리거합니다.
대상 데이터 세트가
us이외의 위치(예:eu)에 있는 경우validate를 실행하기 전에BQMS_VALIDATION_LOCATION환경 변수를 설정합니다.export BQMS_VALIDATION_LOCATION=LOCATION
각 테이블에 대해 출력에 생성된 워크플로 리소스 이름이 포함된
Workflow:줄이 포함되어 있는지 확인합니다. 예를 들면 다음과 같습니다.Run ID: 20261012T180000Z_a1b2c3d4 GCS Path: gs://my-bucket/validation/validationOutputs/sales_db/public/orders/20261012T180000Z_a1b2c3d4 Workflow: projects/my-project/locations/us/workflows/12345678-abcd-ef01-2345-6789abcdef01 Results: my-project.validation_results (populated after target validation)
종료 코드
0는 소스 추출 및 업로드가 성공했음을 나타내며 대상 비교가 완료되었거나 데이터가 일치함을 나타내지 않습니다. 예를 들어 권한 누락으로 인해 워크플로 생성이 실패하면 CLI는 검증 워크플로 트리거가 실패했다는 경고를 로깅하고 수동gcloud대체 명령어를 출력하며 프로세스가0로 종료되더라도Workflow:줄을 생략합니다.
검증 결과 보기
검증 실행이 완료되면Google Cloud 콘솔에서 결과 데이터 세트 validation_results를 쿼리하거나, settings.yaml의 results 아래에 구성된 BigQuery 데이터 세트를 쿼리하거나, Cloud Storage에서 요약 보고서를 읽어 검증 결과를 확인합니다. 다음 옵션 중 하나를 선택합니다.
Google Cloud 콘솔
Google Cloud 콘솔에서 마이그레이션 서비스 페이지로 이동합니다.
이전 검증에서 최근 항목 보기를 클릭합니다.
프로젝트 선택을 클릭하고
validation_results데이터 세트가 저장된 프로젝트를 선택합니다.
GoogleSQL
TARGET_PROJECT_ID.validation_results.run_history를 쿼리하여 최근 검증 실행 상태를 확인합니다.
SELECT
run_id,
source_table,
target_table,
status,
started_at,
finished_at,
gcs_uri,
error_message
FROM `TARGET_PROJECT_ID.validation_results.run_history`
ORDER BY started_at DESC
LIMIT 20;
TARGET_PROJECT_ID를 validation_results 데이터 세트가 저장된 프로젝트의 ID로 바꿉니다.
열별 세부 측정항목과 이전 추세를 보려면 다음을 사용하여 쿼리합니다.
<var>TARGET_PROJECT_ID</var>.validation_results.run_metrics: 실행별, 열별 불일치 수, 집계 비교, 통과 또는 실패 상태<var>TARGET_PROJECT_ID</var>.validation_results.column_history: 실행 전반의 종단 열 감사 기록<var>TARGET_PROJECT_ID</var>.validation_results.run_<var>RUN_ID</var>_mismatches_details: 소스 값과 타겟 값이 다른 샘플링된 행 및 열
Cloud Storage 보고서
완료된 각 실행은 다음 보고서 아티팩트를 실행의 gcs_uri 디렉터리(gs://<var>BUCKET</var>/<var>PREFIX</var>/validationOutputs/<var>SOURCE_TABLE_PATH</var>/<var>RUN_ID</var>/)에 작성합니다.
validation_summary.txt: 스키마, 집계, 행 비교 결과의 핵심 요약column_details.txt: 불일치 및 집계 차이의 열별 분석results.json: 모든 검증 결과의 정형 JSON 보고서queries.sql: 검증 실행 중에 실행된 정확한 SQL 쿼리
실행의 요약 보고서를 출력하려면 다음 명령어를 실행합니다.
gcloud storage cat gs://BUCKET/PREFIX/validationOutputs/SOURCE_TABLE_PATH/RUN_ID/validation_summary.txt
검증 결과 해석
validation_results.run_history의 각 검증 실행은 다음 실행 상태 또는 status 값 중 하나를 보고합니다.
| 상태 | 설명 | 권장 조치 |
|---|---|---|
IN_PROGRESS |
검증 워크플로가 BigQuery에서 아직 실행 중입니다. | finished_at가 채워질 때까지 기다린 후 run_history를 다시 쿼리합니다. |
COMPLETED |
검증 파이프라인이 행 수준 데이터 또는 집계 불일치 없이 완료되었습니다. 스키마 유형 호환성 세부정보는 validation_summary.txt 및 column_history에 별도로 기록됩니다. |
어떤 조치도 필요하지 않습니다. 테이블이 검증을 통과했습니다. |
HEALED |
검증 파이프라인은 누락된 행 없이 완료되었으며, 감지된 모든 값 차이는 검증 도구에 의해 자동으로 조정된 미세한 부동 소수점 표현 지터(셀 수준 비교의 경우 < 1e-4, 집계의 경우 < 1e-6)였습니다. |
통과한 실행으로 처리됩니다. 업스트림 지터를 억제하려면 명시적인 숫자 tolerance를 구성할 수 있습니다. |
COMPLETED_WITH_MISMATCHES |
검증 파이프라인이 완전히 실행되었으며 소스 테이블과 대상 테이블 간에 누락된 행, 누락된 타겟 열, 집계 차이 또는 셀 수준 데이터 차이가 발견되었습니다. 이는 시스템 비정상 종료가 아닌 검증 실행이 완료되었음을 나타냅니다. | column_details.txt, run_metrics, run_RUN_ID_mismatches_details를 검사하여 일치하지 않는 열과 행을 검토합니다. 자세한 내용은 열 수준 불일치 유형을 참조하세요. |
ERROR |
시스템 또는 구성 오류로 인해 검증 파이프라인을 완료할 수 없습니다. 예를 들어 대상 테이블 누락, 권한 오류 또는 커스텀 whereClause 또는 transformExpression의 잘못된 SQL로 인해 발생할 수 있습니다. |
run_history의 error_message 열을 확인합니다. 일반적인 오류 해결에 대한 자세한 내용은 문제 해결을 참조하세요. |
열 수준 불일치 유형
실행이 COMPLETED_WITH_MISMATCHES로 완료되면 실행별 불일치 테이블은 각 열 비교를 다음 결과 중 하나로 분류합니다.
EXACT_MATCH: 구성된 허용 오차 내에서 일치하는 열의 비교된 셀 값DATA_DRIFT:comparisonKeys에서 일치하는 행이지만 셀 값이 구성된 허용 오차를 초과함SCHEMA: 열이 소스 테이블에 있지만 대상 테이블에 없음ROW:comparisonKeys에서 조인될 때 대상 테이블에서 소스 행이 누락되었거나 소스 테이블에서 대상 행이 누락되었습니다.
일반적인 오류 해결
다음 표에는 일반적인 명령줄 및 워크플로 오류와 해결 방법이 나와 있습니다.
| 오류 메시지 또는 문제 | 원인 | 해결 방법 |
|---|---|---|
Failed to load or parse YAML |
테이블, partitioning, columnSettings 또는 googleCloudStorage 블록에 인식할 수 없는 키 또는 잘못된 enum 값(예: SAMPLE 대신 SAMPLING)이 포함되어 있습니다. |
테이블 설정 옵션에 따라 YAML 들여쓰기 및 필드 이름을 확인합니다. |
Connection name '...' is invalid. Must be alphanumeric. |
connections:의 프로필 이름에 밑줄 또는 하이픈이 포함되어 있습니다. 예를 들면 my_source입니다. |
연결 프로필 이름을 source 및 target과 같은 영숫자 이름으로 바꿉니다. |
googleCloudStorage cannot be null |
googleCloudStorage.gcsPath가 validation_config/settings.yaml에서 누락되었으며 --gcs-path가 전달되지 않았습니다. |
validation_config/settings.yaml에 후행 슬래시 없이 googleCloudStorage.gcsPath: gs://BUCKET/PREFIX를 설정합니다. |
Target discovery directory 'validation_config/' is non-empty |
validation_config/에 이미 YAML 파일이 포함되어 있을 때 --update, --force 또는 --clean 없이 generate-config가 실행되었습니다. |
--update를 전달하여 기존 connections.yaml 및 settings.yaml를 유지하면서 발견된 테이블을 병합합니다. |
tables is required(validate 실행 시) |
tables: 목록이 없는 기존 validation-config.yaml 파일이 작업 디렉터리에 있으며 validation_config/보다 우선 적용되거나 validation_config/ 아래에 테이블 YAML 파일이 없습니다. |
validate에서 validation_config/를 로드하도록 작업 디렉터리에서 불필요한 validation-config.yaml 파일을 삭제합니다. |
| 단일 낮은 카디널리티 비교 키의 프리플라이트 오류 | 필터링된 행이 1,000개 이상인 테이블이 카디널리티가 낮은 단일 비교 키로 구성되어 다대다 조인 폭발이 발생합니다. | comparisonKeys에서 고유한 복합 키를 형성하는 모든 열을 지정하거나 sourceTable에서 useAllColumnsAsKey: true를 설정하세요. |
Failed to initialize MemoryUtil 또는 InaccessibleObjectException: Unable to make field long java.nio.Buffer.address accessible |
JVM이 Java 17 이상이며 --add-opens=java.base/java.nio=ALL-UNNAMED 없이 시작되었습니다. 일반적으로 명령줄이 커스텀 래퍼를 통해 또는 java -jar를 사용하여 직접 실행되었기 때문입니다. |
환경에서 JDK_JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED"를 설정하거나 gcloud bq migration validate 명령어를 사용하세요. |
WARNING: Failed to trigger validation workflow |
소스 추출은 성공했지만 IAM 권한 누락, 사용 설정되지 않은 API 또는 지원되지 않는 위치로 인해 CreateMigrationWorkflow 호출이 실패했습니다. |
bigquerymigration.googleapis.com가 사용 설정되어 있고 계정에 roles/bigquerymigration.editor가 있으며 BQMS_VALIDATION_LOCATION가 데이터 세트 위치와 일치하는지 확인하세요. |
검증 아티팩트 삭제
검증 결과를 검토한 후 스토리지 비용을 관리하려면 다음을 수행합니다.
- Cloud Storage에서 스테이징 버킷의
gcsPath프리픽스 아래에 있는 이전 실행 디렉터리를 삭제하거나 버킷에 객체 수명 주기 관리 규칙을 구성합니다. - BigQuery에서 결과 데이터 세트의 실행별 비교 테이블(기본적으로
validation_results)은resultTtlHours(기본적으로168.0시간 또는 7일) 후에 자동으로 만료됩니다.settings.yaml에서resultTtlHours를 조정하여 보관 기간을 단축하거나 연장하거나 공유 기록 테이블 및 뷰(run_history,run_metrics,column_history)를 그대로 유지하면서 실행별 테이블을 수동으로 삭제합니다. - 로컬 파일로 작업할 때는
--output-dir에서 검증 도구로 작성된 로컬 작업 디렉터리를 삭제합니다. 기본 디렉터리는/tmp/validation_outputs입니다.
가격 책정
검증 서비스는 프로젝트에서 다음 리소스를 사용합니다.
- BigQuery 컴퓨팅 및 스토리지:
validation_results데이터 세트의 테이블에 대한 대상 집계 쿼리, 행 비교 조인, 스토리지는 표준 BigQuery 가격 책정에 따라 Google Cloud 프로젝트 또는target연결에 구성된 경우billingProjectId에 청구됩니다. - Cloud Storage 스토리지 및 네트워크: 버킷의 스테이징된 Parquet 또는 CSV 샘플 파일과 결과 보고서는 표준 Cloud Storage 가격 책정에 따라 청구됩니다.
- 소스 데이터베이스 부하: 추출 쿼리가 소스 데이터베이스에 대해 직접 실행됩니다. 대규모 소스 테이블의 부하를 최소화하려면
strategy: SAMPLE를 사용하거나,whereClause로 필터링하거나, 무작위 정렬 오버헤드가 바람직하지 않은 경우skipRandomization: true를 설정합니다.
다음 단계
dwh-migration-dumper도구를 사용하여 변환 및 평가를 위한 메타데이터를 생성하는 방법을 알아봅니다.- SQL 쿼리를 일괄 변환하여 소스 SQL 스크립트와 DDL을 GoogleSQL로 변환합니다.
- 마이그레이션 계보를 사용하여 마이그레이션을 계획하여 소스 데이터 웨어하우스의 데이터 종속 항목을 시각화합니다.