


טעינת נתוני Parquet מ-Cloud Storage
ב-BigQuery אפשר לטעון נתוני Parquet מ-Cloud Storage לטבלה או למחיצה חדשה, או להוסיף אותם לטבלה או למחיצה קיימת או להחליף אותה. Parquet הוא פורמט נתונים בקוד פתוח שמבוסס על עמודות, ונמצא בשימוש נרחב בסביבת Apache Hadoop. במהלך הטעינה, BigQuery ממיר את הפורמט הזה לפורמט האחסון בעמודות של Capacitor. במאמר טעינת נתונים מקבצים מקומיים מוסבר איך טוענים נתוני Parquet מקובץ מקומי.
מגבלות
כשאתם טוענים נתונים ל-BigQuery מקטגוריה של Cloud Storage, אתם כפופים למגבלות הבאות:
- ב-BigQuery אין הבטחה לעקביות של נתונים ממקורות חיצוניים. שינויים בנתוני הבסיס בזמן ששאילתה פועלת עלולים לגרום להתנהגות לא צפויה.
ב-BigQuery אין תמיכה בניהול גרסאות של אובייקטים ב-Cloud Storage. אם תכללו מספר דור ב-URI של Cloud Storage, משימת הטעינה תיכשל.
אי אפשר להשתמש בתו כללי לחיפוש ב-URI של Cloud Storage אם לאחד מהקבצים שרוצים לטעון יש סכימה שונה. כל הבדל במיקום של העמודות נחשב לסכימה שונה.
הדרישות לגבי קובץ הקלט
כדי להימנע משגיאות resourcesExceeded כשאתם טוענים קובצי Parquet ל-BigQuery, מומלץ לפעול לפי ההנחיות הבאות:
- גודל השורות צריך להיות עד 50MB.
- אם נתוני הקלט מכילים יותר מ-100 עמודות, כדאי להקטין את גודל הדף כך שיהיה קטן מגודל ברירת המחדל (1 * 1024 * 1024 בייטים). זה שימושי במיוחד אם אתם משתמשים בדחיסה משמעותית.
- כדי להגיע לביצועים אופטימליים, כדאי להגדיר קבוצות שורות בגודל של לפחות 16MiB. קבוצות קטנות יותר של שורות מגדילות את הקלט/פלט ומאטות את הטעינות והשאילתות.
לפני שמתחילים
מקצים תפקידים של ניהול זהויות והרשאות גישה (IAM) שנותנים למשתמשים את ההרשאות שדרושות כדי לבצע כל משימה במסמך הזה, ויוצרים מערך נתונים לאחסון הנתונים.
ההרשאות הנדרשות
כדי לטעון נתונים ל-BigQuery, אתם צריכים הרשאות IAM להרצת משימת טעינה ולטעינת נתונים לטבלאות ב-BigQuery ולמחיצות. אם אתם טוענים נתונים מ-Cloud Storage, אתם צריכים גם הרשאות IAM כדי לגשת לקטגוריה שמכילה את הנתונים.
הרשאות לטעינת נתונים ל-BigQuery
כדי לטעון נתונים לטבלה או למחיצה חדשה ב-BigQuery, או כדי להוסיף או להחליף טבלה או מחיצה קיימת, צריך את הרשאות ה-IAM הבאות:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
כל אחד מהתפקידים הבאים שמוגדרים מראש ב-IAM כולל את ההרשאות שצריך כדי לטעון נתונים לטבלה או למחיצה ב-BigQuery:
roles/bigquery.dataEditorroles/bigquery.dataOwner-
roles/bigquery.admin(כולל את ההרשאהbigquery.jobs.create) -
bigquery.user(כולל את ההרשאהbigquery.jobs.create) -
bigquery.jobUser(כולל את ההרשאהbigquery.jobs.create)
בנוסף, אם יש לכם את ההרשאה bigquery.datasets.create, אתם יכולים ליצור ולעדכן טבלאות באמצעות משימת טעינה בקבוצות הנתונים שאתם יוצרים.
למידע נוסף על תפקידים והרשאות של IAM ב-BigQuery, קראו את המאמר תפקידים והרשאות מוגדרים מראש.
הרשאות לטעינת נתונים מ-Cloud Storage
כדי לקבל את ההרשאות שנדרשות לטעינת נתונים מקטגוריה של Cloud Storage, בקשו מהאדמין לתת לכם את התפקיד אדמין של אחסון (roles/storage.admin) ב-IAM בקטגוריה.
כדי לקרוא הסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
זהו תפקיד שמוגדר מראש וכולל את ההרשאות שנדרשות לטעינת נתונים מקטגוריה של Cloud Storage. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי לטעון נתונים מקטגוריה של Cloud Storage, נדרשות ההרשאות הבאות:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
יצירת קבוצת נתונים
יוצרים מערך נתונים ב-BigQuery כדי לאחסן את הנתונים.
סכימות של Parquet
כשאתם טוענים קובצי Parquet ל-BigQuery, סכימת הטבלה מאוחזרת באופן אוטומטי מנתוני המקור שמתארים את עצמם. כש-BigQuery מאחזר את הסכימה מנתוני המקור, הוא משתמש בקובץ האחרון לפי סדר אלפביתי.
לדוגמה, נניח שיש לכם את קובצי ה-Parquet הבאים ב-Cloud Storage:
gs://mybucket/00/
  a.parquet
  z.parquet
gs://mybucket/01/
  b.parquet
הרצת הפקודה הזו בכלי שורת הפקודה של BigQuery טוענת את כל הקבצים (כרשימה מופרדת בפסיקים), והסכימה נגזרת מ-mybucket/01/b.parquet:
bq load \
--source_format=PARQUET \
dataset.table \
"gs://mybucket/00/*.parquet","gs://mybucket/01/*.parquet"
כשאתם טוענים כמה קובצי Parquet עם סכימות שונות, עמודות זהות שצוינו בכמה סכימות חייבות להיות באותו מצב בכל הגדרת סכימה.
כש-BigQuery מזהה את הסכימה, חלק מסוגי הנתונים של Parquet מומרים לסוגי נתונים של BigQuery כדי שיהיו תואמים לתחביר של GoogleSQL. מידע נוסף זמין במאמר המרות של Parquet.
כדי לספק סכימת טבלה ליצירת טבלאות חיצוניות, מגדירים את המאפייןreferenceFileSchemaUri ב-BigQuery API או את הפרמטר --reference_file_schema_uri בכלי שורת הפקודה של BigQuery לכתובת ה-URL של קובץ רפרנס.
לדוגמה, --reference_file_schema_uri="gs://mybucket/schema.parquet".
דחיסת Parquet
BigQuery תומך בקודקים הבאים לדחיסת תוכן של קובצי Parquet:
GZipLZO_1CLZO_1XLZ4_RAWSnappyZSTD
טעינת נתוני Parquet לטבלה חדשה
אפשר לטעון נתוני Parquet לטבלה חדשה באמצעות אחת מהאפשרויות הבאות:
- מסוף Google Cloud
- הפקודה
bq loadשל כלי שורת הפקודה של BigQuery - ה-method של ה-API של
jobs.insertוהגדרת משימה ב-load - ספריות הלקוח
כדי לטעון נתוני Parquet מ-Cloud Storage לטבלה חדשה ב-BigQuery:
המסוף
נכנסים לדף BigQuery במסוף Google Cloud .
- בחלונית הימנית, לוחצים על Explorer.
- בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים מערך נתונים.
- בקטע Dataset info, לוחצים על Create table.
- בחלונית Create table, מציינים את הפרטים הבאים:
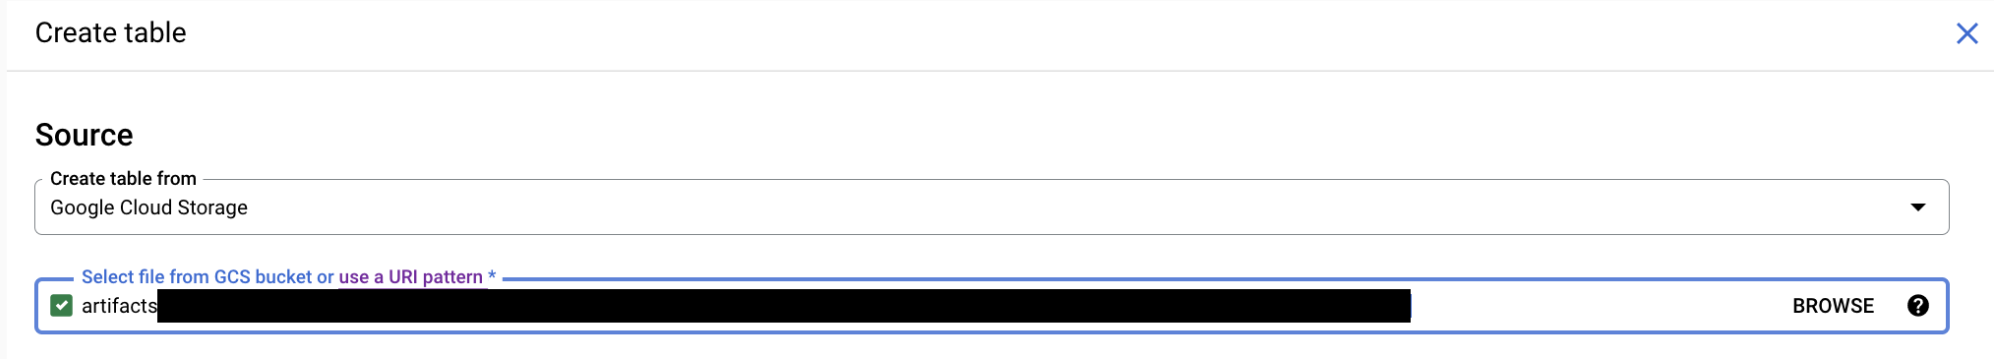
- בקטע Source, בוחרים באפשרות Google Cloud Storage ברשימה Create table from.
לאחר מכן, מבצעים את הפעולות הבאות:
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בשדה פורמט קובץ, בוחרים באפשרות Parquet.
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בקטע Destination, מציינים את הפרטים הבאים:
- בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table, מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהשדה Table type מוגדר ל-Native table.
- בקטע Schema, לא צריך לעשות כלום. הסכימה מתוארת בקובצי Parquet.
- אופציונלי: מציינים את הגדרות המחיצה והאשכול. מידע נוסף זמין במאמרים יצירת טבלאות מחולקות למחיצות ויצירה של טבלאות מסודרות באשכולות ושימוש בהן.
- לוחצים על אפשרויות מתקדמות ומבצעים את הפעולות הבאות:
- בשדה Write preference, משאירים את האפשרות Write if empty מסומנת. This option creates a new table and loads your data into it.
- אם רוצים להתעלם מערכים בשורה שלא קיימים בסכימה של הטבלה, בוחרים באפשרות Unknown values.
- בקטע Encryption, לוחצים על Customer-managed key כדי להשתמש במפתח של Cloud Key Management Service. אם משאירים את ההגדרה Google-managed key, הנתונים מוצפנים במצב מנוחה ב-BigQuery.
- לוחצים על Create table.
SQL
משתמשים בהצהרת ה-DDL LOAD DATA.
בדוגמה הבאה נטען קובץ Parquet לטבלה החדשה mytable:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
LOAD DATA OVERWRITE mydataset.mytable
FROM FILES (
  format = 'PARQUET',
  uris = ['gs://bucket/path/file.parquet']);
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
משתמשים בפקודה bq load, מציינים את PARQUET באמצעות הדגל --source_format וכוללים URI של Cloud Storage.
אפשר לכלול URI יחיד, רשימה מופרדת בפסיקים של מזהי URI, או URI שמכיל תו כללי לחיפוש.
(אופציונלי) מציינים את הדגל --location ומגדירים את הערך למיקום שלכם.
דגלים אופציונליים נוספים:
-
--time_partitioning_type: מפעיל חלוקה למחיצות לפי זמן בטבלה ומגדיר את סוג המחיצה. הערכים האפשריים הםHOUR,DAY,MONTHו-YEAR. הדגל הזה הוא אופציונלי כשיוצרים טבלה שמחולקת למחיצות לפי עמודה מסוגDATE,DATETIMEאוTIMESTAMP. סוג המחיצה שמוגדר כברירת מחדל לחלוקה למחיצות לפי זמן הואDAY. אי אפשר לשנות את מפרט החלוקה למחיצות בטבלה קיימת. -
--time_partitioning_expiration: מספר שלם שמציין (בשניות) מתי צריך למחוק מחיצה שמבוססת על זמן. זמן התפוגה מחושב לפי תאריך ה-UTC של המחיצה בתוספת ערך המספר השלם. -
--time_partitioning_field: העמודהDATEאוTIMESTAMPשמשמשת ליצירת טבלה מחולקת למחיצות. אם מפעילים חלוקה למחיצות לפי זמן בלי הערך הזה, נוצרת טבלה מחולקת למחיצות לפי זמני כתיבת הנתונים. -
--require_partition_filter: כשהאפשרות הזו מופעלת, המשתמשים צריכים לכלול משפטWHEREשמציין את המחיצות שרוצים לשלוח אליהן שאילתות. דרישה למסנן מחיצות יכולה להפחית את העלות ולשפר את הביצועים. למידע נוסף, קראו את המאמר דרישה למסנן מחיצות בשאילתות. -
--clustering_fields: רשימה מופרדת בפסיקים של עד ארבעה שמות עמודות שמשמשים ליצירת טבלה מסודרת באשכולות. -
--destination_kms_key: המפתח של Cloud KMS להצפנת נתוני הטבלה.
--column_name_character_map: מגדיר את ההיקף והטיפול בתווים בשמות של עמודות, עם אפשרות להפעיל שמות גמישים של עמודות. מידע נוסף זמין במאמרload_option_list. מידע נוסף על תווים נתמכים ולא נתמכים זמין במאמר שמות גמישים של עמודות.למידע נוסף על טבלאות מחולקות למחיצות:
מידע נוסף על טבלאות מסודרות באשכולות:
מידע נוסף על הצפנת טבלאות זמין במאמרים הבאים:
כדי לטעון נתוני Parquet ל-BigQuery, מזינים את הפקודה הבאה:
bq --location=LOCATION load \
--source_format=FORMAT \
DATASET.TABLE \
PATH_TO_SOURCE
מחליפים את מה שכתוב בשדות הבאים:
-
LOCATION: המיקום שלכם. הדגל--locationהוא אופציונלי. לדוגמה, אם אתם משתמשים ב-BigQuery באזור טוקיו, אתם יכולים להגדיר את הערך של הדגל ל-asia-northeast1. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ bigqueryrc.. FORMAT:PARQUET.-
DATASET: מערך נתונים קיים. -
TABLE: שם הטבלה שאליה טוענים את הנתונים. -
PATH_TO_SOURCE: URI מלא של Cloud Storage או רשימה של מזהי URI שמופרדים בפסיקים. יש גם תמיכה בתווים כלליים לחיפוש.
דוגמאות:
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.parquet לטבלה בשם mytable ב-mydataset.
    bq load \
    --source_format=PARQUET \
    mydataset.mytable \
    gs://mybucket/mydata.parquet
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.parquet לטבלה חדשה שמחולקת למחיצות (Partitions) לפי זמני כתיבת הנתונים, בשם mytable ב-mydataset.
    bq load \
    --source_format=PARQUET \
    --time_partitioning_type=DAY \
    mydataset.mytable \
    gs://mybucket/mydata.parquet
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.parquet לטבלה מחולקת למחיצות בשם mytable ב-mydataset. הטבלה מחולקת למחיצות לפי העמודה mytimestamp.
    bq load \
    --source_format=PARQUET \
    --time_partitioning_field mytimestamp \
    mydataset.mytable \
    gs://mybucket/mydata.parquet
הפקודה הבאה טוענת נתונים מכמה קבצים ב-gs://mybucket/ לטבלה בשם mytable ב-mydataset. ה-URI של Cloud Storage כולל תו כללי לחיפוש.
    bq load \
    --source_format=PARQUET \
    mydataset.mytable \
    gs://mybucket/mydata*.parquet
הפקודה הבאה טוענת נתונים מכמה קבצים ב-gs://mybucket/ לטבלה בשם mytable ב-mydataset. הפקודה כוללת רשימה מופרדת בפסיקים של מזהי URI של Cloud Storage עם תווים כלליים לחיפוש.
    bq load \
    --source_format=PARQUET \
    mydataset.mytable \
    "gs://mybucket/00/*.parquet","gs://mybucket/01/*.parquet"
API
יוצרים משימת
loadשמפנה לנתוני המקור ב-Cloud Storage.(אופציונלי) מציינים את המיקום במאפיין
locationבקטעjobReferenceשל משאב המשימה.המאפיין
source URIsחייב להיות מוגדר במלואו, בפורמטgs://BUCKET/OBJECT. כל URI יכול להכיל תו כללי לחיפוש אחד מסוג "*".מציינים את פורמט הנתונים Parquet על ידי הגדרת המאפיין
sourceFormatלערךPARQUET.כדי לבדוק את סטטוס המשימה, מפעילים את השיטה
jobs.get(JOB_ID*)ומחליפים את JOB_ID במזהה המשימה שהוחזר בבקשה הראשונית.- אם הערך הוא
status.state = DONE, המשימה הושלמה בהצלחה. - אם המאפיין
status.errorResultקיים, הבקשה נכשלה והאובייקט הזה כולל מידע שמתאר מה השתבש. אם הבקשה נכשלת, לא נוצרת טבלה ולא נטענים נתונים. - אם
status.errorResultלא מופיע, המשימה הסתיימה בהצלחה, אבל יכול להיות שהיו כמה שגיאות לא קריטיות, כמו בעיות בייבוא של כמה שורות. שגיאות לא קריטיות מופיעות במאפייןstatus.errorsשל אובייקט המשימה שמוחזר.
- אם הערך הוא
הערות לגבי ה-API:
משימות טעינה הן אטומיות ועקביות: אם משימת טעינה נכשלת, אף אחד מהנתונים לא זמין, ואם משימת טעינה מצליחה, כל הנתונים זמינים.
מומלץ ליצור מזהה ייחודי ולהעביר אותו בתור
jobReference.jobIdכשקוראים ל-jobs.insertכדי ליצור משימת טעינה. הגישה הזו עמידה יותר בפני כשלים ברשת, כי הלקוח יכול לבצע דגימה או לנסות שוב באמצעות מזהה המשימה הידוע.הקריאה ל-
jobs.insertבמזהה משימה נתון היא אידמפוטנטית. אפשר לנסות שוב כמה פעמים שרוצים עם אותו מזהה משימה, ורק אחת מהפעולות האלה תצליח.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להתחיל משימת טעינה מ-Cloud Storage, משתמשים ב-method Client.load_table_from_uri(). כדי להשתמש ב-Parquet, מגדירים את המאפיין LoadJobConfig.source_format למחרוזתPARQUET ומעבירים את הגדרת המשימה כארגומנט job_config ל-method load_table_from_uri().
הוספה לטבלה או החלפה של טבלה עם נתוני Parquet
אפשר לטעון נתונים נוספים לטבלה מקובצי מקור או על ידי הוספת תוצאות של שאילתות.
במסוף Google Cloud , משתמשים באפשרות Write preference כדי לציין איזו פעולה לבצע כשאתם טוענים נתונים מקובץ מקור או מתוצאת שאילתה.
כשאתם טוענים נתונים נוספים לטבלה, יש לכם את האפשרויות הבאות:
| אפשרות המסוף | דגל של הכלי bq | נכס BigQuery API | תיאור |
|---|---|---|---|
| כתיבה אם ריק | לא נתמך | WRITE_EMPTY |
הנתונים נכתבים רק אם הטבלה ריקה. |
| הוספה לטבלה | --noreplace או --replace=false; אם לא צוין --[no]replace, ברירת המחדל היא append |
WRITE_APPEND |
(ברירת המחדל) הוספת הנתונים לסוף הטבלה. |
| החלפת הטבלה | --replace או --replace=true |
WRITE_TRUNCATE |
מוחק את כל הנתונים הקיימים בטבלה לפני כתיבת הנתונים החדשים. הפעולה הזו גם מוחקת את סכימת הטבלה, את האבטחה ברמת השורה ואת כל מפתחות Cloud KMS. |
אם אתם טוענים נתונים לטבלה קיימת, משימת הטעינה יכולה להוסיף את הנתונים או להחליף את הטבלה.
אפשר להוסיף נתונים לטבלה או להחליף אותה באחת מהדרכים הבאות:
- מסוף Google Cloud
- הפקודה
bq loadשל כלי שורת הפקודה של BigQuery - ה-method של ה-API של
jobs.insertוהגדרת משימה ב-load - ספריות הלקוח
כדי להוסיף נתוני Parquet לטבלה או להחליף אותם:
המסוף
נכנסים לדף BigQuery במסוף Google Cloud .
- בחלונית הימנית, לוחצים על Explorer.
- בחלונית Explorer, מרחיבים את הפרויקט, לוחצים על Datasets ובוחרים מערך נתונים.
- בקטע Dataset info, לוחצים על Create table.
- בחלונית Create table, מציינים את הפרטים הבאים:
- בקטע Source, בוחרים באפשרות Google Cloud Storage ברשימה Create table from.
לאחר מכן, מבצעים את הפעולות הבאות:
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בשדה פורמט קובץ, בוחרים באפשרות Parquet.
- בוחרים קובץ מהקטגוריה של Cloud Storage או מזינים את ה-URI של Cloud Storage.
אי אפשר לכלול כמה מזהי URI במסוף Google Cloud , אבל יש תמיכה בתווים כלליים לחיפוש. הקטגוריה של Cloud Storage צריכה להיות באותו מיקום כמו מערך הנתונים שמכיל את הטבלה שרוצים ליצור, להוסיף לה או להחליף אותה.
- בקטע Destination, מציינים את הפרטים הבאים:
- בשדה Dataset, בוחרים את מערך הנתונים שבו רוצים ליצור את הטבלה.
- בשדה Table, מזינים את שם הטבלה שרוצים ליצור.
- מוודאים שהשדה Table type מוגדר ל-Native table.
- בקטע Schema, לא צריך לעשות כלום. הסכימה מתוארת בקובצי Parquet.
- אופציונלי: מציינים את הגדרות המחיצה והאשכול. מידע נוסף זמין במאמרים יצירת טבלאות מחולקות למחיצות ויצירה של טבלאות מסודרות באשכולות ושימוש בהן. אי אפשר להמיר טבלה לטבלה מחולקת למחיצות או לטבלה מסודרת באשכולות על ידי הוספה או החלפה שלה. במסוף Google Cloud אי אפשר להוסיף נתונים לטבלאות מחולקות למחיצות או לטבלאות מסודרות באשכולות, או להחליף אותן, במסגרת משימת טעינה.
- לוחצים על אפשרויות מתקדמות ומבצעים את הפעולות הבאות:
- בקטע Write preference, בוחרים באפשרות Append to table או Overwrite table.
- אם רוצים להתעלם מערכים בשורה שלא קיימים בסכימה של הטבלה, בוחרים באפשרות Unknown values.
- בקטע Encryption, לוחצים על Customer-managed key כדי להשתמש במפתח של Cloud Key Management Service. אם משאירים את ההגדרה Google-managed key, הנתונים מוצפנים במצב מנוחה ב-BigQuery.
- לוחצים על Create table.
SQL
משתמשים בהצהרת ה-DDL LOAD DATA.
בדוגמה הבאה, קובץ Parquet נוסף לטבלה mytable:
נכנסים לדף BigQuery במסוף Google Cloud .
בעורך השאילתות, מזינים את ההצהרה הבאה:
LOAD DATA INTO mydataset.mytable
FROM FILES (
  format = 'PARQUET',
  uris = ['gs://bucket/path/file.parquet']);
לוחצים על הפעלה.
מידע נוסף על הרצת שאילתות זמין במאמר הרצת שאילתה אינטראקטיבית.
BQ
מזינים את הפקודה bq load עם הדגל --replace כדי להחליף את הטבלה. משתמשים בדגל --noreplace כדי להוסיף נתונים לטבלה. אם לא מציינים דגל, ברירת המחדל היא להוסיף נתונים. מציינים את הדגל --source_format ומגדירים אותו לערך PARQUET. מכיוון שהסכימות של Parquet מאוחזרות באופן אוטומטי מנתוני המקור שמתארים את עצמם, אין צורך לספק הגדרת סכימה.
(אופציונלי) מציינים את הדגל --location ומגדירים את הערך למיקום שלכם.
דגלים אופציונליים נוספים:
-
--destination_kms_key: המפתח של Cloud KMS להצפנת נתוני הטבלה.
bq --location=LOCATION load \
--[no]replace \
--source_format=FORMAT \
DATASET.TABLE \
PATH_TO_SOURCE
מחליפים את מה שכתוב בשדות הבאים:
-
location: המיקום שלכם. הדגל--locationהוא אופציונלי. אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ bigqueryrc.. format:PARQUET.-
dataset: מערך נתונים קיים. -
table: שם הטבלה שאליה טוענים את הנתונים. -
path_to_source: URI מלא של Cloud Storage או רשימה של מזהי URI שמופרדים בפסיקים. יש גם תמיכה בתווים כלליים לחיפוש.
דוגמאות:
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.parquet ומחליפה טבלה בשם mytable ב-mydataset.
    bq load \
    --replace \
    --source_format=PARQUET \
    mydataset.mytable \
    gs://mybucket/mydata.parquet
הפקודה הבאה טוענת נתונים מ-gs://mybucket/mydata.parquet ומוסיפה נתונים לטבלה בשם mytable ב-mydataset.
    bq load \
    --noreplace \
    --source_format=PARQUET \
    mydataset.mytable \
    gs://mybucket/mydata.parquet
במאמר הוספה ודריסה של נתונים בטבלה מחולקת למחיצות מוסבר איך להוסיף ולדרוס טבלאות מחולקות למחיצות באמצעות כלי שורת הפקודה של BigQuery.
API
יוצרים משימת
loadשמפנה לנתוני המקור ב-Cloud Storage.(אופציונלי) מציינים את המיקום במאפיין
locationבקטעjobReferenceשל משאב המשימה.המאפיין
source URIsחייב להיות מוגדר באופן מלא, בפורמטgs://BUCKET/OBJECT. אפשר לכלול כמה מזהי URI ברשימה מופרדת בפסיקים. שימו לב שאפשר להשתמש גם בתווים כלליים לחיפוש.מציינים את פורמט הנתונים על ידי הגדרת המאפיין
configuration.load.sourceFormatלערךPARQUET.מציינים את העדפת הכתיבה על ידי הגדרת המאפיין
configuration.load.writeDispositionלערךWRITE_TRUNCATEאוWRITE_APPEND.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להוסיף את השורות לטבלה קיימת, מגדירים את המאפייןLoadJobConfig.write_disposition לערך WRITE_APPEND.
כדי להחליף את השורות בטבלה קיימת, מגדירים את המאפיין LoadJobConfig.write_disposition לערך WRITE_TRUNCATE.
טעינת נתוני Parquet עם חלוקה למחיצות ב-Hive
ב-BigQuery אפשר לטעון נתוני Parquet שעברו חלוקה למחיצות ב-Hive ומאוחסנים ב-Cloud Storage, ולאכלס את עמודות החלוקה למחיצות ב-Hive כעמודות בטבלה המנוהלת של היעד ב-BigQuery. מידע נוסף זמין במאמר טעינה של נתונים שחולקו למחיצות באופן חיצוני.
המרות של קובצי Parquet
בקטע הזה מוסבר איך BigQuery מנתח סוגי נתונים שונים כשטוענים נתוני Parquet.
אפשר להמיר חלק מסוגי הנתונים של Parquet (כמו INT32, INT64, BYTE_ARRAY ו-FIXED_LEN_BYTE_ARRAY) לכמה סוגי נתונים של BigQuery. כדי לוודא ש-BigQuery ממיר את סוגי הנתונים של Parquet בצורה נכונה, צריך לציין את סוג הנתונים המתאים בקובץ Parquet.
לדוגמה, כדי להמיר את סוג הנתונים INT32 של Parquet לסוג הנתונים DATE של BigQuery, מציינים את הפרטים הבאים:
optional int32 date_col (DATE);
BigQuery ממיר את סוגי הנתונים של Parquet לסוגי הנתונים של BigQuery שמתוארים בקטעים הבאים.
המרות סוגים
| סוג הנתונים ב-BigQuery | ||
|---|---|---|
BOOLEAN |
ללא | בוליאני |
| INT32 | אין, INTEGER (UINT_8, UINT_16,
UINT_32, INT_8, INT_16,
INT_32)
|
INT64 |
| INT32 | DECIMAL | NUMERIC, BIGNUMERIC או STRING |
INT32 |
DATE |
תאריך |
INT32 |
TIME, precision=MILLIS
(TIME_MILLIS)
|
שעה |
INT64 |
אין, INTEGER (UINT_64, INT_64)
|
INT64 |
| INT64 | DECIMAL | NUMERIC, BIGNUMERIC או STRING |
INT64 |
TIME, precision=MICROS
(TIME_MICROS)
|
שעה |
INT64 |
TIMESTAMP, precision=MILLIS
(TIMESTAMP_MILLIS)
|
TIMESTAMP |
INT64 |
TIMESTAMP, precision=MICROS
(TIMESTAMP_MICROS)
|
TIMESTAMP |
INT96 |
ללא | TIMESTAMP |
FLOAT |
ללא | FLOAT64 |
DOUBLE |
ללא | FLOAT64 |
BYTE_ARRAY |
ללא | BYTES |
BYTE_ARRAY |
STRING (UTF8) |
מחרוזת |
| FIXED_LEN_BYTE_ARRAY | DECIMAL | NUMERIC, BIGNUMERIC או STRING |
FIXED_LEN_BYTE_ARRAY |
ללא | BYTES |
קבוצות בתוך קבוצות מומרות לסוגי STRUCT.
אין תמיכה בשילובים אחרים של סוגי Parquet וסוגים שהומרו.
סוגים לוגיים לא חתומים
הסוגים UINT_8, UINT_16, UINT_32 ו-UINT_64 של Parquet הם ללא סימן.
כש-BigQuery טוען ערכים מהסוגים האלה לעמודה INTEGER עם סימן, הוא מתייחס אליהם כערכים ללא סימן. במקרה של UINT_64, תוחזר שגיאה אם הערך ללא סימן חורג מהערך המקסימלי של INTEGER, שהוא 9,223,372,036,854,775,807.
סוג לוגי עשרוני
אפשר להמיר סוגים לוגיים של Decimal לסוגים של NUMERIC, BIGNUMERIC או STRING. הסוג שאליו מתבצעת ההמרה תלוי בפרמטרים של הדיוק והקנה מידה של הסוג הלוגי decimal ובסוגי היעד העשרוניים שצוינו. מציינים את סוג היעד העשרוני באופן הבא:
- במשימת טעינה באמצעות ה-API של
jobs.insert: משתמשים בשדהJobConfigurationLoad.decimalTargetTypes. - במשימת טעינה באמצעות הפקודה
bq loadבכלי שורת הפקודה של BigQuery: משתמשים בדגל--decimal_target_types. - לשאילתה על טבלה עם מקורות חיצוניים: משתמשים בשדה
ExternalDataConfiguration.decimalTargetTypes. - בטבלה חיצונית קבועה שנוצרה באמצעות DDL: משתמשים באפשרות
decimal_target_types.
סוג לוגי של טיפוסים בני מנייה (enum)
אפשר להמיר סוגים לוגיים של Enum ל-STRING או ל-BYTES. מציינים את סוג היעד שהומר באופן הבא:
- במשימת טעינה באמצעות ה-API של
jobs.insert: משתמשים בשדהJobConfigurationLoad.parquetOptions. - במשימת טעינה באמצעות הפקודה
bq loadבכלי שורת הפקודה של BigQuery: משתמשים בדגל--parquet_enum_as_string. - בטבלה חיצונית קבועה שנוצרה באמצעות
bq mk: משתמשים בדגל--parquet_enum_as_string.
סוג לוגי של רשימה
אפשר להפעיל הסקת סכימה לסוגים לוגיים של Parquet LIST. BigQuery בודק אם הצומת LIST נמצא בפורמט הסטנדרטי או באחד מהפורמטים שמתוארים בכללי התאימות לדורות קודמים:
// standard form
<optional | required> group <name> (LIST) {
  repeated group list {
    <optional | required> <element-type> element;
  }
}
אם כן, השדה התואם לצומת LIST בסכימה שהומרה מטופל כאילו לצומת יש את הסכימה הבאה:
repeated <element-type> <name>
הצמתים "list" ו-"element" לא נכללים.
- במשימת טעינה באמצעות ה-API של
jobs.insert, משתמשים בשדהJobConfigurationLoad.parquetOptions. - במשימת טעינה שמשתמשת בפקודה
bq loadבכלי שורת הפקודה של BigQuery, משתמשים בדגל--parquet_enable_list_inference. - בטבלה חיצונית קבועה שנוצרה באמצעות
bq mk, משתמשים בדגל--parquet_enable_list_inference. - בטבלה חיצונית קבועה שנוצרה באמצעות ההצהרה
CREATE EXTERNAL TABLE, משתמשים באפשרותenable_list_inference.
נתונים גיאו-מרחביים
אפשר לטעון קובצי Parquet שמכילים WKT, WKB בקידוד הקסדצימלי או GeoJSON בעמודה STRING, או WKB בעמודה BYTE_ARRAY, על ידי ציון סכימה של BigQuery עם הסוג GEOGRAPHY. מידע נוסף זמין במאמר טעינת נתונים גיאו-מרחביים.
אפשר גם לטעון קובצי GeoParquet. במקרה כזה, העמודות שמתוארות במטא-נתונים של GeoParquet מפורשות כסוג GEOGRAPHY כברירת מחדל. אפשר גם לטעון את נתוני ה-WKB הגולמיים לעמודת BYTES על ידי מתן סכימה מפורשת. מידע נוסף זמין במאמר טעינת קובצי GeoParquet.
שמות העמודות של ההמרות
שם של עמודה יכול להכיל אותיות (a-z, A-Z), מספרים (0-9) או קווים תחתונים (_), והוא חייב להתחיל באות או בקו תחתון. אם אתם משתמשים בשמות גמישים של עמודות, BigQuery תומך בשמות שמתחילים במספר. היזהרו כשאתם מתחילים שמות של עמודות במספר, כי השימוש בשמות גמישים של עמודות ב-BigQuery Storage Read API או ב-BigQuery Storage Write API (gRPC) דורש טיפול מיוחד. מידע נוסף על תמיכה בשמות גמישים של עמודות זמין במאמר שמות גמישים של עמודות.
האורך המקסימלי של שמות העמודות הוא 300 תווים. שמות העמודות לא יכולים לכלול את התחיליות הבאות:
_TABLE__FILE__PARTITION_ROW_TIMESTAMP__ROOT___COLIDENTIFIER_CHANGE_SEQUENCE_NUMBER_CHANGE_TYPE_CHANGE_TIMESTAMP
אסור להשתמש בשמות עמודות כפולים, גם אם יש הבדל באותיות רישיות. לדוגמה, עמודה בשם Column1 נחשבת זהה לעמודה בשם column1. מידע נוסף על הכללים למתן שמות לעמודות זמין בקטע שמות עמודות במדריך העזר של GoogleSQL.
אם שם הטבלה (לדוגמה, test) זהה לאחד משמות העמודות (לדוגמה, test), הביטוי SELECT מפרש את העמודה test כ-STRUCT שמכיל את כל שאר העמודות בטבלה. כדי למנוע את ההתנגשות הזו, אפשר להשתמש באחת מהשיטות הבאות:
אל תשתמשו באותו שם לטבלה ולעמודות שלה.
אל תשתמשו ב-
_field_בתור תחילית לשם של עמודה. קידומות ששמורות למערכת גורמות לשינוי שם אוטומטי במהלך שאילתות. לדוגמה, השאילתהSELECT _field_ FROM project1.dataset.testמחזירה עמודה בשם_field_1. אם אתם צריכים לשלוח שאילתה לעמודה עם השם הזה, השתמשו בכינוי כדי לשלוט בפלט.מקצים לטבלה כינוי אחר. לדוגמה, השאילתה הבאה מקצה את כינוי הטבלה
tלטבלהproject1.dataset.test:SELECT test FROM project1.dataset.test AS t;כשמפנים לעמודה, צריך לכלול את שם הטבלה. לדוגמה:
SELECT test.test FROM project1.dataset.test;
שמות גמישים של עמודות
יש לכם יותר גמישות בבחירת שמות לעמודות, כולל גישה מורחבת לתווים בשפות שאינן אנגלית וגם לסמלים נוספים.
אם שמות העמודות הגמישות הם מזהים במירכאות, הקפידו להשתמש בתווי גרש הפוך (`) כדי לתחום אותם.
שמות עמודות גמישים תומכים בתווים הבאים:
- כל אות בכל שפה, כפי שהיא מיוצגת על ידי הביטוי הרגולרי של Unicode
\p{L}. - כל תו מספרי בכל שפה, כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode
\p{N}. - כל תו פיסוק מקשר, כולל קווים תחתונים, כפי שמיוצג על ידי הביטוי הרגולרי של Unicode
\p{Pc}. - מקף או קו מפריד, כפי שהם מיוצגים בביטוי הרגולרי של Unicode
\p{Pd}. - כל סימן שנועד ללוות תו אחר, כפי שמיוצג על ידי הביטוי הרגולרי של Unicode
\p{M}. לדוגמה, סימני הטעמה, אומלאוטים או תיבות תוחמות. - התווים המיוחדים הבאים:
- אמפרסנד (
&) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u0026. - סימן אחוז (
%) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u0025. - סימן שוויון (
=) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u003D. - סימן פלוס (
+) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u002B. - נקודתיים (
:) כפי שהן מיוצגות על ידי הביטוי הרגולרי של Unicode\u003A. - גרש (
') כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u0027. - סימן קטן מ- (
<) שמיוצג על ידי הביטוי הרגולרי של Unicode\u003C. - סימן גדול מ- (
>) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u003E. - סימן מספר (
#) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u0023. - קו אנכי (
|) שמיוצג על ידי הביטוי הרגולרי של Unicode\u007c. - רווח לבן.
- אמפרסנד (
שמות גמישים של עמודות לא תומכים בתווים המיוחדים הבאים:
- סימן קריאה (
!) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u0021. - מירכאות (
") כפי שהן מיוצגות על ידי הביטוי הרגולרי של Unicode\u0022. - סימן דולר (
$) שמיוצג על ידי הביטוי הרגולרי של Unicode\u0024. - סוגר שמאלי (
() שמיוצג על ידי הביטוי הרגולרי של Unicode\u0028. - סוגר ימני (
)) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u0029. - כוכבית (
*) כפי שהיא מיוצגת על ידי הביטוי הרגולרי של Unicode\u002A. - פסיק (
,) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u002C. - נקודה (
.) כפי שהיא מיוצגת על ידי הביטוי הרגולרי של Unicode\u002E. נקודות לא מוחלפות בקו תחתון בשמות של עמודות בקובץ Parquet כשמשתמשים במפת תווים של שמות עמודות. מידע נוסף זמין במאמר בנושא מגבלות על עמודות גמישות. - לוכסן (
/) שמיוצג על ידי הביטוי הרגולרי של Unicode\u002F. - נקודה ופסיק (
;) כפי שהם מיוצגים על ידי הביטוי הרגולרי של Unicode\u003B. - סימן שאלה (
?) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u003F. - סימן כרוכית (
@) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u0040. - סוגר מרובע שמאלי (
[) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u005B. - לוכסן הפוך (
\) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u005C. - סוגר מרובע ימני (
]) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u005D. - הטעמת גג (
^) שמיוצגת על ידי הביטוי הרגולרי של Unicode\u005E. - סימן הטעמה משני (
`) שמיוצג על ידי הביטוי הרגולרי של Unicode\u0060. - סוגר מסולסל שמאלי {
{) שמיוצג על ידי הביטוי הרגולרי של Unicode\u007B. - סוגר מסולסל ימני (
}) כפי שהוא מיוצג על ידי הביטוי הרגולרי של Unicode\u007D. - טילדה (
~) כפי שהיא מיוצגת על ידי הביטוי הרגולרי של Unicode\u007E.
הנחיות נוספות זמינות במאמר שמות של עמודות.
התווים המורחבים של העמודות נתמכים גם ב-BigQuery Storage Read API וגם ב-BigQuery Storage Write API (gRPC). כדי להשתמש ברשימה המורחבת של תווי Unicode עם BigQuery Storage Read API, צריך להגדיר דגל. אפשר להשתמש במאפיין displayName כדי לאחזר את שם העמודה. בדוגמה הבאה מוסבר איך להגדיר דגל באמצעות לקוח Python:
from google.cloud.bigquery_storage import types
requested_session = types.ReadSession()

#set avro serialization options for flexible column.
options = types.AvroSerializationOptions()
options.enable_display_name_attribute = True
requested_session.read_options.avro_serialization_options = options
כדי להשתמש ברשימה המורחבת של תווי Unicode עם BigQuery Storage Write API (gRPC), צריך לספק את הסכימה עם הסימון column_name, אלא אם משתמשים באובייקט הכתיבה JsonStreamWriter. בדוגמה הבאה אפשר לראות איך מספקים את הסכימה:
syntax = "proto2";
package mypackage;
// Source protos located in github.com/googleapis/googleapis
import "google/cloud/bigquery/storage/v1/annotations.proto";

message FlexibleSchema {
  optional string item_name_column = 1
  [(.google.cloud.bigquery.storage.v1.column_name) = "name-列"];
  optional string item_description_column = 2
  [(.google.cloud.bigquery.storage.v1.column_name) = "description-列"];
}
בדוגמה הזו, item_name_column ו-item_description_column הם שמות של פלייסהולדרים שצריכים לעמוד במוסכמות למתן שמות של מאגר אחסון לפרוטוקולים. שימו לב שההערות של column_name תמיד מקבלות עדיפות על פני שמות של פלייסהולדרים.
מגבלות
- שמות גמישים של עמודות נתמכים כברירת מחדל בטבלאות מנוהלות של Iceberg, בטבלאות חיצוניות של Iceberg ובטבלאות של Apache Iceberg שמנוהלות על ידי קטלוג ייעודי לזמן ריצה של Lakehouse.
בטבלאות חיצוניות אחרות (כמו Parquet, ORC, Avro, CSV או Delta Lake), שמות גמישים של עמודות לא מופעלים כברירת מחדל. כדי לבקש הפעלה ברמת הפרויקט, פנו ל-Cloud Customer Care.
- בטבלאות Delta Lake, צריך גם להפעיל מיפוי עמודות במצב
idאוname.
- בטבלאות Delta Lake, צריך גם להפעיל מיפוי עמודות במצב
- כשמייצאים טבלאות חיצוניות עם שמות עמודות גמישים לפורמטים של קבצים פתוחים (כמו Parquet או Avro באמצעות
EXPORT DATAאו משימות חילוץ), שמות עמודות שלא נתמכים ממופים לשמות גיבוב (hash) פנימיים שנוצרו (col_...), כי פורמטים של צד שלישי לא כוללים מטא-נתונים של שמות תצוגה ב-BigQuery. שמות גמישים של עמודות לא נתמכים ב-SQL מדור קודם. חובה להשתמש ב-GoogleSQL.
אי אפשר לטעון קובצי Parquet שמכילים עמודות עם נקודה (.) בשם העמודה.
שמות של עמודות מקובצי Parquet לא תלויי-רישיות כשטוענים אותם ל-BigQuery. שמות זהים שלא תלויי-רישיות יגרמו להתנגשויות. כדי למנוע את זה, אפשר להוסיף קו תחתון לאחד משמות העמודות הכפולים או לשנות את שמות העמודות לפני הטעינה.
ניפוי באגים בקובץ Parquet
אם משימות הטעינה נכשלות בגלל שגיאות בנתונים, אתם יכולים להשתמש ב-PyArrow כדי לבדוק אם קובצי הנתונים של Parquet פגומים. אם PyArrow לא מצליח לקרוא את הקבצים, סביר להניח שהקבצים יידחו על ידי משימת הטעינה של BigQuery. בדוגמה הבאה מוסבר איך לקרוא את התוכן של קובץ Parquet באמצעות PyArrow:
from pyarrow import parquet as pq

# Read the entire file
pq.read_table('your_sample_file.parquet')
# Read specific columns
pq.read_table('your_sample_file.parquet',columns=['some_column', 'another_column'])
# Read the metadata of specific columns
file_metadata=pq.read_metadata('your_sample_file.parquet')
for col in file_metadata.row_group(0).to_dict()['columns']:
    print col['column_path_in_schema']
    print col['num_values']
מידע נוסף זמין במסמכי התיעוד של PyArrow.