


Replica dei set di dati tra regioni
Con la replica dei set di dati BigQuery, puoi configurare la replica automatica di un set di dati tra due regioni o multi-regioni diverse.
Panoramica
Quando crei un set di dati in BigQuery, selezioni la regione o la multiregione in cui vengono archiviati i dati. Una regione è una raccolta di data center all'interno di un'area geografica, mentre una multiregione è un'area geografica di grandi dimensioni che contiene due o più regioni geografiche. I dati vengono archiviati in una delle regioni contenute e non vengono replicati all'interno della località multiregionale. Per saperne di più su regioni e multi-regioni, consulta Località BigQuery.
BigQuery archivia sempre copie dei tuoi dati in due zoneGoogle Cloud diverse all'interno della località del set di dati. Una zona è un'area di deployment per le risorse Google Cloud all'interno di una regione. In tutte le regioni, la replica tra zone utilizza doppie scritture sincrone. La selezione di una località multiregionale non fornisce la replica tra regioni o la ridondanza regionale, pertanto non aumenta la disponibilità del set di dati in caso di interruzione a livello di regione. I dati vengono archiviati in una singola regione all'interno della posizione geografica.
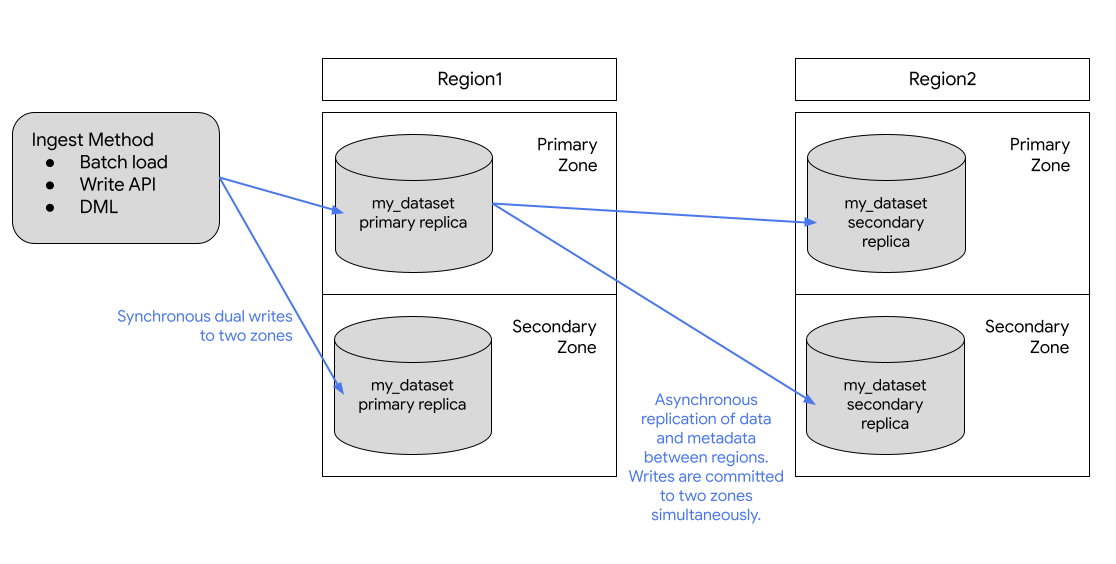
Per una maggiore ridondanza geografica, puoi replicare qualsiasi set di dati. BigQuery crea una replica secondaria del set di dati, situata in un'altra regione specificata da te. Questa replica viene poi replicata in modo asincrono tra due zone con l'altra regione, per un totale di quattro copie di zona.
Replica dei set di dati
Se replichi un set di dati, BigQuery archivia i dati nella regione specificata.
Regione principale. Quando crei un set di dati per la prima volta, BigQuery lo posiziona nella regione principale.
Regione secondaria. Quando aggiungi una replica del set di dati, BigQuery la posiziona nella regione secondaria.
Inizialmente, la replica nella regione principale è la replica principale, mentre la replica nella regione secondaria è la replica secondaria.
La replica principale è scrivibile, mentre quella secondaria è di sola lettura. Le scritture nella replica principale vengono replicate in modo asincrono nella replica secondaria. All'interno di ogni regione, i dati vengono archiviati in modo ridondante in due zone. Il traffico di rete non lascia mai la rete Google Cloud .
Il seguente diagramma mostra la replica che si verifica quando un set di dati viene replicato:
Se la regione principale è online, puoi passare manualmente alla replica secondaria. Per saperne di più, consulta Promuovi la replica secondaria.
Replica e DML
BigQuery archivia i dati in blocchi immutabili. Le operazioni DML (Data Manipulation Language), come le istruzioni UPDATE, DELETE o MERGE, riscrivono i dati modificati e non modificati dei file interessati in nuovi blocchi di archiviazione sottostanti. Poiché la replica tra regioni avviene a livello di file, dopo aver eseguito un'operazione DML, BigQuery deve replicare l'intero nuovo file nella regione secondaria.
Ad esempio, l'aggiornamento di 100 MB di dati all'interno di un file di archiviazione da 1 GB richiede a BigQuery di replicare l'intero file da 1 GB appena ricostruito, non solo i 100 MB aggiornati. Le operazioni DML frequenti su tabelle di grandi dimensioni o non partizionate possono aumentare in modo significativo il volume totale di dati trasferiti.
A causa di questo comportamento, operazioni DML frequenti sui dati replicati possono comportare un aumento dei costi di trasferimento dei dati. Sposta invece le tabelle con un numero elevato di DML in un set di dati separato che non viene replicato.
Prezzi
Per i set di dati replicati, ti vengono addebitati i seguenti costi:
- Spazio di archiviazione. I byte di archiviazione nella regione secondaria vengono fatturati come una copia separata nella regione secondaria. Le tabelle e le partizioni nello archiviazione a lungo termine non vengono reimpostate sull'archiviazione attiva nella replica secondaria.
- Replica dei dati. Per ulteriori informazioni su come vengono fatturati i costi per la replica dei dati, consulta Prezzi della replica dei dati.
La replica dei dati è gestita da BigQuery e non utilizza le tue risorse slot. La replica dei dati viene fatturata separatamente.
Capacità di calcolo nella regione secondaria
Per eseguire job e query sulla replica nella regione secondaria, devi acquistare slot all'interno della regione secondaria o eseguire una query on demand.
Puoi utilizzare gli slot per eseguire query di sola lettura dalla replica secondaria. Se promuovi la replica secondaria a replica principale, puoi utilizzare questi slot anche per scrivere nella replica.
Puoi acquistare lo stesso numero di slot che hai nella regione principale o un numero diverso di slot. Se acquisti meno slot, le prestazioni delle query potrebbero risentirne.
Considerazioni sulla località
Prima di aggiungere una replica del set di dati, devi creare il set di dati iniziale che vuoi replicare in BigQuery, se non esiste già. La località della replica aggiunta è impostata su quella specificata durante l'aggiunta della replica. La località della replica aggiunta deve essere diversa da quella del set di dati iniziale. Ciò significa che i dati nel set di dati vengono replicati continuamente tra la località in cui è stato creato il set di dati e la località della replica. Per le repliche che richiedono la collocazione, come viste, viste materializzate o tabelle esterne non BigLake, l'aggiunta di una replica in una località diversa o non compatibile con quella dei dati di origine potrebbe causare errori dei job.
Quando i clienti replicano un set di dati in più regioni, BigQuery assicura che i dati si trovino solo nelle località in cui sono state create le repliche.
Requisiti di colocation
L'utilizzo della replica del set di dati dipende dai seguenti requisiti di collocazione.
Cloud Storage
Per eseguire query sui dati in Cloud Storage, il bucket Cloud Storage deve essere collocato insieme alla replica. Utilizza le considerazioni sulla località delle tabelle esterne per decidere dove posizionare la replica.
Limitazioni
La replica dei set di dati BigQuery è soggetta alle seguenti limitazioni:
- I dati in modalità flusso scritti nella replica principale dall'API BigQuery Storage Write (gRPC) o dall'API BigQuery Storage Write (REST), che vengono poi replicati nella replica secondaria, sono best-effort e potrebbero presentare un ritardo di replica elevato.
- Gli upsert in modalità flusso scritti nella replica principale da Datastream o dall'importazione di Change Data Capture di BigQuery, che vengono poi replicati nella replica secondaria, sono best effort e potrebbero presentare un ritardo di replica elevato. Una volta replicate, le operazioni di upsert nella replica secondaria vengono unite alla base di riferimento della tabella della replica secondaria in base al valore
max_stalenessconfigurato della tabella. - La replica tra regioni non è supportata per le tabelle con DML granulare abilitato. Sebbene il sistema blocchi la creazione di set di dati replicati che contengono già queste tabelle, non blocca l'attivazione di DML granulare sulle tabelle all'interno di set di dati replicati esistenti. Tuttavia, ciò potrebbe comportare risultati di query errati nel database secondario per la tabella abilitata per DML granulare.
- La replica e lo switchover possono essere gestiti tramite la console Google Cloud o le istruzioni DDL (Data Definition Language) SQL.
- Puoi avere una sola replica di ogni set di dati per ogni regione o località multiregionale. Non puoi creare due repliche secondarie dello stesso set di dati nella stessa regione di destinazione.
- Le risorse all'interno delle repliche sono soggette alle limitazioni descritte in Comportamento delle risorse.
- I tag di policy e le policy dei dati associate non vengono replicati nella replica secondaria. Qualsiasi query eseguita al di fuori della regione principale non va a buon fine se sono presenti tag di policy sulle colonne a cui viene fatto riferimento nella query, a meno che l'utente non disponga del ruolo
roles/datacatalog.categoryFineGrainedReadera livello di progetto, cartella o organizzazione. La promozione di una replica non corregge automaticamente queste associazioni; devi aggiornarle in modo che puntino a una tassonomia valida nella nuova regione principale. - Il Time Travel è disponibile nella replica secondaria solo dopo il completamento della creazione della replica secondaria.
- Il limite di dimensioni della regione di destinazione (in byte logici) per l'abilitazione della replica tra regioni su un set di dati è di 10 PB per le multi-regioni
useeue di 500 TB per le altre regioni per impostazione predefinita. Questi limiti sono configurabili. Per ulteriori informazioni, contatta l'assistenza diGoogle Cloud . - La quota si applica alle risorse logiche.
- Puoi replicare solo un set di dati con meno di 100.000 tabelle.
- Puoi aggiungere (e poi eliminare) un massimo di 4 repliche alla stessa regione per set di dati al giorno.
- La larghezza di banda è limitata.
- Le tabelle con chiavi di crittografia gestite dal cliente (CMEK) applicate non sono interrogabili nella regione secondaria se il valore
replica_kms_keynon è configurato. - Le tabelle BigLake non sono supportate.
- Non puoi replicare set di dati esterni o federati.
- Le località di BigQuery Omni non sono supportate.
- Non puoi configurare le seguenti coppie di regioni se stai configurando la replica dei dati per il disaster recovery:
us-central1-usmultiregionaleus-west1-usmultiregionaleeu-west1-eumultiregionaleeu-west4-eumultiregionale
- I controlli degli accessi a livello di routine non possono essere replicati, ma puoi replicare i controlli degli accessi a livello di set di dati per le routine.
- Il seguente comportamento si applica agli indici della Ricerca:
- Nella regione secondaria vengono replicati solo i metadati dell'indice della Ricerca, non i dati dell'indice.
- Se passi alla replica, l'indice viene eliminato dalla regione principale precedente e rigenerato nella regione promossa.
- Se passi da un tipo all'altro entro 8 ore, la generazione dell'indice viene ritardata di 8 ore.
- Le query pianificate non vengono reindirizzate automaticamente a una nuova località principale se promuovi una replica secondaria. Rimangono
vincolati alla regione specificata al momento della creazione.
- Se la replica principale originale diventa una replica secondaria di sola lettura dopo la promozione, le query pianificate che tentano di scrivere dati nel set di dati non vanno a buon fine.
- Se la regione principale originale non è più disponibile, le query pianificate non vanno a buon fine, anche se eseguono solo operazioni di lettura.
- Per assicurarti che le query pianificate continuino a essere eseguite sulla replica principale promossa, devi ricrearle manualmente nella nuova località principale.
- Non puoi replicare i set di dati nascosti.
- La replica tra regioni non è supportata per i set di dati che contengono policy IAM condizionali. Per identificare se questo errore sta interrompendo la replica, puoi controllare la colonna
sync_statusnella vistaINFORMATION_SCHEMA.SCHEMATA_REPLICAS.
Comportamento delle risorse
Le seguenti operazioni non sono supportate sulle risorse all'interno della replica secondaria:
La replica secondaria è di sola lettura. Se devi creare una copia di una risorsa in una replica secondaria, devi prima copiare la risorsa o eseguire una query sulla risorsa, quindi materializzare i risultati all'esterno della replica secondaria. Ad esempio, utilizza CREATE TABLE AS SELECT per creare una nuova risorsa dalla risorsa di replica secondaria.
Le repliche principali e secondarie sono soggette alle seguenti differenze:
| Replica principale della regione 1 | Replica secondaria della Regione 2 | Note |
|---|---|---|
| Set di dati autorizzato | Set di dati autorizzato | Non puoi creare un set di dati autorizzato in una replica secondaria. Devono essere create nella replica principale e sono quindi disponibili per le query dalla regione secondaria. |
| Routine autorizzata | Routine autorizzata | Non puoi creare una routine autorizzata in una replica secondaria. Devono essere create nella replica principale e sono quindi disponibili per le query dalla regione secondaria. |
| Vista autorizzata | Vista autorizzata | Non puoi creare una vista autorizzata in una replica secondaria. Devono essere create nella replica principale e sono quindi disponibili per le query dalla regione secondaria. |
| Tabella BigLake | Tabella BigLake | Non supportate. |
| Tabella Apache Iceberg di BigLake | Tabella Apache Iceberg di BigLake | Consulta Replica tra regioni e disaster recovery del catalogo di runtime Lakehouse. |
| Tabella esterna | Tabella esterna | Viene replicata solo la definizione della tabella esterna. La query non riesce quando il bucket Cloud Storage non si trova nella stessa località di una replica. |
| Vista logica | Vista logica | Le viste logiche che fanno riferimento a un set di dati o a una risorsa che non si trova nella stessa località della vista logica non vanno a buon fine quando vengono interrogate. |
| Tabella gestita | Tabella gestita | Nessuna differenza. |
| Vista materializzata | Vista materializzata | Se una tabella di riferimento non si trova nella stessa regione della vista materializzata, la query non va a buon fine. Le viste materializzate replicate potrebbero presentare un'inattività superiore all'inattività massima della vista. |
| Modello | Modello | Archiviati come tabelle gestite. |
| Funzione remota | Funzione remota | Le connessioni sono regionali. Le funzioni remote che fanno riferimento a un set di dati o a una risorsa (connessione) che non si trova nella stessa località della funzione remota non vengono eseguite. |
| Routine | Funzione definita dall'utente (UDF) o stored procedure | Le routine che fanno riferimento a un set di dati o a una risorsa che non si trova nella stessa località della routine non vengono eseguite. Qualsiasi routine che fa riferimento a una connessione, ad esempio le funzioni remote, non funziona al di fuori della regione di origine. |
| Policy di accesso alle righe | Policy di accesso alle righe | Nessuna differenza. |
| Indice della Ricerca | Indice della Ricerca | Vengono replicati solo i metadati dell'indice. I dati dell'indice esistono solo nella regione principale. |
| Stored procedure | Stored procedure | Le stored procedure che fanno riferimento a un set di dati o a una risorsa che non si trova nella stessa località della stored procedure non vengono eseguite. |
| Clone della tabella | Tabella gestita | Fatturata come copia completa nella replica secondaria. |
| Snapshot tabella | Snapshot tabella | Fatturata come copia completa nella replica secondaria. |
| Funzione con valore di tabella (TVF) | TVF | Le TVF che fanno riferimento a un set di dati o a una risorsa che non si trova nella stessa località della TVF non vengono eseguite. |
| Funzioni definite dall'utente | Funzioni definite dall'utente | Le funzioni definite dall'utente che fanno riferimento a un set di dati o a una risorsa che non si trova nella stessa località della funzione definita dall'utente non vengono eseguite. |
| Policy dei dati su una colonna | Policy dei dati su una colonna | I criteri dei dati personalizzati che fanno riferimento a una funzione definita dall'utente che non si trova nella stessa località del criterio non vanno a buon fine quando viene eseguita una query sulla tabella a cui è associato il criterio. |
Scenari di interruzione del servizio
La replica tra regioni non è destinata all'utilizzo come piano di ripristino di emergenza durante un'interruzione totale della regione. In caso di interruzione totale della regione della replica principale, non puoi promuovere la replica secondaria. Poiché le repliche secondarie sono di sola lettura, non puoi eseguire job di scrittura sulla replica secondaria e non puoi promuovere la regione secondaria finché non viene ripristinata la regione della replica principale. Per saperne di più sulla preparazione al ripristino di emergenza, consulta Disaster recovery gestito.
La tabella seguente spiega l'impatto delle interruzioni totali della regione sui dati replicati:
| Regione 1 | Regione 2 | Regione dell'interruzione | Impatto |
|---|---|---|---|
| Replica principale | Replica secondaria | Regione 2 | I job di sola lettura in esecuzione nella regione 2 sulla replica secondaria non vanno a buon fine. |
| Replica principale | Replica secondaria | Regione 1 | Tutti i job in esecuzione nella regione 1 non vanno a buon fine. I job di sola lettura continuano a essere eseguiti nella regione 2, dove si trova la replica secondaria. I contenuti della regione 2 sono inattivi finché non vengono sincronizzati correttamente con la regione 1. |
Utilizza la replica del set di dati
Questa sezione descrive come replicare un set di dati, promuovere la replica secondaria ed eseguire job di lettura BigQuery nella regione secondaria.
Autorizzazioni obbligatorie
Per ottenere le autorizzazioni necessarie per gestire le repliche, chiedi all'amministratore di concederti l'autorizzazione bigquery.datasets.update.
Replica un set di dati
Per replicare un set di dati, seleziona una delle seguenti opzioni:
Console
Vai alla pagina BigQuery.
Nel riquadro Explorer, fai clic sul set di dati che vuoi replicare.
Fai clic sulla scheda Dettagli.
Nella sezione Repliche, fai clic su Crea replica.
Nel riquadro Crea replica del set di dati, segui questi passaggi:
- Nella sezione Tipo di località, seleziona un tipo di località per la replica.
- Nell'elenco Regione, seleziona una regione per la replica.
- (Facoltativo) Per utilizzare le chiavi di crittografia gestite dal cliente (CMEK), espandi la sezione Opzioni avanzate, quindi seleziona l'opzione Chiave di crittografia gestita dal cliente (CMEK).
Fai clic su Crea replica.
SQL
Per replicare un set di dati, utilizza l'istruzione DDL ALTER SCHEMA ADD REPLICA.
Puoi aggiungere una replica a qualsiasi set di dati che si trova in una regione o in una multiregione che non è già replicato in quella regione o in quella multiregione. Dopo aver aggiunto una replica, l'operazione di copia iniziale richiede del tempo per essere completata. Puoi comunque eseguire query che fanno riferimento alla replica principale durante la replica dei dati, senza alcuna riduzione della capacità di elaborazione delle query. Non puoi replicare i dati all'interno delle località geografiche di una multi-regione.
L'esempio seguente crea un set di dati denominato my_dataset nella regione us-central1 e poi aggiunge una replica nella regione us-east4:
-- Create the primary replica in the us-central1 region.
CREATE SCHEMA my_dataset OPTIONS(location='us-central1');

-- Create a replica in the secondary region.
ALTER SCHEMA my_dataset
ADD REPLICA `my_replica`
OPTIONS(location='us-east4');
Per verificare quando la replica secondaria è stata creata correttamente, puoi eseguire una query sulla colonna creation_complete nella vista INFORMATION_SCHEMA.SCHEMATA_REPLICAS.
Dopo aver creato la replica secondaria, puoi eseguire query impostando esplicitamente la posizione della query sulla regione secondaria. Se non viene impostata esplicitamente una località, BigQuery utilizza la regione della replica principale del set di dati.
Promuovi la replica secondaria
Se la regione principale è online, puoi promuovere la replica secondaria. La promozione imposta la replica secondaria come istanza principale scrivibile. Questa operazione viene completata entro pochi secondi se la replica secondaria è aggiornata con la replica principale. Se la replica secondaria non è aggiornata, la promozione non può essere completata finché non lo è. La replica secondaria non può essere promossa a principale se si verifica un'interruzione nella regione contenente la replica principale.
Tieni presente quanto segue:
- Tutte le scritture nelle tabelle restituiscono errori durante la promozione. La replica principale precedente diventa non scrivibile immediatamente all'inizio della promozione.
- Le tabelle che non sono completamente replicate al momento dell'avvio della promozione restituiscono letture di dati obsoleti.
Per promuovere una replica a replica principale, seleziona una delle seguenti opzioni:
Console
Vai alla pagina BigQuery.
Nel riquadro Explorer, fai clic sul set di dati che vuoi promuovere.
Fai clic sulla scheda Dettagli.
Nella sezione Repliche, trova la replica che vuoi promuovere e poi fai clic su Imposta come principale.
Nella finestra di dialogo Promuovi replica, digita
confirmnel campo di testo e poi fai clic su Conferma.
SQL
Per promuovere una replica a replica principale, utilizza l'istruzione DDL ALTER SCHEMA SET
OPTIONS
e imposta l'opzione primary_replica.
Tieni presente quanto segue:
- Devi impostare esplicitamente la località del job sulla regione secondaria nelle impostazioni delle query. Per saperne di più, consulta Specifica le località di BigQuery.
L'esempio seguente promuove la replica us-east4 a istanza principale:
ALTER SCHEMA my_dataset SET OPTIONS(primary_replica = 'us-east4');
Per verificare quando la replica secondaria è stata promossa correttamente, puoi eseguire una query sulla colonna replica_primary_assignment_complete nella vista INFORMATION_SCHEMA.SCHEMATA_REPLICAS.
Rimuovi una replica del set di dati
Per rimuovere una replica e interrompere la replica del set di dati, seleziona una delle seguenti opzioni:
Console
Vai alla pagina BigQuery.
Nel riquadro Explorer, fai clic sul set di dati in cui vuoi rimuovere una replica.
Fai clic sulla scheda Dettagli.
Nella sezione Repliche, individua la replica che vuoi rimuovere, fai clic su Altre azioni e poi su Elimina.
Nella finestra di dialogo Vuoi eliminare la replica del set di dati?, digita
deletenel campo di testo e fai clic su Elimina.
SQL
Per rimuovere una replica e interrompere la replica del set di dati, utilizza l'istruzione DDL ALTER SCHEMA DROP REPLICA.
L'esempio seguente rimuove la replica us:
ALTER SCHEMA my_dataset
DROP REPLICA IF EXISTS `us`;
Per eliminare l'intero set di dati, devi prima eliminare tutte le repliche secondarie. Se elimini l'intero set di dati, ad esempio utilizzando l'istruzioneDROP
SCHEMA, senza eliminare tutte le repliche secondarie, ricevi il seguente errore:
The dataset replica of the cross region dataset 'project_id:dataset_id' in region 'REGION' is not yet writable because the primary assignment is not yet complete.
Per saperne di più, consulta Promuovi la replica secondaria.
Monitora replica
Puoi monitorare lo stato delle repliche dei set di dati tramite BigQuery, Cloud Monitoring o le viste INFORMATION_SCHEMA.
Per informazioni sulla creazione di avvisi su queste metriche, consulta Crea dashboard, grafici e avvisi.
Visualizza lo stato della replica con BigQuery
Per visualizzare lo stato e la latenza della replica di un set di dati nella consoleGoogle Cloud , segui questi passaggi:
Nella console Google Cloud , vai alla pagina BigQuery.
Nel riquadro Explorer, espandi il progetto.
Fai clic sul set di dati che vuoi monitorare.
Nel riquadro dei dettagli del set di dati, fai clic sulla scheda Dettagli.
Nella sezione Repliche, visualizza Latenza di replica e Stato. Per visualizzare ulteriori dettagli, incluso un grafico della latenza di replica, fai clic su Visualizza dettagli.
Visualizza lo stato della replica con Cloud Monitoring
BigQuery fornisce le seguenti metriche in Monitoring per aiutarti a monitorare lo stato della replica:
- Latenza di replica: l'inattività dei dati nella regione secondaria replicati nell'ambito della replica tra regioni o del ripristino di emergenza gestito. Questa metrica funge da proxy per il Recovery Point Objective (RPO).
- Byte in uscita dalla rete: il volume di dati fatturati (in byte) replicati dalla regione principale alla regione secondaria. Questa metrica ti aiuta a monitorare l'utilizzo della quota di larghezza di banda.
Per visualizzare queste metriche in Monitoring, segui questi passaggi:
Nella console Google Cloud , vai alla pagina Monitoring.
Fai clic su Esplora metriche.
Nel campo Seleziona una metrica, cerca e seleziona Set di dati BigQuery.
Seleziona Latenza di replica (
bigquery.googleapis.com/storage/replication/dataset_staleness) o Byte in uscita dalla rete (bigquery.googleapis.com/storage/replication/network_egress_bytes_count).Fai clic su Applica.
Nella sezione Aggregazione, seleziona un metodo di aggregazione. Per la metrica della latenza di replica, ti consigliamo di selezionare 99° percentile. Questa aggregazione mostra meglio il rendimento nel caso peggiore rispetto alla media o ad altre aggregazioni.
(Facoltativo) Per visualizzare le metriche per un set di dati o una regione secondaria specifici, fai clic su Aggiungi filtro, seleziona l'opzione dataset_id o location e poi inserisci un valore. Se replichi i dati in più regioni secondarie, puoi raggrupparli per località per visualizzare le metriche di ogni regione.
Visualizza lo stato della replica con INFORMATION_SCHEMA
Per elencare le repliche dei set di dati in un progetto, esegui una query sulla vista INFORMATION_SCHEMA.SCHEMATA_REPLICAS.
Esegui la migrazione dei set di dati
Puoi utilizzare la replica dei set di dati tra regioni per eseguire la migrazione dei set di dati da una regione all'altra. L'esempio seguente mostra il processo di migrazione del set di dati my_migration esistente dalla località multiregionale US alla località multiregionale EU utilizzando la replica tra regioni.
Replica il set di dati
Per iniziare il processo di migrazione, devi prima replicare il set di dati nella regione in cui vuoi eseguire la migrazione dei dati. In questo scenario, esegui la migrazione del set di dati my_migration alla località multiregionale EU.
-- Create a replica in the secondary region.
ALTER SCHEMA my_migration
ADD REPLICA `eu`
OPTIONS(location='eu');
Viene creata una replica secondaria denominata eu nella località multiregionale EU.
La replica principale è il set di dati my_migration nella località multiregionale US.
Promuovi la replica secondaria
Per continuare a eseguire la migrazione del set di dati nella località multiregionale EU, promuovi la replica secondaria:
ALTER SCHEMA my_migration SET OPTIONS(primary_replica = 'eu')
Al termine della promozione, eu è la replica principale. È una replica scrivibile.
Completare la migrazione
Per completare la migrazione dalla multi-regione US alla multi-regione EU, elimina la replica us. Questo passaggio non è obbligatorio, ma è utile se non hai bisogno di una replica del set di dati oltre alle tue esigenze di migrazione.
ALTER SCHEMA my_migration
DROP REPLICA IF EXISTS us;
Il set di dati si trova nella località multiregionale EU e non esistono repliche del set di dati my_migration. Hai eseguito la migrazione del set di dati alla località multiregionale EU. L'elenco completo delle risorse di cui viene eseguita la migrazione è disponibile in Comportamento delle risorse.
Chiavi di crittografia gestite dal cliente (CMEK)
Le chiavi di Cloud Key Management Service gestite dal cliente non vengono replicate automaticamente quando crei una replica secondaria. Per mantenere la crittografia sul set di dati replicato, devi impostare replica_kms_key per la località della replica aggiunta. Puoi impostare replica_kms_key utilizzando l'istruzione DDL ALTER SCHEMA ADD REPLICA.
La replica dei set di dati con CMEK si comporta come descritto nei seguenti scenari:
Se il set di dati di origine ha un
default_kms_key, devi fornire unareplica_kms_keycreata nella regione del set di dati di replica quando utilizzi l'istruzione DDLALTER SCHEMA ADD REPLICA.Se il set di dati di origine non ha un valore impostato per
default_kms_key, non puoi impostarereplica_kms_key.Se utilizzi la rotazione delle chiavi Cloud KMS su uno (o entrambi) i
default_kms_keyoreplica_kms_key, il set di dati replicato è ancora interrogabile dopo la rotazione della chiave.- La rotazione delle chiavi nella regione principale aggiorna la versione della chiave solo nelle tabelle create dopo la rotazione; le tabelle esistenti prima della rotazione della chiave continuano a utilizzare la versione della chiave impostata prima della rotazione.
- La rotazione delle chiavi nella regione secondaria aggiorna tutte le tabelle nella replica secondaria alla nuova versione della chiave.
- Se la replica principale diventa secondaria, tutte le tabelle della replica secondaria (precedentemente principale) vengono aggiornate alla nuova versione della chiave.
- Se la versione della chiave impostata sulle tabelle nella replica principale prima della rotazione della chiave viene eliminata, non è possibile eseguire query sulle tabelle che utilizzano ancora la versione della chiave impostata prima della rotazione della chiave finché la versione della chiave non viene aggiornata. Per aggiornare la versione della chiave, la versione precedente deve essere attiva (non disattivata o eliminata).
Se il set di dati di origine non ha un valore impostato per
default_kms_key, ma esistono singole tabelle nel set di dati di origine con CMEK applicata, queste tabelle non sono interrogabili nel set di dati replicato. Per eseguire query sulle tabelle, segui questi passaggi:- Aggiungi un valore
default_kms_keyper il set di dati di origine. - Quando crei una nuova replica utilizzando l'istruzione DDL
ALTER SCHEMA ADD REPLICA, imposta un valore per l'opzionereplica_kms_key. Le tabelle CMEK sono disponibili per le query nella regione di destinazione.
Tutte le tabelle CMEK nella regione di destinazione utilizzano lo stesso
replica_kms_key, indipendentemente dalla chiave utilizzata nella regione di origine.- Aggiungi un valore
Crea una replica con CMEK
L'esempio seguente crea una replica nella regione us-west1 con un valore replica_kms_key impostato. Per la chiave CMEK, concedi l'autorizzazione del account di servizio BigQuery per criptare e decriptare.
-- Create a replica in the secondary region.
ALTER SCHEMA my_dataset
ADD REPLICA `us-west1`
OPTIONS(location='us-west1',
  replica_kms_key='my_us_west1_kms_key_name');
Limitazioni CMEK
La replica dei set di dati con CMEK applicata è soggetta alle seguenti limitazioni:
Non puoi aggiornare la chiave Cloud KMS replicata dopo la creazione della replica.
Non puoi aggiornare il valore
default_kms_keynel set di dati di origine dopo la creazione delle repliche del set di dati.Se il valore
replica_kms_keyfornito non è valido nella regione di destinazione, il set di dati non verrà replicato.
Policy dei dati assegnate a una colonna o a un tag di governance dei dati
Le sezioni seguenti descrivono l'interazione tra le policy dei dati assegnate direttamente a una colonna e le policy dei dati assegnate ai tag di governance dei dati (anteprima) con la replica tra regioni.
Le policy dei dati assegnate alle colonne o ai tag di governance dei dati sono risorse regionali. Ciò significa che la policy dei dati e la tabella associata devono trovarsi nella stessa regione. Le policy dei dati vengono replicate automaticamente quando crei una replica secondaria. Se una policy dei dati è collegata a una tabella all'interno di un set di dati replicato o se è assegnata a un tag di governance dei dati su quella tabella, BigQuery crea o aggiorna la policy dei dati e le policy IAM corrispondenti nella regione secondaria.
Mutabilità
Le policy dei dati replicate sono di sola lettura nelle regioni secondarie. Non puoi aggiornare la policy dei dati in una regione secondaria. La policy dei dati originale collegata alla tabella nella regione principale rimane modificabile. Una policy dei dati in una regione è modificabile solo se non è collegata a tabelle secondarie. Se è collegato a tabelle in regioni secondarie, diventa immutabile. BigQuery rifiuta qualsiasi operazione che aggiorna o imposta policy IAM se la policy dei dati è immutabile.
Conflitti di nomi
La risorsa della policy dei dati è la stessa tra le regioni principale e secondaria, ad eccezione della località. Per una policy dei dati e la relativa replica nelle regioni secondarie, gli ID nel formato projects/PROJECT_NUMBER/locations/LOCATION_ID/dataPolicies/DATA_POLICY_ID sono identici, ad eccezione del valore di LOCATION_ID.
La replica non riesce se nella regione secondaria esiste già una policy dei dati con un ID in conflitto. Devi risolvere il conflitto di denominazione nella regione principale o secondaria prima di procedere con la replica.
Policy di mascheramento personalizzate
Se utilizzi una routine di mascheramento personalizzata, assicurati di replicare le funzioni definite dall'utente personalizzate. Puoi includere queste funzioni definite dall'utente nel set di dati che stai replicando.
Collegamento, scollegamento o eliminazione delle policy dei dati alle colonne della tabella
Il collegamento, lo scollegamento o l'eliminazione di una policy dei dati a o da una colonna nella regione principale è una modifica dello schema della tabella. Gli schemi delle tabelle in tutte le regioni secondarie vengono aggiornati per riflettere la modifica. Tuttavia, se scolleghi una policy dei dati da tutte le colonne della tabella nella regione principale, la policy dei dati diventa orfana nella regione secondaria e devi eseguire la pulizia manualmente. Non è consigliabile collegare manualmente una policy dei dati replicati nella regione secondaria perché può portare a situazioni complicate, ad esempio l'impossibilità di aggiungere o rimuovere le autorizzazioni FGAC.
Se elimini una policy dei dati scollegata, un job in background la rimuove dallo schema della tabella. In questo caso, la modifica dello schema della tabella viene propagata alla regione di destinazione. Come per lo scollegamento delle policy, devi eliminare manualmente la policy dei dati nella regione secondaria.
Elimina una replica
Se elimini la replica, le policy dei dati associate non vengono eliminate automaticamente. Come per lo scollegamento delle policy, devi eliminare manualmente la policy dei dati nella regione secondaria.
Passaggi successivi
- Scopri come utilizzare le prenotazioni BigQuery.
- Scopri di più sulle funzionalità di affidabilità di BigQuery.