


Trasmetti gli aggiornamenti delle tabelle con l'importazione di Change Data Capture
L'importazione di Change Data Capture (CDC) di BigQuery aggiorna le tabelle BigQuery elaborando e applicando le modifiche in streaming ai dati esistenti. Questa sincronizzazione viene eseguita tramite operazioni di upsert ed eliminazione delle righe, trasmesse in tempo reale dall'API BigQuery Storage Write (gRPC), che dovresti conoscere prima di procedere.
Prima di iniziare
Concedi i ruoli IAM (Identity and Access Management) che forniscono agli utenti le autorizzazioni necessarie per eseguire ogni attività in questo documento e assicurati che il tuo workflow soddisfi ogni prerequisito.
Autorizzazioni obbligatorie
Per ottenere l'autorizzazione necessaria per utilizzare l'API Storage Write (gRPC), chiedi all'amministratore di concederti il ruolo IAM BigQuery Data Editor (roles/bigquery.dataEditor).
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Questo ruolo predefinito contiene l'autorizzazione bigquery.tables.updateData, necessaria per utilizzare l'API Storage Write (gRPC).
Potresti anche ottenere questa autorizzazione con ruoli personalizzati o altri ruoli predefiniti.
Per saperne di più sui ruoli e sulle autorizzazioni IAM in BigQuery, consulta Introduzione a IAM.
Prerequisiti
Per utilizzare l'importazione CDC di BigQuery, il tuo workflow deve soddisfare le seguenti condizioni:
- Devi utilizzare l'API Storage Write (gRPC) nello stream predefinito.
- Devi utilizzare il formato protobuf come formato di importazione. Il formato Apache Arrow non è supportato.
- Devi dichiarare le chiavi primarie per la tabella di destinazione in BigQuery. Sono supportate chiavi primarie composite contenenti fino a 16 colonne.
- Devono essere disponibili risorse di calcolo BigQuery sufficienti per eseguire le operazioni sulle righe CDC. Tieni presente che se le operazioni di modifica delle righe CDC non vanno a buon fine, potresti conservare involontariamente i dati che intendevi eliminare. Per saperne di più, consulta Considerazioni sui dati eliminati.
Specifica le modifiche ai record esistenti
Nell'importazione CDC di BigQuery, la pseudocolonna _CHANGE_TYPE
indica il tipo di modifica da elaborare per ogni riga. Per utilizzare CDC, imposta _CHANGE_TYPE quando trasmetti le modifiche alle righe utilizzando l'API Storage Write (gRPC). La pseudocolonna _CHANGE_TYPE accetta solo i valori UPSERT e DELETE. Una tabella è considerata attiva con CDC mentre l'API Storage Write (gRPC) trasmette in streaming le modifiche alle righe della tabella in questo modo.
Esempio con valori UPSERT e DELETE
Considera la seguente tabella in BigQuery:
| ID | Nome | Stipendio |
|---|---|---|
| 100 | Charlie | 2000 |
| 101 | Tal | 3000 |
| 102 | Lee | 5000 |
Le seguenti modifiche alle righe vengono trasmesse in streaming dall'API Storage Write (gRPC):
| ID | Nome | Stipendio | _CHANGE_TYPE |
|---|---|---|---|
| 100 | ELIMINA | ||
| 101 | Tal | 8000 | UPSERT |
| 105 | Izumi | 6000 | UPSERT |
La tabella aggiornata è la seguente:
| ID | Nome | Stipendio |
|---|---|---|
| 101 | Tal | 8000 |
| 102 | Lee | 5000 |
| 105 | Izumi | 6000 |
Gestisci l'obsolescenza delle tabelle
Per impostazione predefinita, ogni volta che esegui una query, BigQuery restituisce i risultati più aggiornati. Per fornire i risultati più aggiornati quando esegui una query su una tabella con CDC attivo, BigQuery deve applicare ogni modifica delle righe in streaming fino all'ora di inizio della query, in modo che venga eseguita la query sulla versione più aggiornata della tabella. L'applicazione di queste modifiche alle righe al momento dell'esecuzione della query aumenta la latenza e il costo della query. Tuttavia, se non hai bisogno di risultati delle query completamente aggiornati, puoi ridurre i costi e la latenza delle query impostando l'opzione max_staleness sulla tabella. Quando questa opzione è impostata, BigQuery applica le modifiche alle righe almeno una volta nell'intervallo definito dal valore max_staleness, consentendoti di eseguire query senza attendere l'applicazione degli aggiornamenti, al costo di una certa inattività dei dati.
Questo comportamento è particolarmente utile per le dashboard e i report per i quali la freschezza dei dati non è essenziale. È utile anche per la gestione dei costi, in quanto offre un maggiore controllo sulla frequenza con cui BigQuery applica le modifiche alle righe.
Esegui query sulle tabelle con l'opzione max_staleness impostata
Quando esegui una query su una tabella con l'opzione max_staleness impostata, BigQuery restituisce il risultato in base al valore di max_staleness e all'ora in cui si è verificato l'ultimo job di applicazione, rappresentato dal timestamp upsert_stream_apply_watermark della tabella.
Considera l'esempio seguente, in cui un'opzione max_staleness di una tabella è impostata su 10 minuti e il job di applicazione più recente si è verificato alle ore 20:00:
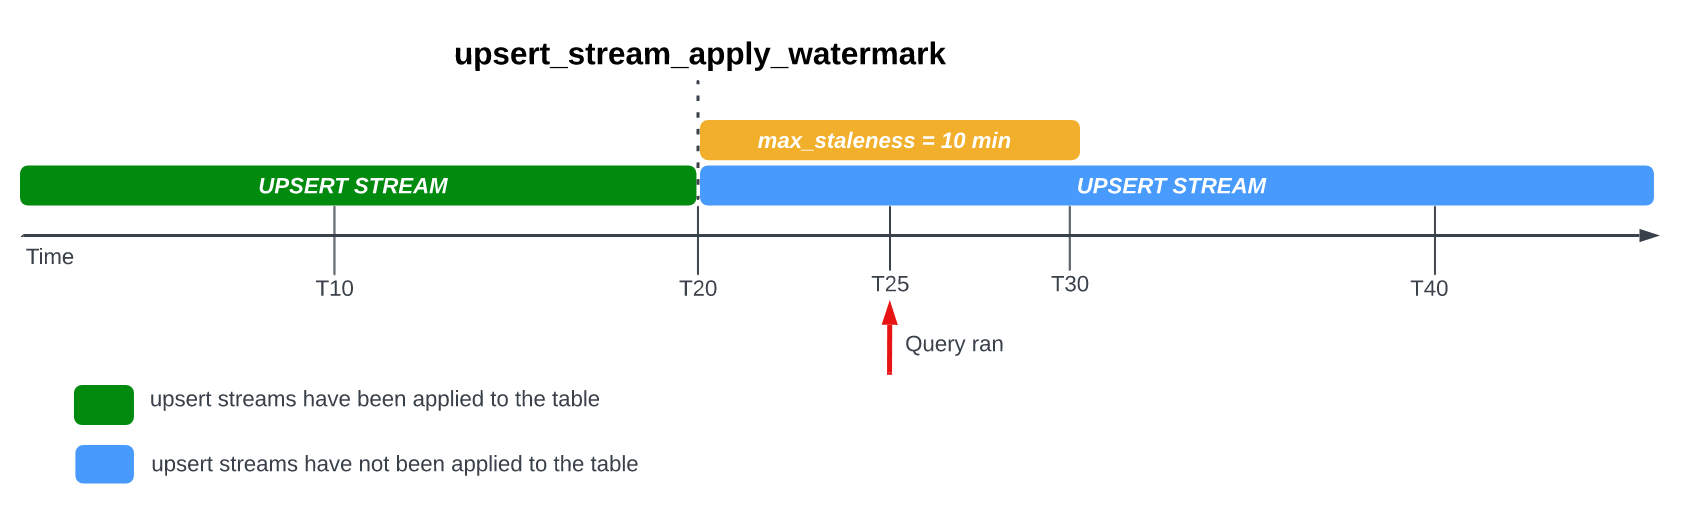
Se esegui una query sulla tabella in T25, la versione corrente della tabella è obsoleta di 5 minuti, ovvero un valore inferiore all'intervallo max_staleness di 10 minuti. In questo caso, BigQuery restituisce la versione di riferimento della tabella in T20, il che significa che anche i dati restituiti sono obsoleti di 5 minuti.
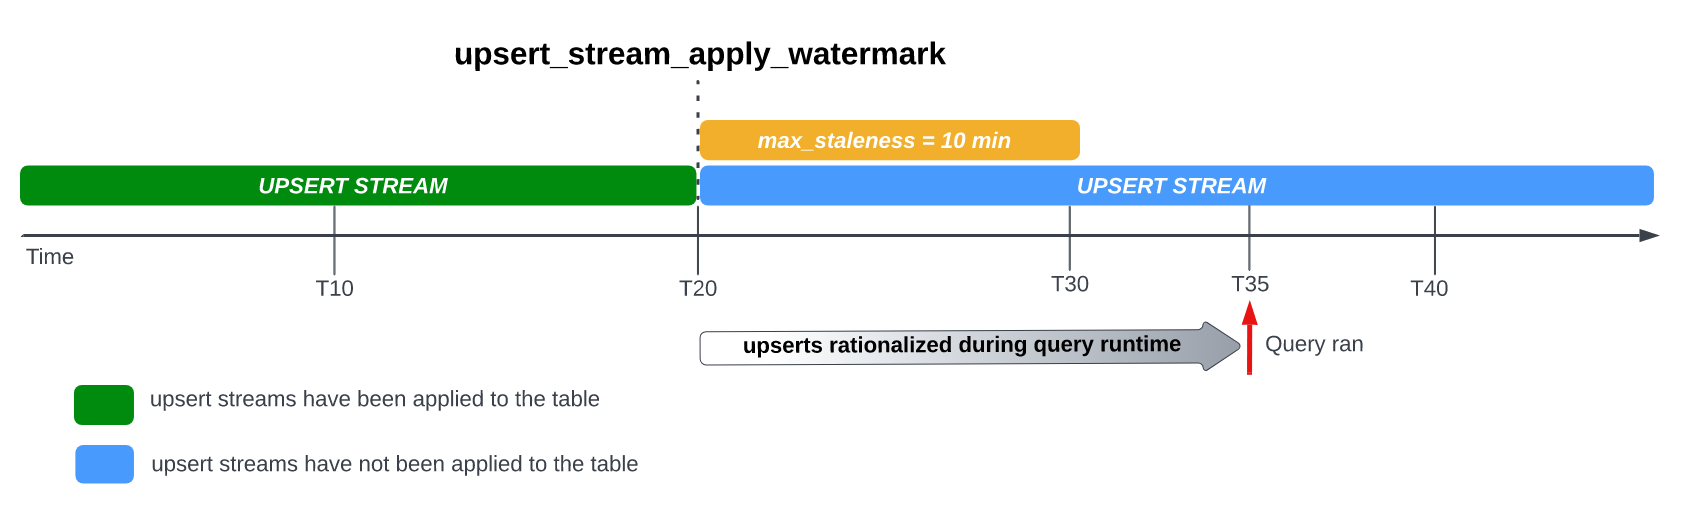
Quando imposti l'opzione max_staleness nella tabella, BigQuery applica le modifiche alle righe in attesa almeno una volta nell'intervallo max_staleness. In alcuni casi, tuttavia, BigQuery potrebbe non completare il processo di applicazione di queste modifiche alle righe in attesa entro l'intervallo.
Ad esempio, se esegui una query sulla tabella in T35 e il processo di applicazione delle modifiche alle righe in attesa non è stato completato, la versione corrente della tabella è obsoleta di 15 minuti, ovvero un valore superiore all'intervallo max_staleness di 10 minuti.
In questo caso, al momento dell'esecuzione della query, BigQuery applica tutte le modifiche alle righe tra T20 e T35 per la query corrente, il che significa che i dati su cui viene eseguita la query sono completamente aggiornati, al costo di una certa latenza aggiuntiva della query.
Questo è considerato un job di unione di runtime.
Eliminazione delle partizioni e unione in fase di runtime
Quando esegui una query su una tabella partizionata con CDC attivo, ad esempio una tabella di destinazione replicata da Datastream, la possibilità di applicare la eliminazione delle partizioni da parte di BigQuery dipende dal fatto che la query attivi o meno un job di unione di runtime:
- Query all'interno della finestra
max_staleness: se il tempo trascorso dall'ultimo job di applicazione in background rientra nell'intervallomax_stalenessdella tabella, BigQuery legge direttamente dalla tabella di riferimento. La riduzione delle partizioni e la riduzione dei cluster funzionano come previsto e BigQuery analizza solo le partizioni che corrispondono al filtro della clausolaWHERE. - Query che attivano un unione in fase di runtime: se
max_stalenessnon è impostato, è impostato su0o la tabella di riferimento è precedente all'intervallomax_staleness, BigQuery esegue un unione in fase di runtime della tabella di riferimento e delle modifiche alle righe trasmesse di recente. Durante un'unione in fase di runtime, la potatura delle partizioni viene ignorata perché BigQuery non può determinare in anticipo quali partizioni sono interessate dalle modifiche in modalità flusso non applicate. Di conseguenza, la query esegue la scansione dell'intera tabella anche quando filtri in base alla colonna di partizionamento.
Se le tue query possono tollerare una leggera inattività dei dati, puoi attivare la riduzione delle partizioni ed evitare scansioni complete della tabella impostando l'opzione max_staleness sulla tabella, ad esempio su 15 minuti, in modo che i job di applicazione in background uniscano le modifiche prima dell'esecuzione delle query:
ALTER TABLE `DATASET_NAME.TABLE_NAME`
SET OPTIONS (
  max_staleness = INTERVAL 15 MINUTE);
Sostituisci quanto segue:
DATASET_NAME: il nome del set di dati in cui si trova la tabella.TABLE_NAME: il nome della tabella partizionata.
Per indicazioni sulla scelta di un intervallo che impedisca le unioni in fase di runtime per il tuo workload, consulta Valore max_staleness consigliato per la tabella.
Valore table max_staleness suggerito
Il valore max_staleness di una tabella deve essere in genere il più alto dei seguenti
due valori:
- L'obsolescenza massima dei dati tollerabile per il tuo workflow.
- Il doppio del tempo massimo necessario per applicare le modifiche sottoposte a upsert alla tabella, più un buffer aggiuntivo.
Per calcolare il tempo necessario per applicare le modifiche sottoposte ad upsert a una tabella esistente, utilizza la seguente query SQL per determinare la durata del 95° percentile dei job di applicazione in background, più un buffer di sette minuti per consentire la conversione dello spazio di archiviazione ottimizzato per la scrittura di BigQuery (buffer di streaming).
SELECT
  project_id,
  destination_table.dataset_id,
  destination_table.table_id,
  APPROX_QUANTILES((TIMESTAMP_DIFF(end_time, creation_time,MILLISECOND)/1000), 100)[OFFSET(95)] AS p95_background_apply_duration_in_seconds,
  CEILING(APPROX_QUANTILES((TIMESTAMP_DIFF(end_time, creation_time,MILLISECOND)/1000), 100)[OFFSET(95)]*2/60)+7 AS recommended_max_staleness_with_buffer_in_minutes
FROM `region-REGION`.INFORMATION_SCHEMA.JOBS AS job
WHERE
  project_id = 'PROJECT_ID'
  AND DATE(creation_time) BETWEEN DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY) AND CURRENT_DATE()
  AND job_id LIKE "%cdc_background%"
GROUP BY 1,2,3;
Sostituisci quanto segue:
REGION: il nome della regione in cui si trova il progetto. Ad esempio,us.PROJECT_ID: l'ID del progetto contenente le tabelle BigQuery che vengono modificate dall'importazione CDC di BigQuery.
La durata dei job di applicazione in background è influenzata da diversi fattori, tra cui il numero e la complessità delle operazioni CDC eseguite nell'intervallo di inattività, le dimensioni della tabella e la disponibilità delle risorse BigQuery. Per saperne di più sulla disponibilità delle risorse, consulta Dimensiona e monitora le prenotazioni BACKGROUND.
Crea una tabella con l'opzione max_staleness
Per creare una tabella con l'opzione max_staleness, utilizza l'istruzione CREATE TABLE.
L'esempio seguente crea la tabella employees con un limite max_staleness di 10 minuti:
CREATE TABLE employees (
  id INT64 PRIMARY KEY NOT ENFORCED,
  name STRING)
  CLUSTER BY
    id
  OPTIONS (
    max_staleness = INTERVAL 10 MINUTE);
Modifica l'opzione max_staleness per una tabella esistente
Per aggiungere o modificare un limite max_staleness in una tabella esistente, utilizza l'istruzione ALTER TABLE.
L'esempio seguente modifica il limite max_staleness della tabella employees in 15 minuti:
ALTER TABLE employees
SET OPTIONS (
  max_staleness = INTERVAL 15 MINUTE);
Determina il valore max_staleness corrente di una tabella
Per determinare il valore max_staleness corrente di una tabella, esegui una query sulla vista INFORMATION_SCHEMA.TABLE_OPTIONS.
L'esempio seguente controlla il valore max_staleness corrente della tabella
mytable:
SELECT
  option_name,
  option_value
FROM
  DATASET_NAME.INFORMATION_SCHEMA.TABLE_OPTIONS
WHERE
  option_name = 'max_staleness'
  AND table_name = 'TABLE_NAME';
Sostituisci quanto segue:
DATASET_NAME: il nome del set di dati in cui si trova la tabella.TABLE_NAME: il nome della tabella.
I risultati mostrano che il valore max_staleness è di 10 minuti:
+---------------------+--------------+
| Row |  option_name  | option_value |
+---------------------+--------------+
|  1  | max_staleness | 0-0 0 0:10:0 |
+---------------------+--------------+
Monitora l'avanzamento dell'operazione di upsert della tabella
Per monitorare lo stato di una tabella e verificare quando sono state applicate le ultime modifiche alle righe, esegui una query sulla vista INFORMATION_SCHEMA.TABLES per ottenere il timestamp upsert_stream_apply_watermark.
L'esempio seguente controlla il valore upsert_stream_apply_watermark della tabella mytable:
SELECT upsert_stream_apply_watermark
FROM DATASET_NAME.INFORMATION_SCHEMA.TABLES
WHERE table_name = 'TABLE_NAME';
Sostituisci quanto segue:
DATASET_NAME: il nome del set di dati in cui si trova la tabella.TABLE_NAME: il nome della tabella.
Il risultato è simile al seguente:
[{
 "upsert_stream_apply_watermark": "2022-09-15T04:17:19.909Z"
}]
Le operazioni di upsert vengono eseguite dal account di servizio bigquery-adminbot@system.gserviceaccount.com e vengono visualizzate nella cronologia dei job del progetto contenente la tabella con CDC attivo.
Gestisci l'ordinamento personalizzato
Quando si esegue lo streaming degli upsert in BigQuery, il comportamento predefinito per l'ordinamento dei record con chiavi primarie identiche è determinato dall'ora di sistema di BigQuery in cui il record è stato importato in BigQuery. In altre parole, il record importato più di recente con il timestamp più recente ha la precedenza sul record importato in precedenza con un timestamp meno recente. Per alcuni casi d'uso, ad esempio quelli in cui possono verificarsi upsert molto frequenti sulla stessa chiave primaria in un intervallo di tempo molto breve o in cui l'ordine di upsert non è garantito, questo potrebbe non essere sufficiente. Per questi scenari, potrebbe essere necessaria una chiave di ordinamento fornita dall'utente.
Per configurare le chiavi di ordinamento fornite dall'utente, viene utilizzata la pseudocolonna _CHANGE_SEQUENCE_NUMBER per indicare l'ordine in cui BigQuery deve applicare i record, in base al valore _CHANGE_SEQUENCE_NUMBER più grande tra due record corrispondenti con la stessa chiave primaria. La pseudocolonna _CHANGE_SEQUENCE_NUMBER è una colonna facoltativa e accetta solo valori nel formato fisso STRING.
Formato _CHANGE_SEQUENCE_NUMBER
La pseudocolonna _CHANGE_SEQUENCE_NUMBER accetta solo valori STRING, scritti in un formato fisso. Questo formato fisso utilizza valori STRING scritti in formato esadecimale, separati in sezioni da una barra /. Ogni sezione può essere espressa con un massimo di 16 caratteri esadecimali e sono consentite fino a quattro sezioni per _CHANGE_SEQUENCE_NUMBER. L'intervallo consentito di _CHANGE_SEQUENCE_NUMBER supporta valori compresi tra 0/0/0/0 e FFFFFFFFFFFFFFFF/FFFFFFFFFFFFFFFF/FFFFFFFFFFFFFFFF/FFFFFFFFFFFFFFFF.
I valori _CHANGE_SEQUENCE_NUMBER supportano sia i caratteri maiuscoli che quelli minuscoli.
L'espressione delle chiavi di ordinamento di base può essere eseguita utilizzando una singola sezione. Ad
esempio, per ordinare le chiavi esclusivamente in base al timestamp di elaborazione di un record da un
server applicazioni, puoi utilizzare una sezione: '2024-04-30 11:19:44 UTC',
espressa in formato esadecimale convertendo il timestamp in millisecondi da
Epoch, '18F2EBB6480' in questo caso. La logica per convertire i dati in formato esadecimale è responsabilità del client che esegue la scrittura in BigQuery utilizzando l'API Storage Write (gRPC).
Il supporto di più sezioni consente di combinare più valori della logica di elaborazione in un'unica chiave per casi d'uso più complessi. Ad esempio, per ordinare le chiavi in base al timestamp di elaborazione di un record da un server applicazioni, a un numero di sequenza del log e allo stato del record, puoi utilizzare tre sezioni: '2024-04-30 11:19:44 UTC' / '123' / 'complete', ciascuna espressa in formato esadecimale.
L'ordine delle sezioni è un aspetto importante per il ranking della logica di elaborazione. BigQuery confronta i valori _CHANGE_SEQUENCE_NUMBER confrontando la prima sezione, quindi confrontando la sezione successiva solo se le sezioni precedenti erano uguali.
BigQuery utilizza _CHANGE_SEQUENCE_NUMBER per eseguire l'ordinamento
confrontando due o più campi _CHANGE_SEQUENCE_NUMBER come valori numerici
non firmati.
Considera i seguenti esempi di confronto di _CHANGE_SEQUENCE_NUMBER e i relativi risultati di precedenza:
Esempio 1:
- Record n. 1:
_CHANGE_SEQUENCE_NUMBER= "77" - Record n. 2:
_CHANGE_SEQUENCE_NUMBER= "7B"
Risultato: il record n. 2 è considerato il record più recente perché "7B" > "77" (ovvero "123" > "119")
- Record n. 1:
Esempio 2:
- Record n. 1:
_CHANGE_SEQUENCE_NUMBER= "FFF/B" - Record n. 2:
_CHANGE_SEQUENCE_NUMBER= "FFF/ABC"
Risultato: il record n. 2 è considerato il record più recente perché "FFF/ABC" > "FFF/B" (ovvero "4095/2748" > "4095/11")
- Record n. 1:
Esempio 3:
- Record n. 1:
_CHANGE_SEQUENCE_NUMBER= "BA/FFFFFFFF" - Record n. 2:
_CHANGE_SEQUENCE_NUMBER= "ABC"
Risultato: il record n. 2 è considerato il record più recente perché "ABC" > "BA/FFFFFFFF" (ovvero "2748" > "186/4294967295")
- Record n. 1:
Esempio 4:
- Record n. 1:
_CHANGE_SEQUENCE_NUMBER= "FFF/ABC" - Record n. 2:
_CHANGE_SEQUENCE_NUMBER= "ABC"
Risultato: il record n. 1 è considerato il record più recente perché "FFF/ABC" > "ABC" (ovvero "4095/2748" > "2748")
- Record n. 1:
Se due valori _CHANGE_SEQUENCE_NUMBER sono identici, il record con l'ora di importazione del sistema BigQuery più recente ha la precedenza sui record importati in precedenza.
Quando per una tabella viene utilizzato l'ordinamento personalizzato, deve essere sempre fornito il valore _CHANGE_SEQUENCE_NUMBER. Qualsiasi richiesta di scrittura che non specifica il valore _CHANGE_SEQUENCE_NUMBER, che porta a un mix di righe con e senza valori _CHANGE_SEQUENCE_NUMBER, genera un ordine imprevedibile.
Configura una prenotazione BigQuery da utilizzare con l'importazione CDC
Puoi utilizzare le prenotazioni BigQuery per allocare risorse di calcolo BigQuery dedicate per le operazioni di modifica delle righe CDC. Le prenotazioni ti consentono di impostare un limite per il costo dell'esecuzione di queste operazioni. Questo approccio è particolarmente utile per i workflow con operazioni CDC frequenti su tabelle di grandi dimensioni, che altrimenti avrebbero costi on demand elevati a causa dell'elevato numero di byte elaborati durante l'esecuzione di ogni operazione.
I job di importazione CDC di BigQuery che applicano le modifiche alle righe in attesa
all'interno dell'intervallo max_staleness sono considerati job in background e utilizzano il
tipo di assegnazione BACKGROUND o BACKGROUND_CHANGE_DATA_CAPTURE,
anziché il tipo di assegnazione QUERY.
Al contrario, le query al di fuori dell'intervallo max_staleness che richiedono l'applicazione di modifiche alle righe in fase di esecuzione della query utilizzano il tipo di assegnazione QUERY. Anche le tabelle senza un'impostazione max_staleness o con max_staleness impostato su 0 utilizzano il tipo di assegnazione QUERY.
I job in background di importazione CDC di BigQuery eseguiti senza un'assegnazione BACKGROUND o BACKGROUND_CHANGE_DATA_CAPTURE utilizzano i prezzi on demand.
Questa considerazione è importante quando progetti la strategia di gestione del workload per l'importazione CDC di BigQuery.
Per configurare una prenotazione BigQuery da utilizzare con CDC, inizia configurando una prenotazione nella regione in cui si trovano le tabelle BigQuery. Per indicazioni sulle dimensioni della prenotazione, consulta
Dimensiona e monitora le prenotazioni BACKGROUND.
Dopo aver creato una prenotazione,
assegna il progetto BigQuery
alla prenotazione e imposta l'opzione job_type su BACKGROUND
eseguendo la seguente
istruzione CREATE ASSIGNMENT:
CREATE ASSIGNMENT
  `ADMIN_PROJECT_ID.region-REGION.RESERVATION_NAME.ASSIGNMENT_ID`
OPTIONS (
  assignee = 'projects/PROJECT_ID',
  job_type = 'BACKGROUND');
Sostituisci quanto segue:
ADMIN_PROJECT_ID: l'ID del progetto di amministrazione proprietario della prenotazione.REGION: il nome della regione in cui si trova il progetto. Ad esempio,us.RESERVATION_NAME: il nome della prenotazione.ASSIGNMENT_ID: l'ID dell'assegnazione. L'ID deve essere univoco per il progetto e la località, iniziare e terminare con una lettera minuscola o un numero e contenere solo lettere minuscole, numeri e trattini.PROJECT_ID: l'ID del progetto contenente le tabelle BigQuery che vengono modificate dall'importazione CDC di BigQuery. Questo progetto è assegnato alla prenotazione.
Dimensiona e monitora le prenotazioni BACKGROUND
Le prenotazioni determinano la quantità di risorse di computing disponibili per eseguire le operazioni di computing di BigQuery. Il sottodimensionamento di una prenotazione può aumentare il tempo di elaborazione delle operazioni di modifica delle righe CDC. Per dimensionare una prenotazione in modo accurato, monitora il consumo storico degli slot per il progetto che esegue le operazioni CDC eseguendo una query sulla vista INFORMATION_SCHEMA.JOBS_TIMELINE:
SELECT
  period_start,
  SUM(period_slot_ms) / (1000 * 60) AS slots_used
FROM
  region-REGION.INFORMATION_SCHEMA.JOBS_TIMELINE_BY_PROJECT
WHERE
  DATE(job_creation_time) BETWEEN DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY)
  AND CURRENT_DATE()
  AND job_id LIKE '%cdc_background%'
GROUP BY
  period_start
ORDER BY
  period_start DESC;
Sostituisci REGION con il
nome della regione in cui si trova il progetto. Ad
esempio, us.
Considerazioni sui dati eliminati
- Le operazioni di importazione CDC di BigQuery utilizzano le risorse di calcolo di BigQuery. Se le operazioni CDC sono configurate per l'utilizzo della fatturazione on demand, le operazioni CDC vengono eseguite regolarmente utilizzando risorse BigQuery interne. Se le operazioni CDC sono configurate con una prenotazione
BACKGROUNDoBACKGROUND_CHANGE_DATA_CAPTURE, sono invece soggette alla disponibilità delle risorse della prenotazione configurata. Se non sono disponibili risorse sufficienti all'interno della prenotazione configurata, l'elaborazione delle operazioni CDC, inclusa l'eliminazione, potrebbe richiedere più tempo del previsto. - Un'operazione CDC
DELETEviene considerata applicata solo quando il timestampupsert_stream_apply_watermarkha superato il timestamp in cui l'API Storage Write (gRPC) ha eseguito lo streaming dell'operazione. Per saperne di più sul timestampupsert_stream_apply_watermark, consulta Monitora l'avanzamento dell'operazione di upsert della tabella. - Per applicare le operazioni CDC
DELETEche arrivano fuori ordine, BigQuery mantiene una finestra di conservazione delle eliminazioni di due giorni. Le operazioni della tabellaDELETEvengono archiviate per questo periodo prima dell'inizio della procedura standard di eliminazione dei dati diGoogle Cloud . Le operazioniDELETEall'interno della finestra di conservazione per l'eliminazione utilizzano i prezzi di archiviazione standard di BigQuery.
Limitazioni
- L'importazione CDC di BigQuery non esegue l'applicazione delle chiavi, quindi è essenziale che le chiavi primarie siano univoche.
- Le chiavi primarie non possono superare le 16 colonne.
- Le tabelle con CDC attiva non possono avere più di 2000 colonne di primo livello definite dallo schema della tabella.
- Le tabelle con CDC attiva non supportano quanto segue:
- Istruzioni DML (Data Manipulation Language) di mutazione come
DELETE,UPDATEeMERGE - Esecuzione di query su tabelle con funzione carattere jolly
- Indici della Ricerca
- Istruzioni DML (Data Manipulation Language) di mutazione come
- Le tabelle con CDC attivo che eseguono job di unione di runtime perché il valore
max_stalenessdella tabella è troppo basso non possono supportare quanto segue: - Le operazioni di esportazione di BigQuery sulle tabelle con CDC attivo non esportano le modifiche alle righe trasmesse in streaming di recente che non sono ancora state applicate da un job in background. Per esportare l'intera tabella, utilizza un'istruzione
EXPORT DATA. - Se la query attiva un'unione di runtime su una tabella partizionata, la potatura delle partizioni viene ignorata e viene eseguita la scansione dell'intera tabella, indipendentemente dal fatto che la query sia limitata o meno a un sottoinsieme delle partizioni. Per consentire la riduzione delle partizioni per le query che possono tollerare una leggera inattività dei dati, configura l'opzione
max_stalenessdella tabella. - Se utilizzi l'edizione Standard, le prenotazioni
BACKGROUNDnon sono disponibili, pertanto l'applicazione delle modifiche alle righe in attesa utilizza il modello di prezzi on demand. Tuttavia, puoi eseguire query sulle tabelle con CDC attivo indipendentemente dalla versione. - Le pseudocolonne
_CHANGE_TYPEe_CHANGE_SEQUENCE_NUMBERnon sono colonne su cui è possibile eseguire query durante la lettura di una tabella. - La combinazione di righe con valori
UPSERToDELETEper_CHANGE_TYPEcon righe con valoriINSERTo non specificati per_CHANGE_TYPEnella stessa connessione non è supportata e genera il seguente errore di convalida:The given value is not a valid CHANGE_TYPE.
Prezzi per l'importazione CDC di BigQuery
L'importazione CDC di BigQuery utilizza l'API Storage Write (gRPC) per l'importazione dati, lo spazio di archiviazione di BigQuery per l'archiviazione dei dati e il computing di BigQuery per le operazioni di modifica delle righe, tutte operazioni che comportano costi. Per informazioni sui prezzi, consulta Prezzi di BigQuery.
Stima i costi di importazione CDC di BigQuery
Oltre alle best practice generali per la stima dei costi di BigQuery, la stima dei costi di importazione CDC di BigQuery potrebbe essere importante per i workflow con grandi quantità di dati, una configurazione max_staleness bassa o dati che cambiano di frequente.
I prezzi di importazione dati di BigQuery e i prezzi di archiviazione di BigQuery vengono calcolati direttamente in base alla quantità di dati che importi e archivi, incluse le pseudocolonne. Tuttavia, i prezzi di calcolo di BigQuery possono essere più difficili da stimare, in quanto si riferiscono al consumo di risorse di calcolo utilizzate per eseguire i job di importazione CDC di BigQuery.
I job di importazione CDC di BigQuery sono suddivisi in tre categorie:
- Job di applicazione in background: job eseguiti in background a intervalli regolari definiti dal valore
max_stalenessdella tabella. Questi job applicano le modifiche alle righe trasmesse in streaming di recente alle tabelle con CDC attiva. - Job di query: query GoogleSQL eseguite all'interno della finestra
max_stalenesse che leggono solo dalla base di riferimento di una tabella con CDC attivo. - Job di unione di runtime: job attivati da query GoogleSQL ad hoc eseguite al di fuori della finestra
max_staleness. Questi job devono eseguire un'unione immediata della base di riferimento di una tabella con CDC attivo e delle modifiche alle righe trasmesse di recente in modalità flusso al runtime della query. Questo tipo di job non fa avanzare il timestampupsert_stream_apply_watermark.
Solo i job di query sfruttano il partizionamento di BigQuery. I job di applicazione in background e i job di unione di runtime non possono utilizzare il partizionamento perché, quando si applicano le modifiche alle righe trasmesse in streaming di recente, non è garantito a quale partizione della tabella vengono applicati gli upsert trasmessi in streaming di recente. In altre parole, l'intera tabella di base viene letta durante i job di applicazione in background e i job di unione in fase di runtime. Per lo stesso motivo, solo i job di query possono trarre vantaggio dai filtri sulle colonne di clustering di BigQuery. Comprendere la quantità di dati letti per eseguire le operazioni CDC è utile per stimare il costo totale.
Se la quantità di dati letti dalla base di riferimento della tabella è elevata, valuta la possibilità di utilizzare il modello di prezzi di capacità di BigQuery, che non si basa sulla quantità di dati elaborati.
Best practice per i costi di importazione CDC di BigQuery
Oltre alle best practice generali per i costi di BigQuery, utilizza le seguenti tecniche per ottimizzare i costi delle operazioni di importazione CDC di BigQuery:
- A meno che non sia necessario, evita di configurare l'opzione
max_stalenessdi una tabella con un valore molto basso. Il valoremax_stalenesspuò aumentare l'occorrenza di job di applicazione in background e di unione in fase di runtime, che sono più costosi e lenti dei job di query. Per indicazioni dettagliate, consulta Valoremax_stalenessdella tabella consigliata. - Valuta la possibilità di configurare una prenotazione BigQuery da utilizzare con le tabelle CDC.
In caso contrario, i job di applicazione in background e i job di unione in fase di runtime utilizzano i prezzi on demand, che possono essere più costosi a causa di un maggiore trattamento dati. Per maggiori dettagli, scopri di più sulle prenotazioni BigQuery e segui le indicazioni su come dimensionare e monitorare una prenotazione
BACKGROUNDda utilizzare con l'importazione CDC di BigQuery.
Passaggi successivi
- Scopri come implementare lo stream predefinito dell'API Storage Write (gRPC).
- Scopri le best practice per l'API Storage Write (gRPC).
- Scopri come utilizzare Datastream per replicare i database transazionali in BigQuery con l'importazione CDC di BigQuery.