


סריקה לאיתור בעיות באיכות הנתונים
התכונה "בדיקת איכות אוטומטית של נתונים" ב-Knowledge Catalog מאפשרת לכם להגדיר ולמדוד את איכות הנתונים בטבלאות ב-BigQuery. אתם יכולים להגדיר סריקות נתונים אוטומטיות, לאמת נתונים לפי כללים מוגדרים ולתעד התראות אם הנתונים לא עומדים בדרישות האיכות.
אתם יכולים לנהל את סריקות איכות הנתונים בכל הפרויקט, או לנהל את סריקות איכות הנתונים בטבלה ספציפית. מידע נוסף על איכות נתונים אוטומטית זמין בסקירה הכללית על איכות נתונים אוטומטית.
לפני שמתחילים
-
מפעילים את Dataplex API, אם הוא עדיין לא מופעל.
התפקידים שנדרשים כדי להפעיל ממשקי API
כדי להפעיל ממשקי API, צריך את ההרשאה
serviceusage.services.enable. אם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד "בעלים" (roles/owner). אחרת, תוכלו לקבל את ההרשאה הזו דרך התפקיד "אדמין בממשק 'שימוש בשירות'" (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידים - אופציונלי: אם רוצים ש-Knowledge Catalog ייצור המלצות לכללים של איכות הנתונים על סמך התוצאות של סריקת פרופיל הנתונים, יוצרים ומריצים את סריקת פרופיל הנתונים.
התפקידים הנדרשים
בקטע הזה מוסבר אילו תפקידים והרשאות ב-IAM נדרשים כדי להשתמש בסריקות של איכות הנתונים ב-Knowledge Catalog.
תפקידים והרשאות של משתמשים
כדי לקבל את ההרשאות שנדרשות להרצה ולניהול של סריקות איכות נתונים, בקשו מהאדמין להקצות לכם את תפקידי ה-IAM הבאים:
-
מריצים סריקה של איכות הנתונים בטבלה ב-BigQuery:
- BigQuery Job User (
roles/bigquery.jobUser) בפרויקט, כדי להריץ משימות סריקה - BigQuery Data Viewer (
roles/bigquery.dataViewer) בטבלה של BigQuery שרוצים לסרוק
- BigQuery Job User (
-
פרסום תוצאות הסריקה של איכות הנתונים ב-Knowledge Catalog:
- עריכת נתונים ב-BigQuery (
roles/bigquery.dataEditor) בטבלה שנסרקה - עריכת קטלוג Dataplex (
roles/dataplex.catalogEditor) בקבוצת הרשומות@bigqueryבאותו מיקום של הטבלה
- עריכת נתונים ב-BigQuery (
-
ביצוע משימות ספציפיות במשאבי
DataScan:- אדמין של Dataplex DataScan (
roles/dataplex.dataScanAdmin) בפרויקט, כדי לקבל גישה מלאה - Dataplex DataScan Creator (
roles/dataplex.dataScanCreator) בפרויקט כדי ליצור סריקות - עריכת Dataplex DataScan (
roles/dataplex.dataScanEditor) בפרויקט, כדי לקבל גישת כתיבה - Dataplex DataScan Viewer (
roles/dataplex.dataScanViewer) בפרויקט, כדי לקרוא את המטא-נתונים של הסריקה - Dataplex DataScan DataViewer (
roles/dataplex.dataScanDataViewer) בפרויקט כדי לקרוא את נתוני הסריקה, כולל כללים ותוצאות
- אדמין של Dataplex DataScan (
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
התפקידים המוגדרים מראש האלה כוללים את ההרשאות שנדרשות כדי להריץ ולנהל סריקות של איכות הנתונים. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי להריץ ולנהל סריקות של איכות הנתונים, צריך את ההרשאות הבאות:
-
הרצת סריקה של איכות הנתונים בטבלה ב-BigQuery:
-
bigquery.jobs.createבפרויקט כדי להריץ משימות סריקה -
bigquery.tables.getבטבלה ב-BigQuery שרוצים לסרוק -
bigquery.tables.getDataבטבלה ב-BigQuery שרוצים לסרוק
-
-
פרסום תוצאות הסריקה של איכות הנתונים ב-Knowledge Catalog:
-
bigquery.tables.updateבטבלה שנסרקה -
dataplex.entryGroups.useDataQualityScorecardAspectבקבוצת הרשומות@bigqueryבאותו מיקום של הטבלה
-
-
יצירת
DataScan:dataplex.datascans.createבפרויקט -
מחיקת
DataScan:dataplex.datascans.deleteבפרויקט -
צפייה במטא-נתונים של
DataScan: dataplex.datascans.getבפרויקט -
צפייה בפרטים של
DataScan, כולל כללים ותוצאות:dataplex.datascans.getDataבפרויקט -
DataScanבפרויקט:dataplex.datascans.list -
הרצת
DataScan:dataplex.datascans.runבפרויקט -
עדכון של
DataScan:dataplex.datascans.updateבפרויקט -
קבלת או הגדרת מדיניות IAM ב-
DataScan:-
dataplex.datascans.getIamPolicyבפרויקט -
dataplex.datascans.setIamPolicyבפרויקט
-
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
אם אתם צריכים לגשת לעמודות שמוגנות על ידי מדיניות גישה ברמת העמודה ב-BigQuery, אתם צריכים גם הרשאות לעמודות האלה.
תפקידים והרשאות של חשבון שירות ב-Knowledge Catalog
אם לא יצרתם סריקות של איכות נתונים או של סריקת פרופיל נתונים, או אם אין לכם מאגר נתונים של Knowledge Catalog בפרויקט הזה, אתם יכולים ליצור מזהה שירות באמצעות הפקודה הבאה: gcloud beta services identity create --service=dataplex.googleapis.com.
הפקודה הזו מחזירה מזהה שירות של Knowledge Catalog, אם הוא קיים.
כדי לוודא שלחשבון השירות של Knowledge Catalog בפרויקט שבו מתבצעת סריקת איכות הנתונים יש את ההרשאות שנדרשות לקריאת נתונים ממקורות שונים ולייצוא התוצאות, צריך לבקש מהאדמין להקצות לחשבון השירות של Knowledge Catalog בפרויקט שבו מתבצעת סריקת איכות הנתונים את תפקידי ה-IAM הבאים:
-
קריאת נתונים מטבלאות ב-BigQuery:
BigQuery Data Viewer (
roles/bigquery.dataViewer) בטבלאות שצריך לסרוק ובכל טבלה אחרת שמוזכרת בכללים -
קריאת נתוני טבלאות של Google Cloud Lakehouse ב-Iceberg REST Catalog, ב-SAP Business Data Cloud Delta Lake וב-Apache Hive:
BigLake Viewer (
roles/biglake.viewer) בטבלאות הרלוונטיות לסריקה ובכל טבלה אחרת שמצוינת בכללים -
ייצוא תוצאות הסריקה לטבלה ב-BigQuery:
עריכת נתונים ב-BigQuery (
roles/bigquery.dataEditor) במערך הנתונים ובטבלה של התוצאות -
סריקת נתונים ב-BigQuery שמאורגנים ב-Knowledge Catalog Lake:
- Dataplex Metadata Reader (
roles/dataplex.metadataReader) במשאבי Dataplex - Dataplex Viewer (
roles/dataplex.viewer) במשאבי Dataplex
- Dataplex Metadata Reader (
-
סריקת טבלה חיצונית של BigQuery מ-Cloud Storage:
צפייה באובייקטים באחסון (
roles/storage.objectViewer) בקטגוריה של Cloud Storage
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
אלה תפקידים מוגדרים מראש שכוללים את ההרשאות שנדרשות כדי לקרוא נתונים ממקורות שונים ולייצא תוצאות. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי לקרוא נתונים ממקורות שונים ולייצא תוצאות, נדרשות ההרשאות הבאות:
-
קריאת נתונים מטבלה ב-BigQuery:
-
bigquery.tables.getבטבלאות ב-BigQuery -
bigquery.tables.getDataבטבלאות ב-BigQuery
-
-
ייצוא של תוצאות הסריקה לטבלה ב-BigQuery:
-
bigquery.datasets.getבמערך הנתונים ובטבלה של התוצאות -
bigquery.tables.createבמערך הנתונים ובטבלה של התוצאות -
bigquery.tables.getבמערך הנתונים ובטבלה של התוצאות -
bigquery.tables.getDataבמערך הנתונים ובטבלה של התוצאות -
bigquery.tables.updateבמערך הנתונים ובטבלה של התוצאות -
bigquery.tables.updateDataבמערך הנתונים ובטבלה של התוצאות
-
-
סריקת נתונים ב-BigQuery שמאורגנים ב-Knowledge Catalog Lake:
-
dataplex.lakes.listבמשאבי Dataplex -
dataplex.lakes.getבמשאבי Dataplex -
dataplex.zones.listבמשאבי Dataplex -
dataplex.zones.getבמשאבי Dataplex -
dataplex.entities.listבמשאבי Dataplex -
dataplex.entities.getבמשאבי Dataplex -
dataplex.operations.getבמשאבי Dataplex
-
-
סריקת טבלה חיצונית של BigQuery מ-Cloud Storage:
-
storage.buckets.getבקטגוריה של Cloud Storage -
storage.objects.getבקטגוריה של Cloud Storage
-
יכול להיות שהאדמין יוכל גם לתת לחשבון השירות של Knowledge Catalog בפרויקט שמכיל את סריקת איכות הנתונים את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
אם אתם צריכים לגשת לעמודות שמוגנות על ידי מדיניות גישה ברמת העמודה ב-BigQuery, הקצו לחשבון השירות של Knowledge Catalog הרשאות לעמודות האלה.
אם בטבלה מופעלות מדיניות גישה ברמת השורה ב-BigQuery, אפשר לסרוק רק שורות שגלויות לחשבון השירות של Knowledge Catalog. חשוב לזכור שהרשאות הגישה של המשתמש הספציפי לא נבדקות במדיניות ברמת השורה.
יצירת סריקה של איכות הנתונים
המסוף
במסוף Google Cloud , בדף Metadata curation של BigQuery, נכנסים לכרטיסייה Data profiling & quality.
לוחצים על יצירת סריקת איכות נתונים.
בחלון Define scan, ממלאים את השדות הבאים:
אופציונלי: מזינים שם לתצוגה.
מזינים מזהה. מוסכמות למתן שמות למשאבים
אופציונלי: מזינים תיאור.
בשדה Table, לוחצים על Browse. בוחרים את הטבלה שרוצים לסרוק ולוחצים על Select. יש תמיכה רק בטבלאות של BigQuery, Iceberg REST Catalog, SAP BDC Delta ו-Hive ב- Google CloudLakehouse.
בטבלאות של מערכי נתונים במספר אזורים, בוחרים את האזור שבו רוצים ליצור את סריקת הנתונים.
כדי לעיין בטבלאות שמאורגנות ב-Knowledge Catalog, לוחצים על Browse within Knowledge Catalog Lakes.
בשדה היקף, בוחרים באפשרות מצטבר או כל הנתונים.
- אם בוחרים באפשרות מצטבר: בשדה עמודת חותמת זמן, בוחרים עמודה מסוג
DATEאוTIMESTAMPמהטבלה ב-BigQuery שגדלה ככל שנוספות רשומות חדשות, ושאפשר להשתמש בה כדי לזהות רשומות חדשות. זו יכולה להיות עמודה שמחלקת את הטבלה למחיצות.
- אם בוחרים באפשרות מצטבר: בשדה עמודת חותמת זמן, בוחרים עמודה מסוג
אופציונלי: כדי לסנן את הנתונים, מסמנים את התיבה סינון שורות. מציינים מסנן שורות שמורכב מביטוי SQL תקין, שאפשר להשתמש בו כחלק מסעיף
WHEREבתחביר של GoogleSQL. לדוגמה,col1 >= 0. המסנן יכול להיות שילוב של כמה תנאים בעמודות. לדוגמה,col1 >= 0 AND col2 < 10.כדי לדגום את הנתונים, בוחרים אחוז דגימה ברשימה Sampling size. בוחרים ערך באחוזים בטווח שבין 0.0% ל-100.0% עם עד 3 ספרות אחרי הנקודה העשרונית. בקבוצות נתונים גדולות יותר, כדאי לבחור אחוז דגימה נמוך יותר. לדוגמה, בטבלה של 1 PB, אם תזינו ערך בין 0.1% ל-1.0%, סריקת איכות הנתונים תדגום בין 1 ל-10 TB של נתונים. בסריקות של נתונים מצטברים, סריקת איכות הנתונים מחילה דגימה על הנתונים המצטברים האחרונים.
אופציונלי: כדי לפרסם את תוצאות הסריקה של איכות הנתונים כמטא-נתונים של Knowledge Catalog, מסמנים את התיבה Publish results to Knowledge Catalog.
אפשר לראות את תוצאות הסריקה האחרונה בכרטיסייה איכות הנתונים בדפים BigQuery ו-Knowledge Catalog של טבלת המקור. כדי לאפשר למשתמשים לגשת לתוצאות הסריקה שפורסמו, עיינו בקטע מתן גישה לתוצאות של סריקת איכות הנתונים במסמך הזה.
בקטע Credential type, קראו את המאמר הגדרת זהות ההפעלה.
כדי ליצור סריקה של איכות הנתונים באמצעות כללים, בוחרים באפשרות Rule type > Create with entry based rule.
בקטע תזמון, בוחרים אחת מהאפשרויות הבאות:
Repeat: הפעלת הסריקה של איכות הנתונים לפי לוח זמנים: מדי שעה, מדי יום, מדי שבוע, מדי חודש או בהתאמה אישית. מציינים את התדירות והשעה של הסריקה. אם בוחרים באפשרות Custom, צריך לציין את לוח הזמנים בפורמט cron.
לפי דרישה: הפעלת סריקת איכות הנתונים לפי דרישה.
הפעלה חד-פעמית: הפעלה של סריקת איכות הנתונים פעם אחת עכשיו, והסרה של הסריקה אחרי זמן המחיקה האוטומטית. התכונה הזו נמצאת בגרסת טרום-השקה (Preview).
- הגדרת מחיקה אוטומטית של תוצאות אחרי סריקה: משך הזמן בין ביצוע הסריקה לבין המחיקה שלה. סריקה של איכות הנתונים שלא צוין בה זמן מחיקה אוטומטית נמחקת באופן אוטומטי 24 שעות אחרי ההפעלה שלה. הזמן למחיקה אוטומטית יכול להיות בין 0 שניות (מחיקה מיידית) ל-365 ימים.
לוחצים על Continue.
בחלון Data quality rules, מגדירים את הכללים לסריקה הזו של איכות הנתונים.
לוחצים על הוספת כללים ובוחרים מבין האפשרויות הבאות.
המלצות שמבוססות על פרופיל: יצירת כללים מההמלצות שמבוססות על סריקה קיימת של פרופיל נתונים.
בחירת עמודות: בוחרים את העמודות שרוצים לקבל עבורן המלצות לכללים.
Choose scan project: אם סריקת פרופיל הנתונים נמצאת בפרויקט אחר מהפרויקט שבו אתם יוצרים את סריקת איכות הנתונים, בוחרים את הפרויקט שממנו רוצים לשלוף את סריקות הפרופיל.
בחירת תוצאות של פרופילים: בוחרים תוצאה אחת או יותר של פרופילים ולוחצים על אישור. תופיע רשימה של כללים מוצעים שאפשר להשתמש בהם כנקודת התחלה.
מסמנים את התיבה לצד הכללים שרוצים להוסיף ולוחצים על בחירה. אחרי שבוחרים את הכללים, הם מתווספים לרשימת הכללים הנוכחית. לאחר מכן, אפשר לערוך את הכללים.
סוגי כללים מובְנים: יצירת כללים מכללים מוגדרים מראש. רשימת הכללים המוגדרים מראש
בחירת עמודות: בוחרים את העמודות שרוצים לבחור להן כללים.
בחירת סוגי כללים: בוחרים את סוגי הכללים שרוצים לבחור מהם ולוחצים על אישור. סוגי הכללים שמופיעים תלויים בעמודות שבחרתם.
מסמנים את התיבה לצד הכללים שרוצים להוסיף ולוחצים על בחירה. אחרי שבוחרים את הכללים, הם מתווספים לרשימת הכללים הנוכחית. לאחר מכן, אפשר לערוך את הכללים.
כלל לבדיקת שורות ב-SQL: יוצרים כלל SQL בהתאמה אישית ומחילים אותו על כל שורה.
בקטע מאפיין, בוחרים מאפיין אחד.
בקטע Passing threshold, בוחרים את אחוז הרשומות שצריכות לעבור את הבדיקה.
בשם העמודה, בוחרים עמודה.
בשדה Provide a SQL expression, מזינים ביטוי SQL שמחזיר ערך בוליאני של
true(עבר) אוfalse(נכשל). למידע נוסף, קראו על סוגי כללי SQL נתמכים בהתאמה אישית ועיינו בדוגמאות שבמאמר הגדרת כללים לאיכות הנתונים.לוחצים על הוספה.
כלל בדיקה של צבירת SQL: יצירת כלל מותאם אישית לתנאי טבלה ב-SQL.
בקטע מאפיין, בוחרים מאפיין אחד.
בשם העמודה, בוחרים עמודה.
בשדה Provide a SQL expression, מזינים ביטוי SQL שמחזיר ערך בוליאני של
true(עבר) אוfalse(נכשל). למידע נוסף, קראו על סוגי כללי SQL נתמכים בהתאמה אישית ועיינו בדוגמאות שבמאמר הגדרת כללים לאיכות הנתונים.לוחצים על הוספה.
כלל טענת נכוֹנוּת (assertion) ב-SQL: יוצרים כלל טענת נכוֹנוּת מותאם אישית ב-SQL כדי לבדוק אם יש מצב לא תקין של הנתונים.
בקטע מאפיין, בוחרים מאפיין אחד.
אופציונלי: בשדה שם העמודה, בוחרים עמודה.
בשדה Provide a SQL statement, מזינים הצהרת SQL שמחזירה שורות שתואמות למצב הלא תקין. אם מוחזרות שורות, הכלל הזה נכשל. אל תכללו את הנקודה-פסיק בסוף הצהרת ה-SQL. למידע נוסף, קראו על סוגי כללי SQL נתמכים בהתאמה אישית ועיינו בדוגמאות שבמאמר הגדרת כללים לאיכות הנתונים.
לוחצים על הוספה.
אופציונלי: לכל כלל של איכות נתונים, אתם יכולים להקצות שם כלל בהתאמה אישית לשימוש במעקב ובהתראות, ותיאור. כדי לעשות את זה, עורכים את הכלל ומציינים את הפרטים הבאים:
- שם הכלל: מזינים שם לכלל בהתאמה אישית, באורך של עד 63 תווים. שם הכלל יכול לכלול אותיות (a-z, A-Z), ספרות (0-9) ומקפים (-). הוא חייב להתחיל באות ולהסתיים בספרה או באות.
- תיאור: מזינים תיאור של הכלל באורך של עד 1,024 תווים.
חוזרים על השלבים הקודמים כדי להוסיף עוד כללים לסריקה של איכות הנתונים. כשמסיימים, לוחצים על המשך.
אופציונלי: ייצוא של תוצאות הסריקה לטבלה רגילה ב-BigQuery. בקטע Export scan results to BigQuery table, מבצעים את הפעולות הבאות:
בשדה Select BigQuery dataset, לוחצים על Browse. בוחרים מערך נתונים ב-BigQuery שבו יישמרו תוצאות הסריקה של איכות הנתונים.
בשדה BigQuery table, מציינים את הטבלה ב-BigQuery שבה רוצים לשמור את תוצאות הסריקה של איכות הנתונים. אם אתם משתמשים בטבלה קיימת, ודאו שהיא תואמת לסכימת טבלת הייצוא. אם הטבלה שציינתם לא קיימת, היא תיווצר על ידי Knowledge Catalog.
אופציונלי: מוסיפים תוויות. תוויות הן צמדי מפתח/ערך שמאפשרים לקשר בין אובייקטים או ביניהם לבין משאבים אחרים של Google Cloud .
אופציונלי: מגדירים דוחות של התראות באימייל כדי לעדכן אנשים לגבי הסטטוס והתוצאות של משימת סריקה של איכות הנתונים. בקטע Notification report, לוחצים על Add email ID ומזינים עד חמש כתובות אימייל. אחר כך בוחרים את התרחישים שרוצים לשלוח עליהם דוחות:
- ציון איכות (<=): שליחת דוח כשהמשימה מסתיימת בהצלחה עם ציון איכות נתונים נמוך יותר מציון היעד שצוין. מזינים ציון איכות בין 0 ל-100.
- כשלים במשימות: שליחת דוח כשהמשימה עצמה נכשלת, בלי קשר לתוצאות של איכות הנתונים.
- השלמת המשימה (הצלחה או כישלון): שליחת דוח כשהמשימה מסתיימת, בלי קשר לתוצאות של איכות הנתונים.
לוחצים על יצירה.
אחרי שיוצרים את הסריקה, אפשר להריץ אותה בכל שלב בלחיצה על Run now.
gcloud
כדי ליצור סריקה של איכות הנתונים, משתמשים בפקודה gcloud dataplex datascans create data-quality.
אם נתוני המקור מאורגנים ב-Knowledge Catalog lake, צריך לכלול את הדגל --data-source-entity:
gcloud dataplex datascans create data-quality DATASCAN \
    --location=LOCATION \
    --data-quality-spec-file=DATA_QUALITY_SPEC_FILE \
    --data-source-entity=DATA_SOURCE_ENTITY
אם נתוני המקור לא מאורגנים ב-Knowledge Catalog lake, צריך לכלול את הדגל --data-source-resource:
gcloud dataplex datascans create data-quality DATASCAN \
    --location=LOCATION \
    --data-quality-spec-file=DATA_QUALITY_SPEC_FILE \
    --data-source-resource=DATA_SOURCE_RESOURCE
מחליפים את המשתנים הבאים:
-
DATASCAN: השם של סריקת איכות הנתונים. -
LOCATION: האזור ב- Google Cloud שבו רוצים ליצור את סריקת איכות הנתונים. -
DATA_QUALITY_SPEC_FILE: הנתיב לקובץ ה-JSON או ה-YAML שמכיל את המפרט של סריקת איכות הנתונים. הקובץ יכול להיות קובץ מקומי או נתיב של Cloud Storage עם הקידומתgs://. משתמשים בקובץ הזה כדי לציין את הכללים של איכות הנתונים לסריקה. אתם יכולים גם לציין פרטים נוספים בקובץ הזה, כמו מסננים, אחוז דגימה ופעולות לאחר הסריקה, כמו ייצוא ל-BigQuery או שליחת דוחות של התראות באימייל. אפשר לעיין במסמכי התיעוד של ייצוג JSON ובדוגמה לייצוג YAML. -
DATA_SOURCE_ENTITY: הישות ב-Knowledge Catalog שמכילה את הנתונים לסריקת איכות הנתונים. לדוגמה,projects/test-project/locations/test-location/lakes/test-lake/zones/test-zone/entities/test-entity. -
DATA_SOURCE_RESOURCE: שם המשאב שמכיל את הנתונים לסריקת איכות הנתונים. לדוגמה,//bigquery.googleapis.com/projects/test-project/datasets/test-dataset/tables/test-table.
C#
C#
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
המשך
Go
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Java
Java
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Node.js
Node.js
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Python
Python
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Ruby
Ruby
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
REST
כדי ליצור סריקה של איכות הנתונים, משתמשים ב-method dataScans.create.
הבקשה הבאה יוצרת סריקה חד-פעמית של איכות הנתונים:
POST https://dataplex.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/dataScans?data_scan_id=DATASCAN_ID

{
"data": {
  "resource": "//bigquery.googleapis.com/projects/PROJECT_ID/datasets/DATASET_ID/tables/TABLE_ID"
},
"type": "DATA_QUALITY",
"executionSpec": {
  "trigger": {
    "oneTime": {
      "ttl_after_scan_completion": "120s"
    }
  }
},
"dataQualitySpec": {
  "rules": [
    {
      "nonNullExpectation": {},
      "column": "COLUMN_NAME",
      "dimension": "DIMENSION",
      "threshold": 1
    }
  ],
  "filter": "FILTER_CONDITION"
}
}
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: מזהה הפרויקט. -
LOCATION: האזור שבו רוצים ליצור את סריקת איכות הנתונים. -
DATASCAN_ID: המזהה של סריקת איכות הנתונים. -
DATASET_ID: המזהה של מערך הנתונים ב-BigQuery. -
TABLE_ID: המזהה של הטבלה ב-BigQuery. -
COLUMN_NAME: שם העמודה של הכלל. -
DIMENSION: המאפיין של הכלל, לדוגמהVALIDITY. -
FILTER_CONDITION: מחרוזת סינון אופציונלית של AIP-160 להרצה סלקטיבית של כללים (לדוגמה,name = \"RULE_NAME\").
אם אתם רוצים ליצור כללים לסריקת איכות הנתונים באמצעות המלצות לכללים שמבוססות על התוצאות של סריקת פרופיל הנתונים, אתם יכולים לקבל את ההמלצות על ידי קריאה ל-method dataScans.jobs.generateDataQualityRules בסריקת פרופיל הנתונים.
הפעלת סריקה של איכות הנתונים
המסוף
במסוף Google Cloud , בדף Metadata curation של BigQuery, נכנסים לכרטיסייה Data profiling & quality.
לוחצים על הסריקה של איכות הנתונים שרוצים להריץ.
לוחצים על הפעלה מיידית.
gcloud
כדי להריץ סריקה של איכות הנתונים, משתמשים בפקודה gcloud dataplex datascans run:
gcloud dataplex datascans run DATASCAN \
--location=LOCATION \
מחליפים את המשתנים הבאים:
-
LOCATION: האזור ב- Google Cloud שבו נוצרה סריקת איכות הנתונים. -
DATASCAN: השם של סריקת איכות הנתונים.
C#
C#
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
המשך
Go
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Java
Java
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Python
Python
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Ruby
Ruby
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
REST
כדי להריץ סריקה של איכות הנתונים, משתמשים ב-method dataScans.run.
Airflow
כדי להריץ סריקה של איכות הנתונים באמצעות גרף אציקלי מכוון (DAG) ב-Managed Service for Apache Airflow (Cloud Composer), משתמשים ב-DataplexRunDataQualityScanOperator:
from datetime import datetime
from airflow import DAG
from airflow.providers.google.cloud.operators.dataplex import DataplexRunDataQualityScanOperator

with DAG(
  "dataplex_auto_dq_scan",
  start_date=datetime(2026, 1, 1),
  schedule_interval="@daily",
  catchup=False,
) as dag:

  run_dq_scan = DataplexRunDataQualityScanOperator(
      task_id="run_dataplex_dq_scan",
      project_id="PROJECT_ID",
      region="REGION",
      data_scan_id="DATASCAN_ID",
  )
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: מזהה הפרויקט ב- Google Cloud . -
REGION: האזור ב- Google Cloud שבו נוצרה סריקת איכות הנתונים. -
DATASCAN_ID: המזהה של סריקת איכות הנתונים.
צפייה בתוצאות הסריקה של איכות הנתונים
המסוף
במסוף Google Cloud , בדף Metadata curation של BigQuery, נכנסים לכרטיסייה Data profiling & quality.
לוחצים על השם של סריקת איכות הנתונים.
בקטע Overview מוצג מידע על הסריקות האחרונות, כולל מתי הסריקה בוצעה, מספר הרשומות שנסרקו בכל סריקה, אם כל בדיקות איכות הנתונים עברו בהצלחה, ואם היו כשלים, מספר בדיקות איכות הנתונים שנכשלו.
בקטע הגדרות סריקת איכות הנתונים מוצגים פרטים על הסריקה.
כדי לראות מידע מפורט על משימה, כמו ציוני איכות הנתונים שמציינים את אחוז הכללים שעברו, אילו כללים נכשלו ויומני המשימות, לוחצים על הכרטיסייה היסטוריית משימות. לאחר מכן לוחצים על מזהה משימה.
gcloud
כדי לראות את התוצאות של משימת סריקה של איכות הנתונים, משתמשים בפקודה gcloud dataplex datascans jobs describe:
gcloud dataplex datascans jobs describe JOB \
--location=LOCATION \
--datascan=DATASCAN \
--view=FULL
מחליפים את המשתנים הבאים:
-
JOB: מזהה המשימה של סריקת איכות הנתונים. -
LOCATION: האזור ב- Google Cloud שבו נוצרה סריקת איכות הנתונים. -
DATASCAN: השם של סריקת איכות הנתונים שאליה שייכת המשימה. -
--view=FULL: כדי לראות את התוצאה של משימת הסריקה, מציינים אתFULL.
C#
C#
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
המשך
Go
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Java
Java
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Python
Python
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Ruby
Ruby
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
REST
כדי לראות את התוצאות של סריקת איכות הנתונים, משתמשים בשיטה dataScans.get.
הצגת התוצאות שפורסמו
אם התוצאות של סריקת איכות הנתונים מתפרסמות כמטא-נתונים של Knowledge Catalog, אתם יכולים לראות את תוצאות הסריקה האחרונות בדפים של BigQuery ו-Knowledge Catalog במסוףGoogle Cloud , בכרטיסייה Data quality של טבלת המקור.
נכנסים לדף BigQuery במסוף Google Cloud .
בחלונית השמאלית, לוחצים על Explorer:
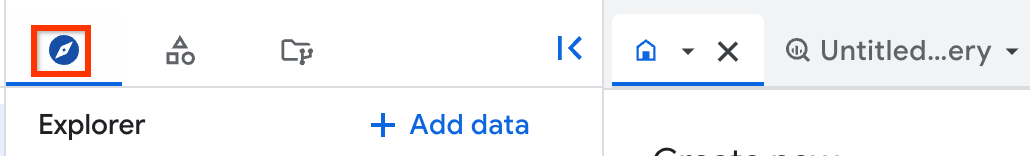
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
בחלונית Explorer, לוחצים על Datasets ואז על מערך הנתונים.
לוחצים על Overview > Tables ובוחרים את הטבלה שרוצים לראות את תוצאות סריקת איכות הנתונים שלה.
לוחצים על הכרטיסייה איכות הנתונים.
התוצאות האחרונות שפורסמו מוצגות.
צפייה בתוצאות של סריקות קודמות
ב-Knowledge Catalog נשמרת היסטוריית סריקות איכות הנתונים של 300 המשימות האחרונות או של השנה האחרונה, המוקדם מביניהם.
המסוף
במסוף Google Cloud , בדף Metadata curation של BigQuery, נכנסים לכרטיסייה Data profiling & quality.
לוחצים על השם של סריקת איכות הנתונים.
לוחצים על הכרטיסייה Jobs history.
בכרטיסייה Jobs history מוצג מידע על משימות קודמות, כמו מספר הרשומות שנסרקו בכל משימה, סטטוס המשימה, זמן הרצת המשימה והאם כל כלל עבר או נכשל.
כדי לראות מידע מפורט על משימה, לוחצים על אחת מהמשימות בעמודה Job ID.
gcloud
כדי לראות את המשימות ההיסטוריות של סריקת איכות הנתונים, משתמשים בפקודה gcloud dataplex datascans jobs list:
gcloud dataplex datascans jobs list \
--location=LOCATION \
--datascan=DATASCAN \
מחליפים את המשתנים הבאים:
-
LOCATION: האזור ב- Google Cloud שבו נוצרה סריקת איכות הנתונים. -
DATASCAN: השם של סריקת איכות הנתונים שרוצים לראות את המשימות ההיסטוריות שלה.
C#
C#
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
המשך
Go
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Java
Java
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Python
Python
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Ruby
Ruby
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
REST
כדי לראות משימות קודמות של סריקות לאיכות הנתונים, משתמשים ב-method dataScans.jobs.list.
סטטוסים של משימות
אלה הסטטוסים האפשריים של משימות סריקת נתונים:
PENDING: המשימה נוצרה אבל עדיין לא התחילה לפעול. במצב הזה, הסריקה מגדירה באופן פעיל תשתית או רוכשת משבצות. השלב הזה יכול להימשך בין 10 ל-20 שניות או יותר, בהתאם למורכבות הסכימה ולתחרות על המשאבים.
RUNNING: המשימה פועלת.
CANCELING: המשימה בתהליך ביטול.
CANCELLED: המשימה בוטלה.
SUCCEEDED: המשימה הושלמה בהצלחה. סטטוס ההשלמה עשוי להופיע באיחור של עד 60 שניות מההשלמה בפועל של השאילתה, בגלל שלבים של עיבוד לאחר השאילתה, כמו צבירה וסנכרון מטא-נתונים.
FAILED: המשימה נכשלה בגלל שגיאה. סטטוס ההשלמה עשוי להופיע באיחור של עד 60 שניות מההשלמה בפועל של השאילתה, בגלל שלבים של עיבוד לאחר השאילתה, כמו צבירה וסנכרון מטא-נתונים.
SUCCEEDED_WITH_ERRORS: המשימה הושלמה, אבל היו כמה שגיאות במהלך הביצוע.
שיטות מומלצות למעקב
כשאתם עוקבים אחרי משימות סריקת הנתונים, חשוב לזכור את השיטות המומלצות הבאות:
הימנעו מסקרים אגרסיביים: הימנעו מסקרים אגרסיביים (לדוגמה, קריאה ל-
GetJobאו לפונקציה מקבילה כל 1 עד 5 שניות). דגימה אגרסיבית מבזבזת את מכסת ה-API ולא מאיצה את מעברי המצבים.שימוש בהשהיה מעריכית לפני ניסיון חוזר (exponential backoff): אם אי אפשר להימנע מדגימה חוזרת, צריך להשתמש בהשהיה מעריכית לפני ניסיון חוזר (exponential backoff) שמתחילה ב-10 עד 15 שניות.
שימוש בהפרדה אסינכרונית מבוססת-אירועים (מומלץ): במקום דגימת API סינכרונית, משתמשים בטריגרים של Eventarc שמאזינים ליומני הביקורת של Cloud (
cloudaudit.googleapis.com). אפשר להשתמש בטריגרים האלה כדי להתחיל תהליכי עבודה במורד הזרם מיד אחרי אירועי השלמת המשימות של DataScan. הגישה הזו עוקפת את מגבלות הסקרים של ה-API, חוסכת במכסות ומפחיתה את זמן האחזור.
מתן גישה לתוצאות של סריקת איכות הנתונים
כדי לאפשר למשתמשים בארגון לראות את תוצאות הסריקה:
במסוף Google Cloud , בדף Metadata curation של BigQuery, נכנסים לכרטיסייה Data profiling & quality.
לוחצים על סריקת איכות הנתונים שרוצים לשתף את התוצאות שלה.
לוחצים על הכרטיסייה Permissions.
מבצעים את הפעולות הבאות:
- כדי לתת גישה לחשבון משתמש, לוחצים על Grant access. מקצים את התפקיד Dataplex DataScan DataViewer לחשבון המשתמש המשויך.
- כדי להסיר את הגישה מחשבון משתמש, בוחרים את החשבון שרוצים להסיר ממנו את התפקיד Dataplex DataScan DataViewer. לוחצים על הסרת הגישה ומאשרים את הפעולה.
פתרון בעיות שקשורות לאיכות הנתונים
אתם יכולים להגדיר התראות על כשלים באיכות הנתונים באמצעות היומנים ב-Cloud Logging. למידע נוסף, כולל שאילתות לדוגמה, קראו את המאמר הגדרת התראות ב-Cloud Logging.
לכל משימה עם כללים ברמת השורה שנכשלו, Knowledge Catalog מספק שאילתה כדי לקבל את הרשומות שנכשלו. מריצים את השאילתה הזו כדי לראות את הרשומות שלא תואמות לכלל.
המסוף
במסוף Google Cloud , בדף Metadata curation של BigQuery, נכנסים לכרטיסייה Data profiling & quality.
לוחצים על השם של סריקת איכות הנתונים שרוצים לפתור בעיות ברשומות שלה.
לוחצים על הכרטיסייה Jobs history.
לוחצים על מזהה המשימה שבה זוהו כשלים באיכות הנתונים.
בחלון תוצאות המשימה שנפתח, בקטע Rules, מאתרים את העמודה Query to get failed records. לוחצים על Copy query to clipboard בכלל שנכשל.
מריצים את השאילתה ב-BigQuery כדי לראות את הרשומות שגרמו למשימה להיכשל.
gcloud
לא נתמך.
REST
כדי לקבל את המשימה שזיהתה את הכשלים באיכות הנתונים, משתמשים ב-method
dataScans.get.באובייקט התגובה, השאילתה מופיעה בשדה
failingRowsQuery.מריצים את השאילתה ב-BigQuery כדי לראות את הרשומות שגרמו למשימה להיכשל.
ב-Knowledge Catalog מופעלת גם שאילתת ניפוי הבאגים, בתנאי שהיא נכללה במהלך יצירת הכלל. תוצאות השאילתה לניפוי באגים נכללות בפלט של כל כלל. התכונה הזו נמצאת בגרסת טרום-השקה (Preview).
המסוף
לא נתמך.
gcloud
לא נתמך.
REST
כדי לקבל את המשימה שזיהתה את הכשלים באיכות הנתונים, משתמשים ב-method dataScans.get.
באובייקט התגובה, השדה debugQueriesResultSets מציג את התוצאות של שאילתות ניפוי הבאגים.
ניהול סריקות של איכות הנתונים בטבלה ספציפית
במאמר הזה מוסבר איך לנהל את הסריקות של איכות הנתונים בפרויקט באמצעות הדף Metadata curation > Data profiling & quality של BigQuery במסוףGoogle Cloud .
אתם יכולים גם ליצור ולנהל סריקות של איכות הנתונים כשאתם עובדים עם טבלה ספציפית. במסוף Google Cloud , בדף BigQuery של הטבלה, משתמשים בכרטיסייה איכות הנתונים. מבצעים את הפעולות הבאות:
נכנסים לדף BigQuery במסוף Google Cloud .
בחלונית Explorer (בחלונית הימנית), לוחצים על Datasets ואז על מערך הנתונים שלכם. לוחצים על Overview > Tables ובוחרים את הטבלה שרוצים לראות את תוצאות סריקת איכות הנתונים שלה.
לוחצים על הכרטיסייה איכות הנתונים.
בהתאם לשאלה אם לטבלה יש סריקת איכות נתונים שהתוצאות שלה מתפרסמות כמטא-נתונים של Knowledge Catalog, אתם יכולים לעבוד עם סריקות איכות הנתונים של הטבלה בדרכים הבאות:
תוצאות הסריקה של איכות הנתונים מתפרסמות: תוצאות הסריקה האחרונות מוצגות בדף.
כדי לנהל את סריקות איכות הנתונים של הטבלה, לוחצים על Data quality scan ובוחרים אחת מהאפשרויות הבאות:
יצירת סריקה חדשה: יצירת סריקה חדשה של איכות הנתונים. מידע נוסף מופיע בקטע יצירת סריקה של איכות הנתונים במאמר הזה. כשיוצרים סריקה מדף הפרטים של הטבלה, הטבלה נבחרת מראש.
הפעלה מיידית: הפעלת הסריקה.
עריכת הגדרות הסריקה: עריכת ההגדרות, כולל השם המוצג, המסננים ולוח הזמנים.
כדי לערוך את הכללים של איכות הנתונים, בכרטיסייה Data quality לוחצים על הכרטיסייה Rules. לוחצים על שינוי כללים. מעדכנים את הכללים ולוחצים על שמירה.
ניהול הרשאות הסריקה: אתם יכולים לקבוע למי תהיה גישה לתוצאות הסריקה. למידע נוסף, קראו את הקטע מתן גישה לתוצאות של סריקת איכות הנתונים במאמר הזה.
View historical results: הצגת מידע מפורט על משימות קודמות של סריקת איכות הנתונים. מידע נוסף זמין בקטעים הצגת תוצאות של סריקות לאיכות הנתונים והצגת תוצאות של סריקות היסטוריות במסמך הזה.
View all scans: הצגת רשימה של סריקות איכות הנתונים שחלות על הטבלה הזו.
תוצאות הסריקה של איכות הנתונים לא מתפרסמות: בוחרים מבין האפשרויות הבאות:
יצירת סריקה של איכות הנתונים: יצירת סריקה חדשה של איכות הנתונים. מידע נוסף מופיע בקטע יצירת סריקה של איכות הנתונים במאמר הזה. כשיוצרים סריקה מדף הפרטים של הטבלה, הטבלה נבחרת מראש.
thought View existing scans: הצגת רשימה של סריקות איכות הנתונים שחלות על הטבלה הזו.
הצגת הסריקות של איכות הנתונים בטבלה
כדי לראות את סריקות איכות הנתונים שחלות על טבלה ספציפית:
במסוף Google Cloud , בדף Metadata curation של BigQuery, נכנסים לכרטיסייה Data profiling & quality.
לסנן את הרשימה לפי שם הטבלה וסוג הסריקה.
עדכון סריקה של איכות הנתונים
אתם יכולים לערוך הגדרות שונות של סריקה קיימת של איכות הנתונים, כמו השם המוצג, המסננים, לוח הזמנים והכללים של איכות הנתונים.
המסוף
במסוף Google Cloud , בדף Metadata curation של BigQuery, נכנסים לכרטיסייה Data profiling & quality.
לוחצים על השם של סריקת איכות הנתונים.
כדי לערוך את ההגדרות, כולל השם המוצג, המסננים ולוח הזמנים, לוחצים על Edit. עורכים את הערכים ולוחצים על שמירה.
כדי לערוך את הכללים של איכות הנתונים, לוחצים על הכרטיסייה Current rules בדף פרטי הסריקה. לוחצים על שינוי כללים. מעדכנים את הכללים ולוחצים על שמירה.
gcloud
כדי לעדכן את התיאור של סריקת איכות נתונים, משתמשים בפקודה gcloud dataplex datascans update data-quality:
gcloud dataplex datascans update data-quality DATASCAN \
--location=LOCATION \
--description=DESCRIPTION
מחליפים את מה שכתוב בשדות הבאים:
-
DATASCAN: השם של סריקת איכות הנתונים שרוצים לעדכן. -
LOCATION: האזור ב- Google Cloud שבו נוצרה סריקת איכות הנתונים. -
DESCRIPTION: התיאור החדש של סריקת איכות הנתונים.
C#
C#
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
המשך
Go
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Java
Java
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Python
Python
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Ruby
Ruby
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
REST
כדי לערוך סריקה של איכות הנתונים, משתמשים ב-method dataScans.patch.
מחיקת סריקה של איכות הנתונים
המסוף
המסוף
במסוף Google Cloud , בדף Metadata curation של BigQuery, נכנסים לכרטיסייה Data profiling & quality.
לוחצים על הסריקה שרוצים למחוק.
לוחצים על מחיקה ומאשרים את הפעולה כשמוצגת בקשה.
gcloud
gcloud
כדי למחוק סריקה של איכות הנתונים, משתמשים בפקודה gcloud dataplex datascans delete:
gcloud dataplex datascans delete DATASCAN \
--location=LOCATION \
--async
מחליפים את המשתנים הבאים:
-
DATASCAN: השם של סריקת איכות הנתונים שרוצים למחוק. -
LOCATION: האזור ב- Google Cloud שבו נוצרה סריקת איכות הנתונים.
C#
C#
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
המשך
Go
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Java
Java
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Python
Python
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
Ruby
Ruby
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. למידע נוסף, ראו הגדרת אימות לסביבת פיתוח מקומית.
REST
REST
כדי למחוק סריקה של איכות הנתונים, משתמשים בשיטה dataScans.delete.