


「探索查詢追蹤工具」和「探索『成效』面板」會提供探索查詢的逐步成效資料。這項資料有助於找出關鍵切入點,排解及解決查詢效能問題,並提供改善建議。
探索查詢追蹤器
「探索」查詢追蹤器會顯示「探索」查詢在三個階段的進度。

如果查詢執行時間過長,查詢追蹤工具會指出是哪個階段導致效能問題。這有助於找出可能發生效能問題的位置,以及最能有效進行最佳化的位置。
只要開啟「探索」的「圖表」面板或「資料」面板,系統就會在執行探索時顯示查詢追蹤器。
探索「效能」面板
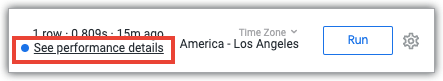
如要查看「探索」的「成效」面板,請點選「查看成效詳細資料」連結,這個連結會顯示在任何已執行的「探索」查詢中。
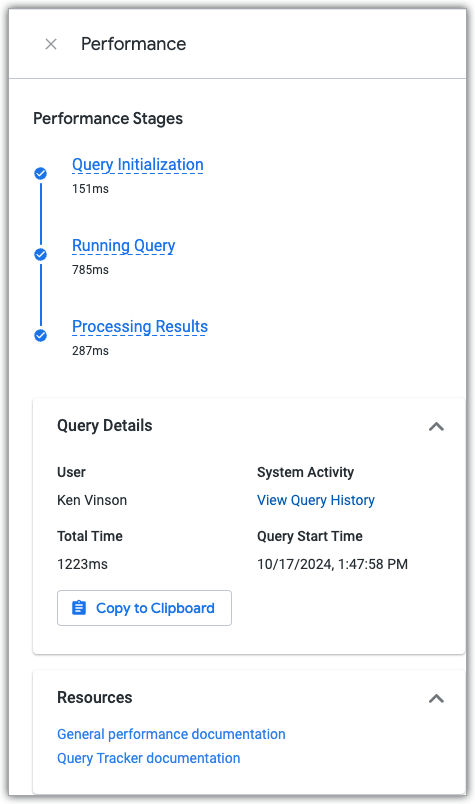
「效能」面板會顯示查詢在三個查詢階段中各花費的時間,並提供效能說明文件和「查詢記錄」系統活動資訊主頁的連結,其中顯示查詢和用於建立查詢的探索目前的和歷來成效資料。
查詢階段
Looker 探索執行資料庫查詢時,會分為下列三個階段:
查詢初始化階段
在「查詢初始化」階段,Looker 會先執行所有必要工作,再將查詢傳送至資料庫。「查詢初始化」階段包含下列工作:
- 編譯 LookML 模型
- 檢查是否需要建立任何永久衍生資料表 (PDT)
- 生成查詢 SQL
- 取得資料庫連線
「瞭解查詢效能指標」說明文件頁面介紹如何使用系統活動中的「查詢效能指標」探索功能,查看查詢的詳細細目。查詢追蹤工具的「查詢初始化」階段包含「查詢成效指標」探索的「非同步 worker 階段」、「初始化階段」和「連線處理階段」中所述的事件。
如果在查詢初始化階段遇到效能問題,或查詢耗時過長,請按照下列步驟操作:
- 錯開排定的傳送時間:如果許多排定的 Look 或資訊主頁同時觸發 (尤其是在整點),突然湧入的大量查詢要求可能會耗盡執行個體資源,並使連線集區飽和。這個並行瓶頸會導致查詢在初始化期間無限期等待或旋轉。請將排定內容錯開,每隔 15 或 30 分鐘發布一次 (例如
:15、:30或:45),而不是全部排定在:00發布。詳情請參閱「最佳化 Looker 伺服器效能」。 - 使用資料群組排定傳送作業:請盡可能使用與 ETL 週期一致的資料群組觸發排定的傳送作業,而非使用時間觸發條件。使用資料群組可分散查詢執行作業,並防止對未重新整理的資料執行多餘的查詢。
- 批次處理及限制 API 呼叫:如果自動化指令碼或外部工具透過 Looker API 觸發查詢或報表,請批次處理要求或設定延遲,避免查詢初始化佇列過載。
- 清除卡住的程序:如果並行數量突然激增,導致查詢卡住且執行個體沒有回應,請重新啟動執行個體,清除進行中的工作並重設內部佇列。
執行查詢階段
在「執行查詢」階段,Looker 會連線至資料庫並進行查詢,然後傳回查詢結果。這個階段發生效能問題,可能代表外部資料庫有問題,例如 PDT 需要很長時間才能重建,可能需要最佳化,或外部資料庫資料表可能需要最佳化。「執行查詢」階段包含下列工作:
- 在資料庫中建構探索查詢所需的任何 PDT
- 正在對資料庫執行要求的查詢
「瞭解查詢效能指標」說明文件頁面介紹如何使用系統活動中的「查詢效能指標」探索功能,查看查詢的詳細細目。查詢追蹤器的「執行查詢」階段包含「查詢成效指標」探索的「主要查詢階段」中所述的事件。
如果在這個階段遇到效能問題,可以採取下列步驟:
- 盡可能使用
many_to_one彙整建立探索。將最詳細的檢視表分別彙整至提供整體資料的檢視表 (many_to_one),通常能讓 Looker 發揮最佳查詢效能。 - 充分利用快取功能,盡可能配合 ETL 政策,減少資料庫查詢流量。根據預設,Looker 會快取查詢一小時。您可以使用
persist_with參數,在探索中套用資料群組,藉此控管快取政策,並讓 Looker 資料重新整理作業與 ETL 程序保持同步。盡可能提高快取用量,Looker 就能與後端資料管道更密切整合,在充分利用快取的同時,避免分析到過時資料。具名快取政策可套用至整個模型,或個別探索和永久衍生資料表 (PDT)。 - 使用 Looker 的匯總感知功能建立匯總或摘要資料表,讓 Looker 盡可能使用這些資料表進行查詢,尤其是大型資料庫的常見查詢。您也可以使用匯總感知功能,大幅提升整個資訊主頁的效能。詳情請參閱匯總感知教學課程。
- 使用 PDT 加快查詢速度。將含有許多複雜或效能不佳彙整的探索,或含有子查詢或子選取的維度,轉換為 PDT,以便在執行階段前預先彙整並準備好檢視表。
- 如果資料庫方言支援永久累加型衍生資料表,請設定永久累加型衍生資料表,減少 Looker 重建 PDT 資料表所需的時間。
- 避免在 Looker 中定義的串連主鍵上,將檢視表彙整至探索。請改為在基本欄位上進行彙整,這些欄位會構成檢視表中的串連主鍵。或者,您也可以將檢視表重新建立為 PDT,並在資料表的 SQL 定義中預先定義串連主鍵,而不是在檢視表的 LookML 中定義。
- 使用 SQL Runner 工具中的「Explain」功能進行基準測試。
EXPLAIN會針對特定 SQL 查詢,產生資料庫查詢執行計畫的總覽,讓您偵測可最佳化的查詢元件。詳情請參閱社群貼文「如何使用EXPLAIN最佳化 SQL」。 - 宣告索引。您可以在 Looker 中,直接透過 SQL Runner 查看各資料表的索引,方法是按一下資料表中的齒輪圖示,然後選取 Show Indexes。
最常受益於索引的資料欄是重要日期和外鍵。為這些資料欄新增索引,幾乎所有查詢的效能都會提升。這也適用於 PDT。LookML 參數 (例如
indexes、sort keys和distribution) 可適當套用。
處理結果階段
在「處理結果」階段,Looker 會處理及呈現查詢結果。「處理結果」階段包含下列工作:
- 將查詢結果串流至快取
- 解決資料表計算問題
- 設定 Liquid 範本語言結果的格式
- 合併查詢
- 計算總計和小計
「瞭解查詢效能指標」說明文件頁面介紹如何使用系統活動中的「查詢效能指標」探索功能,查看查詢的詳細細目。查詢追蹤器的「處理結果」階段包含「查詢成效指標」探索工具中「查詢後階段」所述的事件。
如果在這個階段遇到效能問題,可以採取以下步驟:
- 請盡量少用合併結果、自訂欄位和資料表計算等功能。這些功能僅供概念驗證,協助您設計模型。 最佳做法是在 LookML 中硬式編碼任何常用的計算和函式,這會產生要在資料庫中處理的 SQL。過多計算可能會爭用 Looker 執行個體上的 Java 記憶體,導致 Looker 執行個體的回應速度變慢。
- 如果檢視表檔案數量龐大,請限制模型中包含的檢視表數量。如果將所有檢視表納入單一模型,可能會降低效能。如果專案中有多個檢視表,建議只在每個模型中加入必要的檢視表檔案。建議您為檢視檔案名稱採用策略性命名慣例,以便在模型中加入檢視群組。
includes參數說明文件中有範例。 - 避免在資訊主頁圖塊和 Look 圖表中預設傳回大量資料點。如果查詢傳回數千個資料點,會耗用更多記憶體。請盡可能限制資料,方法是在資訊主頁、Look 和探索套用前端
篩選器,並在 LookML 層級使用
required filters、conditionally_filter和sql_always_where參數。 - 請盡量避免使用「所有結果」選項下載或傳送查詢,因為部分查詢可能非常龐大,處理時會導致 Looker 伺服器不堪負荷。